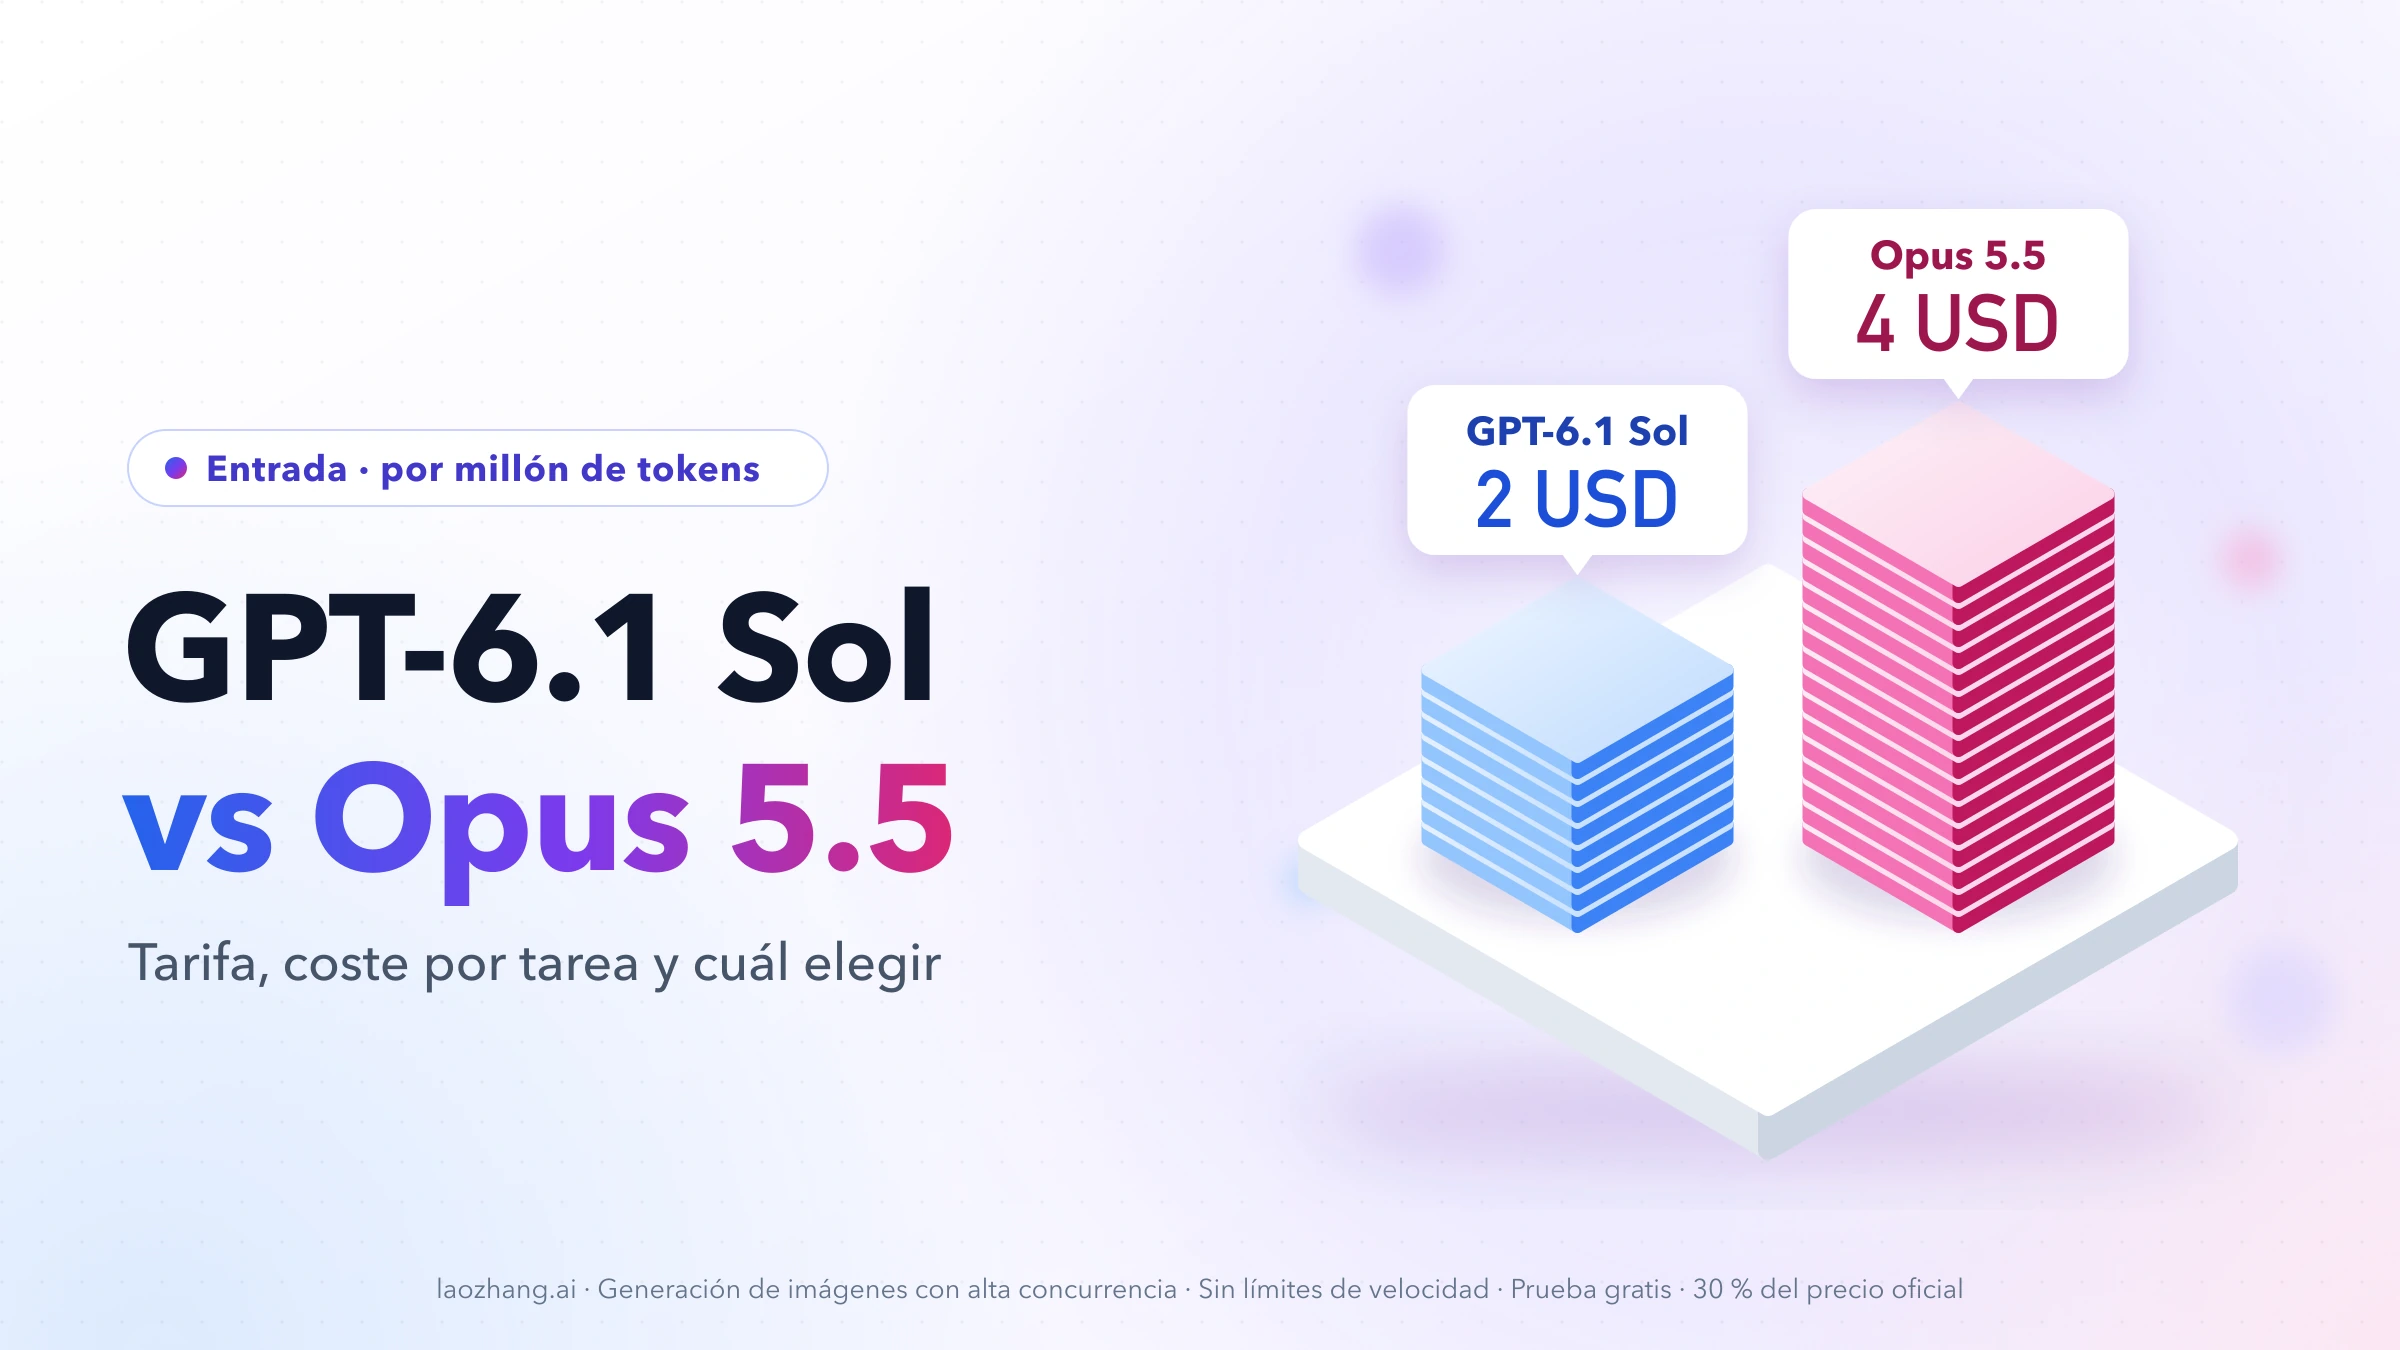
A 10 de octubre de 2026, GPT-6.1 Sol cuesta en la API 2 $ por millón de tokens de entrada y 10 $ por millón de salida; Claude Opus 5.5 cuesta 4 y 20 $. Por petición, Sol sale exactamente a la mitad. Por tarea, la distancia es mayor, porque Opus 5.5 escribe unas tres veces más tokens: en Artificial Analysis, cada tarea de Opus cuesta entre 4,2 y 8,9 veces más según el nivel de razonamiento. A cambio, Opus empata en low y saca hasta 6 puntos de índice en max.
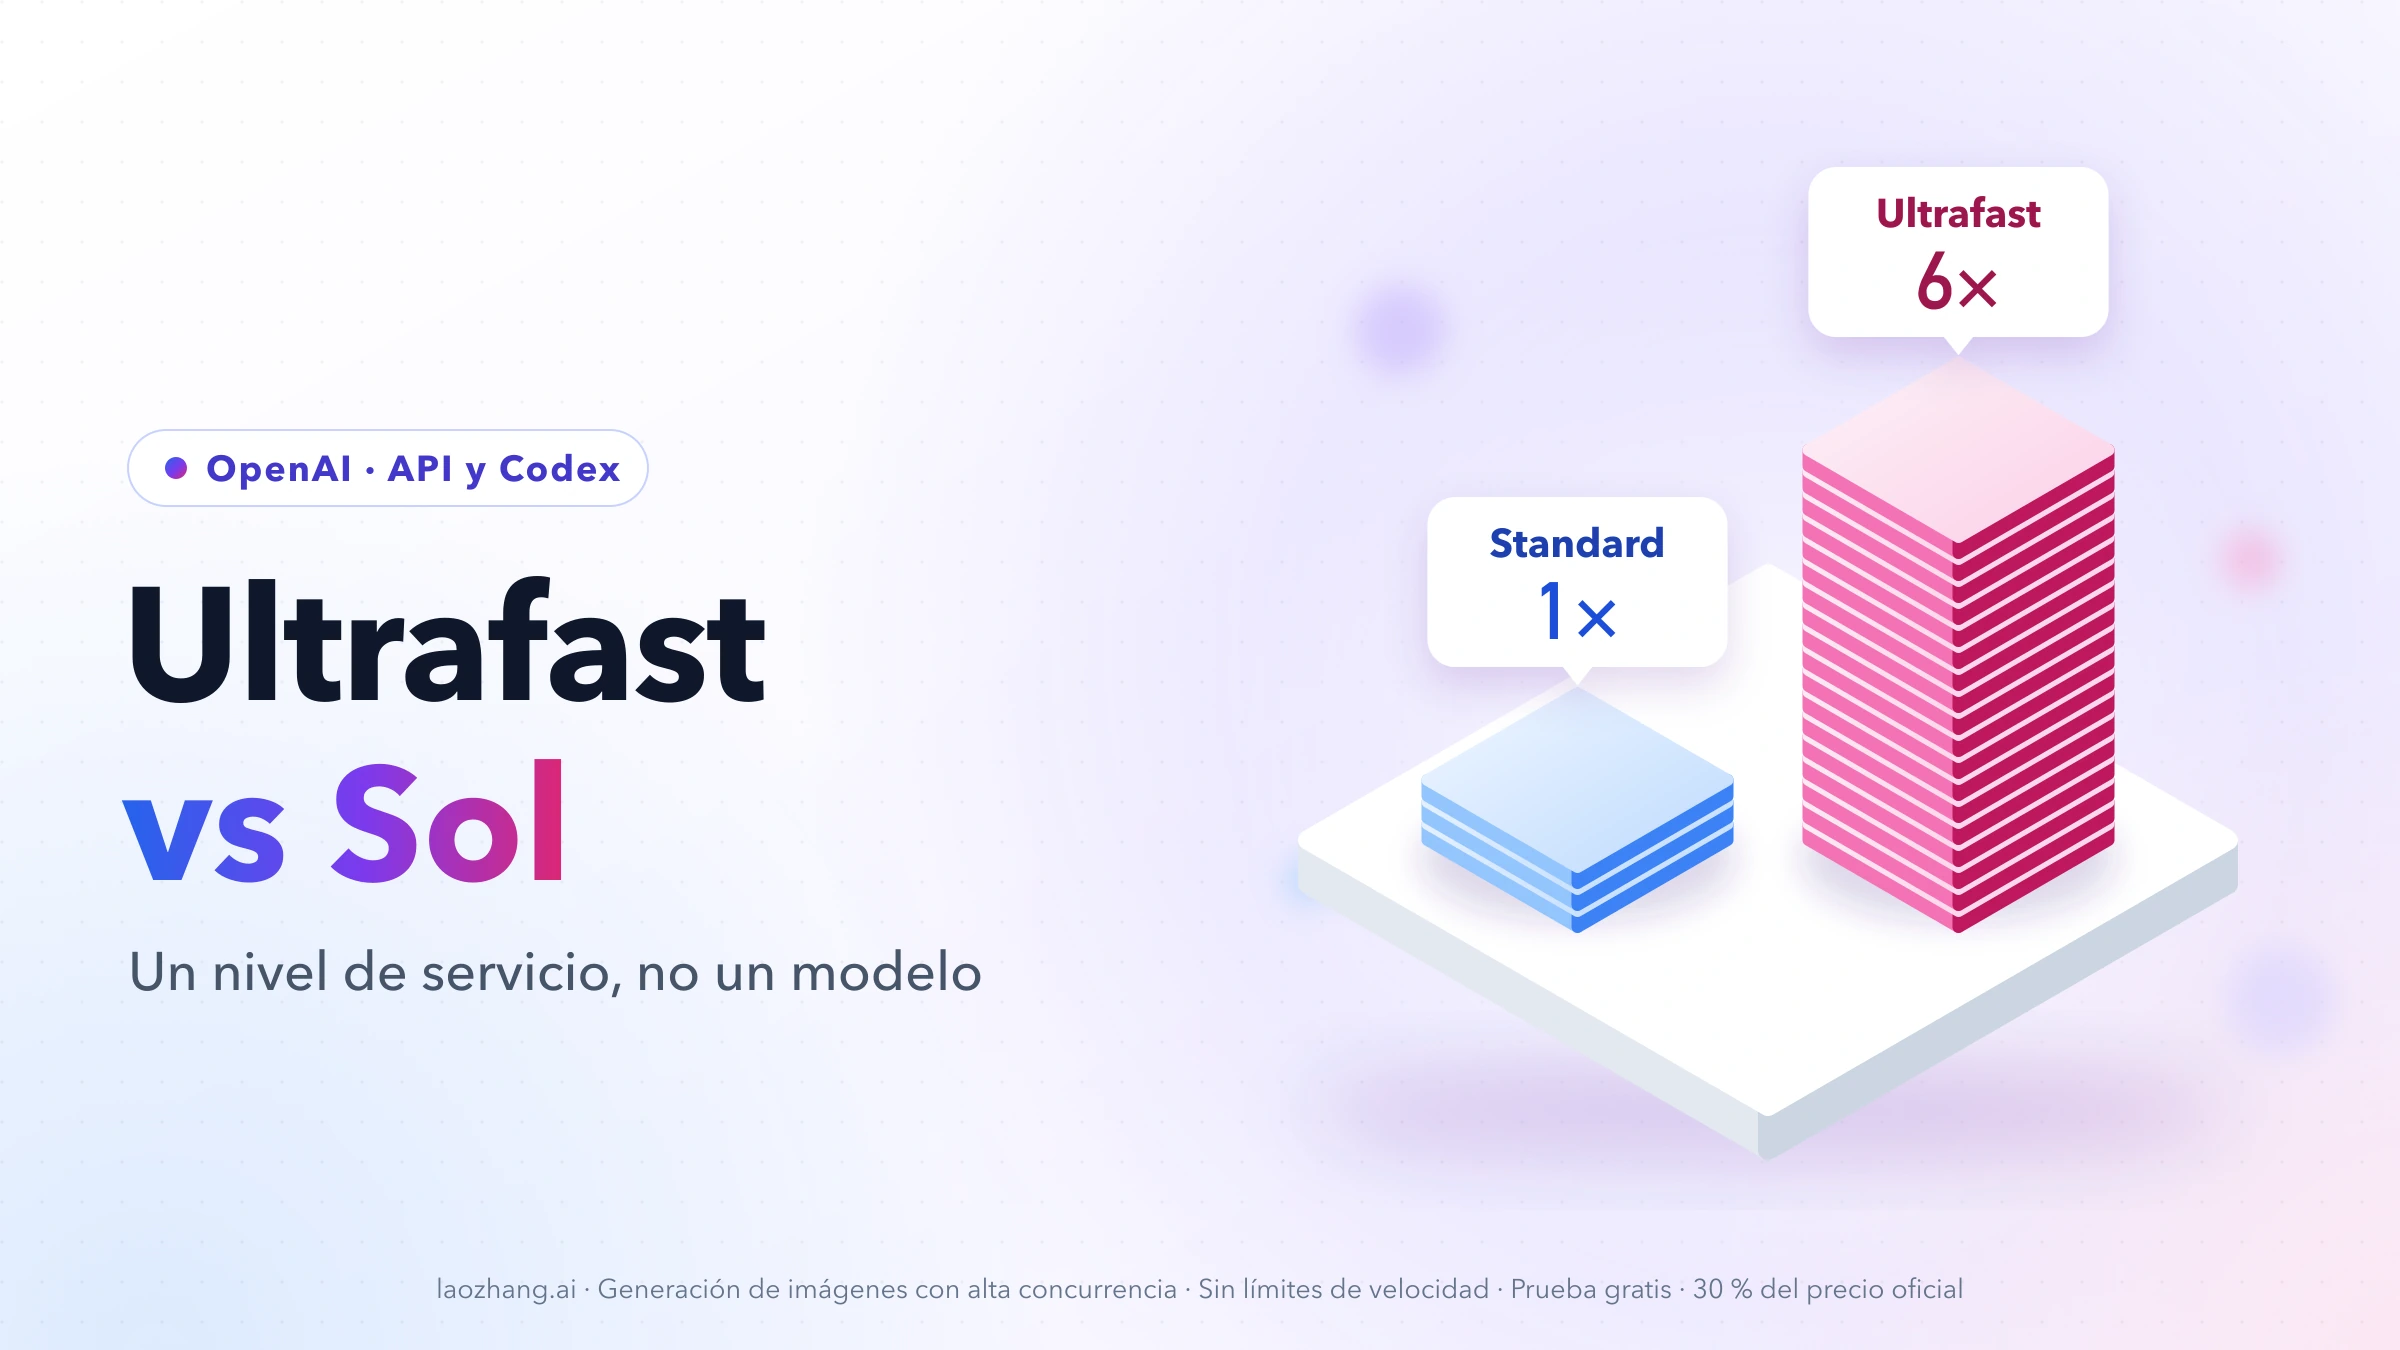
Desde el 8 de octubre hay además un modo de velocidad nuevo: GPT-6.1 Sol Ultrafast, a 12/60 $ en la API para todas las cuentas. La misma petición cuesta con él el triple que con Opus 5.5 normal y 1,5 veces lo que el modo Fast de Opus (8/40 $), que sigue en lista de espera. Por tarea la cuenta se invierte: como Opus escribe más tokens, Sol Ultrafast sale, según una estimación, por la mitad que Opus Fast.
| Tu caso | Empieza por | Por qué |
|---|---|---|
| Mucho volumen, agentes con muchas llamadas, tareas que se validan con tests | GPT-6.1 Sol en medium o high | Coste por tarea entre 5,7 y 6,4 veces menor, con 3–4 puntos menos de índice |
| Tareas largas y difíciles donde revisar o rehacer cuesta caro | Claude Opus 5.5 en high, xhigh o max | 4–6 puntos más; cada tarea cuesta entre 5,7 y 8,9 veces más |
Quieres la nota de Opus medium gastando menos y puedes esperar | GPT-6.1 Sol en xhigh | Misma puntuación (51) por 1/3,4 del coste, pero 174 s hasta el primer token de respuesta frente a 22 s |
| Necesitas más velocidad que la estándar | Sol Ultrafast, disponible ya; Opus Fast si consigues acceso | Ultrafast está abierto a toda la API a 6 veces la tarifa; Opus Fast cuesta 2 veces y requiere lista de espera |
| Peticiones de más de 272.000 tokens de entrada | El que mejor resuelva tu documento | La diferencia por petición cae a un 1–7 % |
| Codex o Claude Code con un plan de 20 $ | Una semana con cada uno | Anthropic no publica cuánto Opus 5.5 incluye cada plan, así que no hay cifra que comparar |
Las puntuaciones independientes son de Artificial Analysis y Vals; las de OpenAI y Anthropic aparecen aparte y marcadas como datos del fabricante.
Qué es GPT-6.1 Sol («Sol 6.1») y en qué se diferencia de Opus 5.5
«GPT 6.1», «Sol 6.1» y gpt-6.1-sol son el mismo modelo: GPT-6.1 Sol, una mejora de GPT-6 Sol que OpenAI publicó en su API el 29 de septiembre de 2026, durante el DevDay (registro de cambios). No existen GPT-6.1 Astra ni GPT-6.1 Luna; GPT-6 Astra sigue siendo el modelo más capaz de OpenAI (anuncio). Por su parte, Claude Opus 5.5 (claude-opus-5-5) salió el 22 de septiembre de 2026 y no es lo mismo que Claude Opus 5 (claude-opus-5), el Opus anterior.
| GPT-6.1 Sol | Claude Opus 5.5 | |
|---|---|---|
| ID en la API | gpt-6.1-sol | claude-opus-5-5 (Bedrock: anthropic.claude-opus-5-5) |
| Tarifa estándar (entrada / salida, por millón) | 2 / 10 $ hasta 272.000 tokens de entrada | 4 / 20 $ en todo el contexto |
| Modos de velocidad | Fast (4 / 20 $) y Ultrafast (12 / 60 $) | Fast (8 / 40 $), en vista previa |
| Contexto | 1.050.000 tokens, con 922.000 de entrada como máximo | 1.000.000 tokens |
| Salida máxima | 128.000 tokens | 128.000 tokens (300.000 en Message Batches con cabecera beta) |
| Niveles de razonamiento | low, medium (por defecto), high, xhigh, max; sin none ni minimal | low, medium (por defecto), high, xhigh, max; razonamiento adaptativo siempre activo |
| Corte de conocimiento | 30 de abril de 2026 | Junio de 2026 |
Índice de Artificial Analysis (medium / max) | 48 / 52 | 51 / 58 |
Coste por tarea en ese índice (medium / max) | 0,21 / 0,72 $ | 1,34 / 5,98 $ |
| Dónde se usa | API; ChatGPT Work y Codex en Plus, Pro, Business, Enterprise y Edu | Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry, Claude Platform on AWS; Claude Pro, Max, Team, Enterprise y Claude Code |
Fuentes: ficha de GPT-6.1 Sol y ficha de Claude Opus 5.5. En la API de OpenAI, las llamadas a herramientas de GPT-6.1 Sol solo funcionan con la Responses API; Chat Completions lo admite sin herramientas.
GPT-6.1 Sol sigue sin estar en la pestaña Chat de ChatGPT. Lo que llegó al Chat el 7 de octubre fue GPT-6 Sol para los planes de pago y GPT-6 Luna para Free y Go (desde el 8), y OpenAI aclara que ese cambio no toca los modelos de Work ni de Codex (GPT-6 para todos).
Precio de la API: Sol a 2/10 $ y Opus 5.5 a 4/20 $ por millón de tokens
Importes en dólares por millón de tokens en la API directa de cada proveedor, sin impuestos.
| Concepto | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Entrada | 2 | 4 |
| Salida | 10 | 20 |
| Lectura de caché | 0,10 | 0,20 |
| Escritura en caché | 2,50 | 5 (5 minutos) / 8 (1 hora) |
| Batch (entrada / salida) | 1 / 5 (Flex, igual) | 2 / 10 |
| Peticiones de más de 272.000 tokens de entrada | 4 / 15, caché 0,20 | Sin recargo hasta 1 millón |
| Modo Fast (entrada / salida) | 4 / 20 | 8 / 40 |
| Modo Ultrafast (entrada / salida) | 12 / 60 | No existe |
Fuentes: precios de OpenAI y precios de Claude. Los endpoints regionales (residencia de datos) de OpenAI suman un 10 % y la inferencia solo en EE. UU. de Anthropic multiplica por 1,1.
El precio de GPT-6.1 Sol no está marcado como promocional. La nota de la página de OpenAI que habla de un precio promocional «al menos hasta el 21 de noviembre de 2026» se refiere solo a GPT-5.6 Sol. Respecto a GPT-6 Sol, la tarifa es la misma y la lectura de caché baja de 0,20 a 0,10 $.
Con los mismos tokens, Sol cuesta la mitad en cada línea. Una petición de 100.000 tokens de entrada y 10.000 de salida:
- GPT-6.1 Sol: 0,1 × 2 + 0,01 × 10 = 0,30 $
- Claude Opus 5.5: 0,1 × 4 + 0,01 × 20 = 0,60 $
Sol Ultrafast vs modo Fast de Opus 5.5: precio y acceso desde el 8 de octubre
Ultrafast y Fast no son modelos distintos, sino modos de velocidad del mismo modelo que se cobran más caros. Desde el 8 de octubre, GPT-6.1 Sol Ultrafast está disponible en la Responses API con service_tier: "ultrafast" para todas las cuentas de API (registro de cambios de OpenAI), a exactamente 6 veces la tarifa estándar. El modo Fast de Opus 5.5 cuesta el doble de la tarifa normal y sigue en vista previa de investigación (documentación de Anthropic).
Precio de la misma petición en cada modo, con peticiones de hasta 272.000 tokens de entrada y el mismo número de tokens en los dos modelos:
| Modo | Tarifa (entrada / salida) | Petición A: 100.000 entrada + 10.000 salida | Petición B: 50.000 entrada + 200.000 de caché + 10.000 salida |
|---|---|---|---|
| GPT-6.1 Sol Standard | 2 / 10 $ | 0,30 $ | 0,22 $ |
| GPT-6.1 Sol Fast | 4 / 20 $ | 0,60 $ | 0,44 $ |
| GPT-6.1 Sol Ultrafast | 12 / 60 $ (caché 0,60) | 1,80 $ | 1,32 $ |
| Claude Opus 5.5 estándar | 4 / 20 $ | 0,60 $ | 0,44 $ |
| Claude Opus 5.5 Fast | 8 / 40 $ | 1,20 $ | 0,88 $ |
Cálculo de la petición B con Sol Ultrafast: 0,05 × 12 + 0,2 × 0,60 + 0,01 × 60 = 1,32 $. Con Opus Fast, la lectura de caché se toma como 0,05 × 8 = 0,40 $, porque Anthropic indica que los multiplicadores de caché se aplican sobre la tarifa Fast; esa cifra no figura como fila propia en su tabla. No se incluye la escritura previa en caché.
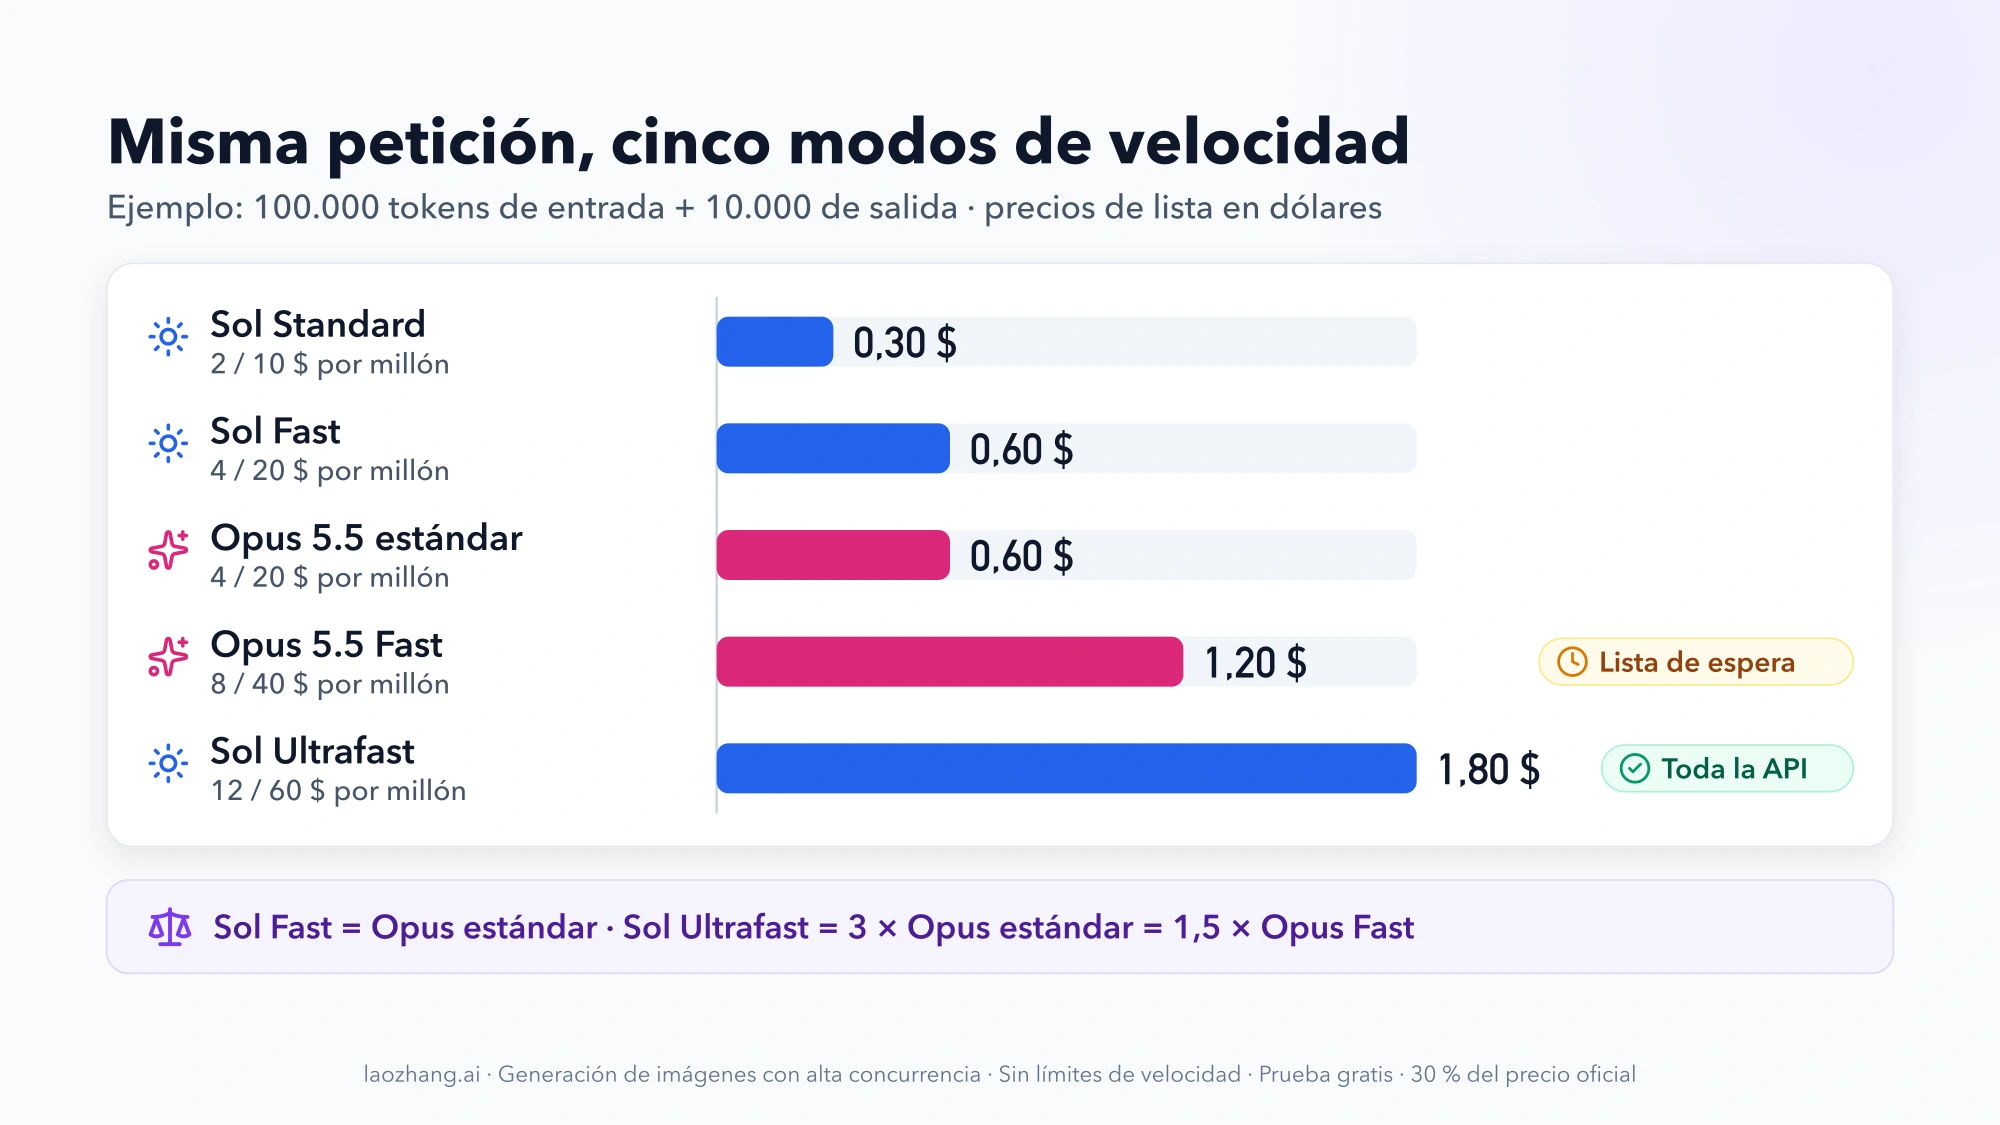
Las proporciones se repiten en los dos tipos de petición: Sol Fast cuesta lo mismo que Opus estándar, y Sol Ultrafast cuesta 1,5 veces Opus Fast, 3 veces Opus estándar y 6 veces Sol Standard.
Por tarea, la cuenta se da la vuelta, porque Opus escribe unas tres veces más tokens para resolver lo mismo. Si el modo de velocidad ejecuta el mismo modelo con los mismos tokens por tarea, basta con aplicar el multiplicador de precio al coste por tarea de Artificial Analysis:
| Coste por tarea estimado | medium | max |
|---|---|---|
| GPT-6.1 Sol Standard | 0,21 $ | 0,72 $ |
| Claude Opus 5.5 estándar | 1,34 $ | 5,98 $ |
| GPT-6.1 Sol Ultrafast (× 6) | 0,21 × 6 ≈ 1,26 $ | 0,72 × 6 ≈ 4,32 $ |
| Claude Opus 5.5 Fast (× 2) | 1,34 × 2 ≈ 2,68 $ | 5,98 × 2 ≈ 11,96 $ |
Por petición, Sol Ultrafast cuesta 1,5 veces Opus Fast; por tarea, aproximadamente la mitad. En medium, una tarea de Sol Ultrafast cuesta casi lo mismo que una de Opus estándar (1,26 frente a 1,34 $), que además puntúa 3 puntos más. Son estimaciones: ningún evaluador ha medido todavía tareas completas en estos modos, los costes de Artificial Analysis están redondeados y las filas de Opus incluyen el modelo de respaldo.
Lo que se acelera y quién puede usarlo es muy distinto en cada caso:
| Modo | Qué promete el fabricante | Dónde y quién |
|---|---|---|
| GPT-6.1 Sol Ultrafast | Hasta 8 veces la velocidad de generación de Sol Standard; OpenAI recomienda WebSocket en la Responses API para no perder la ganancia | Todas las cuentas de API, con límites propios (1M, 4M y 40M de tokens por minuto en Build, Launch y Grow) y residencia de datos en EE. UU. y la UE. En Codex y ChatGPT Work, solo Pro de 500 $ y Enterprise/Edu que cumplan los requisitos (en Enterprise viene desactivado) |
| GPT-6.1 Sol Fast | Procesamiento prioritario (antes «Priority processing») | API; en Codex y Work consume la asignación del plan 2,5 veces más rápido que Standard |
| Claude Opus 5.5 Fast | Hasta 2,5 veces más tokens de salida por segundo; la mejora se centra en la salida, no en el tiempo hasta el primer token | Vista previa: acceso por gestor de cuenta o lista de espera. Solo Claude API (incluidos Managed Agents), no Bedrock, Google Cloud, Foundry ni Claude Platform on AWS; no funciona con Batch. En Claude Code, /fast en Pro, Max, Team y Enterprise, cobrado solo con créditos de uso |
En Codex y Work, Ultrafast gasta la asignación incluida 8 veces más rápido que Standard y los créditos a 6 veces; los demás planes de autoservicio no tienen acceso, ni siquiera comprando créditos (ayuda de OpenAI sobre Pro). En Claude Code, el modo Fast nunca descuenta del límite del plan: necesita tener activados los créditos de uso (documentación de Claude Code). En la API de Claude, pasar de una velocidad a otra invalida la caché de prompts, porque las dos velocidades no comparten prefijos.
Sobre los segundos que ahorra cada modo no hay datos. «Hasta 8 veces» y «hasta 2,5 veces» son máximos de cada fabricante respecto a la velocidad normal de su propio modelo: no se pueden comparar entre sí ni convertir en tiempo, y a 10 de octubre de 2026 ningún evaluador independiente ha publicado tokens por segundo de Sol Ultrafast ni de Opus Fast. Lo que sí está medido es la velocidad estándar: Opus 5.5 emite más rápido (79 frente a 52 tokens por segundo en medium; 97 frente a 59 en max) y GPT-6.1 Sol empieza a responder antes en low, medium y max, pero no en high ni xhigh (5,9 s frente a 21,9 s en medium). Para el detalle de Ultrafast frente a Sol normal, consulta OpenAI Ultrafast vs Sol: diferencias, precio y qué Sol lo admite.
Benchmarks por nivel de razonamiento: empate en low, 6 puntos en max
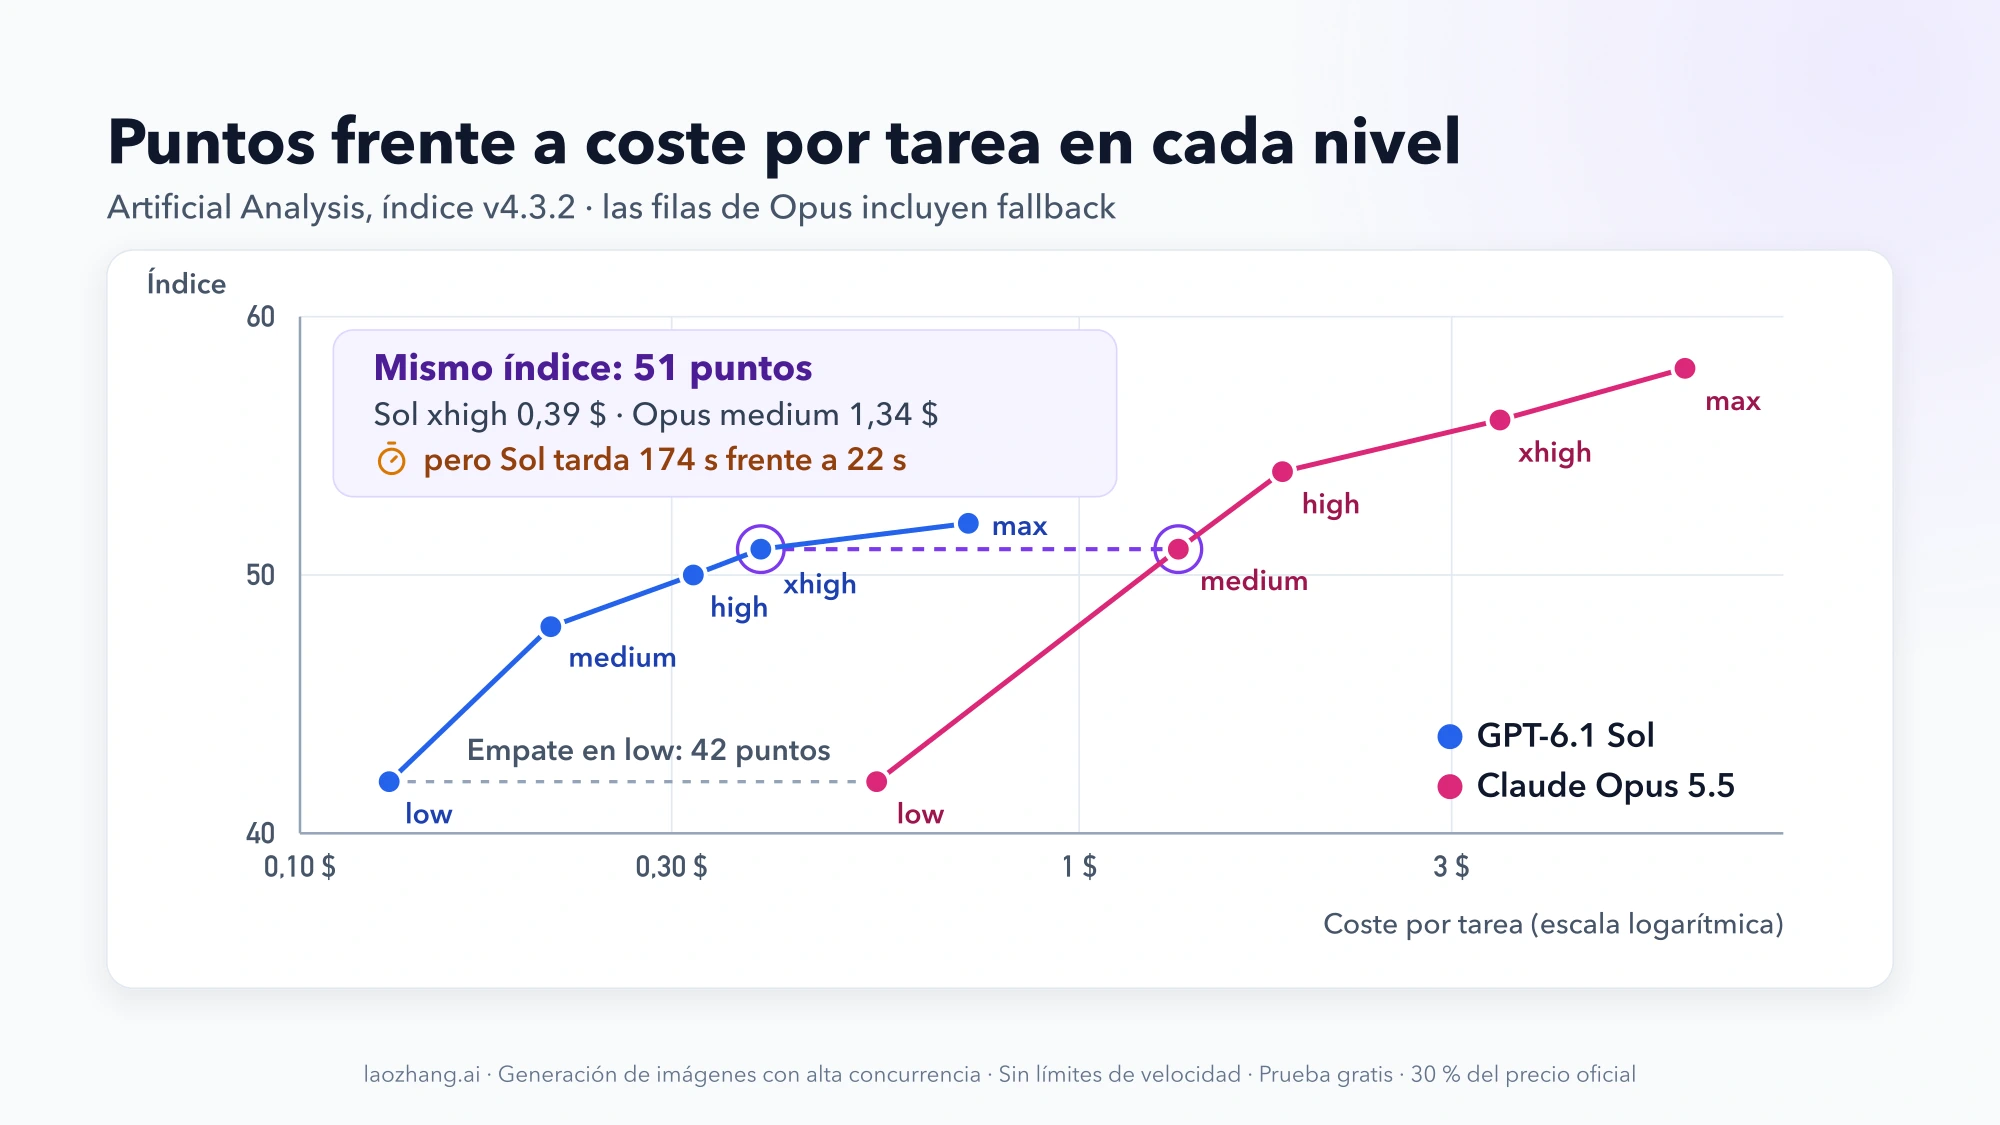
Artificial Analysis publica los dos modelos en sus cinco niveles de razonamiento con la misma batería (Intelligence Index v4.3.2). Es la comparación más completa disponible y muestra que la diferencia depende del nivel:
| Nivel | Índice Sol / Opus | Diferencia | Coste por tarea Sol / Opus | Opus cuesta | Tokens por segundo Sol / Opus | Primer token de respuesta Sol / Opus |
|---|---|---|---|---|---|---|
low | 42 / 42 | 0 | 0,13 / 0,55 $ | 4,2 veces más | 51 / 78 | 3,0 / 8,7 s |
medium | 48 / 51 | 3 | 0,21 / 1,34 $ | 6,4 veces más | 52 / 79 | 5,9 / 21,9 s |
high | 50 / 54 | 4 | 0,32 / 1,82 $ | 5,7 veces más | 53 / 80 | 62,3 / 39,6 s |
xhigh | 51 / 56 | 5 | 0,39 / 3,46 $ | 8,9 veces más | 55 / 83 | 173,7 / 127,9 s |
max | 52 / 58 | 6 | 0,72 / 5,98 $ | 8,3 veces más | 59 / 97 | 309,0 / 704,2 s |
Fuente: comparación de versiones de Artificial Analysis, a 10 de octubre de 2026. Las filas de Opus llevan la etiqueta «Default Fallback» (explicada más abajo). La velocidad depende de la carga y puede cambiar; las puntuaciones también pueden revisarse.
Tres lecturas útiles para elegir:
- En
lowno hay diferencia de calidad. Los dos sacan 42 y Opus cuesta 4,2 veces más por tarea. Si trabajas a ese nivel, pagar Opus no tiene respaldo en este índice. - Sol
xhighiguala a Opusmedium. Ambos sacan 51; Sol cuesta 0,39 $ por tarea frente a 1,34 $ (3,4 veces menos), pero tarda 173,7 s en dar el primer token de respuesta frente a 21,9 s. Solmax(52) supera por un punto a Opusmediumcon el 54 % de su coste por tarea. Si puedes esperar, subir el nivel de Sol es más barato que pasar a Opus. - Arriba, Opus manda. En
high,xhighymaxsaca de 4 a 6 puntos. En Terminal-Bench 4.0, dentro de la misma batería, Opus obtiene un 52,5 % enmediumy un 59,6 % enmax, frente a un 48,0 % y un 56,1 % de Sol.
En Opus el nivel elegido mueve mucho la factura; Effort en Claude Opus 5.5: qué nivel elegir y cómo medir si compensa lo trata por separado.
Vals Index: 5,8 puntos a favor de Opus, 3,9 sin el modelo de respaldo
El Vals Index (versión 2.1, actualizado el 7 de octubre de 2026) da a Claude Opus 5.5 un 66,97 % a 32,14 $ por prueba y a GPT-6.1 Sol un 61,15 % a 3,24 $: 5,82 puntos más por unas 9,9 veces el coste. Vals registra una duración de 1 h 19 min para Opus y de 43 min 10 s para Sol. Vals advierte de que parte de las tareas de Opus las resolvió un modelo de respaldo tras un rechazo; si se cuentan como fallos, Opus baja al 65,05 % y la ventaja se queda en 3,90 puntos.
Lo que publica cada fabricante
OpenAI compara GPT-6.1 Sol con Opus 5.5 «con fallback» en su anuncio, con los datos de Opus tomados de informes públicos y no de ejecuciones propias:
| Benchmark (cifras de OpenAI) | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
GDP.pdf, high | 32,0 % a 0,35 $ por tarea | 28,8 % a 0,83 $ |
AutomationBench 1.0.6, medium | 31,7 % a 0,19 $ | 29,5 % a 0,65 $ |
AutomationBench 1.0.6, max | 36,1 % a 0,30 $ | 42,5 % a 1,44 $ |
Terminal-Bench Science 0.1, max | 57,0 % a 5,47 $ | 63,3 % a 23,21 $ |
Incluso con benchmarks elegidos por OpenAI, el resultado cambia de signo con el nivel: en GDP.pdf y en AutomationBench medium gana Sol por una fracción del coste; en max, Opus saca unos 6 puntos. Anthropic, por su parte, publica en su anuncio de Opus 5.5 un 66,4 % en Terminal-Bench 4.0, un 54,4 % en FrontierCode v1.1, 1.846 en GDPval-AA y un 81,8 % en OSWorld 2.1, pero sus tablas no incluyen ninguna fila de GPT-6.1 Sol, y el 71,4 % de Sol en OSWorld corresponde a otra versión del benchmark (2.0). Aparte de Artificial Analysis y Vals, no se ha publicado otra comparación neutral con el mismo arnés y el mismo nivel para los dos modelos.
Tokens por tarea: por qué el doble de tarifa sale de 4 a 9 veces más caro
La tarifa de Opus es el doble, pero también escribe mucho más para resolver lo mismo. En Artificial Analysis:
| Tokens por tarea | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
Salida en medium (de ellos, razonamiento) | 8.000 (3.000) | 26.000 (12.000) |
Salida en max (de ellos, razonamiento) | 38.000 (25.000) | 119.000 (84.000) |
Fuentes: comparación en nivel medium y en nivel max.
Opus escribe entre 3,1 y 3,3 veces más tokens de salida, y el razonamiento se factura como salida. Una tarifa 2 veces mayor por unas 3,25 veces más salida da 6,5, muy cerca del 6,4 medido en medium. En max la distancia medida (8,3) supera lo que explican la tarifa y la salida juntas (2 × 3,1 ≈ 6,3), y Artificial Analysis no desglosa el resto. En Vals se ve lo mismo a escala: Opus consumió 28.570 millones de tokens de entrada y 477,68 millones de salida, frente a 4.500 y 104,77 millones de Sol.
Conviene no mezclar dos métricas que publica Artificial Analysis: el coste por tarea (lo que cuesta de media cada tarea del índice) y el coste de ejecutar el índice completo. En la segunda, Opus sale 4,5 veces más caro en medium (1.627 frente a 361 $) y 8 veces en max (8.708 frente a 1.082 $).
Tampoco hay una equivalencia fija entre los tokens de un proveedor y los del otro. Anthropic indica que el tokenizador de sus modelos recientes genera alrededor de un 30 % más de tokens que el anterior para el mismo texto, y nadie publica una proporción entre los tokens de Claude y los de OpenAI. Para estimar tu factura, ejecuta una muestra de tus tareas en los dos modelos al nivel que vayas a usar, anota los campos de uso que devuelve cada API (entrada, caché y salida) y aplica las tarifas. Si tus tareas tienen mucha entrada y poca salida, la proporción se acercará a 2; si son agentes que razonan mucho, a la de Artificial Analysis.
Más de 272.000 tokens o entradas de 900.000: la diferencia baja al 1–7 %
Cuando una petición a GPT-6.1 Sol supera los 272.000 tokens de entrada, OpenAI cobra toda la petición al doble en entrada y caché y a 1,5 veces en salida. Con 272.000 exactos se mantiene la tarifa corta. Opus 5.5 cobra lo mismo por token hasta 1 millón.
| Petición (entrada + salida, sin caché) | GPT-6.1 Sol | Claude Opus 5.5 | Diferencia |
|---|---|---|---|
| 272.000 + 20.000 | 0,272 × 2 + 0,02 × 10 = 0,744 $ | 0,272 × 4 + 0,02 × 20 = 1,488 $ | Sol un 50 % más barato |
| 273.000 + 20.000 | 0,273 × 4 + 0,02 × 15 = 1,392 $ | 0,273 × 4 + 0,02 × 20 = 1,492 $ | Sol un 6,7 % más barato |
| 300.000 + 20.000 | 1,50 $ | 1,60 $ | Sol un 6,3 % más barato |
| 900.000 + 10.000 | 0,9 × 4 + 0,01 × 15 = 3,75 $ | 0,9 × 4 + 0,01 × 20 = 3,80 $ | Sol un 1,3 % más barato |
Mil tokens más de entrada encarecen la petición de Sol en 0,648 $ (un 87 %) y la de Opus en 0,004 $. Por encima del umbral, la entrada cuesta lo mismo en los dos (4 $) y solo la salida sigue siendo más barata en Sol (15 frente a 20 $).
Una entrada de 900.000 tokens cabe en los dos: Sol admite hasta 922.000 tokens de entrada y Opus 1 millón de contexto. En los modos rápidos, esa misma petición cuesta 0,9 × 8 + 0,01 × 30 = 7,50 $ en Sol Fast (tarifa larga de 8/30 $), 0,9 × 8 + 0,01 × 40 = 7,60 $ en Opus Fast, que no tiene recargo por contexto largo, y 0,9 × 24 + 0,01 × 90 = 22,50 $ en Sol Ultrafast (tarifa larga de 24/90 $).
Dos consecuencias prácticas: si tus prompts rondan los 250.000–300.000 tokens, recortar el contexto hasta 272.000 reduce la factura de Sol casi a la mitad; si trabajas con 500.000 tokens o más, la tarifa deja de ser un argumento a favor de Sol y decide la calidad sobre tu documento.
Qué significa «Default Fallback» en las puntuaciones de Opus 5.5
Los clasificadores de seguridad de Opus 5.5 pueden rechazar una petición, que entonces termina con stop_reason: "refusal". Si quien llama ha activado el fallback en el servidor (fallbacks: "default" con la cabecera beta server-side-fallback-2026-07-01), la API reintenta con otro modelo de Claude y cobra el intento a la tarifa de ese modelo (documentación de rechazos y fallback). Es decir: «Default Fallback» significa que parte del trabajo lo resolvió otro modelo de Claude después de un rechazo.
Esto afecta a la comparación de tres maneras:
- Una parte de la puntuación de Opus es de otro modelo. Por eso Artificial Analysis etiqueta sus filas y Vals publica la cifra alternativa del 65,05 %.
- La factura también cambia. Desde el 24 de septiembre de 2026, un rechazo antes de producir salida solo se cobra en las categorías
bio,frontier_llmyreasoning_extraction. - La frecuencia depende de tu trabajo. Anthropic deriva la mayoría de las tareas de ciberseguridad a Opus 4.8. Si trabajas en ese terreno, mira en el campo de modelo de tus respuestas cuántas contesta realmente Opus 5.5 antes de atribuirle el resultado.
Coste por resultado aceptado: cuándo compensa Opus con tu tasa de aciertos
El coste por tarea no basta si un modelo acierta más que el otro. Lo que paga tu equipo es el coste de cada resultado que da por bueno. Si un intento cuesta c, cada intento necesita una revisión que cuesta R y el resultado se acepta con probabilidad p:
coste por resultado aceptado = (c + R) / p
Opus 5.5 sale más barato que GPT-6.1 Sol solo cuando:
p de Opus / p de Sol > (c de Opus + R) / (c de Sol + R)
R y las tasas de aciertos salen de tu propia prueba; ninguna fuente los publica para tus tareas. Mientras no tengas tu c, sirven de ejemplo los costes por tarea de Artificial Analysis en medium (0,21 $ y 1,34 $).
Sin coste de revisión (R = 0). La proporción exigida es 1,34 / 0,21 ≈ 6,38. Aunque Opus acertara siempre, solo compensaría si Sol acertara menos del 15,7 % de las veces (1 / 6,38). En tareas que se validan solas, por ejemplo con tests automáticos, Sol gana casi siempre.
Con revisión humana. Supón 5 minutos de una persona a 60 $ la hora: R = 5 $ por intento. La proporción exigida baja a (1,34 + 5) / (0,21 + 5) = 6,34 / 5,21 ≈ 1,217. Si Sol acierta el 70 % de las veces, Opus tiene que superar el 85,2 % (70 × 1,217):
| Aciertos de Opus | Coste por resultado con Opus 5.5 | GPT-6.1 Sol al 70 % | Más barato |
|---|---|---|---|
| 90 % | 6,34 / 0,9 = 7,04 $ | 5,21 / 0,7 = 7,44 $ | Opus 5.5 |
| 80 % | 6,34 / 0,8 = 7,93 $ | 7,44 $ | GPT-6.1 Sol |
Cuanto más cara es la revisión, menos pesa la factura de tokens y más pesa acertar a la primera. La regla supone que se reintenta hasta aceptar y que revisar cuesta lo mismo en cada intento. Si un fallo de Sol se detecta en segundos y uno de Opus exige media hora de depuración, usa un R distinto para cada modelo. Con los modos rápidos, cambia c por el coste del modo (6 veces en Sol Ultrafast, 2 veces en Opus Fast) y la cuenta sigue valiendo.
Planes de 20 $: Sol en ChatGPT Plus y Opus 5.5 en Claude Pro
GPT-6.1 Sol está en ChatGPT Work y en Codex desde Plus (20 $). La página de precios de Codex estima para Plus entre 15 y 160 mensajes locales por ventana de 5 horas con GPT-6.1 Sol (entre 5 y 45 con GPT-6 Astra), según el tamaño de las tareas. Los planes Pro (100, 200 y 500 $) no tienen límite de cinco horas, y Ultrafast solo entra en Pro 500. Las suscripciones nuevas a Pro 200 incluyen una asignación menor que antes por el mismo precio; quien estaba suscrito entre el 22 de septiembre y el 29 de septiembre (10:00, hora del Pacífico) conserva la anterior hasta el 29 de octubre de 2026. OpenAI no dice cuánto se ha reducido.
Opus 5.5 está incluido en Claude Pro (20 $ al mes, 17 $ con pago anual) y Max (desde 100 $, con 5 o 20 veces el uso de Pro), y Claude Code entra en todos los planes de pago (precios de Claude). Anthropic no publica cuánto Opus 5.5 incluye cada plan. Max y Team incluyen ahora entre 100 y 200 $ al mes en créditos de API: Créditos de API de Claude Max y Team: cómo reclamarlos y usarlos.
Dos datos externos ayudan a situarse, sin resolver la comparación:
- SemiAnalysis estima que los planes de Claude dan unas 5 veces (en otro punto, unas 4) el valor de API equivalente que los de OpenAI con GPT-6.1 Sol, midiendo los contadores de uso con su propia mezcla de tareas de agentes. Como el valor se calcula a precio de API y los tokens de Opus cuestan el doble, eso no equivale a 5 veces más trabajo.
- Tibo Sottiaux, de OpenAI, anunció el 5 de octubre que la velocidad por defecto de GPT-6 Astra y GPT-6.1 Sol es alrededor de un 50 % más rápida a través de la suscripción. No dice nada de la API ni da tokens por segundo.
Sin una cifra oficial de uso de Opus 5.5, los dos planes de 20 $ no se pueden comparar con un número, y dividir la cuota entre los precios de la API no da una cantidad real. Si dudas, dedica una semana a cada uno con tu trabajo habitual antes de pagar un año.
Alternativas a Sol y Opus: Sonnet 5.5, GPT-6 Astra y Gemini 4 Argon
- Claude Sonnet 5.5 cuesta lo mismo que Sol (2/10 $; la lectura de caché bajó a 0,10 $ el 7 de octubre) y en Vals queda a la altura de Opus 5.5 (67,04 % frente a 66,97 %) por 21,34 $ por prueba.
- GPT-6 Astra (10/50 $) es el modelo más capaz de OpenAI; en Vals saca un 63,13 %. Su uso en planes se explica en Cómo usar GPT-6 Astra: en Plus va en Work y Codex, no en el Chat.
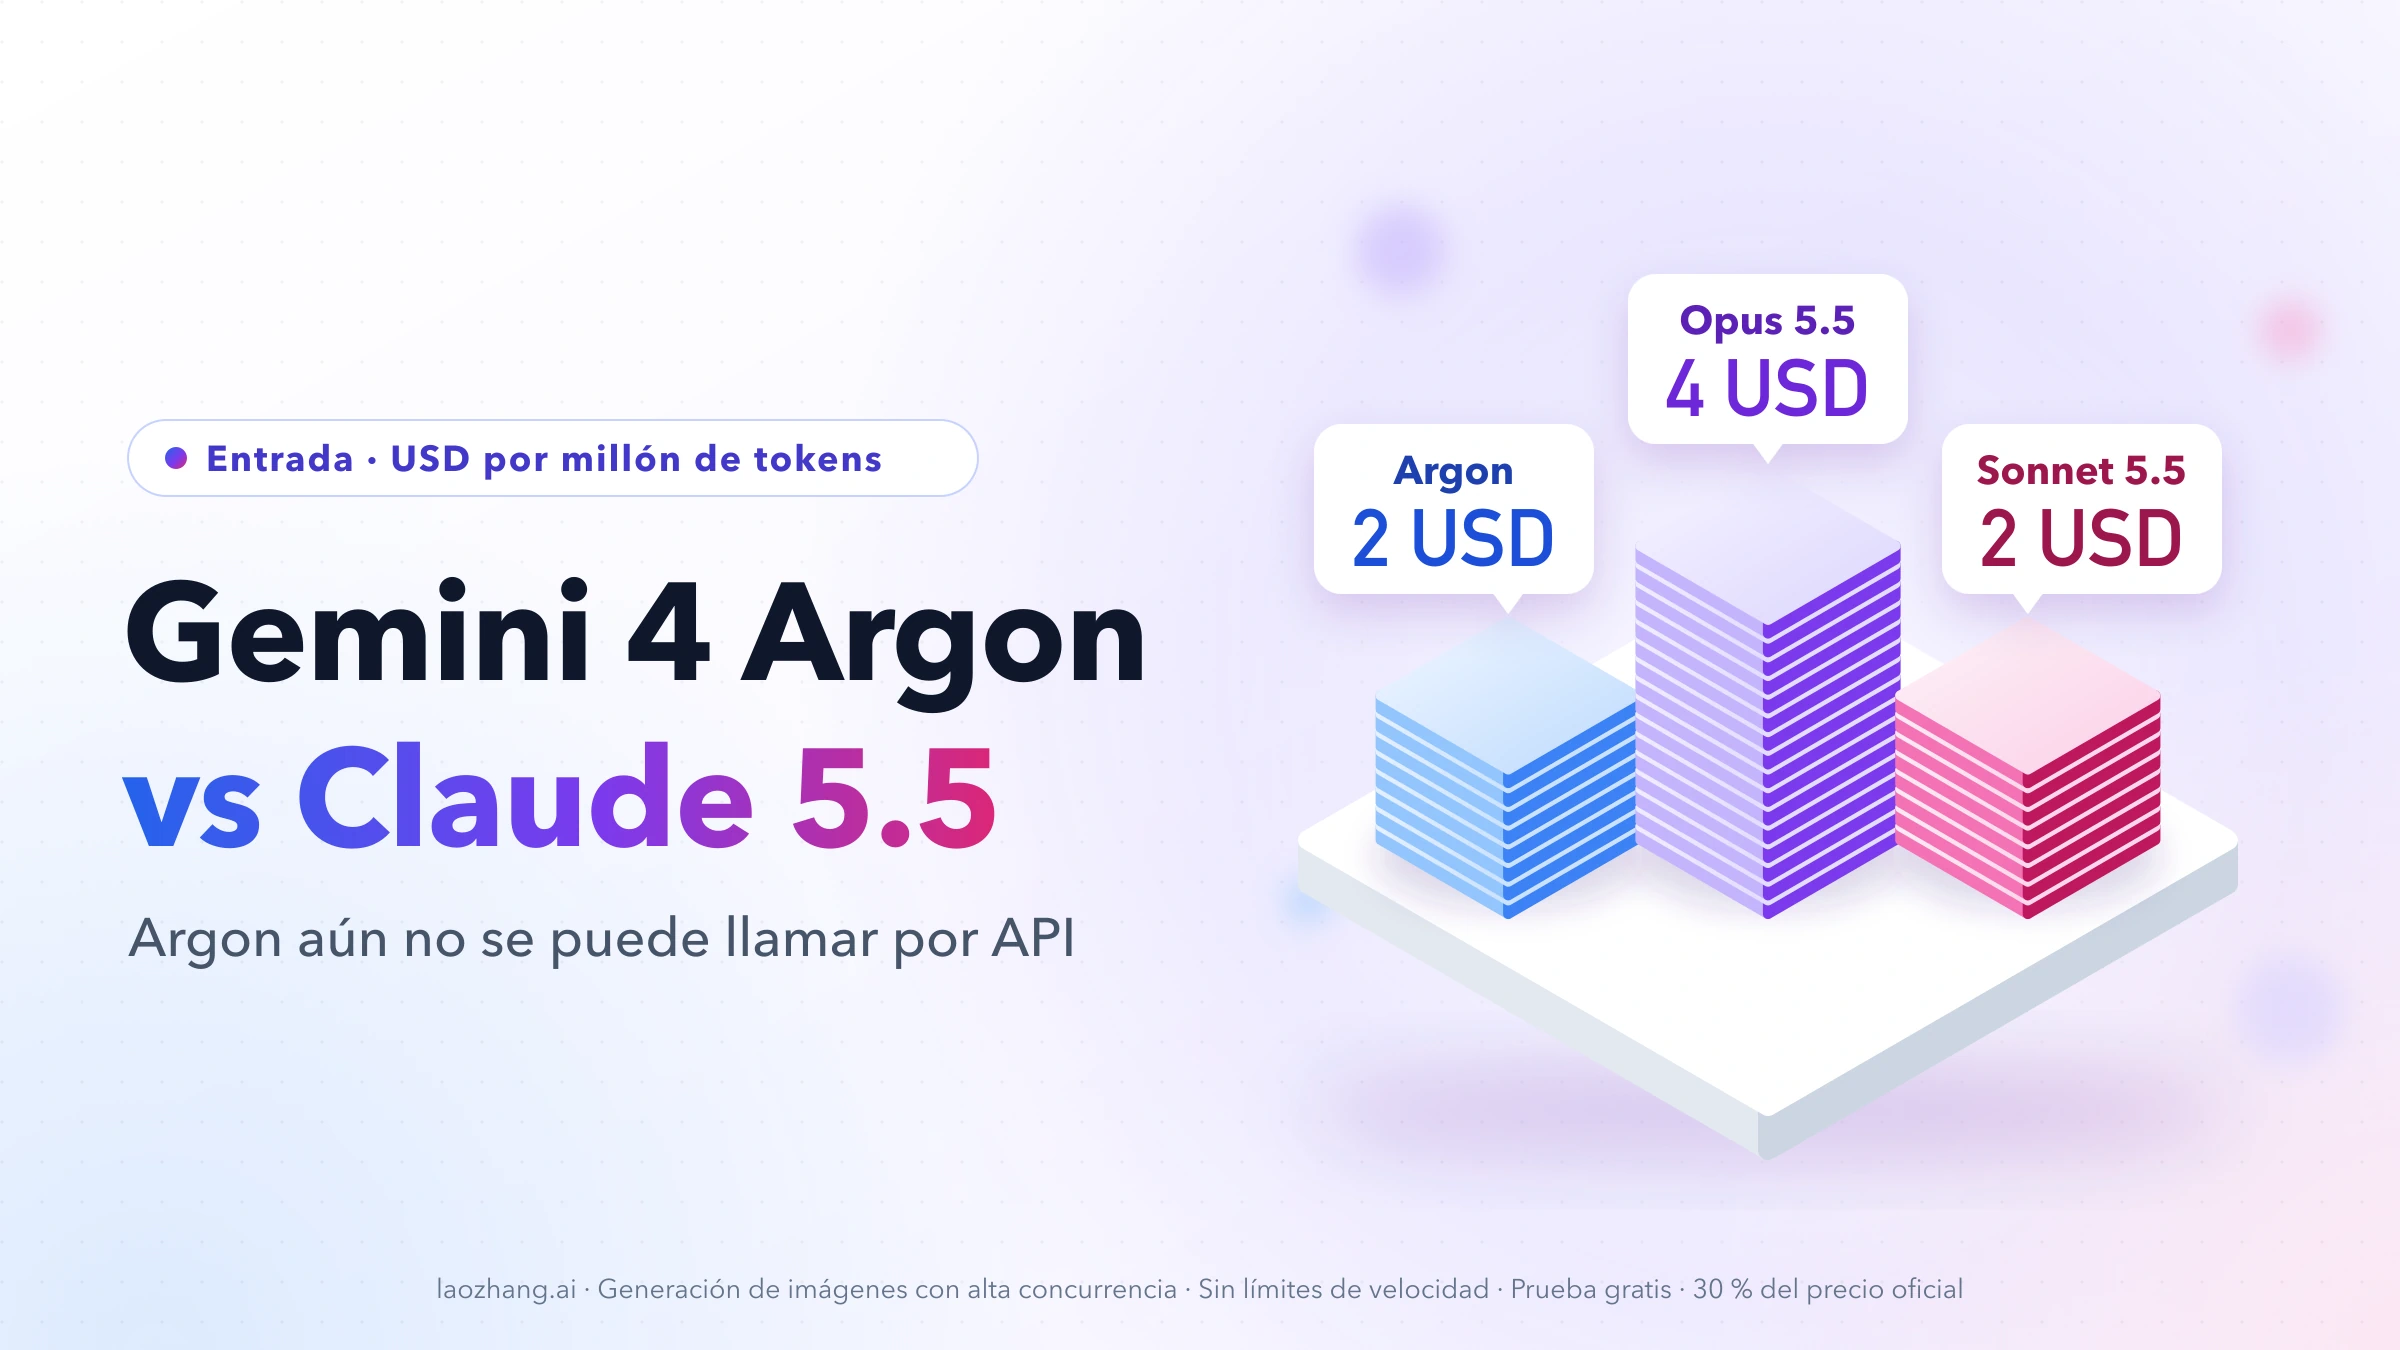
- Gemini 4 Argon encabeza el Vals Index (68,90 %) y está disponible de forma general en la API de pago de Gemini desde el 13 de octubre de 2026: 2 / 10 USD hasta el 30 de noviembre y 4 / 20 USD desde el 1 de diciembre, lo mismo que Opus 5.5. Acceso por plan y costes en Gemini 4 Argon vs Claude Opus 5.5 y Sonnet 5.5: cuál usar ahora.
- Para velocidad dentro de OpenAI, la opción es Sol Ultrafast, con el precio y el acceso descritos arriba.
Si migras de GPT-6 Sol a GPT-6.1 Sol o de OpenAI a Opus 5.5
De gpt-6-sol a gpt-6.1-sol. La tarifa es la misma, la lectura de caché baja a la mitad y el umbral de 272.000 tokens no cambia. Revisa dos cosas: gpt-6.1-sol no admite los niveles none ni minimal (usa low y vuelve a medir coste y latencia), y las llamadas a herramientas requieren la Responses API. Para situar a Sol dentro de su familia, consulta GPT-6 Luna vs Sol: precio, coste por tarea y cuál elegir.
De OpenAI a claude-opus-5-5. Según las novedades de Opus 5.5, estas peticiones devuelven un error 400 o cambian de forma:
- El razonamiento no se puede desactivar:
thinking: {"type": "disabled"}o un presupuesto manual dan error; el control es el nivel de effort. tool_choicesolo aceptaautoynone;anyo una herramienta concreta dan error.- El texto entre llamadas a herramientas llega en bloques de razonamiento, vacíos con la configuración de visualización por defecto.
- En la Claude API y Google Cloud, la herramienta antigua
computer_20251124ya no se acepta.
El resto está en Claude Opus 5.5: precio, disponibilidad y qué falla al migrar. Si vienes del Sol anterior, la comparación a igual tarifa es Claude Opus 5.5 vs GPT-5.6 Sol: misma tarifa, distinto coste real.
Preguntas frecuentes sobre GPT-6.1 Sol y Opus 5.5
¿Es GPT-6.1 Sol mejor que Claude Opus 5.5?
En calidad, no por encima del nivel low: en Artificial Analysis empatan en low (42) y Opus saca de 3 a 6 puntos más desde medium hasta max; en Vals, 5,82 puntos más (3,90 si se descuentan las tareas resueltas por el modelo de respaldo). En coste, Sol gana con claridad: cada tarea cuesta entre 4,2 y 8,9 veces menos. En los benchmarks que publica OpenAI, Sol queda por delante en niveles medios.
¿Cuánto cuesta GPT-6.1 Sol Ultrafast y quién puede usarlo?
Desde el 8 de octubre de 2026 cuesta 12 $ por millón de tokens de entrada, 0,60 $ de lectura de caché, 15 $ de escritura en caché y 60 $ de salida en peticiones de hasta 272.000 tokens de entrada; por encima, 24 / 1,20 / 30 / 90 $. En la API está abierto a todas las cuentas con límites propios. En Codex y ChatGPT Work solo lo tienen Pro de 500 $ y los Enterprise/Edu que cumplan los requisitos.
¿El precio de GPT-6.1 Sol es promocional?
No. La página de precios de OpenAI no lo marca como promocional; la nota de precio promocional «al menos hasta el 21 de noviembre de 2026» se refiere a GPT-5.6 Sol. Aun así, ningún proveedor garantiza cuánto tiempo se mantendrán las tarifas actuales.
¿Existe GPT-6.1 Astra o GPT-6.1 Luna?
No. La versión 6.1 solo existe como GPT-6.1 Sol (gpt-6.1-sol). GPT-6 Astra y GPT-6 Luna siguen en la versión 6, y Astra continúa siendo el modelo más capaz de OpenAI, a 5 veces el precio por token de Sol.
¿Puedo usar GPT-6.1 Sol en el chat normal de ChatGPT?
No. GPT-6.1 Sol está en ChatGPT Work y en Codex para Plus, Pro, Business, Enterprise y Edu, no en la pestaña Chat. El modelo del Chat desde el 7 de octubre es GPT-6 Sol en los planes de pago y GPT-6 Luna en Free y Go.