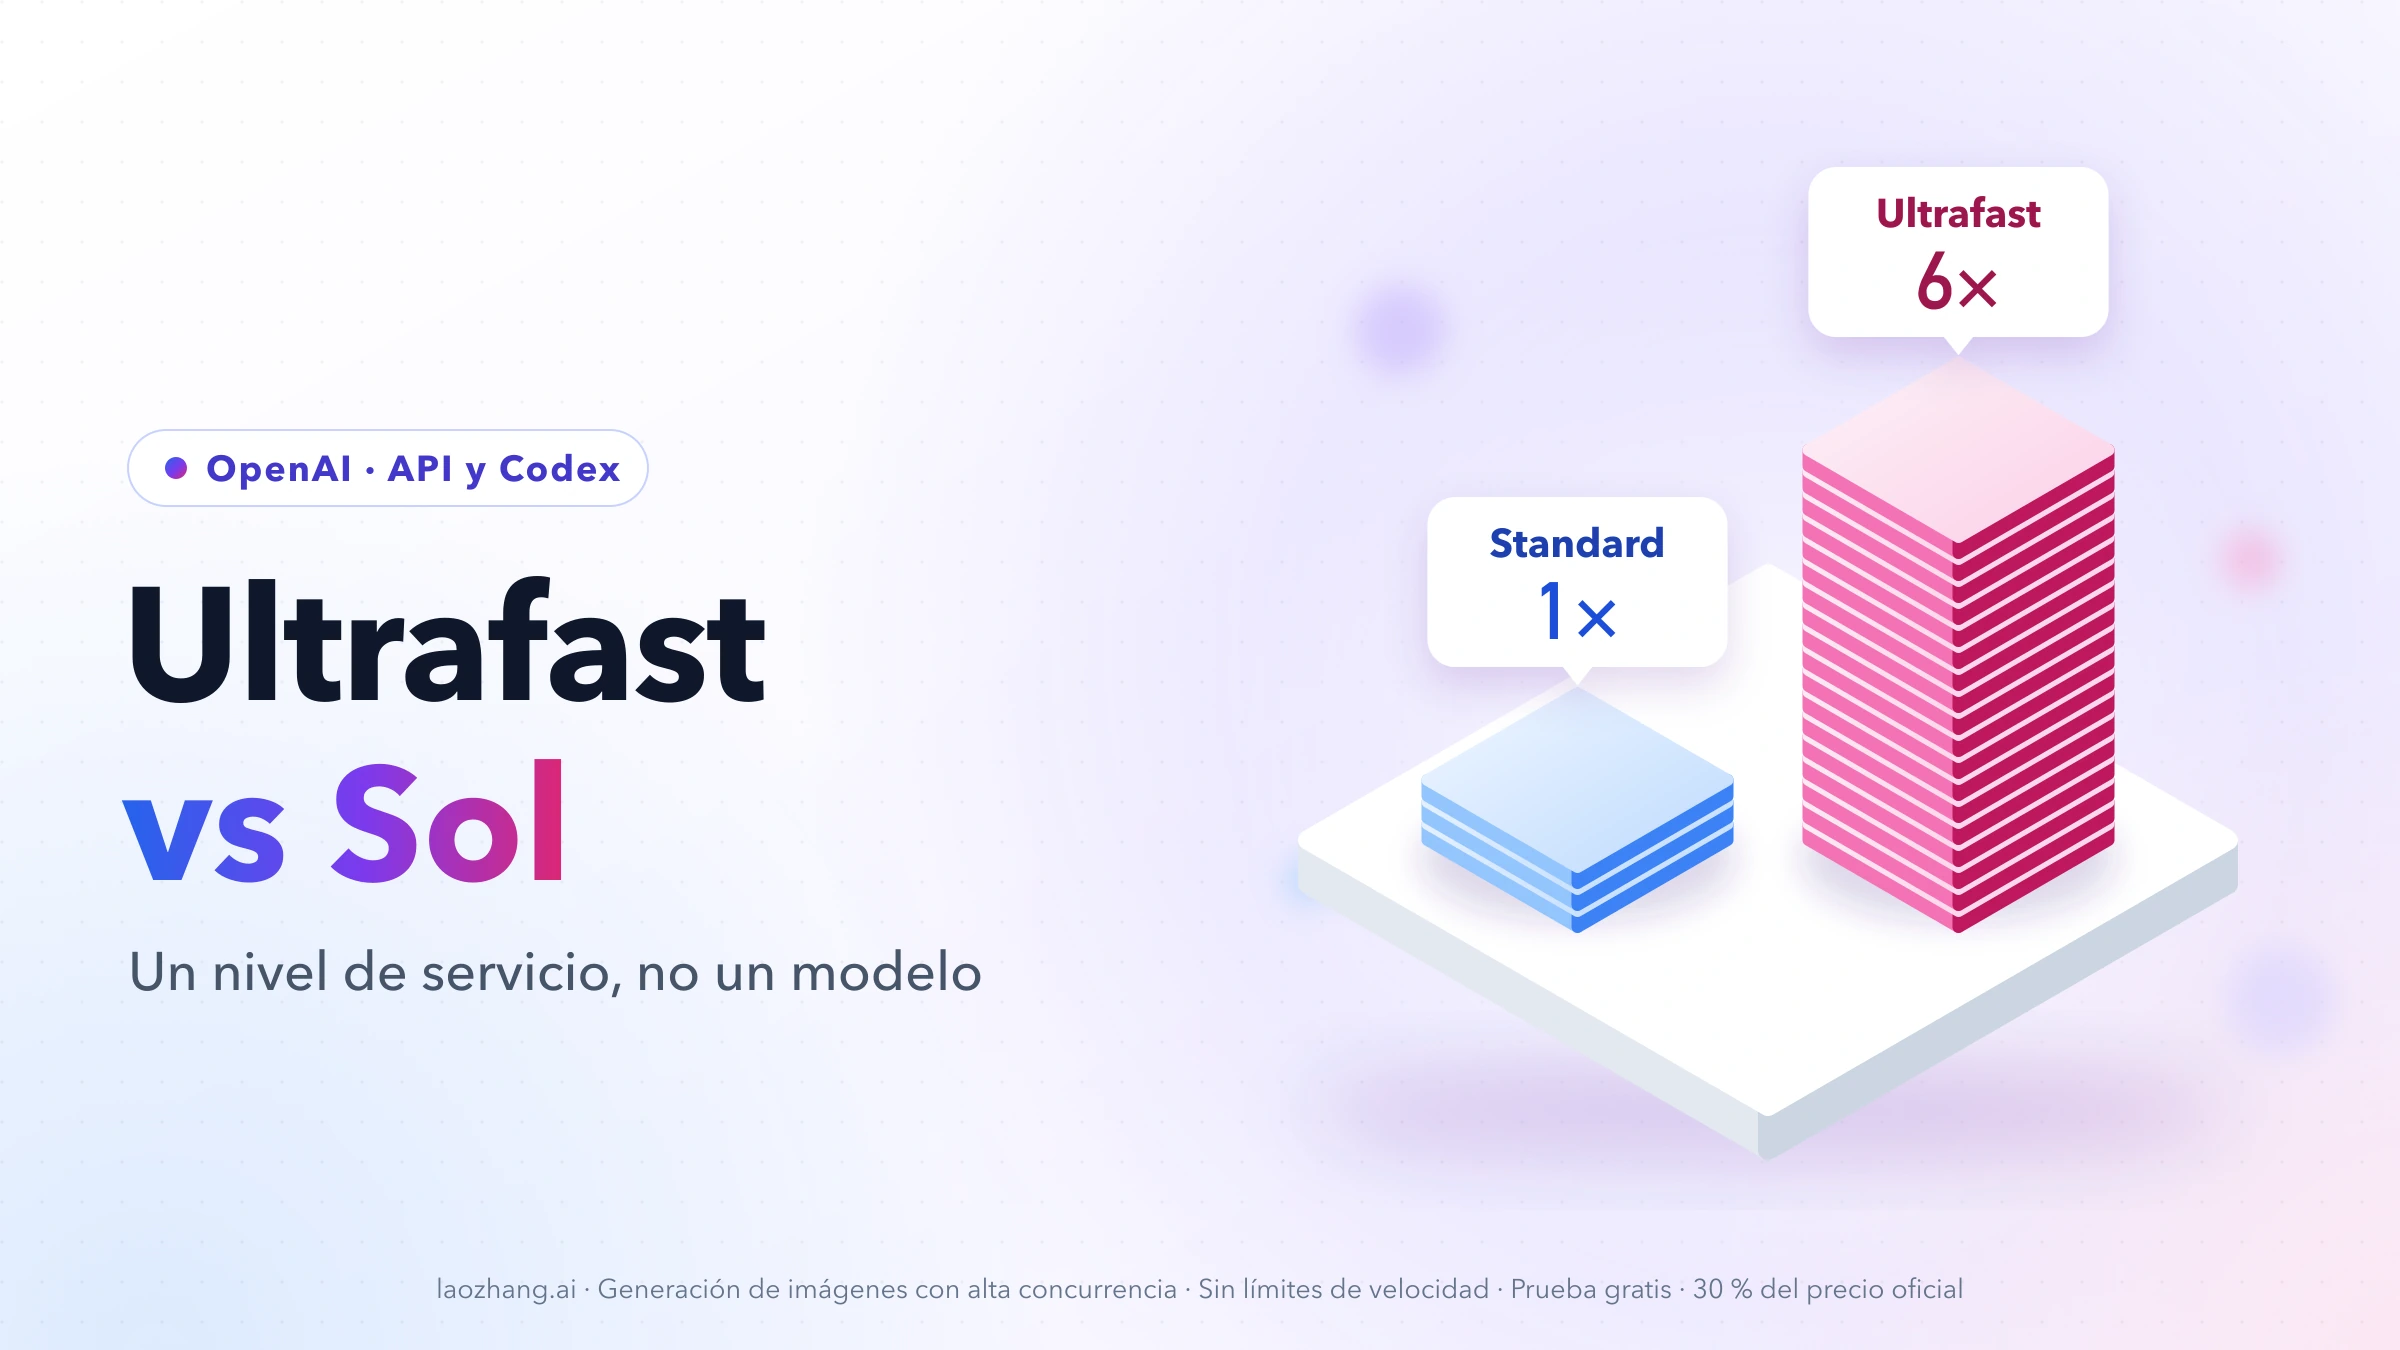
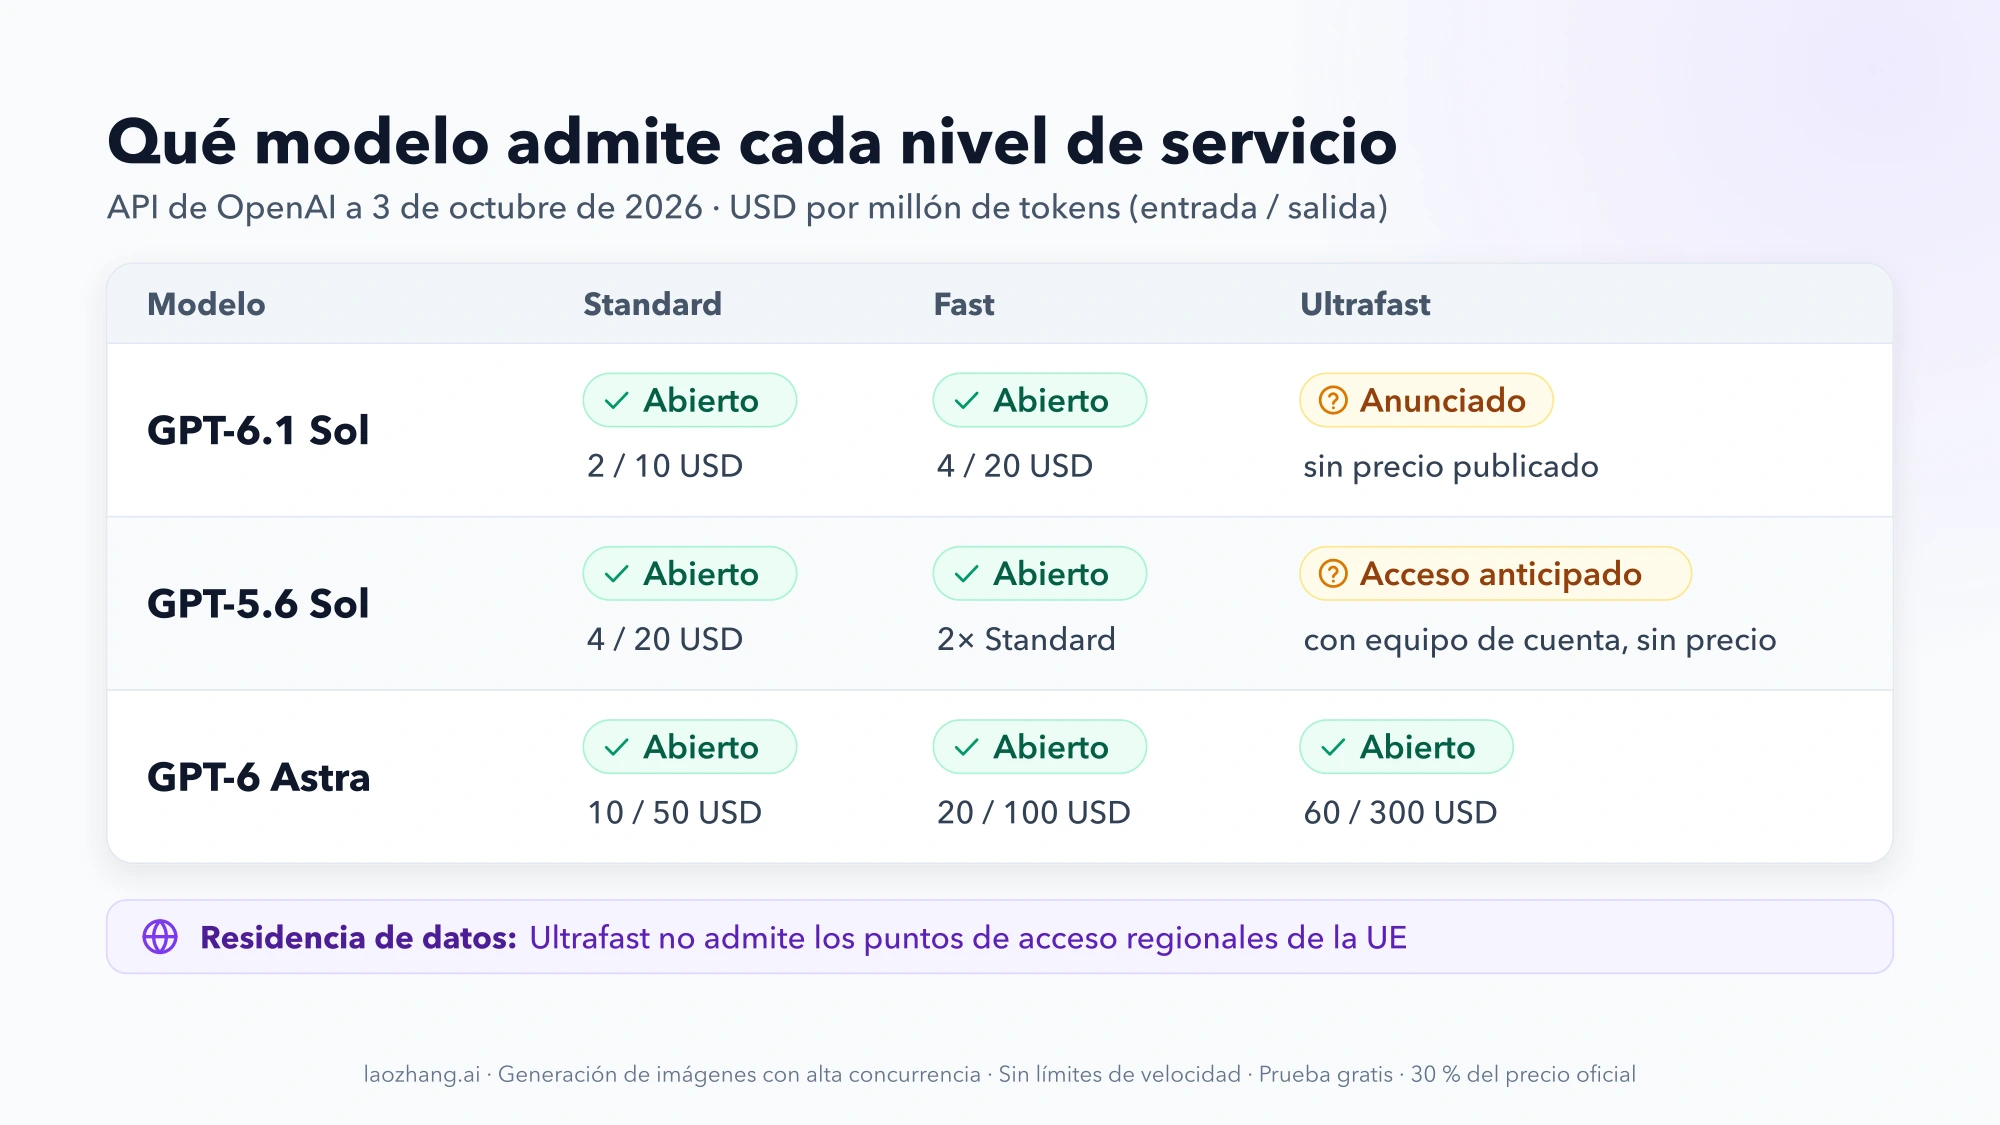
Ultrafast y Sol no son dos opciones del mismo tipo: Ultrafast es un nivel de servicio (el valor ultrafast del parámetro service_tier) y Sol es una familia de modelos. La pregunta útil es qué modelo puedes ejecutar en ese nivel. A 3 de octubre de 2026, la guía de Ultrafast de la API lo abre a todos los usuarios solo para GPT-6 Astra; GPT-5.6 Sol tiene acceso anticipado que se pide al equipo de cuenta de OpenAI, y GPT-6.1 Sol Ultrafast está anunciado, pero no figura ni en esa guía ni en la tabla de precios.
| Lo que quieres | Lo que hay a 3 de octubre de 2026 | Precio de lista en la API (entrada / salida por millón de tokens) |
|---|---|---|
| GPT-6.1 Sol al menor coste | Nivel Standard, abierto a cualquier cuenta | 2 / 10 USD |
| GPT-6.1 Sol con respuesta más rápida | Nivel Fast | 4 / 20 USD |
| La máxima velocidad que OpenAI vende hoy | GPT-6 Astra en Ultrafast | 60 / 300 USD |
| GPT-6.1 Sol en Ultrafast | Anunciado el 29 de septiembre; sin fila en la tabla de precios | Sin precio publicado |
| GPT-5.6 Sol en Ultrafast | Acceso anticipado a través del equipo de cuenta | Sin precio publicado |
Las tarifas son las de la página de precios de OpenAI para peticiones de hasta 272.000 tokens de entrada. La disponibilidad de Ultrafast para Sol puede cambiar en cuestión de días, así que la fecha forma parte de la respuesta.
Diferencias entre Ultrafast y Sol: nivel de servicio frente a modelo
Ultrafast decide con qué prioridad e infraestructura se sirve tu petición; Sol decide qué modelo la responde. Son dos campos distintos de la misma llamada: model y service_tier. OpenAI define Ultrafast como el nivel de servicio más rápido de su API, por encima de Standard y de Fast (el antiguo «Priority processing», rebautizado el 30 de julio de 2026). La página de OpenAI en español lo llama «modo Ultrarrápido»; es lo mismo, y en el código el valor sigue siendo ultrafast.
Sol es la gama que la tabla de precios sitúa entre GPT-6 Luna y GPT-6 Astra, y a 3 de octubre conviven tres versiones con situaciones distintas:
| Modelo | Tarifa Standard (entrada / salida) | Niveles documentados | Situación en Ultrafast |
|---|---|---|---|
gpt-6.1-sol | 2 / 10 USD | Standard y Fast | Anunciado, sin precio ni documentación |
gpt-6-sol | 2 / 10 USD (según VentureBeat) | Standard y Fast | No aparece |
gpt-5.6-sol | 4 / 20 USD (precio promocional al menos hasta el 21 de noviembre de 2026) | Standard y Fast | Acceso anticipado con equipo de cuenta |
gpt-6-astra | 10 / 50 USD | Standard, Fast y Ultrafast | Abierto a todos los usuarios de la API |
La confusión viene de dos anuncios distintos. El 13 de agosto de 2026 OpenAI presentó Ultrafast como un nivel que ejecuta GPT-5.6 Sol hasta 14 veces más rápido que el procesamiento estándar, con hasta 750 tokens de salida por segundo sobre hardware de Cerebras, y solo para clientes seleccionados. El 29 de septiembre, junto con el lanzamiento de GPT-6.1 Sol, anunció GPT-6 Astra Ultrafast y GPT-6.1 Sol Ultrafast. De ahí que ambos nombres aparezcan juntos y parezcan rivales: en realidad uno se aplica sobre el otro.
Si lo que comparas es Sol con modelos de otros proveedores, o con el resto de la gama, el precio por tarea se analiza aparte en GPT-6.1 Sol vs Opus 5.5: comparativa de precio y coste por tarea y en GPT-6 Luna vs Sol: precio, coste por tarea y cuál elegir, este último anterior a la versión 6.1.
¿Se puede usar ya GPT-6.1 Sol Ultrafast? Anunciado, aún sin precio
A 3 de octubre de 2026, no como opción documentada: OpenAI lo ha anunciado, pero ninguna de sus páginas técnicas lo ofrece para llamadas ni le pone tarifa. Las fuentes no dicen lo mismo, y conviene saber cuál dice qué:
- El anuncio del 29 de septiembre presenta GPT-6 Astra Ultrafast y GPT-6.1 Sol Ultrafast a la vez, disponibles mediante la API y para el nuevo plan Pro de 500 USD al mes en ChatGPT Work y Codex. Añade que, con GPT-6.1 Sol Ultrafast, el coste en la API será aproximadamente el que antes tenía GPT-6 Astra. No da precio, velocidad en tokens por segundo ni fecha.
- VentureBeat, en su crónica del DevDay, escribe que Ultrafast está disponible de inmediato para GPT-6 Astra y que la versión para GPT-6.1 Sol llegará «en los próximos días».
- La guía de Ultrafast solo nombra GPT-6 Astra y el acceso anticipado de GPT-5.6 Sol.
- La pestaña Ultrafast de la tabla de precios contiene una única fila:
gpt-6-astra. - La página Speed de Codex indica que GPT-6.1 Sol admite Standard y Fast.
Lo que se sostiene con todo ello es un estado intermedio: anunciado y esperado, todavía no listado. El resultado de enviar service_tier: "ultrafast" con un modelo Sol desde una cuenta sin acceso anticipado no está descrito en la documentación.
Para saber si ha cambiado cuando leas esto, bastan tres comprobaciones de un minuto:
- Abre la página de precios, pulsa la pestaña Ultrafast y mira si hay una fila
gpt-6.1-sol. - Lee el primer párrafo de la guía de Ultrafast: ahí se enumeran los modelos abiertos a todos.
- En la página Speed de Codex, busca el apartado de modelos compatibles y comprueba qué niveles figuran para GPT-6.1 Sol.
Si tu organización trabaja con un equipo de cuenta de OpenAI, ese es el único canal documentado para pedir hoy un Sol en Ultrafast, y se trata de GPT-5.6 Sol, no de la versión 6.1.
Precio de Ultrafast en la API: 60/300 USD por millón con GPT-6 Astra
El único precio de Ultrafast publicado es el de GPT-6 Astra: 60 USD por millón de tokens de entrada y 300 USD por millón de salida, seis veces su tarifa Standard. Fast cuesta el doble que Standard en ambos modelos.
| Modelo y nivel | Entrada | Entrada en caché | Escritura en caché | Salida |
|---|---|---|---|---|
| GPT-6.1 Sol · Standard | 2,00 | 0,10 | 2,50 | 10,00 |
| GPT-6.1 Sol · Fast | 4,00 | 0,20 | 5,00 | 20,00 |
| GPT-5.6 Sol · Standard | 4,00 | 0,40 | 5,00 | 20,00 |
| GPT-6 Astra · Standard | 10,00 | 1,00 | 12,50 | 50,00 |
| GPT-6 Astra · Fast | 20,00 | 2,00 | 25,00 | 100,00 |
| GPT-6 Astra · Ultrafast | 60,00 | 6,00 | 75,00 | 300,00 |
USD por millón de tokens, peticiones de hasta 272.000 tokens de entrada, según la página de precios de OpenAI a 3 de octubre de 2026. Por encima de ese umbral se aplica otro tramo: GPT-6.1 Sol Standard pasa a 4 / 0,20 / 5 / 15 USD y GPT-6 Astra Ultrafast a 120 / 12 / 150 / 450 USD.
Para GPT-6.1 Sol Ultrafast circula la cifra de 12 USD de entrada, 0,60 USD de entrada en caché y 60 USD de salida. No es una tarifa de OpenAI: es el cálculo de VentureBeat, que el propio medio presenta como derivado, de aplicar el multiplicador 6× a la tarifa Standard de GPT-6.1 Sol. Encaja con la frase del anuncio (un coste parecido al de GPT-6 Astra, que está en 10 / 50 USD), pero hasta que haya una fila en la tabla sigue siendo una estimación.
Cuánto cuesta la misma petición: de 0,22 USD a 7,20 USD
Una petición idéntica cuesta 0,22 USD con GPT-6.1 Sol en Standard y 7,20 USD con GPT-6 Astra en Ultrafast, unas 33 veces más. El ejemplo es una llamada de agente con contexto reutilizado: 50.000 tokens de entrada sin caché, 200.000 tokens de entrada en caché y 10.000 tokens de salida. Suman 250.000 tokens de entrada, dentro del tramo de 272.000, y se dejan fuera los cargos por escritura en caché.
La fórmula es la misma en todas las filas, con los tokens expresados en millones:
coste = 0,05 × precio de entrada + 0,2 × precio de entrada en caché + 0,01 × precio de salida
| Modelo y nivel | Operación | Coste de la petición |
|---|---|---|
| GPT-6.1 Sol · Standard | 0,05 × 2 + 0,2 × 0,10 + 0,01 × 10 | 0,22 USD |
| GPT-6.1 Sol · Fast | 0,05 × 4 + 0,2 × 0,20 + 0,01 × 20 | 0,44 USD |
| GPT-5.6 Sol · Standard | 0,05 × 4 + 0,2 × 0,40 + 0,01 × 20 | 0,48 USD |
| GPT-6 Astra · Standard | 0,05 × 10 + 0,2 × 1 + 0,01 × 50 | 1,20 USD |
| GPT-6 Astra · Fast | 0,05 × 20 + 0,2 × 2 + 0,01 × 100 | 2,40 USD |
| GPT-6 Astra · Ultrafast | 0,05 × 60 + 0,2 × 6 + 0,01 × 300 | 7,20 USD |
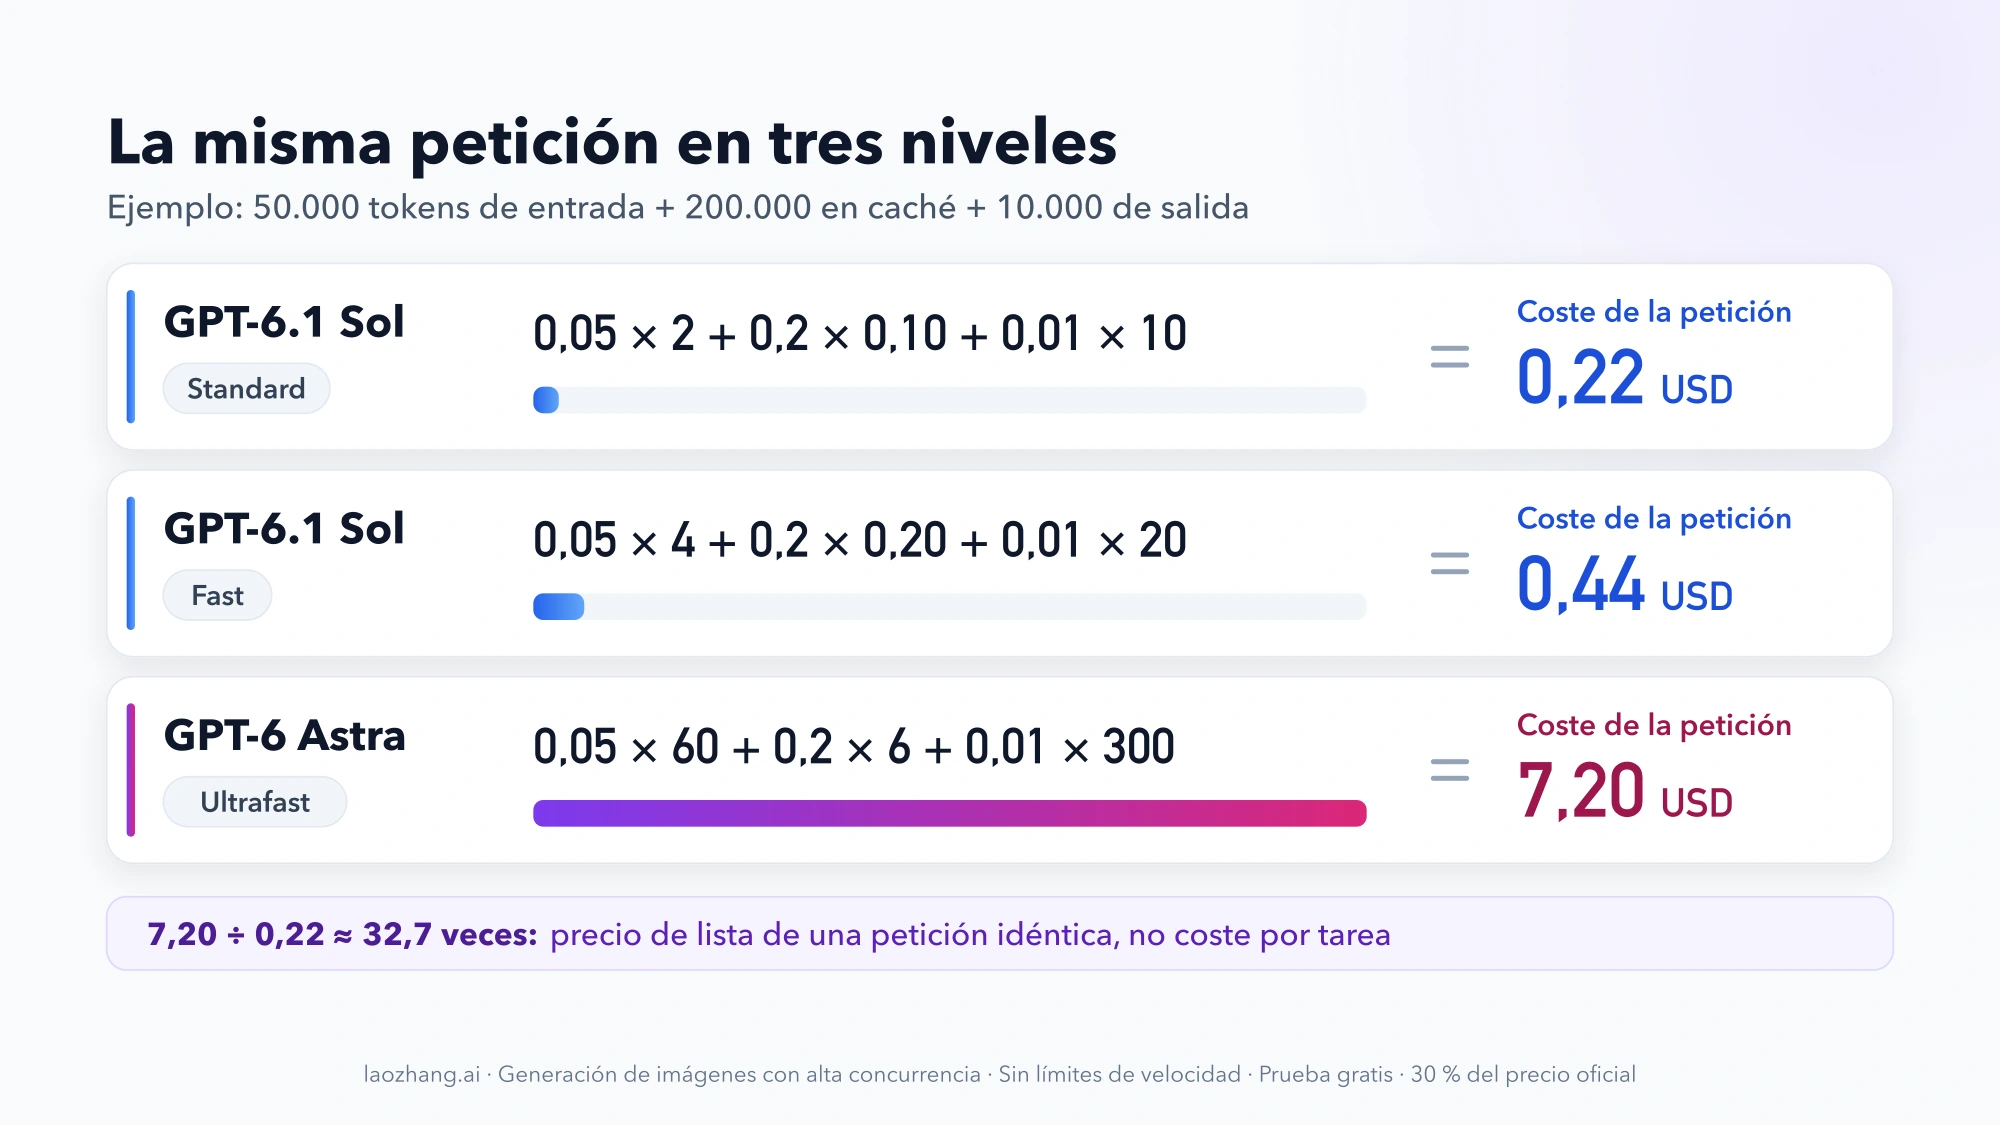
De ahí salen dos proporciones: 7,20 ÷ 0,22 ≈ 32,7 frente a Sol en Standard, y 7,20 ÷ 0,44 ≈ 16,4 frente a Sol en Fast. Si GPT-6.1 Sol Ultrafast acabara costando 6× su tarifa Standard, que es la hipótesis sin confirmar, la misma petición saldría por 6 × 0,22 = 1,32 USD: algo más que Astra en Standard y menos de la quinta parte de Astra en Ultrafast.
Dos límites del cálculo. Compara el precio de lista de una petición con los mismos tokens, no el coste de terminar una tarea: cada modelo consume una cantidad distinta de tokens para el mismo trabajo. Y el reparto entre caché y entrada nueva pesa mucho; con tu propia proporción, sustituye los tres coeficientes y repite la operación.
Qué mide «hasta 8 veces más rápido» y qué tiempo deja fuera
Las cifras de velocidad de Ultrafast son máximos de generación de tokens de salida, no el tiempo que tarda tu tarea completa. La documentación de Codex lo dice expresamente: GPT-6 Astra Ultrafast genera tokens hasta 8 veces más rápido que GPT-6 Astra en Standard, y esa comparación mide velocidad de generación, no tarifas ni tiempo total de la tarea.
Las cifras que circulan tienen orígenes distintos:
| Cifra | A qué se refiere | Origen |
|---|---|---|
| Hasta 14 veces, hasta 750 tokens/s | GPT-5.6 Sol en Ultrafast frente a Standard | Anuncio de OpenAI del 13 de agosto |
| Hasta 8 veces | GPT-6 Astra Ultrafast frente a Astra Standard en Codex | Documentación de Codex y anuncio del 29 de septiembre |
| 6 veces en la API, hasta 300 tokens/s | Ultrafast de la familia GPT-6 | Crónica de VentureBeat sobre el DevDay; no figura en las páginas de OpenAI |
OpenAI no publica la velocidad en Standard de GPT-6 Astra ni de GPT-6.1 Sol, de modo que no hay una base oficial contra la que convertir «hasta 8 veces» en segundos. Como orden de magnitud, y solo como ilustración: 10.000 tokens de salida a 300 tokens por segundo son unos 33 segundos de generación; a una sexta parte de ese ritmo, 50 tokens por segundo (una base deducida de la cifra de VentureBeat, no publicada), serían unos 200 segundos.
El tiempo de red, la ejecución de herramientas y el procesamiento de la entrada quedan fuera del multiplicador. En un agente que encadena muchas llamadas cortas esa parte puede dominar, y por eso OpenAI recomienda una conexión WebSocket persistente: sin ella, advierte la guía, la sobrecarga de red puede reducir la ganancia de latencia. Todas las cifras anteriores son del proveedor o de prensa; ninguna procede de una medición independiente de Ultrafast con la familia GPT-6.
Ultrafast en Codex y ChatGPT Work: plan Pro de 500 USD y solo Astra
En Codex y ChatGPT Work, Ultrafast exige el plan Pro de 500 USD al mes o un plan Enterprise o Edu que cumpla los requisitos, y el modelo que lo usa es GPT-6 Astra. Según la página Speed, el resto de planes de autoservicio no tiene acceso a Ultrafast en el lanzamiento, ni siquiera comprando créditos; los planes Pro de 100 y 200 USD quedan fuera.
GPT-6.1 Sol está disponible en ChatGPT Work y Codex para Plus, Pro, Business, Enterprise y Edu, pero en Standard y Fast. Una opción GPT-6.1 Sol Ultrafast dentro de Codex no figura en su documentación a 3 de octubre, y la cifra de «hasta 8 veces» que esta publica se refiere a Astra.
El consumo de la cuota también se multiplica, y no por el mismo factor que en la API:
| Nivel en Codex | Uso incluido en la suscripción | Créditos comprados y pago por uso de Enterprise |
|---|---|---|
| Fast | 2,5× la tasa Standard | 2× |
| Ultrafast (GPT-6 Astra) | 8× la tasa Standard | 6× |
En el plan Pro de 500 USD, Ultrafast gasta primero el uso incluido y después los créditos disponibles. En Enterprise viene desactivado por defecto y no está disponible para espacios de trabajo que exigen residencia de inferencia fuera de Estados Unidos. Las tasas Standard de partida, según la página de precios de Codex, son de 250 / 25 / 1.250 créditos por millón de tokens (entrada / entrada en caché / salida) para GPT-6 Astra y de 50 / 2,5 / 250 para GPT-6.1 Sol. Si usas Codex con una clave de API, se aplican las tarifas por token de la API y no estos multiplicadores de créditos.
Fast sí está al alcance de Sol en Codex. Se alterna con /fast en la CLI o se deja fijo en config.toml:
service_tier = "fast"

[features]
fast_mode = true
Cómo activar Ultrafast en la API: service_tier, límites y residencia
En la API basta con enviar service_tier: "ultrafast" con el modelo gpt-6-astra en la Responses API. Es el único par que documenta la guía:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-astra",
    "input": "Explica en una frase por qué el cielo es azul.",
    "service_tier": "ultrafast"
  }'
HTTP funciona, pero para agentes con muchas llamadas a herramientas seguidas OpenAI recomienda WebSocket: se abre la conexión con client.responses.connect(), se envía cada turno con connection.response.create(...) y se reutiliza la misma conexión, pasando el identificador de la respuesta anterior en previous_response_id.
Antes de contar con Ultrafast en producción, revisa tres condiciones:
- Límites por defecto. Con GPT-6 Astra, 500.000 tokens por minuto en los niveles de uso 1 a 3 de la API, 1.000.000 en el nivel 4 y 5.000.000 en el nivel 5. La guía los describe como límites bajos; ampliarlos pasa por el equipo de cuenta.
- Residencia de datos. Ultrafast admite residencia de datos en Estados Unidos y procesamiento global, y no los puntos de acceso regionales de la UE ni de otras regiones. Si tu contrato o tu política interna exigen procesamiento en la UE, Ultrafast queda descartado hoy, con cualquier modelo.
- Qué nivel te ha servido. El blog de la pasarela OrcaRouter sostiene que la respuesta devuelve en
service_tierel nivel que realmente la atendió. Es una afirmación de un tercero anterior al DevDay, sin respaldo en la guía; aun así, registrar ese campo en tus pruebas no cuesta nada y te evita dar por hecho un nivel que no se aplicó.
Qué elegir ahora: Sol en Fast, Astra en Ultrafast o esperar
Con lo publicado a 3 de octubre de 2026, la elección depende de si lo que te importa es el modelo, la latencia o el presupuesto:
| Tu situación | Combinación | Por qué |
|---|---|---|
| Procesos por lotes, evaluación, trabajo en segundo plano | GPT-6.1 Sol en Standard | Nadie espera la respuesta; 0,22 USD en la petición del ejemplo |
| Uso interactivo con Sol y la latencia molesta | GPT-6.1 Sol en Fast | Es el nivel rápido que Sol tiene hoy, al doble de precio (0,44 USD) |
| Cada segundo de espera cuesta dinero o clientes: voz, atención en directo, respuesta a incidentes | GPT-6 Astra en Ultrafast | Único par abierto a todos; 7,20 USD en la misma petición |
| Necesitas procesamiento en la UE | Standard o Fast | Ultrafast no admite puntos de acceso regionales fuera de Estados Unidos |
| Quieres velocidad de Ultrafast a precio cercano al de Astra Standard | Esperar a GPT-6.1 Sol Ultrafast | Anunciado; la estimación de 1,32 USD por la misma petición no es una tarifa |
| Ya trabajas con GPT-5.6 Sol y tienes equipo de cuenta | Pedir el acceso anticipado | Sin precio público: pídelo por escrito antes de planificar |
Sobre Fast hay un matiz: OpenAI no publica cuánto acelera a la familia GPT-6. La única cifra documentada es 1,5 veces para GPT-5.6 y GPT-5.5 en Codex, así que el beneficio con GPT-6.1 Sol tendrás que medirlo en tu propia carga.
El sobreprecio de Ultrafast compensa cuando el tiempo de generación es la parte dominante de la espera y esa espera tiene un coste claro. Con las cifras ilustrativas de antes, pasar de Astra Standard a Astra Ultrafast añade 6,00 USD a la petición del ejemplo (7,20 − 1,20) para recortar, como máximo, unos 167 segundos de generación (200 − 33). En una conversación de voz o en una incidencia abierta esa cuenta puede salir; en una tarea nocturna, no.
Esperar tiene sentido si tu caso encaja con Sol y no con Astra: el anuncio promete inteligencia cercana a la de Astra a un coste parecido al que Astra tenía en Standard, pero con la velocidad de Ultrafast. Mientras tanto, lo razonable es dejar el nivel como un parámetro de configuración y no fijarlo en el código, de forma que cambiar de fast a ultrafast sea editar una línea el día que aparezca la fila en la tabla de precios.
Dudas rápidas sobre Ultrafast, Fast y Sol
¿Ultrafast es un modelo nuevo de OpenAI?
No. Es un nivel de servicio de la API y de Codex que sirve un modelo existente a mayor velocidad. El modelo se elige en model; el nivel, en service_tier. «GPT-6 Astra Ultrafast» significa GPT-6 Astra servido en ese nivel.
¿En qué se diferencia Ultrafast del modo Fast?
Son dos niveles distintos. Fast cuesta 2× la tarifa Standard en la API y admite GPT-6.1 Sol además de GPT-6 Astra. Ultrafast cuesta 6× y, a 3 de octubre de 2026, solo tiene precio para GPT-6 Astra. En Codex, Fast consume el uso incluido a 2,5× y Ultrafast a 8×.
¿Cuánto costará GPT-6.1 Sol Ultrafast?
OpenAI no ha publicado el precio. Su anuncio habla de un coste aproximadamente igual al que antes tenía GPT-6 Astra (10 / 50 USD por millón de tokens de entrada y salida), y VentureBeat calcula 12 / 60 USD si se aplica el multiplicador 6×. Ninguna de las dos cosas es una tarifa.
¿Qué plan de Codex hace falta para usar Ultrafast?
El plan Pro de 500 USD al mes, o un plan Enterprise o Edu que cumpla los requisitos. Los demás planes de autoservicio, como Plus o los Pro de 100 y 200 USD, no tienen Ultrafast en el lanzamiento, aunque compres créditos. Y el modelo disponible en ese nivel es GPT-6 Astra.
¿Puedo usar Ultrafast con residencia de datos en la UE?
No. La guía de la API limita Ultrafast a residencia de datos en Estados Unidos y procesamiento global, y en Enterprise no está disponible para espacios de trabajo que exigen inferencia fuera de Estados Unidos.