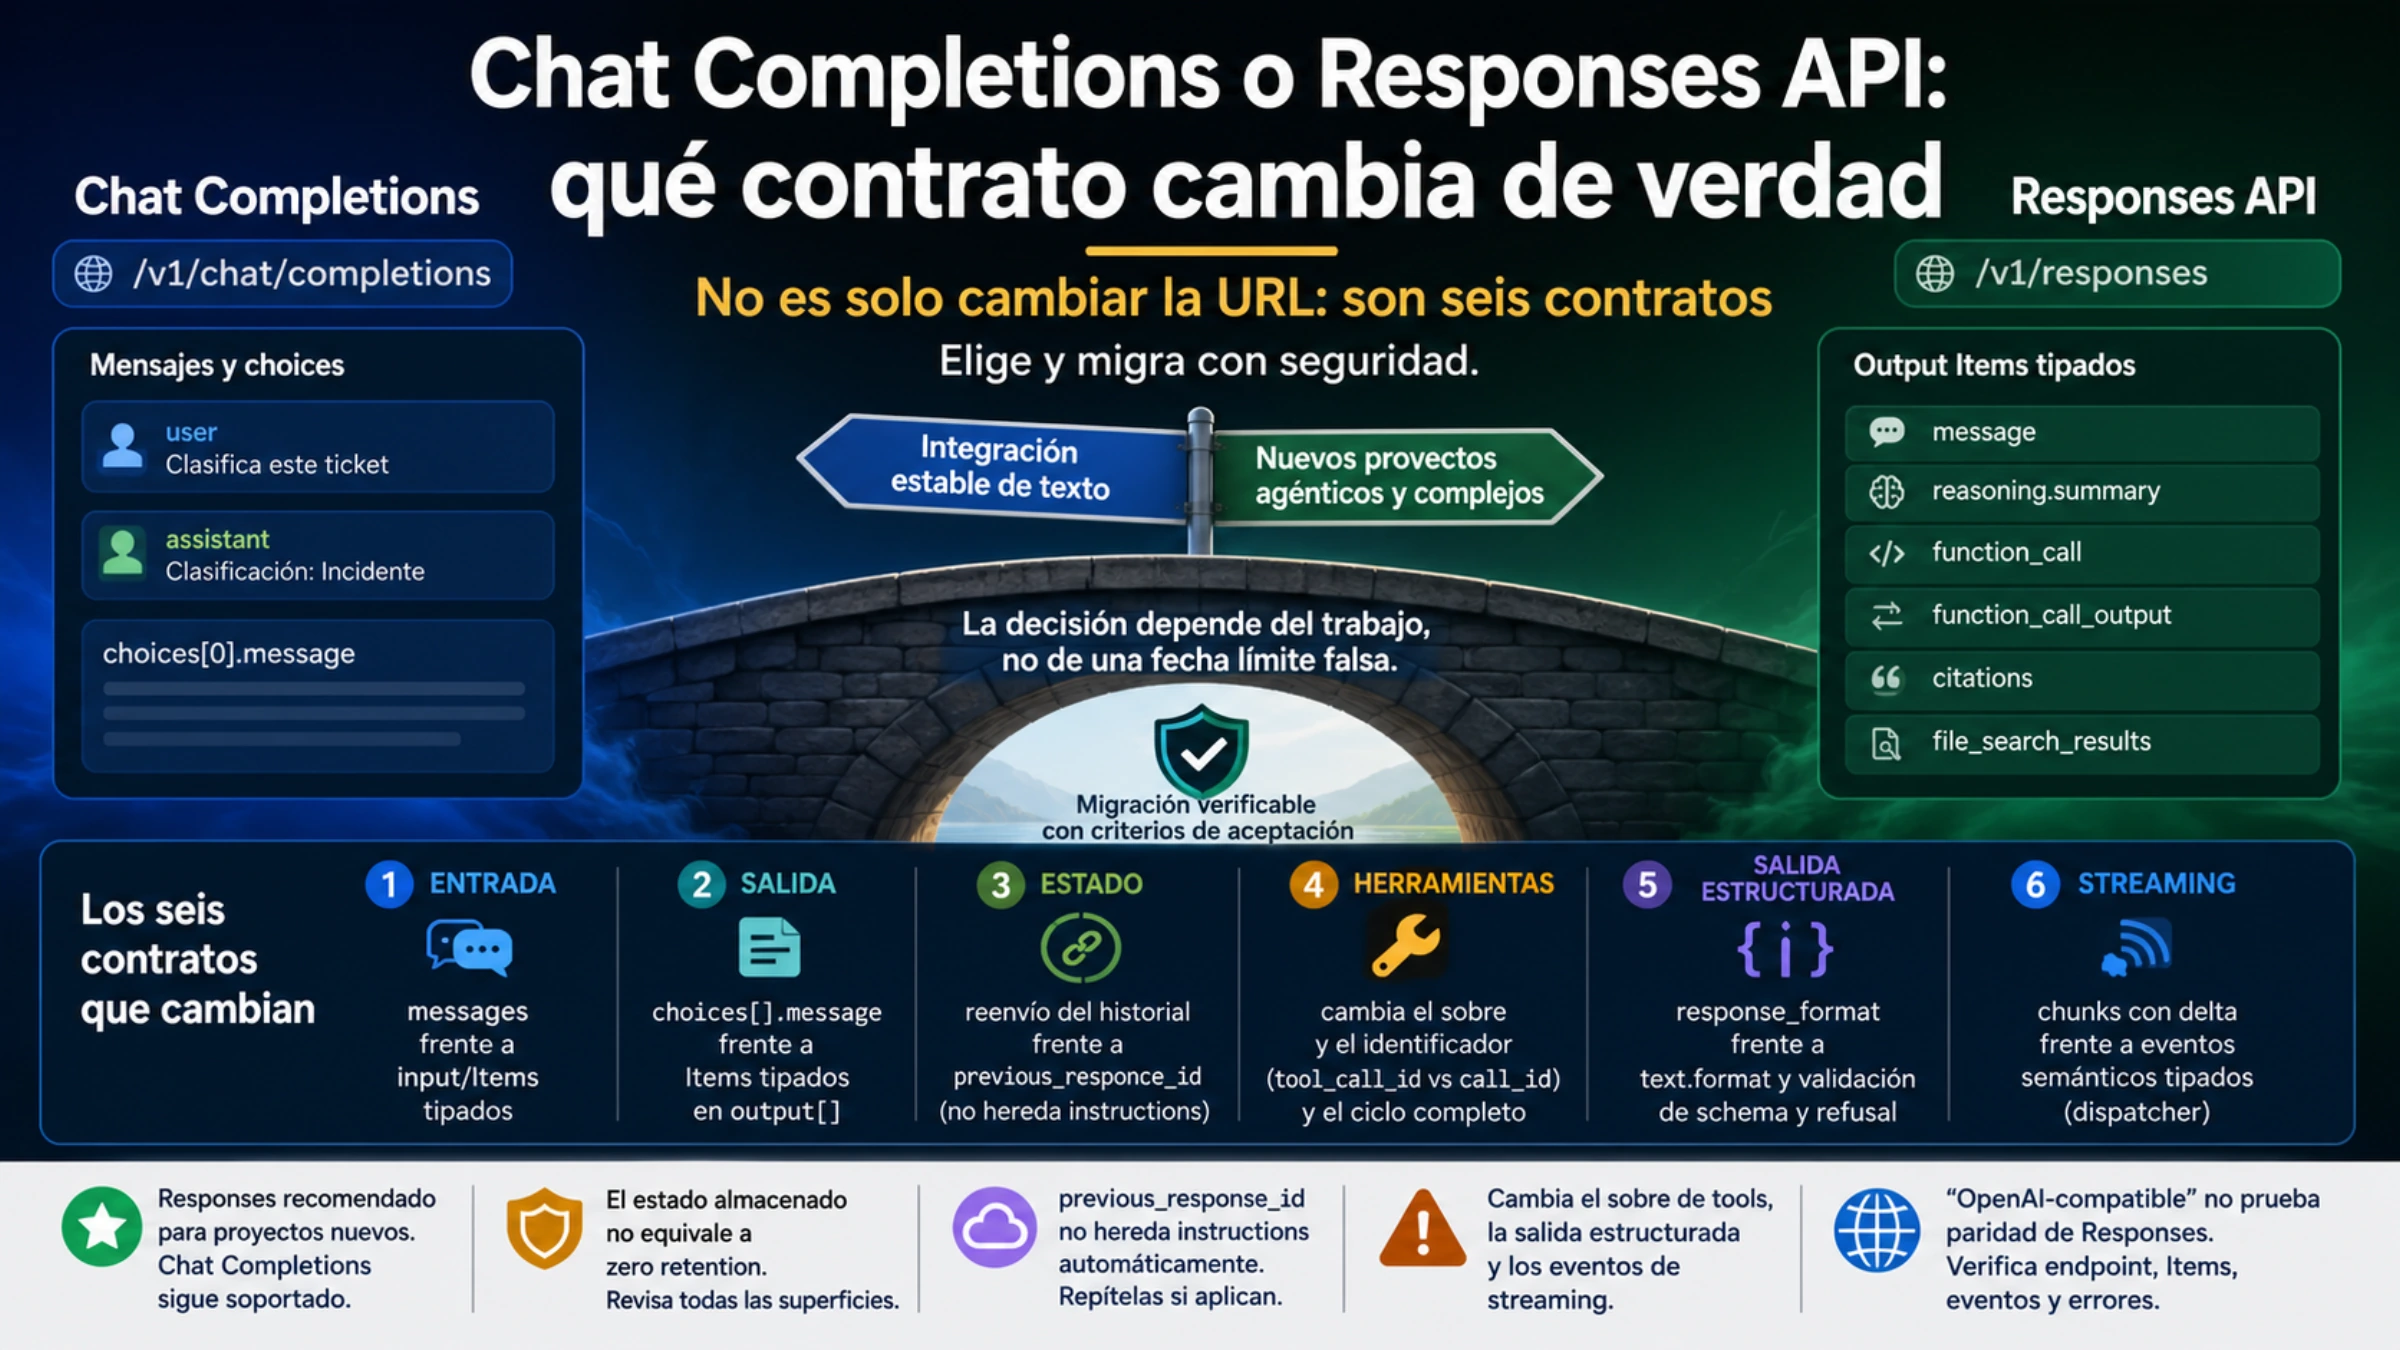
Si empiezas un proyecto con la API de OpenAI, usa Responses API. Si ya tienes una integración estable con Chat Completions que genera texto o salida estructurada, puedes dejarla como está: a 25 de septiembre de 2026, OpenAI la mantiene soportada y no ha anunciado fecha de retirada para /v1/chat/completions. Lo que sí la vuelve insuficiente es la combinación de herramientas con razonamiento: desde GPT-5.4, Chat Completions solo admite llamadas a herramientas con reasoning_effort en none, y con GPT-6 Astra no admite function calling en absoluto.
Resumido en una regla: si tu flujo llama a funciones y quieres que el modelo razone, o si necesitas las herramientas alojadas por OpenAI (búsqueda web, búsqueda en archivos, intérprete de código, MCP remoto), tu destino es Responses. Para lo demás, migrar es una mejora recomendada que puedes hacer flujo a flujo, no una urgencia.
Qué API te toca según tu modelo y lo que usas
La guía de migración de OpenAI resume la postura oficial en dos frases: Chat Completions «sigue soportada» y Responses se recomienda para todos los proyectos nuevos. Las condiciones concretas que inclinan la balanza dependen del modelo y de las funciones que tengas activas:
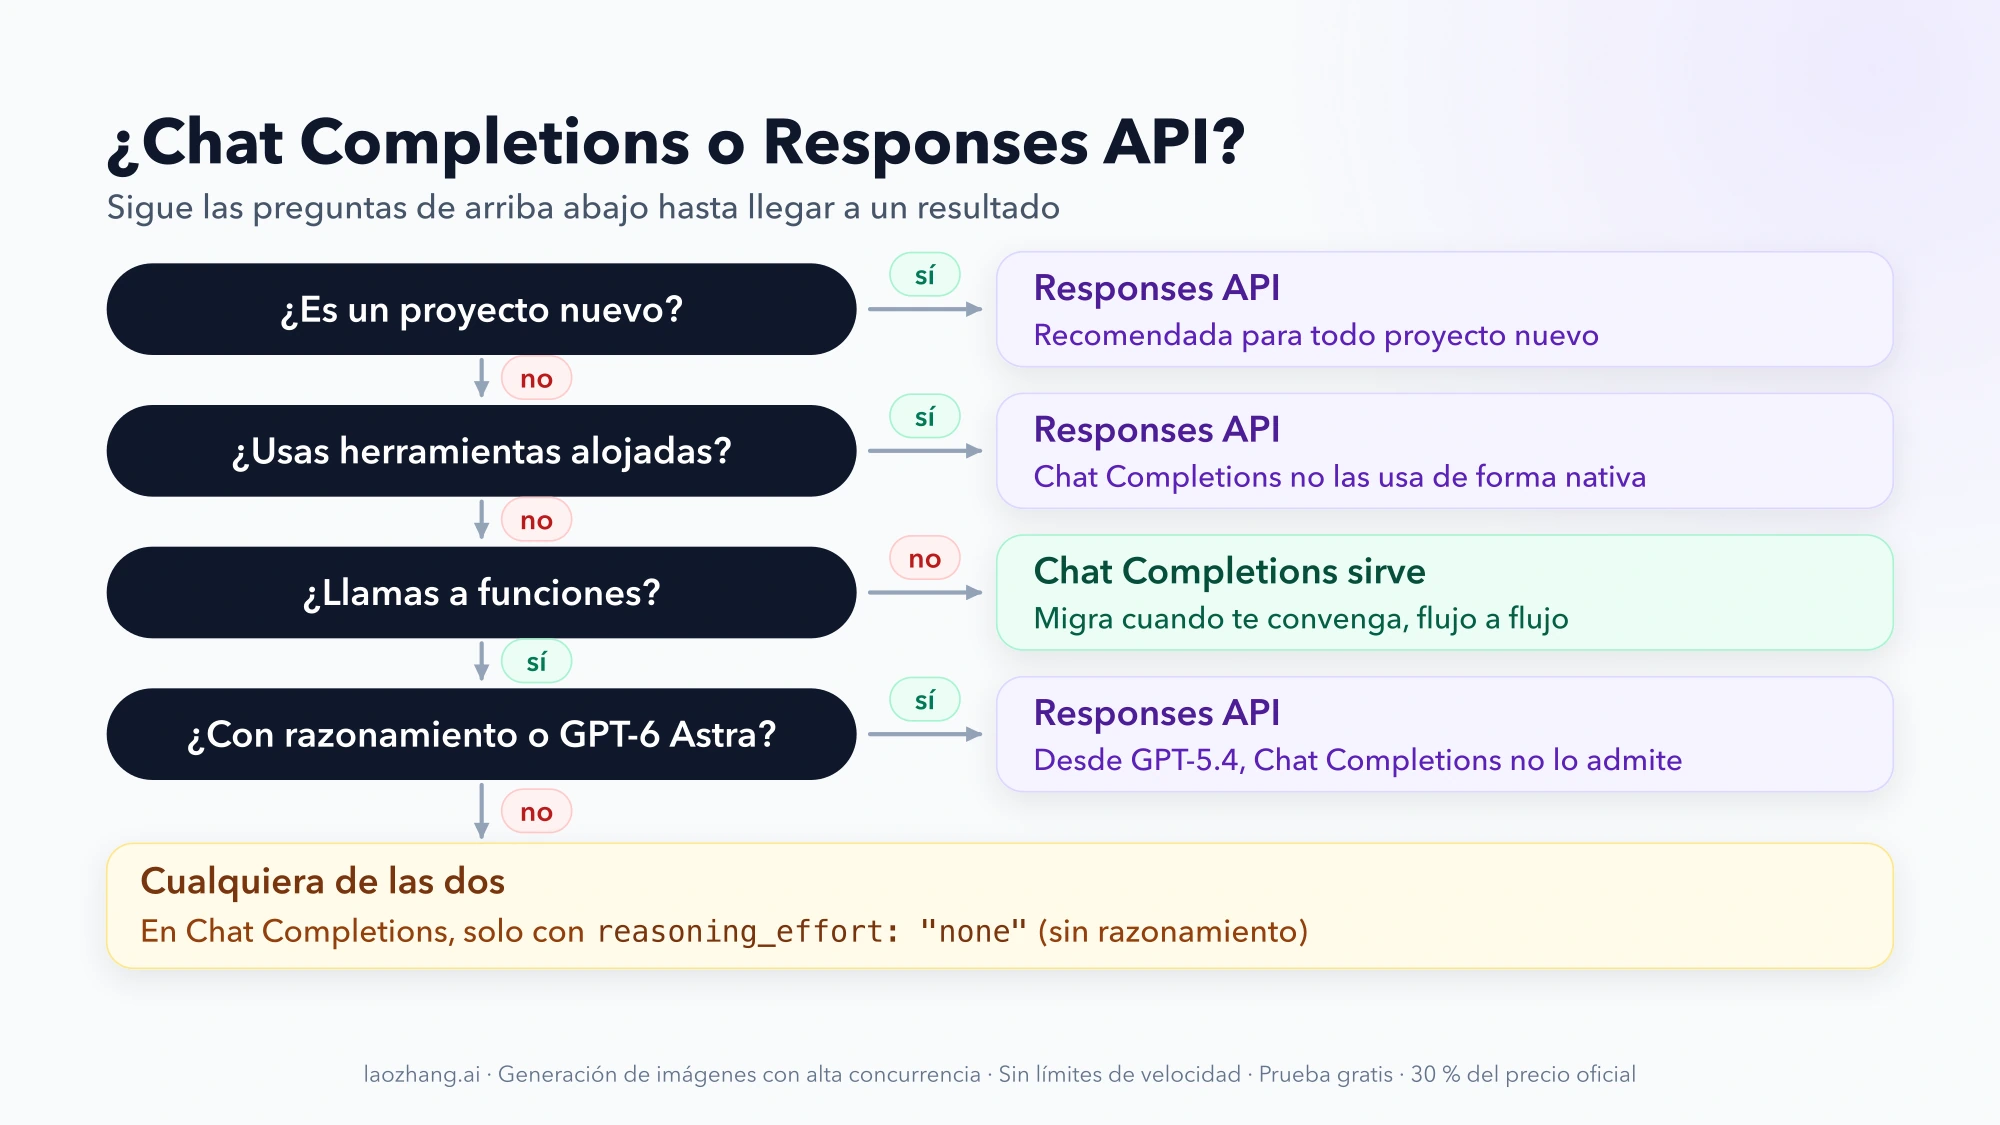
| Tu caso | API adecuada | Por qué |
|---|---|---|
| Proyecto nuevo, cualquier modelo | Responses | Es la recomendación explícita de OpenAI y evita una segunda migración |
| Integración en producción que solo genera texto o JSON con esquema | Chat Completions sirve | Ambas APIs admiten Structured Outputs con JSON Schema estricto; cambia solo la forma de la petición |
Llamadas a funciones sin razonamiento (reasoning_effort: "none") en GPT-5.4 o posterior | Cualquiera de las dos | Chat Completions admite herramientas solo con none |
| Llamadas a funciones con razonamiento en GPT-5.4 o posterior | Responses | Chat Completions no admite herramientas con otro valor de reasoning_effort |
| GPT-6 Astra con herramientas | Responses | Chat Completions no admite function calling con Astra, y Astra devuelve HTTP 400 si pides none |
| Búsqueda web, búsqueda en archivos, intérprete de código o MCP remoto | Responses | En Chat Completions no puedes usar las herramientas alojadas de forma nativa; tendrías que integrarlas tú |
| Proveedor tercero «compatible con OpenAI» | Lo que exponga el proveedor | Esa etiqueta suele referirse a Chat Completions y no garantiza paridad con Responses |
Las restricciones por modelo están en la guía de razonamiento y en la de function calling, que indica literalmente que «GPT-6 Astra requires the Responses API for tool calling». La página de GPT-6 Astra lista los niveles de razonamiento que acepta (low, medium, high, xhigh, max) y precisa que sus herramientas alojadas están disponibles «when using the Responses API».
Hay una consecuencia práctica que no aparece escrita así en la documentación, pero se deduce de ella: GPT-5.6 Sol (alias gpt-5.6) razona en medium por defecto. Para enviarle herramientas por Chat Completions tendrías que bajar reasoning_effort a none, es decir, renunciar al razonamiento en esas peticiones. En Responses mantienes las dos cosas. Lo mismo aplica a GPT-6 Sol y GPT-6 Luna, que aceptan de none a max y también parten de medium.
Si todavía no has elegido modelo, empieza por ahí: la comparativa de modelos de texto de OpenAI en 2026 resume IDs y usos, y GPT-6 Luna vs Sol calcula el coste por tarea de esos dos modelos, que funcionan en ambas APIs.
¿Chat Completions está obsoleta?
No. La página de deprecaciones no incluye ninguna entrada que retire /v1/chat/completions, y la guía de migración sigue describiéndola como soportada. OpenAI recomienda migrar «all flows to the Responses API over time» y, precisamente porque Chat Completions sigue en pie, propone hacerlo de un flujo de usuario en uno.
Tres cosas que se confunden con esa supuesta retirada:
- Assistants API sí desapareció: se apagó el 26 de agosto de 2026 y su sustituto oficial es Responses junto con la Conversations API. Si todavía tienes código de Assistants, esa migración ya no es opcional.
- Completions (legacy), el endpoint
/v1/completionsde texto sin roles, es otra API más antigua. La etiqueta «legacy» es suya, no de Chat Completions. - La CLI de Codex dejó de aceptar
wire_api = "chat"en febrero de 2026, según el anuncio en GitHub. Es un cliente que abandona el protocolo, no la API que cierra. Si configuras Codex con un proveedor propio, el artículo sobre conectar Codex a una API de modelos externa explica cómo hacerlo con Responses.
Qué cambia de verdad al pasar a Responses
El cambio de URL (POST /v1/chat/completions → POST /v1/responses) es lo de menos. Chat Completions trabaja con mensajes: entran como messages y salen dentro de choices[].message, con la llamada a herramientas pegada al mensaje del asistente. Responses trabaja con Items, elementos tipados e independientes: un mensaje es un tipo de Item, y también lo son reasoning, function_call y function_call_output. De ahí salen casi todas las diferencias:
| Aspecto | Chat Completions | Responses API |
|---|---|---|
| Entrada | messages | input (string o lista de Items) e instructions opcional |
| Salida | choices[].message | lista output de Items tipados |
| Texto final | choices[0].message.content | output_text, ayuda del SDK; en REST crudo, recorre output |
| Varias respuestas | n devuelve varias choices | no existe n: una generación por petición |
| Definición de función | {"type": "function", "function": {"name": ...}} | {"type": "function", "name": ...}, sin el nivel function |
| Modo estricto de funciones | no estricto por defecto | si omites strict, intenta el modo estricto |
| Llamada a herramienta | tool_calls dentro del mensaje del asistente | Item function_call con call_id, name y arguments |
| Resultado de herramienta | mensaje role: "tool" con tool_call_id | Item function_call_output con el mismo call_id |
| Salida estructurada | response_format | text.format |
| Límite de salida | max_completion_tokens (max_tokens está deprecado) | max_output_tokens, que incluye los tokens de razonamiento |
| Esfuerzo de razonamiento | reasoning_effort | reasoning.effort |
| Streaming | fragmentos con campo delta | eventos tipados (response.output_text.delta, etc.) |
| Estado entre turnos | reenvías el historial | historial manual, previous_response_id o Conversations API |
Qué hace store | guarda la salida para destilación y evals | guarda el estado de la aplicación, 30 días por defecto |
Para una llamada de texto de un solo turno, el cambio es pequeño:
from openai import OpenAI

client = OpenAI()

# Chat Completions
completion = client.chat.completions.create(
    model="gpt-5.6",
    messages=[
        {"role": "system", "content": "Clasifica tickets de soporte en una palabra."},
        {"role": "user", "content": "No puedo iniciar sesión desde ayer."},
    ],
)
print(completion.choices[0].message.content)

# Responses API
response = client.responses.create(
    model="gpt-5.6",
    instructions="Clasifica tickets de soporte en una palabra.",
    input="No puedo iniciar sesión desde ayer.",
)
print(response.output_text)
Si no usas funciones ni entradas multimodales, también puedes pasar tu lista de mensajes role/content tal cual como input. Eso sirve para una primera prueba, pero no convierte en compatible el código que lee la respuesta: con un modelo de razonamiento, el primer elemento de output suele ser un Item reasoning, no el mensaje. Si lees output[0] esperando texto, te encontrarás con un Item sin el texto de la respuesta. Usa output_text para el texto final y recorre output por tipo cuando haya herramientas o razonamiento de por medio.
Llamadas a herramientas: donde más código se rompe
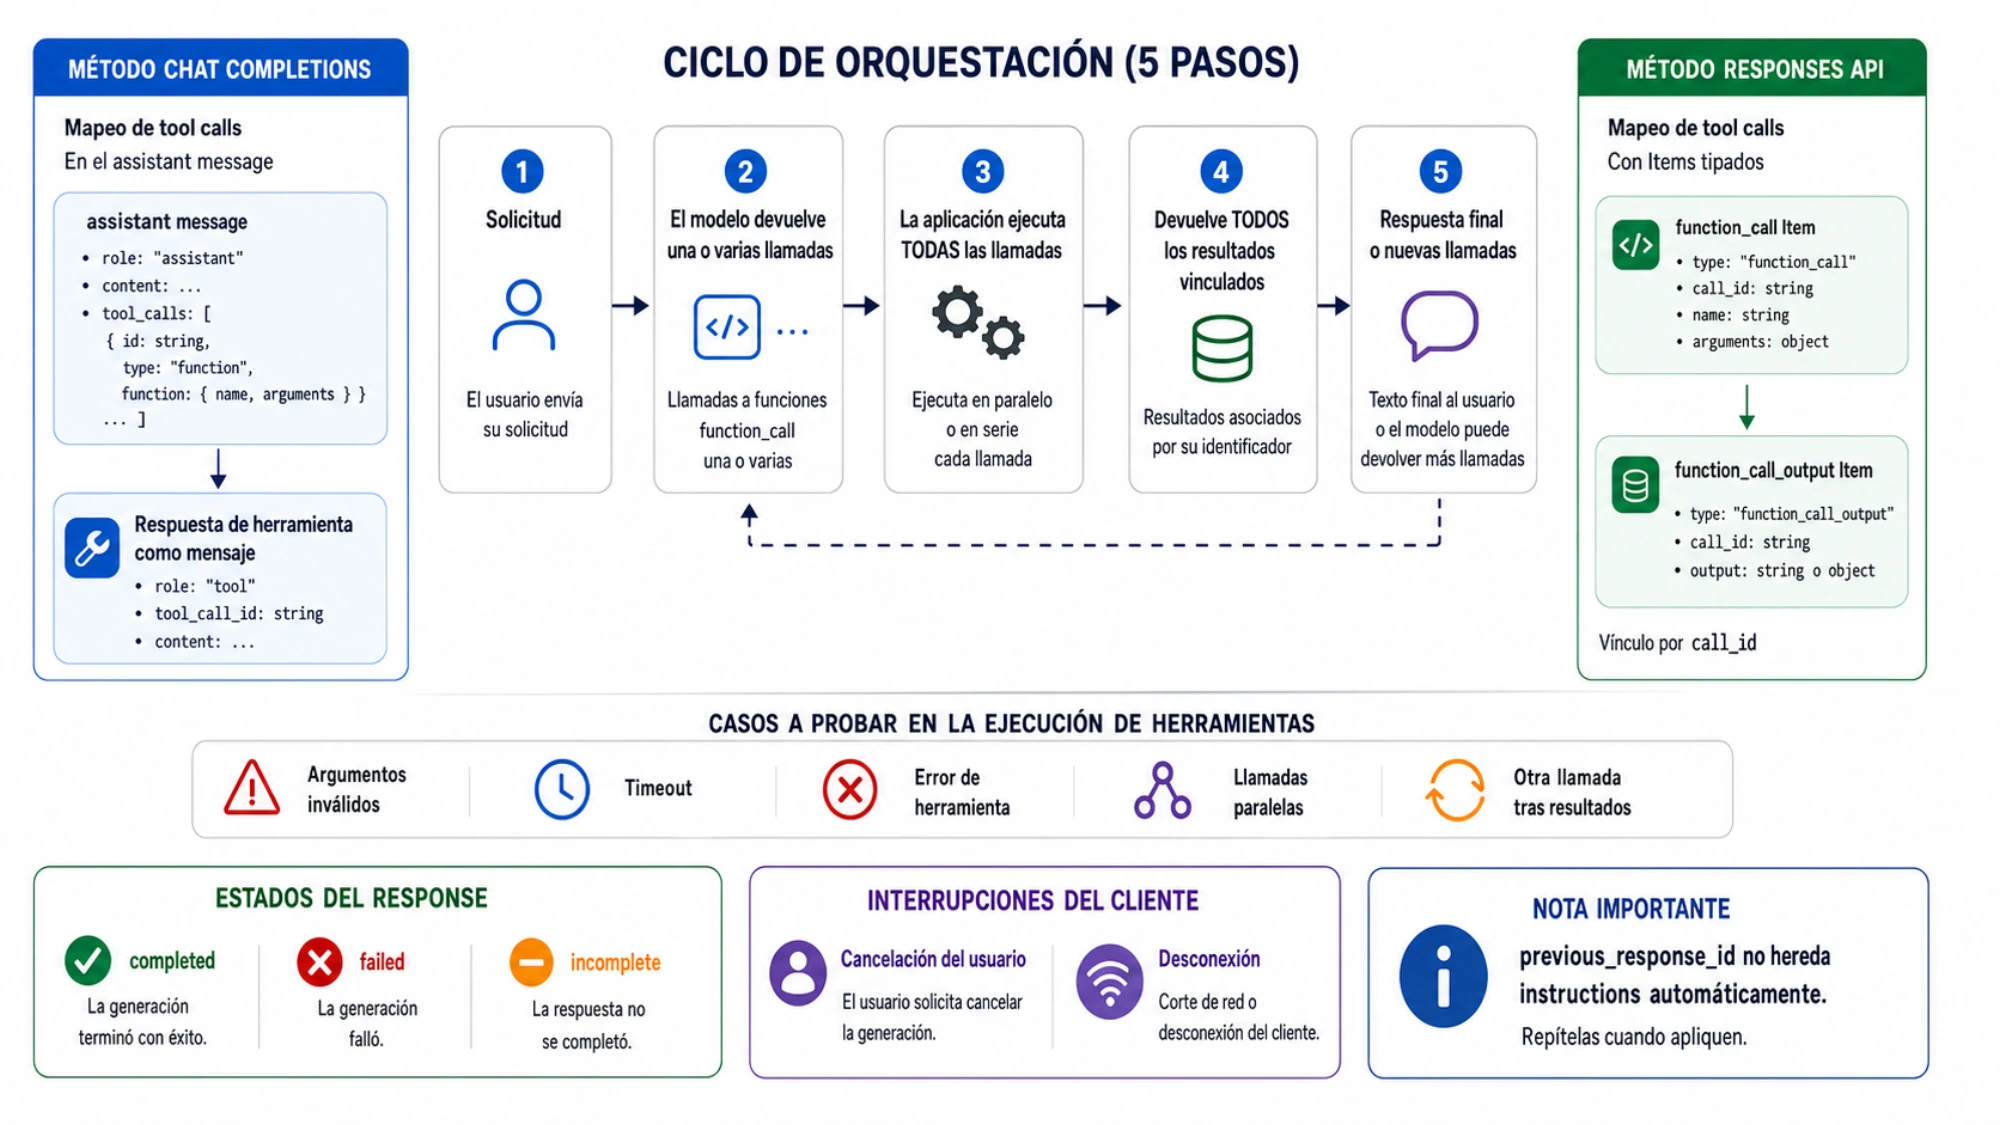
En Chat Completions, el modelo devuelve un mensaje del asistente con tool_calls, tú ejecutas la función y respondes con un mensaje role: "tool" que lleva tool_call_id. En Responses, la llamada y su resultado son dos Items separados que se enlazan por call_id. Tres detalles provocan la mayoría de fallos:
argumentsllega como string JSON, no como objeto: hay que parsearlo conjson.loads.- El
outputque devuelves enfunction_call_outputdebe ser normalmente un string (JSON, un código de error o texto plano). Para imágenes o archivos puedes pasar una lista de objetos de imagen o de archivo. Si tu función no devuelve nada, devuelve algo como"success". - Con modelos de razonamiento, los Items
reasoningque acompañan a las llamadas tienen que volver en la siguiente petición junto con los resultados. La forma más segura es reenviar todoresponse.output.
Este ejemplo completo sigue el patrón de la guía de function calling; consultar_pedido es una función de ejemplo que sustituirías por la tuya:
import json
from openai import OpenAI

client = OpenAI()

tools = [{
    "type": "function",
    "name": "consultar_pedido",
    "description": "Devuelve el estado de un pedido a partir de su ID.",
    "parameters": {
        "type": "object",
        "properties": {"pedido_id": {"type": "string"}},
        "required": ["pedido_id"],
        "additionalProperties": False,
    },
}]

def consultar_pedido(pedido_id: str) -> dict:
    return {"pedido_id": pedido_id, "estado": "enviado"}

entrada = [{"role": "user", "content": "¿En qué estado está el pedido A-1042?"}]
response = client.responses.create(model="gpt-5.6", input=entrada, tools=tools)

entrada += response.output  # conserva reasoning y function_call
for item in response.output:
    if item.type == "function_call":
        args = json.loads(item.arguments)  # arguments es un string JSON
        resultado = consultar_pedido(**args)
        entrada.append({
            "type": "function_call_output",
            "call_id": item.call_id,
            "output": json.dumps(resultado),
        })

final = client.responses.create(model="gpt-5.6", input=entrada, tools=tools)
print(final.output_text)
El bucle recorre todos los Items porque el modelo puede pedir varias funciones en el mismo turno; si quieres como máximo una, pon parallel_tool_calls=False. El esquema lleva additionalProperties: False y todos los campos en required porque, al omitir strict, Responses intenta el modo estricto. Si el esquema no encaja, vuelve a un modo no estricto y la herramienta resuelta aparece con strict: false. Para conservar a propósito el comportamiento que tenías en Chat Completions, declara "strict": False.
Estado de la conversación, store y lo que pagas
Chat Completions no guarda la conversación por ti: reenvías el historial en cada petición. Responses ofrece tres caminos, descritos en la guía de estado de conversación:
- Historial manual: reenvías los Items anteriores tú mismo. Es lo más parecido a lo que ya haces y te deja recortar el contexto.
previous_response_id: encadenas con el ID de la respuesta anterior y OpenAI recupera el contexto.- Conversations API: un objeto de conversación persistente que sobrevive entre sesiones, dispositivos o trabajos.
previous_response_id tiene dos trampas. La primera: no hereda las instructions de la respuesta anterior, así que debes reenviarlas en cada turno.
primera = client.responses.create(
    model="gpt-5.6",
    instructions="Responde como analista de incidentes, en frases cortas.",
    input="Agrupa estas alertas por causa probable: ...",
)

siguiente = client.responses.create(
    model="gpt-5.6",
    previous_response_id=primera.id,
    instructions="Responde como analista de incidentes, en frases cortas.",
    input="Quédate solo con el grupo que hay que escalar ya.",
)
La segunda: no abarata la conversación. Según OpenAI, todos los tokens de entrada de las respuestas anteriores de la cadena se facturan como entrada. Lo que puede reducir el coste es la caché: OpenAI afirma haber medido en pruebas internas entre un 40 % y un 80 % más de aprovechamiento de caché en Responses frente a Chat Completions, y una mejora del 3 % en SWE-bench con modelos de razonamiento y el mismo prompt. Son cifras del propio proveedor; compruébalas con tu tráfico antes de contar con ellas.
El parámetro store no significa lo mismo en las dos APIs, y conviene tenerlo claro si tienes requisitos de privacidad:
- En Responses,
storeguarda el estado de la aplicación que usaprevious_response_id. Según la página de controles de datos, ese estado se conserva 30 días por defecto. Constore: falseno se guarda. - En Chat Completions, la referencia define
storecomo guardar la salida «for use in our model distillation or evals products». No tiene que ver con el estado de la conversación, pero la guía de migración indica que en cuentas nuevas se guarda por defecto. - Las organizaciones con retención de datos cero (ZDR) tienen
storeforzado afalse. Para mantener el razonamiento entre turnos sin estado en el servidor, reenvía los Itemsreasoningcon suencrypted_content. - Los objetos de la Conversations API no caducan a los 30 días: se conservan hasta que los borras y no son elegibles para ZDR.
Si no quieres que se almacene nada, pon store: false de forma explícita en cualquiera de las dos APIs y revisa la configuración de tu organización.
Salida estructurada, límites de tokens y streaming
Salida estructurada. El esquema no cambia; cambia dónde va. En Chat Completions iba en response_format con un nivel json_schema; en Responses va en text.format y el nombre sube un nivel:
esquema = {
    "type": "object",
    "properties": {"nombre": {"type": "string"}, "edad": {"type": "integer"}},
    "required": ["nombre", "edad"],
    "additionalProperties": False,
}

response = client.responses.create(
    model="gpt-5.6",
    input="Extrae nombre y edad: Lucía tiene 34 años.",
    text={"format": {"type": "json_schema", "name": "persona", "strict": True, "schema": esquema}},
)
print(response.output_text)  # JSON que cumple el esquema
Límite de salida. max_output_tokens cuenta los tokens visibles y los de razonamiento, con un mínimo de 16, según la referencia de Responses. Si copias el max_tokens que usabas en Chat Completions, un modelo de razonamiento puede agotar el presupuesto antes de escribir la respuesta y devolverte algo vacío o cortado. Microsoft lo recoge como fallo típico en su guía de migración para Azure OpenAI.
Streaming. En Chat Completions concatenabas choices[0].delta.content. Responses envía eventos con tipo y tienes que ramificar por él. La guía de streaming cita para texto response.created, response.output_text.delta, response.completed y error; si hay llamadas a funciones, llegan también response.function_call_arguments.delta y response.function_call_arguments.done.
stream = client.responses.create(
    model="gpt-5.6",
    input="Resume este ticket en dos frases: ...",
    stream=True,
)
for event in stream:
    if event.type == "response.output_text.delta":
        print(event.delta, end="", flush=True)
    elif event.type == "error":
        raise RuntimeError(str(event))
    elif event.type == "response.completed":
        break
Envuelve el bucle en un try/except: si un error de cuota, autenticación o filtro de contenido llega a mitad del stream y nadie lo captura, el stream simplemente se detiene sin decir nada.
Parámetros de muestreo. Esa misma guía de Microsoft recomienda quitar seed y comprobar si el modelo de destino acepta temperature y top_p, sobre todo si es de razonamiento. La guía de OpenAI no menciona seed; tómalo como una comprobación más, no como una regla universal.
Cómo migrar un flujo de Chat Completions a Responses sin perder nada
OpenAI propone migrar de un flujo en uno y comparar antes de mover más tráfico. Ordenado para que cada paso se pueda verificar:
- Aísla el acceso a la API. Si el código de negocio lee
choices[0]directamente, crea antes una capa propia que devuelva texto, llamadas a herramientas y uso de tokens. Así la migración toca un solo sitio. - Empieza por un flujo de solo texto. Cambia endpoint, cuerpo de la petición y lectura de la respuesta (
output_texto recorrido deoutput). - Elige cómo guardas el estado: historial manual,
previous_response_ido Conversations API. Si el flujo es sin estado o tu organización usa ZDR, añadestore: falsey reenvía los Itemsreasoningcifrados. - Migra las funciones: aplana las definiciones, parsea
arguments, devuelvefunction_call_outputcon elcall_idcorrecto y prueba cada esquema con el modo estricto. - Mueve los esquemas de
response_formatatext.format. - Reescribe el consumidor de streaming para eventos tipados, con manejo de
error. - Sustituye integraciones propias por herramientas alojadas solo donde encajen en el flujo.
- Compara antes de ampliar: comportamiento, latencia, tokens consumidos y errores con peticiones reales. No busques frases idénticas; busca que el JSON se parsee, que no se pierda ninguna llamada a herramienta y que el stream termine.
No des por hecho que una API es más rápida que la otra: la documentación de OpenAI no incluye una comparación de latencia, y su propia lista de comprobación pide medirla con tu tráfico. Actualiza también los mocks y snapshots de los tests: los que simulan choices o choices[0].delta.content dejan de representar lo que devuelve la API.
Síntomas típicos al enviar un payload con forma de Chat Completions
Estos son los fallos que aparecen cuando parte del código sigue pensando en mensajes. Los mensajes de error literales proceden de la tabla de solución de problemas de Microsoft para Azure OpenAI; en api.openai.com el texto exacto puede variar, pero la causa es la misma.
| Síntoma | Causa probable | Arreglo |
|---|---|---|
missing_required_parameter: tools[0].name | Definición de función anidada al estilo Chat | Quita el nivel function y pon name arriba |
unknown_parameter: input[N].tool_calls | Reenvías el mensaje del asistente con tool_calls o mensajes role: "tool" | Reenvía los Items de output y un function_call_output por llamada |
invalid_type: text.format | Pasas la estructura antigua de response_format | Usa text={"format": {"type": "json_schema", "name": ..., "schema": ...}} |
invalid input content type | Contenido con tipo text o image_url | Usa input_text e input_image |
integer below minimum value en max_output_tokens | Valor por debajo de 16 | Sube el límite |
| Respuesta vacía o cortada | max_output_tokens pequeño con un modelo de razonamiento | Deja margen para los tokens de razonamiento |
| El código no encuentra el texto | Lees choices o tratas output[0] como mensaje | Usa output_text o filtra output por tipo message |
| El modelo no «ve» el resultado de la función | function_call_output sin el call_id correcto | Copia el call_id del Item function_call |
| El modelo pierde el rol en el segundo turno | previous_response_id no hereda instructions | Reenvía instructions en cada petición |
La factura no baja con previous_response_id | Toda la cadena se factura como entrada | Recorta contexto con historial manual si el coste importa |
| HTTP 400 con GPT-6 Astra | Pides esfuerzo de razonamiento none | Usa de low a max |
| El stream se para sin error visible | Un error a mitad del stream que nadie captura | Maneja el evento error y envuelve el bucle en try/except |
La lista de errores comunes de la guía de OpenAI incluye dos más que conviene revisar a mano: perder Items reasoning, function_call o function_call_output al reconstruir el contexto y reutilizar el manejador de fragmentos de Chat Completions sin adaptarlo a eventos.
Proveedores «compatibles con OpenAI»
Muchos proveedores y pasarelas que se anuncian como compatibles con OpenAI implementan Chat Completions; el soporte de Responses varía mucho. Algunos exponen una ruta compatible con Responses pero sin estado e ignorando parámetros o herramientas que no soportan. Antes de migrar un flujo que pasa por un tercero, comprueba en su documentación que existe /v1/responses y qué hace con previous_response_id, store, los eventos de streaming y las herramientas alojadas.
En Azure, Microsoft documenta la migración a Responses con el cliente OpenAI apuntando a .../openai/v1/. Y si llamas a un modelo de otro proveedor con el cliente de OpenAI, como en el caso de DeepSeek V4 Pro, la documentación de ese proveedor es la que dice qué endpoint expone y con qué limitaciones.
Preguntas frecuentes
¿Puedo seguir usando Chat Completions en 2026?
Sí. A 25 de septiembre de 2026 está soportada y sin fecha de retirada. El límite real es funcional: no te sirve para combinar herramientas y razonamiento en GPT-5.4 o posterior, ni para function calling con GPT-6 Astra, ni para herramientas alojadas.
¿Responses API es más rápida?
La documentación de OpenAI no incluye una comparación de latencia. Mide con tus propias peticiones antes de sacar conclusiones; las diferencias que publica OpenAI se refieren a calidad con modelos de razonamiento y a aprovechamiento de caché, no a velocidad.
¿previous_response_id reduce el coste de una conversación larga?
No. Todos los tokens de entrada de la cadena se facturan como entrada en cada turno. Te ahorra reenviar el historial, no pagarlo.
¿Tengo que migrar si usaba Assistants API?
Sí, y no es opcional: Assistants API dejó de funcionar el 26 de agosto de 2026. Los sustitutos oficiales son Responses API y la Conversations API.