Precio de Haiku 5.5 y GPT-6 Luna: iguales hasta 100.000 tokens
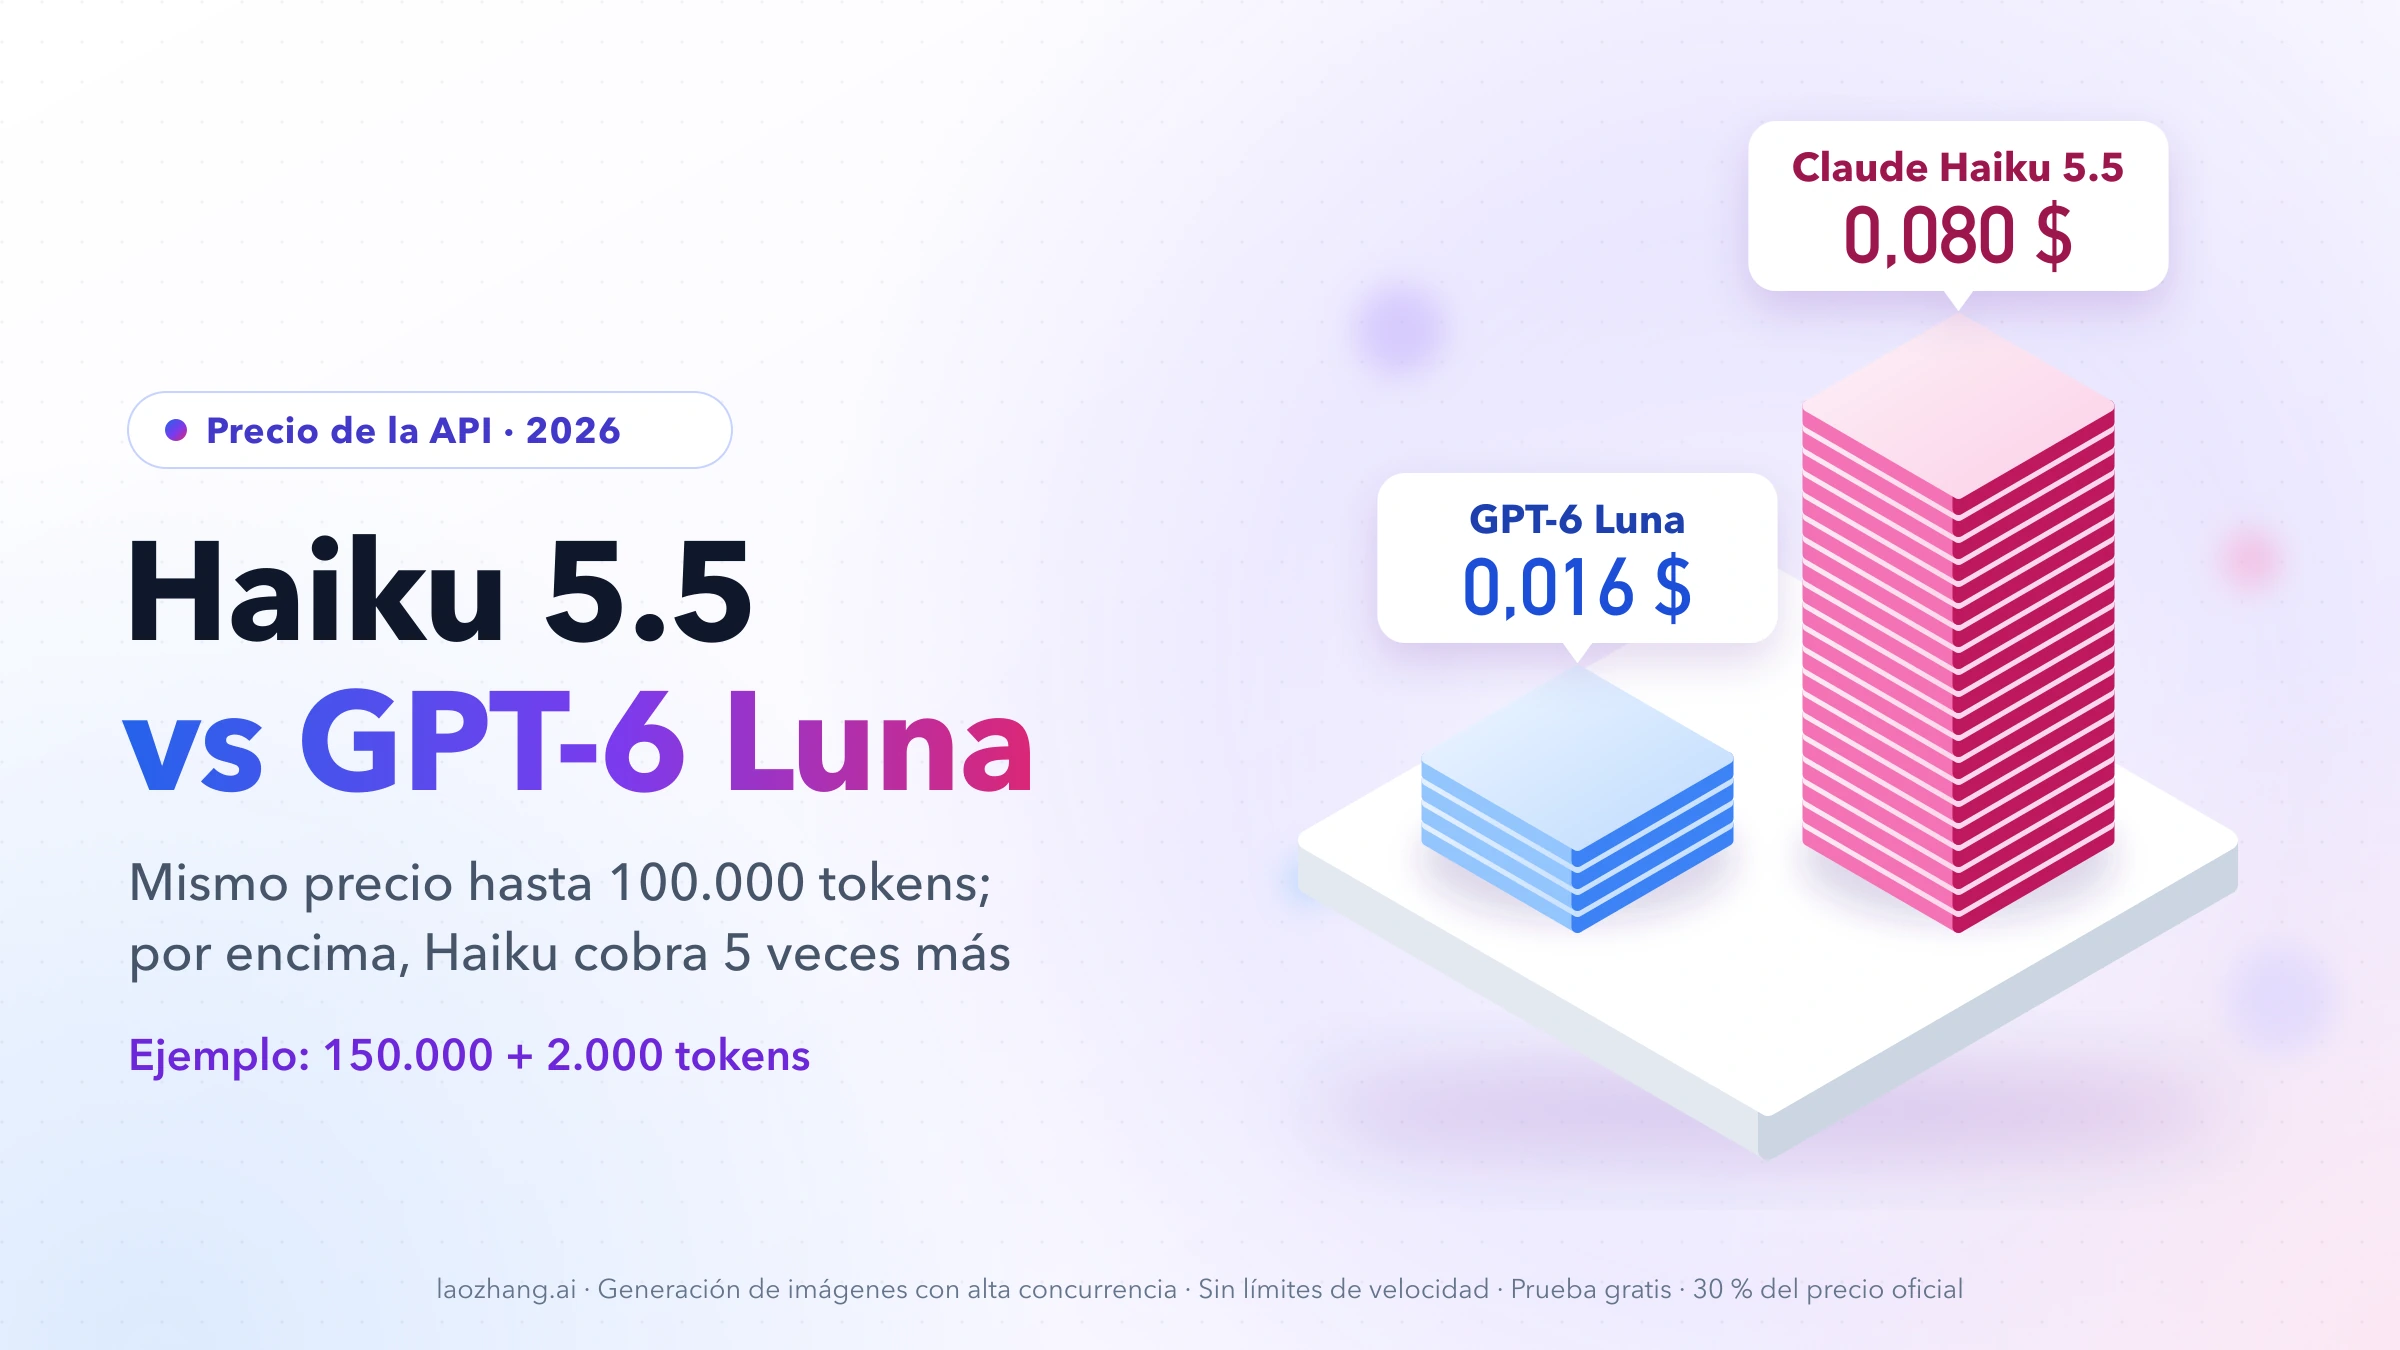
A 8 de octubre de 2026, Claude Haiku 5.5 y GPT-6 Luna cobran exactamente lo mismo por token mientras el prompt no pase de 100.000 tokens: 0,10 $ por millón de tokens de entrada y 0,50 $ por millón de salida, con lectura de caché a 0,01 $. A partir de 100.001 tokens de prompt, Haiku multiplica por cinco todas sus tarifas; Luna mantiene las suyas hasta 272.000 tokens de entrada y, por encima, solo las sube entre 1,5 y 2 veces.
La regla práctica para tráfico de API con un modelo pequeño:
- Prompts de hasta 100.000 tokens (clasificación, extracción, enrutado, respuestas de soporte, RAG con pocos fragmentos): el precio por token es idéntico. Lo que decide la factura es cuántos tokens consume cada modelo para la misma tarea, sobre todo de salida y de razonamiento.
- Prompts de 100.001 a 272.000 tokens: Luna cuesta la quinta parte por petición, con el mismo número de tokens.
- Prompts de más de 272.000 tokens: los dos están en su tramo caro y Luna sigue siendo entre 2,5 y 3,3 veces más barata por token.
- Agentes y conversaciones que acumulan contexto: en cuanto un turno supera 100.000 tokens, Haiku empieza a perder, aunque el resto del trabajo vaya por debajo.
Estas son las tarifas estándar de la tabla de precios de Anthropic y de la tabla de precios de OpenAI, en dólares por millón de tokens y sin impuestos:
| Tarifa por millón de tokens | Haiku 5.5, prompt ≤100.000 | Haiku 5.5, prompt >100.000 | Luna, entrada ≤272.000 | Luna, entrada >272.000 |
|---|---|---|---|---|
| Entrada | 0,10 $ | 0,50 $ | 0,10 $ | 0,20 $ |
| Escritura en caché | 0,125 $ (5 min) | 0,625 $ (5 min) | 0,125 $ | 0,25 $ |
| Escritura en caché de 1 h | 0,20 $ | 1 $ | no figura | no figura |
| Lectura de caché | 0,01 $ | 0,05 $ | 0,01 $ | 0,02 $ |
| Salida | 0,50 $ | 2,50 $ | 0,50 $ | 0,75 $ |
Tres detalles cambian el cálculo. Exactamente 100.000 tokens todavía pagan la tarifa baja de Haiku, porque Anthropic define el tramo caro como «más de 100.000». El tramo se decide por la longitud del prompt, pero la tabla aplica el precio alto también a la salida y a la caché de esa misma petición. Y ninguna de las dos empresas aclara si los tokens leídos de caché cuentan para su umbral (100.000 en Haiku, 272.000 en Luna): lo prudente es planificar como si contaran, que es el supuesto de todos los ejemplos de abajo.
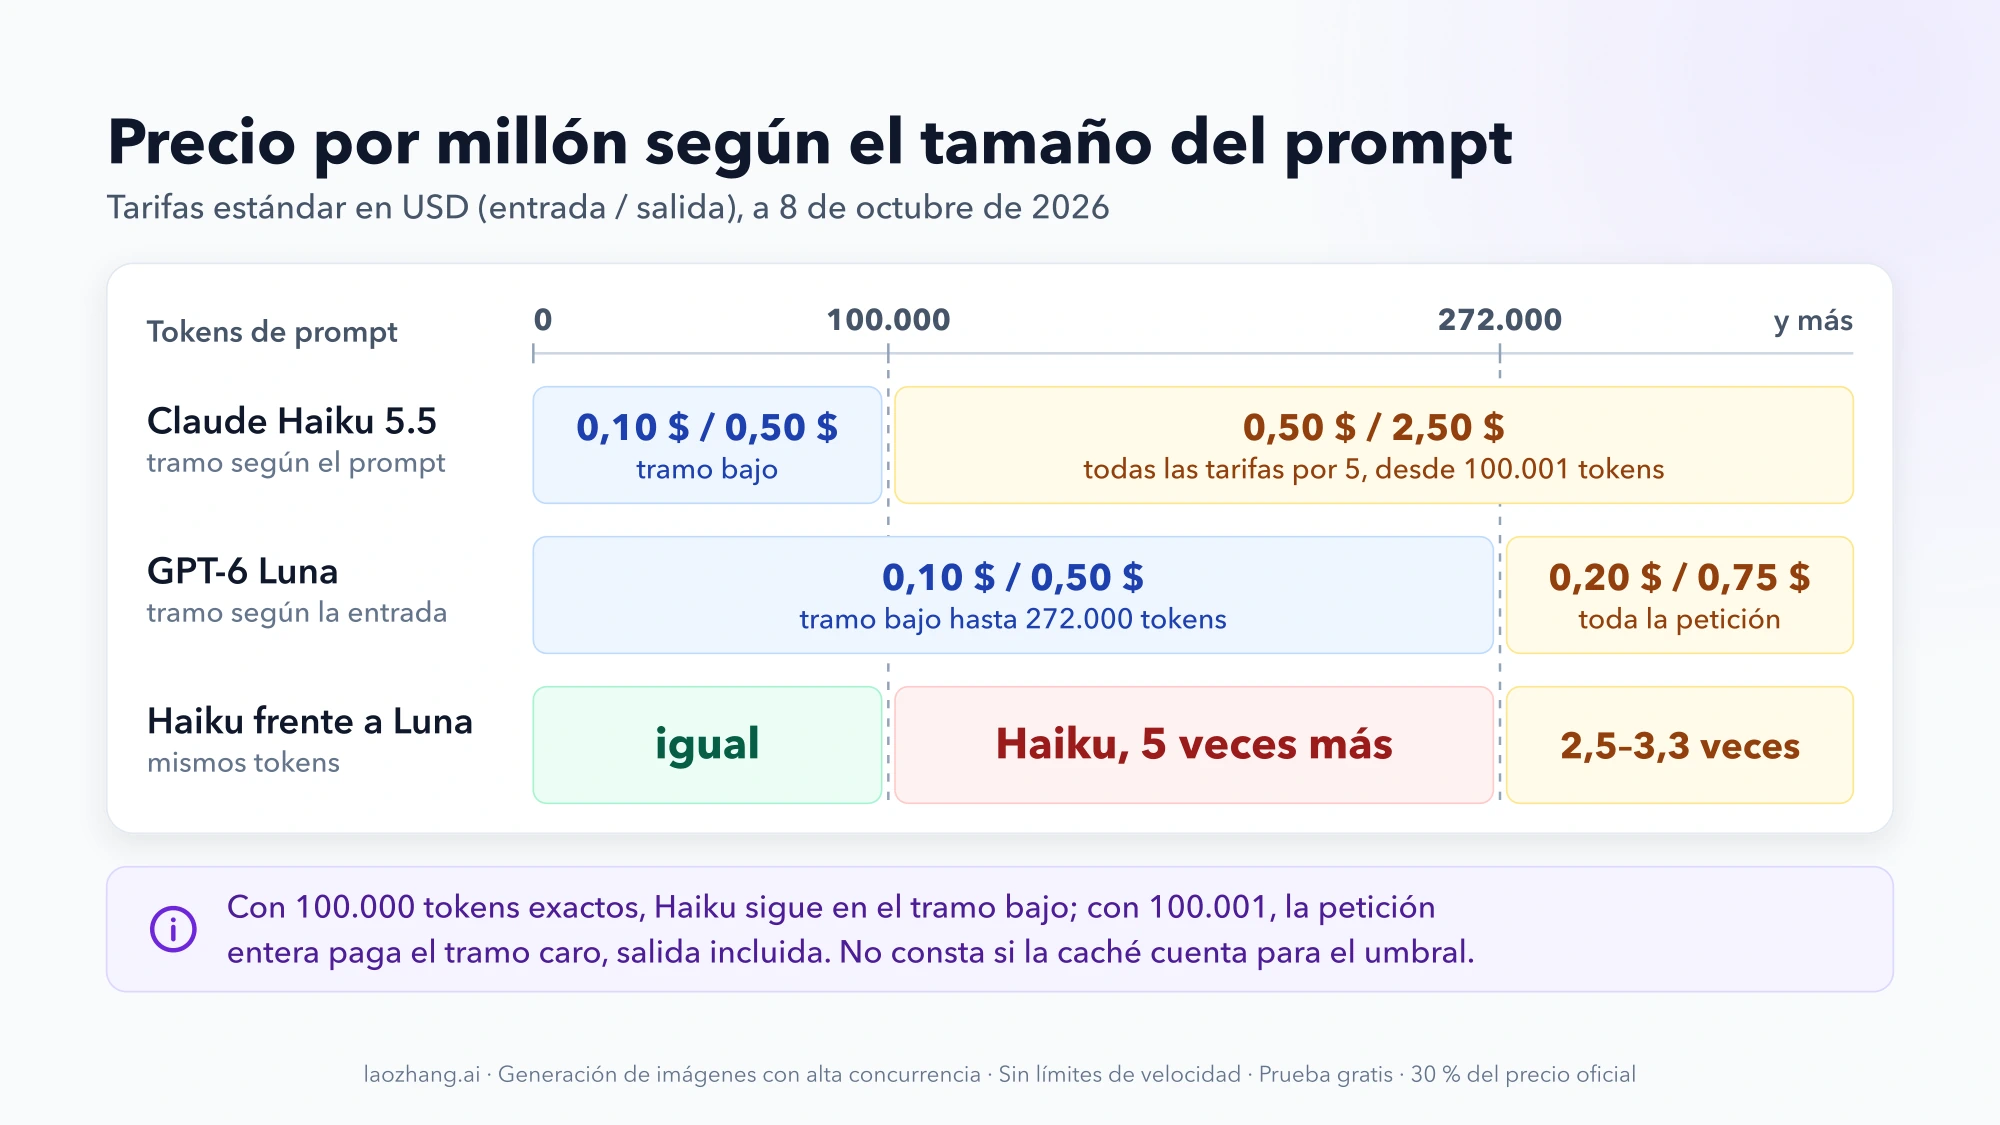
Los dos modelos están pensados para lo mismo. La ficha de Haiku 5.5 lo sitúa en tareas de mucho volumen y sensibles a la latencia, como clasificación, extracción y enrutado; la ficha de GPT-6 Luna lo presenta como el modelo más eficiente de OpenAI para tareas acotadas y de alto volumen. Ambos aceptan texto e imagen, devuelven texto y admiten 128.000 tokens de salida.
Coste por petición según el tamaño: dónde Haiku pasa a costar 5 veces más
El coste de una petición se calcula igual en las dos API:
coste = (entrada × tarifa de entrada
       + escritura en caché × tarifa de escritura
       + lectura de caché × tarifa de lectura
       + salida × tarifa de salida) / 1.000.000
La única diferencia es qué fila de tarifas toca: en Haiku, la del tramo caro si el prompt pasa de 100.000 tokens; en Luna, si la entrada pasa de 272.000. Con el mismo número de tokens en los dos modelos, sin caché ni herramientas y a tarifa estándar, quedan así:
| Petición (prompt + salida) | Haiku 5.5 | GPT-6 Luna | Haiku / Luna |
|---|---|---|---|
| 2.000 + 200 | 0,0003 $ | 0,0003 $ | 1 |
| 20.000 + 1.000 | 0,0025 $ | 0,0025 $ | 1 |
| 100.000 + 2.000 | 0,011 $ | 0,011 $ | 1 |
| 100.001 + 2.000 | 0,0550 $ | 0,0110 $ | 5 |
| 150.000 + 2.000 | 0,080 $ | 0,016 $ | 5 |
| 272.000 + 2.000 | 0,141 $ | 0,0282 $ | 5 |
| 300.000 + 5.000 | 0,1625 $ | 0,06375 $ | 2,55 |
| 150.000 + 2.000 en Batch | 0,040 $ | 0,008 $ | 5 |
Un millón de clasificaciones de 2.000 tokens de entrada y 200 de salida cuestan 300 $ en cualquiera de los dos. El salto de la fila 100.001 es el que conviene vigilar: un solo token más multiplica por cinco toda la petición en Haiku, incluidos los 2.000 tokens de respuesta. Entre 100.001 y 272.000 tokens la relación es siempre de 5 a 1, porque las tarifas de Haiku suben de forma uniforme y las de Luna no se mueven. Por encima de 272.000, Luna también encarece la petición entera y la distancia baja hacia 2,5–3,3 veces, según pese más la entrada o la salida.
El descuento de Batch no cambia el reparto. Las dos API rebajan un 50 % el trabajo asíncrono (Luna también en Flex), así que la proporción entre ambos se mantiene; en Haiku, el lote sigue pagando el tramo caro si el prompt pasa de 100.000. Luna tiene además un modo Fast al doble del precio estándar, y OpenAI aplica su recargo largo a la petición entera: lo explica con más detalle GPT-6 Luna vs Sol: precio, coste por tarea y cuál elegir.
Agente de 20 turnos: con caché, Haiku sale 2,2 veces más caro
Las peticiones sueltas rara vez cruzan 100.000 tokens; los agentes sí, porque cada turno arrastra el historial anterior. Para ver el efecto, un modelo sencillo: 20 turnos, un prompt inicial de 12.000 tokens que crece 6.000 por turno (en el turno 20 llega a 126.000) y 1.500 tokens de salida por turno. Solo los turnos 16 a 20 pasan de 100.000.
| Sesión de 20 turnos | Haiku 5.5 | GPT-6 Luna | Haiku / Luna |
|---|---|---|---|
| Sin caché | 0,396 $ | 0,153 $ | 2,59 |
| Con caché | 0,0949 $ | 0,0433 $ | 2,19 |
| Con caché y contexto compactado a 40.000 antes del turno 16 | 0,0441 $ | — | — |
Supuestos de la tabla: los dos modelos cuentan los mismos tokens; con caché, cada turno lee de caché el prompt anterior y escribe solo los 6.000 tokens nuevos a la tarifa de 5 minutos; los tokens leídos de caché cuentan para el umbral de 100.000; el coste de generar el resumen al compactar no está incluido. Es un modelo de cálculo, no una factura medida.
Lo que enseña es dónde se va el dinero. Con caché, los cinco turnos que superan 100.000 tokens suman 0,0645 $ de los 0,0949 $ de Haiku: el 68 % de la factura sale de una cuarta parte de los turnos. Si mantienes cada turno por debajo de 100.000 —compactando el contexto, recortando resultados de herramientas o abriendo una sesión nueva—, Haiku vuelve a la tarifa de Luna para esos turnos y la sesión queda en 0,0441 $, prácticamente lo mismo que Luna sin tocar nada.
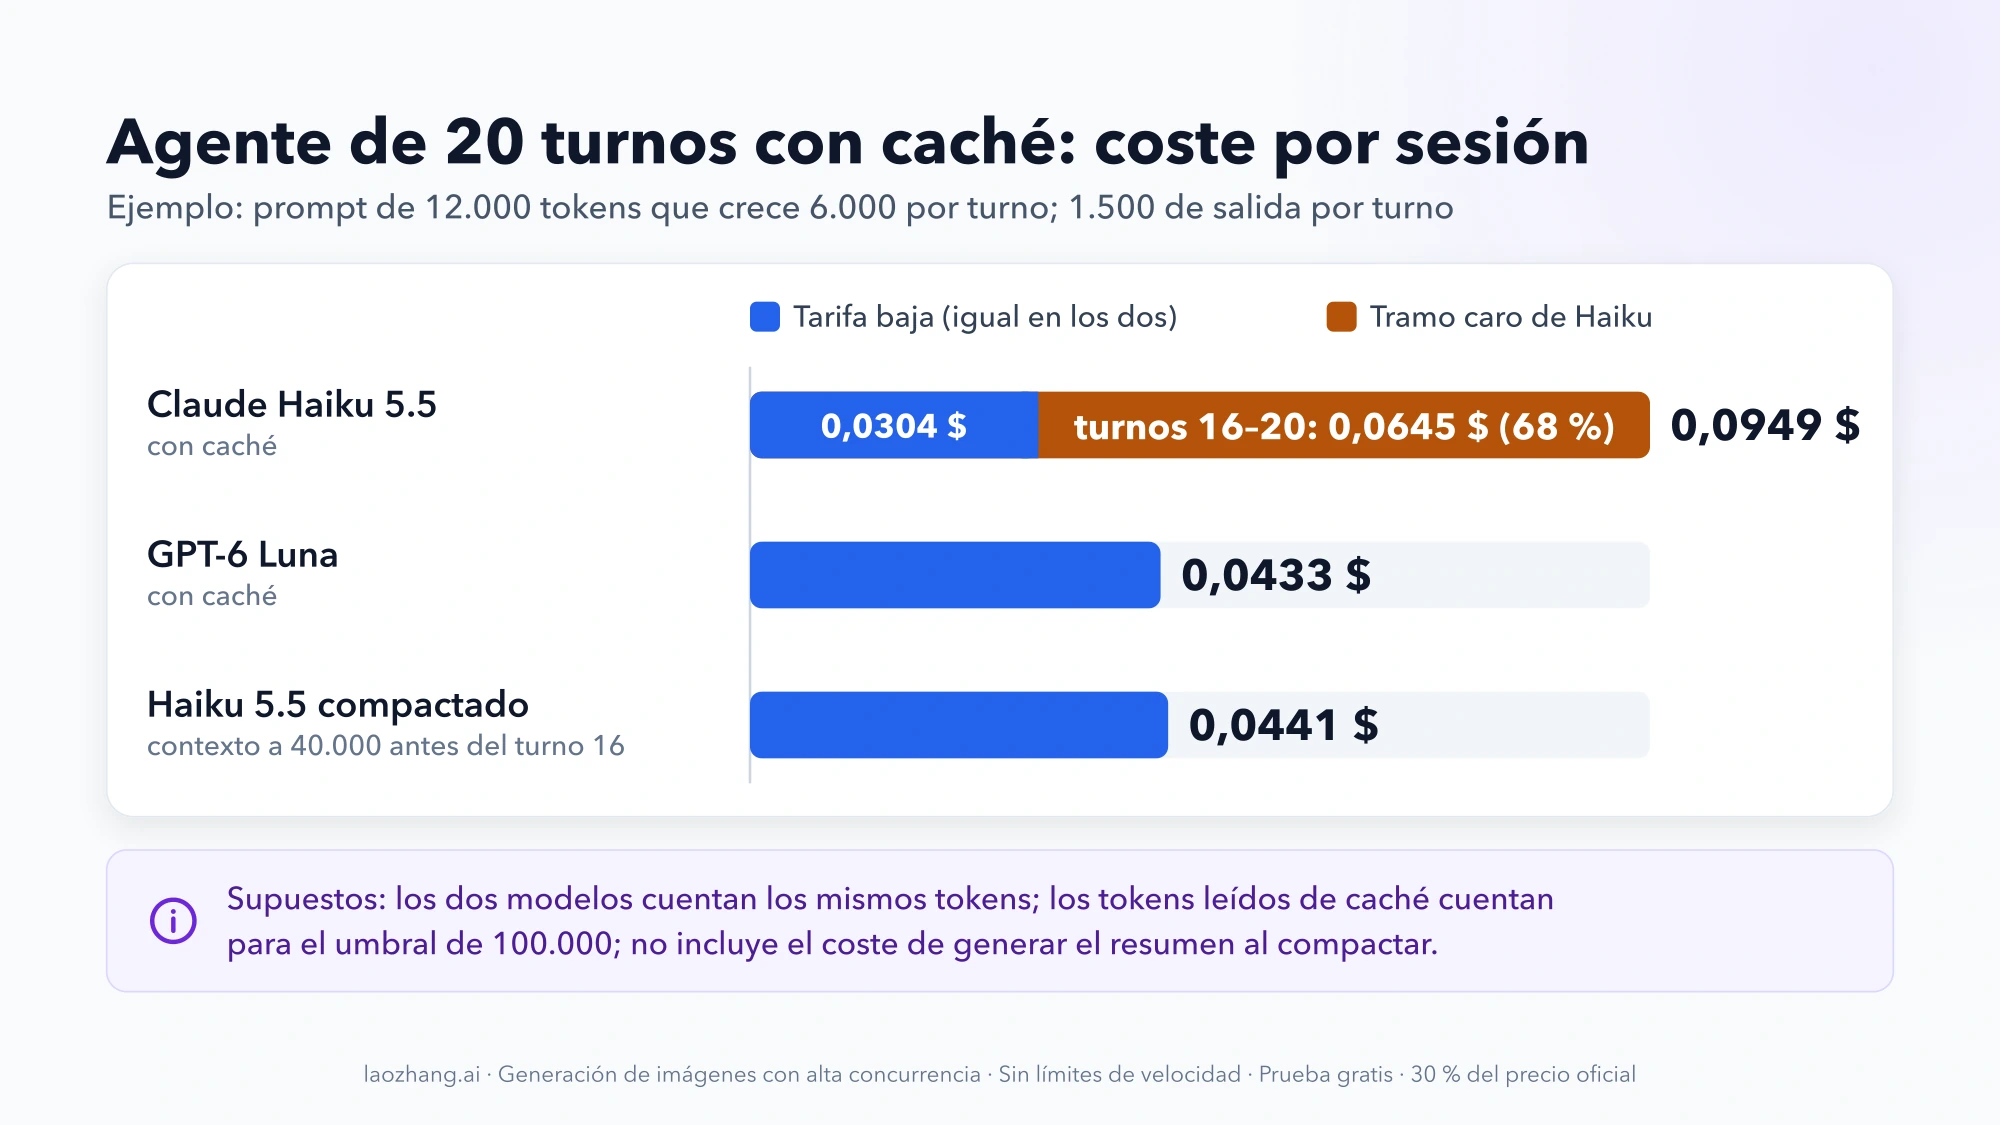
Hay un factor que el modelo no incluye y empeora el caso de Haiku. Según la documentación de ventanas de contexto, Haiku 5.5 conserva por defecto los bloques de razonamiento de turnos anteriores, y esos bloques se cobran como entrada en las peticiones siguientes. El contexto real de un agente con razonamiento crece más deprisa que en la tabla y llega antes a 100.000.
Así se explican casos como el hilo de r/ClaudeAI que habla de una tarea que costó 12 veces más en Haiku que en Luna: no se conocen las condiciones exactas, pero los comentarios lo atribuyen al salto de precio por encima de 100.000 tokens en un trabajo de varios turnos. El tramo multiplica la tarifa y, como se ve en la siguiente sección, la cantidad de salida puede multiplicar los tokens; los dos efectos se acumulan.
Mismo precio, distinta factura: tokenizador, razonamiento y salida
Que las tarifas coincidan no significa que la misma tarea cueste lo mismo. Tres cosas separan la factura incluso por debajo de 100.000 tokens.
El tokenizador. Haiku 5.5 usa el tokenizador de Claude 4.7 y posteriores; según el resumen de novedades de Haiku 5.5, el mismo texto cuenta aproximadamente un 30 % más de tokens que en Haiku 4.5, y Simon Willison midió un 25 % más con su propio prompt. Ninguna fuente publicada compara los recuentos de Haiku 5.5 y de Luna para el mismo texto, así que no sabes de antemano cuál de los dos te cobrará más tokens por tu prompt. La única forma de saberlo es medirlo: envía una muestra representativa de tus peticiones a las dos API y compara los tokens de entrada que devuelve cada respuesta.
Los tokens de razonamiento. En los dos modelos el razonamiento se cobra como salida, a 0,50 $ por millón en el tramo bajo. Haiku 5.5 trae el razonamiento adaptativo activado y effort medium por defecto; Luna usa medium como reasoning effort por defecto. Una respuesta de 200 tokens visibles puede ir acompañada de miles de tokens de razonamiento facturados. Cómo aparecen en los datos de uso de cada API lo explica Tokens de razonamiento: cómo evitar contarlos dos veces en Gemini, OpenAI y Claude.
La salida por tarea. Con el mismo nombre de nivel, Haiku escribe bastante más. En las comparativas de Artificial Analysis, Haiku 5.5 en Medium generó 33.000 tokens de salida por tarea frente a 11.000 de Luna en Medium; solo esa salida son 0,0165 $ frente a 0,0055 $ por tarea, tres veces más con el mismo precio por token.
Los ajustes que controlan estas cifras se llaman distinto en cada API:
| Ajuste | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Nivel por defecto | effort medium, razonamiento adaptativo | reasoning effort medium |
| Sin razonamiento | thinking: {"type": "disabled"}, con effort high o inferior | reasoning effort none |
| Niveles disponibles | effort; Anthropic recomienda bajarlo antes que desactivar el razonamiento | none, low, medium, high, xhigh, max |
| Razonamiento de turnos anteriores | se conserva por defecto y se cobra como entrada | no figura en la ficha del modelo |
Los niveles con el mismo nombre no hacen el mismo trabajo en los dos modelos: low en Haiku y low en Luna producen cantidades de razonamiento muy distintas. Compáralos por resultado y por coste, no por etiqueta.
Coste por tarea a calidad parecida: la diferencia se estrecha
Comparar nivel con nivel favorece a Luna en coste y a Haiku en puntuación. Los datos de Artificial Analysis (Intelligence Index v4.3.2, diez evaluaciones, publicados un día después del lanzamiento de Haiku 5.5) quedan así:
| Mismo nivel en los dos | Índice Haiku / Luna | Coste por tarea Haiku / Luna | Tokens de salida por tarea Haiku / Luna |
|---|---|---|---|
| Low | 29 / 22 | 0,02 $ / 0,0045 $ | 17.000 / 2.000 |
| Medium (por defecto en ambos) | 34 / 30 | 0,05 $ / 0,02 $ | 33.000 / 11.000 |
| High | 38 / 33 | 0,08 $ / 0,03 $ | 55.000 / 20.000 |
| Max | 43 / 38 | 0,21 $ / 0,07 $ | sin dato fiable |
La fila Max procede de la comparación general de Artificial Analysis, que muestra ese nivel por defecto; es la menos firme de la tabla y puede revisarse.
Si cruzas los niveles para comparar resultados parecidos, la ventaja de Luna se reduce mucho:
- Haiku en Low (índice 29) frente a Luna en Medium (30): 0,02 $ por tarea en ambos.
- Haiku en Medium (34) frente a Luna en High (33): 0,05 $ frente a 0,03 $.
- Haiku en High (38) frente a Luna en Max (38): 0,08 $ frente a 0,07 $.
La latencia también depende de cómo compares. A igual etiqueta, Luna da antes el primer token (3,05 s frente a 9,93 s en Low; 21,08 s frente a 28,01 s en High), aunque Haiku escribe más rápido una vez arranca (178 frente a 121 tokens por segundo en Low). A puntuación parecida, Haiku en High tarda 28 s en dar el primer token y Luna en Max, 111 s.
Lee estas cifras como guía para diseñar tu prueba, no como resultado para tu caso. Es una única metodología externa, medida justo después del lanzamiento; el coste por tarea de Haiku aparece marcado con un asterisco, así que conviene leer la nota de la página antes de usar esa cifra, y el índice incluye una prueba de contexto largo en la que algunas peticiones podrían haber cruzado los 100.000 tokens. El índice no es tu tarea: una clasificación con salida de diez tokens y razonamiento desactivado no se parece a una evaluación de diez pruebas variadas.
Los gráficos de Anthropic en el anuncio de Haiku 5.5 dan a Haiku ventajas grandes (39,2 % en Terminal-Bench 4.0, frente al 16,4 % que la prensa atribuye a Luna en el mismo gráfico), pero son resultados publicados por el propio fabricante.
Cómo calcular tu factura antes de elegir entre Haiku 5.5 y Luna
Con tus propios registros puedes llegar a una frase del tipo «para mi tráfico sale más barato X, salvo que…» en una tarde. El orden que evita sorpresas:
- Mide la distribución de tamaños de prompt, no la media. Calcula qué parte de tus peticiones pasa de 100.000 tokens contando con el tokenizador de Haiku 5.5 (el contador de tokens de Anthropic acepta
model=claude-haiku-5-5). Incluye el prompt de sistema, las definiciones de herramientas, los resultados de herramientas y el historial. Si esa parte es cero y no va a crecer, el tramo caro no te afecta. - Recuenta el mismo texto en Luna. Con una muestra real, compara los tokens de entrada que devuelve cada API. Sin ese dato, cualquier comparación da por hecho que los dos tokenizadores cuentan igual, y no hay fuente que lo confirme.
- Mide salida y razonamiento por tarea completada. Ejecuta un lote de tareas reales en cada modelo y suma todos los tokens de salida, razonamiento incluido, de las tareas que salen bien. Divide el coste entre tareas aceptadas, no entre peticiones.
- Prueba al menos dos niveles por modelo. Haiku en effort bajo frente a Luna en
medium, y Haiku enmediumfrente a Luna enhigh, por ejemplo. Elige el par que alcanza tu umbral de calidad con menos coste por tarea aceptada. - Simula las sesiones largas. Para agentes y chats, suma el coste turno a turno con la fórmula de arriba, aplicando el tramo de cada turno, y repítelo con caché, con compactación y con el razonamiento conservado de Haiku.
- Decide qué trabajo puede ir en lote. Batch rebaja un 50 % en los dos; si el trabajo admite espera, es la palanca más grande que tienes, pero no elimina el tramo caro de Haiku.
Con esos datos, la conclusión suele caer en uno de estos casos:
- Casi todo por debajo de 100.000 tokens y salida corta: la diferencia la marcan el tokenizador y el razonamiento. Si Haiku resuelve con razonamiento bajo o desactivado lo que Luna necesita en
medium, Haiku puede salir igual o más barato; si necesitas el mismo nivel en los dos, ten en cuenta que en las pruebas de Artificial Analysis Luna generó con la misma etiqueta entre casi tres y más de ocho veces menos salida. - Una parte apreciable por encima de 100.000: Luna, salvo que puedas mantener Haiku por debajo del umbral con compactación o troceando el contexto.
- Agentes de muchos turnos: Luna por defecto; Haiku solo si controlas el tamaño del contexto y la calidad de Haiku te ahorra reintentos.
La conclusión cambia si tu prueba muestra que uno de los dos necesita reintentos o revisión humana en una parte de las tareas: el coste de un fallo suele ser mayor que la diferencia de tarifa. Y si ninguno de los dos alcanza tu nivel de calidad, el paso siguiente es un modelo mayor, con otras cuentas: Claude Opus 5.5: precio, disponibilidad y qué falla al migrar y GPT-6.1 Sol vs Opus 5.5: comparativa de precio y coste por tarea.
Si vienes de Haiku 4.5: el 90 % de rebaja y sus condiciones
Anthropic anuncia Haiku 5.5 como un 90 % más barato que Haiku 4.5 para peticiones de hasta 100.000 tokens y un 50 % más barato por encima. Por token es exacto: Haiku 4.5 cobra 1 $ de entrada y 5 $ de salida por millón. Pero el mismo texto ocupa en torno a un 30 % más de tokens en Haiku 5.5, por eso la propia Anthropic habla de un ahorro medio de alrededor del 75 % en su tráfico, no del 90 %.
Un ejemplo con esa proporción: un prompt que en Haiku 4.5 medía 10.000 tokens pasa a unos 13.000 en Haiku 5.5. Con 500 tokens de salida, la petición baja de 0,0125 $ a 0,00155 $, en torno a un 88 % menos. El umbral también se desplaza: 100.000 tokens de Haiku 5.5 equivalen a unos 76.900 tokens contados como en Haiku 4.5. Si tus prompts rondaban los 80.000 tokens en Haiku 4.5, ahora pueden caer en el tramo caro.
Antes de cambiar el identificador del modelo, revisa también lo que la guía de migración a Haiku 5.5 marca como incompatible: valores no predeterminados de temperature, top_p o top_k y el relleno previo de la respuesta del asistente devuelven error 400, y los clasificadores de seguridad pueden cortar una petición con stop_reason: "refusal". El razonamiento activado por defecto también cuenta para max_tokens. A 8 de octubre de 2026, Haiku 4.5 sigue activo y su retirada no será antes del 15 de octubre de 2026, según la página de retirada de modelos; comprueba esa página antes de planificar una migración con margen.
Preguntas frecuentes sobre Haiku 5.5 y GPT-6 Luna
¿Qué pasa con el precio de Claude Haiku 5.5 por encima de 100.000 tokens?
Si el prompt tiene más de 100.000 tokens, toda la petición paga el tramo caro: 0,50 $ de entrada, 2,50 $ de salida y 0,05 $ de lectura de caché por millón, cinco veces la tarifa baja. Con 100.000 tokens exactos sigues en el tramo bajo. Anthropic no aclara si los tokens leídos de caché cuentan para el umbral, así que conviene calcular como si contaran.
¿Cuál es mejor, Claude Haiku 5.5 o GPT-6 Luna?
En el índice de Artificial Analysis, Haiku puntúa más que Luna en cada nivel de esfuerzo (34 frente a 30 en Medium), pero genera bastante más salida por tarea (33.000 frente a 11.000 tokens en Medium). Si comparas resultados parecidos, el coste por tarea se acerca. Para una clasificación o una extracción concreta, solo una prueba con tus datos dice cuál acierta más por cada dólar gastado.
¿Se pueden usar las API de Haiku 5.5 y GPT-6 Luna desde España?
Sí: España figura en las listas de países admitidos de la API de Anthropic y de la API de OpenAI. Los precios de arriba están en dólares y sin impuestos; para la compra de créditos y el IVA, consulta Créditos de Claude API: cómo comprarlos, cuánto cuestan y el IVA. Haiku 5.5 también está en Amazon Bedrock, Google Cloud y Microsoft Foundry, pero allí cada plataforma fija su propio precio.
¿El descuento de Batch es igual en Haiku 5.5 y en GPT-6 Luna?
Sí, los dos rebajan un 50 % el procesamiento por lotes: Haiku queda en 0,05 $ y 0,25 $ por millón hasta 100.000 tokens de prompt, y Luna, en las mismas cifras en su tramo corto. Luna ofrece también Flex al mismo precio que Batch y Fast al doble del estándar. Haiku 5.5 no admite Priority Tier, y fijar la inferencia solo en EE. UU. con inference_geo multiplica sus tarifas por 1,1.