A 14 de octubre de 2026 ya puedes usar los tres modelos. Gemini 4 Argon (gemini-4-argon) tiene disponibilidad general desde el 13 de octubre: en el nivel de pago de la API de Gemini, en la app de Gemini y el Modo IA de la Búsqueda con Google AI Pro o Ultra, en Google Antigravity con AI Ultra y en GitHub Copilot con los planes Pro+, Max, Business y Enterprise. No tiene nivel gratuito. Frente a los dos Claude, lo que decide es la fecha en que pagues:
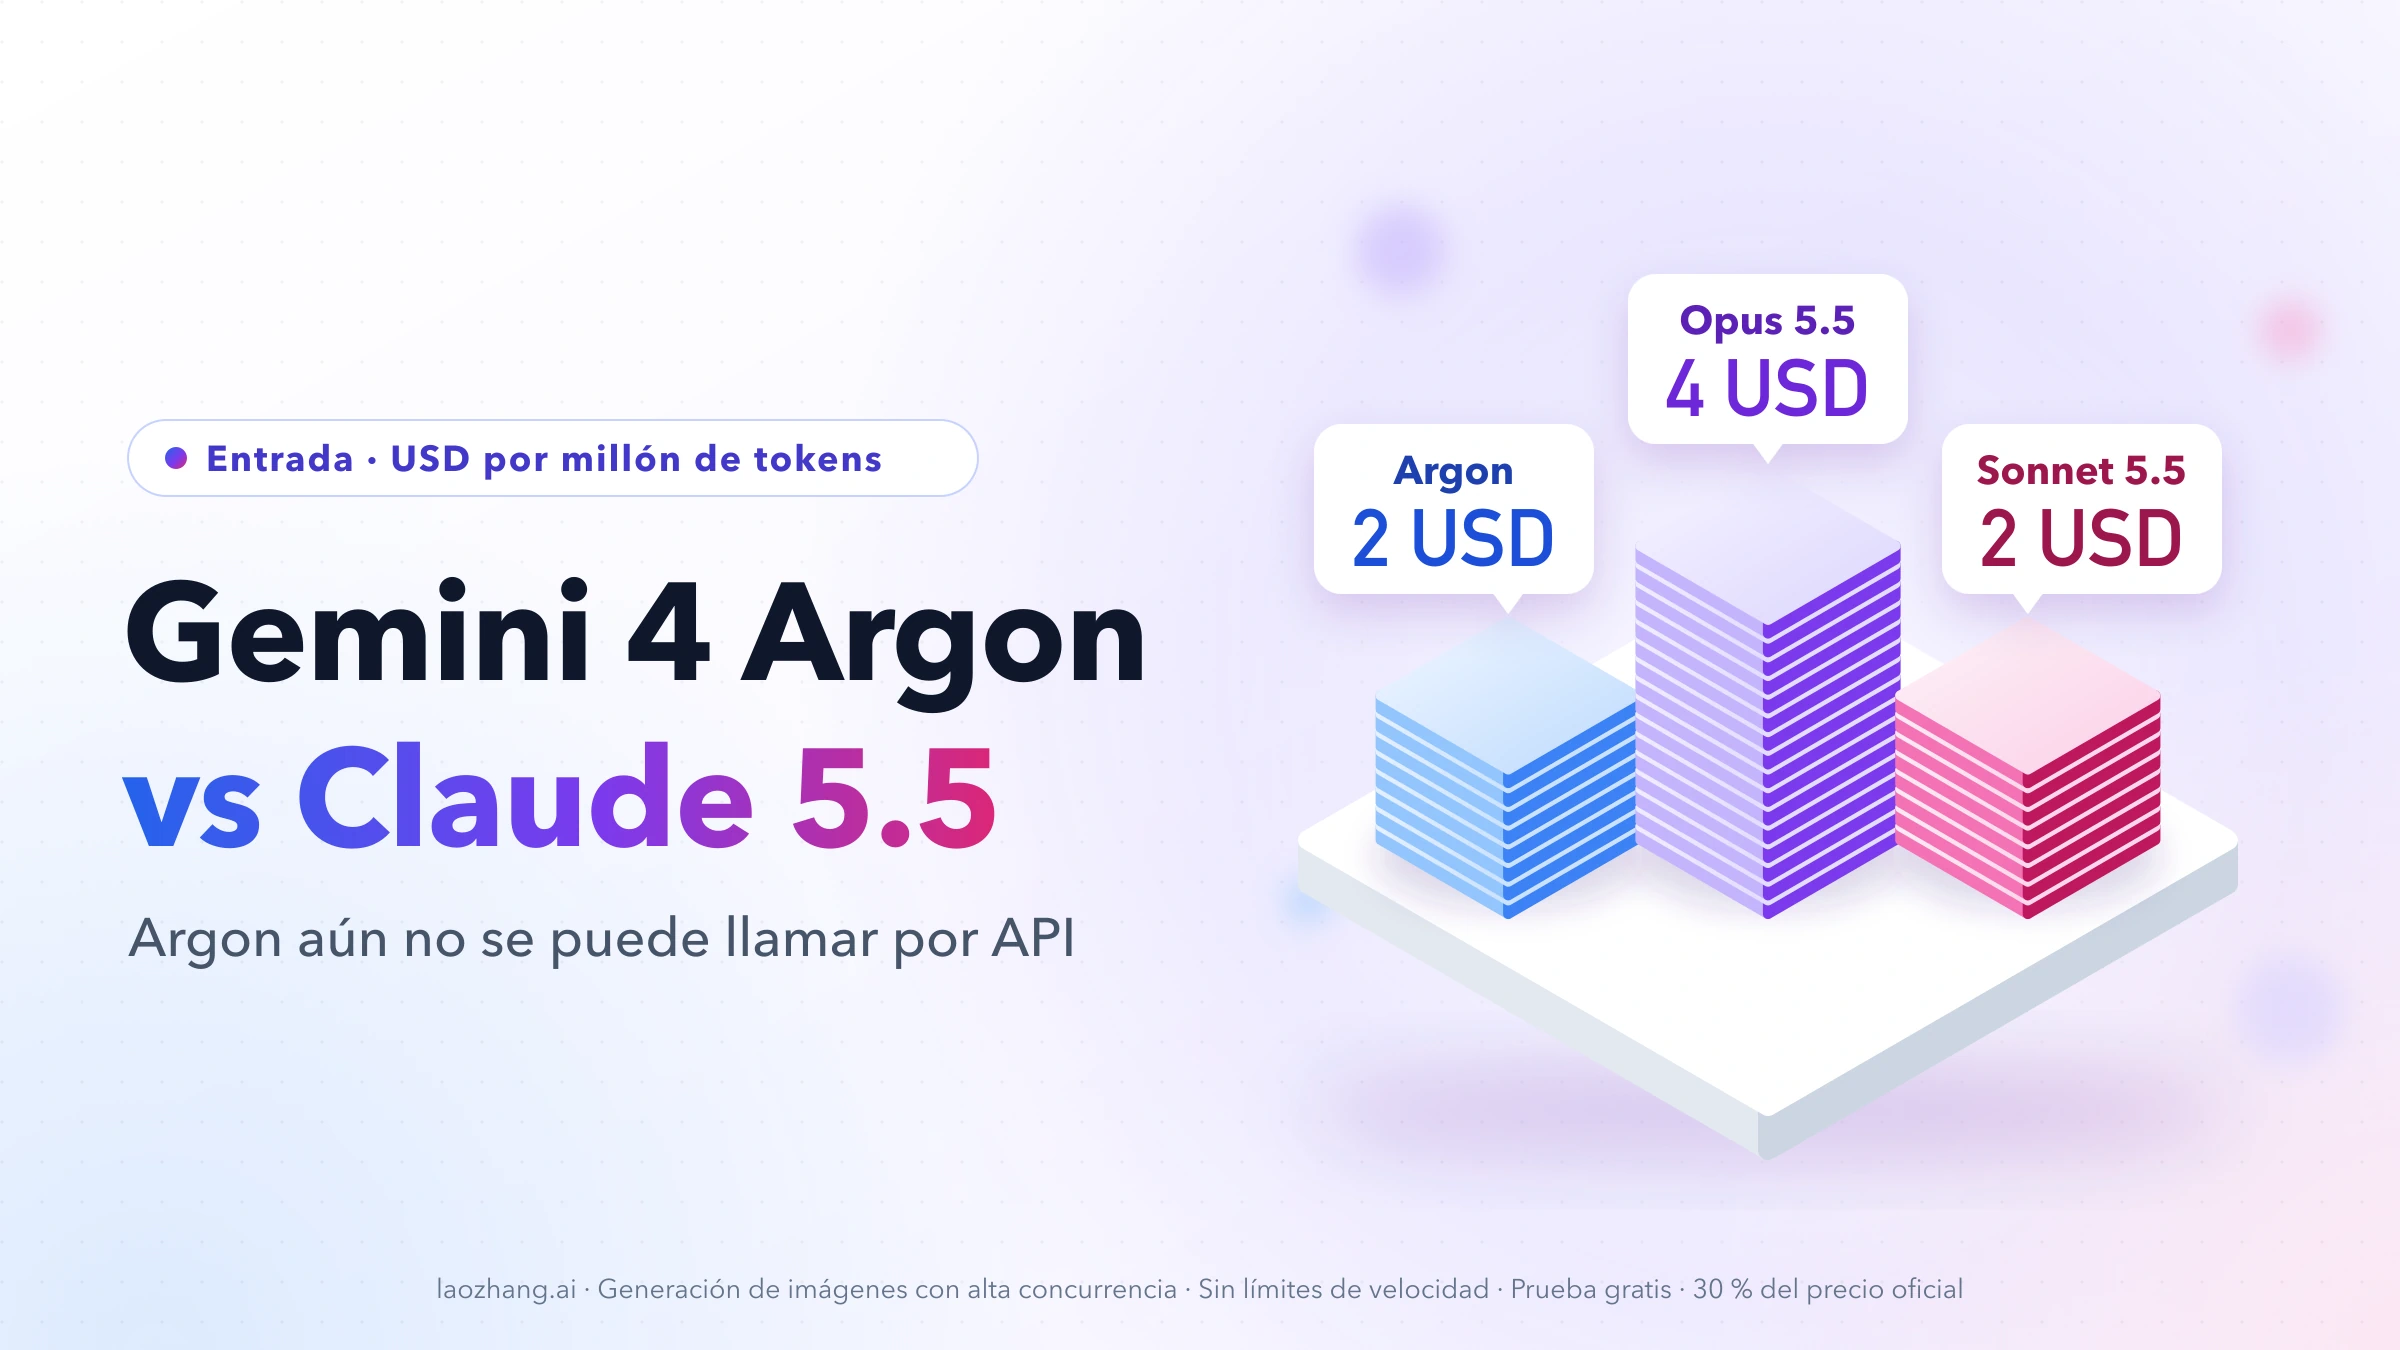
- Hasta el 30 de noviembre de 2026, Argon cuesta en la API lo mismo que Claude Sonnet 5.5 (
claude-sonnet-5-5): 2 USD por millón de tokens de entrada, 10 USD de salida y 0,10 USD la lectura de caché. - Desde el 1 de diciembre de 2026 pasa a 4, 20 y 0,20 USD, la tarifa exacta de Claude Opus 5.5 (
claude-opus-5-5).
Con eso, la elección queda así:
- Sonnet 5.5 sigue siendo el punto de partida para tareas bien acotadas: generar código, analizar datos, redactar, usar herramientas.
- Opus 5.5 compensa en trabajo largo y abierto: agentes de programación que corren durante horas, refactorizaciones grandes, uso del ordenador.
- Argon merece una prueba con tus propias tareas mientras cueste como Sonnet 5.5. En Vals Index va primero con un 68,9 %, pero en el índice de Artificial Analysis queda por detrás de los dos Claude; con dos clasificaciones que se contradicen, quien decide es tu lote de tareas, no la tabla.
Las cifras de rendimiento que aparecen más abajo las publican Google, Anthropic, Vals y Artificial Analysis; cada una va con quién la midió y en qué condiciones, porque eso cambia lo que permite afirmar.
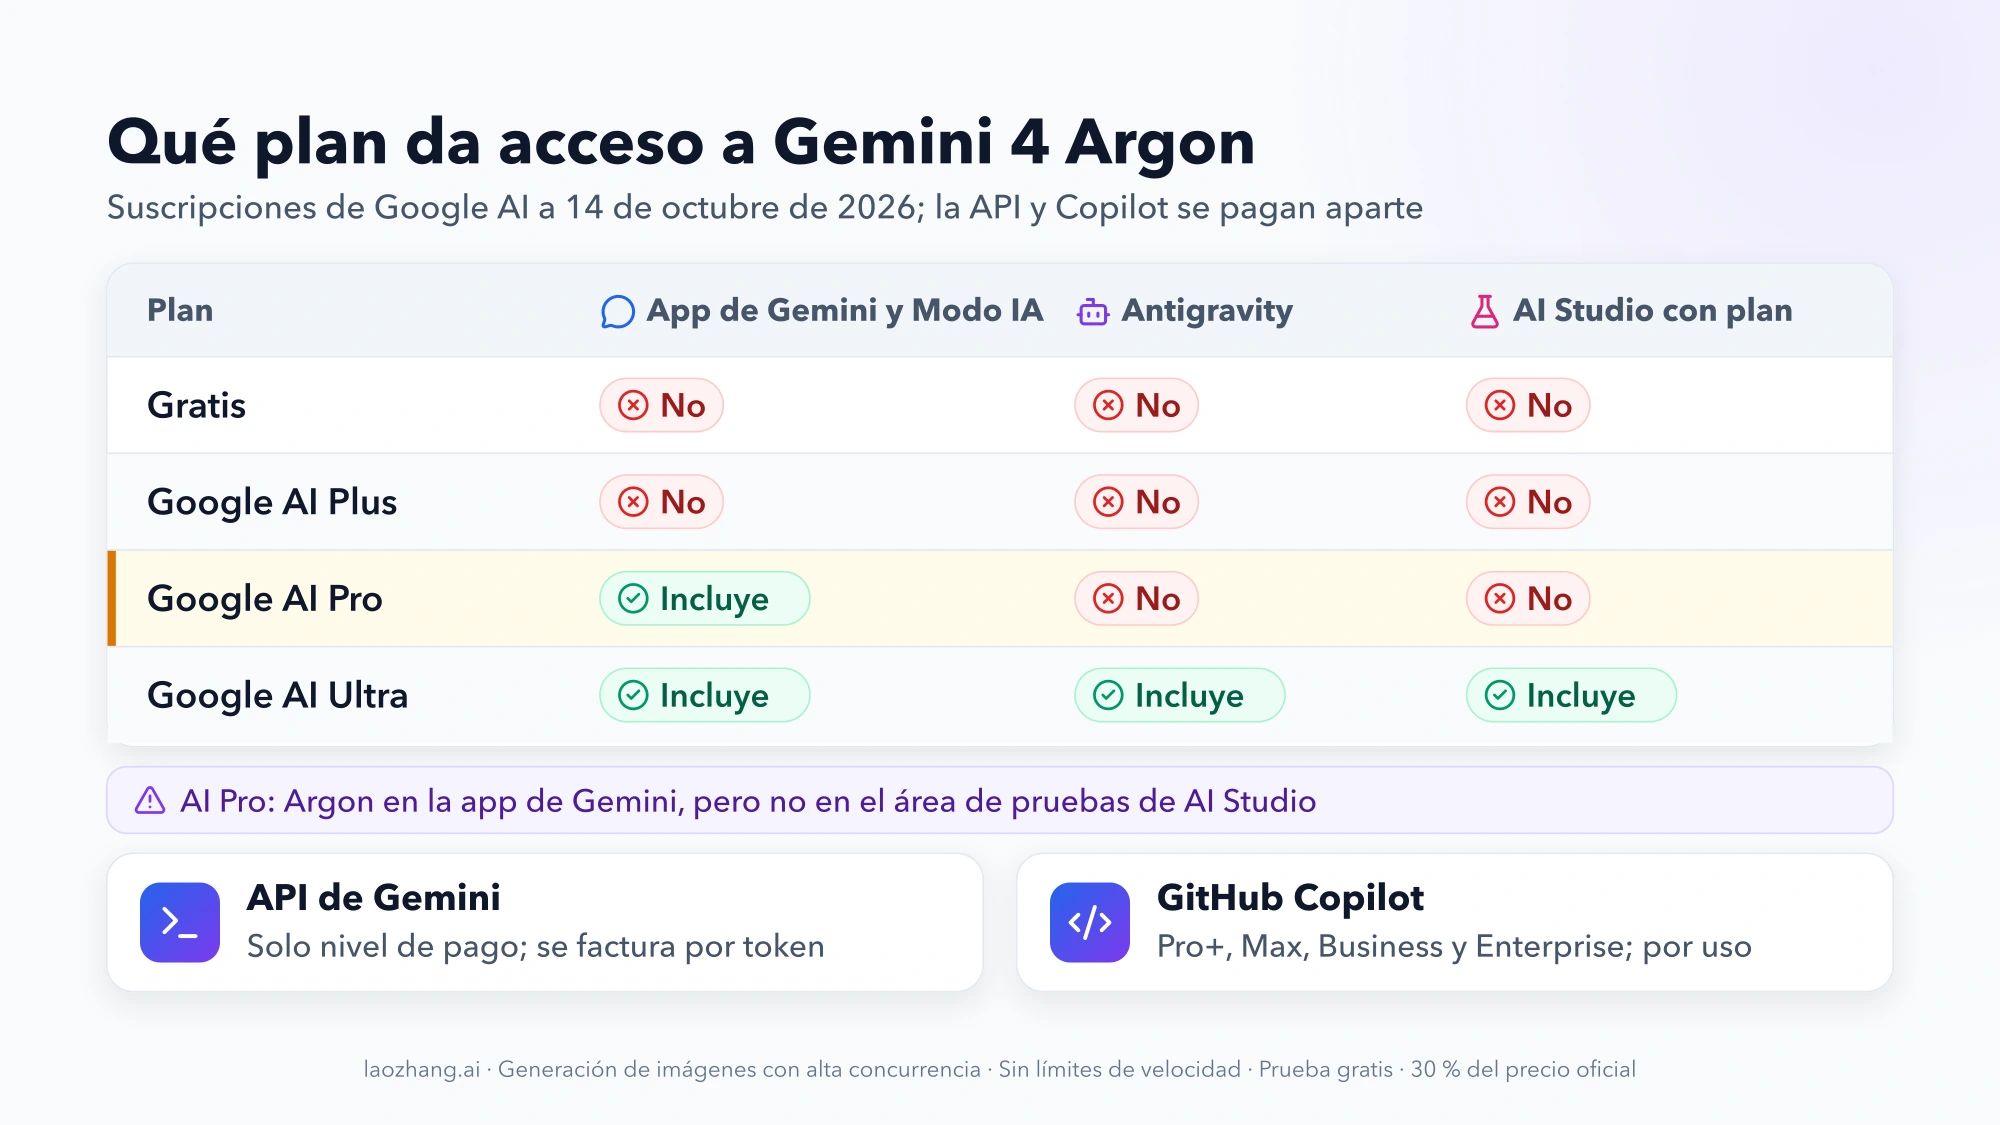
Dónde usar Gemini 4 Argon desde el 13 de octubre y con qué plan
Google lo anunció el 30 de septiembre solo para los equipos de ciberdefensa de su programa Fairwind y lo abrió el 13 de octubre: el registro de cambios de la API de Gemini lo marca como disponibilidad general y la ficha del modelo como versión estable. El despliegue es gradual, así que puede tardar unos días en aparecer en tu cuenta.
| Dónde | Qué necesitas | Cómo se paga Argon |
|---|---|---|
| API de Gemini (claves de Google AI Studio) | Nivel de pago activado | Por token, con la tarifa de abajo; el nivel gratuito no incluye Argon |
| App de Gemini y Modo IA de la Búsqueda | Google AI Pro o Google AI Ultra | Dentro de la suscripción; el plan gratuito usa Flash-Lite y Google AI Plus tampoco lo incluye |
| Google Antigravity | Google AI Ultra | Dentro de la suscripción |
| Área de pruebas de AI Studio con un plan de Google AI | Solo Google AI Ultra | Dentro de la suscripción; AI Pro no da acceso a Argon aquí |
| GitHub Copilot (VS Code, Visual Studio, Copilot CLI, agente de código, JetBrains, Xcode, Eclipse) | Copilot Pro+, Max, Business o Enterprise | Facturación por uso al precio de lista del proveedor; Copilot Free y Pro no lo tienen |
| Android Studio | Nivel de pago de la API de Gemini | Por token, como en la API |
| Gemini for business | Contrato de empresa | Según tu contrato |
La fila que más confunde es la de AI Pro. En la app de Gemini, AI Pro incluye Argon (19,99 USD al mes en la página de planes de EE. UU.; en otros países el precio cambia). En cambio, la página de precios de la API avisa de que Argon «no está disponible en el nivel gratuito ni en el plan Google AI Pro», y ahí se refiere al plan de AI Studio: según la documentación de los planes de Google AI en AI Studio, esas ventajas solo valen dentro de la interfaz web de AI Studio, donde Argon queda reservado a Ultra. Las llamadas con clave de API se facturan aparte, sea cual sea tu suscripción.
En Copilot, Argon entra en la facturación por uso, pero el anuncio de GitHub no aclara si aplica la tarifa de lanzamiento o la de diciembre. En empresas, los administradores de Business y Enterprise lo controlan desde la política de modelos; por defecto, los modelos nuevos quedan activados.
Si te basta un modelo de Google más barato y con nivel gratuito, el más reciente de la familia Flash es Gemini 3.8 Flash (gemini-3.8-flash), a 0,75 USD de entrada y 3,75 USD de salida por millón de tokens hasta el 31 de diciembre de 2026 y 1,50 y 7,50 USD desde el 1 de enero de 2027. Su ficha está en Gemini 3.8 Flash API: ID, precios, límites y migración.
Ficha de los tres modelos: ID, contexto de 1 millón y salida máxima
| Gemini 4 Argon | Claude Opus 5.5 | Claude Sonnet 5.5 | |
|---|---|---|---|
| Lanzamiento | Anuncio el 30 de septiembre de 2026; disponibilidad general el 13 de octubre | 22 de septiembre de 2026 | 28 de septiembre de 2026 |
| ID de modelo | gemini-4-argon | claude-opus-5-5 | claude-sonnet-5-5 |
| Otras plataformas | App de Gemini, Modo IA, Antigravity, GitHub Copilot, Android Studio | Amazon Bedrock (anthropic.claude-opus-5-5), Google Cloud, Microsoft Foundry, Claude Platform on AWS | Amazon Bedrock (anthropic.claude-sonnet-5-5), Google Cloud, Microsoft Foundry, Claude Platform on AWS |
| Ventana de contexto | 1.048.576 tokens, compartidos entre entrada y salida | 1 millón de tokens | 1 millón de tokens |
| Salida máxima | 65.536 tokens por defecto; hasta 1.048.576 con salida larga (long decode) | 128.000 tokens (llamada síncrona) | 128.000 tokens (llamada síncrona) |
| Entrada y salida | Texto, imagen, vídeo, audio y PDF; salida de texto | Texto e imágenes; salida de texto | Texto e imágenes; salida de texto |
| Caché | Solo implícita | Explícita, con escritura de pago | Explícita, con escritura de pago |
| Control del razonamiento | Niveles de pensamiento low, medium y high | Effort, medium por defecto | Effort, high por defecto |
| Latencia según el fabricante | Sin publicar | Moderada | Rápida |
El límite de 1 millón de Argon no es solo de entrada: entrada y salida comparten los 1.048.576 tokens, de modo que un prompt de 900.000 tokens deja unos 148.000 para la respuesta. Pasar de los 65.536 tokens de salida exige el protocolo de continuación que Google describe para la salida larga; sin él, la respuesta se corta en ese límite.
Los datos de los dos Claude salen de la tabla de modelos de Anthropic. Que una nube los ofrezca no garantiza que tu cuenta o tu región ya los tengan activados: compruébalo en el catálogo de esa consola antes de dar por hecho el acceso.
Qué Claude usar: Sonnet 5.5 para lo acotado, Opus 5.5 para lo largo
La regla corta: empieza por Sonnet 5.5 si la tarea tiene un alcance claro y pasa a Opus 5.5 cuando el trabajo sea largo, abierto o dependa de mucha autonomía. Argon entra en la comparación como alternativa a cualquiera de los dos, con la condición de que lo pruebes antes de cambiar.
| Tu caso | Empieza por | Por qué |
|---|---|---|
| Generación de código con alcance definido, análisis de datos, redacción, comprensión de imágenes, agentes que encadenan herramientas | Sonnet 5.5 | Mitad de precio por token que Opus 5.5, latencia «rápida» y resultados casi iguales en trabajo profesional general |
| Agentes de programación autónomos de varias horas, refactorizaciones a gran escala, ingeniería de sistemas compleja, flujos con mucha visión, uso del ordenador | Opus 5.5 | Son los usos que Anthropic le asigna, y donde mantiene ventaja en sus propias pruebas de código difícil |
| Ya usas Opus 5.5 y te preocupa la factura | Opus 5.5 con otro nivel de effort, y Argon como prueba | Anthropic indica que ajustar effort suele dar más resultado que cambiar de modelo; Argon cuesta la mitad hasta el 30 de noviembre |
| Necesitas más de 128.000 tokens de salida en una sola respuesta, o vídeo y audio como entrada | Argon | Es el único de los tres con salida larga hasta 1.048.576 tokens y entrada de vídeo y audio |
Esta regla se apoya en dos fuentes de Anthropic que conviene leer juntas. La guía de elección de modelo dice que la mayoría de las cargas de trabajo empiezan por Opus 5.5 y reserva Sonnet 5.5 para generación de código, análisis de datos, creación de contenido, comprensión visual y uso de herramientas en agentes. El anuncio de Sonnet 5.5 lo presenta para «tareas cotidianas bien acotadas» y añade que, en trabajo complejo y abierto, Opus 5.5 «sigue siendo claramente más fuerte». Las dos coinciden en el reparto; la diferencia está en por cuál empezar, y ahí el precio inclina la balanza: Sonnet 5.5 cuesta la mitad por token, también en la lectura de caché, y en Vals Index queda a 0,07 puntos de Opus 5.5 con dos tercios de su coste por prueba.
Si la duda es cuánto effort poner en Opus 5.5 antes de plantearte el cambio, Effort en Claude Opus 5.5: qué nivel elegir y cómo medir si compensa lo desarrolla. Y si en la decisión entran también Fable 5.1 o Haiku, la comparación dentro de la gama está en Claude Opus 5.5 o Fable 5.1: cuál elegir y cuánto cuesta en la API.
Antes de cambiar el nombre del modelo en código que ya funciona, ten en cuenta que los dos Claude 5.5 rechazan con un error 400 el uso forzado de herramientas (tool_choice con any o tool) y la herramienta de ordenador antigua computer_20251124 en la API de Claude y en Google Cloud. Ninguno acepta thinking: {"type": "disabled"}; Sonnet 5.5 admite en su lugar thinking: {"type": "between_tools"}, que suprime el pensamiento inicial y solo funciona con effort low, medium o high. El detalle de cada cambio está en Claude Opus 5.5: precio, disponibilidad y qué falla al migrar. Pasar de Claude a Argon es otra migración distinta: cambian la API y el SDK, el control del razonamiento (niveles de pensamiento en lugar de effort) y la caché, que en Argon no se configura.
Precios: Argon iguala a Sonnet 5.5 hasta noviembre y a Opus 5.5 después
Precios oficiales en dólares por millón de tokens, sin impuestos, a 14 de octubre de 2026. Los de Claude son los de la API directa según la página de precios de Anthropic; los de Argon, los del nivel de pago de la API de Gemini.
| Concepto | Sonnet 5.5 | Opus 5.5 | Argon hasta el 30/11/2026 | Argon desde el 1/12/2026 |
|---|---|---|---|---|
| Entrada | 2 USD | 4 USD | 2 USD | 4 USD |
| Salida (incluido el pensamiento) | 10 USD | 20 USD | 10 USD | 20 USD |
| Lectura de caché | 0,10 USD | 0,20 USD | 0,10 USD | 0,20 USD |
| Escritura de caché (5 minutos / 1 hora) | 2,50 / 4 USD | 5 / 8 USD | Solo caché implícita | Solo caché implícita |
| Batch, entrada / salida | 1 / 5 USD | 2 / 10 USD | 1 / 5 USD | 2 / 10 USD |
| Prioridad, entrada / salida | No aplica | No aplica | 3,60 / 18 USD | 7,20 / 36 USD |
La tabla se lee en dos columnas pareadas. Hasta el 30 de noviembre, Argon y Sonnet 5.5 cobran lo mismo en entrada, salida, lectura de caché y Batch; desde el 1 de diciembre, Argon y Opus 5.5 coinciden en esas mismas cuatro filas. La lectura de caché cuesta en todos los casos un 95 % menos que la entrada, y Argon no tiene un precio aparte para contexto largo: la misma tarifa vale en toda la ventana de 1 millón.
Dos diferencias no salen en el precio por token. Claude cobra la escritura de caché (1,25 veces la entrada a 5 minutos, 2 veces a 1 hora), mientras que Argon no la cobra pero tampoco te deja decidir qué se guarda: la caché implícita se aplica de forma automática y sin garantía de acierto. Y solo Opus 5.5 tiene modo rápido, en vista previa de investigación y solo en la API de Claude, a 8 y 40 USD. En Bedrock y Google Cloud los precios de Claude los fija cada nube, y la inferencia limitada a EE. UU. multiplica la tarifa por 1,1.
Ejemplo A: mismos tokens, sin caché
Supón una tarea con 100.000 tokens de entrada y 20.000 de salida. El coste es entrada en millones × precio de entrada + salida en millones × precio de salida:
| Modelo | Cálculo | Coste |
|---|---|---|
| Sonnet 5.5 | 0,1 × 2 + 0,02 × 10 | 0,40 USD |
| Opus 5.5 | 0,1 × 4 + 0,02 × 20 | 0,80 USD |
| Argon hasta el 30 de noviembre | 0,1 × 2 + 0,02 × 10 | 0,40 USD |
| Argon desde el 1 de diciembre | 0,1 × 4 + 0,02 × 20 | 0,80 USD |
Ejemplo B: un turno de agente con mucha caché
Ahora un turno con 200.000 tokens leídos de caché, 20.000 de entrada nueva y 5.000 de salida:
| Modelo | Cálculo | Coste |
|---|---|---|
| Sonnet 5.5 | 0,2 × 0,10 + 0,02 × 2 + 0,005 × 10 = 0,02 + 0,04 + 0,05 | 0,11 USD |
| Opus 5.5 | 0,2 × 0,20 + 0,02 × 4 + 0,005 × 20 = 0,04 + 0,08 + 0,10 | 0,22 USD |
| Argon hasta el 30 de noviembre | 0,2 × 0,10 + 0,02 × 2 + 0,005 × 10 = 0,02 + 0,04 + 0,05 | 0,11 USD |
| Argon desde el 1 de diciembre | 0,2 × 0,20 + 0,02 × 4 + 0,005 × 20 = 0,04 + 0,08 + 0,10 | 0,22 USD |
Con la lectura de caché de Sonnet 5.5 a 0,10 USD, Sonnet cuesta exactamente la mitad que Opus 5.5 también en un turno con mucha caché, y Argon reproduce los dos importes según el periodo: 0,11 USD hasta el 30 de noviembre y 0,22 USD desde el 1 de diciembre. Para un agente que hoy corre en Opus 5.5, eso significa que probar Argon en noviembre cuesta la mitad, pero que a partir de diciembre la factura vuelve al nivel de Opus.
Los dos ejemplos suponen que los tres modelos consumen exactamente los mismos tokens, y eso no ocurre: el recuento cambia con el tokenizador, el nivel de effort o de pensamiento y la longitud de la respuesta, y el pensamiento se factura como salida. El ejemplo B, además, no incluye la escritura de caché que Claude cobra la primera vez y da por hecho que la caché implícita de Argon acierta en los 200.000 tokens. Tampoco entran herramientas ni impuestos. Sirven para sustituir tus propias cifras: toma del campo de uso de una respuesta real los tokens de entrada, de caché y de salida, y repite la cuenta con cada tarifa. Cómo leer ese campo en cada proveedor sin duplicar el pensamiento está en Tokens de razonamiento: cómo evitar contarlos dos veces en Gemini, OpenAI y Claude.
Qué dicen las pruebas y quién midió cada cifra
Hay cuatro juegos de cifras y no todos comparan a los mismos modelos. Vals y Artificial Analysis miden a los tres, y llegan a órdenes opuestos; Google compara a Argon con Opus 5.5 y deja fuera a Sonnet 5.5; Anthropic compara a sus dos modelos entre sí. Ningún fabricante ha publicado un cara a cara entre Argon y Sonnet 5.5.
Vals Index: los tres en la misma escala
Vals Index es una clasificación independiente que pondera tareas de finanzas, programación, derecho y fiscalidad según su peso económico. Versión 2.1, actualizada el 13 de octubre de 2026:
| Modelo | Puntuación | Coste por prueba | Tiempo |
|---|---|---|---|
| Gemini 4 Argon | 68,90 % | 15,68 USD | 46 min 33 s |
| Claude Sonnet 5.5 | 67,04 % | 21,34 USD | 1 h 18 min |
| Claude Opus 5.5 | 66,97 % | 32,14 USD | 1 h 19 min |
Lo que permite afirmar: en este conjunto de tareas, Argon va unos dos puntos por delante y termina antes y por menos dinero; Sonnet 5.5 y Opus 5.5 están empatados a efectos prácticos (0,07 puntos), con Sonnet a unos dos tercios del coste por prueba de Opus. Lo que no permite afirmar: que ese orden se mantenga en tu trabajo ni que sea estable. La tabla cambia cuando Vals repite ejecuciones, y una diferencia de 0,07 puntos puede invertirse en la siguiente, así que conviene citar estas cifras con su fecha. Vals tampoco explica con qué tarifa de Argon calcula el coste por prueba, así que no lo tomes como tu factura en ninguno de los dos periodos.
Artificial Analysis: los mismos tres, en orden contrario
El índice de inteligencia de Artificial Analysis (versión 4.3.2) también mide a los tres y los ordena al revés que Vals:
| Modelo y configuración | Índice | Coste de ejecutar el índice |
|---|---|---|
| Claude Opus 5.5 (Max) | 58 | 8.708 USD |
| Claude Sonnet 5.5 (Max) | 56 | 7.260 USD |
| Gemini 4 Argon (High) | 53 | 2.407 USD |
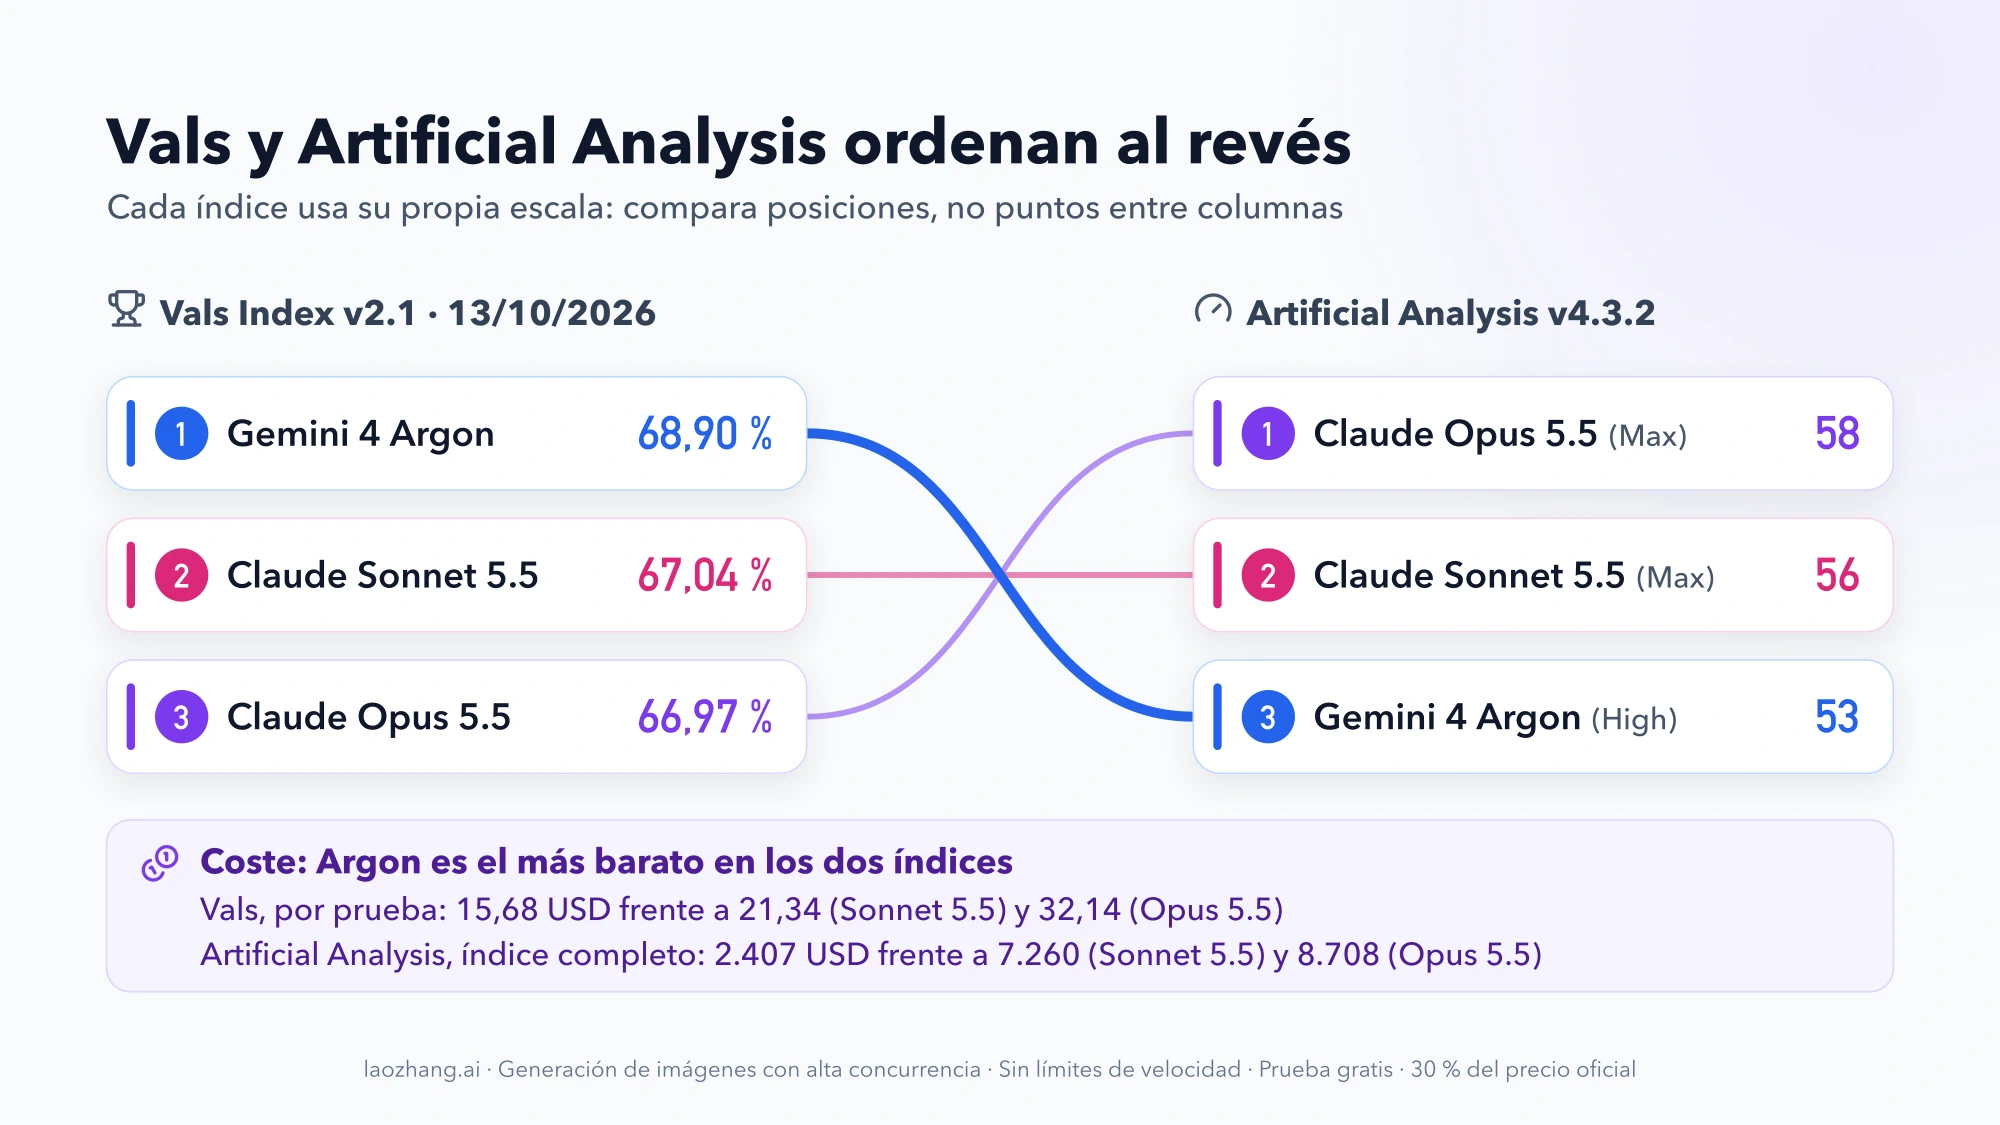
La configuración explica parte de la distancia: los dos Claude se midieron con el esfuerzo máximo y Argon con su nivel de pensamiento alto, y Artificial Analysis combina pruebas distintas de las de Vals. Lo que sí coincide en las dos clasificaciones es el coste: Argon completa la batería por bastante menos dinero que cualquiera de los Claude. Si una clasificación te dice que Argon gana y la otra que pierde, la conclusión útil es que la diferencia de calidad entre los tres es pequeña y depende de la tarea, y que el precio pesa más en la decisión.
La tabla de Google: Argon frente a Opus 5.5
Google publica en la página de modelos Gemini una tabla con Argon y Opus 5.5 en las mismas filas. Todas las cifras son porcentajes.
| Prueba | Gemini 4 Argon | Claude Opus 5.5 |
|---|---|---|
| Vals Index | 68,9 | 67,0 |
| AutomationBench | 51,3 | 42,5 |
| Vals Finance Agent v2 | 65,4 | 58,6 |
| Harvey Legal Agent Benchmark | 19,6 | 3,8 |
| DeepSWE v1.1 | 77,9 | 74,2 |
| Vibe Code Bench | 91,9 | 90,3 |
| LABBench 2 | 88,8 | 73,1 |
| RiemannBench | 76,0 | 69,6 |
| GraphWalks, hasta 128k | 99,7 | 90,6 |
| GraphWalks, de 256k a 1M | 84,2 | 66,8 |
| Agent's Last Exam | 39,5 | 38,2 |
| Chartography | 71,6 | 66,3 |
| LVBench | 91,7 | 83,7 |
| CWE-bench v1 | 68,0 | 67,0 |
| FrontierSWE v2 | 55,0 | 62,3 |
| Terminal-Bench 4.0 | 57,4 | 66,4 |
| PostTrainBench | 45,3 | 49,3 |
| Terminal-Bench Science 0.1 | 57,6 | 63,3 |
Argon queda por delante en 14 de las 18 filas, con las mayores distancias en contexto largo, agentes jurídicos, biología (LABBench 2) y automatización. Opus 5.5 gana las cuatro últimas, que miden programación autónoma, trabajo en terminal e ingeniería de aprendizaje automático.
Antes de sacar conclusiones, mira cómo se construyó la tabla, que Google detalla en su nota de metodología:
- Las pruebas las eligió Google, y Argon se ejecutó con el nivel de pensamiento más alto.
- Las cifras de Opus 5.5 proceden en su mayoría de lo que publica Anthropic o de las clasificaciones públicas, con el nivel de razonamiento máximo o el mejor disponible.
- En PostTrainBench, LABBench 2, GraphWalks y LVBench, Google ejecutó por su cuenta todos los modelos. En LVBench usó un número distinto de fotogramas para cada modelo «por limitaciones de la API», así que esa fila no compara en igualdad de condiciones.
- Varias cifras de Argon (DeepSWE, Terminal-Bench 4.0, Terminal-Bench Science, Agent's Last Exam) las calculó Google, mientras que las de los demás vienen de las clasificaciones públicas.
Es una tabla de fabricante: útil para saber dónde buscar diferencias y no como veredicto.
Las cifras de Anthropic: Sonnet 5.5 frente a Opus 5.5
| Prueba | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| Terminal-Bench 4.0 | 70,6 % | 66,4 % (con effort xhigh, su mejor resultado) |
| FrontierCode 1.1 | 46,2 % con max; 52,1 % con xhigh | 54,4 % |
| CursorBench 4.0 | 55,5 % | 57,8 % |
| GDPval-AA v2.1 | 1844 | 1846 |
| AA-Briefcase v1.1 | 1811 | 1822 |
| Humanity's Last Exam (con herramientas) | 64,5 % | 67,7 % |
| OSWorld 2.1 | 80,1 % | 81,8 % |
| Chartography (sin herramientas) | 61,6 % | 64,4 % |
Sonnet 5.5 solo gana en Terminal-Bench 4.0; en el resto Opus 5.5 va por delante, con poca distancia en trabajo de oficina (GDPval-AA, AA-Briefcase) y uso del ordenador, y con más en código difícil (FrontierCode). Encaja con la regla de arriba: para lo acotado, la diferencia de calidad es pequeña y la de precio es del doble.
Dos avisos al leer estas cifras. Anthropic dice que Sonnet 5.5 genera la salida más de un 30 % más rápido y cuesta hasta un 30 % menos por tarea, pero la comparación es con Sonnet 5, su predecesor, no con Opus 5.5 ni con Gemini. Y Chartography aparece con dos valores para Opus 5.5: 64,4 % en la tabla de Anthropic y 66,3 % en la de Google. Son ejecuciones o configuraciones distintas, así que el 61,6 % de Sonnet 5.5 solo se compara con el 64,4 %, y el 71,6 % de Argon solo con el 66,3 %.
Cuándo merece la pena probar Argon antes del 1 de diciembre
El periodo de lanzamiento es la ventana barata para medir: hasta el 30 de noviembre, una prueba con Argon cuesta lo mismo que con Sonnet 5.5 y la mitad que con Opus 5.5. Merece la pena dedicarle una tarde si te encuentras en alguno de estos casos:
- Pagas Opus 5.5 por tareas parecidas a las de Vals Index (finanzas, derecho, fiscalidad, programación). En esa clasificación, Argon puntúa dos puntos más con aproximadamente la mitad de coste por prueba.
- Trabajas con contextos muy largos. Es la fila con más distancia a favor de Argon en la tabla de Google: 84,2 % frente a 66,8 % en GraphWalks entre 256.000 y 1 millón de tokens, ejecutada por Google para ambos modelos. Recuerda que en Argon la respuesta sale del mismo presupuesto de 1.048.576 tokens.
- Necesitas salidas de más de 128.000 tokens en una sola respuesta, con el protocolo de continuación de la salida larga.
- Tus documentos llevan vídeo o audio, que Argon acepta como entrada y los dos Claude no.
Hay menos motivos para esperar un salto si lo tuyo es programación autónoma en terminal: en la propia tabla de Google, Opus 5.5 supera a Argon en Terminal-Bench 4.0 (66,4 % frente a 57,4 %) y en FrontierSWE v2 (62,3 % frente a 55,0 %). Y si ya usas Sonnet 5.5 y te funciona, cambiar a Argon no te ahorra nada hasta noviembre y te cuesta el doble desde diciembre, salvo que tus pruebas muestren que necesita menos tokens o menos intentos para terminar.
Para que la prueba sirva, usa un conjunto fijo de tareas tuyas, las mismas en cada modelo, en el canal al que tengas acceso: la API de pago si vas a integrarlo, la app de Gemini con AI Pro o Ultra si lo usas a mano, o Copilot si programas desde el editor. Compara el coste por tarea terminada con los tokens reales de cada respuesta, no el precio por token, y calcula ese coste dos veces, con la tarifa de noviembre y con la de diciembre. Si Argon solo gana con la primera, la decisión es para dos meses, no para el año.
Preguntas frecuentes sobre Argon, Opus 5.5 y Sonnet 5.5
¿Gemini 4 Argon es gratis?
No. La API de Gemini no tiene nivel gratuito para Argon, y tampoco lo incluyen el plan gratuito de la app de Gemini, Google AI Plus, el plan AI Pro de AI Studio ni Copilot Free o Pro. Para usarlo hay que pagar de una de tres formas: por token en la API, con una suscripción que lo incluya (Google AI Pro o Ultra) o con un plan de Copilot que lo admita, que lo cobra por uso. Las únicas vías sin coste son solicitudes con selección: Google ofrece a investigadores científicos seis meses gratis del nivel más alto de Antigravity, con plazas limitadas y selección, y los equipos de ciberdefensa pueden pedir acceso a Fairwind. Si buscas un modelo de Google gratuito para la API, la lista está en Gemini API gratis en 2026: modelos, límites y regla para España.
¿Dónde se puede usar Gemini 4 Argon?
Desde el 13 de octubre de 2026: en la API de Gemini con nivel de pago (AI Studio y Android Studio), en la app de Gemini y el Modo IA de la Búsqueda con Google AI Pro o Ultra, en Google Antigravity con AI Ultra, en GitHub Copilot con Pro+, Max, Business o Enterprise y en Gemini for business para empresas. El despliegue es gradual en todos los canales.
¿Se puede usar Gemini 4 Argon en la API o en la app de Gemini?
Sí, en las dos, con condiciones distintas. En la API necesitas el nivel de pago y pagas por token: 2 y 10 USD por millón hasta el 30 de noviembre, 4 y 20 USD desde el 1 de diciembre. En la app de Gemini lo tienes con Google AI Pro o Ultra, sin coste por token. Ojo con el nombre: el plan AI Pro de AI Studio no incluye Argon, aunque el de la app sí.
¿Qué es Claude Opus 5.5 y cuánto cuesta?
Es el modelo grande de la generación Claude 5.5 de Anthropic, por encima de Sonnet 5.5, lanzado el 22 de septiembre de 2026, con ID claude-opus-5-5, 1 millón de tokens de contexto y 128.000 de salida. En la API cuesta 4 USD por millón de tokens de entrada, 20 USD de salida y 0,20 USD la lectura de caché. Los cambios que rompen código al migrar están en Claude Opus 5.5: precio, disponibilidad y qué falla al migrar.
¿Qué modelo es más caro, Sonnet 5.5 u Opus 5.5?
Opus 5.5, el doble en todo: 4 USD de entrada y 20 USD de salida por millón de tokens frente a 2 y 10 USD, y 0,20 USD de lectura de caché frente a 0,10 USD.
¿Qué consume menos, Opus 5.5 o Sonnet 5.5?
En coste, Sonnet 5.5. En Vals Index completó la prueba por 21,34 USD frente a 32,14 USD de Opus 5.5, unos dos tercios, con una puntuación casi idéntica. Con los mismos tokens, la tarifa de Sonnet es la mitad tanto sin caché como con mucha lectura de caché (0,11 frente a 0,22 USD en el ejemplo B). La proporción real depende de cuántos tokens gaste cada uno en tu tarea.
¿Gemini 4 Argon es mejor que Claude Opus 5.5?
Depende de quién mida. En la tabla de Google va por delante en 14 de 18 pruebas y en Vals Index puntúa 68,9 % frente a 67,0 %; en el índice de Artificial Analysis, Opus 5.5 saca 58 frente a 53. Opus 5.5 gana también en la tabla de Google en Terminal-Bench 4.0, FrontierSWE v2, PostTrainBench y Terminal-Bench Science. Ya puedes comprobarlo con tu propio trabajo, y hasta el 30 de noviembre la prueba con Argon cuesta la mitad.
¿Cuánto cuesta Gemini 4 Argon y cuánto costará desde diciembre?
Hasta el 30 de noviembre de 2026, el precio de lanzamiento en la API es de 2 USD por millón de tokens de entrada, 10 USD de salida y 0,10 USD la entrada en caché. Desde el 1 de diciembre de 2026 pasa a 4, 20 y 0,20 USD. Batch y Flex cuestan la mitad (1 y 5 USD, luego 2 y 10 USD) y Prioridad, 3,60 y 18 USD, luego 7,20 y 36 USD. En la app de Gemini va incluido en Google AI Pro y Ultra; en Copilot se factura por uso a precio de lista.