Para una automatización repetitiva con un resultado fácil de comprobar, probaría primero GPT-6.1 Terra. Su tarifa de API permite ensayar ese trabajo con un menor coste por token. Si el problema exige encadenar decisiones difíciles, revisar código o reconciliar información contradictoria, incluiría Claude Opus 5.5 desde el primer ensayo: obtiene una puntuación superior en la evaluación independiente que veremos, aunque esa ventaja aún debe traducirse en mejores resultados con tus documentos y herramientas.
La diferencia de precio está clara: en las API directas y a tarifa Standard, Terra cobra 1 USD por millón de tokens de entrada y 5 USD por millón de salida hasta 272.000 tokens de entrada; Opus cobra 4 y 20 USD, respectivamente. La diferencia de calidad requiere más contexto. Estas cifras y las condiciones de este artículo se han comprobado el 28 de octubre de 2026 en las tarifas de OpenAI y las tarifas de Anthropic. No hemos realizado una prueba propia de los modelos.
Cuál probar primero según el trabajo
La forma más útil de elegir es fijar qué resultado vas a aceptar y cuánto cuesta corregir lo que salga mal. Estas son prioridades de prueba, no un reparto de capacidades demostrado para todas las empresas.
| Trabajo que quieres resolver | Por dónde empezaría | Qué tendría que ocurrir para cambiar |
|---|---|---|
| Extraer campos, clasificar documentos o preparar borradores que alguien revisa | Terra, con criterios de aceptación explícitos | Opus reduce las correcciones o los reintentos lo suficiente para compensar el gasto adicional |
| Analizar un problema con varias dependencias o modificar código en varios archivos | Una comparación directa con Opus desde el principio | Terra supera los mismos casos y comprobaciones con menos coste total |
| Leer pantallas y actuar en una aplicación | Una prueba del proceso completo, incluidas las herramientas | El modelo elegido no completa los pasos, pierde el estado o necesita demasiadas intervenciones |
| Procesar expedientes de más de 272.000 tokens de entrada | Recalcular ambos con las tarifas de contexto largo | Cambia la ventaja económica al incluir la salida, la caché y las correcciones |
| Redactar para clientes en español | Una revisión de textos reales con el mismo encargo | Uno obliga a rehacer más el tono, el significado o la terminología |
El motivo para incluir Opus en las tareas difíciles es la señal que ofrecen las evaluaciones, no una garantía de acierto. En acciones con consecuencias, como modificar registros, la revisión y los permisos forman parte del proceso con cualquiera de los dos modelos. Una puntuación más alta no sustituye esas comprobaciones.
Qué modelo estás contratando
Esta comparación trata de GPT-6.1 Terra, con el identificador gpt-6.1-terra. No deben trasladarse aquí los resultados o precios de GPT-6.1 Sol. En Anthropic, el identificador de la API directa es claude-opus-5-5.
| Especificación de la API directa | GPT-6.1 Terra | Claude Opus 5.5 |
|---|---|---|
| Entrada y salida nativas | Texto e imágenes → texto | Texto e imágenes → texto |
| Ventana de contexto | 1.050.000 tokens | 1.000.000 de tokens |
| Entrada máxima publicada | 922.000 tokens | Sujeta a la ventana de contexto |
| Salida máxima estándar | 128.000 tokens | 128.000 tokens |
| Esfuerzo de razonamiento por defecto | medium | medium |
| Control del razonamiento | none, low, medium, high, xhigh, max | Razonamiento adaptativo siempre activado; se ajusta con effort |
Fuentes: ficha de GPT-6.1 Terra y ficha de Claude Opus 5.5. El límite de salida de la tabla es el habitual; no incluye la opción beta de salida ampliada de Opus en Batch.
Que un expediente quepa en la ventana no demuestra que el modelo encuentre y relacione todos sus detalles. Para comparar documentos largos, incluye preguntas cuya respuesta dependa de información repartida por el expediente y comprueba las referencias. Y recibir imágenes tampoco equivale a generarlas: la salida nativa de estos modelos es texto; una herramienta de generación de imágenes es otra capacidad del sistema.
La cuenta de la API cambia al superar 272.000 tokens
Terra mantiene la tarifa inferior de entrada y salida hasta 272.000 tokens de entrada, incluidos. Al superarlos, toda la petición pasa a 2 USD por millón de entrada y 7,50 USD por millón de salida; las tarifas de caché también se duplican. No se aplica solo a la parte que excede el umbral. Opus 5.5 mantiene sus tarifas normales en toda su ventana de un millón de tokens, sin suplemento por contexto largo. Así lo recogen la ficha de Terra y los precios de Claude.
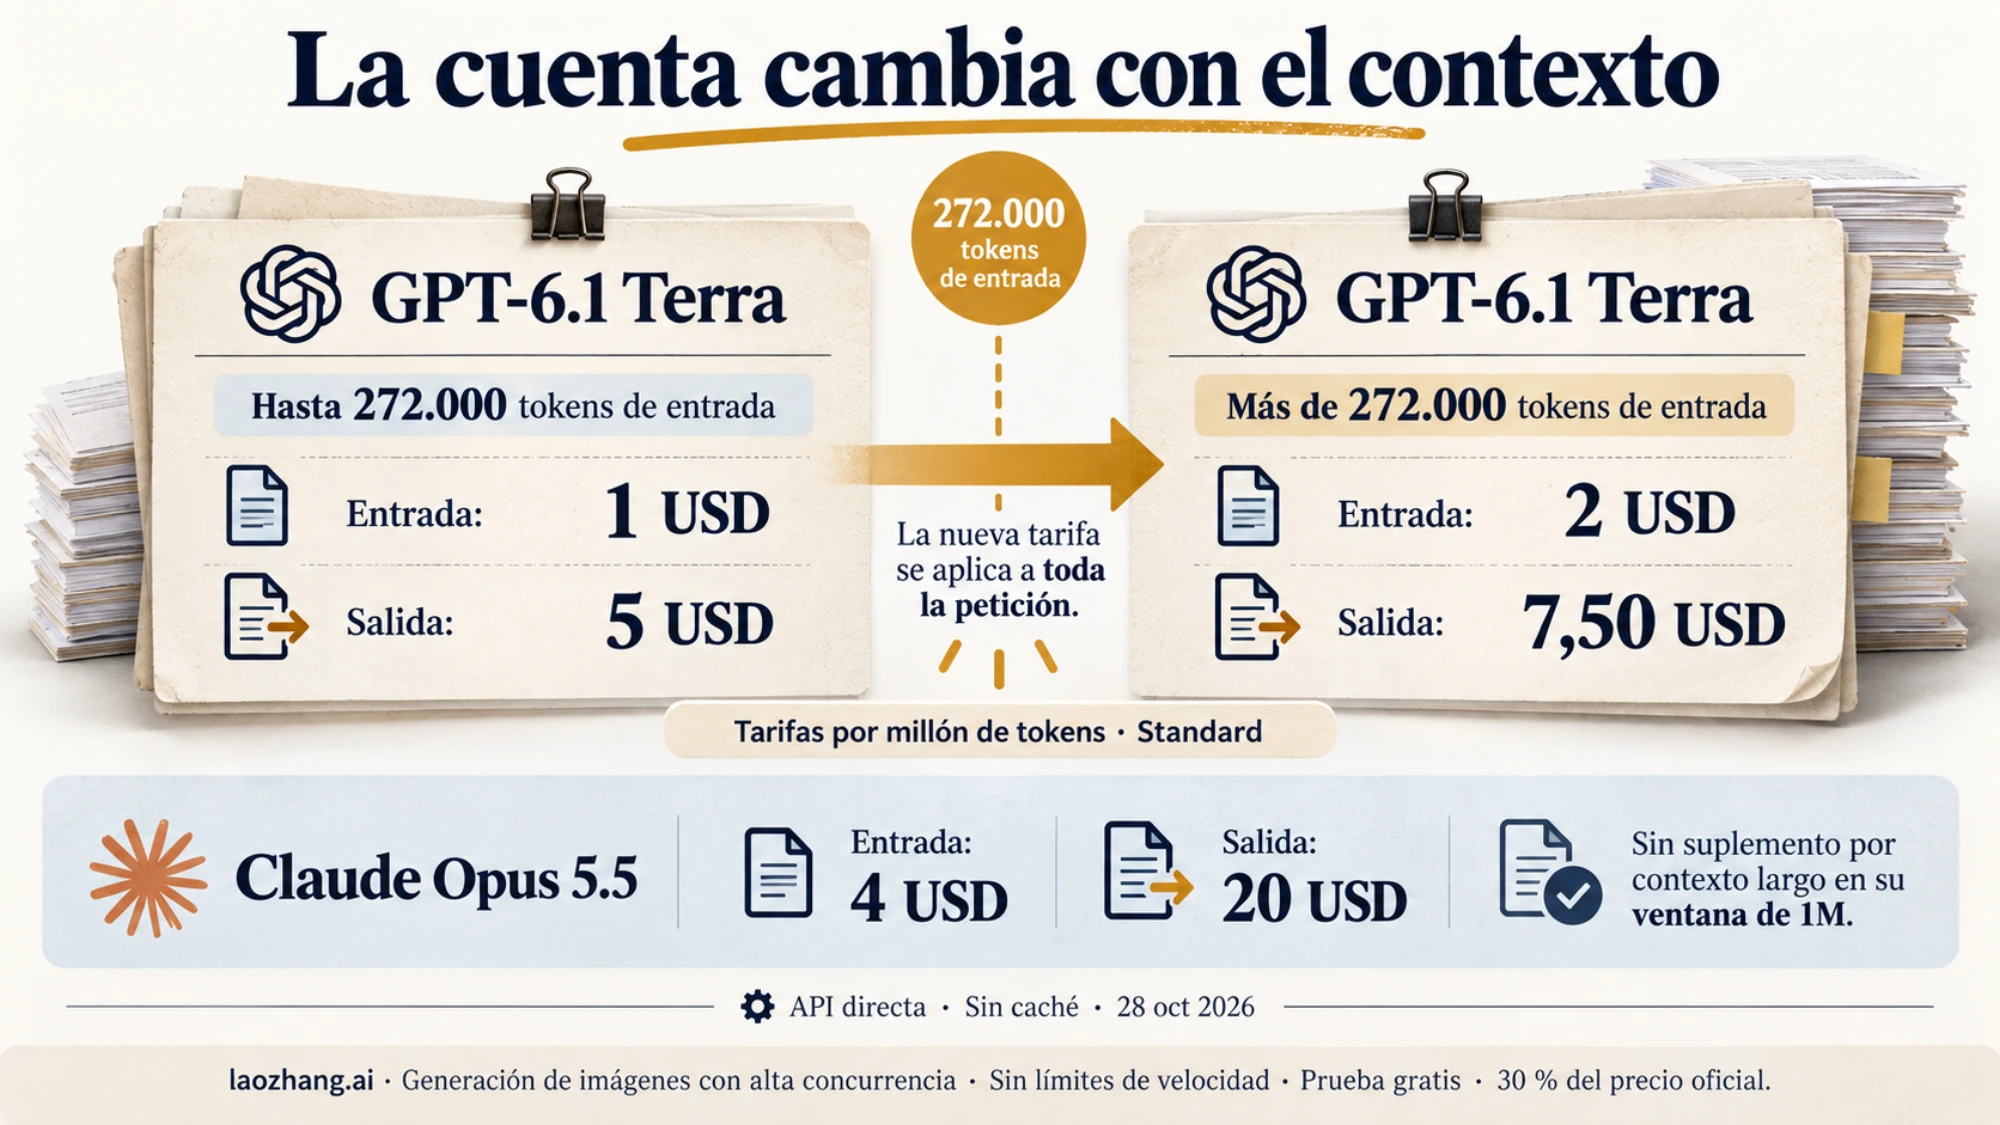
Para una petición sin caché, la cuenta es:
Coste en USD = (tokens de entrada × tarifa de entrada
             + tokens de salida facturados × tarifa de salida) / 1.000.000
Estos ejemplos usan las mismas cantidades facturadas en ambos modelos, con API directa y Standard. Excluyen herramientas, impuestos, suplementos regionales y reintentos. Son cálculos de tarifa, no mediciones de tareas terminadas.
| Entrada | Salida facturada, incluido el razonamiento | Coste de Terra | Coste de Opus 5.5 |
|---|---|---|---|
| 10.000 tokens | 2.000 tokens | 0,02 USD | 0,08 USD |
| 100.000 tokens | 20.000 tokens | 0,20 USD | 0,80 USD |
| 272.000 tokens | 20.000 tokens | 0,372 USD | 1,488 USD |
| 272.001 tokens | 20.000 tokens | 0,694002 USD | 1,488004 USD |
| 300.000 tokens | 20.000 tokens | 0,75 USD | 1,60 USD |
Cálculos a partir de las tarifas Standard de OpenAI y Anthropic, con las condiciones indicadas. Por ejemplo, la última fila de Terra resulta de 300.000 × 2 / 1.000.000 + 20.000 × 7,5 / 1.000.000.
La conclusión práctica: la relación de cuatro a uno en precio por token deja de servir para peticiones largas. Terra sigue costando menos en estos ejemplos, pero el ahorro ya no tiene la misma proporción. Si estás cerca del umbral, cuenta la entrada completa que envías, no solo el último documento añadido.
El razonamiento también se factura
Contar las palabras de la respuesta visible no basta para presupuestar. Tanto OpenAI como Anthropic facturan el razonamiento interno como salida. En cada respuesta, toma el total de salida de usage: sus desgloses reasoning_tokens o thinking_tokens ya están incluidos, por lo que no hay que sumarlos otra vez.
Además, un mismo texto no tiene por qué producir el mismo número de tokens en ambos sistemas. La tabla anterior permite comparar tarifas; tu presupuesto real necesita los consumos registrados por cada proveedor, incluidos los intentos que no acabaron en un resultado aceptable.
Caché y procesamiento por lotes
Con entradas de hasta 272.000 tokens, la lectura de caché cuesta 0,05 USD por millón en Terra y 0,20 USD en Opus. Escribirla es otra partida: Terra publica 1,25 USD para 30 minutos y 2,50 USD para 12 horas; Opus, 5 USD para 5 minutos y 8 USD para una hora. Las duraciones son distintas, así que compara cuánto reutilizas realmente la entrada durante cada periodo. Fuentes: OpenAI y Anthropic.
Los dos ofrecen un descuento del 50 % en entrada y salida mediante Batch; Terra también lo ofrece en Flex. Fast cuesta el doble de Standard en ambos. Mantén la misma modalidad al comparar y añade los cargos aplicables a tu configuración, como herramientas o procesamiento regional. Una tarifa de una plataforma intermediaria puede ser diferente de la API directa.
Qué dicen los resultados de Artificial Analysis
La lectura del 28 de octubre de 2026 del Intelligence Index v5.0 muestra esta diferencia:
| Configuración evaluada | Puntuación del índice | Coste ponderado por tarea del índice |
|---|---|---|
GPT-6.1 Terra, High | 42 | 0,26 USD |
Claude Opus 5.5, Max / Default Fallback | 58 | 10,04 USD |
Fuentes: fichas de Terra High y Opus 5.5, y metodología de Artificial Analysis. Son resultados publicados por ese evaluador, no por nosotros.
Opus obtiene una puntuación más alta en esas configuraciones. Esto justifica probarlo cuando la calidad sea el factor decisivo. Pero High y Max / Default Fallback no acreditan el mismo esfuerzo, presupuesto de cómputo ni ajustes por defecto. Se conserva la etiqueta del evaluador sin atribuirle un mecanismo de cambio de modelo que no está documentado aquí.
El índice combina evaluaciones principalmente de texto en inglés. Sus 58 y 42 puntos no son porcentajes de tareas resueltas y no permiten calcular cuántos errores tendrá tu automatización. Tampoco determinan cuál redacta mejor en español o utiliza mejor una interfaz visual. Esas capacidades necesitan una evaluación correspondiente a la tarea. Véase la metodología del índice.
El coste de 0,26 o 10,04 USD tampoco es el precio de un informe correcto entregado a un cliente. AA calcula el gasto por tarea dentro de sus evaluaciones y lo pondera entre ellas, con su consumo de tokens y tratamiento de la caché. Sirve para entender el coste de esa prueba, no para multiplicarlo sin más por el número de expedientes de tu empresa.
En cuanto a velocidad, la misma lectura recoge 90,9 tokens por segundo para Terra y 98,4 para Opus. Esa medida corresponde a la fase de salida bajo las condiciones de prueba de AA, con entrada de unos 10.000 tokens y mediana móvil de 72 horas desde un nodo de EE. UU. No incluye por sí sola toda la espera, el uso de herramientas ni los reintentos; no demuestra cuál termina antes tu trabajo.
Cambiar de modelo exige revisar la integración
Antes de comparar respuestas, comprueba que la aplicación esté llamando correctamente a cada modelo. Un error de integración no es una prueba de que uno razone peor.
- Herramientas con Terra: las llamadas a herramientas requieren la API Responses. No basta con mantener cualquier integración anterior y cambiar el identificador del modelo. La ficha oficial señala este requisito.
- Razonamiento con Opus 5.5: no admite desactivarlo ni los controles manuales antiguos con
budget_tokens. Debes usar el control de esfuerzo que describe Anthropic. - Herramientas forzadas con Opus 5.5:
tool_choiceconanyo con una herramienta concreta devuelve un error 400. Revisa si tu aplicación dependía de esa llamada obligatoria. - Conversaciones y ordenador: los bloques de razonamiento de Opus están ligados al modelo y a la conversación; la compatibilidad de herramientas antiguas de ordenador también cambia según la plataforma. No reutilices el historial o la configuración sin revisar los cambios de Opus 5.5.
Si ya tienes un proceso fiable, conserva una referencia de su comportamiento antes de sustituirlo. La prueba debe incluir tanto una tarea nueva como la continuación de una conversación y una secuencia de herramientas, si tu aplicación las utiliza.
Cómo decidir si el ahorro compensa
Prepara una muestra del trabajo que vas a repetir, con casos normales y otros que hoy requieren corrección. Para documentos, marca qué campos y referencias deben ser correctos; para código, qué pruebas debe pasar; para una aplicación, qué estado final debe alcanzarse. Define esos criterios antes de ver qué modelo hizo cada resultado.
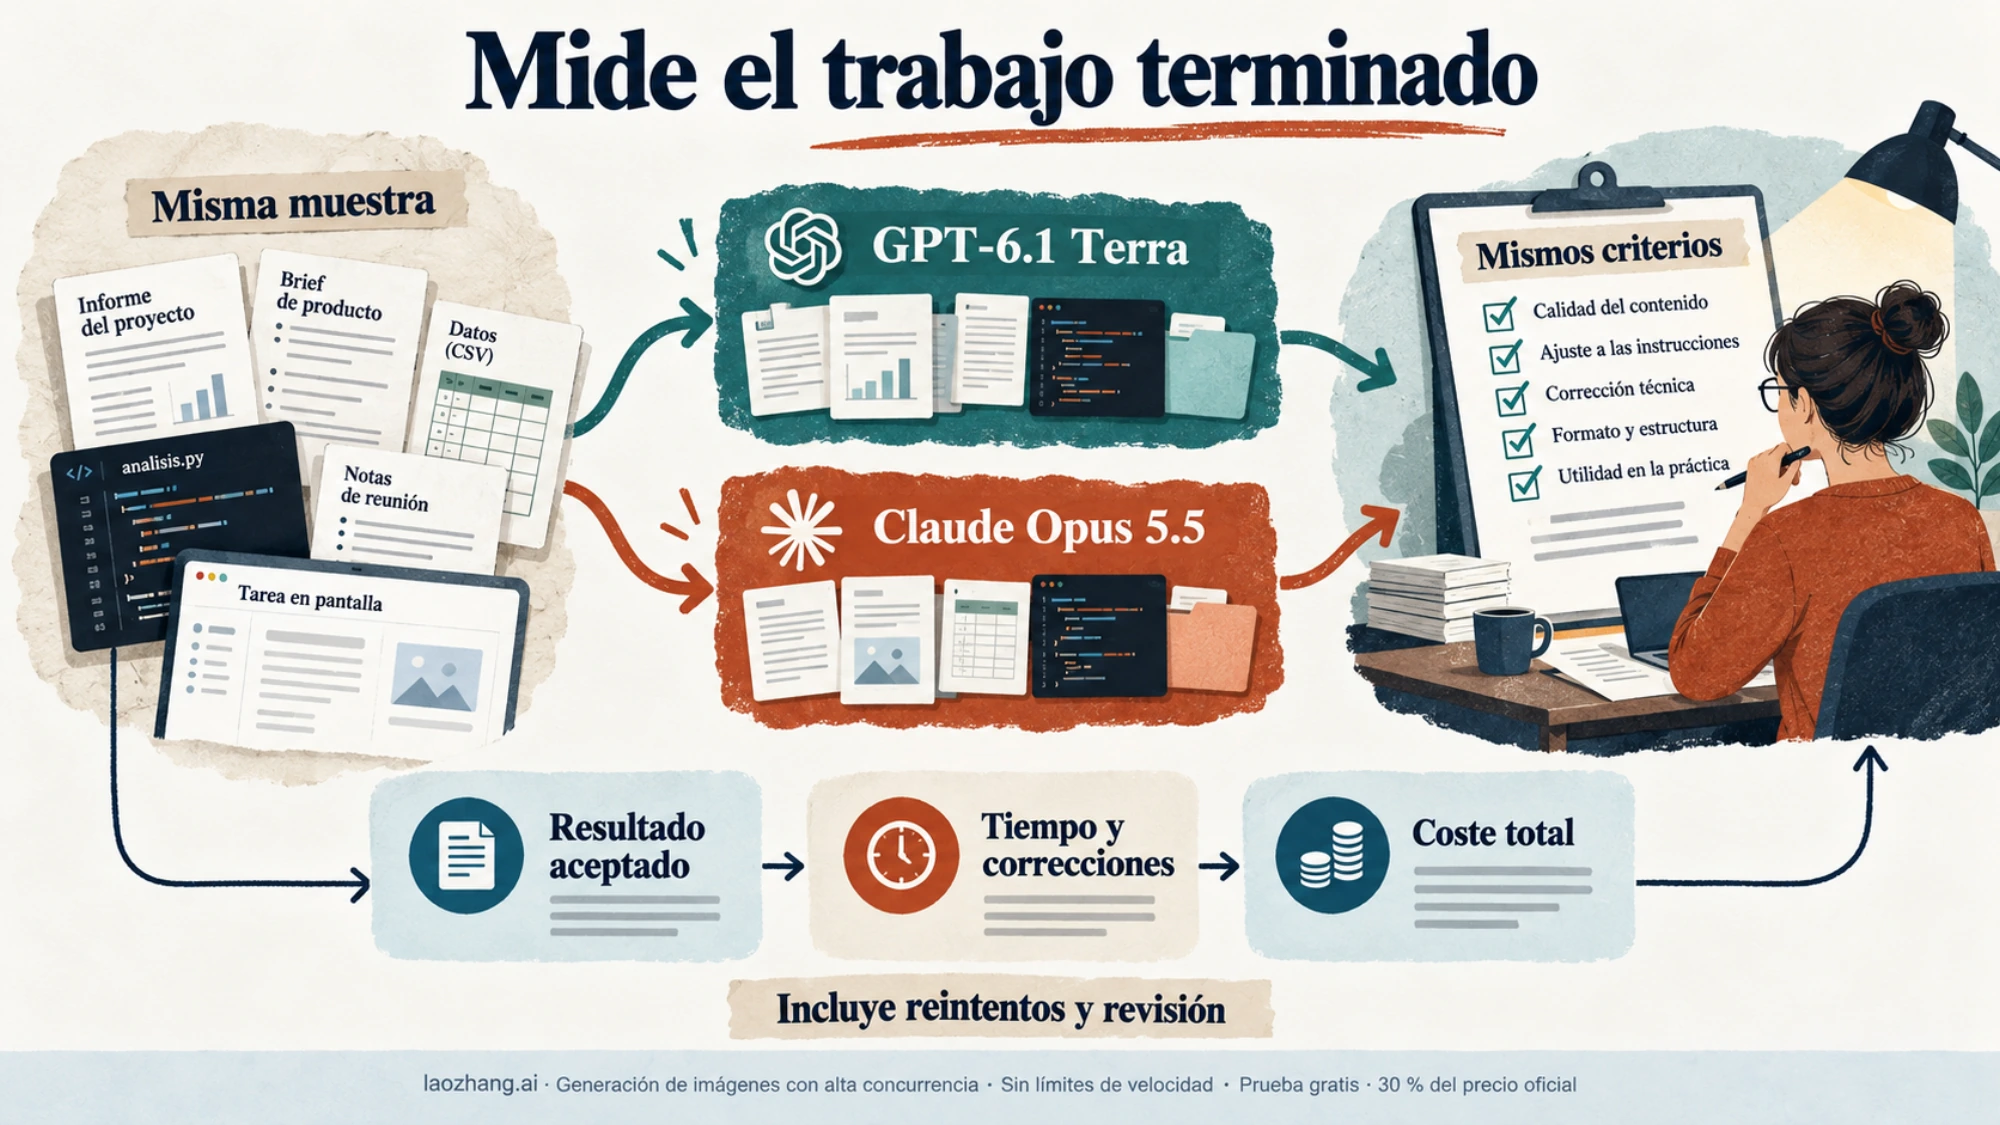
- Prueba ambos con los mismos materiales y permisos. Registra el identificador, el esfuerzo, la modalidad de procesamiento y las herramientas disponibles. Si ajustas el esfuerzo, guarda cada configuración por separado.
- Mide el resultado completo. Anota si se acepta, cuánto tarda hasta estar utilizable, cuántos reintentos necesita y los minutos de revisión o corrección.
- Suma el gasto real. Incluye todas las llamadas, incluso las fallidas, la caché, las herramientas y el coste de revisión que corresponda a tu equipo.
- Compara por resultado aceptado. Divide ese total entre los trabajos que cumplen tus criterios; registra también los casos sin resolver para que no desaparezcan del análisis.
Si Terra cumple los criterios y el tiempo de corrección es parecido, su menor tarifa ofrece una razón concreta para elegirlo. Si Opus evita suficientes correcciones o resuelve casos que Terra deja pendientes, puede compensar su precio. También puedes reservar cada modelo para un tipo de tarea, siempre que la regla de selección se pueda comprobar. Esa decisión sale de tus resultados; no de convertir puntos de un índice en horas de trabajo ahorradas.
Dudas antes de elegir
¿Cuál escribe mejor en español?
No hay en esta comparación una prueba propia que permita dar un ganador. El índice citado se centra principalmente en inglés y texto. Compara muestras de tus correos, informes o documentación en español, con atención al significado, el tono y las correcciones necesarias, no solo a que las frases sean gramaticales.
¿Puedo usar Terra con mi suscripción de ChatGPT?
OpenAI lo anuncia para ChatGPT Work y Codex en los planes Plus, Pro, Business, Enterprise y Edu; no está disponible en Chat. En Enterprise también intervienen la disponibilidad del espacio y los controles del administrador. Comprueba el producto que utilizas y las opciones de tu cuenta en el anuncio de disponibilidad.
Las tarifas por token de este artículo no indican la cuota de tu suscripción ni el número de tareas que podrás completar en ella. Si trabajas desde una aplicación de ChatGPT o Claude, compara primero el acceso y los límites de ese producto.
¿Tiene sentido enviar todas las tareas a Opus por su mejor puntuación?
No se deduce de los datos. Su resultado en la evaluación citada es un motivo para probarlo, especialmente en los casos difíciles. Si Terra ya cumple los requisitos de una tarea a menor coste total, la puntuación de Opus no demuestra por sí sola que pagar más mejore ese trabajo.