Qué elegir según el trabajo que tengas entre manos
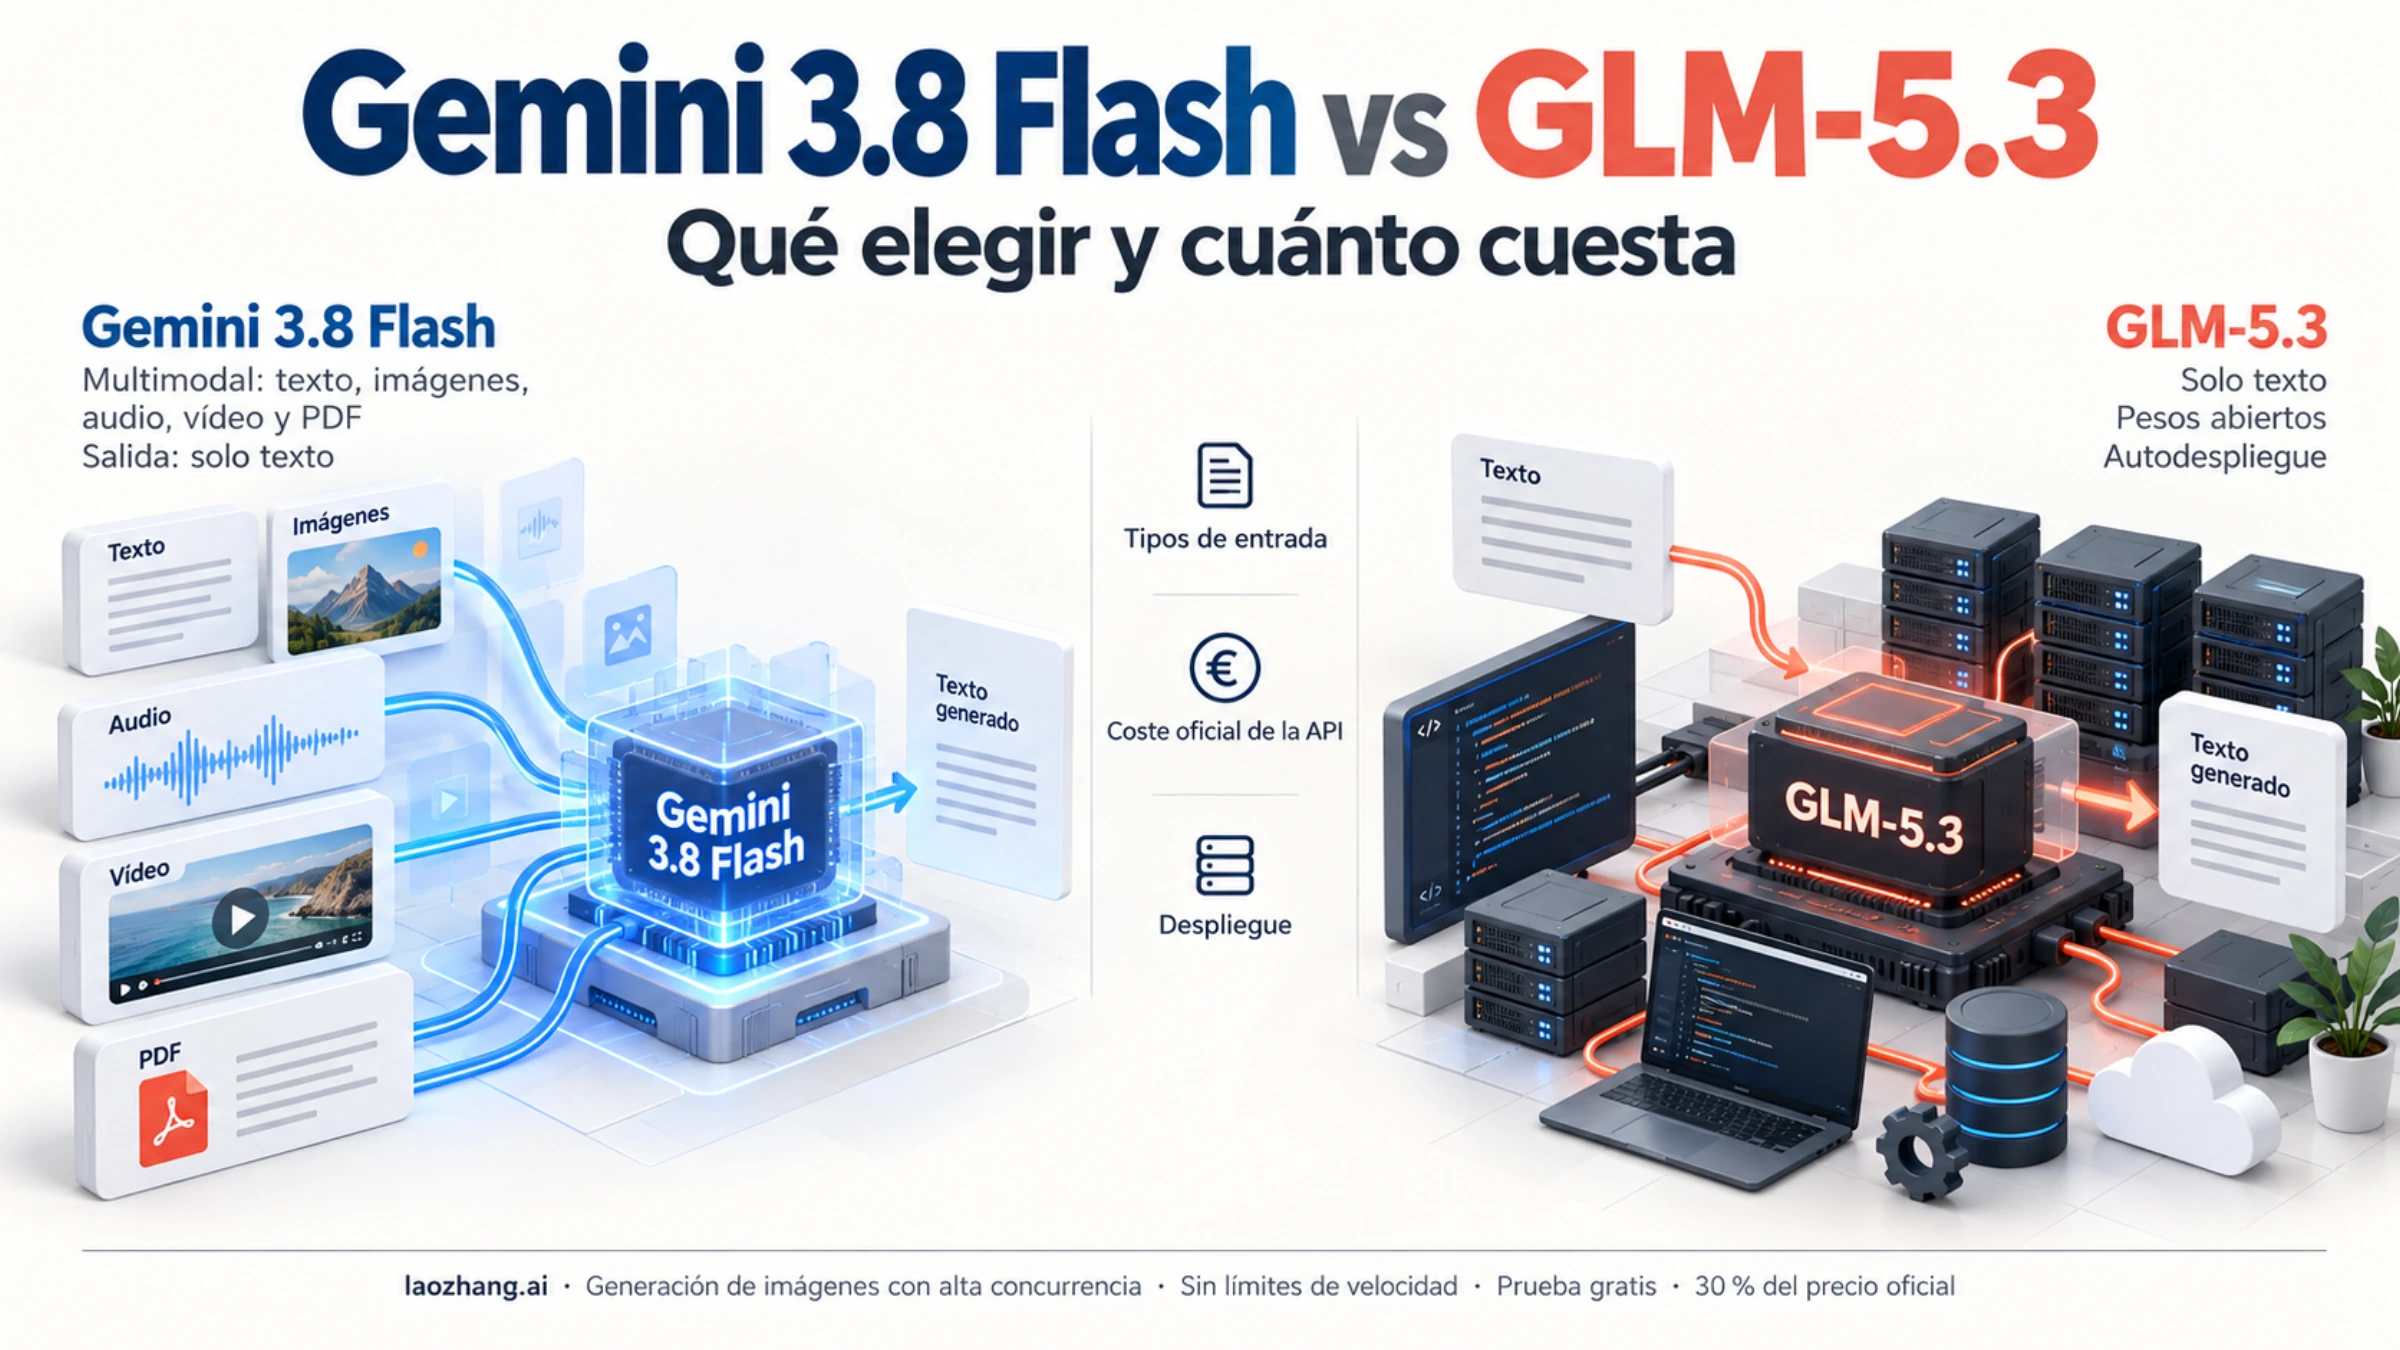
Elegiría Gemini 3.8 Flash para analizar imágenes, grabaciones, vídeos o PDF sin montar antes un proceso que los convierta en texto. Para un agente que trabaja con código y texto, probaría también GLM-5.3; y si necesitas alojar el modelo en tu infraestructura, sus pesos abiertos son una diferencia decisiva. Las fichas de Google y Z.AI confirman la diferencia de entradas, y el repositorio oficial de GLM-5.3 ofrece la vía de despliegue propio.
Para una aplicación de texto que pueda utilizar cualquiera de los dos, empezaría presupuestando Gemini: a 28 de octubre de 2026, sus tarifas Standard de entrada y salida son inferiores. Hay una fecha que conviene tener presente: el precio anunciado por Google se duplica el 1 de enero de 2027. Con las tarifas actuales de Z.AI como supuesto, la comparación de precios por token se invierte entonces. Más abajo están los importes y un cálculo con el mismo consumo facturable para ambos (Google, Z.AI).
Aquí comparamos los identificadores exactos gemini-3.8-flash y glm-5.3. GLM-5.3-Flash es otro modelo: sus precios o resultados no sirven para decidir entre esta pareja. Las recomendaciones se basan en documentación oficial y datos externos de rendimiento; no hemos ejecutado pruebas propias de las dos API.
Entradas, contexto y salida: las diferencias que descartan opciones
| Característica | Gemini 3.8 Flash | GLM-5.3 |
|---|---|---|
| Entrada admitida | Texto, imágenes, vídeo, audio y PDF | Texto |
| Salida | Texto | Texto |
| Capacidad publicada | Hasta 1.048.576 tokens de entrada | Ventana de contexto de 1M tokens |
| Salida máxima publicada | 65.536 tokens | 128K tokens |
| Razonamiento | low, medium o high; predeterminado: medium | Obligatorio; low, high o max; predeterminado: max |
| Funciones útiles para agentes | Llamadas a funciones, salida estructurada y caché | Llamadas a funciones, salida estructurada y caché |
Fuentes: especificaciones de Gemini, ajustes de Gemini 3.8 y documentación de GLM-5.3.
Si el trabajo consiste en localizar un fallo en una captura o relacionar lo que se ve y se oye en un vídeo, Gemini admite ese material directamente. Para llevarlo a GLM habría que extraer antes texto mediante otras herramientas. Ese paso añade componentes, coste y posibles pérdidas de información; por eso no basta con comparar el precio del modelo de texto.
Las cifras de contexto tampoco son intercambiables. Google publica un límite de entrada y Z.AI una ventana de contexto. No conviene interpretar ambas como un presupuesto idéntico de texto de entrada más respuesta. Del mismo modo, el mayor límite de salida de GLM puede resultar útil para documentos extensos, pero no garantiza que una respuesta larga sea correcta ni que alcance ese límite en cada petición.
Precios oficiales: la ventaja de Gemini tiene fecha
Estos son los precios en dólares estadounidenses por millón de tokens de las API directas de Google y Z.AI. Para Gemini usamos la modalidad Standard; las tarifas de Batch, Flex, Priority, intermediarios y suscripciones quedan fuera de esta comparación.
| Concepto | Gemini Standard hasta el 31-12-2026 | Gemini Standard anunciado desde el 01-01-2027 | GLM-5.3 en Z.AI, a 28-10-2026 |
|---|---|---|---|
| Entrada sin caché | 0,75 USD | 1,50 USD | 1,40 USD |
| Entrada servida desde caché | 0,075 USD | 0,15 USD | 0,26 USD |
| Salida | 3,75 USD | 7,50 USD | 4,40 USD |
Fuentes: precios de Gemini Developer API y precios de Z.AI Model API. Google incluye los tokens de razonamiento en la salida facturable. La columna de 2027 recoge una tarifa anunciada, no un cargo ya observado.
La caché merece una cuenta aparte. Google cobra actualmente 0,50 USD por millón de tokens almacenados y hora, y anuncia 1 USD desde enero de 2027. Z.AI indica almacenamiento temporalmente gratuito sin concretar una fecha de finalización en la tabla consultada. Una tarifa baja por lectura de caché no equivale por sí sola a una factura menor: también importan cuánto tiempo conservas los datos y cuántas veces los reutilizas.
Un ejemplo de 1.000 peticiones con el mismo consumo
Supongamos que cada petición factura 10.000 tokens de entrada sin caché y 2.000 de salida, incluido el razonamiento que se facture. Usamos exactamente esos volúmenes para ambos modelos y excluimos herramientas, almacenamiento, impuestos, reintentos y fallos.
La cuenta es:
Coste = tokens de entrada × tarifa de entrada / 1.000.000
+ tokens facturables de salida × tarifa de salida / 1.000.000| API y escenario | Una petición | 1.000 peticiones |
|---|---|---|
| Gemini Standard, tarifa hasta final de 2026 | 0,015 USD | 15 USD |
| GLM-5.3, tarifa actual de Z.AI | 0,0228 USD | 22,80 USD |
| Gemini Standard, tarifa anunciada para 2027 | 0,030 USD | 30 USD |
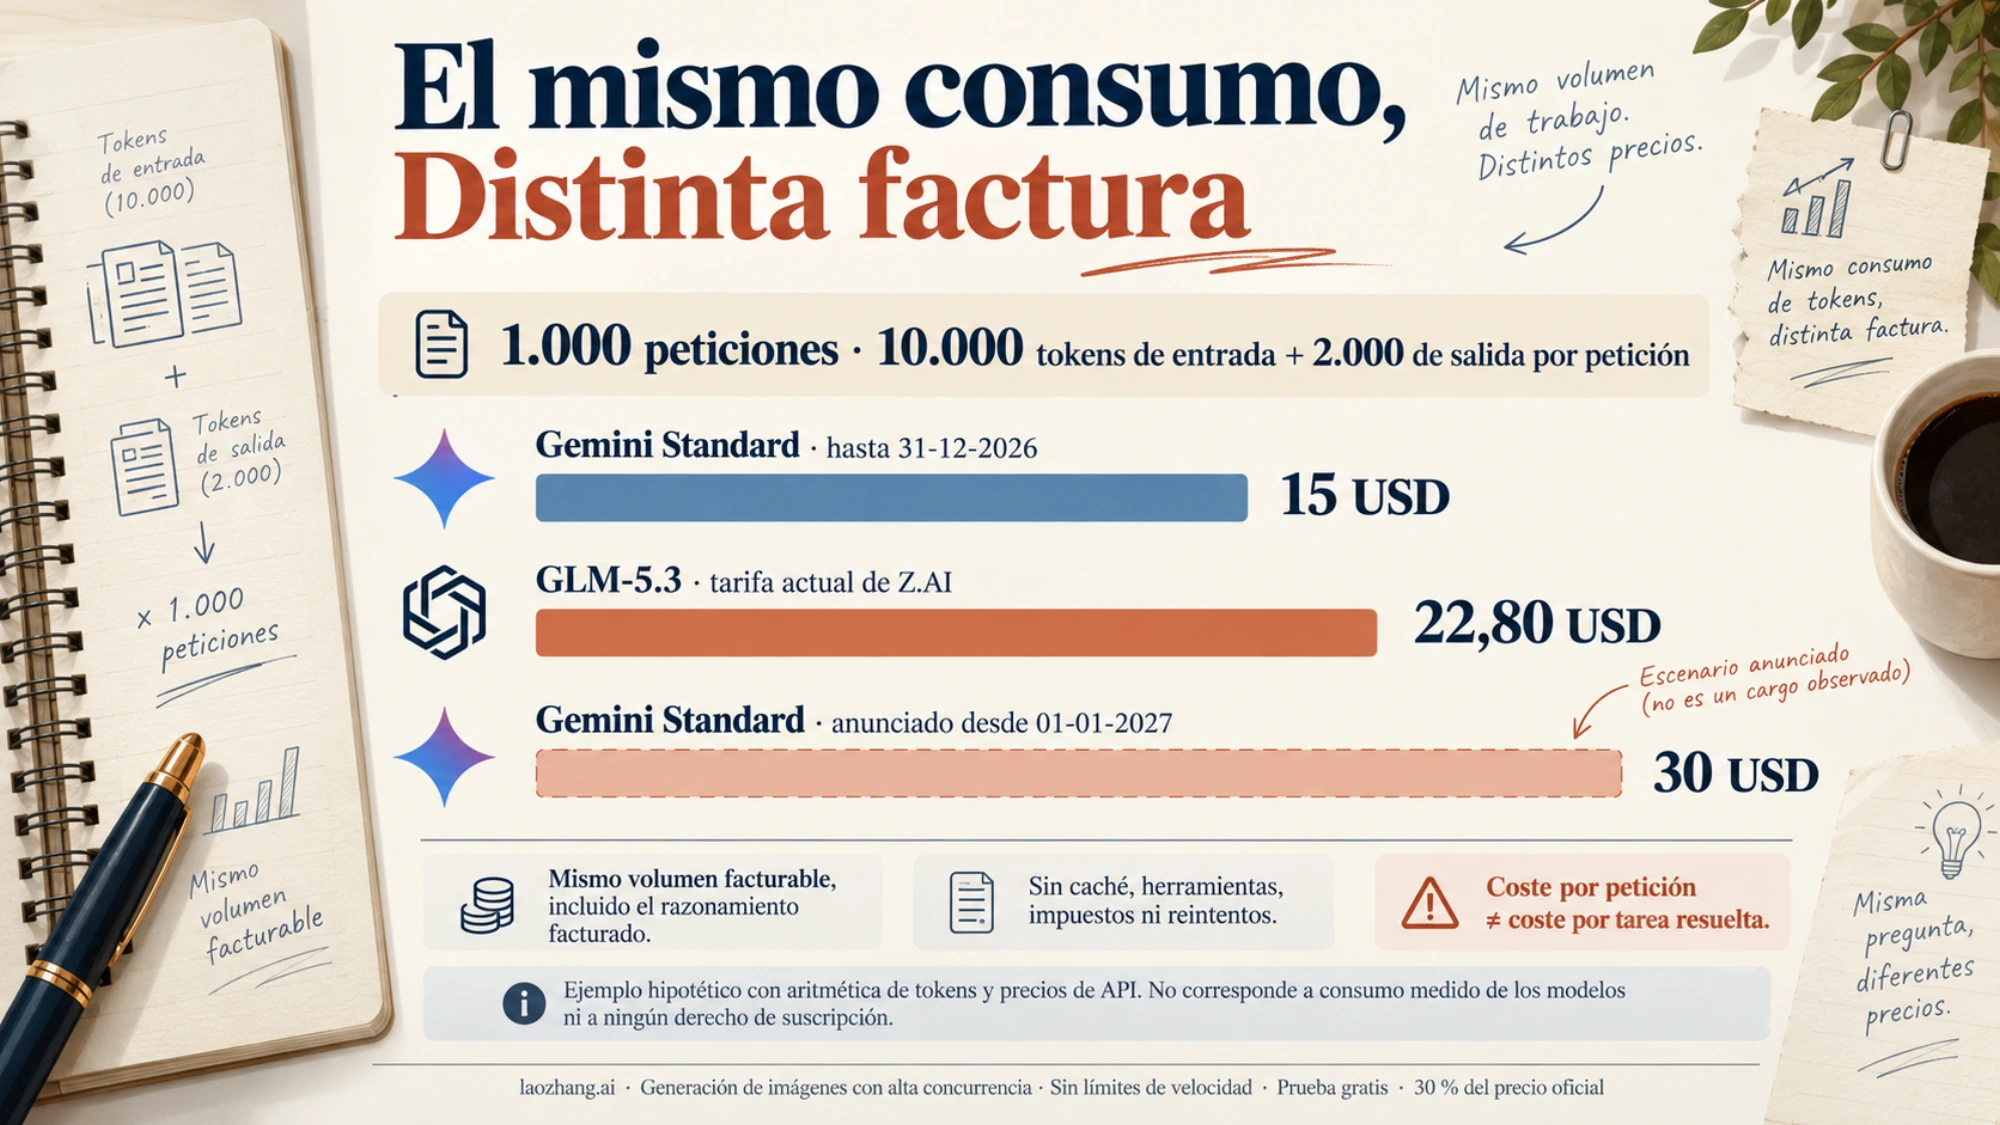
Por ejemplo, la primera fila resulta de 0,01 × 0,75 + 0,002 × 3,75 = 0,015. La comparación futura con GLM solo se sostiene si Z.AI mantiene sus tarifas actuales; no hay aquí una promesa de precio para 2027.
Este cálculo permite preparar un presupuesto, pero no indica cuánto costará resolver tu tarea. Un agente puede releer archivos, llamar a herramientas y revisar su respuesta varias veces. Además, los modelos pueden producir y facturar cantidades distintas de tokens ante el mismo encargo. Para decidir, divide el gasto total de una prueba representativa entre las tareas que hayas aceptado como resueltas, incluyendo sus reintentos. Esa medida será más útil que el precio de una única respuesta.
Rendimiento: qué indican las pruebas externas
Para tareas de programación, GLM merece una prueba propia: en la captura de Artificial Analysis consultada el 28 de octubre de 2026, GLM-5.3 en Max superaba a Gemini 3.8 Flash en High tanto en el índice agregado como en Terminal-Bench 4.0. Son ajustes distintos y no implican el mismo presupuesto de razonamiento.
| Medida de la captura | Gemini 3.8 Flash, High | GLM-5.3, Max |
|---|---|---|
| Intelligence Index v4.3.2 | 41 | 45 |
| Terminal-Bench 4.0 | 20 % | 42 % |
| Velocidad de salida | 131 tokens/s | 81 tokens/s |
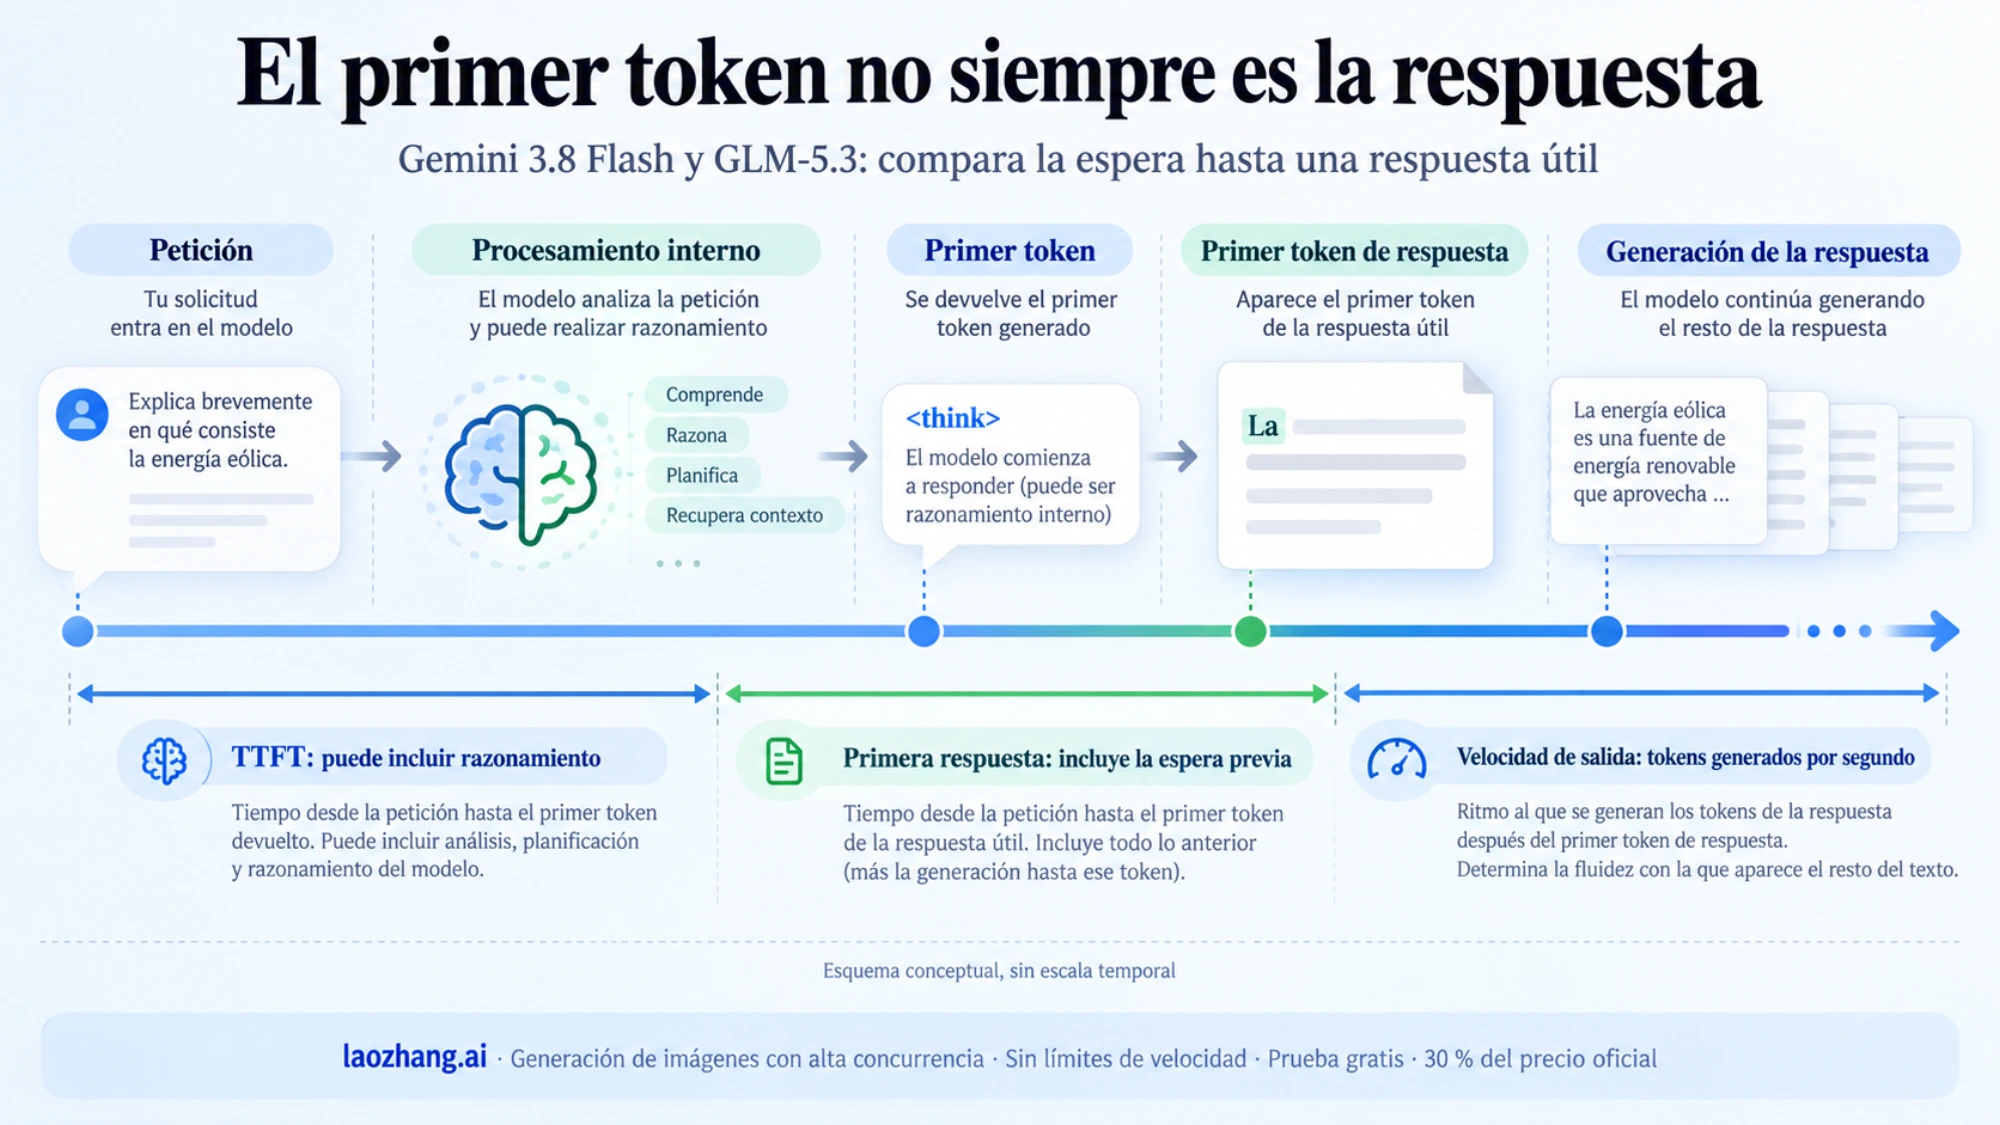
| Tiempo hasta el primer token | 25,27 s | 2,74 s |
| Tiempo hasta el primer token de respuesta | 25,27 s | 27,47 s |
Fuente: comparación de Artificial Analysis. El índice de esta captura es v4.3.2; la metodología vigente ya es v5.0. No es, por tanto, una clasificación de la versión más reciente del índice ni una prueba específica de calidad en español (metodología del índice).
La aparente contradicción en los tiempos tiene explicación: el primer token puede pertenecer al razonamiento, mientras que el primer token de respuesta mide cuándo empieza la contestación. La velocidad de salida describe la generación una vez iniciada. Por eso, los 2,74 segundos de GLM no equivalen a recibir antes una respuesta útil. Las mediciones dependen de la carga y del punto de acceso; sus tokens normalizados tampoco son los tokens nativos de facturación (método de rendimiento).
Pesos abiertos: GLM permite otro tipo de despliegue
El modelo oficial GLM-5.3 en Hugging Face incluye pesos y documentación para ejecutarlo en infraestructura propia. Esto puede ser relevante si necesitas controlar dónde se procesa el texto o gestionar el servicio por tu cuenta. La licencia es la GLM-5.3 License, con sus propias condiciones; no debe presentarse como MIT, Apache ni como permiso comercial sin condiciones.
Tampoco es una alternativa que se pueda presupuestar como una instalación doméstica corriente. La receta de vLLM enlazada por el modelo ofrece ejemplos con ocho GPU H200 o H20; para el contexto completo de 1M muestra ocho B200 y caché KV en FP8. Son ejemplos de despliegue, no mínimos de hardware verificados por nosotros. La concurrencia y la memoria destinada a la caché cambian las necesidades.
La decisión económica pasa entonces de pagar tokens a pagar capacidad, operación y mantenimiento. Si no tienes ese requisito de infraestructura, la API de Z.AI te permite evaluar GLM sin desplegar sus pesos.
Cómo decidir antes de cambiar una aplicación
Empieza por el requisito que no puedas negociar. Si necesitas enviar material multimedia, prueba Gemini. Si necesitas alojar el modelo, estudia la licencia y el despliegue de GLM. Si ambos encajan en una aplicación de texto, compara unas tareas reales antes de migrar:
- Fija qué cuenta como un resultado válido. Por ejemplo, una corrección que pase las pruebas existentes o una extracción que respete el esquema y los datos del documento.
- Anota modelo, proveedor y razonamiento. Gemini usa
mediumde forma predeterminada; GLM usamaxy requiere razonamiento activado. El mismo nombre de nivel en dos proveedores tampoco demuestra un esfuerzo equivalente. - Registra coste total, tiempo hasta una respuesta aprovechable y reintentos. Conserva las llamadas a herramientas en la cuenta cuando formen parte de la tarea.
- Recalcula el presupuesto de Gemini para enero de 2027. Si el proyecto continuará entonces, decidir solo con la promoción de 2026 puede darte una imagen equivocada del gasto.
Los ajustes se describen en las novedades de Gemini 3.8 y la guía de GLM-5.3. Esta última recoge diferencias de protocolo según el historial de Coding Plan del usuario; antes de migrar, confirma el punto de acceso correspondiente a tu cuenta. No damos por comprobados el acceso regional, las cuotas ni el rendimiento de una cuenta concreta.
Si eliges Google, la guía de Gemini 3.8 Flash API continúa con la primera solicitud, los parámetros y la migración. Si eliges GLM, empieza por su documentación de API o por el repositorio oficial según vayas a contratar el servicio o a desplegarlo.
Dudas frecuentes
¿Gemini 3.8 Flash genera imágenes?
No. El modelo gemini-3.8-flash acepta imágenes como entrada, pero su salida es texto. La ficha oficial distingue expresamente esa capacidad de la generación de imágenes y de audio.
¿La suscripción GLM Coding Plan incluye el consumo de esta tabla?
La tabla compara el pago por uso de Z.AI Model API, no una asignación de tokens de Coding Plan. No puedes convertir la cuota mensual en una cantidad garantizada de peticiones dividiéndola por estos precios. Consulta por separado las tarifas de API y las condiciones de tu suscripción.
¿Cuál conviene para trabajar en español?
La evidencia recogida aquí no permite declarar un ganador por su español. Para redacción, atención al cliente o extracción de documentos, usa ejemplos de tu propia actividad y valora si conservan el sentido, el tono y los datos. El índice externo citado mide principalmente capacidades de texto en inglés; no sustituye esa comprobación (metodología).