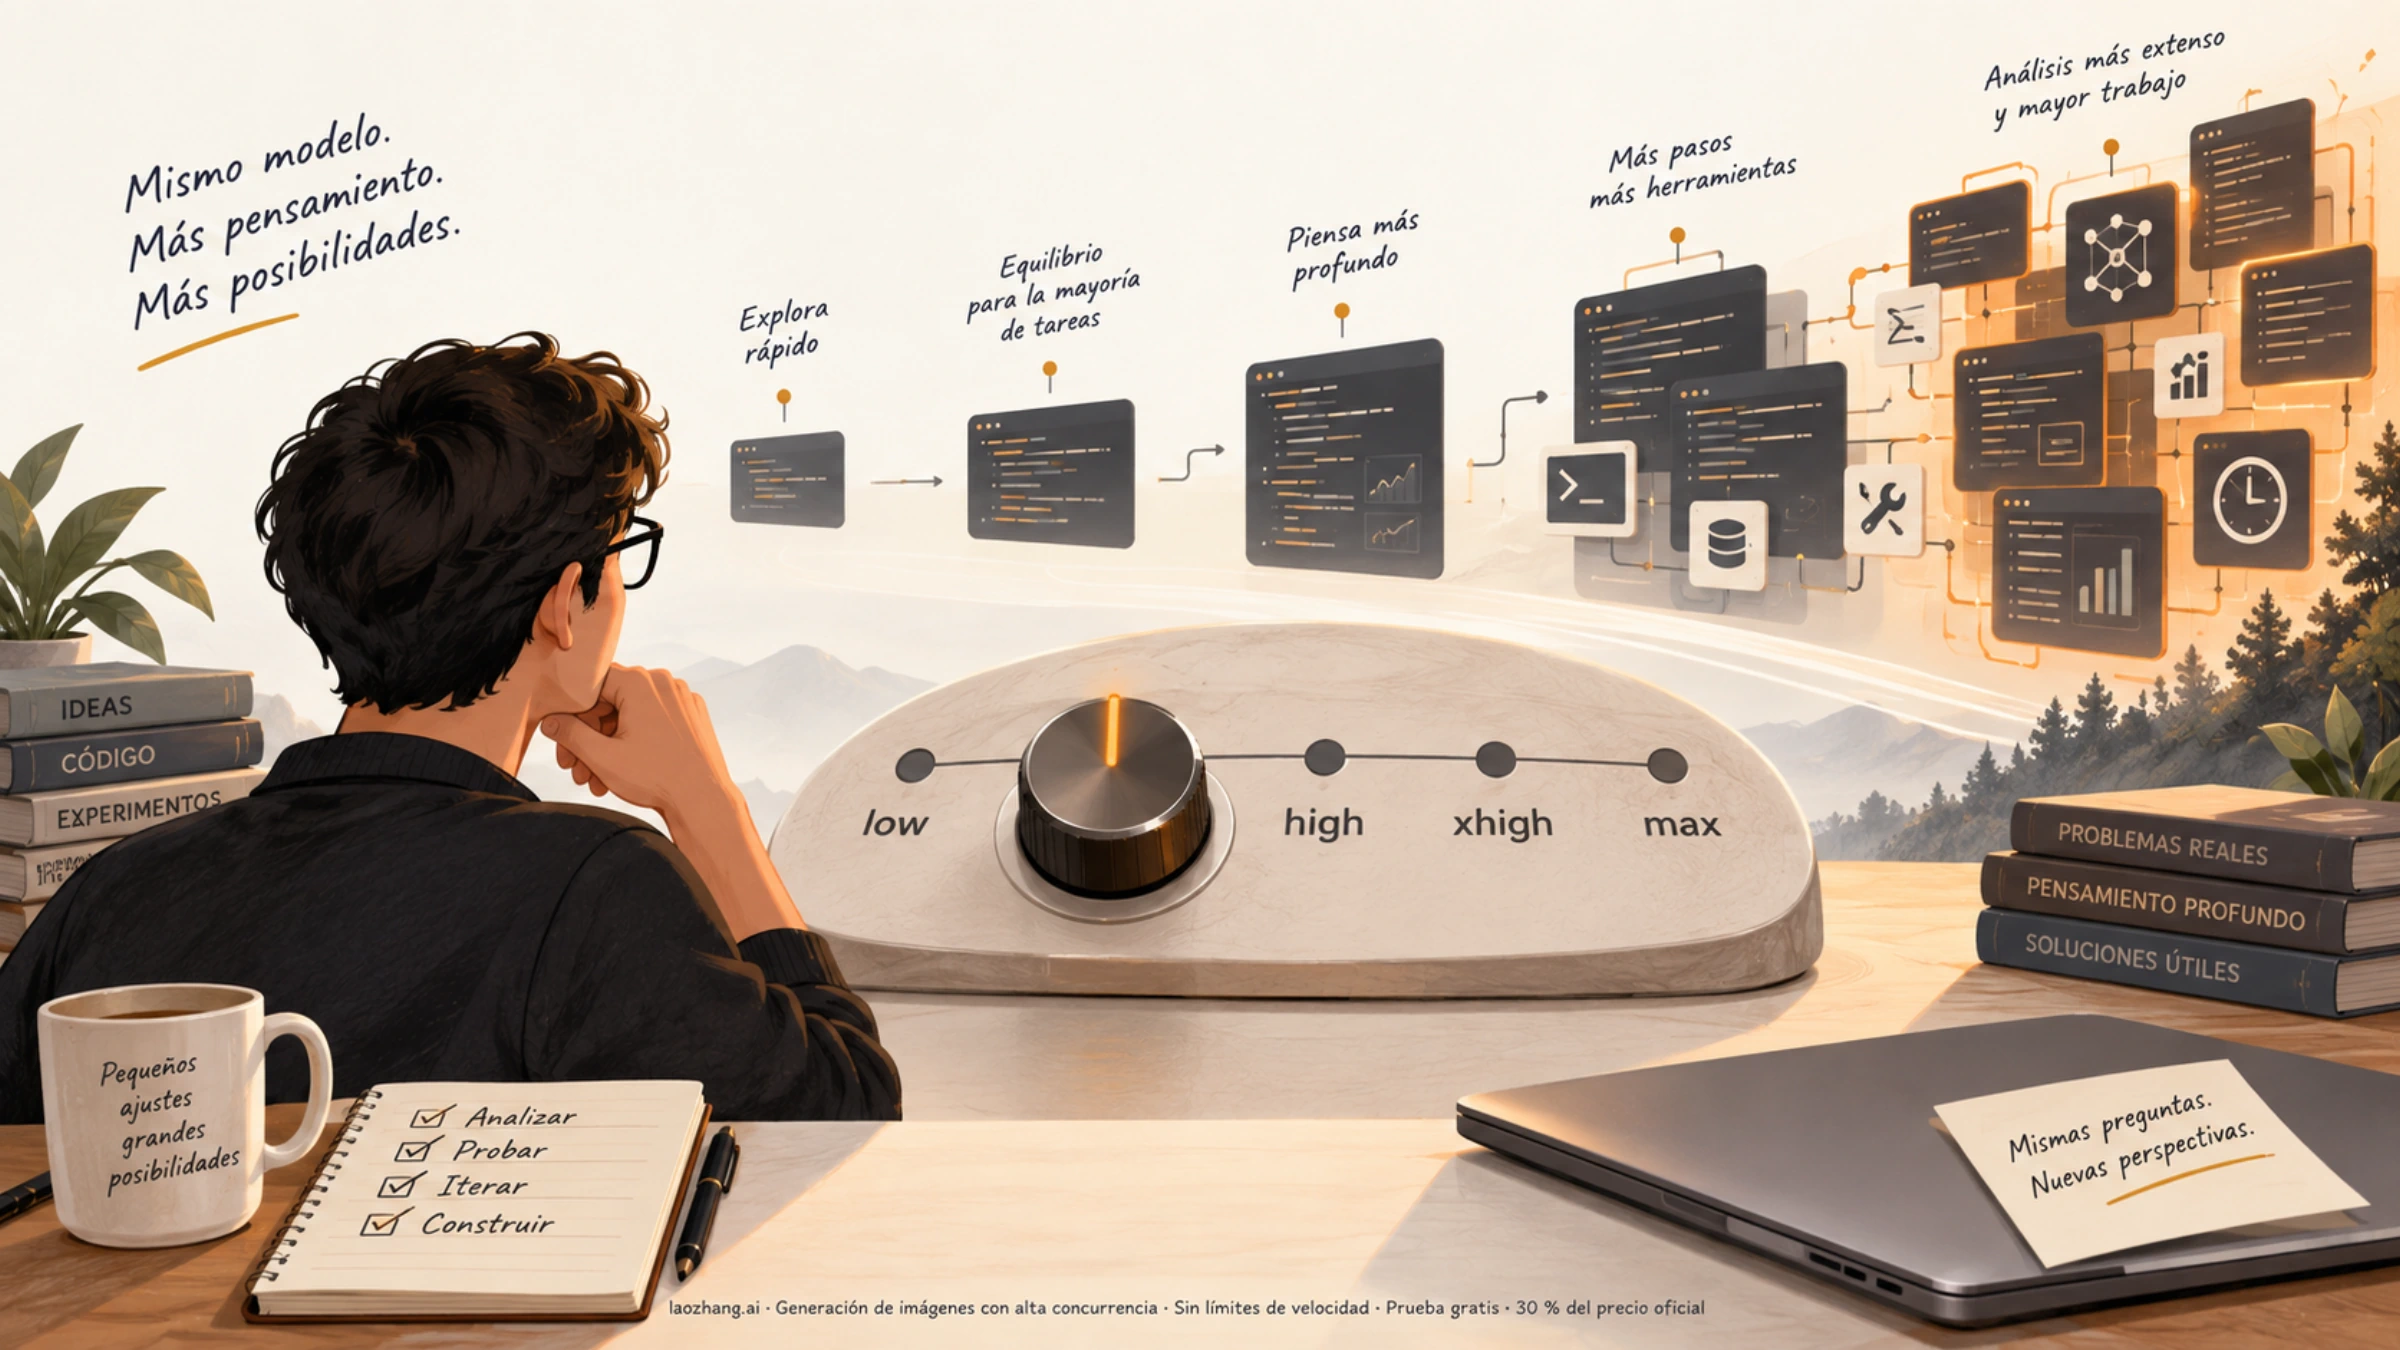
Si no sabes qué effort poner en Claude Opus 5.5, empieza por medium, su valor predeterminado. Para tareas mecánicas y fáciles de verificar, prueba low; si medium se queda corto en un trabajo que abarca varias partes, pasa a high. Deja xhigh y max para problemas exigentes donde puedas comprobar que ese gasto adicional cambia el resultado. En Claude Code se ajusta con /effort; en la Messages API, con output_config.effort. La elección solo se sostiene si comparas tareas terminadas, no el precio de una respuesta aislada. Fuentes: documentación de esfuerzo de Anthropic y guía de costes de Claude Code.
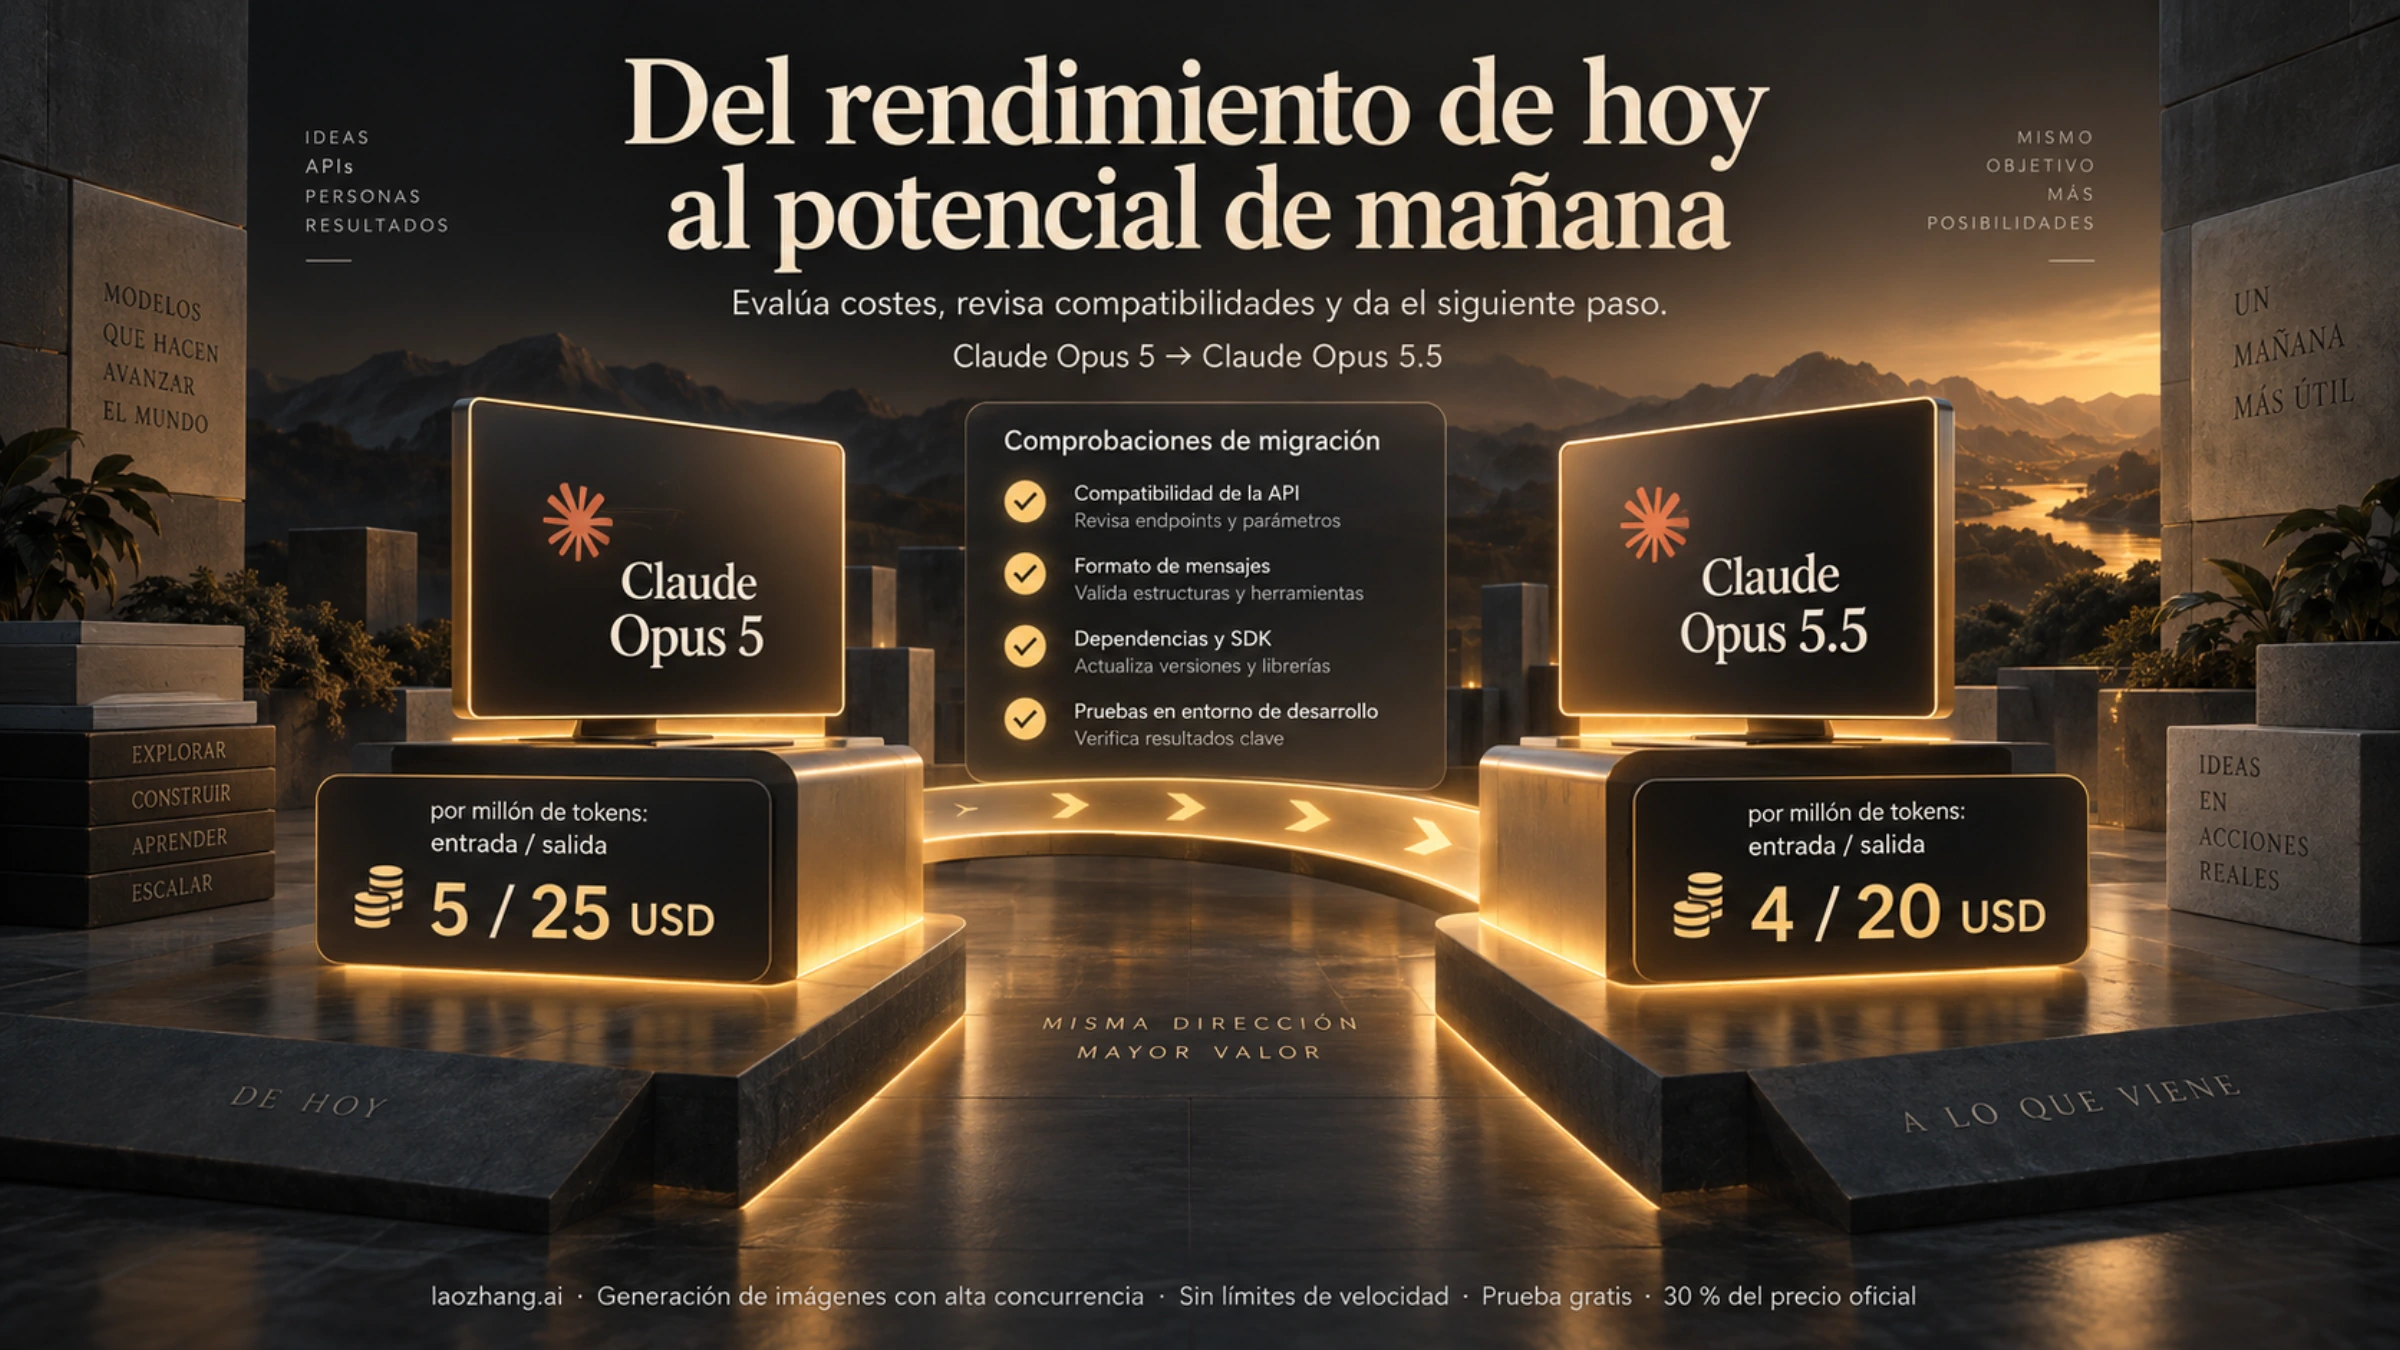
La clave al venir de Opus 5 es que una petición sin effort ya no significa lo mismo: Opus 5.5 usa medium por defecto; Opus 5 usaba high. Tampoco hay una equivalencia garantizada entre niveles que se llaman igual en ambos modelos. Si estás migrando, haz una prueba nueva con tus casos habituales en lugar de copiar la configuración anterior. Para precio, disponibilidad y cambios generales de integración, consulta la guía de Claude Opus 5.5.
Qué cambia realmente entre los cinco niveles
effort orienta cuánto trabajo dedica el modelo a una solicitud: influye en el pensamiento, la respuesta visible y las llamadas a herramientas. No asigna un presupuesto fijo de tokens ni garantiza que cada subida mejore una tarea concreta. Anthropic documenta los cinco valores para Opus 5.5; este mapa traduce sus descripciones en una primera decisión que después conviene comprobar en tu flujo. Fuente: documentación de esfuerzo.
| Nivel | Cuándo probarlo primero | Qué comprobar antes de adoptarlo |
|---|---|---|
low | Cambios repetitivos, consultas sencillas o tareas acotadas con una comprobación clara. | Que no omita pasos y que el ahorro no se pierda en correcciones. |
medium | Trabajo diario bien delimitado; es el punto de partida de Opus 5.5. | Que complete también las dependencias y llamadas necesarias, no solo la primera parte. |
high | Problemas difíciles o trabajo que en medium termina con una capa sin resolver. | Que reduzca reintentos o fallos lo suficiente para compensar sus tokens y su latencia. |
xhigh | Trabajo de programación o agentes de larga duración, con muchas decisiones encadenadas. | Que la mejora sea medible frente a high en esas tareas largas. |
max | Casos excepcionales en los que interesa explorar la capacidad máxima. | Que la ganancia real justifique el mayor gasto de salida. |
No conviertas esta tabla en una regla basada solo en la dificultad aparente. Una tarea con buenas pruebas puede resolverse en medium porque el modelo detecta el fallo a tiempo. En otra, una corrección que pasa una prueba local pero deja roto el cliente quizá necesite mayor esfuerzo o una comprobación que cubra ambos lados. Anthropic recomienda dar al modelo medios para verificar su trabajo y elevar el nivel cuando medium se atasca. Fuente: guía de costes de Anthropic.
Cómo fijar effort en Claude Code
En una sesión con Opus 5.5, ejecuta /effort medium —o el nivel que hayas elegido— y usa /effort status para comprobar el valor activo. Por ejemplo, si una tarea delimitada quedó a medias, ejecuta /effort high antes del siguiente intento. El cambio se aplica a la próxima petición, no reescribe las respuestas anteriores. Fuente: guía de Claude Code de Anthropic.
text/effort medium
/effort status
/effort high
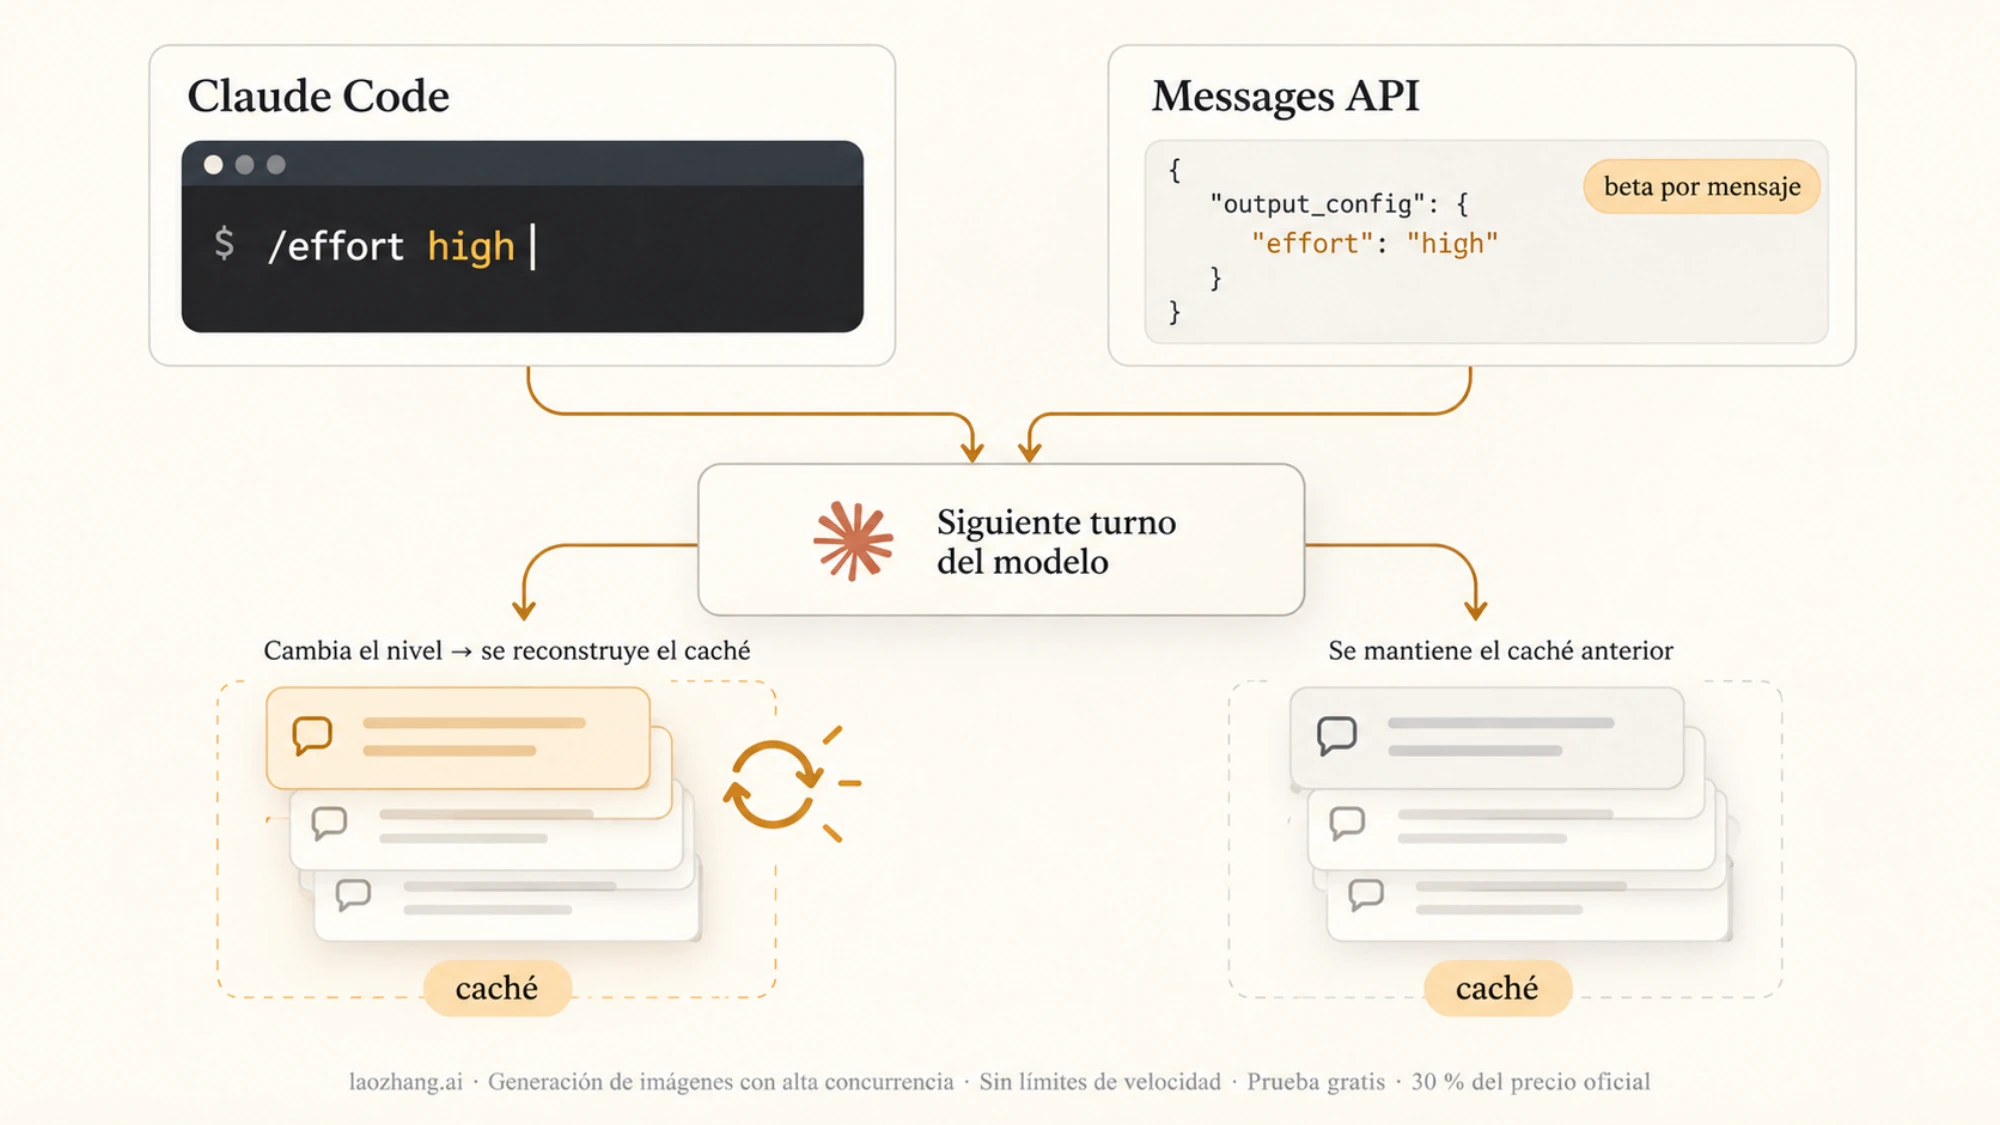
Hay un coste fácil de pasar por alto: cambiar effort o la configuración de pensamiento en Claude Code borra la caché de la conversación. La siguiente petición debe escribir de nuevo el contexto en caché. En una sesión larga, alternar de medium a high y volver puede consumir parte del ahorro esperado. Elige el nivel antes de iniciar un tramo de trabajo y cambia en una pausa razonable si los resultados lo piden. Si pagas Claude Code mediante suscripción, las tarifas de la API que aparecen más abajo no son una factura de tu plan; observa el uso y los límites de tu propia cuenta. Fuente: explicación de caché y uso en Claude Code.
Cómo fijarlo en la Messages API
En la API directa de Claude, coloca el valor en output_config.effort. Esta petición en Python muestra la forma del campo; presupone un cliente Anthropic ya configurado y no representa una llamada ejecutada para este artículo. Fuente: ejemplo oficial de la API.
pythonimport anthropic

client = anthropic.Anthropic()
response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=4096,
    messages=[{"role": "user", "content": "Revisa esta propuesta de cambio y señala los riesgos verificables."}],
    output_config={"effort": "medium"},
)
Puedes sustituir medium por low, high, xhigh o max. Si omites el campo, Opus 5.5 se comporta como medium. Deja un max_tokens suficiente al subir el esfuerzo: ese límite abarca pensamiento y respuesta, de modo que un techo demasiado pequeño puede impedir que la tarea avance aunque el nivel elegido sea alto. El pensamiento adaptativo de Opus 5.5 permanece activo; intentar desactivarlo con thinking: {"type": "disabled"} devuelve HTTP 400, igual que usar el formato antiguo de presupuesto enabled. Fuentes: documentación de esfuerzo y cambios de Opus 5.5.
Si tu aplicación necesita subir o bajar el esfuerzo dentro de la misma conversación, la API ofrece una función beta diferente del ajuste superior: requiere la cabecera mid-conversation-output-config-2026-07-01 y un mensaje system vacío con el nuevo output_config.effort. El cambio entra en vigor en el siguiente turno del usuario y conserva el prefijo anterior de la caché. Cambiar simplemente el effort superior entre peticiones no conserva ese prefijo. Esa ventaja de la beta no se traslada al comando /effort de Claude Code. Comprueba que tu ruta y cliente admiten esta función antes de incorporarla. Fuente: esfuerzo por mensaje en la documentación oficial.
¿Merece la pena subir de medium a high, xhigh o max?
Una comparación externa muestra por qué la respuesta no sale de mirar solo la puntuación. En el Artificial Analysis Intelligence Index v4.3.2, con fallback predeterminado activado, las fichas de Opus 5.5 publicaban los siguientes pares de puntuación y coste medio ponderado por tarea del índice al consultarlas el 23 de septiembre de 2026. Es un compuesto de diez evaluaciones. Los dólares de esta tabla no son el precio habitual de una petición tuya ni el cargo de una suscripción. [Fuentes: fichas de Artificial Analysis para low, medium, high, xhigh y max.]
effort de Opus 5.5 | Puntuación del índice | Coste ponderado por tarea del índice |
|---|---|---|
low | 42 | 0,55 USD |
medium | 51 | 1,34 USD |
high | 54 | 1,82 USD |
xhigh | 56 | 3,46 USD |
max | 58 | 5,98 USD |
En esa medición, subir de medium a high añadió 3 puntos y 0,48 USD por tarea del índice; de high a max, otros 4 puntos costaron 4,16 USD adicionales. Esa resta ayuda a leer el resultado, pero no mide tu repositorio ni demuestra que medium sea siempre la opción más rentable. Las cinco fichas usaron fallback y el índice puede actualizarse.
Para una aplicación propia, compara el mismo conjunto de tareas terminadas con una definición previa de éxito. Por ejemplo, selecciona diez incidencias representativas, conserva el mismo contexto y las mismas herramientas, y registra para cada nivel: incidencias resueltas y verificadas, turnos y reintentos, tiempo transcurrido, tokens de entrada y salida, lecturas y escrituras de caché. Anota también los casos en que la salida parecía correcta pero una prueba posterior falló. Diez incidencias serían solo una muestra de trabajo para decidir internamente, no un benchmark universal.
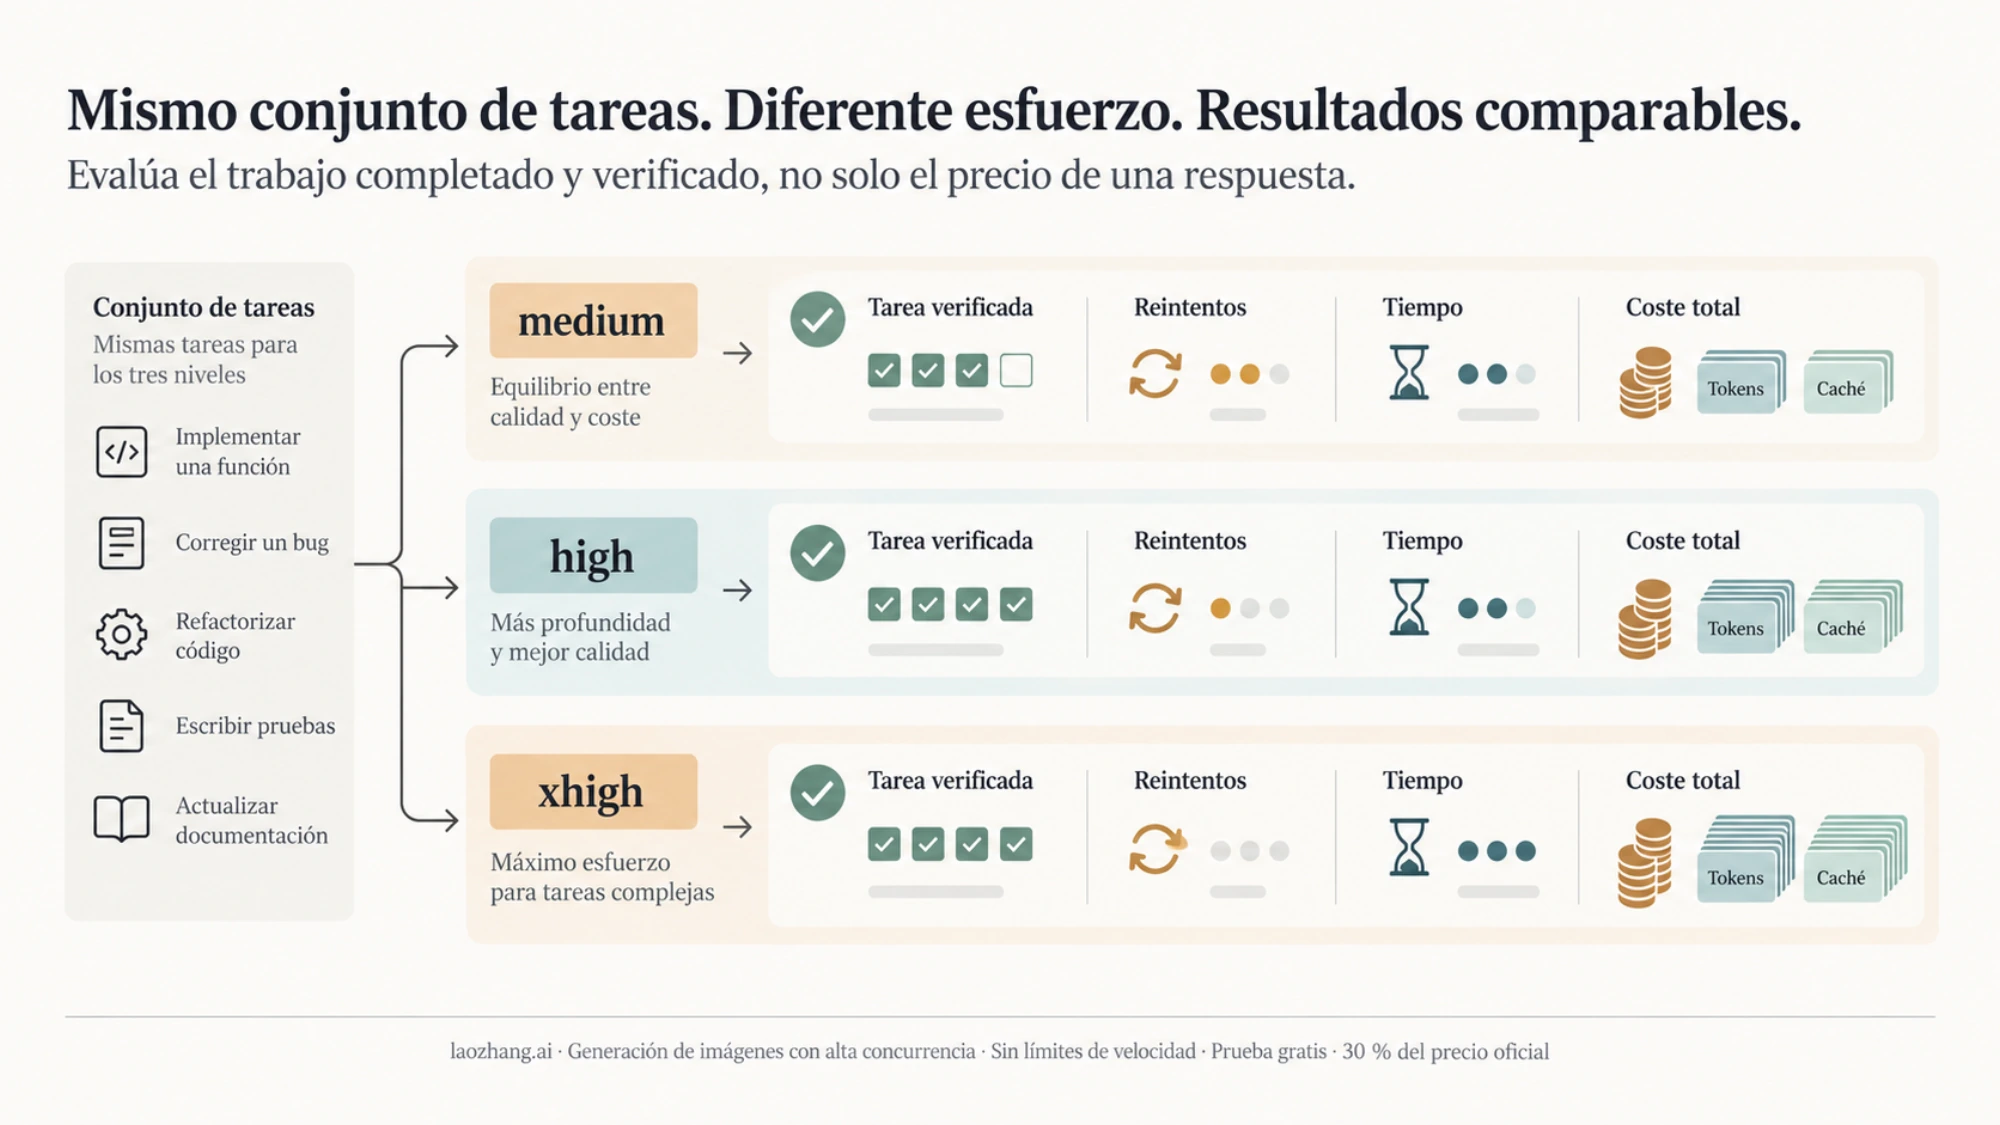
Calcula el coste por incidencia resuelta dividiendo el gasto total de todas las pruebas de ese nivel entre las incidencias que pasan la verificación. Incluye los intentos fallidos en el numerador. Si high cuesta más por intento pero evita repetir trabajo, puede salir mejor por tarea terminada; si medium ya termina a la primera, probablemente no recuperes el gasto extra. Acompaña el número de tiempo y tasa de éxito: un coste menor no compensa un resultado que llega demasiado tarde o deja errores.
Para valorar la API directa, usa los contadores de uso reales y las tarifas correspondientes: en Opus 5.5, Anthropic publica 4 USD por millón de tokens de entrada sin caché, 20 USD de salida, 0,20 USD de lectura de caché y 5 USD de escritura de caché de cinco minutos; la escritura de una hora figura a 8 USD. Son precios de lista en dólares de la API directa, antes de impuestos, recargos de proveedor u otras funciones. Los tokens de pensamiento cuentan en la salida. Mantener el mismo precio por millón no implica mantener el mismo coste por tarea al cambiar effort, porque también pueden cambiar la cantidad de tokens, las llamadas a herramientas y los reintentos. [Fuentes: tarifas oficiales de Opus 5.5 y explicación de costes de Anthropic.]
Decisión práctica: conserva medium mientras las tareas delimitadas pasen tus comprobaciones; baja a low en trabajo repetitivo que siga pasando; sube a high cuando falten pasos o la tarea exija más exploración. Usa xhigh o max solo después de medir una mejora que importe en trabajos largos o especialmente difíciles. No tenemos pruebas pagadas de tus tareas ni datos de disponibilidad de tu cuenta: la medición local es la que decide dónde acaba siendo rentable cada nivel.