A 24 de septiembre de 2026, Claude Opus 5.5 y GPT-5.6 Sol tienen la misma tarifa en la API: 4 USD por millón de tokens de entrada y 20 USD por millón de salida. La diferencia de coste aparece en tres sitios. Si una petición supera los 272.000 tokens de entrada, OpenAI factura toda la petición de GPT-5.6 Sol a 8/30 USD, mientras que Opus 5.5 mantiene la tarifa normal hasta 1 millón. La lectura de caché cuesta 0,20 USD en Opus 5.5 y 0,40 USD en GPT-5.6 Sol. Y Opus 5.5 escribe más tokens de salida por tarea: en el índice de Artificial Analysis generó unos 26.000 frente a 13.000 y ejecutar la batería completa costó cerca de un 9 % más, a cambio de una puntuación más alta (51 frente a 42).
Para elegir hoy:
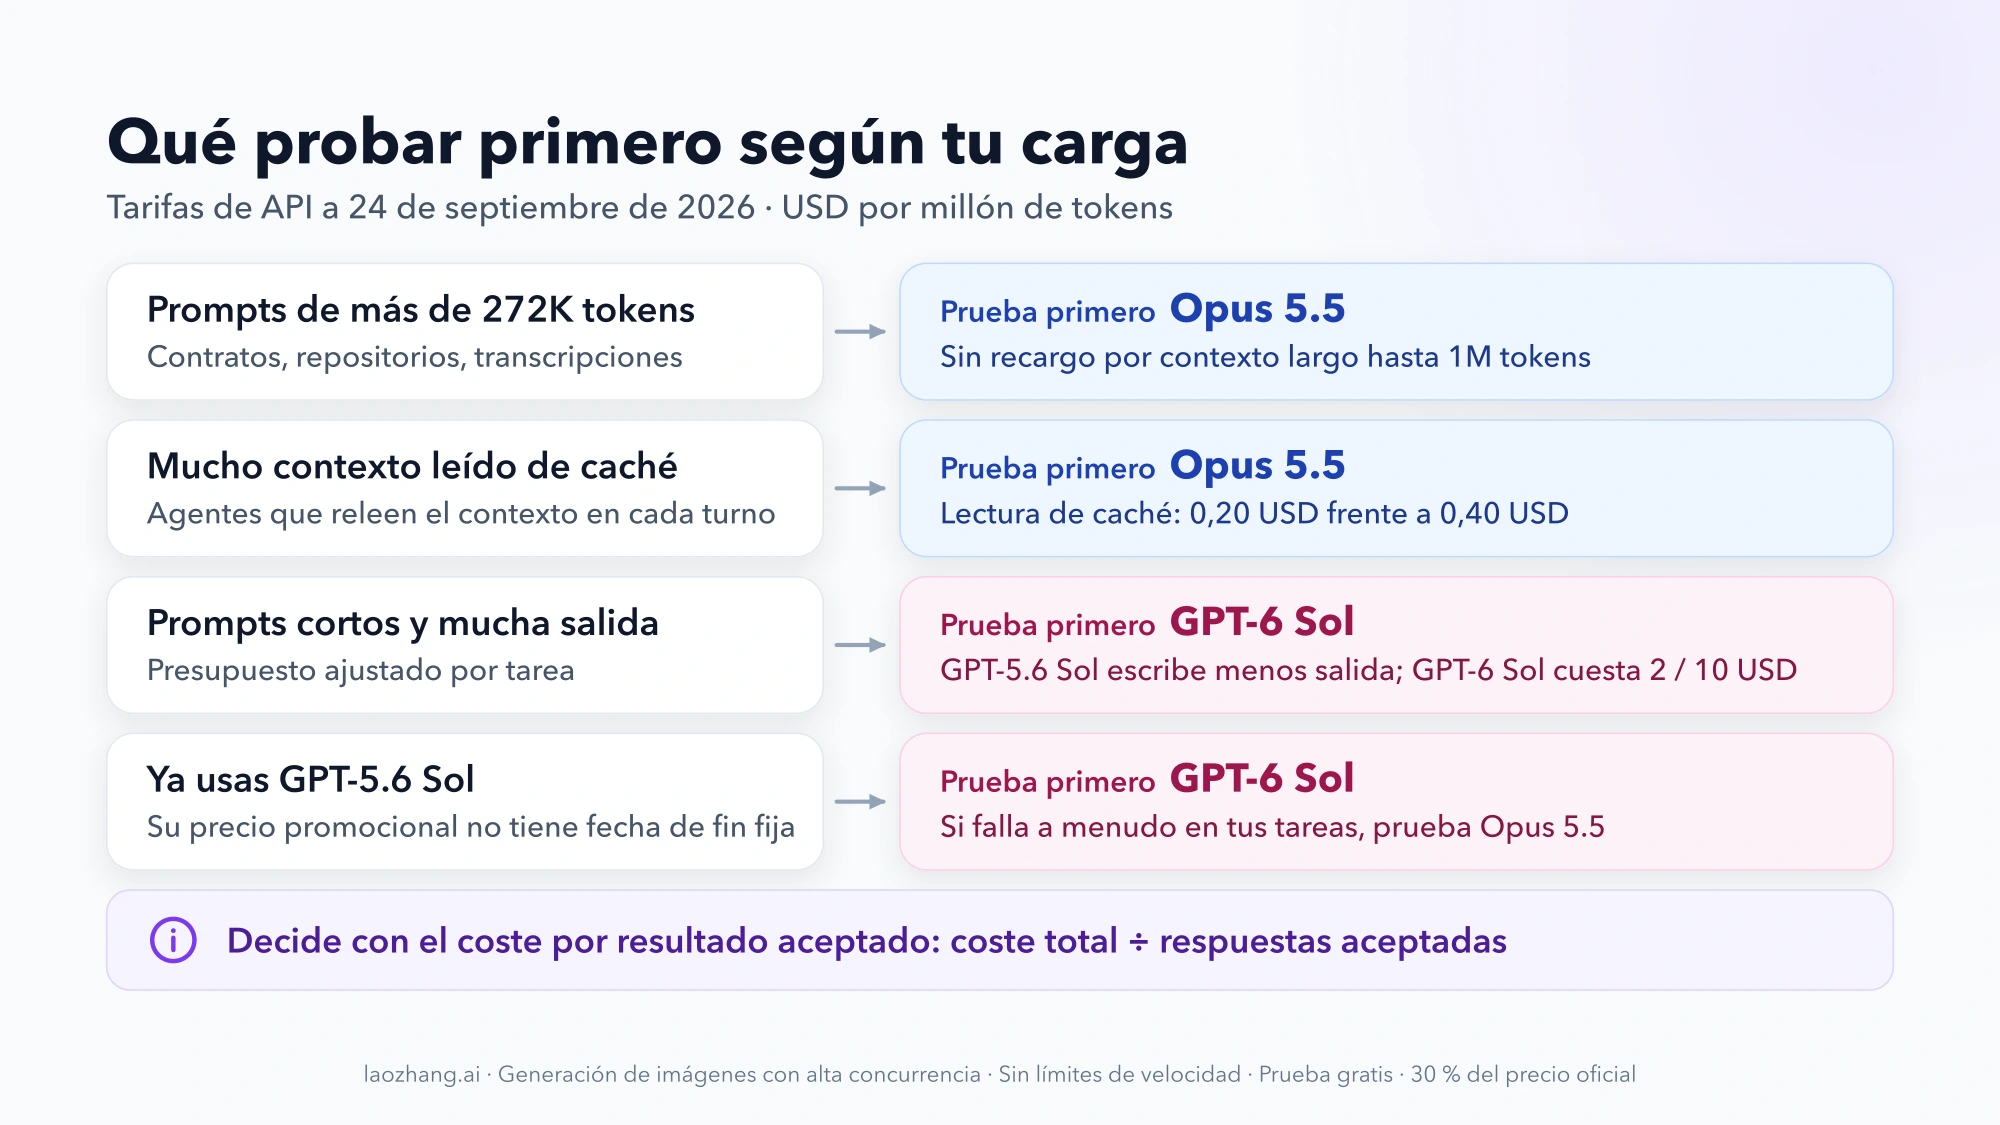
- Documentos largos, agentes con mucho contexto repetido o prompts de más de 272K tokens: Opus 5.5 es más barato por token y además puntúa más alto en el índice independiente. Es el primero que conviene probar.
- Prompts cortos con mucha salida y un presupuesto ajustado: GPT-5.6 Sol escribió la mitad de salida por tarea en el índice independiente, lo que abarata cada tarea con la misma tarifa. Antes de quedarte con él, prueba GPT-6 Sol, que cuesta 2/10 USD, la mitad.
- Ya usas GPT-5.6 Sol: su precio actual es promocional «al menos hasta el 21 de noviembre de 2026» y OpenAI no ha publicado el precio posterior. Mide primero GPT-6 Sol con tus propias tareas; pasa a Opus 5.5 si la calidad aceptada o el tamaño del contexto lo justifican.
En los tres casos, la cifra que decide es el coste por resultado aceptado con tus tareas, no el precio por token ni una sola tabla de benchmarks. Más abajo tienes los cálculos para repetirlos con tus números y un procedimiento de prueba.
Precios de la API a 24 de septiembre de 2026
Todos los importes son USD por millón de tokens en la API directa de cada proveedor, nivel estándar, sin impuestos, recargos por residencia de datos, herramientas ni márgenes de nubes o revendedores.
| Modelo (ID) | Entrada | Lectura de caché | Escritura de caché | Salida | Por encima de 272K tokens de entrada |
|---|---|---|---|---|---|
Claude Opus 5.5 (claude-opus-5-5) | 4 | 0,20 | 5 (5 min) / 8 (1 hora) | 20 | Sin recargo: todo el contexto de 1M a tarifa normal |
GPT-5.6 Sol (gpt-5.6-sol), precio promocional | 4 | 0,40 | 5 | 20 | Toda la petición a 8 / 0,80 / 10 / 30 |
GPT-6 Sol (gpt-6-sol) | 2 | 0,20 | 2,50 | 10 | Toda la petición a 4 / 0,40 / 5 / 15 |
Fuentes: precios de Claude, ficha de GPT-5.6 Sol, ficha de GPT-6 Sol y precios de OpenAI.
Tres detalles cambian la lectura de esta tabla:
- El precio de GPT-5.6 Sol es promocional. OpenAI lo mantiene «al menos hasta el 21 de noviembre de 2026» y no indica qué tarifa vendrá después. Cuando se presentó GPT-5.6, el 9 de julio de 2026, Sol costaba 5/30 USD.
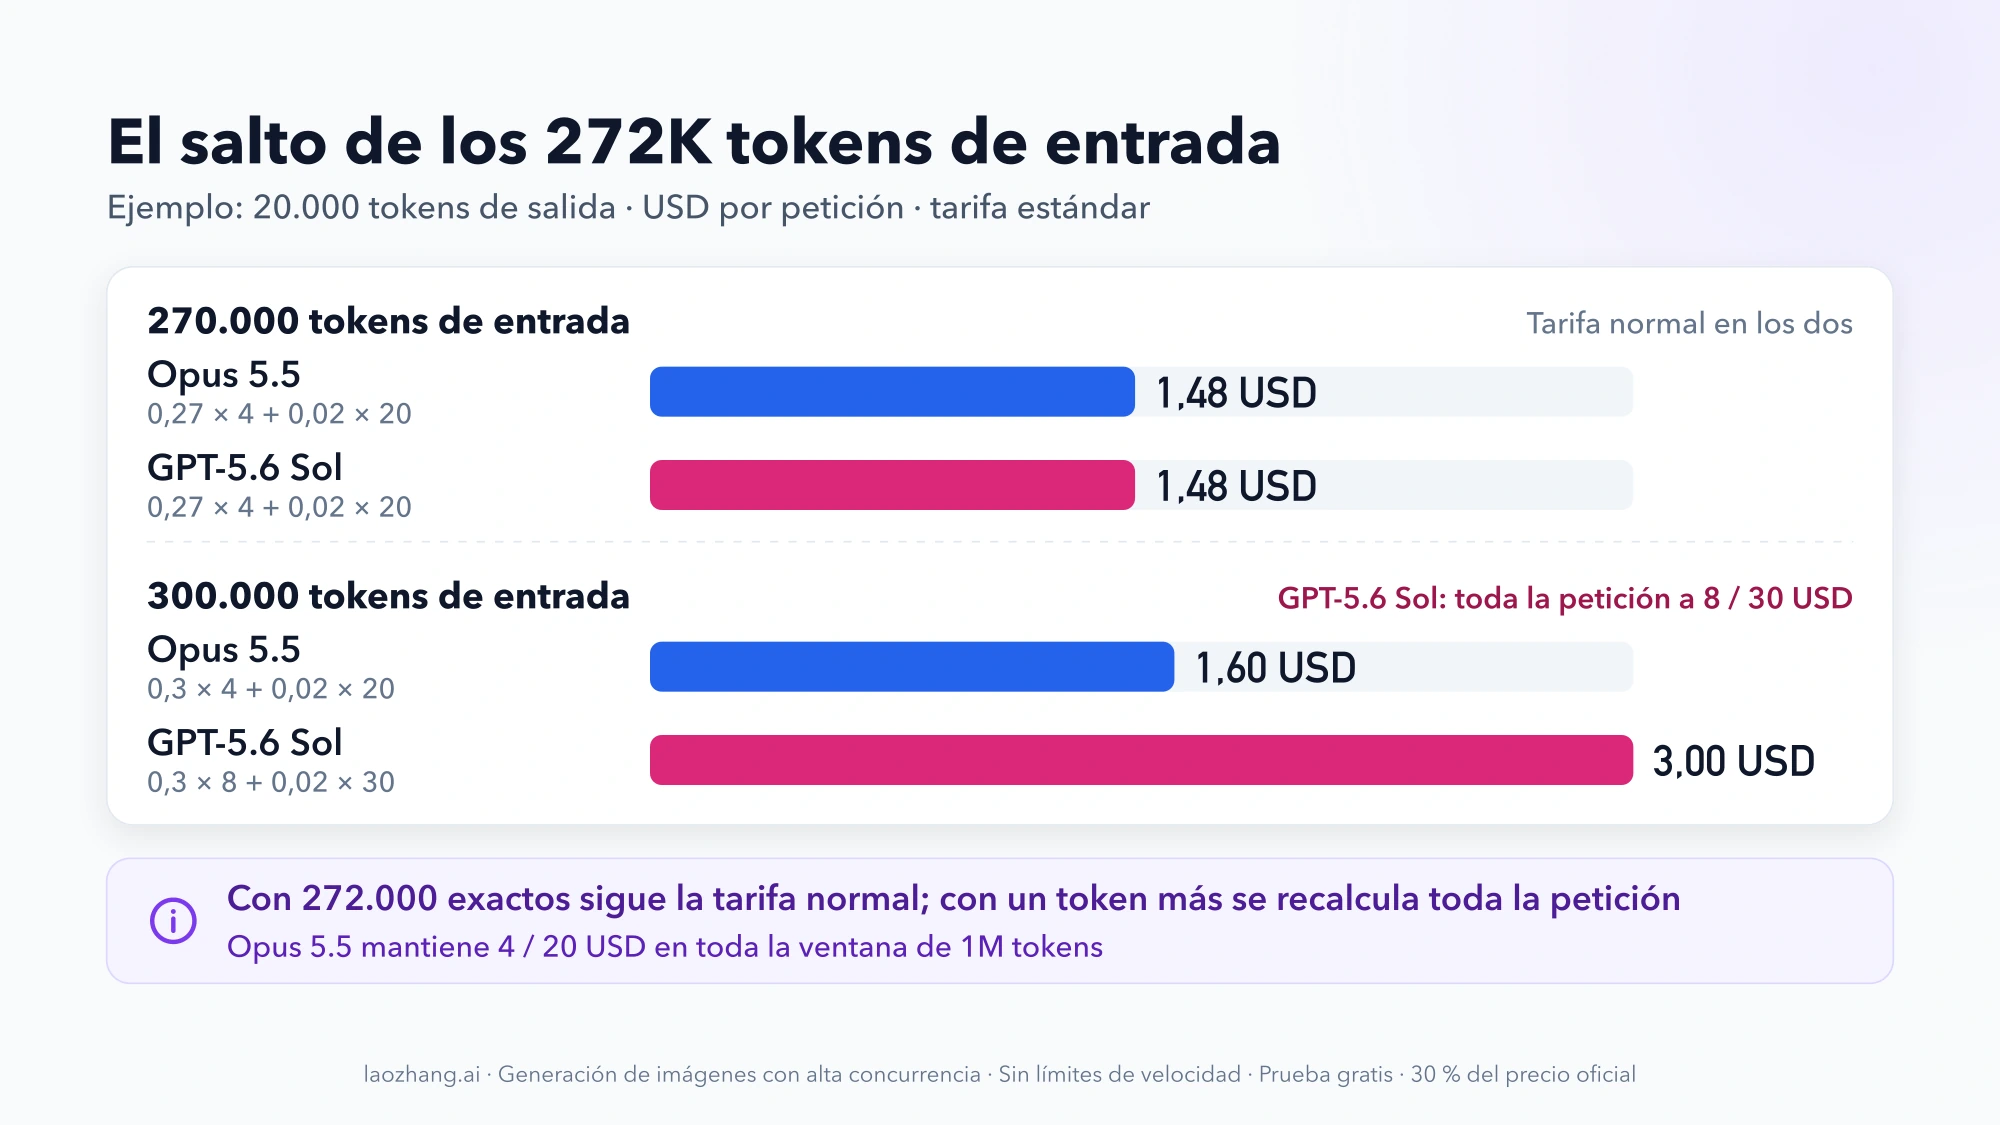
- El umbral de OpenAI es «más de 272K» tokens de entrada. Con 272.000 exactos sigue la tarifa normal; con uno más se recalcula la petición entera, no solo el exceso.
- La residencia de datos tiene recargo en los dos proveedores: Anthropic multiplica por 1,1 todas las categorías de tokens si fijas la inferencia en EE. UU., y OpenAI añade un 10 % en sus endpoints de procesamiento regional. Si necesitas alguna de esas opciones, suma el recargo al proveedor correspondiente.
Si quieres profundizar en cada familia, tienes los detalles de facturación de Anthropic en Claude Opus 5.5: precio de la API y qué revisar antes de migrar y los de OpenAI en GPT-6 Luna frente a Sol: precios de API y créditos de Codex.
Tres cálculos con los mismos tokens
Los tres ejemplos suponen el mismo número de tokens en cada modelo, sin herramientas. Sirven para ver dónde se separan las tarifas; la factura real de una misma tarea será distinta porque cada modelo tokeniza el texto a su manera y escribe una cantidad diferente de salida (lo verás en la sección siguiente).
1. Prompt corto: 100.000 tokens de entrada nuevos y 10.000 de salida.
- Opus 5.5: 0,1 × 4 + 0,01 × 20 = 0,60 USD
- GPT-5.6 Sol (promocional): 0,1 × 4 + 0,01 × 20 = 0,60 USD
- GPT-5.6 Sol a precio de lanzamiento (5/30): 0,1 × 5 + 0,01 × 30 = 0,80 USD
- GPT-6 Sol: 0,1 × 2 + 0,01 × 10 = 0,30 USD
Con prompts cortos y sin caché, Opus 5.5 y GPT-5.6 Sol empatan por token. El caso de 5/30 no es una previsión: solo muestra cuánto cambiaría el cálculo si Sol volviera a su precio de julio.
2. Documento largo: 300.000 tokens de entrada nuevos y 20.000 de salida.
- Opus 5.5: 0,3 × 4 + 0,02 × 20 = 1,60 USD
- GPT-5.6 Sol (más de 272K): 0,3 × 8 + 0,02 × 30 = 3,00 USD
- GPT-6 Sol (más de 272K): 0,3 × 4 + 0,02 × 15 = 1,50 USD
El salto es brusco. Con 270.000 tokens de entrada y la misma salida, GPT-5.6 Sol costaría 0,27 × 4 + 0,02 × 20 = 1,48 USD, igual que Opus 5.5. Unos pocos miles de tokens más casi duplican la factura de Sol, mientras que la de Opus solo crece en proporción. Si trabajas con contratos, repositorios o transcripciones que rondan ese tamaño, este es el factor que más pesa.
3. Mucha caché: 200.000 tokens leídos de caché, 20.000 nuevos y 5.000 de salida.
- Opus 5.5: 0,2 × 0,20 + 0,02 × 4 + 0,005 × 20 = 0,22 USD
- GPT-5.6 Sol: 0,2 × 0,40 + 0,02 × 4 + 0,005 × 20 = 0,26 USD
- GPT-6 Sol: 0,2 × 0,20 + 0,02 × 2 + 0,005 × 10 = 0,13 USD
Aquí no se incluye la escritura inicial en caché (5 USD por millón en ambos modelos; 8 USD en Opus si eliges caché de 1 hora). En agentes que releen el mismo contexto en cada turno, la lectura de caché a mitad de precio es una ventaja de Opus 5.5 que se acumula turno a turno.
Por qué la misma tarifa no produce la misma factura
La tarifa por token es solo una parte del precio. La otra es cuántos tokens necesita cada modelo para resolver la misma tarea.
Artificial Analysis comparó Opus 5.5 con esfuerzo medio (el nivel por defecto de Anthropic) y GPT-5.6 Sol con esfuerzo alto:
| Artificial Analysis | Opus 5.5 (medio) | GPT-5.6 Sol (alto) |
|---|---|---|
| Intelligence Index | 51 | 42 |
| Tokens de salida por tarea | 26.000 | 13.000 |
| Tokens de razonamiento por tarea | 12.000 | 6.000 |
| Coste de ejecutar el índice | 1.627 USD | 1.487 USD |
| Velocidad de salida | 78 tokens/s | 69 tokens/s |
| Tiempo hasta el primer token de respuesta | 21,62 s | 14,72 s |
Con la misma tarifa, ejecutar el índice con Opus 5.5 costó cerca de un 9 % más (1.627 / 1.487 ≈ 1,09), con el doble de tokens de salida por tarea. En la comparación con esfuerzo máximo en ambos, la puntuación sube a 58 frente a 47, pero el coste pasa a 8.708 frente a 3.465 USD, unas 2,5 veces más para Opus. Es un único evaluador con su propio conjunto de pruebas y las cifras pueden cambiar, pero la conclusión práctica es clara: en estas mediciones, si subes el esfuerzo (effort, el parámetro que regula cuánto razona el modelo) de Opus 5.5, el coste crece más deprisa que el de Sol. Cómo elegir ese nivel se explica en Effort en Claude Opus 5.5: qué nivel elegir y cómo medir si compensa.
Hay un segundo factor que ningún proveedor cuantifica frente al otro: el tokenizador. Anthropic indica en su página de precios que los modelos Claude 4.7 y posteriores generan alrededor de un 30 % más de tokens para el mismo texto que su tokenizador anterior. No hay una cifra pública de cuántos tokens produce Claude frente a OpenAI con el mismo documento, así que el mismo PDF puede costar distinto con la misma tarifa. La única forma de saberlo es medir los campos de uso (usage) que devuelve cada API con tus textos.
Un caso aislado lo ilustra. En una prueba de DataCamp con una única tarea (un Tetris en un solo archivo con inversión de gravedad), GPT-6 Sol gastó 0,26 USD y obtuvo 5,0 en su rúbrica; Opus 5.5 gastó 0,87 USD y obtuvo 4,3. Es un solo intento con GPT-6 Sol, no con GPT-5.6 Sol, y no sirve como veredicto, pero muestra que el coste por tarea y la calidad aceptada pueden ir en direcciones que la tabla de precios no anticipa.
Qué dicen los benchmarks y por qué no se cruzan las tablas
Anthropic publicó en el lanzamiento de Opus 5.5 una tabla que incluye a GPT-5.6 Sol:
| Tabla de Anthropic | Opus 5.5 | GPT-5.6 Sol |
|---|---|---|
| Terminal-Bench 4.0 (Opus con esfuerzo xhigh) | 66,4 % | 37,3 % |
| FrontierCode v1.1 | 54,4 % | 47,5 % |
| CursorBench 4.0 | 57,8 % | 41,7 % |
| GDPval-AA v2.1 | 1846 | 1588 |
| AutomationBench (ejecutado por Zapier) | 40,0 % | 28,8 % |
OpenAI, en el anuncio de GPT-5.6, usó otras pruebas para Sol: Terminal-Bench 2.1 (88,8 %), SWE-Bench Pro (64,6 %), OSWorld 2.0 (62,6 %) y BrowseComp (90,4 %). Las dos tablas casi no comparten versiones de benchmark, así que un 88,8 % en una no se puede poner al lado del 66,4 % de la otra.
El único benchmark que aparece en ambas lo deja claro: en AutomationBench, GPT-5.6 Sol figura con un 28,8 % en la tabla de Anthropic y con un 18,1 % en la de OpenAI. Esa diferencia no dice cuál de las dos ejecuciones es la correcta; dice que la versión del benchmark, el entorno de ejecución y el nivel de esfuerzo cambian el resultado lo suficiente como para que las cifras de proveedores distintos no se comparen fila a fila.
Por eso tiene más valor un índice independiente que aplica la misma batería a los dos modelos, como el de Artificial Analysis de la sección anterior. Aun así, un índice general no sustituye a tus tareas: mide promedios en pruebas ajenas y no sabe si tu prompt de extracción de facturas o tu agente de soporte funcionan mejor con uno u otro.
Si ya usas GPT-5.6 Sol: ¿Opus 5.5 o GPT-6 Sol?
OpenAI lanzó GPT-6 Sol el mismo día que Anthropic presentó Opus 5.5, el 22 de septiembre de 2026, y su registro de cambios indica que GPT-6 Sol y Luna llegan «a precios por token más bajos que sus predecesores GPT-5.6». En la API, GPT-6 Sol cuesta exactamente la mitad que la tarifa promocional de GPT-5.6 Sol, también por encima de 272K.
Lo que falta es un dato fiable de cuánto mejora GPT-6 Sol sobre GPT-5.6 Sol: ni la ficha del modelo ni el registro de cambios lo cuantifican. Tampoco hay fecha de retirada publicada para GPT-5.6 Sol. Con eso, el orden razonable es:
- Prueba GPT-6 Sol primero. Es el cambio más barato: mismo proveedor, mismos niveles de esfuerzo (de none a max), mismo contexto de 1.050.000 tokens y la mitad de precio. Si con tus tareas iguala o mejora la tasa de aceptación de GPT-5.6 Sol, el ahorro es inmediato.
- Prueba Opus 5.5 si tu carga lo favorece: prompts que superan los 272K, contexto muy reutilizado o tareas en las que Sol falla con frecuencia. Opus 5.5 puntúa más alto en el índice independiente y en la tabla de Anthropic, pero cuesta el doble por token que GPT-6 Sol y suele escribir más salida.
- No te quedes en GPT-5.6 Sol por inercia. Su tarifa de 4/20 USD es promocional y el precio que tenga después del 21 de noviembre de 2026 no está publicado.
Si el resultado de la prueba te lleva a Opus 5.5 y ya tienes código escrito para Opus 5, no basta con cambiar el ID: el razonamiento ya no se puede desactivar y forzar la elección de herramienta devuelve un error, entre otros cambios. Los tienes detallados en Claude Opus 5.5: precio de la API y qué revisar antes de migrar. Si también dudas entre modelos de Anthropic, mira Claude Opus 5.5 o Fable 5.1: cuál elegir y cuánto cuesta en la API; y para ubicar a Sol dentro de la familia de OpenAI, Modelos de texto de OpenAI en 2026: Sol, Terra y Luna comparados.
Cómo probar antes de cambiar
Una prueba pequeña con tu propio trabajo te dice más que cualquier tabla. Este procedimiento no requiere infraestructura especial:
- Reúne tareas reales, no de ejemplo. Toma peticiones de producción recientes que representen tu mezcla: las cortas, las largas que rozan o superan los 272K tokens y las que reutilizan contexto. Anota qué respuesta habrías aceptado.
- Fija la configuración de cada modelo. Empieza por el esfuerzo por defecto (medium en los tres) y usa los mismos prompts de sistema, las mismas herramientas y la misma política de caché. Si luego subes el esfuerzo, trátalo como otra variante con su propio coste.
- Guarda los tokens de cada llamada. Registra desde los campos de uso de cada API la entrada nueva, la leída de caché, la escrita en caché y la salida, y calcula el importe con la tabla de precios. Así ves el efecto real del tokenizador y de la longitud de salida.
- Evalúa sin saber qué modelo respondió. Marca cada respuesta como aceptada o no con el mismo criterio que usas en producción (pasa los tests, no necesita corrección manual, cumple el formato).
- Divide el coste total entre los resultados aceptados. Coste por resultado aceptado = suma del importe de todas las llamadas ÷ número de respuestas aceptadas. Un modelo más caro por llamada puede salir más barato si necesita menos reintentos, y al revés.
- Compara también el tiempo. En Artificial Analysis, Opus 5.5 tardó más en dar el primer token de respuesta (21,62 s frente a 14,72 s). Si tu producto es interactivo, mide la latencia junto al coste.
Todas las cifras anteriores son de la API. Los límites de uso por cuenta, la disponibilidad por región y las cuotas de las suscripciones de ChatGPT o Claude son otra cuestión: revísalos en tu propia cuenta si van a condicionar el cambio.
Preguntas frecuentes
¿Es Claude Opus 5.5 mejor que GPT-5.6 Sol?
En el índice independiente de Artificial Analysis, sí: 51 frente a 42 con los ajustes habituales y 58 frente a 47 en esfuerzo máximo. En la tabla de Anthropic también gana en todas las filas compartidas, pero es la tabla de un proveedor. Lo que no está demostrado es que gane en tus tareas concretas, y además suele gastar más tokens de salida.
¿Seguirá costando GPT-5.6 Sol 4/20 USD?
OpenAI mantiene ese precio «al menos hasta el 21 de noviembre de 2026» y no publica cuál será después. En su lanzamiento, en julio de 2026, costaba 5/30 USD, pero eso no significa que vaya a volver a esa cifra.
¿Qué diferencia hay entre GPT-5.6 Sol y GPT-6 Sol?
GPT-6 Sol es el modelo posterior, lanzado el 22 de septiembre de 2026, con la mitad de precio por token (2/10 USD, y 4/15 USD por encima de 272K). Los dos admiten los mismos niveles de esfuerzo y una ventana de 1.050.000 tokens. No hay cifras de primera mano que midan cuánto mejora GPT-6 Sol sobre GPT-5.6 Sol, así que conviene comprobarlo con tus tareas.
¿Cuál sale más barato con documentos largos?
Por encima de 272.000 tokens de entrada, Opus 5.5 cuesta aproximadamente la mitad que GPT-5.6 Sol con los mismos tokens (1,60 frente a 3,00 USD en el ejemplo de 300K de entrada y 20K de salida). GPT-6 Sol queda casi igual que Opus 5.5 en ese mismo ejemplo (1,50 USD), porque su recargo por contexto largo parte de una tarifa más baja.


