Si utilizas la API directa de Claude, empieza la comparación con Opus 5.5. Su tarifa estándar es inferior a la de Fable 5.1 en entrada, salida, escritura y lectura de caché, y con el mismo consumo de tokens Fable sale unas 2,4 veces más caro. Fable sigue mereciendo una prueba en razonamiento especialmente exigente o agentes que trabajan durante horas, pero tendrá que resolver más tareas, necesitar menos intentos o ahorrar suficiente revisión para compensar su precio. No hay un umbral de lecturas de caché que, por sí solo, le dé la vuelta a la factura con el mismo consumo de tokens.
Por debajo de esos dos, la gama se renovó entre finales de septiembre y principios de octubre. Según la página de modelos de Anthropic, a 8 de octubre de 2026 los modelos actuales son Fable 5.1 (el de mayor capacidad), Opus 5.5, Sonnet 5.5 (publicado el 28 de septiembre) y Haiku 5.5 (publicado el 7 de octubre). Sonnet 5 y Haiku 4.5 pasan a ser modelos anteriores, aún disponibles. Los cuatro actuales tienen un contexto de un millón de tokens y una salida máxima de 128.000.
Esta elección afecta al coste por tarea aceptada, no solo al precio por millón de tokens. También depende del nivel de effort: Opus 5.5 y Haiku 5.5 empiezan en medium, y Fable 5.1 y Sonnet 5.5 en high, según la documentación de effort. La propia guía de Anthropic recuerda que ajustar el effort suele ser mejor palanca que cambiar de modelo, así que antes de atribuir una diferencia al modelo, deja constancia del nivel usado en cada prueba.
Cuánto cuesta Opus 5.5 frente a Fable 5.1
La tarifa de Anthropic para la API directa, a 8 de octubre de 2026, expresa estos importes en dólares por un millón de tokens. Son precios estándar; no incluyen herramientas adicionales, impuestos, modo Fast, Batch ni precios propios de plataformas asociadas.
| Tipo de token | Opus 5.5 | Fable 5.1 |
|---|---|---|
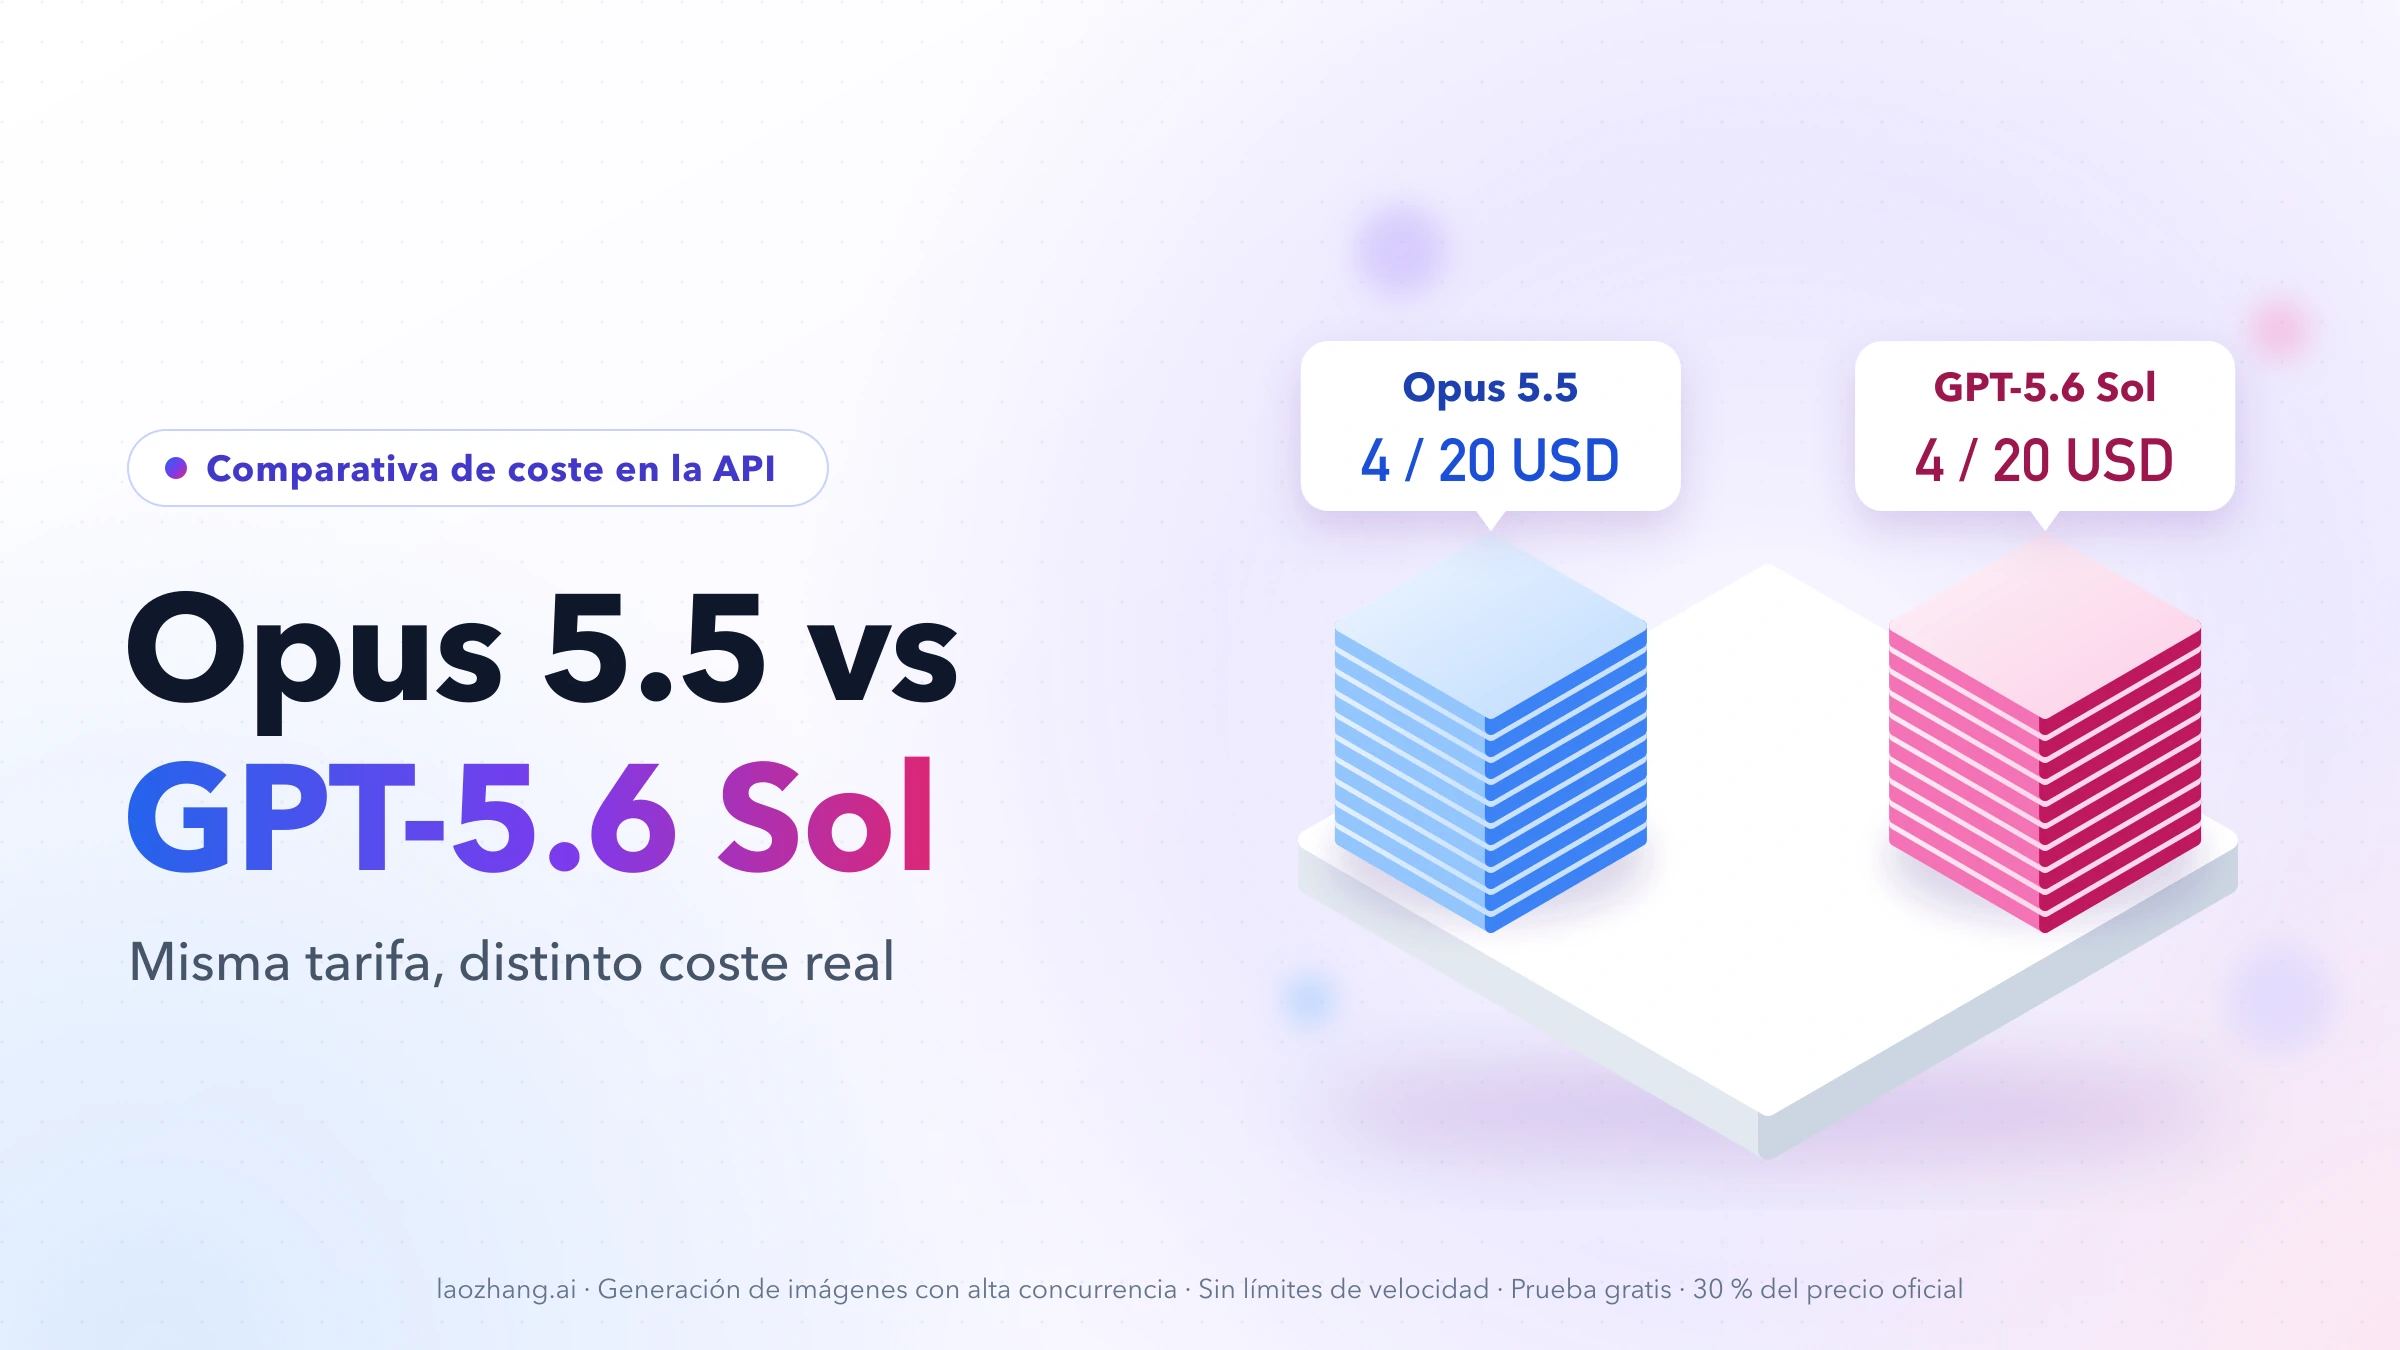
| Entrada nueva | 4 $ | 10 $ |
| Salida | 20 $ | 50 $ |
| Escritura de caché, 5 minutos | 5 $ | 12,50 $ |
| Escritura de caché, 1 hora | 8 $ | 20 $ |
| Lectura de caché | 0,20 $ | 0,25 $ |
Con la misma cantidad de cada clase de tokens, Opus 5.5 cuesta menos en todas las filas. Sus tarifas de entrada nueva, salida y escritura equivalen al 40 % de las de Fable; la lectura de caché equivale al 80 %. Por eso ya no sirve la regla anterior de que Fable 5.1 podía ganar a Opus 5 cuando se releía muchas veces el mismo contexto: aquella comparación utilizaba los 0,50 $ por millón de lecturas de Opus 5, no los 0,20 $ de Opus 5.5.
Por ejemplo, supón un intento con un prompt de 90.000 tokens (30.000 de entrada nueva y 60.000 leídos de caché) y 5.000 tokens de salida, sin nuevas escrituras ni otros cargos:
- Opus 5.5:
0,03 × 4 + 0,06 × 0,20 + 0,005 × 20 = 0,232 $. - Fable 5.1:
0,03 × 10 + 0,06 × 0,25 + 0,005 × 50 = 0,565 $, unas 2,4 veces más.
Cuando la caché pesa mucho más, la distancia se reduce, pero no se invierte. En un agente de 20 turnos que relee en cada uno un prefijo de 80.000 tokens en caché (1,6 millones de lecturas en total), con 50.000 tokens de entrada nueva y 10.000 de salida, sin contar la escritura inicial:
- Opus 5.5:
1,6 × 0,20 + 0,05 × 4 + 0,01 × 20 = 0,72 $. - Fable 5.1:
1,6 × 0,25 + 0,05 × 10 + 0,01 × 50 = 1,40 $, casi el doble.
Son ejemplos con consumo idéntico, no mediciones de ambos modelos en una tarea real. Si uno genera más tokens de razonamiento o de salida, hace más llamadas o necesita varios intentos, la diferencia efectiva cambia. La caché tampoco es gratuita: su escritura se factura aparte y su utilidad depende de que las peticiones posteriores reutilicen el prefijo.
¿Es Opus 5.5 tan capaz como Fable 5.1?
Anthropic presenta a Opus 5.5 como comparable a Fable 5.1 en la mayor parte del trabajo y publica resultados favorables a Opus en varias pruebas. En su anuncio de Opus 5.5, por ejemplo, comunica un 66,4 % frente a un 55,8 % en Terminal-Bench 4.0 y un 57,8 % frente a un 51,8 % en CursorBench 4.0. Son resultados del proveedor para versiones y configuraciones concretas, no una garantía para tu repositorio o tus documentos.
El ajuste de esfuerzo cambia la lectura de esas cifras. Salvo las excepciones que detalla Anthropic, los resultados publicados de Opus 5.5 utilizan max; Terminal-Bench 4.0 se informa con xhigh. El valor predeterminado de Opus 5.5 en la API es medium. No conviene trasladar una puntuación obtenida con esfuerzo alto a una estimación de coste calculada con el ajuste predeterminado como si fueran la misma ejecución. Anthropic también advierte que, con modelos de este nivel, los márgenes en las pruebas orientan cada vez peor sobre las diferencias reales, y que en su uso interno la distancia entre Opus 5.5 y Fable 5.1 es menor de lo que sugieren las puntuaciones.
El otro porcentaje fácil de confundir es el 40 % menos de coste que anuncia Anthropic para Opus 5.5: su referencia es Opus 5, no Fable 5.1. La tabla anterior permite comparar el precio de Opus 5.5 y Fable 5.1 por token; una reducción concreta del coste por trabajo entre ambos exige medir el consumo y el resultado del mismo flujo.
Cuándo probar Fable 5.1 y cómo decidirlo
La guía oficial para elegir modelo indica que la mayoría de cargas de trabajo empiezan con Opus 5.5, el modelo para programación agéntica compleja y trabajo empresarial. Recomienda pasar a Fable 5.1 cuando tus evaluaciones con Opus en xhigh o max siguen quedándose cortas en razonamiento exigente o en trabajo agéntico de larga duración. Eso orienta la primera prueba, pero la decisión para producción debe salir de tus propios criterios de aceptación.
Prepara un conjunto pequeño de trabajos representativos: tareas corrientes, tareas largas y fallos que resultarían caros. Define antes qué cuenta como éxito: tests que pasan, cifras conciliadas con sus fuentes, un documento revisable o una operación terminada sin intervención. Ejecuta Opus 5.5 y Fable 5.1 con la misma entrada, herramientas, permisos, límite de tiempo y regla de parada. Anota el effort de cada ejecución y prueba primero Opus con un nivel mayor si medium falla en trabajos importantes.
| Registro por tarea | Por qué importa |
|---|---|
| Entrada nueva, salida, escrituras y lecturas de caché | Permite aplicar la tarifa real a cada ejecución. |
| Éxito inicial, reintentos y fallo definitivo | Un modelo barato por token puede necesitar más intentos. |
| Tiempo hasta un resultado aceptado | Una respuesta rápida que requiere reparaciones puede tardar más en conjunto. |
| Revisión y correcciones humanas | Son parte del trabajo necesario para entregar el resultado. |
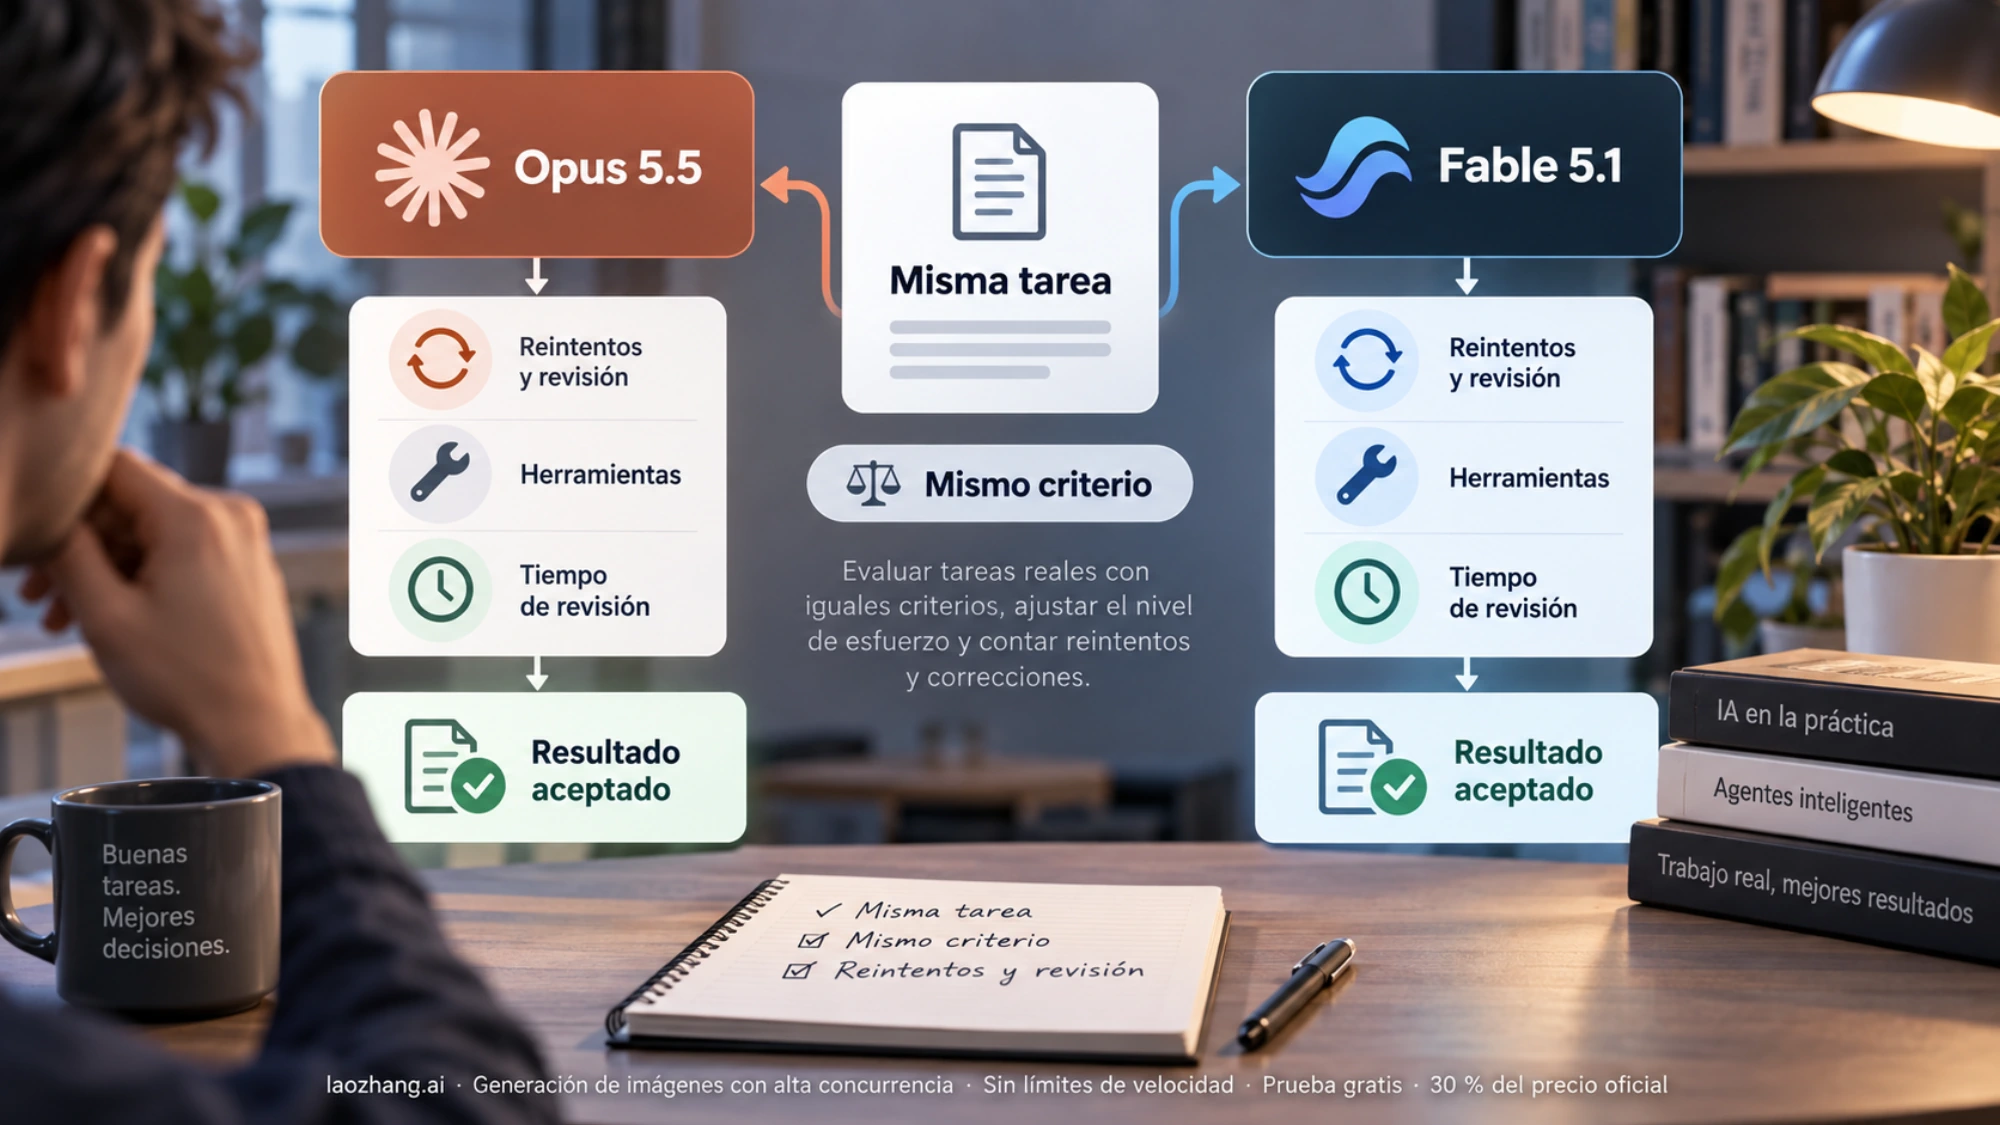
Calcula coste por tarea aceptada = (API de todos los intentos + herramientas + tiempo humano valorado) ÷ tareas aceptadas. Si no dispones de una valoración monetaria fiable del tiempo humano, informa por separado del gasto de API y de los minutos de revisión por tarea aceptada. Si Opus supera las pruebas al nivel de esfuerzo elegido, no hay una ventaja de tarifa de caché que obligue a pasar a Fable. Si Fable resuelve fallos persistentes o reduce suficiente trabajo posterior, resérvalo para ese grupo concreto de tareas.
El contexto de un millón de tokens y la salida máxima estándar de 128.000 tokens son iguales en los cuatro modelos actuales. Esas cifras no significan que cada tarea deba llenar el contexto ni que vaya a producir la salida máxima. Tampoco convierten el precio de la API en una cuota de mensajes de Claude Pro o Max.
Sonnet 5.5 y Haiku 5.5: cuándo bastan sin subir a Opus
Antes de pagar por cualquiera de los dos modelos más caros, comprueba si el trabajo requiere esa capacidad. La guía de selección de Anthropic sitúa Sonnet 5.5 en el código, los agentes y el trabajo empresarial del día a día, y Haiku 5.5 donde mandan la latencia y el precio: tiempo real, grandes volúmenes y subagentes. Su ficha lo describe para clasificación, extracción y enrutado. La misma tabla de precios fija el punto de partida económico (USD por millón de tokens):
| Modelo | ID en la API | Entrada / lectura de caché / salida | Effort por defecto | Primera prueba razonable |
|---|---|---|---|---|
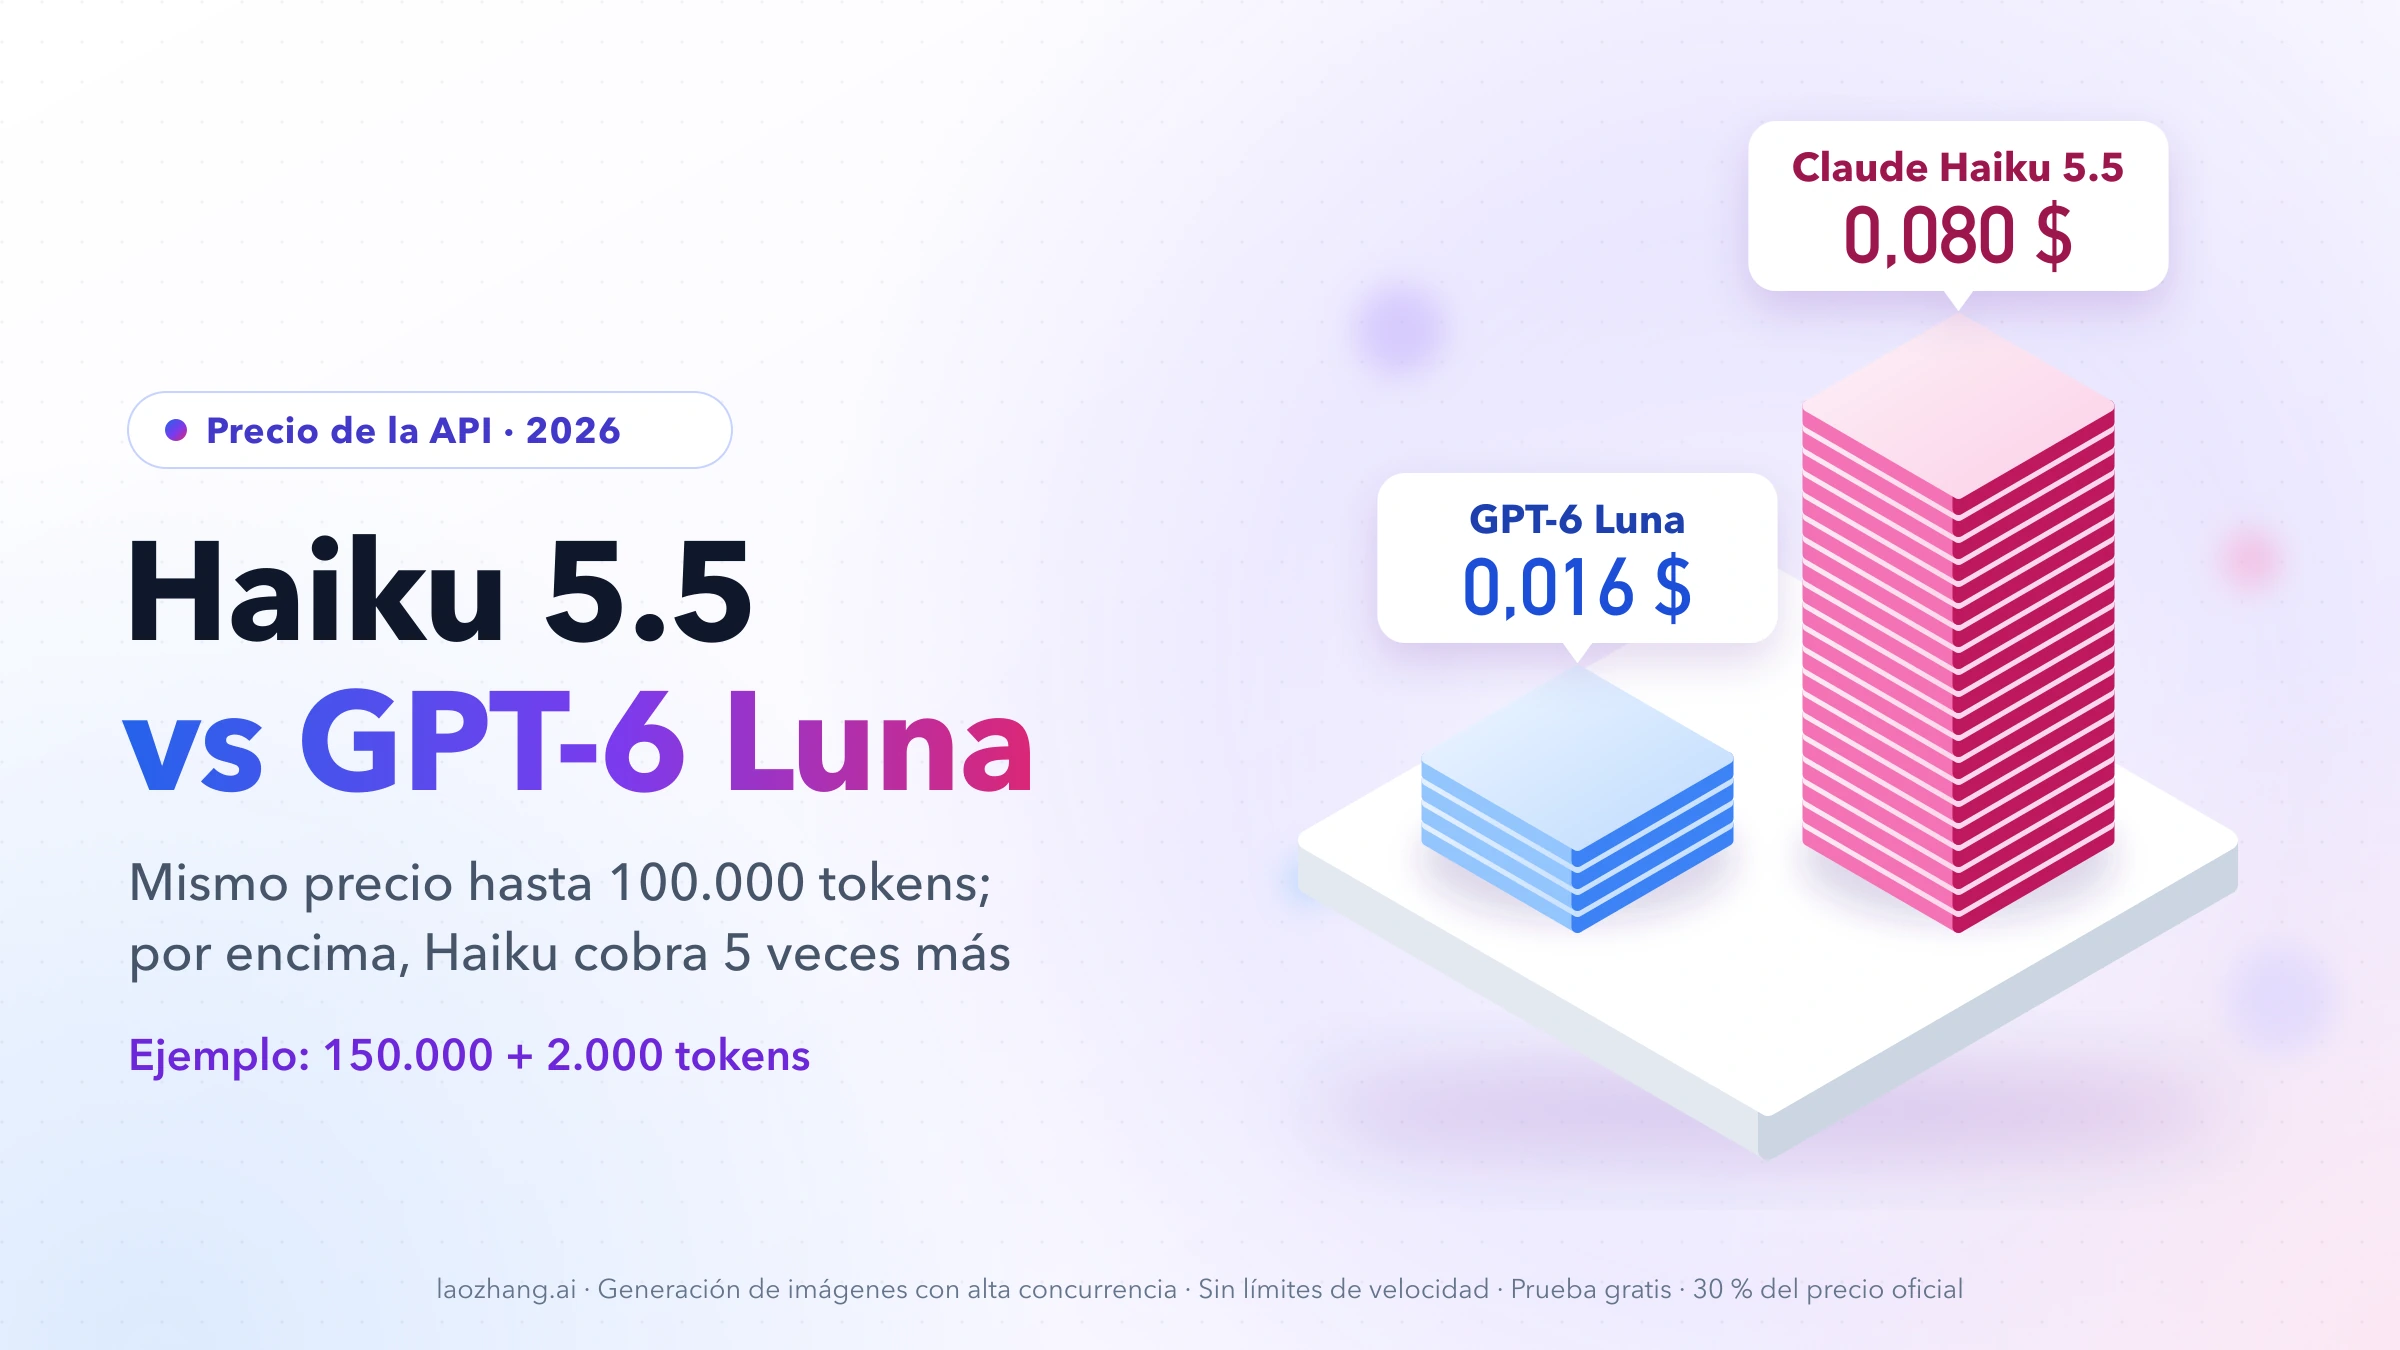
| Haiku 5.5 | claude-haiku-5-5 | 0,10 $ / 0,01 $ / 0,50 $ con prompts de hasta 100.000 tokens; ×5 por encima | medium | Clasificación, extracción, enrutado o subagentes con fallos fáciles de detectar. |
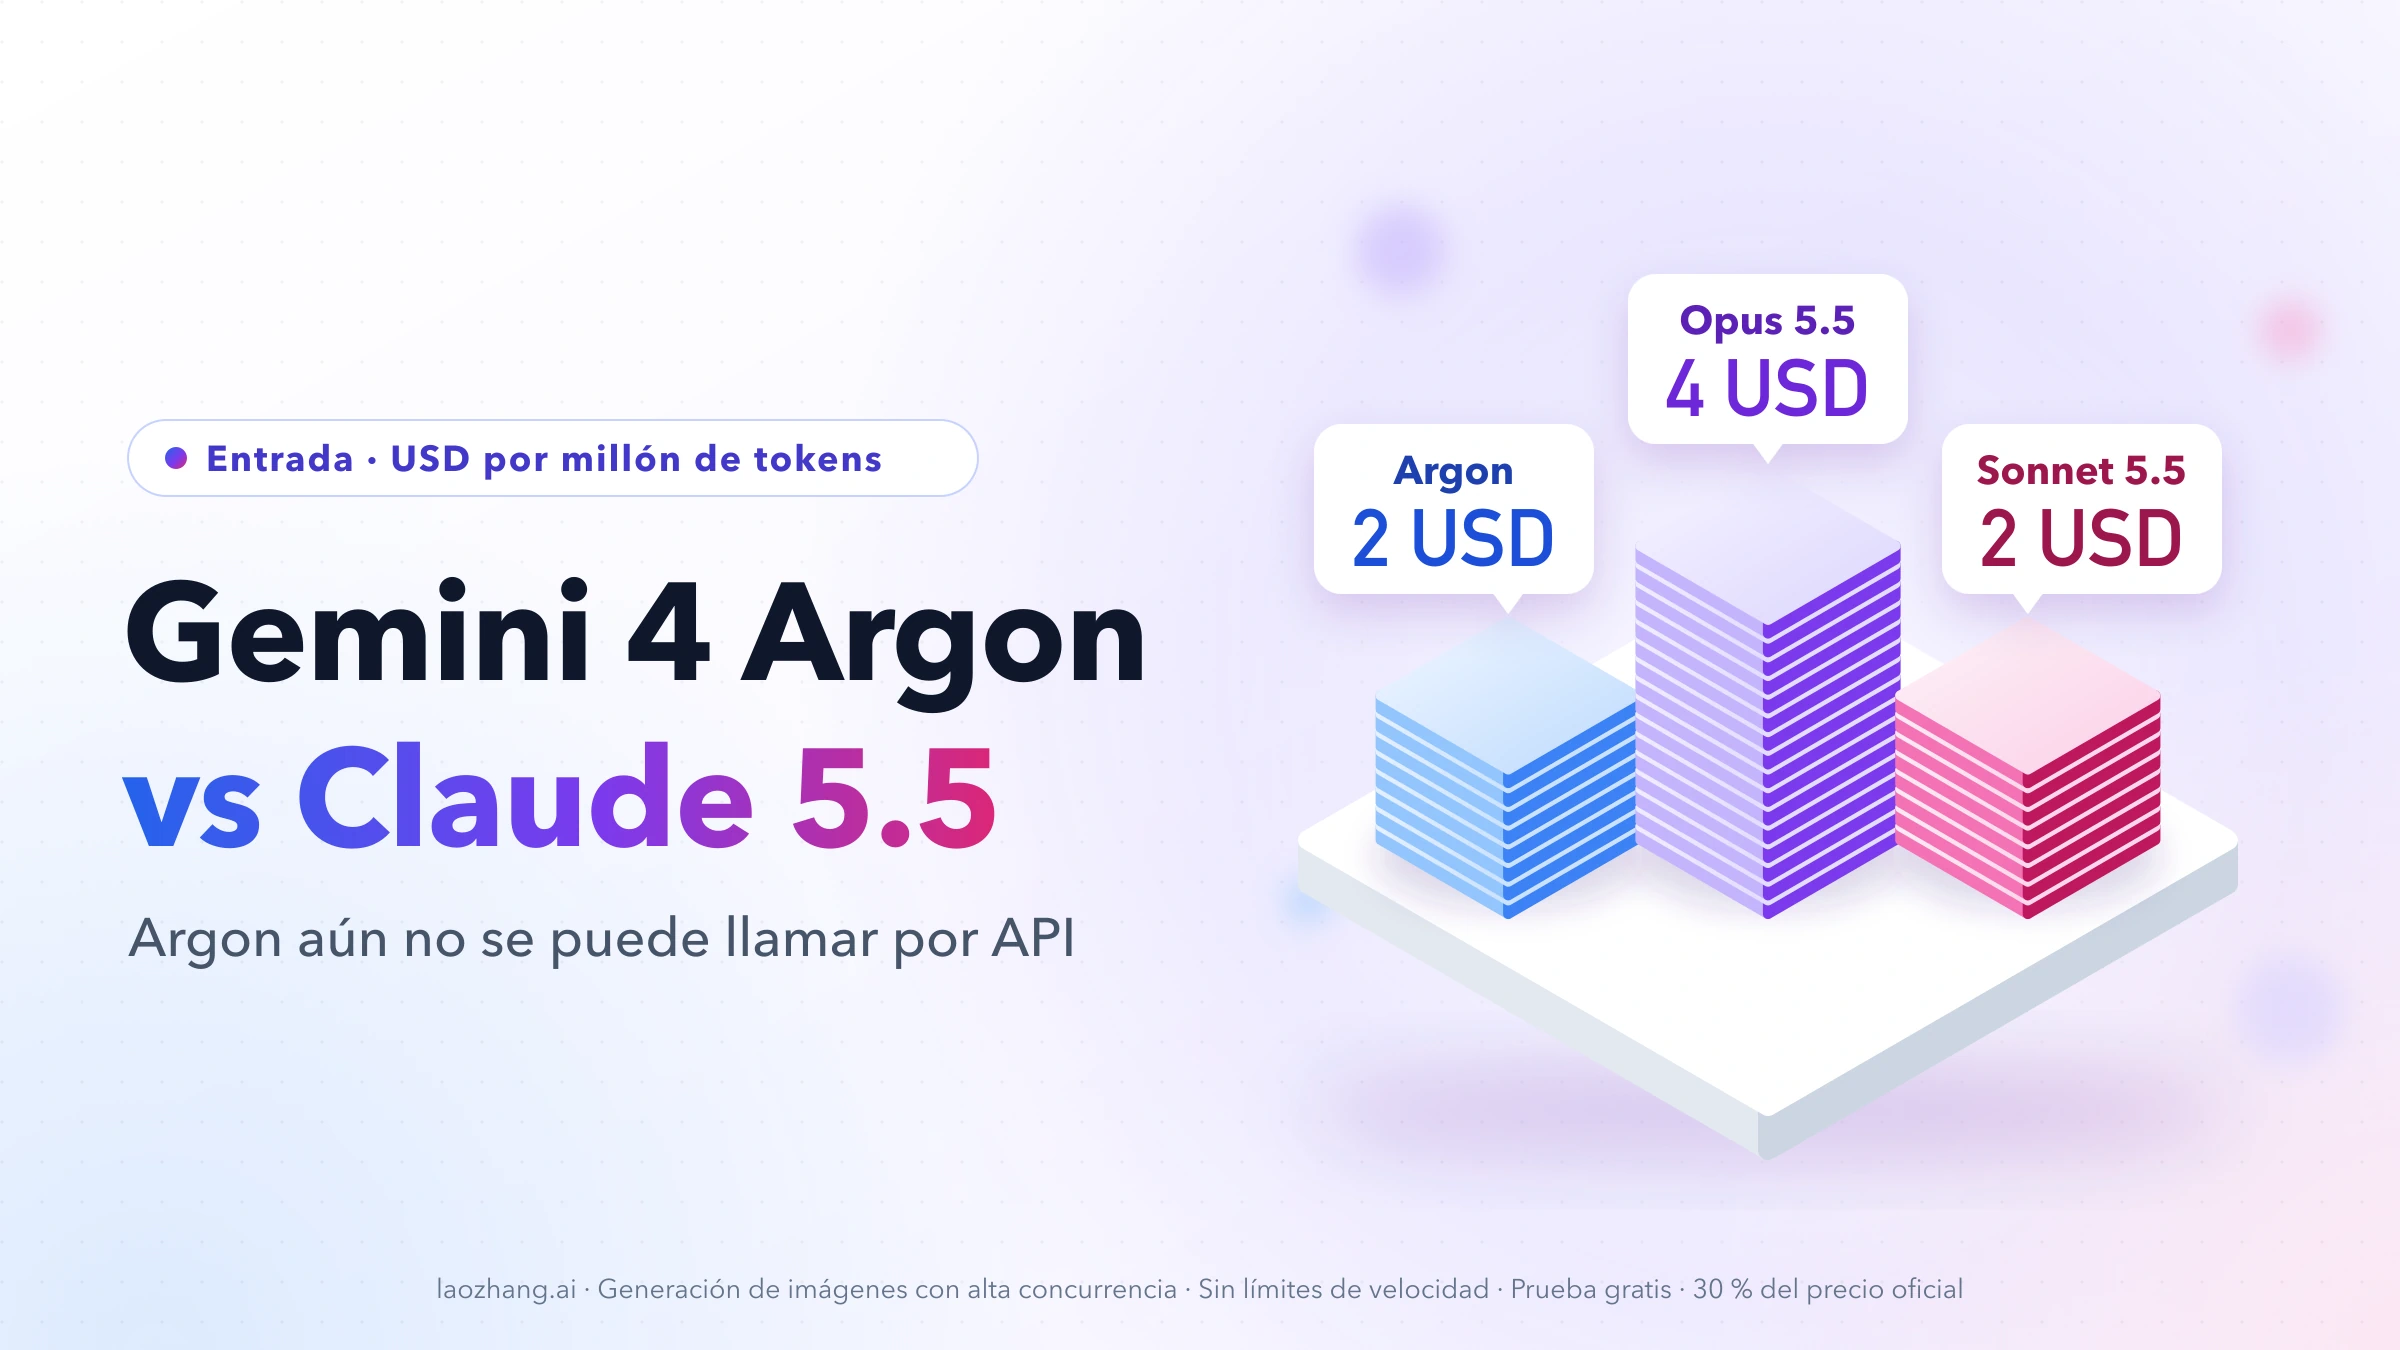
| Sonnet 5.5 | claude-sonnet-5-5 | 2 $ / 0,10 $ / 10 $ | high | Código, análisis y herramientas del trabajo habitual. |
| Opus 5.5 | claude-opus-5-5 | 4 $ / 0,20 $ / 20 $ | medium | Tareas complejas que Sonnet no supera con fiabilidad. |
| Fable 5.1 | claude-fable-5-1 | 10 $ / 0,25 $ / 50 $ | high | Casos límite que siguen fallando con Opus tras subir el esfuerzo. |
Con los dos ejemplos de la sección de precios (el intento de 90.000 tokens de prompt y el agente de 20 turnos), los cuatro modelos actuales quedan así:
| Modelo | Intento de ejemplo | Agente de ejemplo |
|---|---|---|
| Haiku 5.5 | 0,0061 $ | 0,026 $ |
| Sonnet 5.5 | 0,116 $ | 0,36 $ |
| Opus 5.5 | 0,232 $ | 0,72 $ |
| Fable 5.1 | 0,565 $ | 1,40 $ |

Los cuatro comparten tokenizador, así que el mismo texto se convierte en los mismos tokens en todos; lo que cambia es cuánto razona y escribe cada uno. En el intento, Sonnet 5.5 cuesta unas 19 veces lo que Haiku 5.5, y Opus 5.5 el doble que Sonnet.
El precio bajo de Haiku 5.5 tiene una condición: si el prompt supera 100.000 tokens, todas sus tarifas se multiplican por 5 (0,50 $ de entrada y 2,50 $ de salida). El mismo intento con un prompt de 150.000 tokens (90.000 nuevos y 60.000 de caché) costaría 0,09 × 0,50 + 0,06 × 0,05 + 0,005 × 2,50 = 0,0605 $ en Haiku 5.5 frente a 0,236 $ en Sonnet 5.5, suponiendo que las lecturas de caché cuentan para ese umbral, algo que la tarifa no aclara. Si comparas Haiku 5.5 con el modelo pequeño de OpenAI, consulta Claude Haiku 5.5 vs GPT-6 Luna: precio API igual hasta 100K tokens.
Antes de subir de Haiku a Sonnet, o de Sonnet a Opus, prueba un nivel de effort más alto en el modelo que ya usas. La documentación de effort recomienda empezar Haiku 5.5 en medium, bajar a low en chat y tareas cortas con herramientas, subir a high en trabajo de conocimiento o agentes largos, y comparar xhigh o max con Sonnet 5.5.
La secuencia práctica es probar primero el modelo más económico que pueda cumplir tus criterios y subir cuando aparezca un fallo reproducible. Si ya tienes un agente difícil en Opus 5 o Fable 5.1, compara de nuevo contra Opus 5.5: las antiguas cuentas de caché y los resultados de otro modelo no deciden este cambio. Para detalles de integración, consulta qué falla al migrar a Claude Opus 5.5 y la guía de migración de Claude Fable 5.1.
Sonnet 5 y Haiku 4.5: modelos anteriores, aún disponibles
Si tu integración sigue en los modelos anteriores, esto es lo que cambia al pasar a la versión 5.5:
- Sonnet 5 → Sonnet 5.5: mismo precio de entrada y salida (2 $ / 10 $) y la lectura de caché baja a la mitad, de 0,20 $ a 0,10 $; en el intento de ejemplo, 0,116 $ frente a 0,122 $. Los niveles de effort se han recalibrado, así que repite tu barrido de effort en lugar de copiar el de Sonnet 5, y revisa los cambios incompatibles de Sonnet 5.5, como el modo
between_toolsen lugar de desactivar el razonamiento. - Haiku 4.5 → Haiku 5.5: Anthropic anuncia un precio un 90 % menor con prompts de hasta 100.000 tokens y un 50 % menor por encima (Haiku 4.5 cuesta 1 $ / 5 $). Pero el mismo texto cuenta aproximadamente un 30 % más de tokens en Haiku 5.5, según su página de novedades, así que el ahorro por texto es algo menor que el ahorro por token: vuelve a contar tus prompts con
claude-haiku-5-5. El contexto sube de 200.000 a un millón de tokens, el razonamiento viene activado ytemperature,top_p,top_ko el prefill devuelven un error 400.
Haiku 4.5 sigue activo; su retirada está fijada como «no antes del 15 de octubre de 2026» en la tabla de obsolescencias, sin aviso publicado a 8 de octubre. Es un mínimo, no una fecha de retirada.
¿Qué consume menos en Claude Pro o Max: Opus o Sonnet?
En las aplicaciones de Claude no pagas por token, sino que gastas el límite de tu plan, y Sonnet consume menos que Opus. La guía de Claude Academy para elegir modelo ordena el consumo de menor a mayor así: Haiku, Sonnet, Opus y Fable, sin publicar multiplicadores. El centro de ayuda de Claude Code añade que Opus cuesta varias veces más por turno que Sonnet, y Sonnet más que Haiku.
Según la página de precios de Claude, Haiku y Sonnet están en todos los planes, incluido Free; Opus empieza en Pro; Fable no está en Free, funciona con créditos de uso en Pro y puede ocupar hasta el 50 % del límite semanal en Max 5x y Max 20x. Si te preocupa agotar la cuota, consulta qué límites cambian entre Claude Pro y Max.
En Claude Code, los alias de /model ya apuntan a la gama nueva: sonnet es Sonnet 5.5, haiku es Haiku 5.5, opus es Opus 5.5 y fable es Fable 5.1. El modelo default es Opus 5.5 en Pro, Max, Team, Enterprise y la API de Anthropic, y opusplan planifica con Opus 5.5 y ejecuta con Sonnet 5.5, según la configuración de modelos de Claude Code.
Qué anotar de cada prueba antes de cambiar tráfico en producción
Anota el modelo exacto, el effort, max_tokens, los aciertos de caché y el coste de herramientas de cada prueba. Revisa también las llamadas a herramientas y las denegaciones: la guía de migración de Opus 5.5 recoge cambios de comportamiento que pueden afectar a una integración existente. Amplía el tráfico por etapas y conserva una forma de volver al modelo anterior si el porcentaje de tareas aceptadas empeora.
Los importes anteriores corresponden a peticiones estándar de la API directa. Batch reduce a la mitad la entrada y la salida de los cuatro modelos; Fast (solo en Opus 5.5), la residencia de datos y las plataformas asociadas tienen otras tarifas o condiciones. Usa la tabla del canal que realmente te factura antes de presupuestar. La recomendación de partida sigue siendo Opus 5.5 para un trabajo difícil, Fable 5.1 solo para las tareas en las que su resultado medido compense el sobrecoste completo, y Sonnet 5.5 o Haiku 5.5 para todo lo que superen con tus propios criterios.