

GPT-6 Astra y Claude Fable 5.1 parten del mismo precio estándar: 10 dólares por millón de tokens de entrada y 50 dólares por millón de tokens de salida. Ese empate solo describe una solicitud sin más condiciones. No dice cuánto costará una aplicación con contexto largo, caché, razonamiento, herramientas, reintentos o procesamiento por lotes.
La diferencia decisiva aparece al mirar el tipo de solicitudes. Claude Fable 5.1 cobra menos por leer contenido ya almacenado en caché. GPT-6 Astra, en cambio, aplica una tarifa superior a la solicitud completa cuando la entrada supera 272K tokens. Para estimar el gasto hay que separar cada categoría del registro de uso y compararla con su equivalente; sumar caracteres o tomar el precio de salida como coste de una tarea conduce a cifras falsas.
Precios y condiciones comprobados el 5 de septiembre de 2026 en la documentación oficial. El registro de cambios de OpenAI anunció GPT-6 Astra el 3 de septiembre y su acceso se está habilitando de forma gradual, por lo que una ficha pública no garantiza que una organización concreta ya pueda invocarlo. Las notas de Claude sitúan la publicación de Fable 5.1 el 1 de septiembre; su identificador en la API de Claude es claude-fable-5-1.
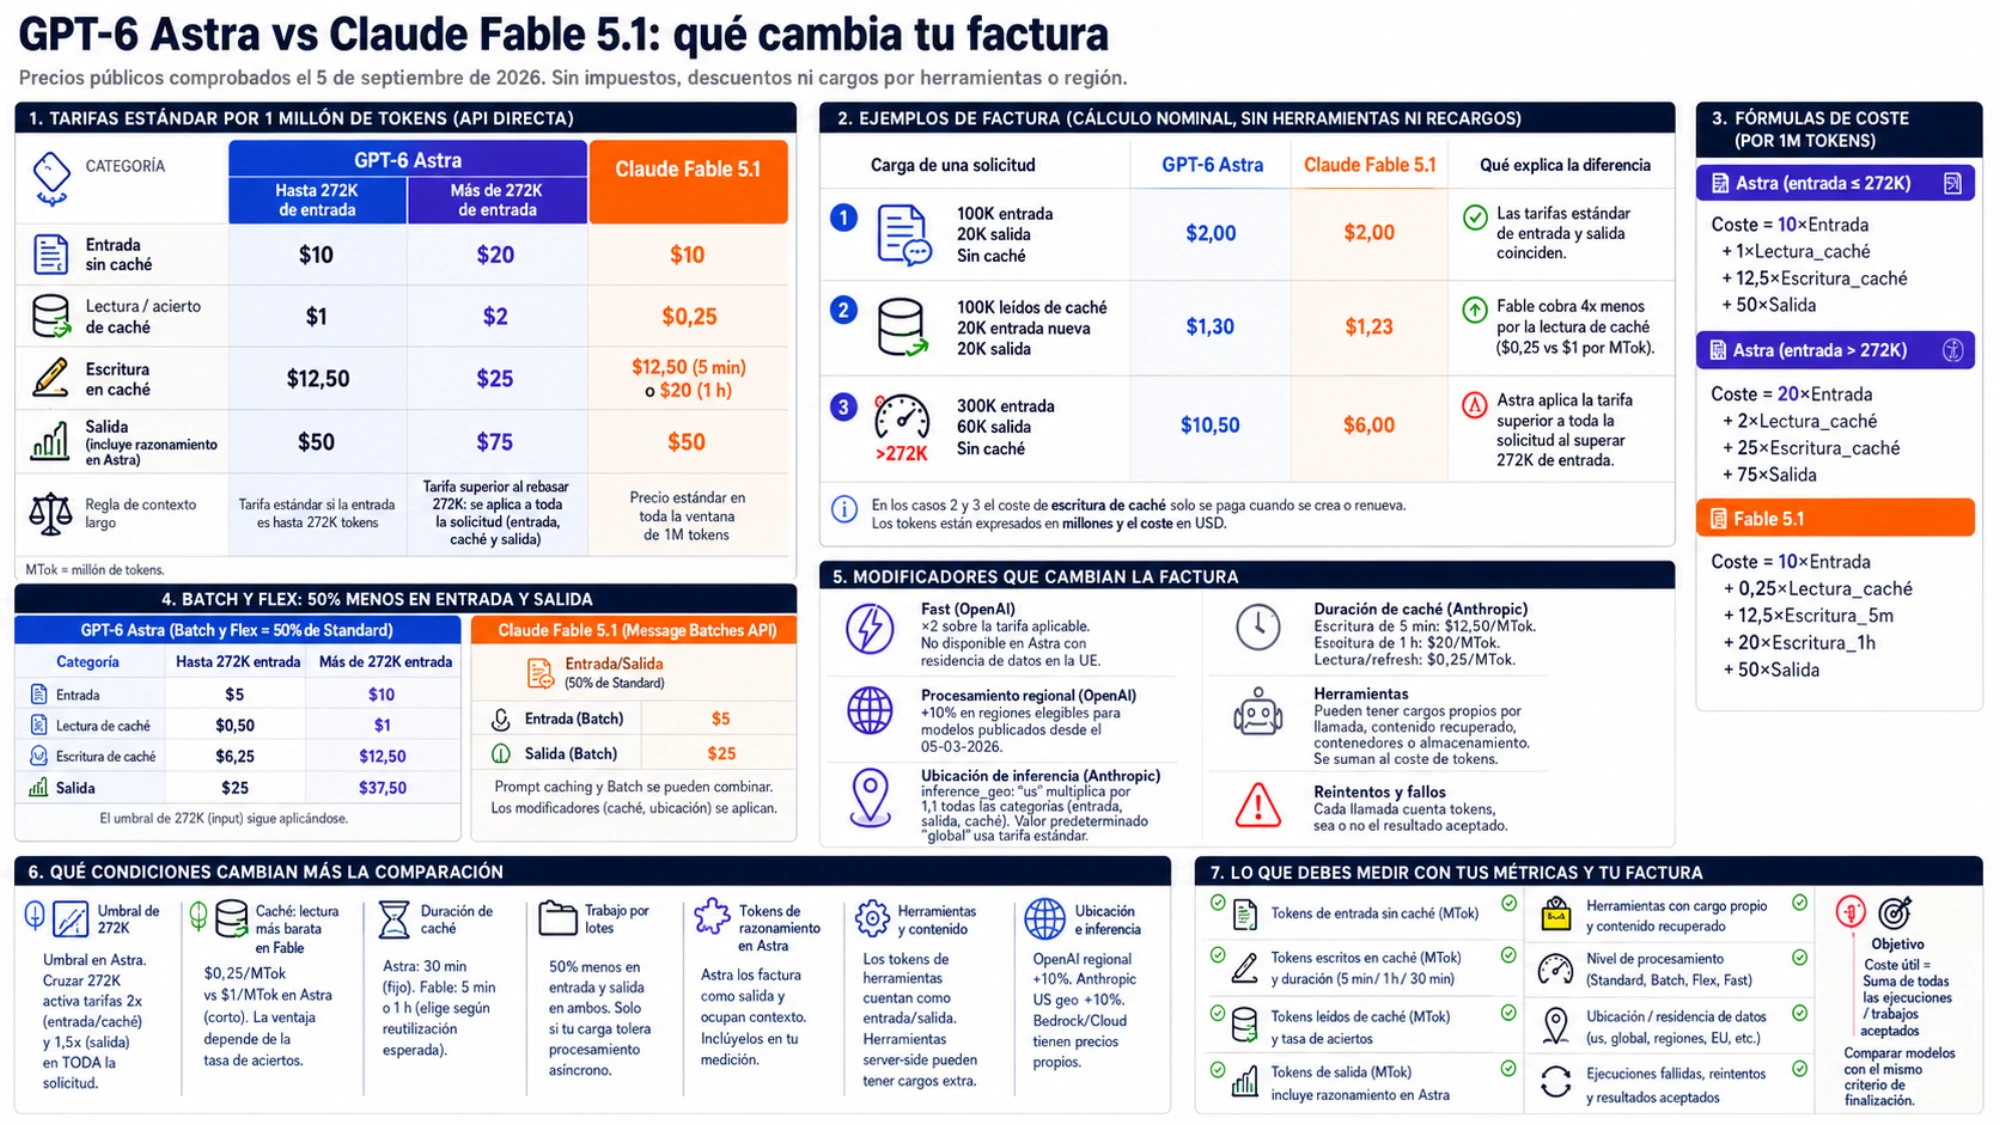
Las tarifas estándar empatan hasta que intervienen el contexto y la caché
Esta es la comparación para las API directas de ambos proveedores, antes de impuestos, descuentos empresariales, herramientas y recargos regionales. En Astra, la columna estándar solo se aplica cuando la solicitud contiene como máximo 272K tokens de entrada.
| Categoría, por 1 millón de tokens | GPT-6 Astra, hasta 272K de entrada | GPT-6 Astra, más de 272K de entrada | Claude Fable 5.1 |
|---|---|---|---|
| Entrada sin caché | 10 USD | 20 USD | 10 USD |
| Lectura o acierto de caché | 1 USD | 2 USD | 0,25 USD |
| Escritura en caché | 12,50 USD | 25 USD | 12,50 USD durante 5 min; 20 USD durante 1 h |
| Salida | 50 USD | 75 USD | 50 USD |
| Regla de contexto largo | tarifa superior al rebasar 272K | se aplica a toda la solicitud | precio estándar en toda la ventana de 1M |
OpenAI publica tanto la tarifa de GPT-6 Astra como la regla del modelo para contexto largo. Anthropic detalla los precios de Claude Fable 5.1 y explica que los modelos Claude 4.6 y posteriores mantienen el precio estándar por token dentro de su ventana completa de 1M en su documentación de precios.
Las filas de caché no describen exactamente el mismo producto. Astra distingue escritura y lectura con una duración de 30 minutos. Fable permite pagar una escritura de 5 minutos o una de 1 hora. Por tanto, no basta con escoger el número más bajo de una fila: primero hay que decidir cuánto tiempo debe sobrevivir el prefijo y cuántas veces se reutilizará.
Una fórmula sencilla evita comparar categorías distintas
Conviene expresar todos los contadores en millones de tokens. Para una solicitud estándar de Astra que no supera 272K tokens de entrada:
coste Astra = 10 × entrada + 1 × lectura_caché + 12,5 × escritura_caché + 50 × salida
Si la entrada supera 272K, la misma fórmula pasa a:
coste Astra largo = 20 × entrada + 2 × lectura_caché + 25 × escritura_caché + 75 × salida
Para Fable 5.1:
coste Fable = 10 × entrada + 0,25 × lectura_caché + 12,5 × escritura_5m + 20 × escritura_1h + 50 × salida
En Responses, resta input_tokens_details.cached_tokens y input_tokens_details.cache_write_tokens de input_tokens para obtener entrada ordinaria. En Claude Messages, input_tokens ya excluye lecturas y escrituras de caché; no las restes otra vez.
Estas fórmulas solo cubren tokens de inferencia estándar. Después hay que sumar las herramientas con cargo propio, el nivel de procesamiento, la ubicación de inferencia cuando corresponda y los reintentos. La factura real puede incluir además impuestos, conversión de moneda o condiciones contractuales.
Tres ejemplos muestran dónde cambia la decisión. Son cálculos nominales, sin herramientas, recargos ni descuentos:
| Carga de una solicitud | GPT-6 Astra | Claude Fable 5.1 | Qué explica la diferencia |
|---|---|---|---|
| 100K de entrada y 20K de salida, sin caché | 2,00 USD | 2,00 USD | las tarifas estándar coinciden |
| 100K leídos de caché, 20K de entrada nueva y 20K de salida | 1,30 USD | 1,23 USD | Fable cobra menos por la lectura de caché |
| 300K de entrada y 60K de salida, sin caché | 10,50 USD | 6,00 USD | Astra cobra toda la solicitud en el tramo superior |
En el segundo caso se ha supuesto que el contenido ya estaba almacenado y que esa ejecución no paga una nueva escritura. El coste de crear o renovar la caché debe añadirse en la operación en que ocurra. En el tercer caso sería incorrecto cobrar 272K a precio estándar y solo 28K a precio alto: OpenAI especifica que, una vez superado el umbral, las tarifas superiores afectan a la solicitud completa, incluida la salida.
El umbral de 272K es una discontinuidad, no un recargo marginal
La entrada de Astra puede ser apenas mayor que 272K y aun así trasladar toda la llamada a 20 USD por millón de tokens de entrada, 2 USD por lectura de caché, 25 USD por escritura y 75 USD por salida. Por eso, dos solicitudes casi iguales en longitud pueden tener costes unitarios muy distintos.
Antes de aceptar ese salto, comprueba qué está ocupando el contexto: historiales completos, resultados de herramientas, definiciones extensas, documentos repetidos o registros antiguos. Dividir una tarea no siempre es correcto —puede perder relaciones necesarias—, pero eliminar material que el modelo no necesita sí evita pagar el tramo superior sin obtener utilidad.
Fable 5.1 mantiene su tarifa estándar dentro de la ventana de 1M. Esto le da una ventaja nominal clara en solicitudes largas, pero no demuestra por sí solo un coste menor por resultado. Los proveedores no tokenizan necesariamente el mismo contenido de igual manera. En su explicación de precios y recuento, Anthropic indica que el tokenizer nuevo puede producir alrededor de un 30 % más de tokens que Claude Sonnet 4.6 y modelos anteriores según el tipo de texto; esa cifra no es una conversión frente al tokenizer de OpenAI. La única comparación válida usa los contadores reales de cada respuesta.
La caché favorece a Fable en lectura, pero hay que contar el ciclo completo
En GPT-6 Astra, el prefijo susceptible de caché debe tener al menos 1.024 tokens. La opción pública de duración es prompt_cache_options.ttl: "30m". Un acierto dentro del periodo renueva la vigencia sin volver a cobrar la escritura, según la explicación de la duración. Para cargas de hasta 272K, la escritura cuesta 1,25 veces la entrada normal y la lectura una décima parte; por encima del umbral se aplica el tramo largo a toda la solicitud.
Fable 5.1 cobra 0,25 USD por millón de tokens leídos o actualizados desde caché, frente a 1 USD de Astra en el tramo corto. Su escritura cuesta 12,50 USD con una duración de cinco minutos y 20 USD con una hora. Esa lectura cuatro veces más barata puede ser importante en agentes que reutilizan un prefijo grande muchas veces, pero solo si la tasa de aciertos es alta y el contenido permanece estable.
Para evaluar una caché, registra al menos cuatro cantidades por separado: tokens escritos, tokens leídos, tokens de entrada no almacenados y número de aciertos antes de expirar. Una escritura de una hora puede ser más cara y aun así ahorrar dinero si evita reescrituras frecuentes; también puede ser un gasto inútil si el prompt cambia antes de la segunda lectura. Las etiquetas parecidas de dos facturas no autorizan a asumir la misma duración o la misma regla de renovación.
Batch reduce entrada y salida; no elimina los demás modificadores
Ambos proveedores ofrecen un descuento del 50 % para trabajo asíncrono por lotes. En una carga sin caché y dentro del tramo corto de Astra, esto deja la entrada en 5 USD y la salida en 25 USD por millón de tokens para los dos modelos.
OpenAI también publica Flex al 50 % de Standard para Astra. Sus tarifas Batch y Flex son 5/0,50/6,25/25 USD por millón para entrada, lectura de caché, escritura de caché y salida en el tramo corto; en el tramo largo pasan a 10/1/12,50/37,50 USD. El umbral sigue dependiendo de superar 272K tokens de entrada.
Anthropic publica para Message Batches 5 USD de entrada y 25 USD de salida por millón de tokens. Permite combinar lotes y caché, pero las condiciones de caché y de ubicación se siguen aplicando. No conviene inventar una tarifa combinada a partir de dos porcentajes: calcula con las categorías que aparezcan en el uso real y confirma el importe en la factura.
El lote solo es comparable si la aplicación tolera la espera y el procesamiento asíncrono. Para una respuesta interactiva, ese descuento no existe como sustituto automático. En OpenAI, Fast cuesta el doble de la tarifa aplicable; el procesamiento regional elegible añade un 10 %, y Astra no admite Fast con residencia de datos en la UE. En la API de Claude, inference_geo: "us" multiplica por 1,1 la entrada, la salida y las operaciones de caché; el valor predeterminado global conserva la tarifa estándar.
Razonamiento y herramientas pueden pesar más que la tabla
Los tokens de razonamiento no visibles de Astra ocupan contexto y se facturan como salida. Una estimación basada únicamente en el texto que recibe el usuario los omite. Además, aunque Astra admite Chat Completions, OpenAI exige Responses API para usar herramientas con este modelo. El endpoint no tiene un cargo separado, pero las herramientas integradas pueden cobrar llamadas, contenido recuperado, contenedores o almacenamiento, tal como recoge la tarifa de herramientas de OpenAI.
En Fable 5.1, las definiciones incluidas en tools cuentan como tokens de entrada y la respuesta generada como salida. Las herramientas ejecutadas por el cliente no añaden una tarifa de herramienta, pero las operadas por el servidor sí pueden tener cargos por uso. Fable 5.1 tampoco acepta tool_choice con los valores any o tool; esas solicitudes devuelven un error 400, mientras auto y none siguen disponibles, según las notas de versión de Claude. Una integración que reintenta automáticamente una configuración inválida puede gastar más sin completar el trabajo.
Esto obliga a comparar una tarea con el mismo criterio de finalización, no dos respuestas aisladas. Registra la entrada nueva, las lecturas y escrituras de caché, la salida total —incluido el razonamiento facturable—, las llamadas a herramientas, los fallos, los reintentos y si el resultado fue aceptado. El coste útil es la suma de todas las ejecuciones dividida entre los trabajos que realmente cumplieron el criterio.
Qué modelo sale más barato según la carga
Solicitudes de hasta 272K, sin caché ni herramientas: hay un empate nominal. Ambos cobran 10 USD por millón de tokens de entrada y 50 USD por millón de salida. Decide con los tokens y reintentos que produzca cada modelo en una tarea representativa.
Prefijos estables con muchas reutilizaciones: Fable 5.1 parte con una lectura de caché más barata, 0,25 frente a 1 USD por millón en Astra corto. Incluye el coste y la duración de la escritura antes de calcular el ahorro.
Solicitudes por encima de 272K tokens de entrada: dentro de 1M, Fable conserva 10 USD para la entrada, 0,25 USD para la lectura de caché, 12,50 o 20 USD para la escritura según su duración y 50 USD para la salida. Astra salta a 20/2/25/75 USD en esas categorías para toda la solicitud. Si ambos consumen una mezcla de tokens parecida, Fable tiene la ventaja tarifaria. Compruébalo con sus contadores reales antes de presupuestar.
Trabajo asíncrono compatible con lotes: la entrada y la salida base vuelven a empatar en 5 y 25 USD por millón. La diferencia reaparece en caché, contexto largo, ubicación, herramientas y cantidad total de tokens.
Compra mediante nube, revendedor o contrato empresarial: ninguna de estas tablas basta. OpenAI en Amazon Bedrock y las distintas plataformas asociadas de Claude pueden facturar de otra forma. También pueden cambiar el resultado los descuentos negociados, el compromiso de consumo, los impuestos y el tipo de cambio.
Cómo obtener una cifra defendible para tu presupuesto
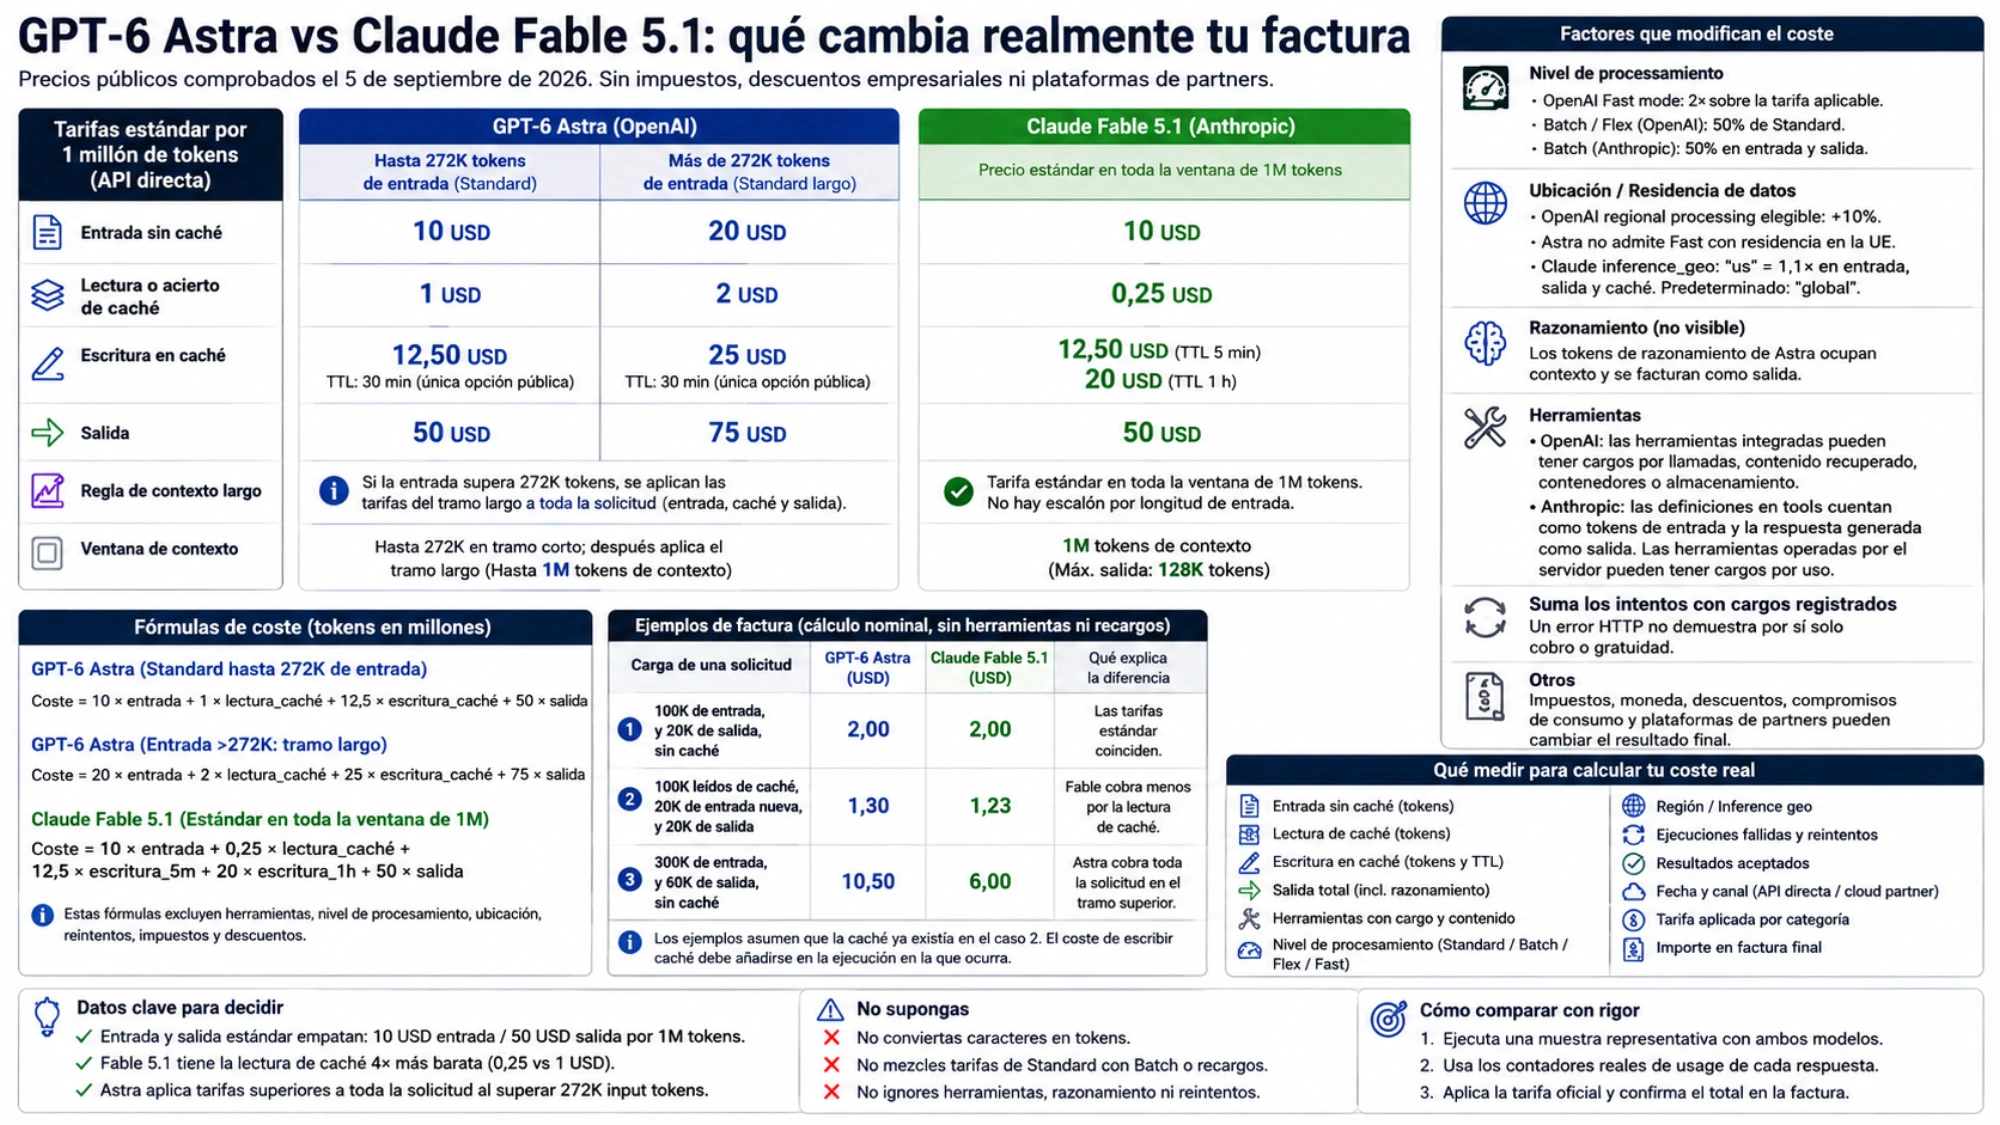
Ejecuta una muestra pequeña del trabajo real con el mismo material de partida y el mismo criterio de aceptación. Conserva por modelo los campos de usage y la factura del proveedor; no conviertas caracteres en tokens ni reutilices el recuento del rival. Separa como mínimo:
- tokens de entrada sin caché;
- tokens escritos y leídos de caché, con su duración;
- tokens de salida y razonamiento facturable;
- herramientas con cargo propio y contenido recuperado;
- nivel de procesamiento, región o ubicación de inferencia;
- ejecuciones fallidas, reintentos y resultados aceptados.
Después aplica la tarifa de la fecha y del canal de compra a cada categoría. Repite la muestra si una sola ejecución contiene un fallo excepcional. El resultado útil no es “Astra cuesta X” o “Fable cuesta Y”, sino un intervalo para una carga definida: por ejemplo, contexto habitual, percentil alto, tasa de aciertos de caché y número de reintentos.
La conclusión del 5 de septiembre de 2026 es concreta: el precio estándar de entrada y salida empata; Fable 5.1 ofrece la lectura de caché más barata y evita el escalón de contexto largo de Astra; Astra puede volver a empatar en cargas cortas o por lotes. Ninguna de esas ventajas establece un ganador universal por tarea. La decisión final depende de los tokens que realmente facture cada modelo y de cuántas ejecuciones hagan falta para producir un resultado aceptable.
Si lo que necesitas comparar son límites incluidos en suscripciones, créditos y herramientas de desarrollo —no la API por consumo—, trátalo como una compra distinta. La guía de Claude Code vs Codex separa ese escenario de los precios por token.


