Cuánto cuesta cada uno: Luna, 20 veces menos que Sol por token
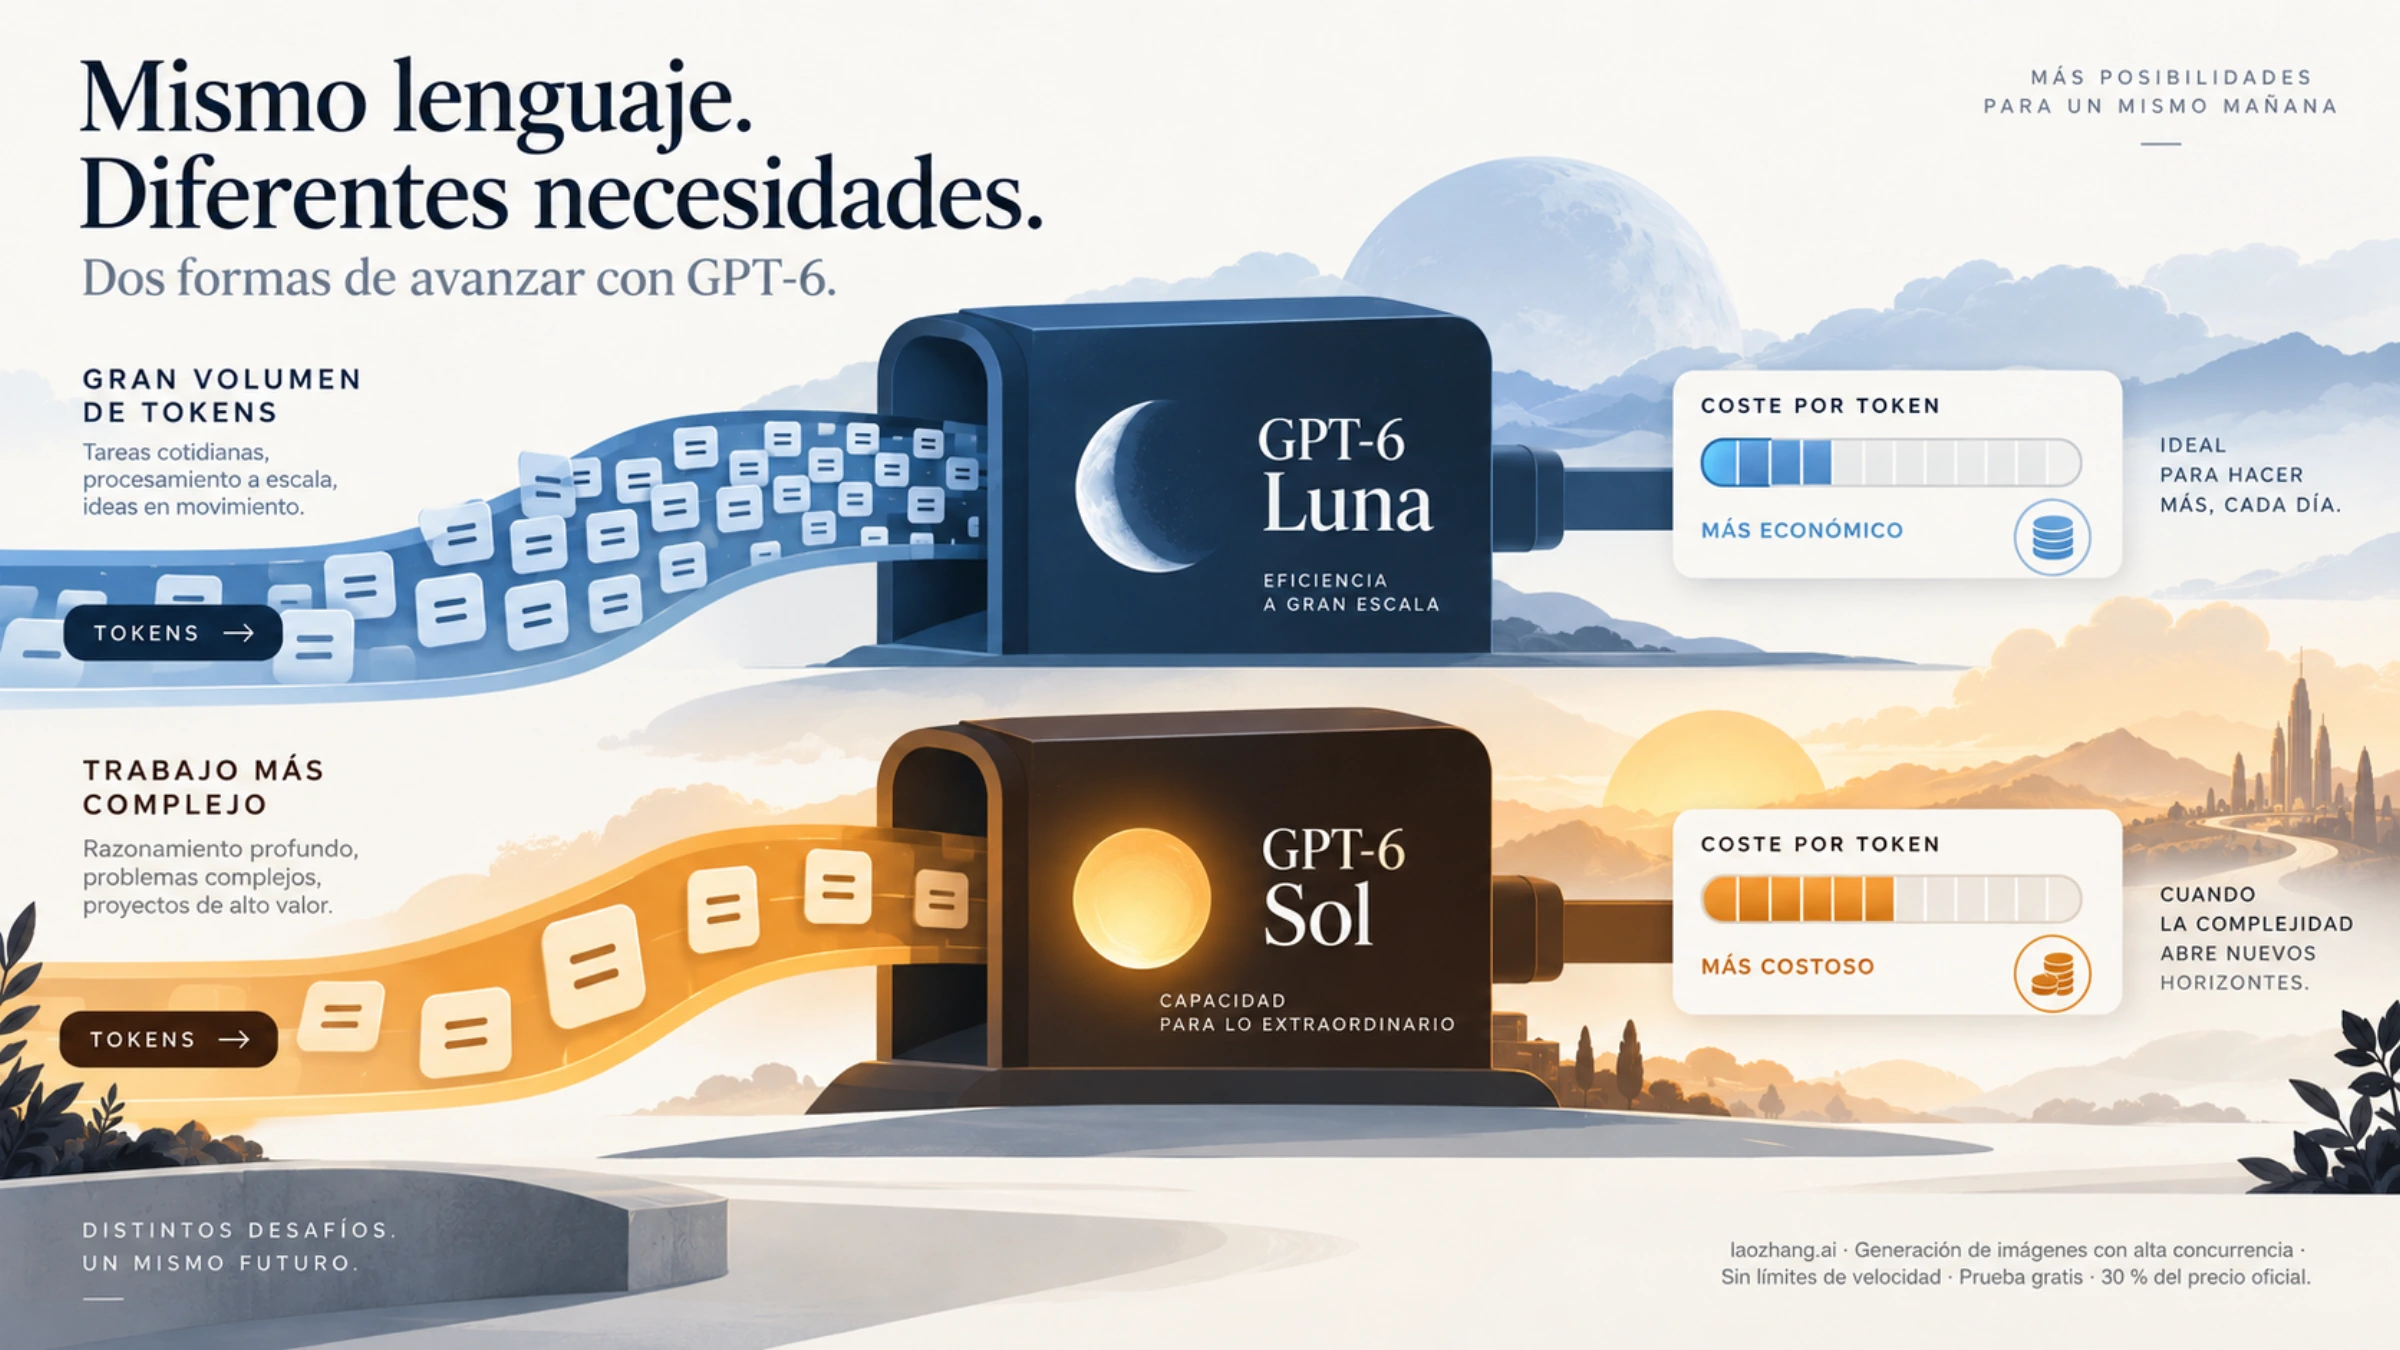
A 24 de septiembre de 2026, la tabla de precios de la API de OpenAI cobra por GPT-6 Luna exactamente la vigésima parte que por GPT-6 Sol en cada tipo de token: 0,10 $ frente a 2 $ por millón de tokens de entrada y 0,50 $ frente a 10 $ por millón de salida. Con 100.000 tokens de entrada y 10.000 de salida, Luna cobra 0,015 $ y Sol 0,30 $.
Esa relación de 20 a 1 no llega intacta a una tarea real. En las pruebas de Artificial Analysis, Luna generó unas dos veces más tokens de salida con el mismo conjunto de pruebas, y pasar el conjunto completo costó 12,7 veces más con Sol, no 20.
Para decidir sin perderte en tablas:
- Empieza por Luna si tu trabajo es repetible y tiene un criterio de aceptación comprobable: clasificar, etiquetar, extraer campos, transformar textos. Por coste de tokens gana casi siempre.
- Mete a Sol en la prueba cuando un fallo te cueste algo más que tokens: tiempo de revisión, un agente que rompe una ejecución larga, un error que llega a producción.
- Confirma en qué sistema pagas antes de comparar cifras: dólares de la API, créditos de Codex o uso incluido en un plan de ChatGPT. No se convierten entre sí.
- Si necesitas residencia de datos en la UE, para estos dos modelos solo existe con procesamiento Standard y con un recargo del 10 %, así que no puedes sumarle el descuento de Batch o Flex.
Tarifas de la API: la misma tabla dividida entre 20
Precios de lista en dólares por millón de tokens, procesamiento Standard y contexto corto (hasta 272.000 tokens de entrada):
| Tipo de token | GPT-6 Sol (gpt-6-sol) | GPT-6 Luna (gpt-6-luna) |
|---|---|---|
| Entrada nueva | 2,00 $ | 0,10 $ |
| Entrada en caché (lectura) | 0,20 $ | 0,01 $ |
| Escritura de caché | 2,50 $ | 0,125 $ |
| Salida | 10,00 $ | 0,50 $ |
Las cuatro filas son conceptos distintos: una misma solicitud puede tener entrada nueva, lecturas y escrituras de caché, y la salida se cobra aparte. La lectura de caché cuesta el 10 % de la entrada nueva en los dos modelos; si tu aplicación reutiliza un prompt largo, esa fila pesa más que la tarifa de entrada. El mecanismo y cuándo compensa pagar la escritura están en OpenAI vs Claude: coste de prompt caching, entrada en caché y punto de equilibrio.
Las herramientas van aparte. La búsqueda web, por ejemplo, cuesta 10 $ por cada 1.000 llamadas más los tokens del contenido recuperado, a la tarifa del modelo que uses.
Fuera del precio, las fichas de Sol y Luna son casi idénticas: ventana de contexto de 1.050.000 tokens, entrada máxima de 922.000, salida máxima de 128.000, los mismos niveles de razonamiento (de none a max, con medium por defecto), las mismas herramientas y los mismos endpoints (Chat Completions, Responses y Batch). Si todavía no sabes cuál de los dos contratos usar, Chat Completions o Responses API: qué contrato cambia de verdad lo resuelve. OpenAI describe a Sol como modelo para programación compleja y flujos con agentes, y a Luna como su modelo más eficiente para tareas acotadas y de gran volumen; es una orientación del fabricante, no una medida de calidad sobre tus datos.
Un cálculo que puedes repetir con tus tokens
La fórmula para una solicitud sin caché:
coste = tokens de entrada / 1.000.000 × tarifa de entrada + tokens de salida / 1.000.000 × tarifa de salida
Con 100.000 tokens de entrada nueva y 10.000 de salida:
| Modelo | Entrada | Salida | Total |
|---|---|---|---|
| GPT-6 Sol | 0,1 × 2,00 = 0,20 $ | 0,01 × 10,00 = 0,10 $ | 0,30 $ |
| GPT-6 Luna | 0,1 × 0,10 = 0,01 $ | 0,01 × 0,50 = 0,005 $ | 0,015 $ |
Si esos 100.000 tokens de entrada se leen de caché, el total baja a 0,12 $ con Sol (0,1 × 0,20 + 0,01 × 10) y a 0,006 $ con Luna (0,1 × 0,01 + 0,01 × 0,50), sin contar la escritura previa que creó esa caché. Fíjate en que con caché la salida pasa a ser la mayor parte de la factura: en Sol, 0,10 $ de 0,12 $.
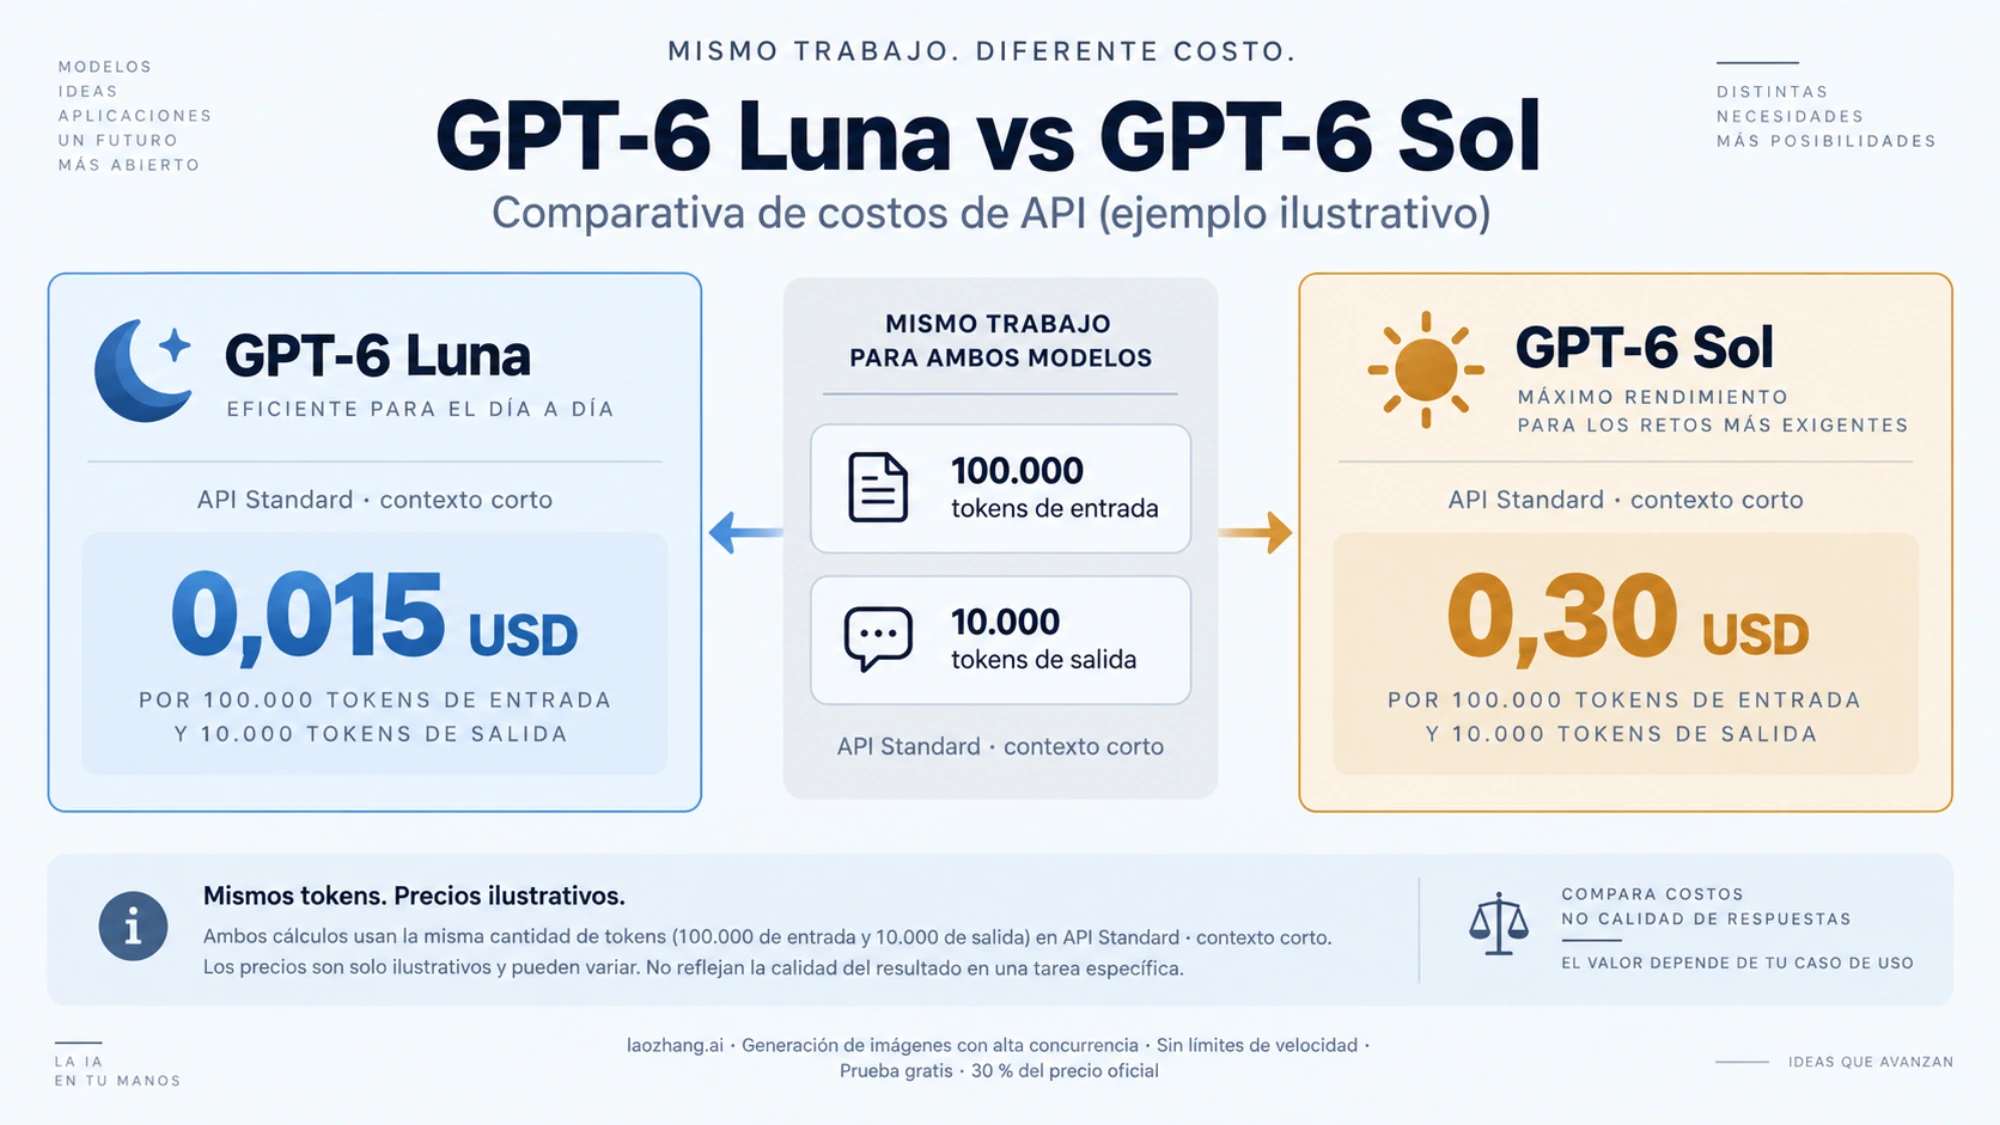
El cálculo usa los mismos tokens para los dos modelos. En una tarea real no será así, porque cada modelo escribe respuestas de distinta longitud y razona durante más o menos tokens; de eso trata la sección sobre el coste por tarea.
Por encima de 272.000 tokens de entrada, la factura casi se duplica
Cuando una solicitud tiene más de 272.000 tokens de entrada, OpenAI cobra toda la solicitud a la tarifa de contexto largo, no solo el tramo que pasa del límite. La entrada y la caché se multiplican por 2 y la salida por 1,5:
| Tipo de token (contexto largo) | GPT-6 Sol | GPT-6 Luna |
|---|---|---|
| Entrada nueva | 4,00 $ | 0,20 $ |
| Entrada en caché (lectura) | 0,40 $ | 0,02 $ |
| Escritura de caché | 5,00 $ | 0,25 $ |
| Salida | 15,00 $ | 0,75 $ |
Así se ve a los dos lados del umbral, con 10.000 tokens de salida y sin caché:
| Entrada | GPT-6 Sol | GPT-6 Luna |
|---|---|---|
| 272.000 tokens (tarifa corta) | 0,272 × 2 + 0,01 × 10 = 0,644 $ | 0,272 × 0,10 + 0,01 × 0,50 = 0,0322 $ |
| 280.000 tokens (tarifa larga) | 0,28 × 4 + 0,01 × 15 = 1,27 $ | 0,28 × 0,20 + 0,01 × 0,75 = 0,0635 $ |
Añadir 8.000 tokens de entrada, un 2,9 % más, multiplica la factura por 1,97 en los dos modelos. Exactamente 272.000 tokens todavía se cobran a tarifa corta: el cambio empieza a partir de ahí. Entre modelos la proporción sigue siendo de 20 a 1 dentro del mismo tramo; lo que se dispara es el coste de esa solicitud.
Esto afecta sobre todo a agentes que acumulan historial y a quien mete documentos enteros en cada llamada. Vigila la longitud de cada solicitud, no la media del mes: una media de 260.000 tokens puede esconder muchas solicitudes de 290.000 que ya se cobran enteras a tarifa larga. Las fichas de los modelos no aclaran si los tokens leídos de caché cuentan para el umbral; si rondas el límite, deja margen o recorta el contexto antes de enviarlo.
Batch, Flex, Fast y residencia de datos en la UE
El modo de procesamiento cambia el precio de los dos modelos por igual. Según la tabla oficial, Batch y Flex cuestan la mitad que Standard y Fast cuesta el doble. Con el ejemplo de 100.000 tokens de entrada y 10.000 de salida en contexto corto:
| Modo | GPT-6 Sol | GPT-6 Luna | Nota |
|---|---|---|---|
| Standard | 0,30 $ | 0,015 $ | Único modo con residencia de datos en la UE |
| Batch | 0,15 $ | 0,0075 $ | Asíncrono: no sirve para respuestas inmediatas |
| Flex | 0,15 $ | 0,0075 $ | Cifras de contexto corto |
| Fast | 0,60 $ | 0,03 $ | El doble que Standard |
Compara siempre los dos modelos en el mismo modo. Sol en Batch (0,15 $) sigue costando diez veces más que Luna en Standard (0,015 $): pasar Sol a Batch no lo acerca a Luna, solo lo abarata respecto a sí mismo.
Si trabajas desde España, la condición que más puede cambiar tu ruta es la residencia de datos. OpenAI aplica un recargo del 10 % a los endpoints de procesamiento regional para los modelos publicados a partir del 5 de marzo de 2026, y para GPT-6 Sol y Luna la residencia en la UE solo está disponible con Standard. Si aplicas ese 10 % al ejemplo, quedan 0,33 $ con Sol y 0,0165 $ con Luna. La consecuencia práctica: si tu cumplimiento normativo exige tratar los datos en la UE, no puedes rebajar Sol a la mitad con Batch, y el ahorro tiene que venir de elegir Luna donde baste o de aprovechar la caché. Que tu organización pueda activar esos endpoints depende de tu cuenta.
España figura en la lista de países admitidos por la API de OpenAI, así que puedes contratar la API directamente. La tabla de precios da importes de lista en dólares y no detalla impuestos: el tratamiento del IVA lo verás en el desglose de tu factura.
Por qué por tarea la diferencia no es de 20 veces
La tarifa por token es fija; los tokens que consume cada modelo para resolver algo no. Artificial Analysis pasó los dos modelos por el mismo conjunto de pruebas con dos niveles de razonamiento (high y max):
| Medida (Artificial Analysis) | Luna (high) | Sol (high) | Luna (max) | Sol (max) |
|---|---|---|---|---|
| Intelligence Index | 32 | 43 | 37 | 48 |
| Coste de pasar el índice completo | 48 $ | 610 $ | 122 $ | 1.550 $ |
| Tokens de salida | 20.000 por tarea | 10.000 por tarea | 145 millones en total | 77 millones en total |
| Velocidad de salida | 137 tokens/s | 97 tokens/s | 141 tokens/s | 110 tokens/s |
En los dos niveles, Sol costó 12,7 veces más (610 / 48 y 1.550 / 122). La distancia se reduce porque Luna escribió aproximadamente el doble de tokens de salida, buena parte de ellos de razonamiento. Aun así, Luna fue más barata con diferencia y además generó texto más deprisa; Sol sacó más puntos en el índice. Son resultados de un solo evaluador con su propia batería de pruebas, útiles para dimensionar la diferencia de coste y no como veredicto sobre tu caso.
El nivel de razonamiento es el otro mando del coste: subirlo hace que el modelo genere más tokens, y esos tokens se pagan. Por eso, antes de pasar a Sol, merece la pena probar Luna con un nivel más alto y ver si alcanza tu criterio de aceptación por menos dinero. El mismo efecto, tarifas parecidas y facturas distintas, aparece al comparar proveedores en Claude Opus 5.5 vs GPT-5.6 Sol: misma tarifa, distinto coste real.
Cuándo compensa pagar Sol: cuenta el coste por resultado aceptado
La cifra útil no es la tarifa por millón, sino cuánto pagas por cada respuesta que pasa tu revisión. Si los intentos son independientes y un fallo simplemente se repite:
coste por resultado aceptado = coste por intento / tasa de aceptación
Con el ejemplo anterior y suponiendo que Sol acierta el 90 % de las veces, cada resultado aceptado de Sol cuesta 0,30 / 0,9 = 0,333 $. Luna sigue siendo más barata mientras acepte más del 4,5 % de sus respuestas (0,015 × 0,9 / 0,30). Si Luna gasta el doble de salida, como en las pruebas anteriores, su intento cuesta 0,02 $ y el umbral sube al 6 %. Compruébalo a los dos lados: con Luna al 5 %, 0,02 / 0,05 = 0,40 $, más caro que Sol; al 7 %, 0,286 $, más barato.
Dicho de otro modo: si solo cuentas tokens, Luna gana casi siempre. La balanza se inclina hacia Sol cuando cada fallo tiene un coste que no aparece en la factura de OpenAI. Supón que revisar cada respuesta te cuesta 0,50 $ en tiempo de una persona, falle o no. Entonces:
- Sol al 90 %: (0,30 + 0,50) / 0,9 = 0,889 $ por resultado aceptado.
- Luna al 70 %: (0,015 + 0,50) / 0,7 = 0,736 $. Sigue ganando Luna.
- Luna al 55 %: 0,515 / 0,55 = 0,936 $. Ahora gana Sol.
Con ese coste de revisión, Luna necesita aceptar alrededor del 58 % de sus respuestas para empatar con Sol, frente al 4,5 % cuando solo contabas tokens. Las tasas y el coste de revisión de estos ejemplos son supuestos; sustitúyelos por los tuyos.
Para medirlos en tu carga:
- Elige de 20 a 50 casos reales y representativos, con un criterio de aceptación escrito antes de empezar.
- Pasa los mismos casos por los dos modelos con el mismo modo de procesamiento, el mismo prompt y, al principio, el mismo nivel de razonamiento.
- Anota por modelo la entrada nueva, la entrada en caché, la salida, los reintentos y los minutos de revisión o corrección.
- Divide el coste total, tokens más tiempo, entre las respuestas aceptadas, no entre las solicitudes enviadas.
- Si Luna se queda corta, repite con un nivel de razonamiento más alto antes de dar el salto a Sol.
Un lote pequeño sirve para descartar fallos evidentes, no para demostrar una ventaja general. Si procesas mucho volumen, ten en cuenta también los límites de la API: en el Tier 1 los dos modelos admiten 500 solicitudes y 500.000 tokens por minuto, pero desde el Tier 2 Luna permite más tokens por minuto; en el Tier 5, 180 millones frente a 40 millones de Sol.
Codex y ChatGPT: créditos y uso incluido, no dólares
En Codex con un plan de ChatGPT no pagas en dólares por token: primero consumes el uso incluido y, cuando se agota, créditos. Si conectas Codex con una clave de API, pagas a las tarifas de la API de arriba. La tabla de precios de Codex fija estas tarifas por millón de tokens en Standard:
| Tokens en Codex | GPT-6 Sol | GPT-6 Luna |
|---|---|---|
| Entrada | 50 créditos | 2,5 créditos |
| Entrada en caché | 5 créditos | 0,25 créditos |
| Salida | 250 créditos | 12,5 créditos |
La proporción vuelve a ser de 20 a 1, pero un crédito no es un dólar y esa página no publica cuánto cuesta un crédito en dólares. Tampoco hay fila de escritura de caché. El mismo ejemplo de 100.000 tokens de entrada y 10.000 de salida consume 7,5 créditos con Sol (0,1 × 50 + 0,01 × 250) y 0,375 con Luna (0,1 × 2,5 + 0,01 × 12,5). En modo Fast, Codex multiplica la tarifa en créditos por 2,5: 18,75 y 0,9375 créditos.
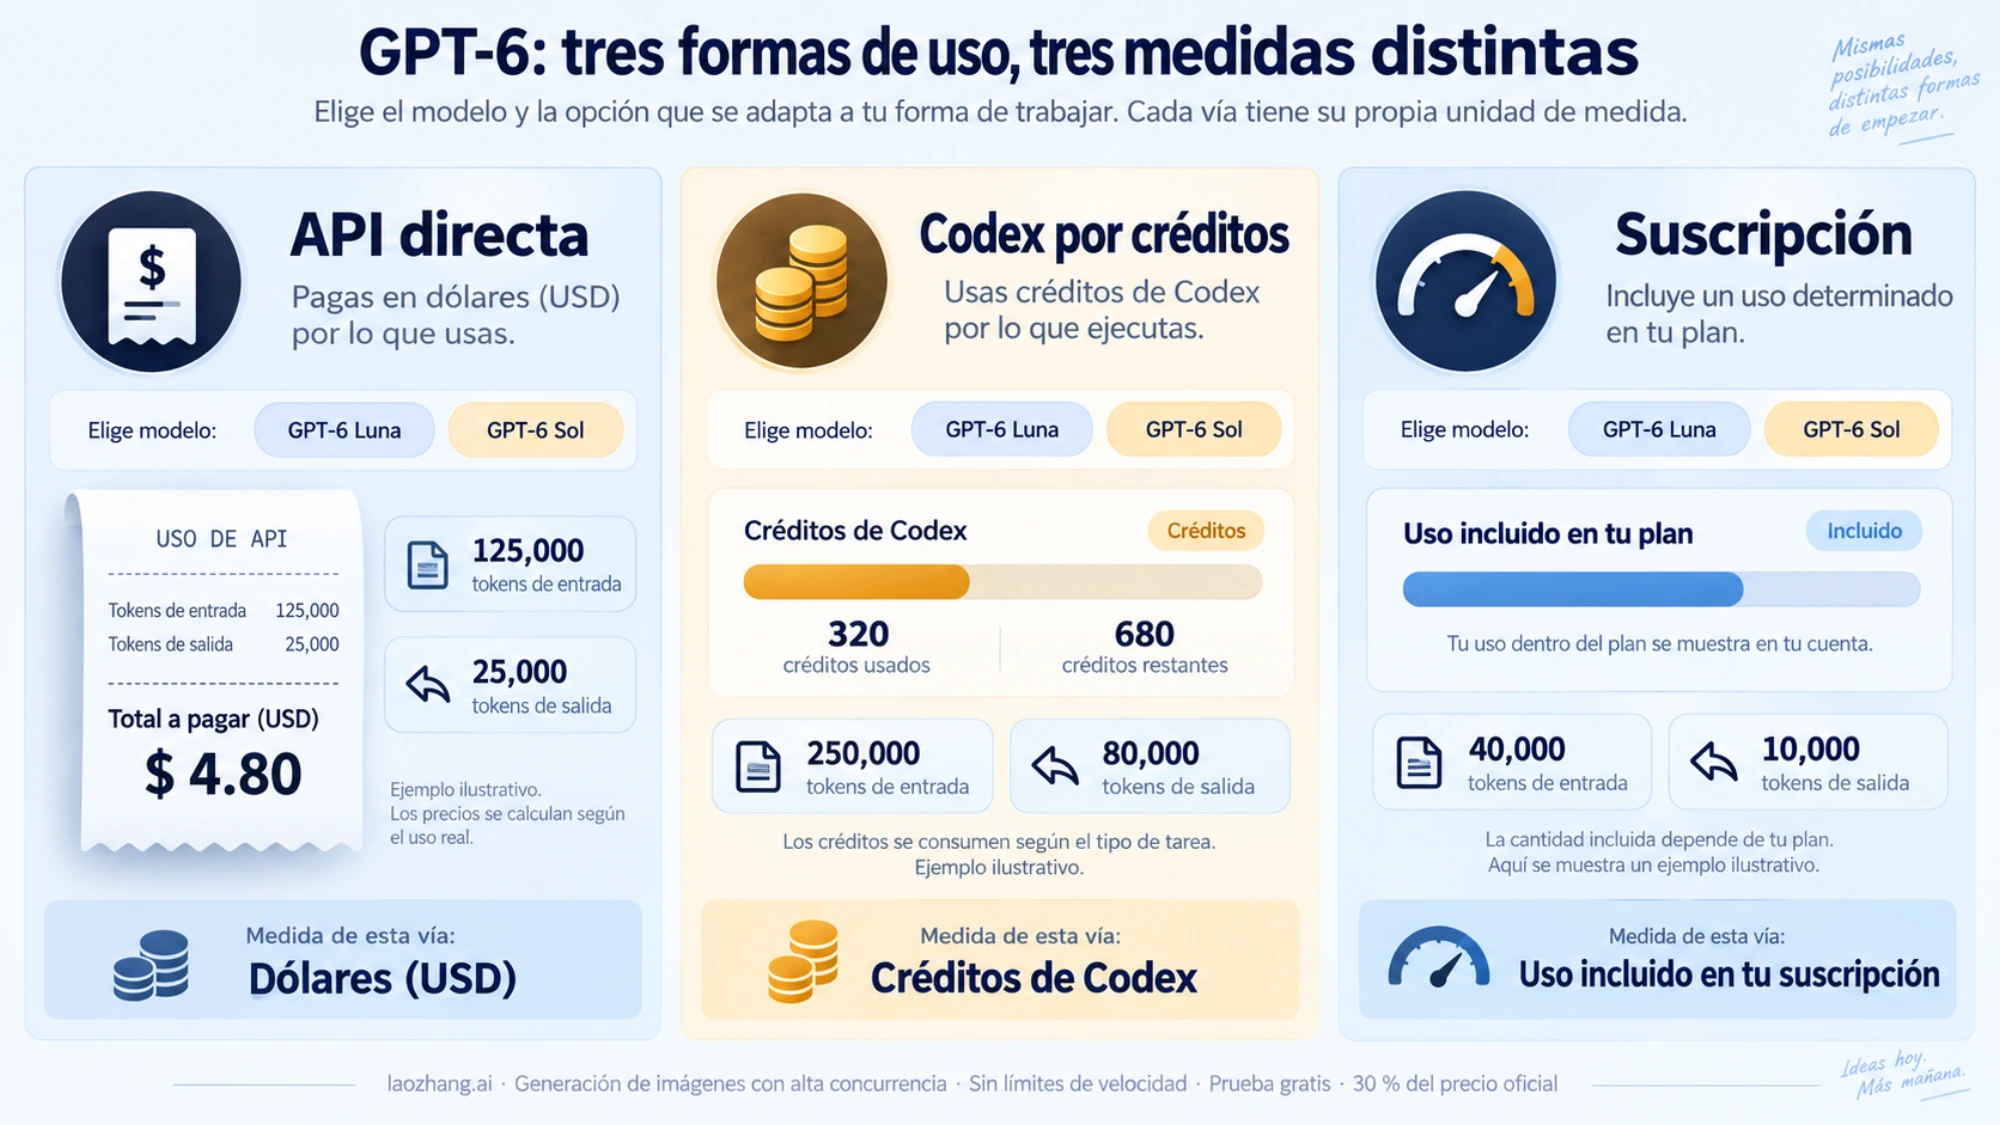
Según el registro de cambios del 22 de septiembre de 2026, los dos modelos se están desplegando en Plus, Pro, Business, Enterprise y Edu; los usuarios de Free y Go pueden usar Luna en la aplicación de escritorio. Dentro de ChatGPT están en Work y en Codex, pero no en Chat. En la CLI los eliges con /model o con codex --model gpt-6-sol y codex --model gpt-6-luna. El despliegue es progresivo, así que puede que tu cuenta todavía no los muestre.
Los planes tienen precio de lista en dólares (Go, 8 $ al mes; Plus, 20 $; Pro, desde 100 $), los límites de uso se renuevan cada semana y el número de mensajes que caben varía mucho según el modelo y el plan. Una bajada de la tarifa de la API no se traduce en un número fijo de mensajes más en tu suscripción. Si dudas entre planes, Codex Plus, Pro 5x o Pro 20x: elige por uso, no por el número y ChatGPT Go o Plus: diferencias reales, límites y uso de Codex tratan esa decisión; si Codex te devuelve un 429, Codex termina con 429: encuentra qué límite rechazó la petición te ayuda a localizar el límite.
Preguntas frecuentes
¿GPT-6 es un 50 % más barato que GPT-5.6?
Para Sol, sí, pero frente al precio promocional de GPT-5.6 Sol (4 $ de entrada y 20 $ de salida por millón, vigente al menos hasta el 21 de noviembre de 2026): GPT-6 Sol cobra 2 $ y 10 $. GPT-6 Luna pasa de 0,20 $ y 1,20 $ a 0,10 $ y 0,50 $, un 50 % menos en entrada y un 58 % menos en salida. Si todavía trabajas con la generación 5.6, Modelos de texto de OpenAI en 2026: Sol, Terra y Luna comparados explica qué modelo usar ahí.
¿Luna es 20 veces más barata en cualquier caso?
Solo por token, comparando la misma fila de la tabla y el mismo modo de procesamiento. Por tarea depende de cuántos tokens genera cada modelo: en las pruebas de Artificial Analysis la diferencia fue de 12,7 veces. Por resultado aceptado puede ser mucho menor si Luna falla más y revisar cuesta dinero.
¿Puedo combinar la residencia de datos en la UE con Batch para Sol o Luna?
No. Para estos dos modelos, OpenAI ofrece la residencia de datos en la UE solo con procesamiento Standard, con un recargo del 10 %.
¿Los créditos de Codex equivalen a dólares de la API?
No. Son unidades distintas y la página de precios de Codex no da una conversión. Compara Sol y Luna dentro de cada sistema: en los dos la proporción es de 20 a 1.