По состоянию на 10 октября 2026 года GPT-6.1 Sol стоит в API $2 за 1 млн входных токенов и $10 за 1 млн выходных, Claude Opus 5.5 — $4 и $20. В счёте разрыв больше двух раз: по замерам Artificial Analysis одна задача на Opus 5.5 обходится в 4,2–8,9 раза дороже в зависимости от уровня рассуждений, потому что Opus пишет на задачу примерно втрое больше токенов. За эти деньги Opus набирает больше баллов, но не на всех уровнях: на low у моделей ничья (42 против 42), на medium Opus впереди на 3 балла, на max — на 6.
С 8 октября у GPT-6.1 Sol появился режим Ultrafast: $12 / $60 за 1 млн токенов, ровно вшестеро дороже обычного. Один и тот же запрос на Sol Ultrafast стоит втрое больше, чем на Opus 5.5 в обычном режиме, и в 1,5 раза больше, чем на Opus в Fast mode. Зато Ultrafast открыт всем пользователям API, а Fast mode у Opus пока выдают через менеджера аккаунта или по листу ожидания.
Практический вывод такой. GPT-6.1 Sol разумно ставить моделью по умолчанию для массовых задач с автоматической проверкой: агентные циклы, разбор документов, рутинные правки кода. Opus 5.5 оправдан на уровнях high–max и там, где каждую неудачную попытку разбирает человек: если проверка стоит около $5, Opus окупается, когда его результат принимают примерно в 1,2 раза чаще, чем результат Sol.
GPT-6.1 Sol или Opus 5.5: с какой модели начать под вашу задачу
| Ваша ситуация | С чего начать | Что меняет выбор |
|---|---|---|
| Много однотипных задач, результат проверяют тесты, схема или валидатор | GPT-6.1 Sol | Даже идеальный Opus 5.5 выгоднее, только если Sol проходит проверку реже чем в 16 % попыток |
| Результат проверяет человек, проверка стоит несколько долларов | Прогнать обе модели на своих задачах | При проверке за $5 Opus 5.5 окупается, если его принимают примерно в 1,2 раза чаще |
Сложные задачи на уровнях xhigh и max | Opus 5.5, если позволяет бюджет | Разрыв 5–6 баллов, задача дороже в 8–9 раз |
Нужен результат уровня Opus medium, но дешевле | GPT-6.1 Sol на xhigh | Задача в 3,4 раза дешевле, но первый токен ответа приходит через 174 с вместо 22 с |
| Нужна максимальная скорость вывода в API уже сейчас | GPT-6.1 Sol Ultrafast | Opus Fast mode за запрос в 1,5 раза дешевле, но за задачу дороже; выдаётся по листу ожидания и только в Claude API |
| Запросы больше 272 000 входных токенов | Любая: разница в цене 1–7 % | Выбирайте по качеству; Sol принимает не больше 922 000 входных токенов |
| Работаете через Amazon Bedrock, Google Cloud или Microsoft Foundry | Opus 5.5 | Fast mode в этих облаках не работает |
| Задачи по кибербезопасности | Проверьте, какая модель ответила на самом деле | Часть таких запросов Opus 5.5 отклоняет, при настроенном fallback их выполняет Opus 4.8 |
Расчёты к каждой строке — в разделах ниже.
Что такое GPT-6.1 Sol и чем он отличается от Claude Opus 5.5
GPT-6.1 Sol (gpt-6.1-sol) — обновление GPT-6 Sol, которое появилось в API OpenAI 29 сентября 2026 года, по журналу изменений. В обсуждениях его часто называют Sol 6.1 — это та же модель. Других моделей версии 6.1 нет: GPT-6.1 Astra и GPT-6.1 Luna не существует, а самой способной моделью OpenAI по-прежнему называет GPT-6 Astra. Claude Opus 5.5 (claude-opus-5-5) вышел 22 сентября 2026 года. Opus 5 (claude-opus-5) — предыдущая версия, и её цены и баллы к Opus 5.5 не относятся.
Вторая частая путаница связана с ChatGPT. 7 октября OpenAI вывела GPT-6 в обычный чат: на платных тарифах там работает GPT-6 Sol, на Free и Go — GPT-6 Luna. GPT-6.1 Sol в чат не попал, он доступен только в режиме Work и в Codex.
| Параметр | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Идентификатор в API | gpt-6.1-sol | claude-opus-5-5 |
| Контекстное окно | 1 050 000 токенов, ввод — до 922 000 | 1 000 000 токенов |
| Максимальный вывод | 128 000 токенов | 128 000 токенов (300 000 в Message Batches с бета-заголовком) |
| Уровни рассуждений | low, medium (по умолчанию), high, xhigh, max; none и minimal не поддерживаются | low, medium (по умолчанию), high, xhigh, max; адаптивное мышление включено всегда |
| Граница знаний | 30 апреля 2026 года | июнь 2026 года |
| Где работает | API OpenAI; в ChatGPT — Work и Codex на Plus, Pro, Business, Enterprise и Edu | Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry, Claude Platform on AWS; приложения Claude на Pro, Max, Team, Enterprise; Claude Code |
Источники: страница модели GPT-6.1 Sol и обзор Claude Opus 5.5. Две детали, которые ломают интеграцию, если о них не знать. Вызов инструментов у GPT-6.1 Sol работает только через Responses API: через Chat Completions модель отвечает, но без инструментов. А уровни аккаунта OpenAI с 6 октября называются Build, Launch и Grow вместо пяти нумерованных; для Sol это от 5 000 запросов и 1 млн токенов в минуту на Build до 15 000 запросов и 40 млн токенов на Grow.
По таблице доступности DataCamp на 30 сентября, Sol есть также в Azure AI Foundry, GitHub Copilot и OpenRouter, Opus 5.5 — ещё и в Cursor. Что проверить при переходе на Opus 5.5 с предыдущих версий, разобрано в статье Claude Opus 5.5: сколько стоит API и что проверить при переходе с Opus 5.
Цены API GPT-6.1 Sol и Opus 5.5: $2/$10 против $4/$20
Все цены — в долларах за 1 млн токенов при прямой оплате API каждого вендора, без налогов. Режимы скорости разобраны отдельно ниже.
| Статья расхода | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
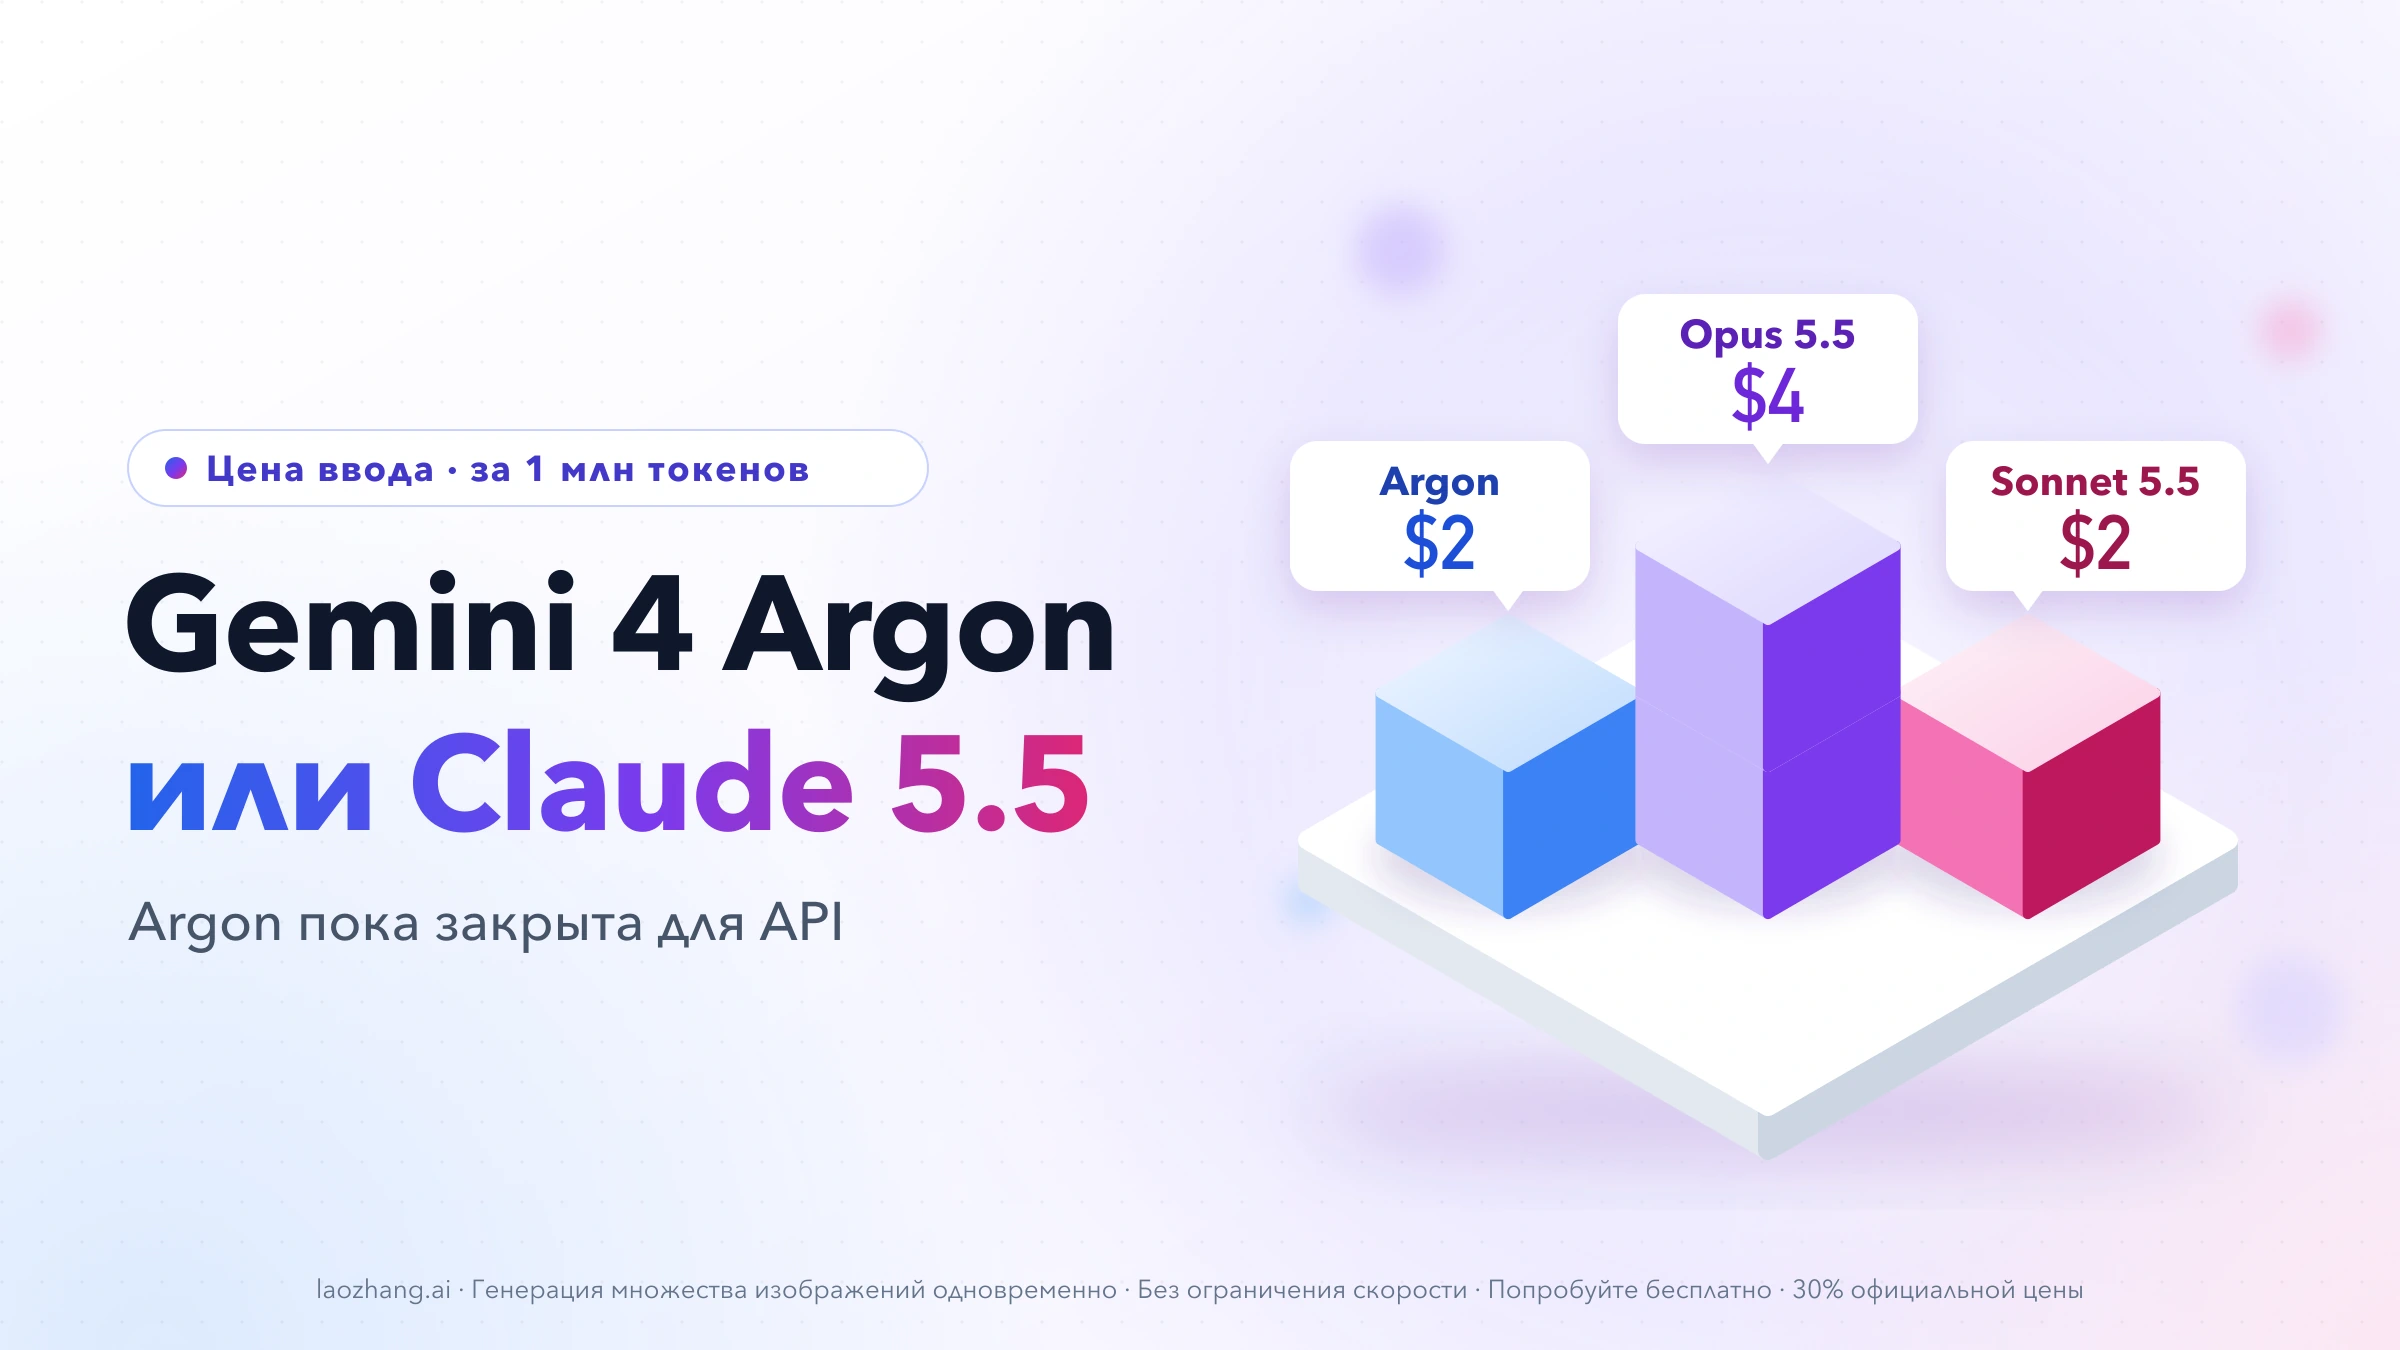
| Ввод | $2 | $4 |
| Вывод | $10 | $20 |
| Чтение кеша | $0,10 | $0,20 |
| Запись в кеш | $2,50 | $5 (на 5 минут), $8 (на 1 час) |
| Пакетная обработка (Batch), ввод / вывод | $1 / $5 (столько же в Flex) | $2 / $10 |
| Запрос больше 272 000 входных токенов, ввод / вывод | $4 / $15 | $4 / $20, надбавки нет |
| Обработка данных в регионе | +10 % | ×1,1 при inference_geo только в США |
Источники: прайс OpenAI и прайс Anthropic. До порога в 272 000 входных токенов каждая строка у GPT-6.1 Sol ровно вдвое ниже, чем у Opus 5.5. Чтение из кеша у обеих моделей на 95 % дешевле обычного ввода; как считать окупаемость кеша, разобрано в материале OpenAI vs Claude: стоимость prompt caching, кэшированный ввод и точка окупаемости.
Цена GPT-6.1 Sol в прайсе OpenAI не помечена как промо. Оговорка «как минимум до 21 ноября 2026 года» на той же странице относится к GPT-5.6 Sol. Сколько продержатся текущие цены обеих моделей, вендоры не сообщают.
Порог 272 000 токенов и запросы на 900 000
OpenAI тарифицирует дороже весь запрос, если в нём больше 272 000 входных токенов: ввод и кеш вдвое, вывод в 1,5 раза. Ровно 272 000 ещё идут по обычной ставке. У Anthropic весь контекст в 1 млн токенов стоит одинаково. Примеры без кеша:
| Запрос (ввод + вывод) | GPT-6.1 Sol | Claude Opus 5.5 | Разница |
|---|---|---|---|
| 272 000 + 20 000 | 0,272 × $2 + 0,02 × $10 = $0,744 | 0,272 × $4 + 0,02 × $20 = $1,488 | Sol дешевле на 50 % |
| 273 000 + 20 000 | 0,273 × $4 + 0,02 × $15 = $1,392 | 0,273 × $4 + 0,02 × $20 = $1,492 | Sol дешевле примерно на 7 % |
| 300 000 + 20 000 | $1,50 | $1,60 | Sol дешевле примерно на 6 % |
| 900 000 + 10 000 | 0,9 × $4 + 0,01 × $15 = $3,75 | 0,9 × $4 + 0,01 × $20 = $3,80 | Sol дешевле примерно на 1 % |
Лишняя тысяча входных токенов поднимает цену запроса на Sol с $0,744 до $1,392, то есть на $0,648 (+87 %); у Opus 5.5 тот же шаг стоит $0,004. За порогом входная ставка Sol сравнивается с Opus, дешевле остаётся только вывод. Если ваши запросы колеблются около 272 000 токенов, выгоднее обрезать контекст до порога, чем менять модель.
Запрос на 900 000 токенов Sol принимает: его предел — 922 000 входных токенов. Но на таком объёме он дешевле Opus всего на 1 %, а всё, что больше 922 000, уходит только в Opus 5.5 с его окном в 1 млн токенов.
Почему задача на Opus 5.5 дороже в 4–9 раз: токены на задачу
Прайс сравнивает цену токена, а платите вы за задачу. Artificial Analysis публикует для каждой модели стоимость задачи (cost per task) на своём наборе тестов и число токенов, которое модель на неё тратит:
| Метрика Artificial Analysis | Sol, medium | Opus 5.5, medium | Sol, max | Opus 5.5, max |
|---|---|---|---|---|
| Выходные токены на задачу | 8 тыс. | 26 тыс. | 38 тыс. | 119 тыс. |
| из них токены рассуждений | 3 тыс. | 12 тыс. | 25 тыс. | 84 тыс. |
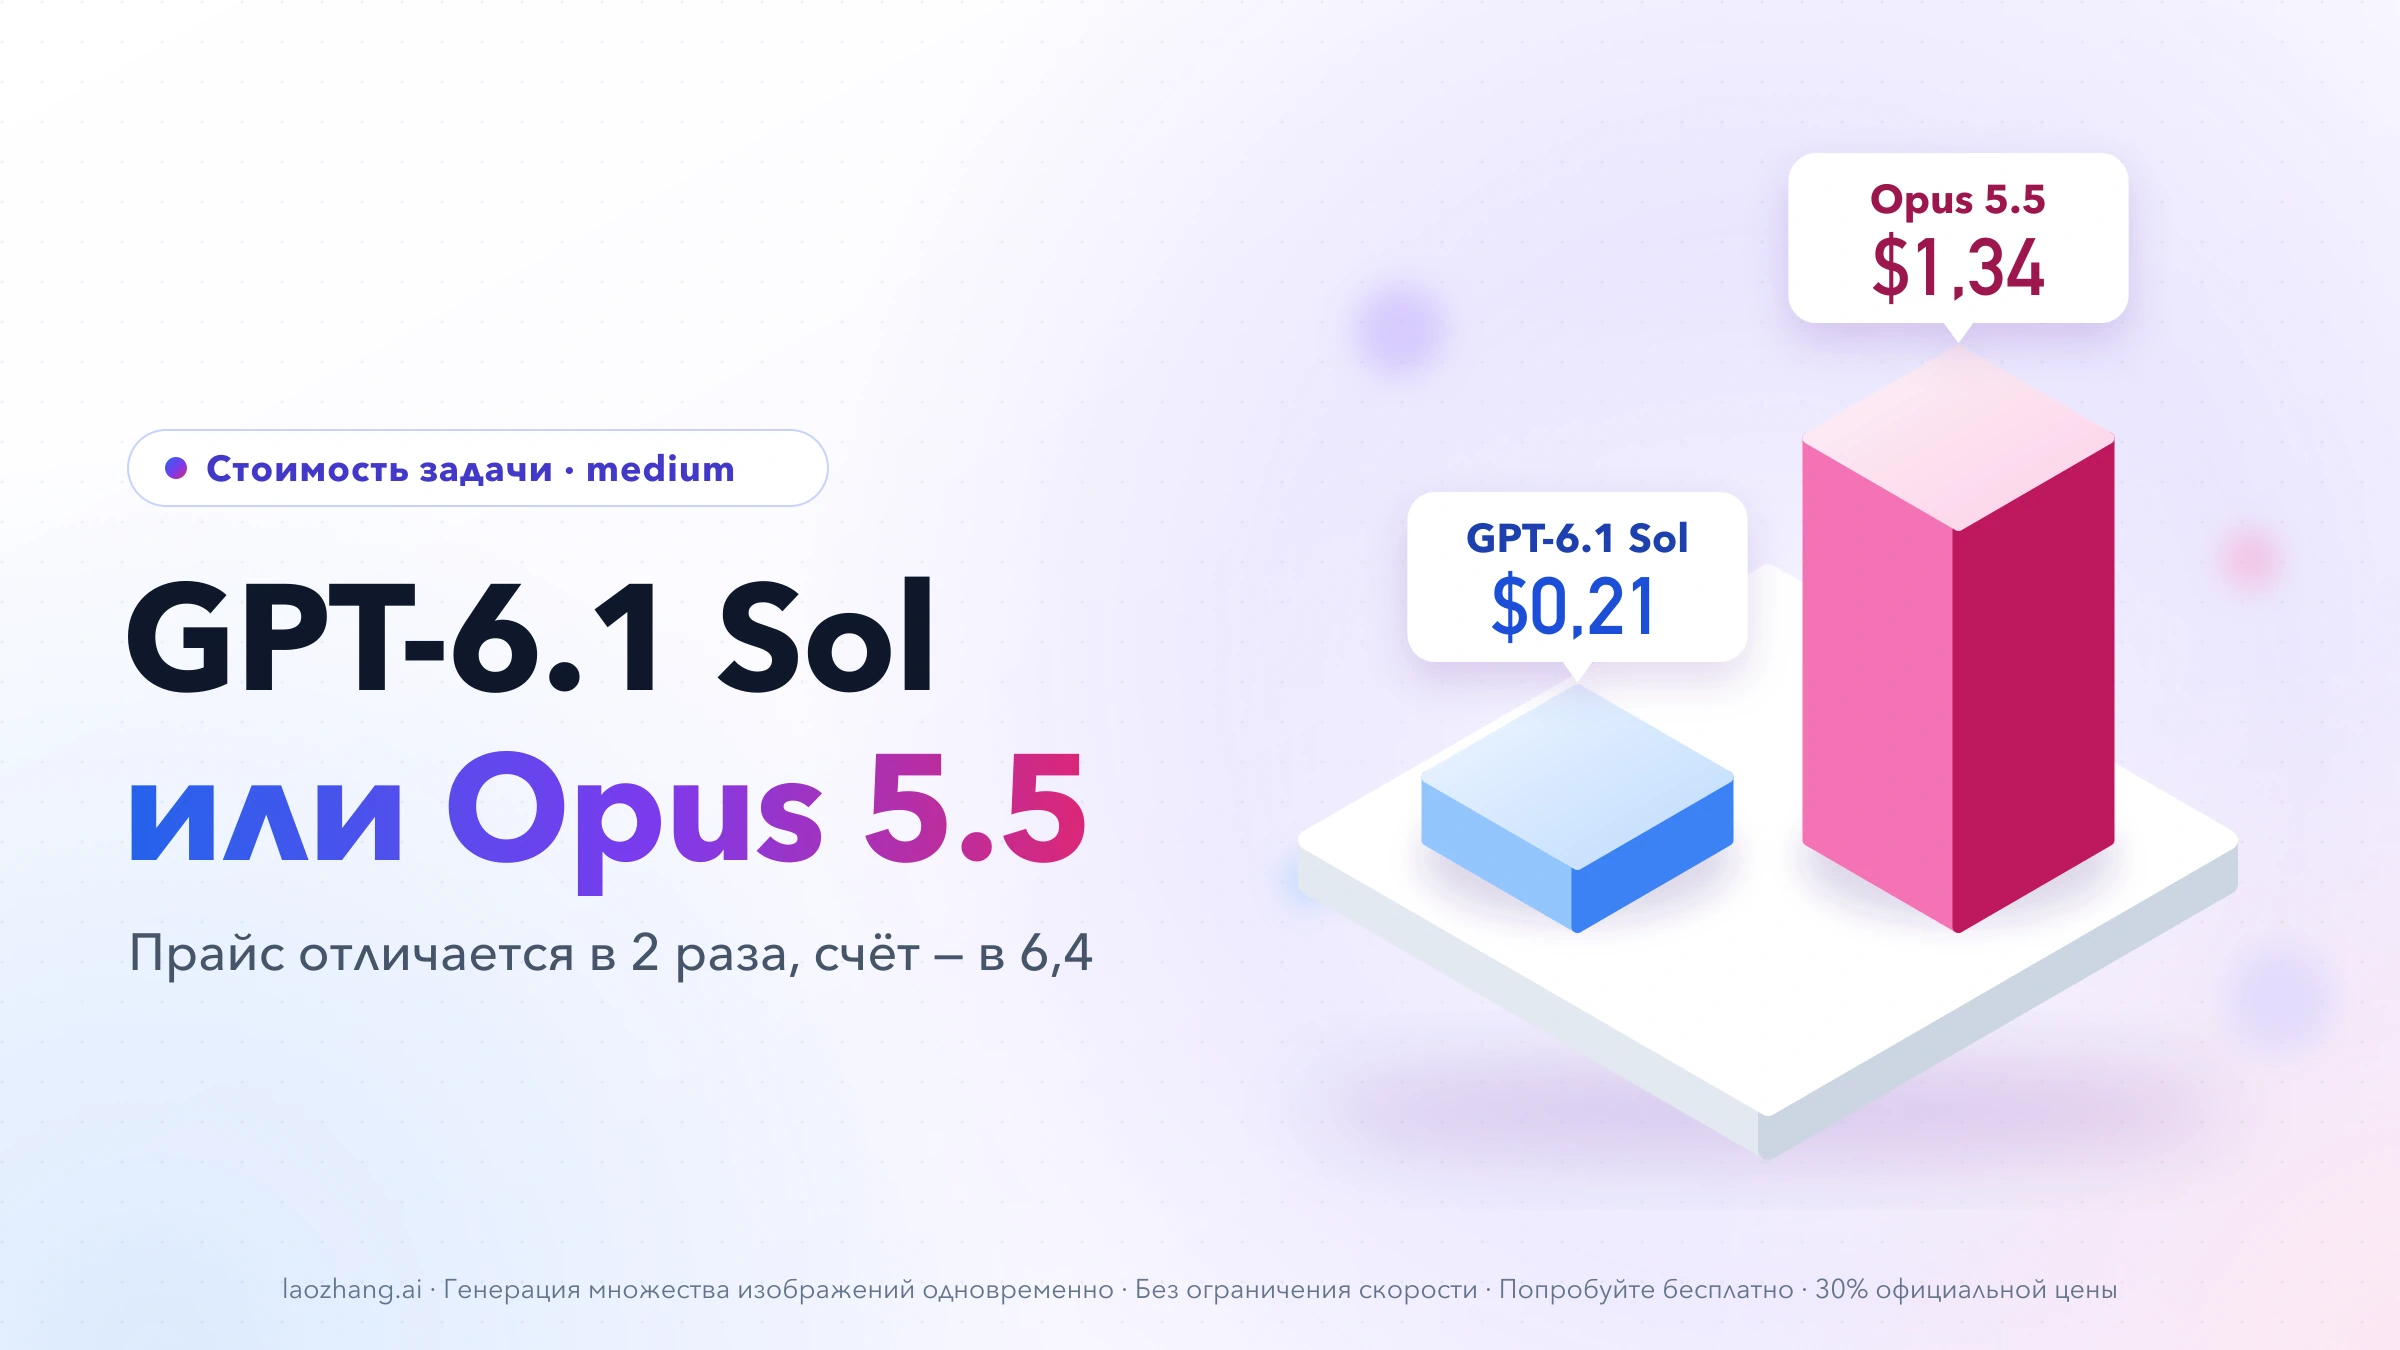
| Стоимость задачи | $0,21 | $1,34 | $0,72 | $5,98 |
| Стоимость прогона всего индекса | $361 | $1 627 | $1 082 | $8 708 |
Источники: сравнения Artificial Analysis для пары medium и пары max.
Opus 5.5 пишет на задачу в 3,1–3,3 раза больше выходных токенов, и каждый из них вдвое дороже. Отсюда стоимость задачи выше в 1,34 / 0,21 ≈ 6,4 раза на medium и в 5,98 / 0,72 ≈ 8,3 раза на max. Стоимость прогона всего индекса — другая метрика с другим соотношением (4,5 и 8,0 раза), и смешивать её со стоимостью задачи нельзя.
Сами токены у вендоров тоже разные. Anthropic указывает в прайсе, что токенизатор Claude 4.7 и более новых моделей даёт на тот же текст примерно на 30 % больше токенов, чем её прежний. Соотношения между токенами Claude и OpenAI на одинаковом тексте не публикует ни один вендор, поэтому «вдвое дешевле за токен» не значит «вдвое дешевле за документ». Надёжнее всего прогнать 20–50 типичных задач через обе модели и сложить поля usage из ответов API.
Sol Ultrafast и Opus Fast mode: цена одного запроса в каждом режиме
Ultrafast и Fast mode — не отдельные модели, а режимы обслуживания: та же модель выдаёт токены быстрее и стоит дороже. Anthropic прямо пишет, что Fast mode не меняет ни возможностей, ни качества Opus. У Sol Ultrafast включается параметром service_tier: "ultrafast" в Responses API, у Opus Fast mode — параметром speed: "fast" с бета-заголовком fast-mode-2026-02-01. С 8 октября 2026 года у GPT-6.1 Sol три режима скорости, у Opus 5.5 — два.
| Режим | Ввод | Чтение кеша | Вывод | Множитель к обычной цене |
|---|---|---|---|---|
| GPT-6.1 Sol, обычный | $2 | $0,10 | $10 | 1× |
| GPT-6.1 Sol Fast | $4 | $0,20 | $20 | 2× |
| GPT-6.1 Sol Ultrafast | $12 | $0,60 | $60 | 6× |
| Claude Opus 5.5, обычный | $4 | $0,20 | $20 | 1× |
| Claude Opus 5.5 Fast mode | $8 | $0,40 | $40 | 2× |
Цены Sol — для запросов до 272 000 входных токенов; выше порога Ultrafast стоит $24 / $1,20 / $90, Fast — $8 / $0,40 / $30. Fast mode у Opus 5.5 стоит одинаково на всём контексте. Отдельной строки чтения кеша для Fast mode в прайсе Anthropic нет: документация говорит, что множители кеша применяются поверх цены Fast mode, отсюда 0,05 × $8 = $0,40. Подробности о самом Ultrafast — в статье OpenAI Ultrafast и Sol: в чём разница, цена Sol Ultrafast $12/$60.
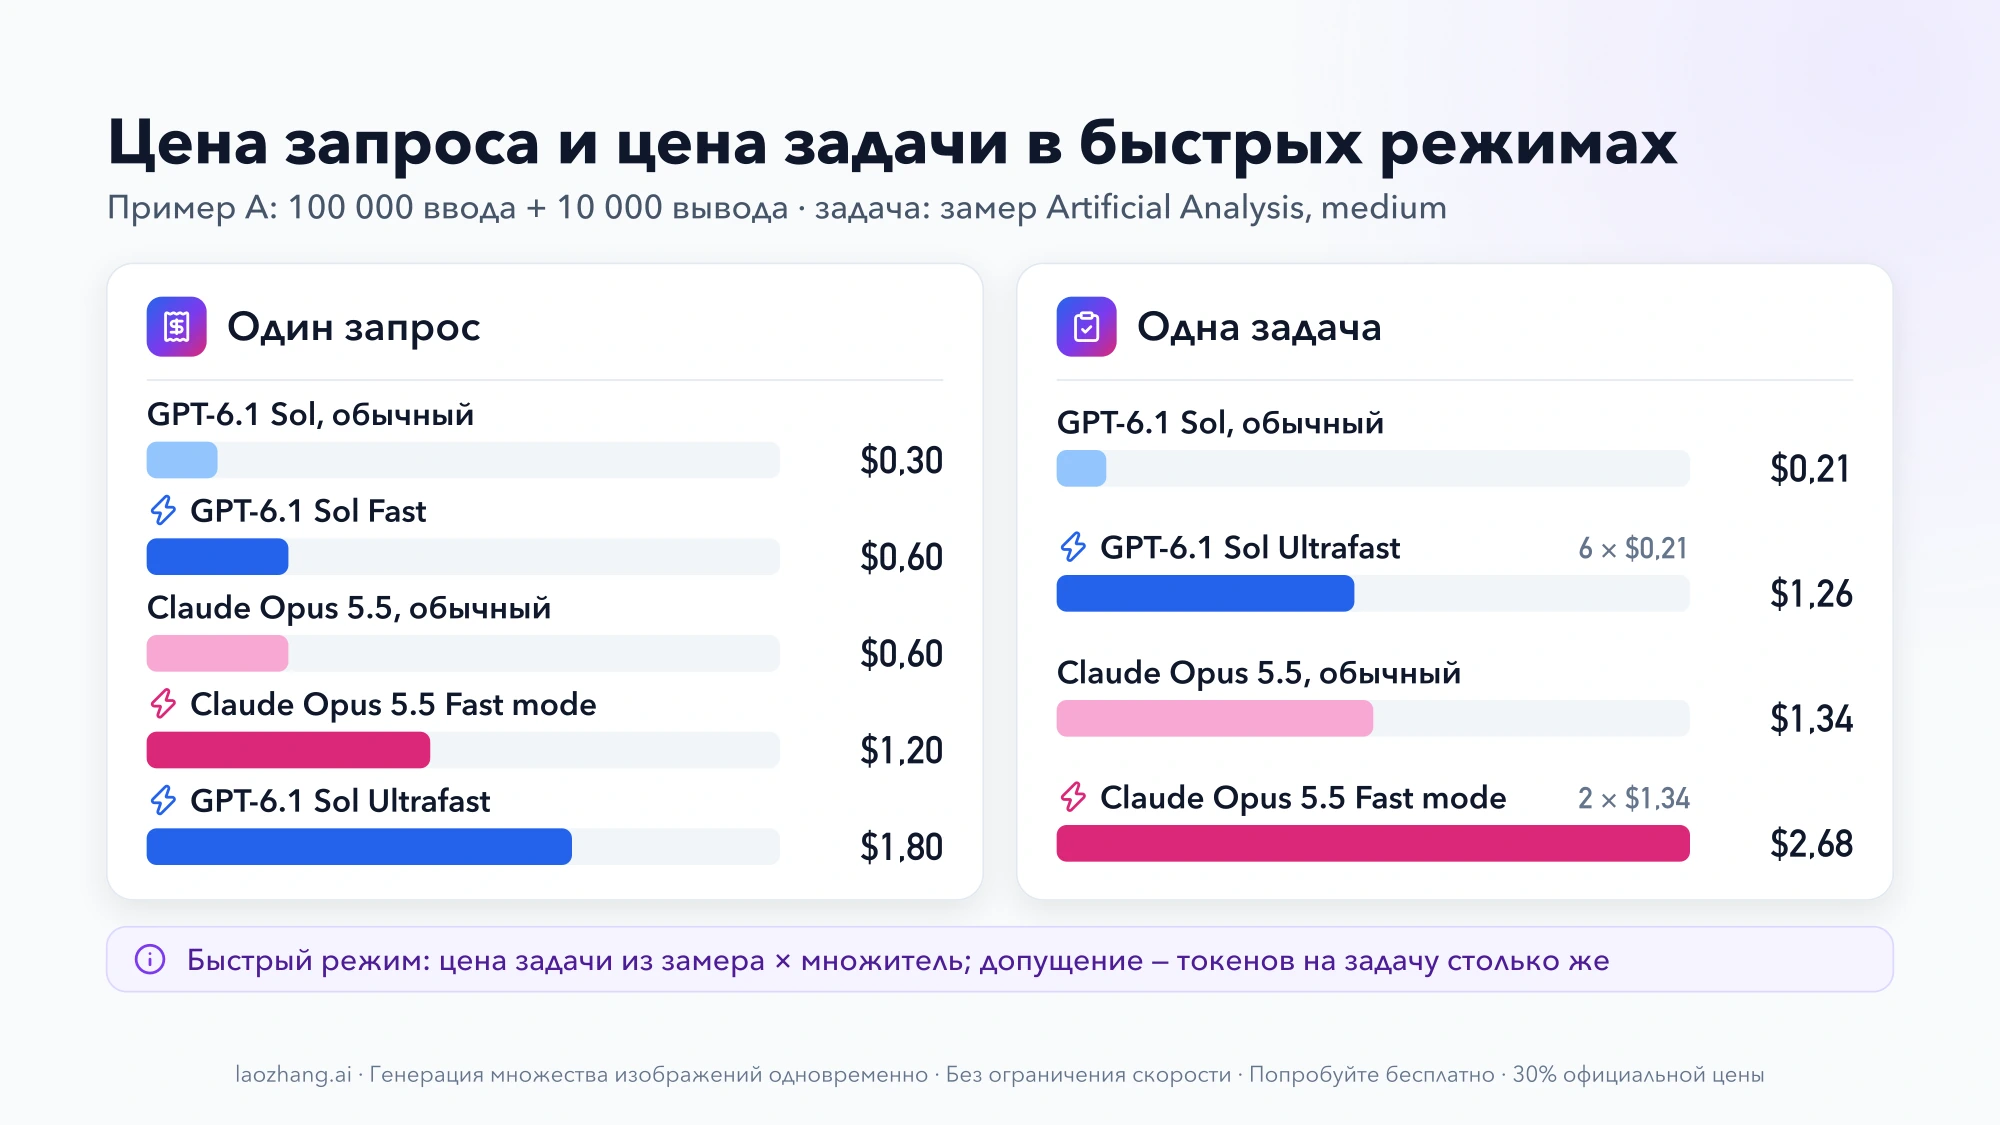
Сколько стоит один и тот же запрос при одинаковом числе токенов (запись в кеш не учтена):
| Режим | A: 100 000 ввода + 10 000 вывода, без кеша | B: 50 000 нового ввода + 200 000 из кеша + 10 000 вывода |
|---|---|---|
| GPT-6.1 Sol, обычный | $0,30 | $0,22 |
| GPT-6.1 Sol Fast | $0,60 | $0,44 |
| Claude Opus 5.5, обычный | $0,60 | $0,44 |
| Claude Opus 5.5 Fast mode | $1,20 | $0,88 |
| GPT-6.1 Sol Ultrafast | $1,80 | $1,32 |
Пример расчёта для Sol Ultrafast: 0,1 × $12 + 0,01 × $60 = $1,80 и 0,05 × $12 + 0,2 × $0,60 + 0,01 × $60 = $1,32. Соотношения в обоих вариантах одинаковые: Sol Fast стоит столько же, сколько обычный Opus, Sol Ultrafast — втрое дороже обычного Opus и в 1,5 раза дороже Opus Fast mode.
Но запрос — не задача. Если допустить, что режим скорости не меняет число токенов на задачу (быстрые режимы Artificial Analysis не измерял), то на medium задача на Sol Ultrafast стоит 6 × $0,21 = $1,26, на Opus Fast mode — 2 × $1,34 = $2,68. На max оценка такая же по направлению: 6 × $0,72 = $4,32 против 2 × $5,98 = $11,96. То есть по стоимости задачи Sol Ultrafast обходится примерно как Opus 5.5 в обычном режиме ($1,34 на medium) и в 2,1–2,8 раза дешевле Opus в Fast mode, хотя за одинаковый запрос он дороже в 1,5 раза. Это оценка с допущением, а не замер.
Кому доступны Sol Ultrafast и Opus Fast mode
| GPT-6.1 Sol Ultrafast | Claude Opus 5.5 Fast mode | |
|---|---|---|
| API | Все пользователи, только Responses API; свои лимиты: 1 млн токенов в минуту на Build, 4 млн на Launch, 40 млн на Grow | Исследовательская версия: доступ через менеджера аккаунта или лист ожидания; отдельный лимит |
| Облака и регионы | Обработка в США и ЕС (+10 %) | Только Claude API, включая Managed Agents; в Bedrock, Google Cloud, Microsoft Foundry и Claude Platform on AWS нет |
| Агент для кода | Codex и ChatGPT Work: только Pro за $500 и подходящие Enterprise/Edu (в Enterprise по умолчанию выключен) | Claude Code: команда /fast на Pro, Max, Team, Enterprise, оплата только кредитами использования (usage credits) |
| Ограничения | OpenAI советует подключаться к Responses API через WebSocket, чтобы не потерять выигрыш в задержке | Не работает с Batch и Priority Tier; переключение скорости сбрасывает кеш промптов |
В Codex Ultrafast расходует включённый в Pro 500 лимит в 8 раз быстрее обычного режима, а купленные кредиты — в 6 раз. На Pro 100 и Pro 200 Ultrafast недоступен даже с купленными кредитами (справка OpenAI о тарифах Pro). В Claude Code /fast никогда не списывается из лимита подписки — только из кредитов, которые нужно включить в настройках (документация Claude Code).
Насколько быстрее Ultrafast и Fast mode: что измерено, а что нет
OpenAI обещает для Ultrafast генерацию «до 8 раз быстрее», чем у Sol в обычном режиме. Anthropic для Fast mode — до 2,5 раза больше выходных токенов в секунду, причём ускоряется поток вывода, а не время до первого токена. Оба числа — максимумы вендоров относительно обычной скорости своей же модели. Сравнивать их между собой или переводить в сэкономленные секунды нельзя: независимых замеров токенов в секунду ни для Ultrafast, ни для Fast mode по состоянию на 10 октября 2026 года нет.
Измерена только обычная скорость. Данные Artificial Analysis:
| Уровень рассуждений | Вывод, токенов в секунду: Sol / Opus 5.5 | До первого токена ответа: Sol / Opus 5.5 |
|---|---|---|
low | 51 / 78 | 3,0 с / 8,7 с |
medium | 52 / 79 | 5,9 с / 21,9 с |
high | 53 / 80 | 62 с / 40 с |
xhigh | 55 / 83 | 174 с / 128 с |
max | 59 / 97 | 309 с / 704 с |
Opus 5.5 выдаёт токены быстрее на каждом уровне, а Sol раньше начинает отвечать на low, medium и max. Быстрый поток не означает, что задача закончится раньше: Opus пишет втрое больше. Полное время на задачу у Artificial Analysis — 156 с у Sol против 199 с у Opus на medium и 643 с против 767 с на max. Скорость зависит от нагрузки и меняется: с начала октября эти значения уже сдвигались.
Отдельно о подписках. 5 октября сотрудник OpenAI Tibo Sottiaux написал, что обычная скорость GPT-6 Astra и GPT-6.1 Sol через подписку ChatGPT стала примерно на 50 % выше. Про API в этом сообщении ничего не сказано, и в журнале изменений API такой записи нет.
Бенчмарки GPT-6.1 Sol и Opus 5.5: от ничьей на low до 6 баллов на max
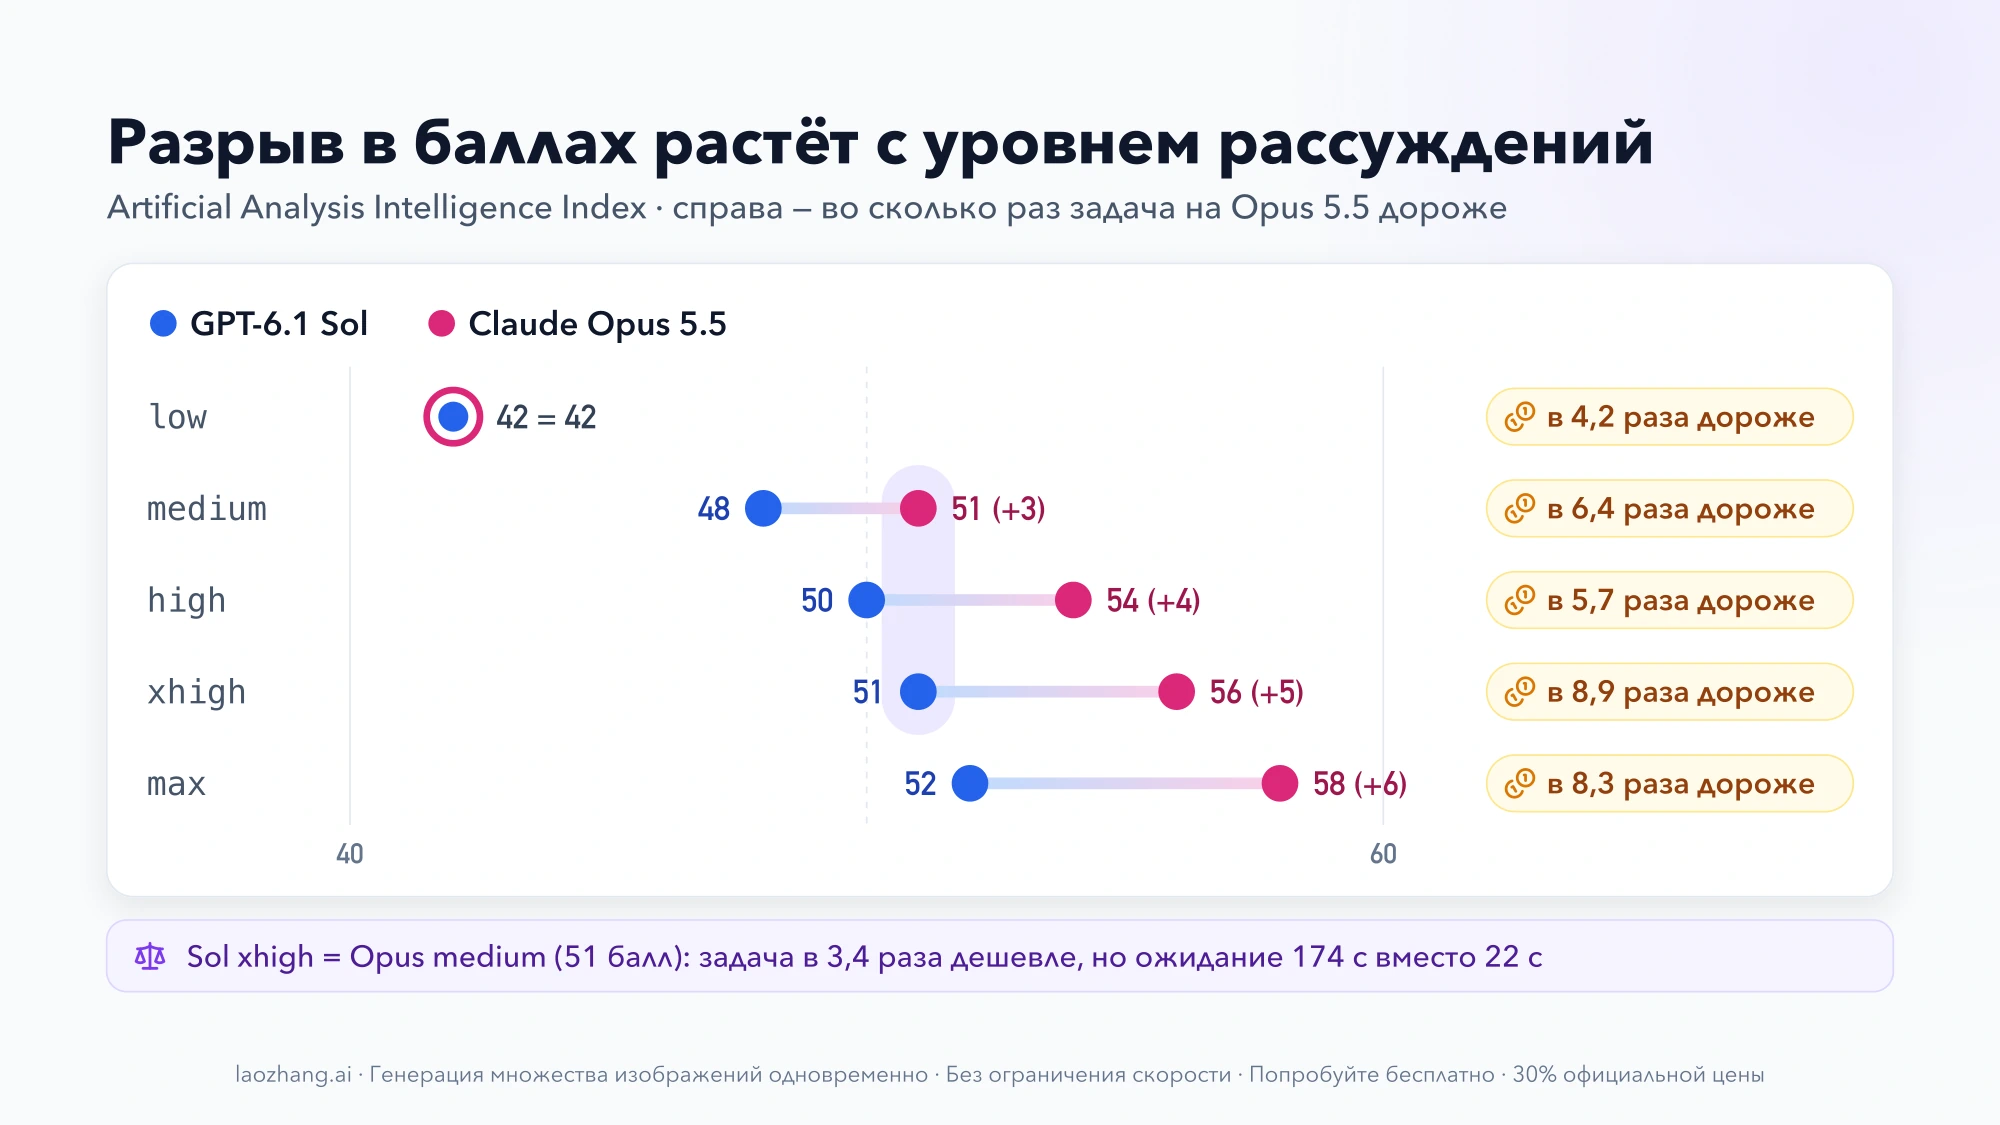
Artificial Analysis прогнал обе модели на всех пяти уровнях рассуждений (Intelligence Index v4.3.2):
| Уровень рассуждений | Индекс: Sol / Opus 5.5 | Перевес Opus | Стоимость задачи: Sol / Opus 5.5 | Opus дороже |
|---|---|---|---|---|
low | 42 / 42 | 0 | $0,13 / $0,55 | в 4,2 раза |
medium | 48 / 51 | +3 | $0,21 / $1,34 | в 6,4 раза |
high | 50 / 54 | +4 | $0,32 / $1,82 | в 5,7 раза |
xhigh | 51 / 56 | +5 | $0,39 / $3,46 | в 8,9 раза |
max | 52 / 58 | +6 | $0,72 / $5,98 | в 8,3 раза |
Источник: сравнение релизов на Artificial Analysis, значения по состоянию на 10 октября 2026 года и могут быть пересмотрены. Строки Opus 5.5 помечены Default Fallback — что это значит, объяснено ниже.
Из таблицы следуют три вещи:
- На
lowплатить за Opus незачем. Балл одинаковый, задача дороже в 4,2 раза. - Sol на высоком уровне догоняет Opus на среднем. Sol на
xhighнабирает те же 51 балл, что Opus наmedium, при стоимости задачи $0,39 против $1,34, то есть в 3,4 раза дешевле. Плата за это — ожидание: первый токен ответа через 174 с вместо 22 с. Sol наmax(52 балла) на балл выше Opusmediumи стоит 54 % от его цены за задачу. - Верх шкалы остаётся за Opus. 56 и 58 баллов на
xhighиmaxSol не достигает ни на одном уровне.
Для задач по коду полезна отдельная строка того же сравнения — Terminal-Bench 4.0 в прогоне Artificial Analysis: Sol набирает 48,0 % на medium и 56,1 % на max, Opus 5.5 — 52,5 % и 59,6 %. Как подобрать уровень рассуждений у Opus под свою задачу, разобрано в руководстве Claude Opus 5.5: какой уровень effort выбрать и как его задать.
Vals Index: 66,97 % против 61,15 %, с поправкой на fallback — 65,05 %
Vals Index v2.1 (обновлён 7 октября 2026 года) взвешивает задачи по финансам, коду, праву и налогам. Уровень рассуждений для строк Vals не указывает.
| Модель | Vals Index | Стоимость теста | Время на тест |
|---|---|---|---|
| Claude Opus 5.5 | 66,97 % | $32,14 | 1 ч 19 мин |
| GPT-6.1 Sol | 61,15 % | $3,24 | 43 мин 10 с |
Opus 5.5 впереди на 5,8 процентного пункта при тесте в 9,9 раза дороже. В примечании Vals уточняет: если задачи, которые после отказа выполнила другая модель, считать проваленными, у Opus 5.5 остаётся 65,05 %, и разрыв сокращается до 3,9 пункта. В той же таблице Claude Sonnet 5.5 набирает 67,04 % при прайсе как у Sol ($2 / $10), а первое место занимает Gemini 4 Argon с 68,90 %.
Что показывают графики OpenAI: на medium впереди Sol, на max — Opus
OpenAI в анонсе GPT-6.1 Sol сравнивает модель с Opus 5.5 «с fallback» на трёх тестах:
| Тест из анонса OpenAI | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
GDP.pdf, high | 32,0 %, $0,35 за задачу | 28,8 %, $0,83 |
AutomationBench 1.0.6, medium | 31,7 %, $0,19 | 29,5 %, $0,65 |
AutomationBench 1.0.6, max | 36,1 %, $0,30 | 42,5 %, $1,44 |
Terminal-Bench Science 0.1, max | 57,0 %, $5,47 | 63,3 %, $23,21 |
Это тесты и настройки, выбранные вендором, а результаты конкурента OpenAI взяла из публичных отчётов. Но направление совпадает со сторонними замерами: на среднем уровне Sol сопоставим или впереди при кратно меньшей цене, на максимальном Opus 5.5 сильнее и кратно дороже. В собственных таблицах Anthropic в анонсе Opus 5.5 строки GPT-6.1 Sol нет: они вышли раньше этой модели.
Default Fallback: часть задач Opus 5.5 выполнила другая модель Claude
Классификаторы безопасности Opus 5.5 могут отклонить запрос. Это не ошибка: API возвращает обычный ответ со stop_reason: "refusal". Если вызывающая сторона включила серверный fallback (бета-параметр fallbacks: "default"), Claude API повторяет запрос на модели, которую Anthropic рекомендует для этой категории отказа; большинство задач по кибербезопасности уходит на Opus 4.8. Пометка Default Fallback у Artificial Analysis и примечания Vals и OpenAI означают ровно это: часть баллов и часть стоимости в строках Opus 5.5 принадлежит другой модели.
Что из этого следует для выбора:
- Без настройки fallback отказ остаётся отказом, и ваш код должен его обрабатывать.
- Каждая попытка оплачивается по ставкам той модели, которая её выполнила. Отказ до начала вывода оплачивается только в категориях
bio,frontier_llmиreasoning_extraction, но в лимиты запросов засчитывается всегда (документация Anthropic). - Чем ближе ваши задачи к кибербезопасности и другим чувствительным темам, тем больше реальный Opus 5.5 у вас будет отличаться от строк в рейтингах.
Стоит ли менять модель по умолчанию: стоимость принятого результата
Баллы не говорят, сколько стоит результат, который вы действительно примете. Пусть одна попытка стоит c, проходит вашу проверку с вероятностью p, а проверка каждой попытки стоит R (время человека или прогон тестов). Тогда ожидаемая стоимость одного принятого результата:
стоимость принятого результата = (c + R) / pOpus 5.5 выгоднее GPT-6.1 Sol только при условии:
p_opus / p_sol > (c_opus + R) / (c_sol + R)Величины p и R — ваши, их даёт только пробный прогон на собственных задачах. Для c ниже взята стоимость задачи из замера Artificial Analysis на medium ($0,21 и $1,34); на ваших задачах она будет другой.
Проверка бесплатна (R = 0). Нужное соотношение — 1,34 / 0,21 ≈ 6,38. Даже если Opus 5.5 проходит проверку всегда, он выгоднее только тогда, когда Sol проходит её реже чем в 1 / 6,38 ≈ 15,7 % попыток. При автоматической проверке Sol почти всегда дешевле.
Проверка стоит $5 на попытку (например, 5 минут специалиста при ставке $60 в час). Нужное соотношение — (1,34 + 5) / (0,21 + 5) = 6,34 / 5,21 ≈ 1,217. Если Sol проходит 70 % попыток, Opus 5.5 должен проходить больше 85,2 %:
| Вариант | Доля принятых | Расчёт | Стоимость принятого результата |
|---|---|---|---|
| Claude Opus 5.5, обычный | 90 % | (1,34 + 5) / 0,9 | $7,04 |
| GPT-6.1 Sol, обычный | 70 % | (0,21 + 5) / 0,7 | $7,44 |
| Claude Opus 5.5, обычный | 80 % | (1,34 + 5) / 0,8 | $7,93 |
| Claude Opus 5.5 Fast mode | 90 % | (2,68 + 5) / 0,9 | $8,53 |
| GPT-6.1 Sol Ultrafast | 70 % | (1,26 + 5) / 0,7 | $8,94 |
Чем дороже проверка, тем меньше значит цена токенов и тем больше — доля результатов, принятых с первого раза. Быстрые режимы добавляют к каждому принятому результату около $1,50 в этом примере; это цена ожидания, и платить её имеет смысл там, где ждёт человек, а не очередь задач. Расчёт предполагает, что попытки независимы, повторяются до успеха и проверяются одинаково долго, а режим скорости не меняет число токенов на задачу.
Codex, Claude Code и подписки за $20: где работает каждая модель
ChatGPT. На Plus за $20 GPT-6.1 Sol доступен в Work и Codex. По странице тарифов это примерно 15–160 локальных сообщений за пятичасовое окно (у GPT-6 Astra — 5–45); число зависит от размера и сложности задач. У тарифов Pro (за $100, $200 и $500) пятичасового лимита нет. Новые подписки Pro 200, по справке OpenAI, получают меньший включённый лимит при той же цене $200; кто был подписан с 22 по 29 сентября, сохраняет прежний лимит до 29 октября 2026 года. Насколько лимит уменьшился, OpenAI не называет. Подробнее о том, что даёт Plus в Work и Codex, — в статье Как пользоваться GPT-6 Astra: на Plus — только в Work и Codex.
Claude. Opus 5.5 входит в Claude Pro ($20 в месяц или $17 при оплате за год) и Max (от $100, в 5 или 20 раз больше лимита Pro); Claude Code доступен на всех платных тарифах. Числового лимита для Opus 5.5 Anthropic не публикует. Max и Team теперь включают $100–200 в месяц кредитов на API — как их получить, описано в материале Кредиты API Claude Max: как получить и на что хватит $100–200.
Поэтому сравнить две подписки за $20 по количеству задач нельзя. Аналитики SemiAnalysis в отчёте от 6 октября оценивают, что подписки Claude дают примерно в 5 раз больше ценности в пересчёте на цены API, чем подписки с GPT-6.1 Sol на их агентной нагрузке. Это не «в 5 раз больше работы»: в пересчёте по прайсу каждый токен Opus весит вдвое больше токена Sol. Надёжный способ выбрать подписку — поработать на каждой со своими задачами и следить за счётчиком лимита.
Частые вопросы о GPT-6.1 Sol и Opus 5.5
GPT-6.1 Sol лучше Claude Opus 5.5?
По баллам — нет: в индексе Artificial Analysis Opus 5.5 выше на всех уровнях, кроме low, где ничья, а в Vals Index он впереди на 5,8 пункта (3,9 с поправкой на fallback). По стоимости задачи GPT-6.1 Sol дешевле в 4–10 раз в тех же замерах. В тестах из анонса OpenAI на среднем уровне рассуждений впереди Sol, на максимальном — Opus.
Во сколько раз GPT-6.1 Sol дешевле Opus 5.5?
По прайсу до 272 000 входных токенов — ровно в 2 раза по каждой строке. Выше порога при равном числе токенов — на 1–7 %. По стоимости задачи у Artificial Analysis — в 4,2–8,9 раза в зависимости от уровня рассуждений, потому что Opus 5.5 пишет втрое больше токенов.
Сколько стоит GPT-6.1 Sol Ultrafast и кому он доступен?
С 8 октября 2026 года — $12 за 1 млн входных токенов, $0,60 за чтение кеша, $15 за запись в кеш и $60 за вывод; выше 272 000 входных токенов — $24 / $1,20 / $30 / $90. В API режим открыт всем через Responses API с service_tier: "ultrafast". В Codex и ChatGPT Work — только на Pro за $500 и в подходящих Enterprise и Edu.
Есть ли GPT-6.1 Astra или GPT-6.1 Luna?
Нет. Единственная модель версии 6.1 — GPT-6.1 Sol с идентификатором gpt-6.1-sol. Astra и Luna остаются в версии GPT-6.
Есть ли GPT-6.1 Sol в обычном чате ChatGPT?
Нет. В чате с 7 октября работает GPT-6: на платных тарифах это GPT-6 Sol, на Free и Go — GPT-6 Luna. GPT-6.1 Sol доступен в ChatGPT только в режиме Work и в Codex.
Цена GPT-6.1 Sol — временная промо-цена?
В прайсе OpenAI она как промо не помечена. Примечание о промо-цене «как минимум до 21 ноября 2026 года» относится к GPT-5.6 Sol. Если вы сравниваете Opus 5.5 именно с ним, смотрите разбор Claude Opus 5.5 или GPT-5.6 Sol: одинаковая цена, разные счета.
Чем заменить, если не подходят ни Sol, ни Opus 5.5?
Claude Sonnet 5.5 стоит как Sol ($2 / $10) и в Vals Index набирает 67,04 % — чуть выше Opus 5.5; сравнение с ним и с Gemini 4 Argon — в статье Gemini 4 Argon, Opus 5.5 или Sonnet 5.5: что выбрать для API. Самая сильная модель OpenAI — GPT-6 Astra за $10 / $50; Sol Ultrafast стоит в 1,2 раза дороже её обычного режима. Если Sol слишком дорог для массовых задач, посмотрите GPT-6 Luna или Sol: сколько стоят и когда Sol окупается.
Что о GPT-6.1 Sol и Opus 5.5 пока неизвестно?
Измеренная скорость Sol Ultrafast и Opus Fast mode в токенах в секунду; насколько уменьшился лимит новых подписок Pro 200; касается ли ускорение на 50 % обращений через API; числовые лимиты Opus 5.5 в подписках Claude; соотношение токенов двух вендоров на одинаковом тексте; сколько продержатся текущие цены. Независимых сравнений на одинаковой обвязке, кроме Artificial Analysis и Vals, на 10 октября 2026 года не опубликовано.