По состоянию на 24 сентября 2026 года Claude Opus 5.5 и GPT-5.6 Sol стоят в API одинаково: $4 за 1 млн входных токенов и $20 за 1 млн выходных. Но у GPT-5.6 Sol это промо-цена, которую OpenAI гарантирует «как минимум до 21 ноября 2026 года», а на одних и тех же задачах модели тратят разное число токенов. Поэтому выбирать стоит не по ставке, а по форме вашей нагрузки и по стоимости результата, который вы в итоге принимаете.
Что пробовать первым
- Вы уже работаете на GPT-5.6 Sol и довольны качеством. Сначала проверьте GPT-6 Sol (
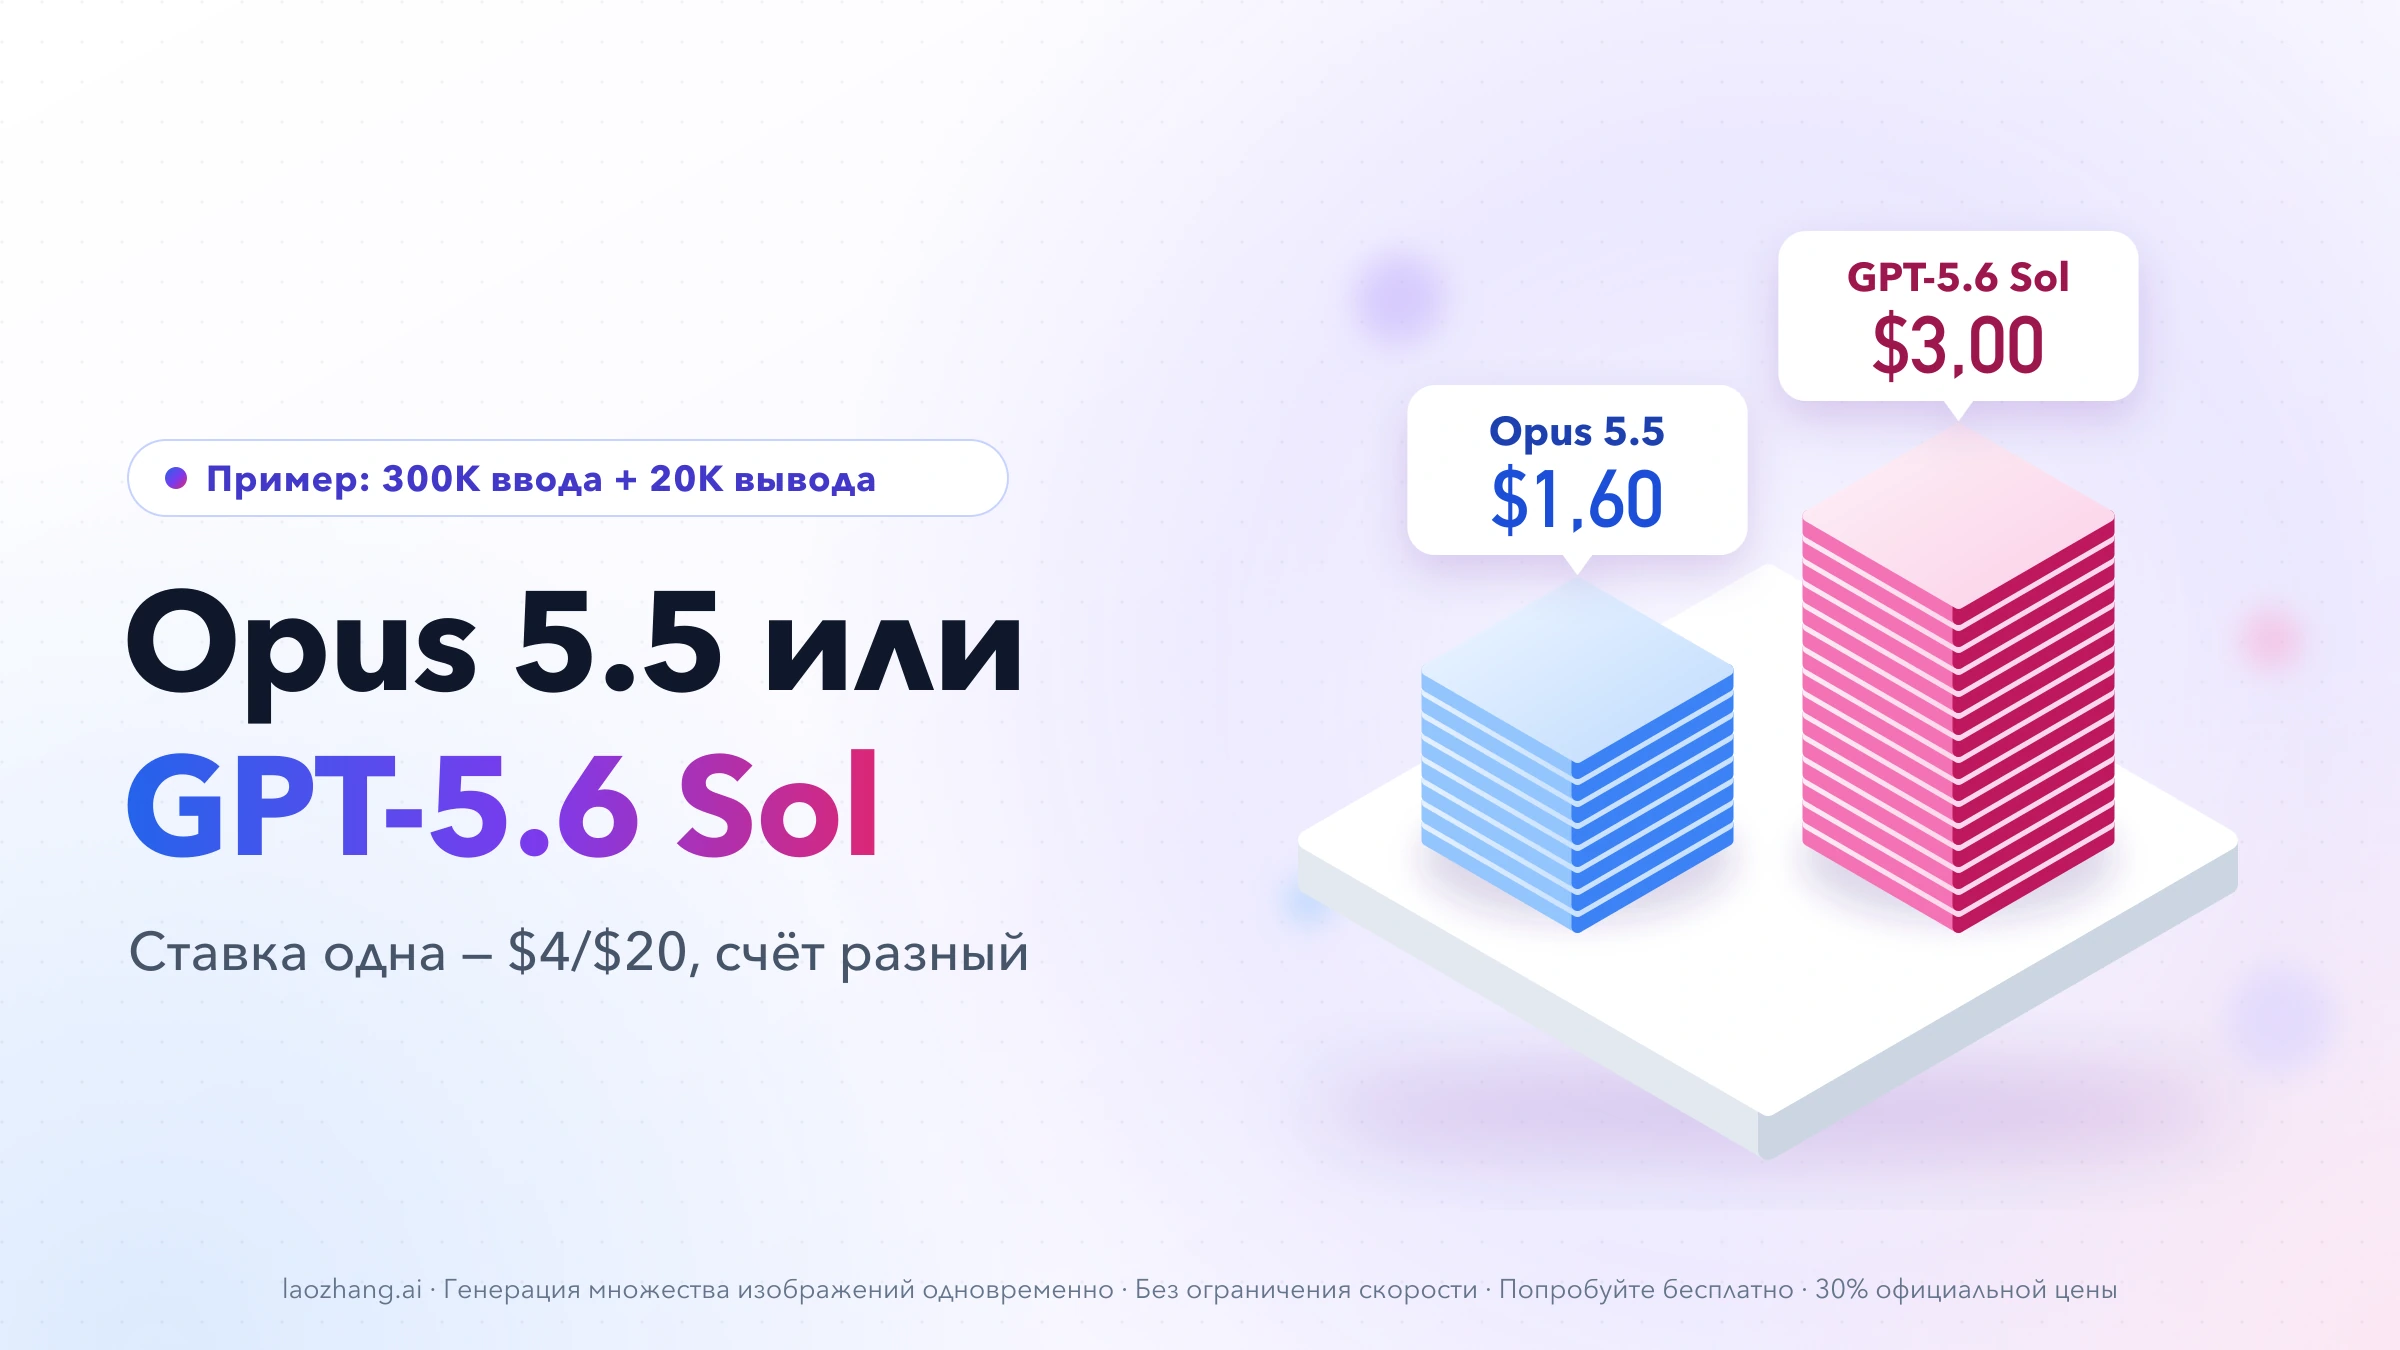
gpt-6-sol), который OpenAI выпустила 22 сентября 2026 года, в один день с Opus 5.5. Его ставка вдвое ниже — $2/$10, а цена GPT-5.6 Sol после окончания промо не объявлена. Opus 5.5 имеет смысл добавить в тот же тест, если качество Sol вас не устраивало. - Запросы больше 272K входных токенов. Здесь дешевле Opus 5.5: у OpenAI такой запрос целиком тарифицируется по повышенной ставке, у Anthropic надбавки за длинный контекст нет. На примере в 300K ввода и 20K вывода это $1,60 у Opus 5.5 против $3,00 у GPT-5.6 Sol.
- Большая доля повторно читаемого кеша. Чтение кеша у Opus 5.5 стоит $0,20 за 1 млн токенов, у GPT-5.6 Sol — $0,40.
- Короткие запросы без кеша. Ставки равны, и решает объём вывода. В независимом индексе Artificial Analysis Opus 5.5 выдаёт примерно вдвое больше выходных токенов на задачу, чем GPT-5.6 Sol, поэтому при равной ставке прогон индекса у него дороже — примерно на 9 %.
- Сложная агентная работа с кодом, где важен процент принятых решений. И таблица Anthropic, и независимый индекс ставят Opus 5.5 выше GPT-5.6 Sol, так что с него логично начать. Но считать нужно стоимость принятого результата, а не число баллов.
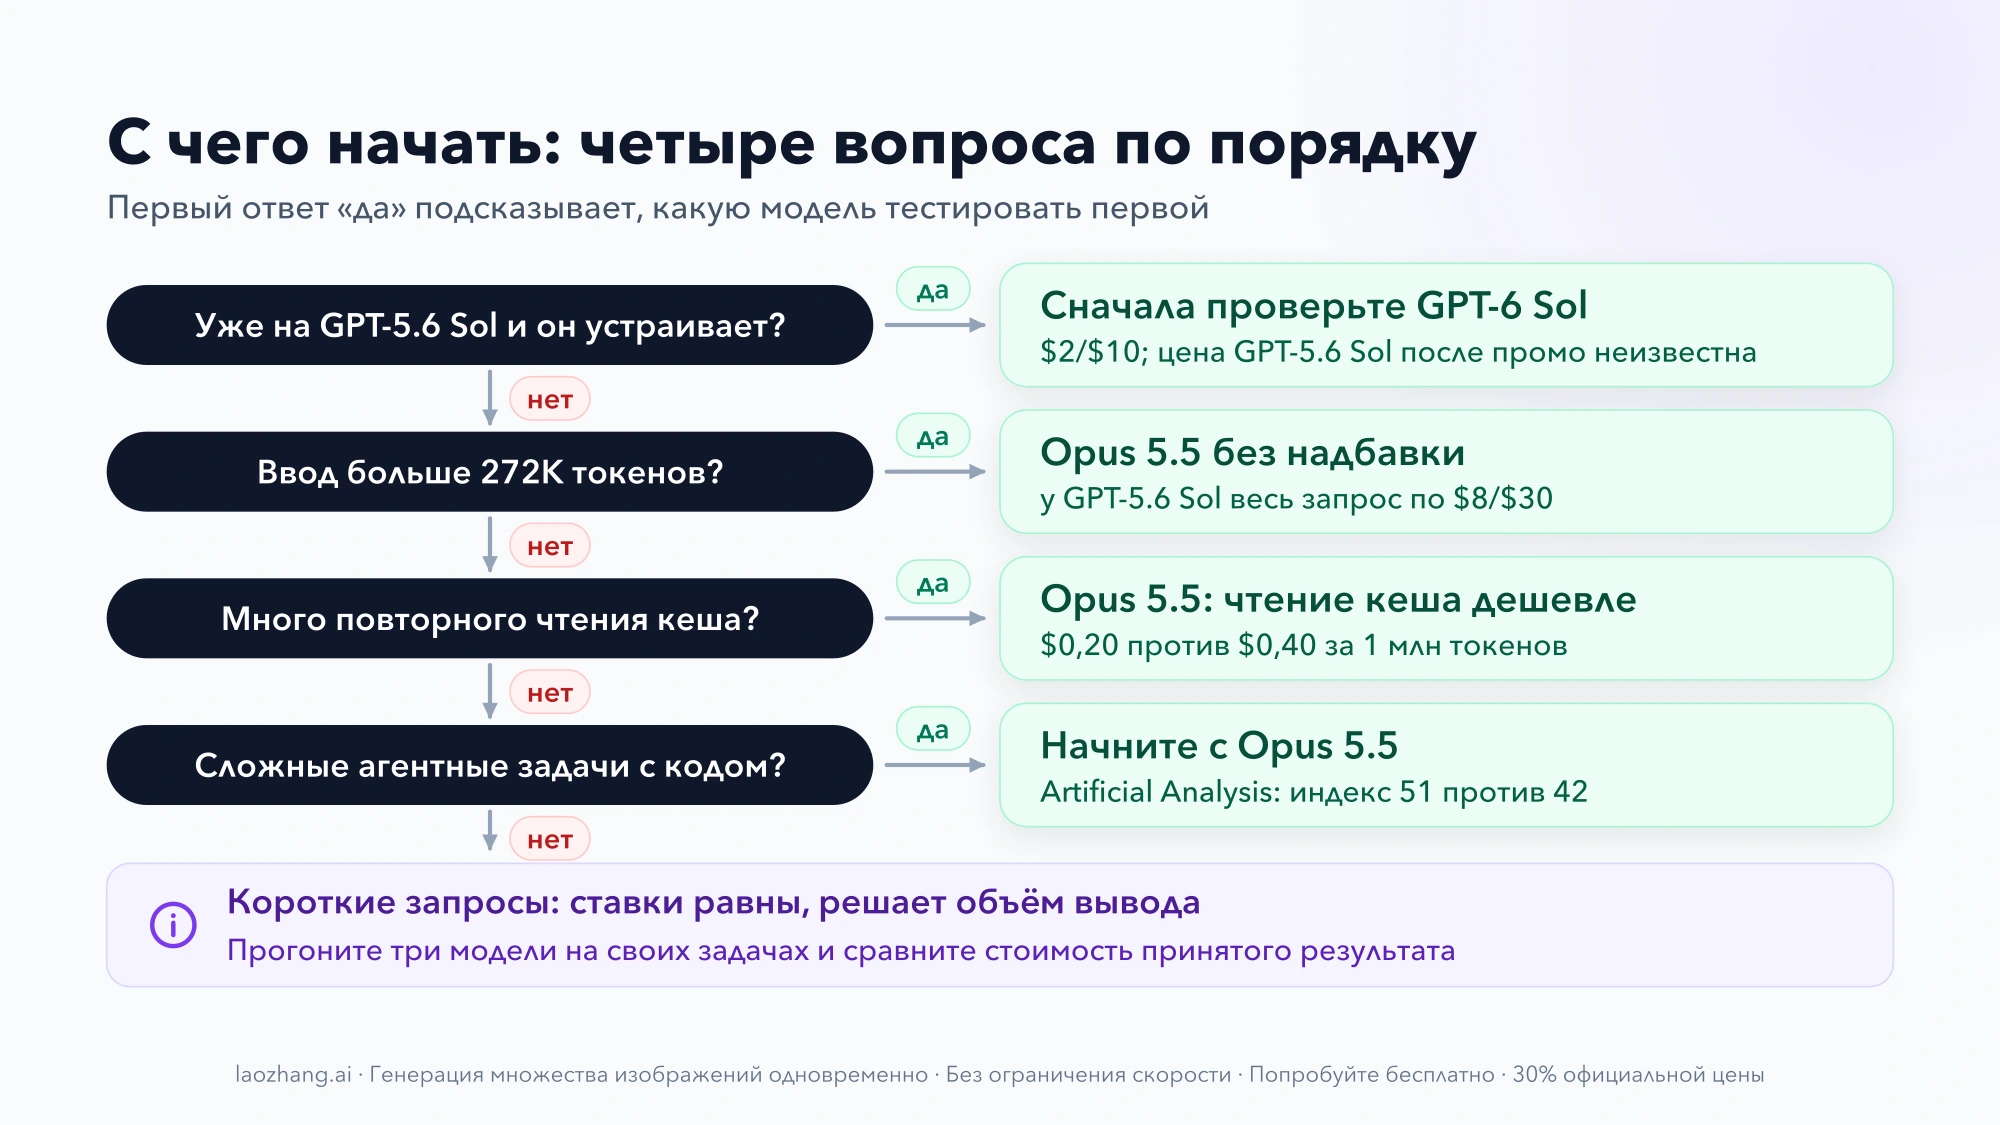
Если ни один пункт не подходит явно, проведите небольшой тест по методике в конце страницы: на ваших задачах он даст ответ точнее любой таблицы.
Цены на 24 сентября 2026 года
Все цены — в долларах США за 1 млн токенов, прямой API, тариф Standard, без налогов, надбавок за хранение данных в регионе и наценок облачных платформ.
| Claude Opus 5.5 | GPT-5.6 Sol | GPT-6 Sol | |
|---|---|---|---|
| ID модели | claude-opus-5-5 | gpt-5.6-sol | gpt-6-sol |
| Ввод | $4 | $4 (промо) | $2 |
| Чтение кеша (cache read) | $0,20 | $0,40 | $0,20 |
| Запись в кеш (cache write) | $5 на 5 минут, $8 на 1 час | $5 | $2,50 |
| Вывод | $20 | $20 (промо) | $10 |
| Запрос больше 272K входных токенов | та же цена | весь запрос: $8 / $0,80 / $10 / $30 | весь запрос: $4 / $0,40 / $5 / $15 |
| Контекст / максимум вывода | 1M / 128K | 1 050 000 / 128 000 | 1 050 000 (ввод до 922 000) / 128 000 |
| Batch | $2 / $10 | вдвое дешевле Standard | вдвое дешевле Standard |
Для строк больше 272K порядок цен: ввод / чтение кеша / запись в кеш / вывод.
Источники: цены Anthropic, карточка Opus 5.5, цены OpenAI, карточки GPT-5.6 Sol и GPT-6 Sol.
Три условия меняют смысл этой таблицы:
- $4/$20 у GPT-5.6 Sol — промо-цена. Так её называет сама OpenAI и обещает её «как минимум до 21 ноября 2026 года», без точной даты окончания. На запуске 9 июля 2026 года Sol стоил $5 за ввод и $30 за вывод. Какой будет цена после промо, OpenAI не сообщает, поэтому $5/$30 ниже используется только как «цена запуска», а не как прогноз.
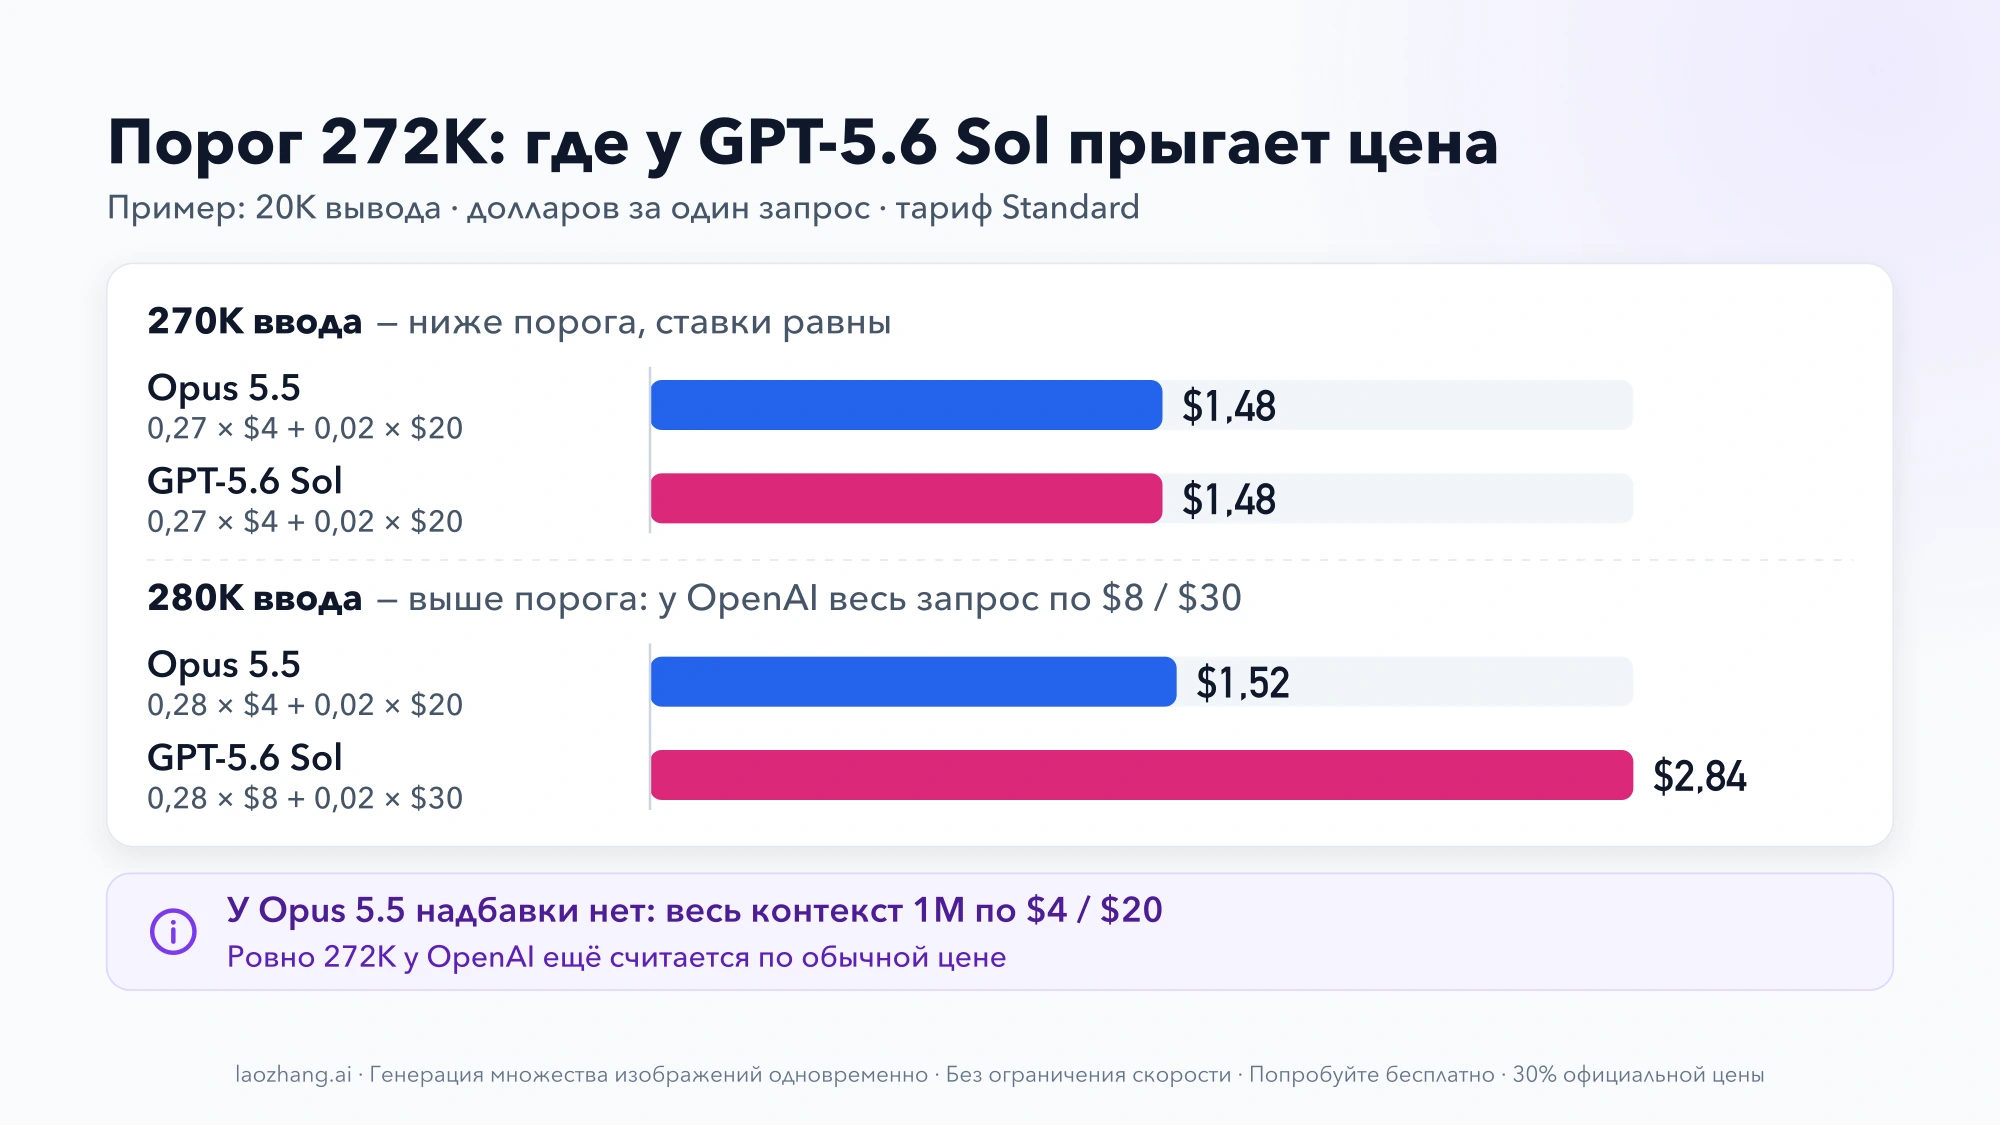
- Порог 272K у OpenAI применяется ко всему запросу. Если ввод больше 272K токенов, по повышенной ставке считаются и ввод, и вывод всего запроса. Ровно 272K — ещё обычная цена. У Anthropic весь контекст 1M тарифицируется по стандартной ставке: запрос на 900K токенов стоит столько же за токен, сколько запрос на 9K.
- Региональная обработка стоит дороже. У Anthropic параметр
inference_geoсо значениемusумножает цену на 1,1, у OpenAI региональные эндпоинты для новых моделей дают надбавку 10 %.
Подробнее о ценах на стороне Anthropic — в статье «Claude Opus 5.5: сколько стоит API и что проверить при переходе с Opus 5», о тарифах GPT-6 Sol — в «GPT-6 Luna и Sol: сколько стоят токены и какую модель выбрать».
Сколько стоит запрос: три расчёта
Формула одна для всех моделей:
стоимость = (новый ввод × ставка ввода + чтение кеша × ставка чтения + вывод × ставка вывода) / 1 000 000
В примерах число токенов одинаковое у всех моделей, предварительная запись в кеш не учитывается, инструменты не вызываются.
| Сценарий | Claude Opus 5.5 | GPT-5.6 Sol (промо) | GPT-6 Sol |
|---|---|---|---|
| 100K нового ввода + 10K вывода | $0,60 | $0,60 (по цене запуска $0,80) | $0,30 |
| 300K нового ввода + 20K вывода | $1,60 | $3,00 | $1,50 |
| 200K чтения кеша + 20K нового ввода + 5K вывода | $0,22 | $0,26 | $0,13 |
Как получены цифры:
- Короткий запрос. Opus 5.5 и GPT-5.6 Sol: 0,1 × $4 + 0,01 × $20 = $0,60. GPT-5.6 Sol по цене запуска: 0,1 × $5 + 0,01 × $30 = $0,80. GPT-6 Sol: 0,1 × $2 + 0,01 × $10 = $0,30.
- Длинный запрос (больше 272K). Opus 5.5: 0,3 × $4 + 0,02 × $20 = $1,60. GPT-5.6 Sol по длинной ставке: 0,3 × $8 + 0,02 × $30 = $3,00. GPT-6 Sol: 0,3 × $4 + 0,02 × $15 = $1,50.
- Кеш. Opus 5.5: 0,2 × $0,20 + 0,02 × $4 + 0,005 × $20 = $0,22. GPT-5.6 Sol: 0,2 × $0,40 + 0,02 × $4 + 0,005 × $20 = $0,26. GPT-6 Sol: 0,2 × $0,20 + 0,02 × $2 + 0,005 × $10 = $0,13.
Скачок на пороге хорошо виден, если сдвинуть длинный пример. При 270K ввода и 20K вывода Opus 5.5 и GPT-5.6 Sol стоят одинаково: 0,27 × $4 + 0,02 × $20 = $1,48. При 280K Opus 5.5 обойдётся в $1,52, а GPT-5.6 Sol — в 0,28 × $8 + 0,02 × $30 = $2,84. Поэтому, если ваши запросы колеблются около 272K, сокращение контекста на несколько тысяч токенов у OpenAI может почти вдвое снизить цену запроса.
Сколько кешированных токенов OpenAI засчитывает в порог 272K, в документации отдельно не расписано, поэтому кешированный пример взят заведомо меньше порога.
Почему одинаковая ставка не даёт одинаковый счёт
Таблица выше сравнивает цену токена, но не число токенов, которое модель тратит на задачу. Разница складывается из двух причин.
Объём вывода и рассуждений. В сравнении Artificial Analysis Opus 5.5 на уровне рассуждений (effort) medium и GPT-5.6 Sol на high дают такие цифры:
| Показатель Artificial Analysis | Opus 5.5 (medium) | GPT-5.6 Sol (high) |
|---|---|---|
| Intelligence Index | 51 | 42 |
| Выходных токенов на задачу | 26 тыс. | 13 тыс. |
| Токенов рассуждений на задачу | 12 тыс. | 6 тыс. |
| Стоимость прогона индекса | $1 627 | $1 487 |
| Скорость вывода | 78 токенов/с | 69 токенов/с |
| Время до первого токена ответа | 21,62 с | 14,72 с |
При одинаковой ставке Opus 5.5 обходится примерно на 9 % дороже (1 627 / 1 487 ≈ 1,09), потому что выдаёт вдвое больше выходных токенов. На максимальных уровнях рассуждений разрыв растёт: индекс 58 против 47, стоимость прогона $8 708 против $3 465, то есть примерно в 2,5 раза. Это результаты одного оценщика на его наборе задач, и цифры могут обновляться.
У Opus 5.5 мышление включено всегда, а effort по умолчанию — medium. Как уровень effort влияет на расход, разобрано в статье «Claude Opus 5.5: какой уровень effort выбрать и как его задать».
Токенизаторы. Один и тот же текст превращается у Anthropic и OpenAI в разное число токенов. Anthropic пишет, что токенизатор моделей Claude 4.7 и новее даёт примерно на 30 % больше токенов, чем её прежний. Соотношение «токены Claude / токены OpenAI» для одинакового текста не опубликовано ни одной из компаний. Значит, одинаковая цена за токен не означает одинаковую цену документа: сравнивать нужно по счётчикам токенов в ответах API на ваших же данных.
Стоимость задачи и качество результата тоже могут расходиться. В единичном тесте DataCamp (однофайловый тетрис с переворотом гравитации) GPT-6 Sol потратил $0,26 и получил 5,0 балла по рубрике, Opus 5.5 — $0,87 и 4,3 балла. Это одна задача и один прогон, к тому же в нём участвовал GPT-6 Sol, а не GPT-5.6 Sol, так что вердиктом это не является. Но пример хорошо показывает, зачем считать стоимость принятого результата.
Бенчмарки: почему две таблицы запуска нельзя сложить
Каждая компания опубликовала свою таблицу, и в каждой выигрывает своя модель.
В таблице Anthropic (Opus 5.5 / GPT-5.6 Sol):
| Бенчмарк | Opus 5.5 | GPT-5.6 Sol |
|---|---|---|
| Terminal-Bench 4.0 (Opus на xhigh) | 66,4 % | 37,3 % |
| FrontierCode v1.1 | 54,4 % | 47,5 % |
| CursorBench 4.0 | 57,8 % | 41,7 % |
| GDPval-AA v2.1 | 1846 | 1588 |
| AutomationBench (прогон Zapier) | 40,0 % | 28,8 % |
В таблице OpenAI для GPT-5.6 Sol другие строки и версии: Terminal-Bench 2.1 — 88,8 %, SWE-Bench Pro — 64,6 %, OSWorld 2.0 — 62,6 %, BrowseComp — 90,4 %. Terminal-Bench и GDPval-AA есть в обеих таблицах, но в разных версиях. Полностью совпадает только AutomationBench, и там у одного и того же GPT-5.6 Sol разные цифры: 28,8 % в таблице Anthropic (прогон Zapier) и 18,1 % в таблице OpenAI. Какой прогон верен, отсюда не следует: обвязка агента, даты и настройки effort у них могут отличаться. Но следует другое: цифры из двух таблиц нельзя ставить в один столбец.
Из вендорских таблиц можно вынести только то, на каких задачах каждая компания считает свою модель сильной. Единый сравнительный замер из доступных — индекс Artificial Analysis, где Opus 5.5 выше на обоих уровнях рассуждений (51 против 42 и 58 против 47). Это веский довод в пользу Opus 5.5 для сложных задач, но не гарантия, что на вашем коде разница будет такой же.
Если вы уже на GPT-5.6 Sol
Выход GPT-6 Sol меняет вопрос. Раньше он звучал как «Sol или Opus», теперь для многих — «остаться на GPT-5.6 Sol, перейти на GPT-6 Sol или на Opus 5.5».
- Цена. GPT-6 Sol стоит $2/$10, вдвое дешевле нынешней промо-цены GPT-5.6 Sol, и на длинных запросах тоже: $4/$15 против $8/$30. В журнале изменений OpenAI от 22 сентября 2026 года прямо сказано, что GPT-6 Sol и Luna выходят «по более низким ценам за токен, чем их предшественники GPT-5.6».
- Сроки. Даты отключения GPT-5.6 Sol в документации OpenAI нет, как нет и цены после 21 ноября 2026 года. Оставаться на нём можно, но бюджет на конец года лучше считать с запасом.
- Качество. Первичных сравнительных цифр GPT-6 Sol против GPT-5.6 Sol в открытой документации нет. У GPT-6 Sol те же уровни effort и те же эндпоинты, что у GPT-5.6 Sol, поэтому проверить его проще всего, но проверка на ваших задачах всё равно нужна.
- Переход на Opus 5.5 оправдан, если качество GPT-5.6 Sol на сложных агентных задачах вас не устраивало или у вас много запросов больше 272K. Учтите, что код, написанный под Opus 5, может сломаться при простой замене ID: мышление нельзя отключить, а принудительный выбор инструмента возвращает ошибку. Список изменений — в статье «Claude Opus 5.5: сколько стоит API и что проверить при переходе с Opus 5».
Общая картина моделей OpenAI для текста собрана в статье «Модели OpenAI для текста в 2026 году: GPT-5.6 Sol, Terra и Luna», а выбор внутри линейки Anthropic — в «Opus 5.5 или Fable 5.1: какую модель Claude выбрать для API».
Как проверить на своих задачах
Итоговую метрику лучше считать как стоимость одного принятого результата: всё потраченное на серию задач, включая повторы, делённое на число ответов, которые прошли вашу проверку.
- Соберите набор реальных задач. Возьмите несколько десятков запросов из вашего потока в тех пропорциях, в которых они встречаются: короткие, длинные, с кешем. Критерий «принято / не принято» зафиксируйте заранее — тесты, ревью, сверка с эталоном.
- Запустите три модели.
claude-opus-5-5,gpt-5.6-solиgpt-6-solна одних и тех же задачах. Уровень effort запишите для каждой: у Opus 5.5 и у моделей OpenAI по умолчанию этоmedium, но в сравнении Artificial Analysis GPT-5.6 Sol работал наhigh. - Сохраните счётчики токенов из ответа API. Новый ввод, чтение кеша, запись в кеш и вывод вместе с рассуждениями. Для OpenAI отметьте, был ли ввод больше 272K.
- Посчитайте стоимость по ценам из таблицы выше и разделите сумму на число принятых ответов. Отдельно смотрите задержку, если модель отвечает пользователю в реальном времени.
Для подсчёта хватит короткой функции. Цены в ней — на 24 сентября 2026 года. Предполагается, что в порог 272K входят все входные токены, включая кешированные, — сверьте это со своим счётом.
PRICES = {  # долларов за 1 млн токенов: ввод, чтение кеша, запись в кеш, вывод
    "claude-opus-5-5": {"short": (4, 0.20, 5, 20), "long": None},  # запись в кеш на 5 минут
    "gpt-5.6-sol": {"short": (4, 0.40, 5, 20), "long": (8, 0.80, 10, 30)},  # промо-цена
    "gpt-6-sol": {"short": (2, 0.20, 2.50, 10), "long": (4, 0.40, 5, 15)},
}

def request_cost(model, fresh_in, cache_read, cache_write, output):
    p = PRICES[model]
    total_in = fresh_in + cache_read + cache_write
    rates = p["long"] if p["long"] and total_in > 272_000 else p["short"]
    tokens = (fresh_in, cache_read, cache_write, output)
    return sum(t * r for t, r in zip(tokens, rates)) / 1_000_000

def cost_per_accepted(runs):
    """runs: список словарей с полями model, fresh_in, cache_read, cache_write, output, accepted"""
    total = sum(request_cost(r["model"], r["fresh_in"], r["cache_read"],
                             r["cache_write"], r["output"]) for r in runs)
    accepted = sum(1 for r in runs if r["accepted"])
    return total / accepted if accepted else float("inf")

print(request_cost("gpt-5.6-sol", 300_000, 0, 0, 20_000))    # 3.0
print(request_cost("claude-opus-5-5", 300_000, 0, 0, 20_000))  # 1.6
Результаты считайте отдельно для каждой модели. Если GPT-6 Sol проходит проверку так же часто, как GPT-5.6 Sol, и тратит сопоставимое число токенов, переход сразу снижает расходы. Если Opus 5.5 даёт заметно больше принятых решений на сложных задачах, его более длинный вывод может оправдать себя.
Частые вопросы
Какая модель дешевле для длинных документов?
Если ввод больше 272K токенов, Opus 5.5 дешевле GPT-5.6 Sol: у Anthropic нет надбавки за длинный контекст, а OpenAI считает такой запрос целиком по $8 за ввод и $30 за вывод. В примере с 300K ввода и 20K вывода это $1,60 против $3,00. GPT-6 Sol на том же примере стоит $1,50, то есть примерно как Opus 5.5. До 272K ставки Opus 5.5 и GPT-5.6 Sol одинаковы.
GPT-5.6 Sol стоит $5/$30 или $4/$20?
Сейчас $4 за ввод и $20 за вывод — это промо-цена, действующая «как минимум до 21 ноября 2026 года». $5/$30 — цена запуска 9 июля 2026 года. Цену после промо OpenAI не назвала, поэтому $5/$30 в роли текущей цены — устаревшие данные, но и возврат к этой цене не гарантирован.
Можно ли выбрать модель по таблицам бенчмарков?
Только в самом общем виде. Таблицы Anthropic и OpenAI почти не пересекаются по тестам, а на единственном тесте, который есть в обеих в одной версии, у GPT-5.6 Sol разные результаты. Независимый индекс Artificial Analysis ставит Opus 5.5 выше, но это один оценщик. Надёжнее небольшой тест на ваших задачах.