Если вы выбираете между Claude Opus 5.5 и Fable 5.1 для прямого API, начните с Opus 5.5. При одинаковом количестве токенов она дешевле Fable во всех категориях стандартного тарифа, включая чтение из кэша. Переход на Fable оправдан, когда на ваших сложных задачах она чаще достигает заданного результата или требует меньше повторов и доработки настолько, что окупает более высокую цену токенов. Это выбор по стоимости принятой задачи, а не по одному столбцу прайс-листа.
Прежде чем менять модель, поменяйте effort. Руководство Anthropic по выбору модели называет настройку effort часто более действенным рычагом, чем смену модели, и предлагает переходить к Fable 5.1, только если Opus 5.5 на уровнях xhigh или max всё ещё не дотягивает. Повседневную разработку и агентские задачи по той же схеме закрывает Sonnet 5.5, массовые простые операции — Haiku 5.5. Это рекомендации производителя, а не гарантия для вашей нагрузки.
По состоянию на 8 октября 2026 года текущая линейка Claude — Fable 5.1, Opus 5.5, Sonnet 5.5 (вышла 28 сентября) и Haiku 5.5 (вышла 7 октября). Sonnet 5 и Haiku 4.5 переведены в устаревшие модели: в API они пока доступны, но текущими уже не считаются.
Сколько стоят Opus 5.5 и Fable 5.1 в Claude API
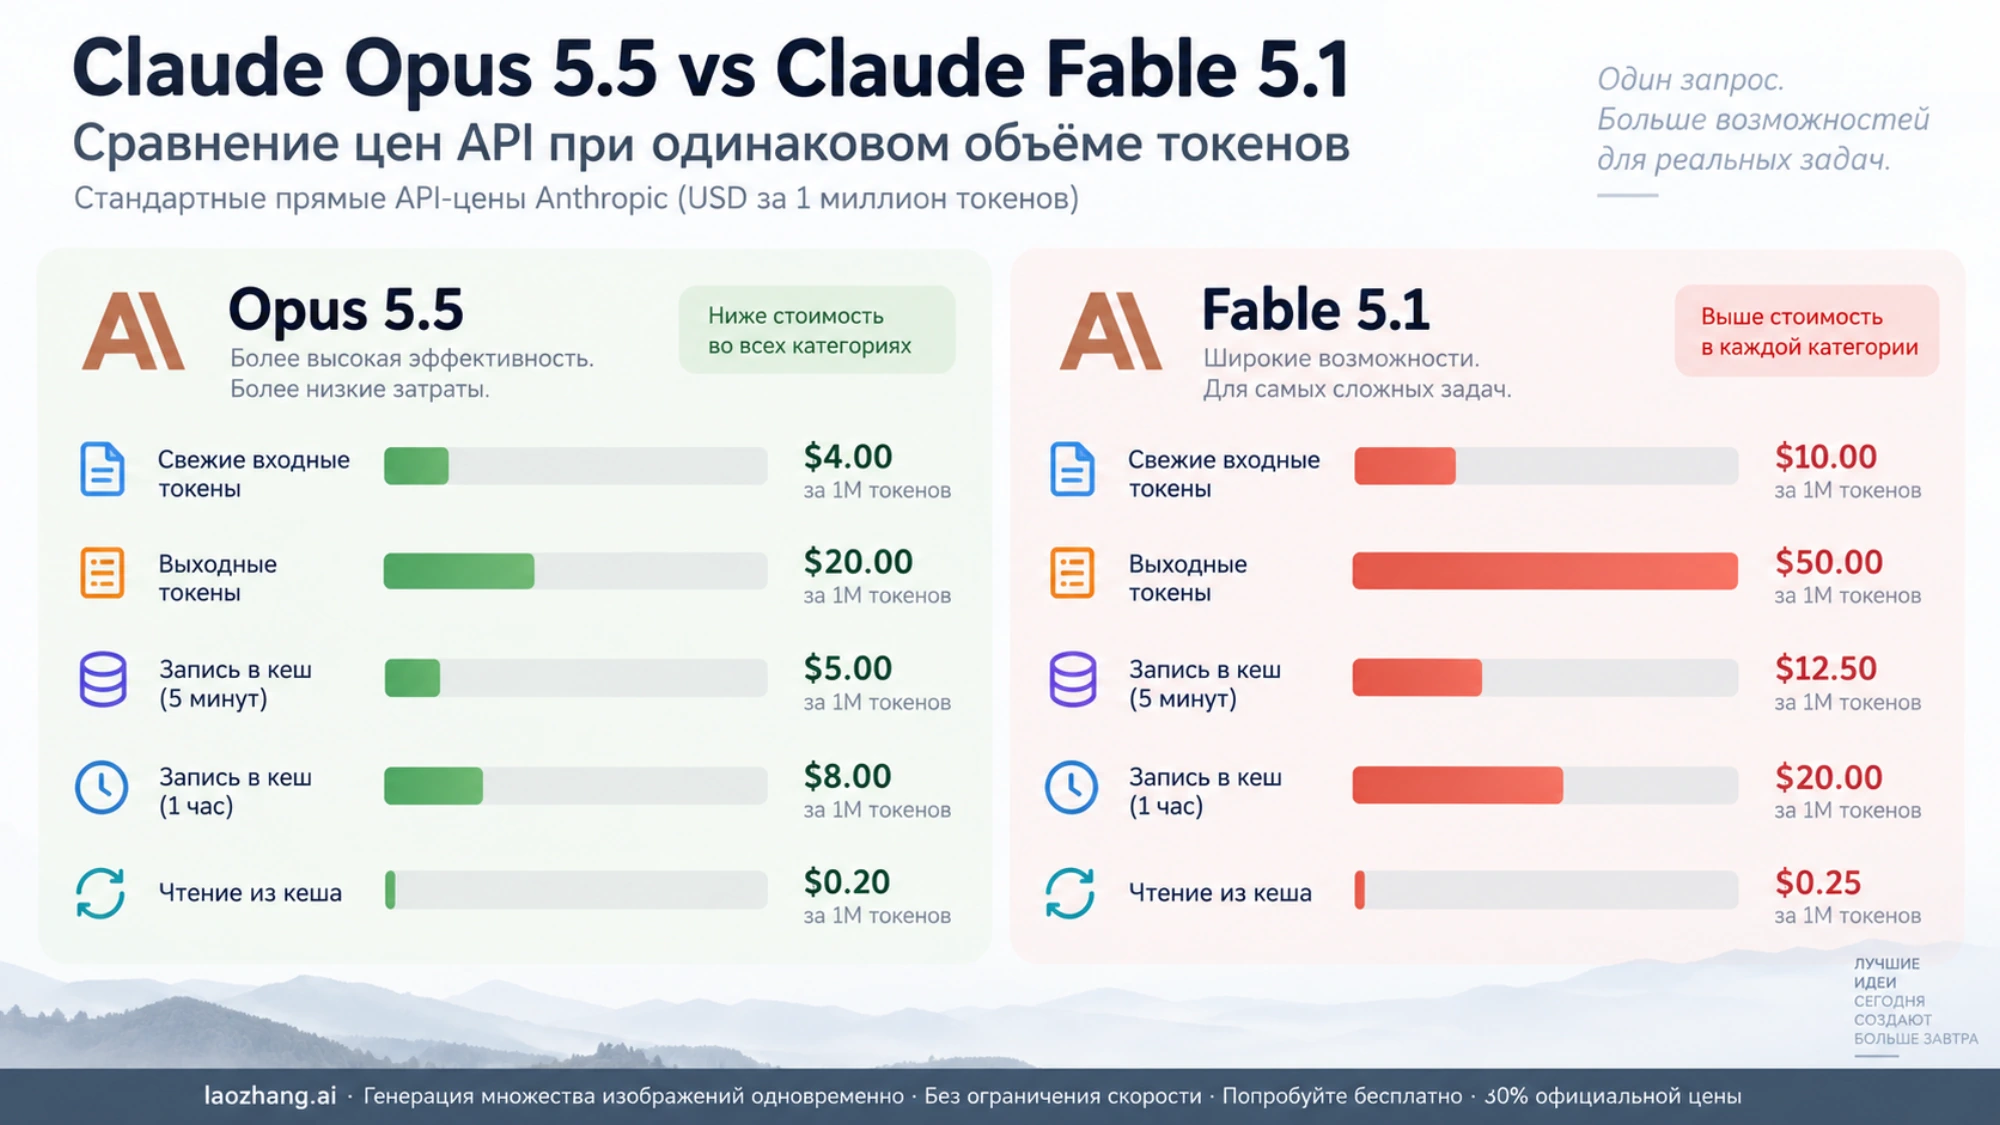
По текущему прайс-листу Anthropic стандартные ставки прямого API в долларах за миллион токенов таковы:
| Категория токенов | Opus 5.5 | Fable 5.1 |
|---|---|---|
| Новый ввод | $4 | $10 |
| Вывод | $20 | $50 |
| Запись в кэш на 5 минут | $5 | $12,50 |
| Запись в кэш на 1 час | $8 | $20 |
| Чтение из кэша | $0,20 | $0,25 |
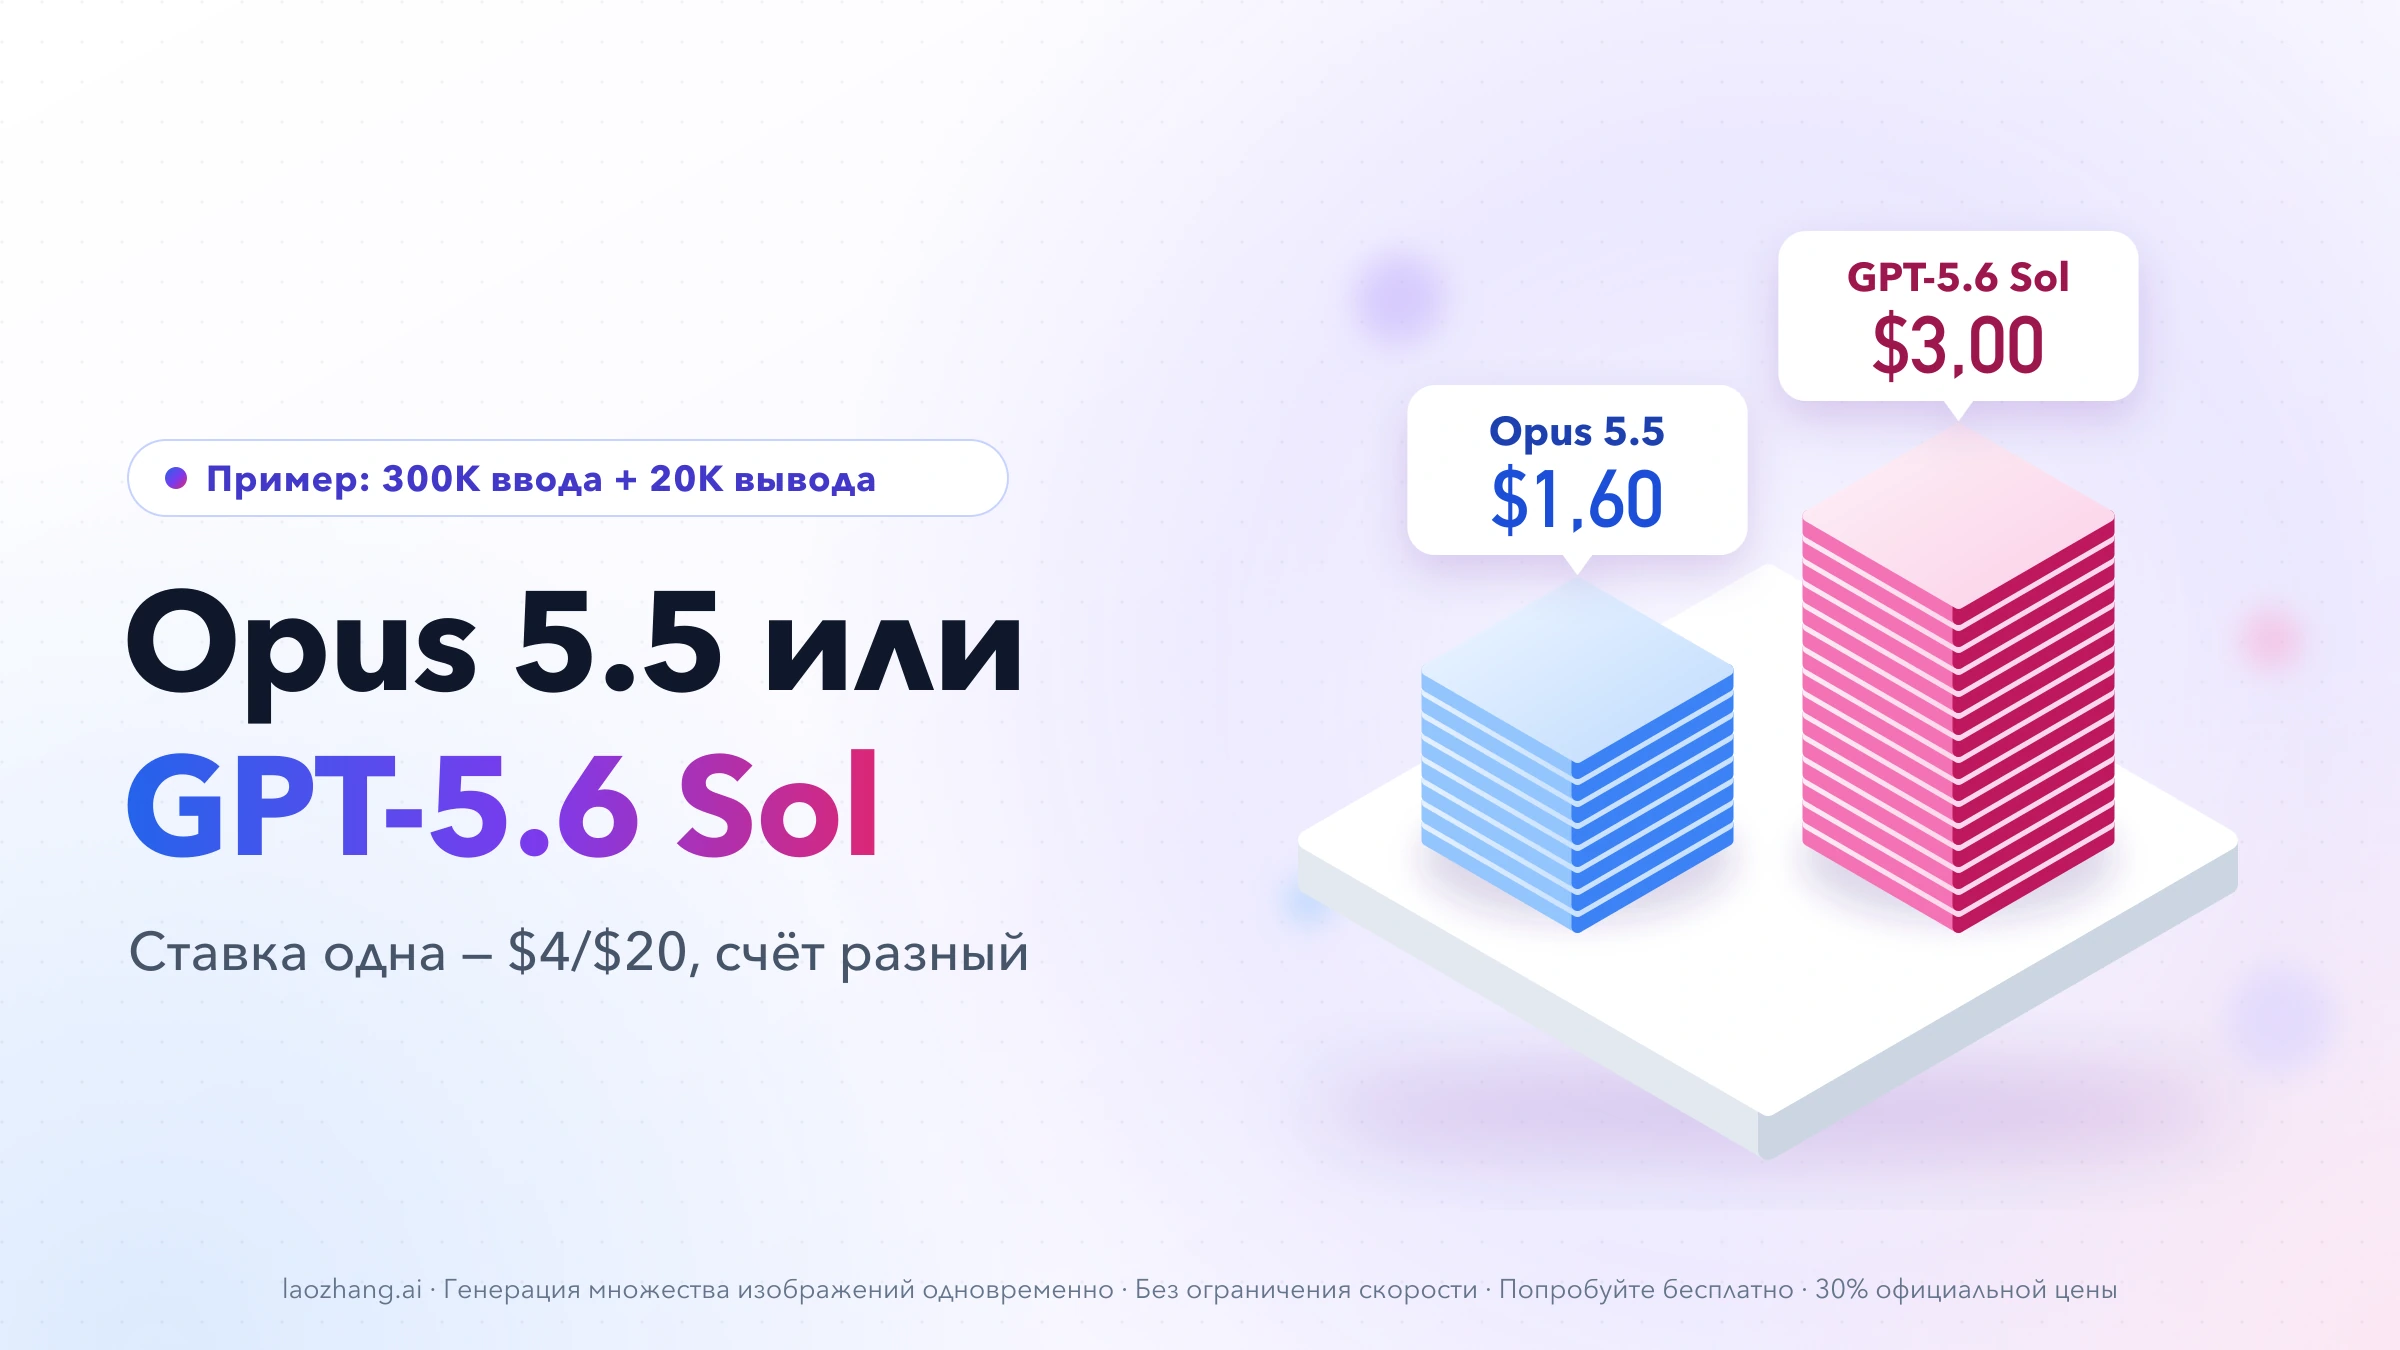
В отличие от старой пары Opus 5 и Fable 5.1, здесь нет порога, после которого одна только доля чтений из кэша делает Fable дешевле. Если обе модели получили одинаковые объёмы каждого типа токенов, Opus 5.5 стоит меньше при любой их комбинации: ввод и вывод у Fable дороже в 2,5 раза, чтение из кэша — в 1,25 раза. Это вывод из тарифов, а не измерение работы моделей: число ходов, длина ответа и доля попаданий в кэш у них могут различаться.
Например, одна попытка с 30 тыс. токенов нового ввода, 60 тыс. токенов чтения из кэша и 5 тыс. токенов вывода без новых записей в кэш и других начислений стоит $0,232 на Opus 5.5: 0,03 × 4 + 0,06 × 0,20 + 0,005 × 20. На Fable 5.1 — $0,565: 0,03 × 10 + 0,06 × 0,25 + 0,005 × 50, то есть примерно в 2,4 раза дороже. Это расчёт одного и того же набора токенов по официальным ставкам, а не прогноз счёта за реальное задание.
Цены относятся к стандартному прямому API, а не к подписке Claude, оплате в рублях или тарифу облачного партнёра. В подписке модели расходуют общие лимиты, и правила там другие — об этом статья «Claude Pro и Max: что меняется в лимитах и почему лимиты остаются на Max». Batch и Fast имеют отдельные ставки; налоги, инструменты и другие условия также меняют итоговый счёт. Перед расчётом проверьте именно тот способ доступа, которым будете пользоваться.
Когда более дорогая Fable может оказаться выгоднее
Цена вызова и стоимость готовой работы расходятся, когда модели по-разному решают задачу. Если Fable заканчивает сложное расследование за один проход, а Opus требует нескольких запусков и ручного исправления, более дорогие токены Fable могут обойтись дешевле в пересчёте на принятый результат. Обратное тоже возможно. Без сопоставимых запусков на ваших задачах ни одна модель не получает такого преимущества автоматически.
Порог легко прикинуть на примере выше. Если попытка расходует одинаковые токены на обеих моделях, две попытки Opus 5.5 стоят $0,464 и всё ещё дешевле одной попытки Fable 5.1 за $0,565, а три стоят $0,696 и уже дороже. При таких объёмах Fable окупается по токенам, только если Opus в среднем нужно больше 2,4 попытки там, где Fable справляется с первой (0,565 / 0,232 ≈ 2,4). На деле модели тратят на попытку разное число токенов, поэтому порог считайте по своим логам, а время человека на проверку прибавляйте отдельно.
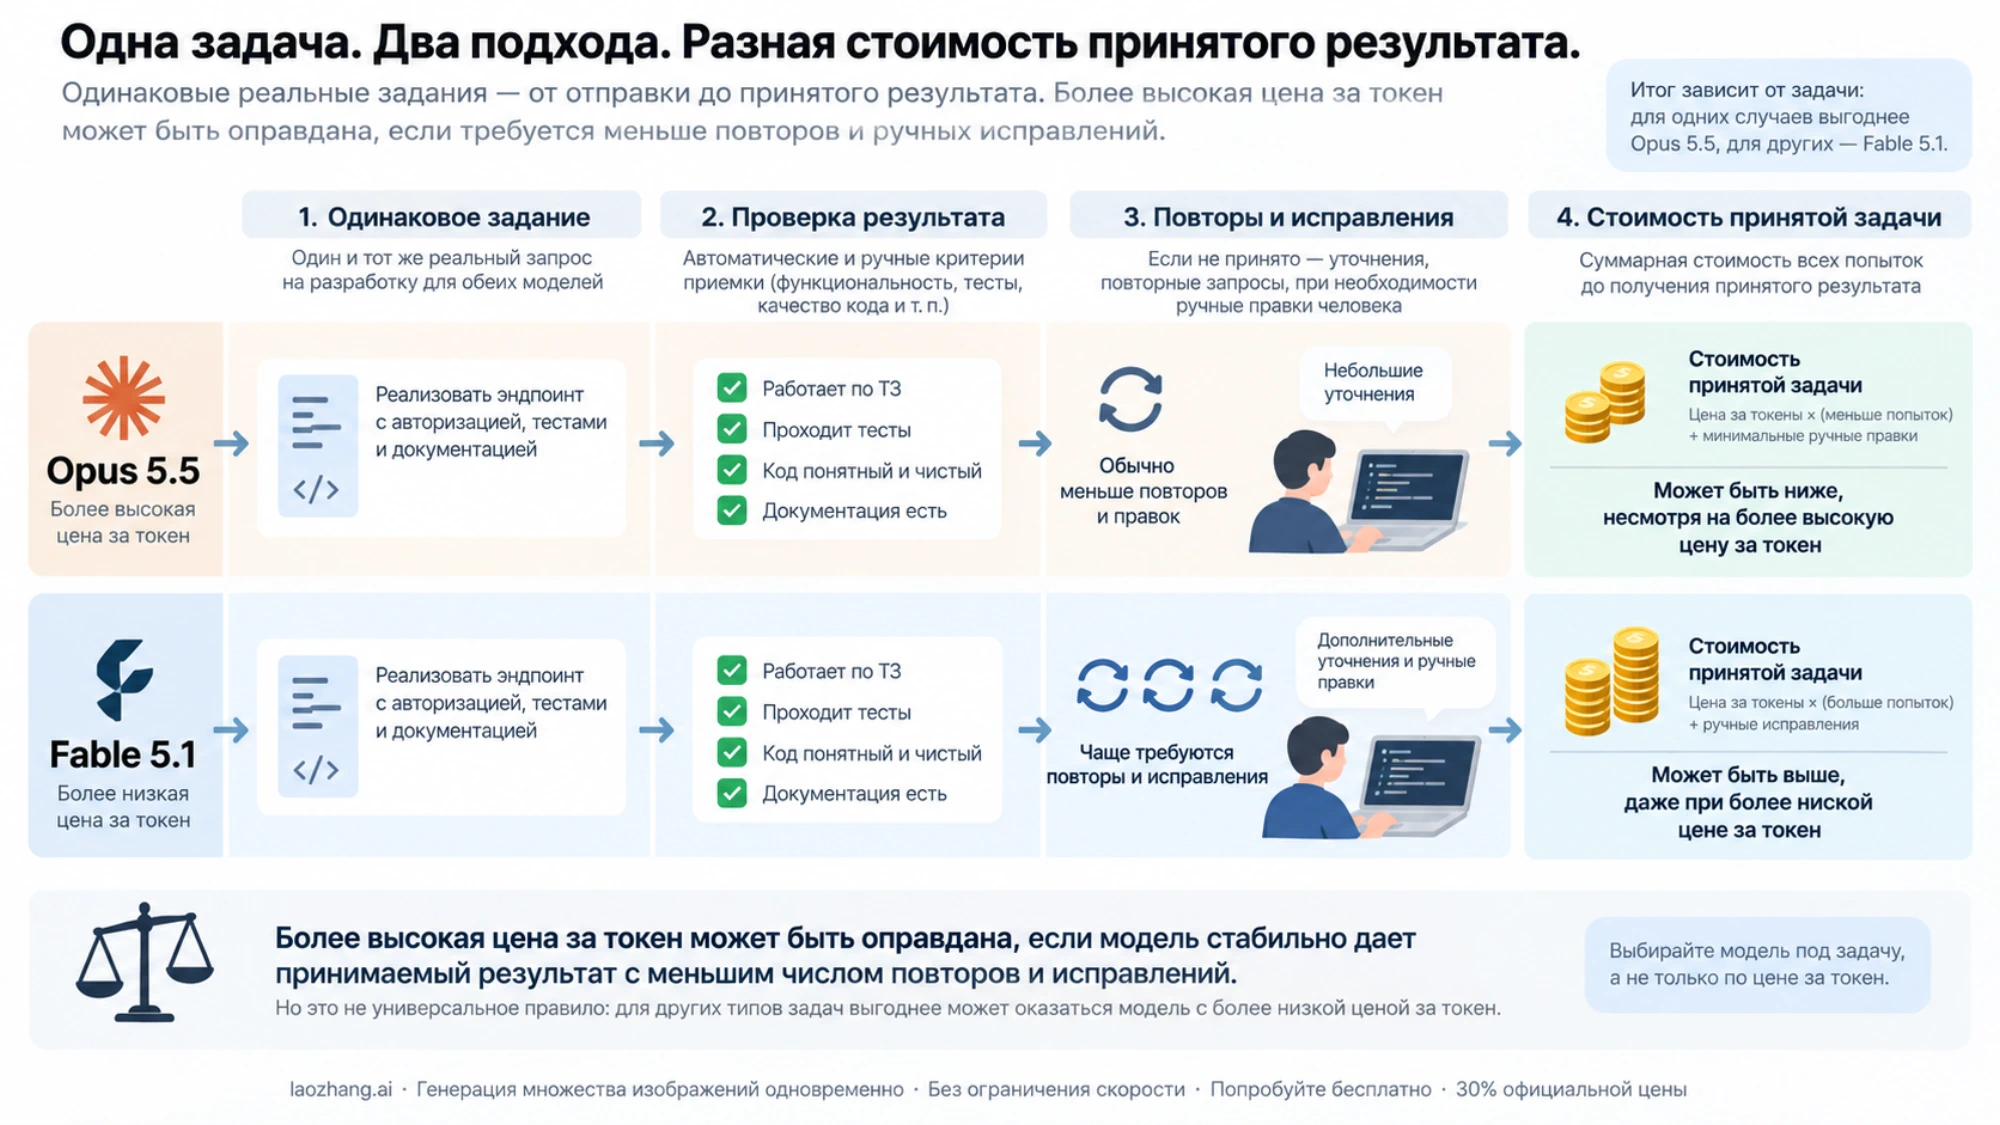
Соберите небольшой набор заданий с проверяемым результатом: тесты для кода, сверяемые ответы, корректные действия инструмента. Зафиксируйте одинаковые входные данные, доступные инструменты, критерий приёмки и правило остановки. Затем для каждой модели запишите расход токенов по категориям, число попыток, время до принятого результата и время человека на проверку и исправление. Сравнивайте не только общую сумму, но и стоимость на одну принятую задачу; проваленные и повторные попытки тоже входят в затраты.
Такой тест особенно нужен для длинных агентских сценариев. Кэш может снизить цену повторного чтения контекста, но тарифная таблица не говорит, сколько токенов каждая модель фактически прочитает и сколько работы завершит. Старое сравнение с Opus 5, где у Fable чтение кэша стоило дешевле, к Opus 5.5 переносить нельзя.
Что говорят оценки Anthropic — и чего они не доказывают
В анонсе Opus 5.5 Anthropic сообщает, что модель достигает уровня Fable 5.1 на большинстве видов работы. В приведённых компанией оценках Opus 5.5 набрала 66,4 против 55,8 у Fable 5.1 на Terminal-Bench 4.0 и 57,8 против 51,8 на CursorBench 4.0. Это результаты производителя на указанных наборах и настройках, а не независимая проверка и не обещание такого же разрыва в вашем продукте.
Для чтения этих чисел важны условия: результаты Opus 5.5 в анонсе получены при max effort, если не указано иное, а Terminal-Bench — при xhigh. Между тем спецификации моделей задают для Opus 5.5 в API по умолчанию medium, а для Fable 5.1 — high. Сравнение верхних результатов теста нельзя выдавать за результат двух вызовов с настройками по умолчанию.
Anthropic также пишет о снижении типичной стоимости работы на 40% относительно Opus 5. Базой этого заявления служит предыдущая версия Opus, а не Fable 5.1. При выборе между двумя моделями выше используйте ставки текущего прайс-листа и результат собственной проверки.
Где теперь Sonnet 5.5 и Haiku 5.5: цены и задачи
Sonnet 5.5 Anthropic предлагает для повседневного программирования, агентов и рабочих задач, где нужны и скорость, и качество. Haiku 5.5 — самая быстрая и дешёвая модель линейки для классификации, извлечения данных, маршрутизации запросов и субагентов. Все четыре текущие модели имеют окно контекста 1 млн токенов и до 128 тыс. токенов ответа (обзор моделей).
| Модель | Ввод | Чтение из кэша | Вывод | effort по умолчанию | Назначение по Anthropic |
|---|---|---|---|---|---|
| Fable 5.1 | $10 | $0,25 | $50 | high | самые трудные рассуждения и долгая агентская работа |
| Opus 5.5 | $4 | $0,20 | $20 | medium | сложное агентское программирование; старт для большинства нагрузок |
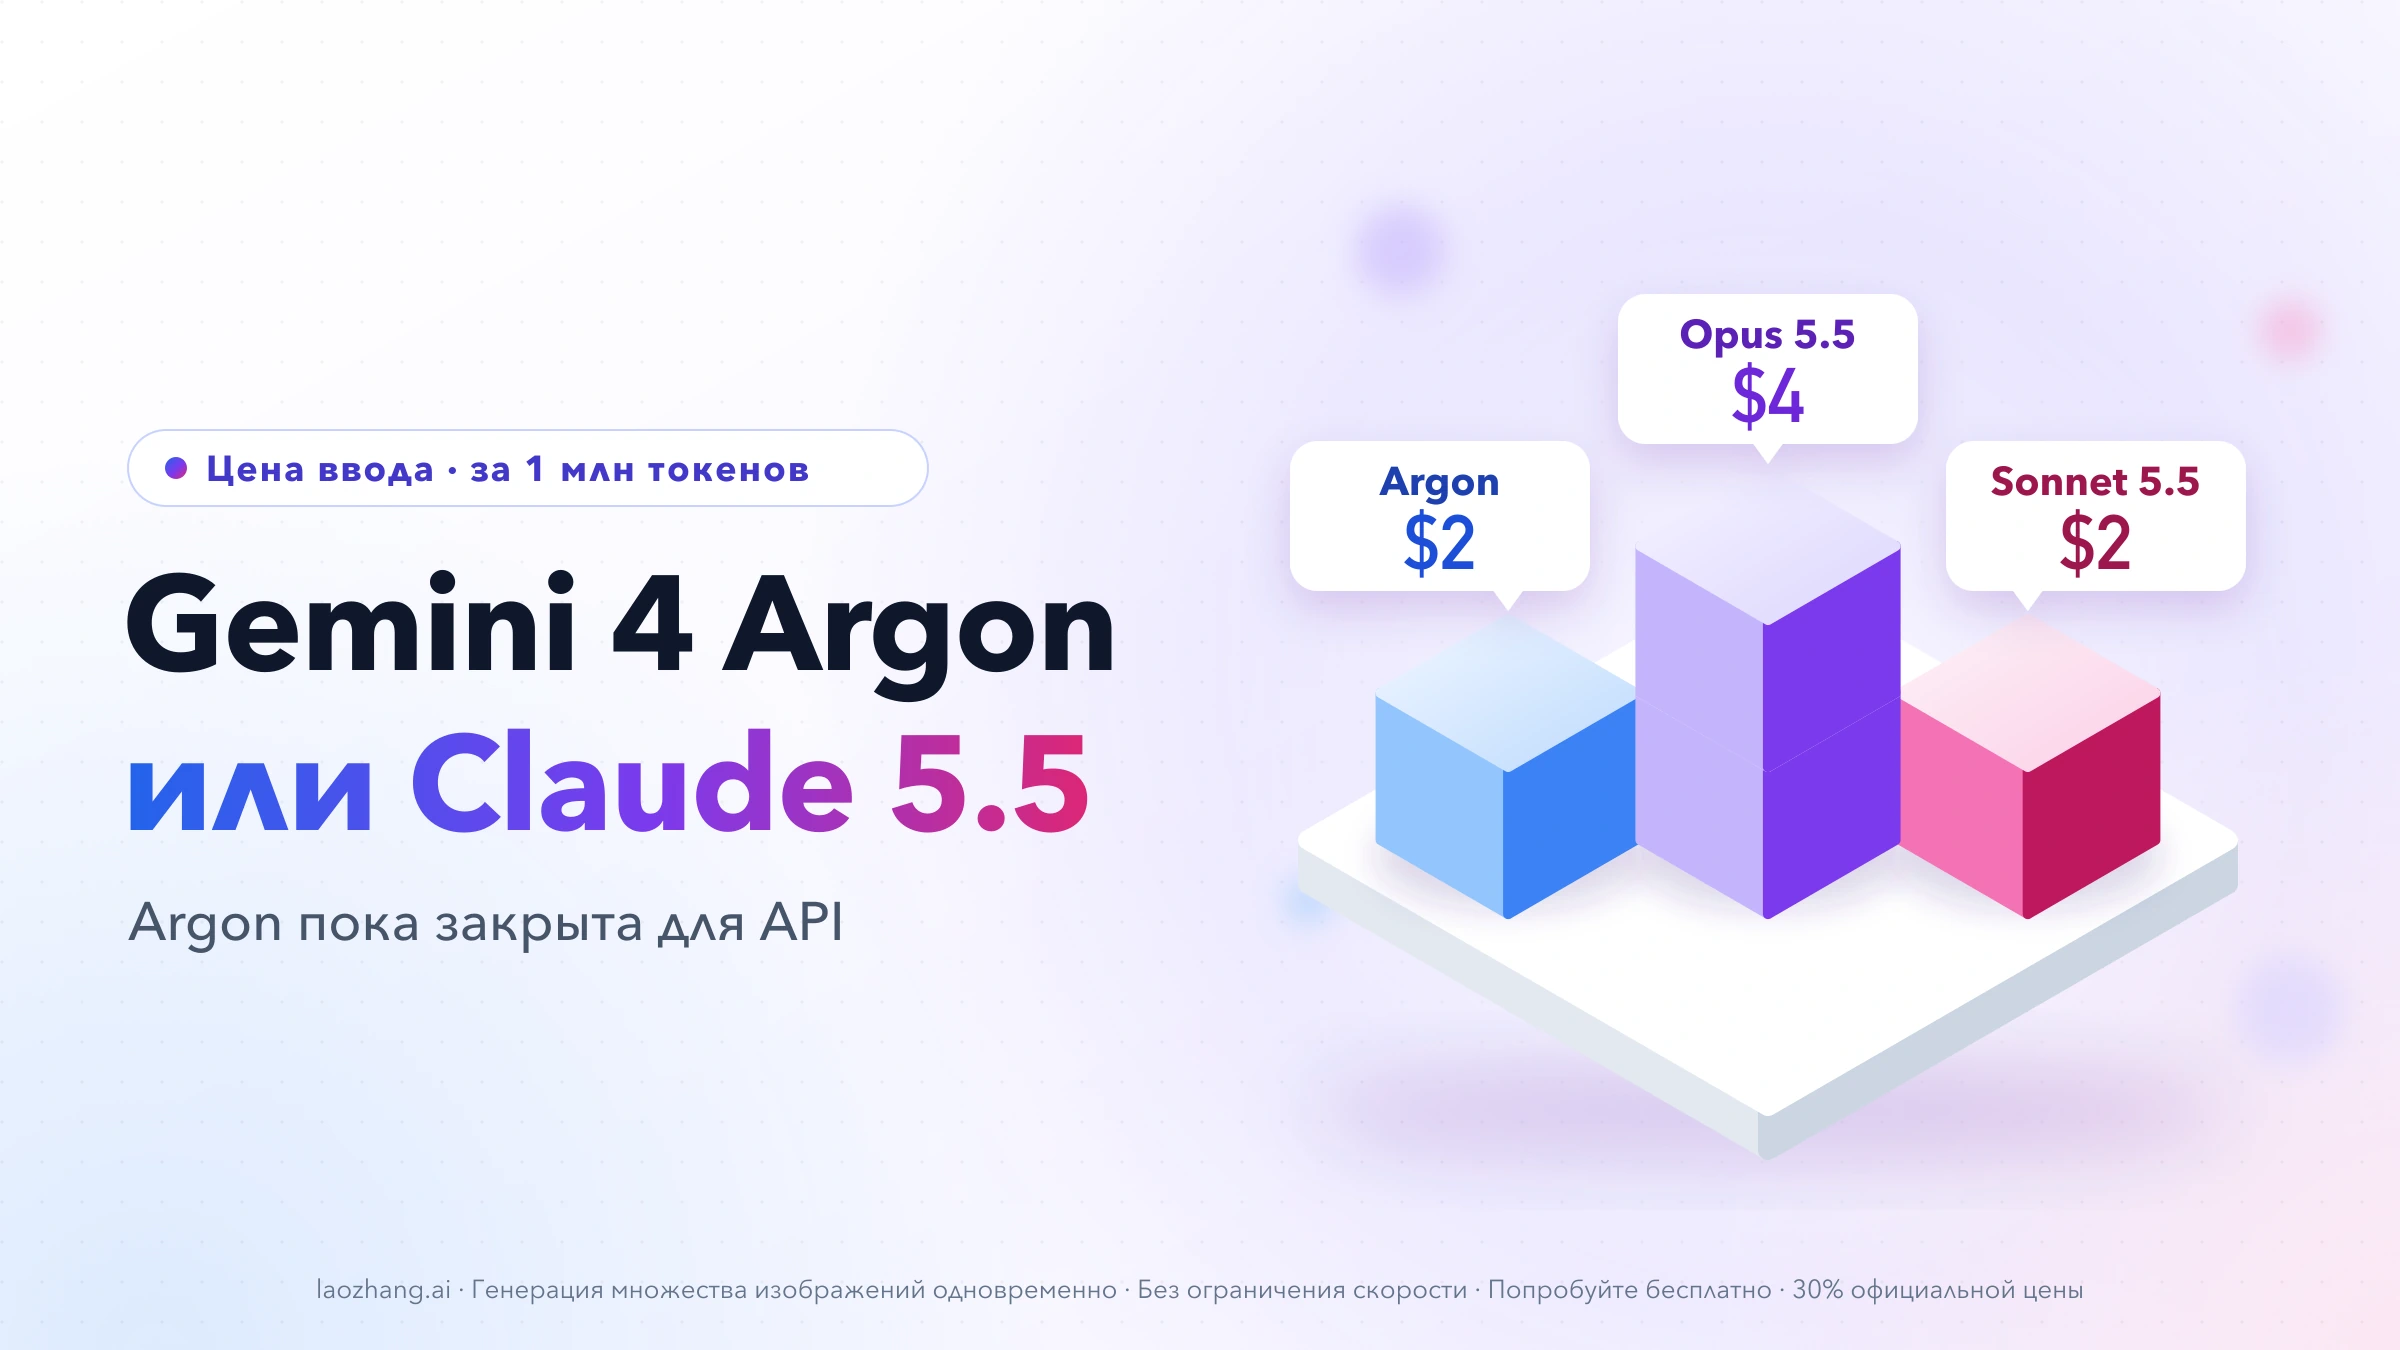
| Sonnet 5.5 | $2 | $0,10 | $10 | high | повседневный код, агенты, рабочие задачи |
| Haiku 5.5, промпт до 100 000 токенов | $0,10 | $0,01 | $0,50 | medium | массовые задачи с жёсткими требованиями к задержке |
| Haiku 5.5, промпт больше 100 000 токенов | $0,50 | $0,05 | $2,50 | medium | то же, но все ставки ×5 |
Цены — стандартный прямой API, доллары за миллион токенов, по прайс-листу Anthropic на 8 октября 2026 года. Учитываются ли прочитанные из кэша токены в пороге 100 000 у Haiku 5.5, в документации не сказано.
Тот же набор токенов на всех четырёх моделях выглядит так. Попытка — 30 тыс. нового ввода, 60 тыс. чтения из кэша и 5 тыс. вывода; промпт 90 тыс. токенов, поэтому Haiku остаётся на нижнем тарифе. Агентский цикл — 20 ходов, каждый перечитывает закэшированный префикс в 80 тыс. токенов (всего 1,6 млн токенов чтения), плюс 50 тыс. нового ввода и 10 тыс. вывода; первая запись в кэш не учитывается.
| Сценарий | Haiku 5.5 | Sonnet 5.5 | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|
| Одна попытка | $0,0061 | $0,116 | $0,232 | $0,565 |
| Агентский цикл из 20 ходов | $0,026 | $0,36 | $0,72 | $1,40 |
Для проверки цикла на Sonnet 5.5: 1,6 × 0,10 + 0,05 × 2 + 0,01 × 10 = $0,36. В первом сценарии Sonnet 5.5 дороже Haiku 5.5 примерно в 19 раз, Opus 5.5 дороже Sonnet 5.5 в 2 раза, Fable 5.1 дороже Opus 5.5 в 2,4 раза. Для сравнения, устаревшие модели на тех же объёмах: Sonnet 5 — $0,122 и $0,52, Haiku 4.5 — $0,061 и $0,26. Как и выше, это одинаковые токены для всех моделей, а не замер реальной работы.
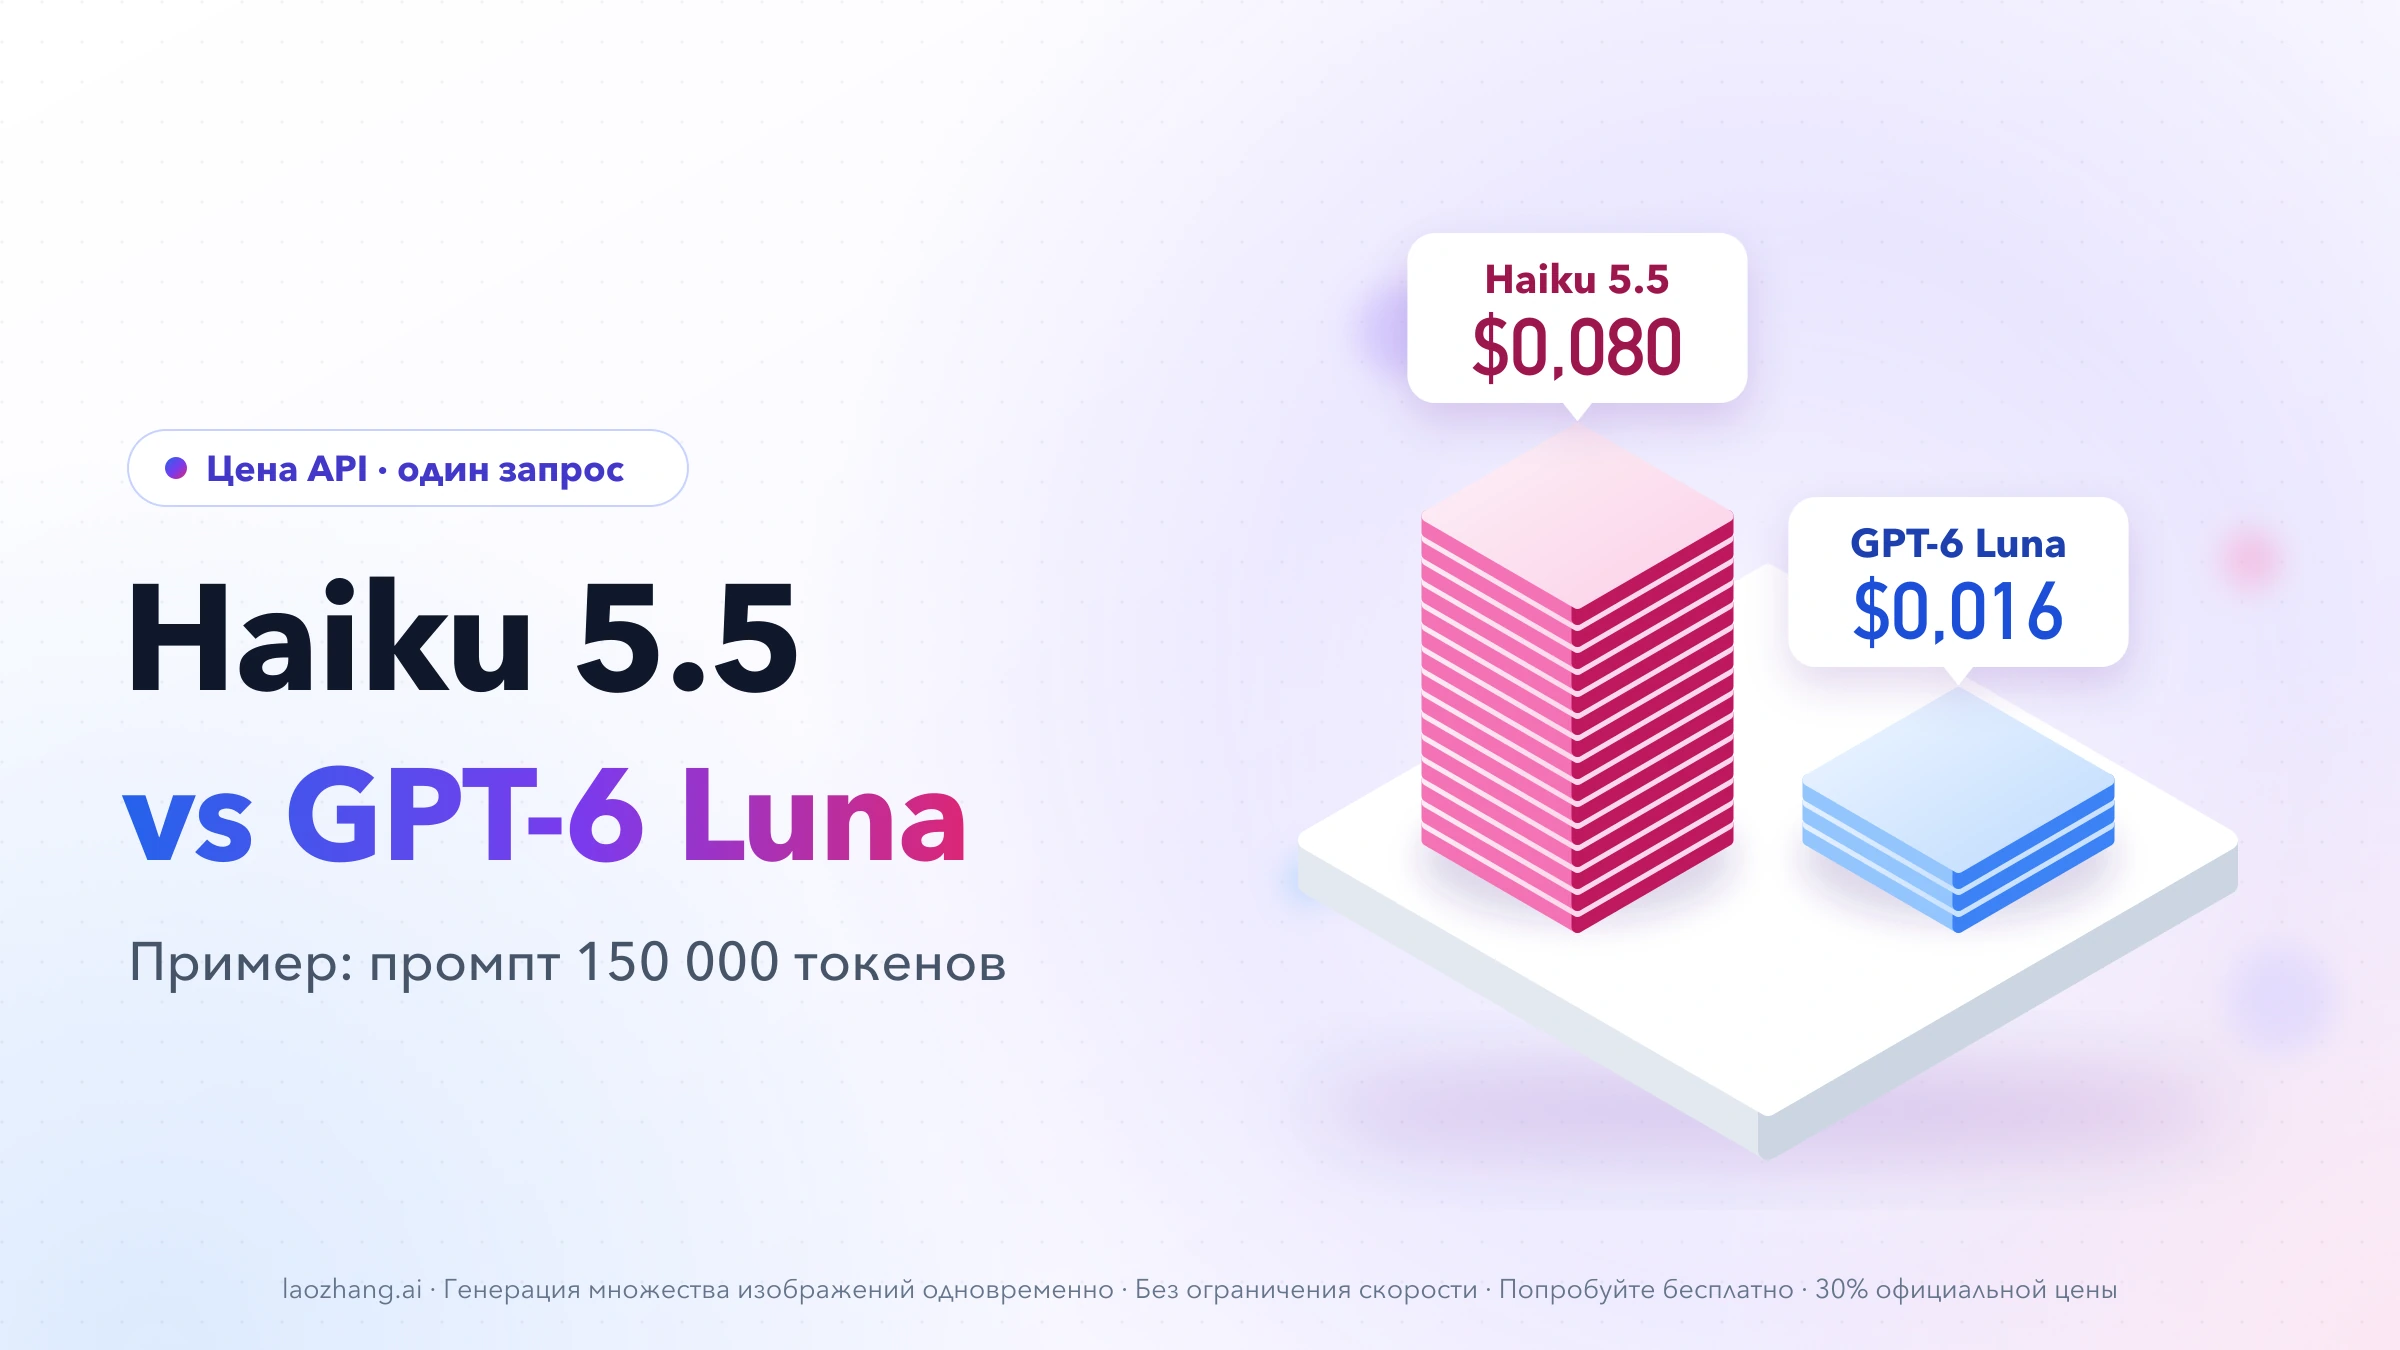
Преимущество Haiku 5.5 держится, пока промпт не превышает 100 000 токенов. Та же попытка с промптом в 150 тыс. токенов (90 тыс. нового ввода и 60 тыс. чтения из кэша) стоит на Haiku 5.5 уже $0,0605, на Sonnet 5.5 — $0,236, если считать, что чтения из кэша входят в порог. Как Haiku 5.5 выглядит на фоне OpenAI по обе стороны этого порога, разобрано в статье «Claude Haiku 5.5 vs GPT-6 Luna: цена API до и после 100K токенов».
Что изменилось по сравнению с устаревшими версиями:
- Sonnet 5.5 и Sonnet 5: ввод и вывод по-прежнему $2 и $10, но чтение из кэша подешевело вдвое — с $0,20 до $0,10. Уровни
effortу Sonnet 5.5 откалиброваны заново, поэтому настройки, подобранные на Sonnet 5, стоит перепроверить (описание Sonnet 5.5). - Haiku 5.5 и Haiku 4.5: по данным Anthropic цена ниже на 90% для промптов до 100 000 токенов и на 50% для более длинных. При этом новый токенизатор, общий теперь для всех четырёх текущих моделей, превращает тот же текст примерно на 30% больше токенов, чем у Haiku 4.5. Окно контекста выросло с 200 тыс. до 1 млн токенов, рассуждение (thinking) включено по умолчанию.
- Сроки: по таблице жизненного цикла моделей Haiku 4.5 выводится из эксплуатации не раньше 15 октября 2026 года; на 8 октября уведомления о прекращении поддержки нет. Точные даты отключения Sonnet 5 и Haiku 4.5 не опубликованы.
Anthropic описывает два способа начать. Если важнее экономия и задержка, начинайте с Haiku 5.5 и поднимайтесь на ступень выше только там, где не хватает качества. Если важнее возможности, начинайте с Opus 5.5, а затем снижайте effort или переводите часть задач на Sonnet 5.5 и Haiku 5.5. Не переносите весь поток на более дорогую модель из-за одного впечатляющего примера: выделите класс заданий, где разница воспроизводится, а остальные оставьте на подходящей более дешёвой модели.
Сначала effort, потом модель: с каких уровней начинать
Все четыре текущие модели поддерживают уровни low, medium, high, xhigh и max. Прежде чем переходить на ступень выше, пройдите уровни текущей модели и сравните стоимость принятой задачи на каждом. Токены рассуждения оплачиваются как вывод, поэтому более высокий effort обычно увеличивает выходную часть счёта. Стартовые точки по документации об effort:
- Haiku 5.5: начинайте с
medium, в том числе для агентского программирования.lowподходит для чата, коротких задач с инструментами и простых массовых запросов, но на нём модель может пропустить поиск или рано остановиться в длинном агентском промпте.high— для работы со знаниями, длинных агентских задач и строгого следования инструкциям. Если доходите доxhighилиmax, сравните результат с Sonnet 5.5. - Sonnet 5.5: по умолчанию
high; для агентского программирования начинайте сmedium, для чата —mediumилиlow. - Opus 5.5: по умолчанию
medium, отключить рассуждение нельзя. Прежде чем пробовать Fable, проверьтеhigh,xhighиmax. - Fable 5.1: начинайте с
high.
Если запрос пришёл без параметра effort, модель работает на уровне по умолчанию. Поэтому сравнивайте модели с явно заданными уровнями, иначе Opus 5.5 на medium будет соревноваться с Fable 5.1 на high.
Что проверить перед переключением model ID
В прямом API модели называются claude-fable-5-1, claude-opus-5-5, claude-sonnet-5-5 и claude-haiku-5-5. Окно контекста 1 млн токенов и стандартный максимум ответа 128 тыс. токенов — это пределы моделей, а не бесплатный объём или одинаковая цена длинного запроса: у Haiku 5.5 промпт длиннее 100 000 токенов стоит впятеро дороже.
Для существующего агента замены одного ID недостаточно. Проверьте effort, max_tokens, обработку thinking blocks, выбор инструментов, попадания в кэш и собственный сценарий отката. Основные ловушки при переходе:
- Opus 5.5: есть особенности thinking и tool choice, которые могут повлиять на прежний код.
- Sonnet 5.5 после Sonnet 5: вместо отключённого рассуждения используется минимальный режим
between_tools, принудительный вызов инструмента возвращает ошибку 400, а thinking blocks привязаны к модели и диалогу. - Haiku 5.5 после Haiku 4.5: нестандартные значения
temperature,top_pиtop_k, а также prefill возвращают ошибку 400. Число токенов пересчитайте сclaude-haiku-5-5, а не переносите замеры с Haiku 4.5.
В Claude Code псевдонимы моделей уже указывают на новую линейку: opus и default — Opus 5.5, sonnet — Sonnet 5.5, haiku — Haiku 5.5, fable — Fable 5.1. Практические детали по двум старшим моделям — в статьях «Claude Opus 5.5: сколько стоит API и что проверить при переходе с Opus 5» и «Claude Fable 5.1: цена API, изменения и миграция».
Итак: для сложной новой задачи сначала берите Opus 5.5, измеряйте принятый результат и повышайте effort при необходимости. Fable 5.1 оставляйте там, где она убедительно выигрывает по качеству или полной стоимости работы. Повседневный поток проверьте на Sonnet 5.5, массовые простые операции — на Haiku 5.5 с промптами до 100 000 токенов.
Fable, Opus, Sonnet и Haiku: короткие ответы
Чем Fable 5.1 отличается от Opus 5.5?
Fable 5.1 — самая мощная модель линейки для трудных рассуждений и долгой агентской работы, но её ввод и вывод в 2,5 раза дороже, а ответы медленнее. Opus 5.5, по заявлению Anthropic, на большинстве задач работает на уровне Fable 5.1 и рекомендована как стартовая модель. Fable стоит пробовать, когда Opus не справляется даже на xhigh или max.
Какая модель мощнее, Opus 5.5 или Sonnet 5.5?
Opus 5.5 рассчитана на более сложные агентские и инженерные задачи, Sonnet 5.5 быстрее и вдвое дешевле за ввод и вывод. Для обычной разработки и агентов Anthropic предлагает Sonnet 5.5; на Opus 5.5 переходите, когда Sonnet на ваших задачах не проходит проверку качества.
Какая последняя модель Opus?
На 8 октября 2026 года это Opus 5.5 (claude-opus-5-5). Opus 5 и более ранние версии числятся устаревшими, но пока доступны.
Работают ли ещё Sonnet 5 и Haiku 4.5?
Да, обе модели доступны в API как устаревшие. Для Haiku 4.5 опубликована нижняя граница вывода из эксплуатации — не раньше 15 октября 2026 года; для новых проектов разумнее сразу брать Sonnet 5.5 и Haiku 5.5 и заново измерить расход токенов.