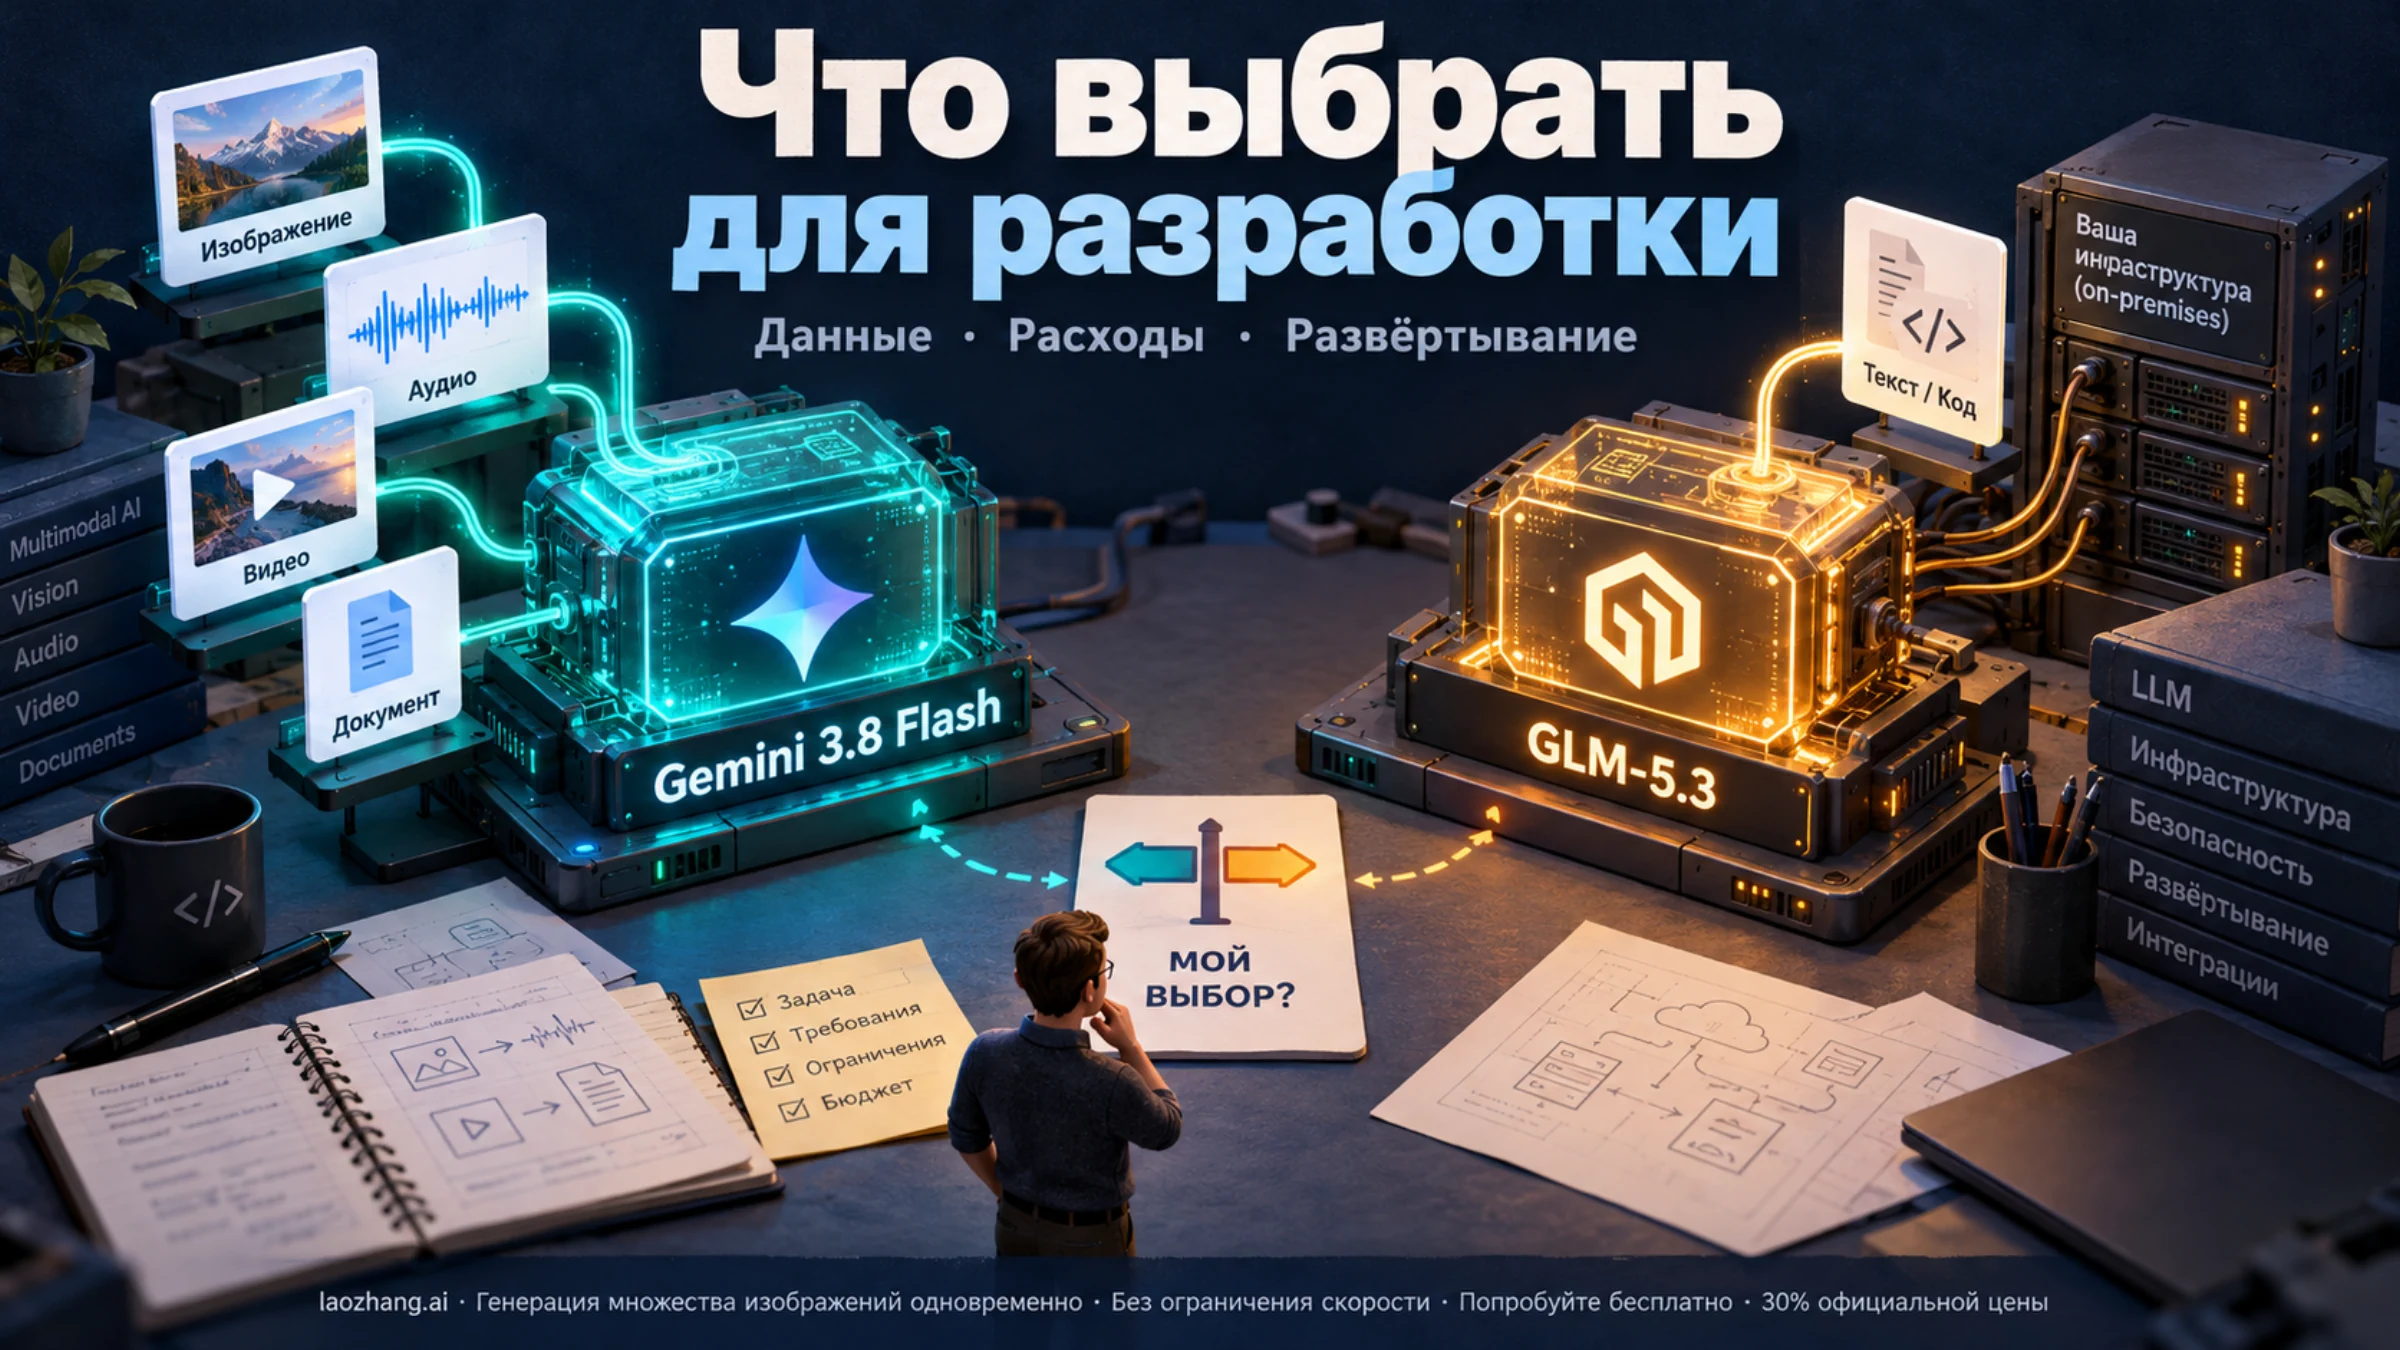
Gemini 3.8 Flash стоит пробовать первым, если приложению нужны разные виды входных данных или низкая текущая цена токенов. GLM-5.3 имеет смысл включить в испытания для сложных текстовых задач, программирования и собственного развёртывания. Его преимущество в одном внешнем тесте не гарантирует преимущество на вашем проекте; зато открытые веса и более высокий предел вывода — конкретные различия, которые можно учесть ещё до эксперимента.
Здесь сравниваются точные модели gemini-3.8-flash и glm-5.3. GLM-5.3-Flash — другая модель: её тарифы, скорость и требования к оборудованию к этому сравнению не относятся. Характеристики и цены ниже проверены 28 октября 2026 года. Собственных API-испытаний мы не проводили; результаты производительности приведены с указанием внешнего источника и настроек.
Сначала определите, какие данные получит модель
Если приложение должно разбирать скриншоты, записи встреч, видео или PDF без отдельного этапа извлечения текста, из этой пары подходит Gemini 3.8 Flash. GLM-5.3 принимает только текст. Для него распознавание речи, OCR или описание изображения придётся выполнять отдельно, а затем передавать результат в текстовом виде. Это меняет и архитектуру, и итоговую стоимость обработки.
| Что важно приложению | Gemini 3.8 Flash | GLM-5.3 |
|---|---|---|
| Входные данные | Текст, изображения, аудио, видео, PDF | Только текст |
| Ответ | Текст | Текст |
| Объём входа / контекста | Вход — до 1 048 576 токенов | Контекст — 1M токенов |
| Максимальный вывод | 65 536 токенов | 128K токенов |
| Уровни рассуждения | low, medium, high; по умолчанию medium | low, high, max; по умолчанию max |
| Вызов функций и структурированный вывод | Поддерживаются | Поддерживаются |
Параметры API указаны в документации Gemini 3.8 Flash и документации GLM-5.3; открытые веса GLM доступны в официальном репозитории. Google обозначает ёмкость как предел входа, Z.AI — как окно контекста. Поэтому одинаковое округлённое «1M» ещё не означает, что в оба запроса поместится один и тот же документ вместе с ответом.
Для длинного отчёта или большой генерации кода предел GLM в 128K может быть полезен. Но это допустимая длина вывода, а не обещание, что модель без ошибок заполнит её содержательным текстом. Для обработки документов также важнее проверить, извлекает ли модель нужные сведения из удалённых частей файла, чем сравнивать только максимальные числа.
В этой паре мультимодальность Gemini означает понимание входных данных. Обычная Gemini 3.8 Flash не генерирует изображения или аудио и не поддерживает Live API; для таких задач нужны другие модели или сервисы. Источник: таблица возможностей Google.
Сколько стоит одинаковый объём токенов
До конца 2026 года Gemini 3.8 Flash дешевле GLM-5.3 по обоим основным тарифам: входу и выходу. С 1 января 2027 года Google объявила повышение цен. Если цены Z.AI останутся нынешними, преимущество по этим ставкам перейдёт к GLM-5.3.
Это сравнение прямых международных API в долларах США. Для Google взят режим Standard, для Z.AI — Model API. Оно не описывает стоимость Coding Plan, потребительских подписок, тарифов посредников или доступность оплаты из России.
| За 1 млн токенов, USD | Gemini до 31.12.2026 | Gemini с 01.01.2027 — объявлено | GLM-5.3 на 28.10.2026 |
|---|---|---|---|
| Обычный вход | $0,75 | $1,50 | $1,40 |
| Вход при попадании в кеш | $0,075 | $0,15 | $0,26 |
| Выход | $3,75 | $7,50 | $4,40 |
Источники: тарифы Gemini Developer API и тарифы Z.AI. У Google оплачиваемый вывод включает токены рассуждения. Будущие ставки Google уже опубликованы; неизменность цены Z.AI в 2027 году — лишь условие сравнения, а не объявленная гарантия.
Пример: 10 000 входных и 2 000 оплачиваемых выходных токенов
Для расчёта используем формулу:
стоимость = входные токены × тариф входа / 1 000 000 + оплачиваемые выходные токены × тариф выхода / 1 000 000
Предположим, что у обеих моделей одинаковые оплачиваемые объёмы, а 2 000 выходных токенов уже включают учитываемые при оплате рассуждения. Кеш, инструменты, налоги и повторные запросы исключены.
| Модель и период | Один такой запрос | 1 000 таких запросов |
|---|---|---|
| Gemini 3.8 Flash до конца 2026 года | $0,015 | $15 |
| GLM-5.3 по текущей цене | $0,0228 | $22,80 |
| Gemini 3.8 Flash по объявленной цене с 2027 года | $0,03 | $30 |
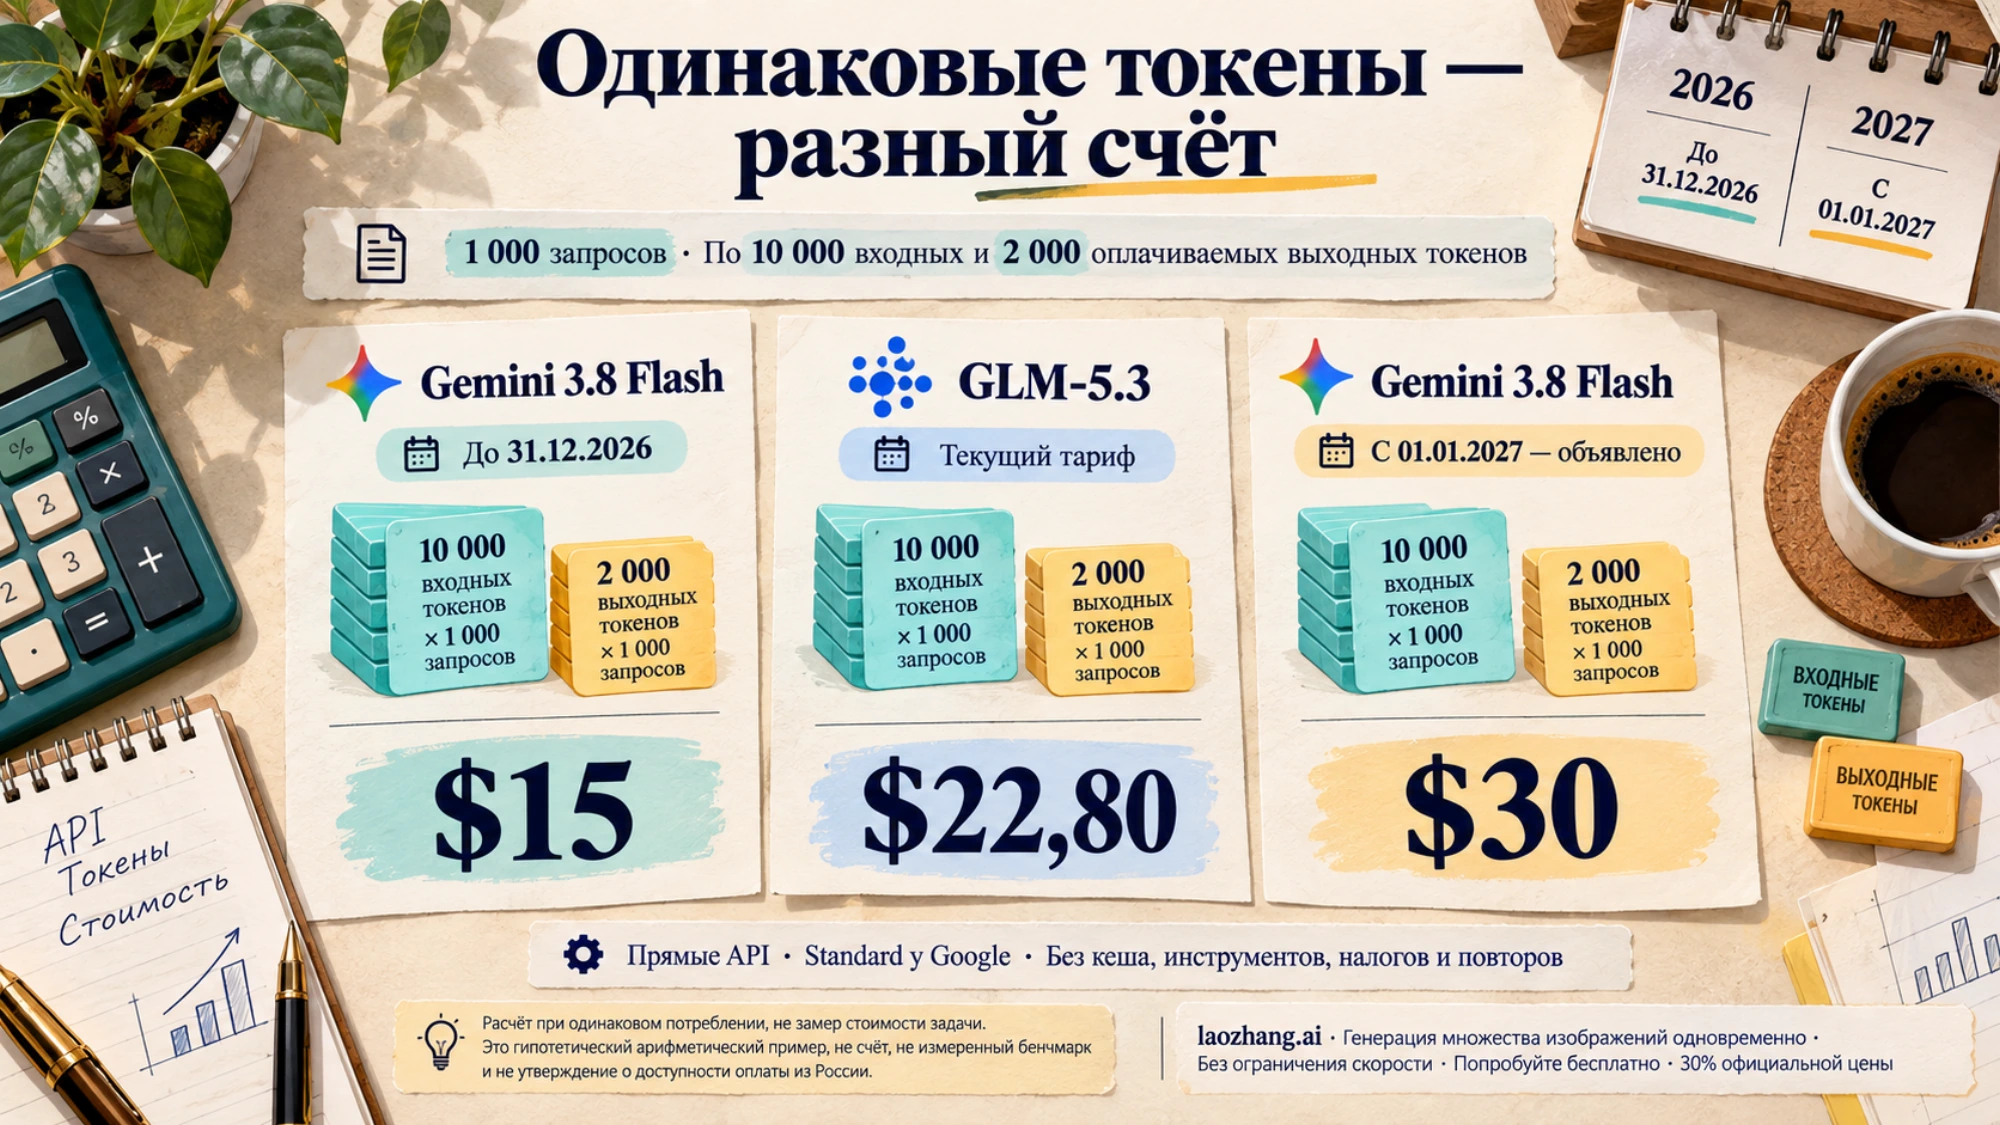
Например, для нынешней Gemini расчёт выглядит так: 10 000 × 0,75 / 1 000 000 + 2 000 × 3,75 / 1 000 000 = $0,015. Это сравнение тарифов при одинаковом потреблении, не измеренная стоимость решения одной задачи. Модели могут по-разному разбить русский текст на токены, потратить разный объём на рассуждения и потребовать разное число попыток.
При большом повторяющемся контексте нужно отдельно считать кеш. У Google хранение стоит сейчас $0,50 за миллион токенов в час, а с 1 января 2027 года объявлена цена $1,00. У Z.AI хранение временно бесплатно, дата окончания на странице тарифов не указана. Низкая цена попадания в кеш сама по себе не определяет весь счёт: важны срок хранения и доля запросов, которые действительно используют сохранённый контекст. Google, Z.AI.
Что говорят тесты о программировании и скорости
У GLM-5.3 есть основание для участия в отборе на сложные текстовые и программные задачи: в снимке результатов Artificial Analysis за 28 октября 2026 года его показатели качества выше, чем у Gemini. Однако сравнивались Gemini 3.8 Flash (High) и GLM-5.3 (Max), а не модели с одинаковым бюджетом рассуждения.
| Показатель в снимке Artificial Analysis | Gemini 3.8 Flash (High) | GLM-5.3 (Max) |
|---|---|---|
| Intelligence Index v4.3.2 | 41 | 45 |
| Terminal-Bench 4.0 | 20% | 42% |
| Скорость вывода после начала генерации | 131 токен/с | 81 токен/с |
| Время до первого возвращённого токена | 25,27 с | 2,74 с |
| Время до первого токена ответа | 25,27 с | 27,47 с |
Источник — страница сравнения Artificial Analysis, просмотренная 28 октября 2026 года. Блок с индексом был помечен v4.3.2, тогда как страница методологии уже описывала v5.0. Это результаты указанной версии, а не утверждение о месте моделей в новейшем рейтинге. Индекс в основном оценивает текстовые задачи на английском; он не устанавливает качество русского языка или работы с изображениями.
Самая полезная деталь для чат-интерфейса — различие между первым токеном и началом ответа. GLM в этом снимке возвращал первый токен значительно раньше, но пользовательский ответ начинался примерно через 27,47 секунды. У Gemini соответствующий показатель составлял 25,27 секунды. Причина различия метрик: первым возвращённым токеном может быть токен рассуждения. Методика измерения производительности отдельно учитывает ожидание ответа и последующую скорость вывода.
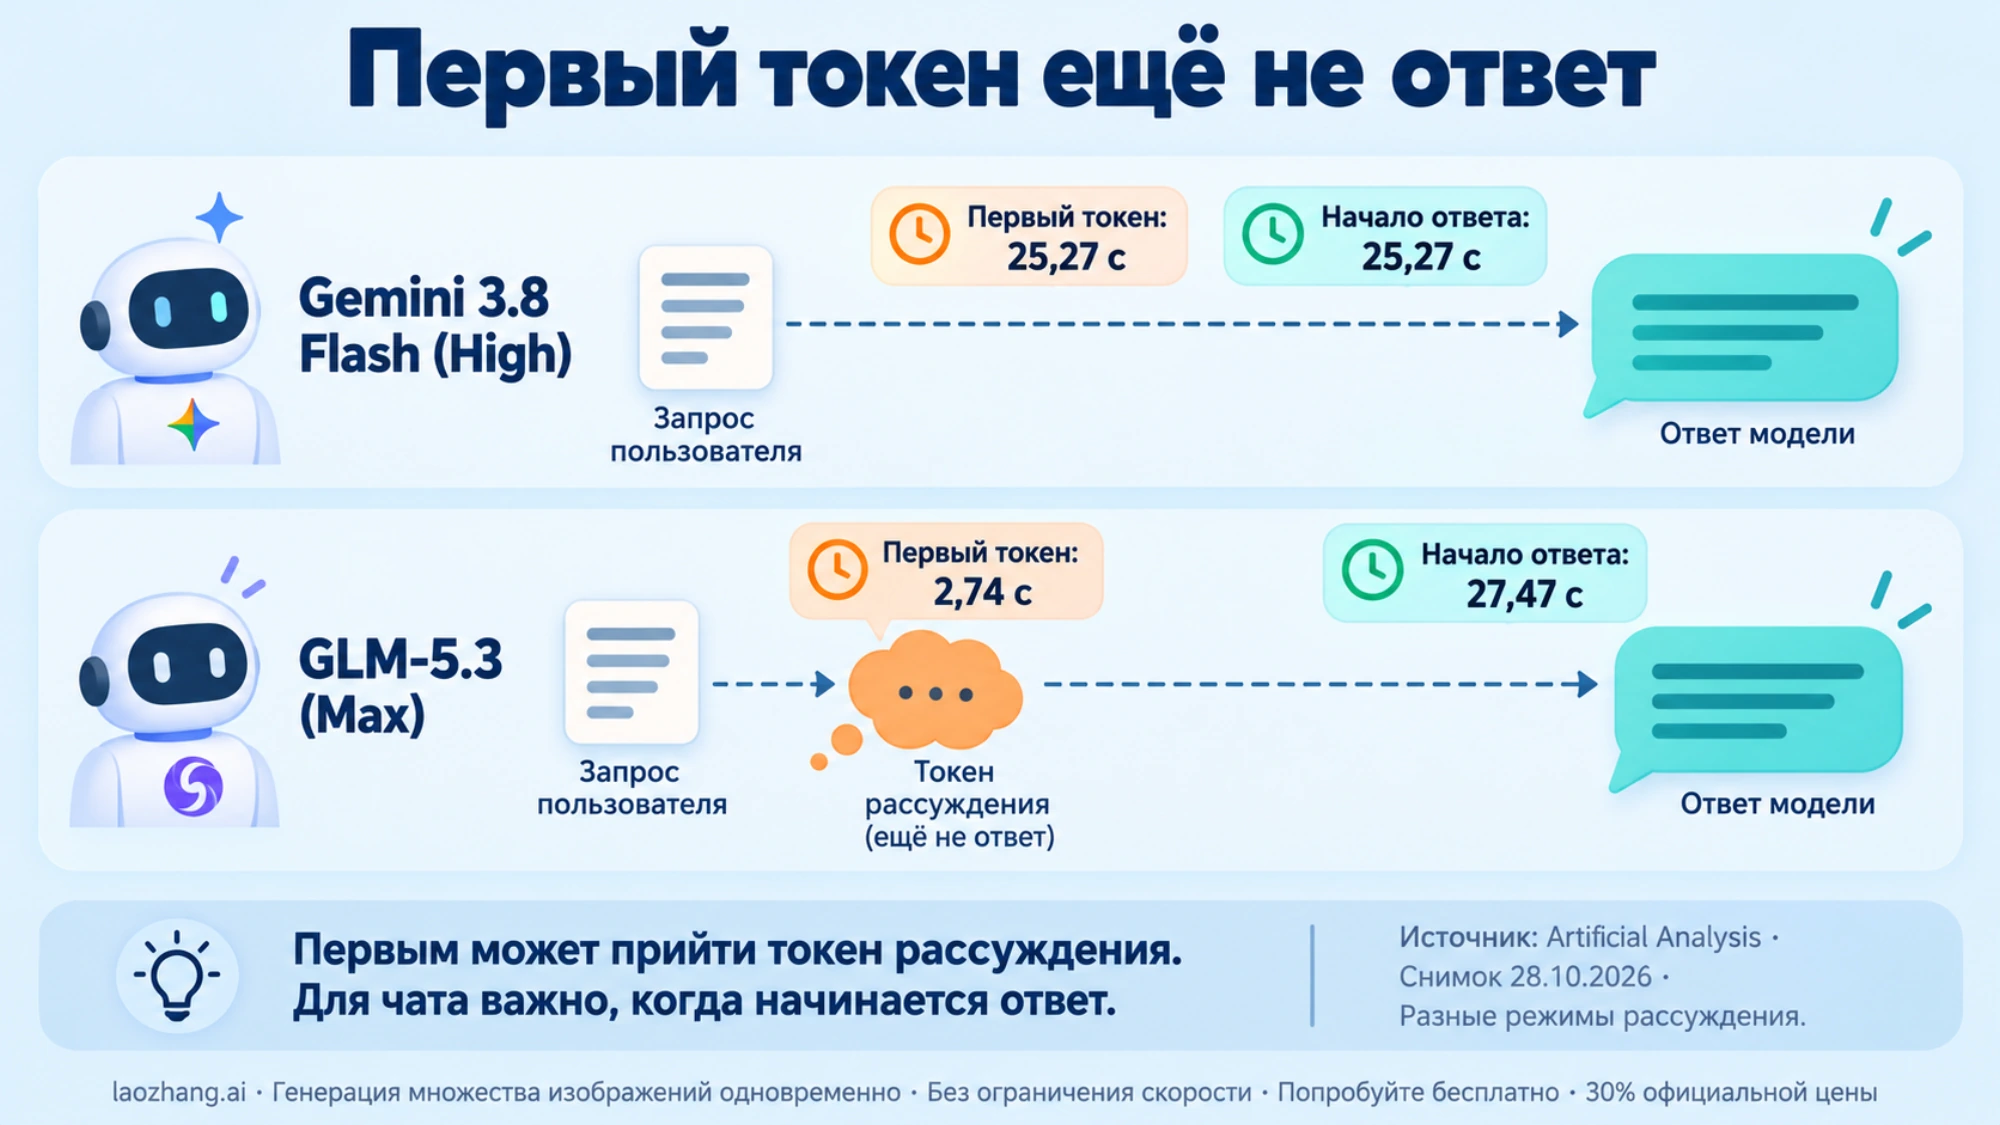
Поэтому «быстрее» нужно привязывать к действию пользователя. Для короткого интерактивного ответа важнее ожидание содержательного текста; для длинного отчёта существенна ещё и скорость продолжения. Эти числа меняются с нагрузкой, поставщиком API, настройками и сетевым маршрутом. Токены в измерениях Artificial Analysis также не тождественны родным токенам тарификации каждого API: по этой таблице нельзя вычислить собственный счёт.
Открытые веса GLM — вариант для серверной инфраструктуры
Если данные должны обрабатываться на вашей инфраструктуре, GLM-5.3 даёт реальную возможность развернуть модель самостоятельно. Официальный репозиторий содержит веса точного варианта GLM-5.3 и ссылки на поддерживаемые способы запуска. Но это крупная серверная модель: наличие открытых весов не превращает её в готовую замену облачному API на обычном рабочем компьютере. Модельная карточка Z.AI.
В рецепте vLLM приведены конфигурации с восемью H200 или H20 для FP8, а для полного контекста 1M — пример с восемью B200 и KV-кешем в формате FP8. Это примеры развёртывания, не измеренный нами минимум. Реальные ресурсы зависят от квантования, длины контекста и одновременных запросов; кроме размещения весов, нужна память для кеша и работы сервера.
Модель распространяется под собственной лицензией GLM-5.3. Она предусматривает коммерческое использование с условиями; называть её MIT, Apache 2.0 или безусловным разрешением на любой сценарий нельзя. До внедрения проверьте условия лицензии применительно к своей организации и способу использования.
Для небольшой команды прямой API обычно позволяет быстрее проверить качество без закупки инфраструктуры. Собственное развёртывание разумно оценивать, когда управление данными и средой исполнения оправдывает затраты на оборудование, эксплуатацию и обновления. Сопоставлять только цену токенов API с нулевой ценой скачивания весов недостаточно.
Как выбрать модель на своих задачах
Начните с обязательных ограничений. Если нужен прямой ввод аудио или изображений, проверяйте Gemini. Если обязательны открытые веса, проверяйте GLM. Если обе модели подходят по формату данных и способу размещения, решение можно принять на небольшом наборе реальных задач:
- Заранее определите, что считается успехом. Для исправления кода — проходящие тесты и отсутствие новых ошибок; для извлечения данных — правильные поля и ссылки на исходные фрагменты; для русскоязычной поддержки — точный и понятный ответ без потери условий.
- Явно задайте режим рассуждения. У Gemini по умолчанию
medium, у GLM —max. Одинаковый текст запроса с настройками по умолчанию не создаёт одинаковые условия. Сначала выберите допустимое время ожидания, затем сравнивайте режимы, которые в него укладываются. - Запишите расход и время до полезного ответа. Учитывайте оплачиваемые токены, инструменты и повторные попытки. Отдельно отмечайте запросы, которые закончились технически успешно, но не решили задачу.
- Сравните стоимость пригодного результата. Разделите фактические расходы на число результатов, которые прошли вашу проверку. Для бюджета на 2027 год дополнительно пересчитайте Gemini по объявленным новым ставкам.
При переносе настроек есть два конкретных несовпадения: Gemini 3.8 Flash не принимает minimal, а GLM-5.3 требует включённого рассуждения — thinking.type=enabled. Не переносите прежнюю конфигурацию без проверки параметров. Изменения Gemini 3.8 Flash, параметры GLM-5.3.
Если выбор пал на Google, дальнейший шаг описан в руководстве по API Gemini 3.8 Flash: ID модели, первый запрос и миграция. Для GLM сначала уточните в документации маршрут именно своего аккаунта: Model API и Coding Plan имеют различия, а универсальную замену адреса API для всех подписок предполагать нельзя.
Частые вопросы
Какая модель дешевле для программирования?
При одинаковом числе оплачиваемых токенов и прямом обращении к Standard API до 31 декабря 2026 года дешевле Gemini 3.8 Flash: $0,75 за миллион входных и $3,75 за миллион выходных токенов против $1,40 и $4,40 у GLM-5.3. Но исправление сложной ошибки может потребовать разного числа попыток и токенов рассуждения. Поэтому стоимость принятого изменения нужно измерять отдельно от тарифов. Google, Z.AI.
Можно ли использовать GLM-5.3 для изображений и PDF?
Модель принимает текст, поэтому изображение или содержимое PDF сначала нужно преобразовать в текст внешним инструментом. Для PDF с диаграммами такое преобразование может потерять существенные сведения. Gemini 3.8 Flash принимает PDF и изображения напрямую. Это различие входных форматов, а не гарантия безошибочного чтения любого файла. GLM-5.3, Gemini 3.8 Flash.
Можно ли оплачивать эти API из России?
Приведённые долларовые тарифы не подтверждают доступность регистрации, оплаты или вызовов API из России. В этом сравнении такие операции не проверялись. Перед выбором проверьте условия провайдера для своего региона и аккаунта; если используете посредника, отдельно учитывайте его цену, поддерживаемый точный ID модели и правила обработки данных.