Ultrafast и Sol нельзя выбирать друг вместо друга: Ultrafast — это уровень обслуживания (service tier) в OpenAI API, то есть режим, в котором обрабатывается запрос, а Sol — семейство моделей. Вопрос на практике звучит иначе: какую модель можно запустить в режиме Ultrafast и сколько это стоит.
С 8 октября 2026 года ответ такой: в Ultrafast работают две модели — GPT-6 Astra и GPT-6.1 Sol, обе открыты всем пользователям API. По прайсу OpenAI API GPT-6.1 Sol в Ultrafast стоит $12 за 1 млн входных и $60 за 1 млн выходных токенов — ровно в 6 раз дороже, чем в Standard. GPT-6 Astra в Ultrafast — $60 и $300. Запуск зафиксирован в журнале изменений API записью от 8 октября.
На одинаковом запросе (250 000 входных токенов, из них 200 000 из кеша, и 10 000 выходных) это $1,32 на GPT-6.1 Sol в Ultrafast против $0,22 в Standard и $7,20 на GPT-6 Astra в Ultrafast. В Codex и ChatGPT Work режим есть только на тарифе Pro за $500 и подходящих планах Enterprise и Edu. Расчёт и условия разобраны ниже.
Ultrafast и Sol — в чём разница: режим обработки и модель
Разница в том, что эти слова отвечают на разные вопросы: модель определяет, кто отвечает на запрос, а уровень обслуживания — с какой скоростью и по какой ставке. OpenAI описывает Ultrafast как самый быстрый уровень обслуживания в API, который стоит использовать, когда скорость оправдывает более высокую цену.
| Ultrafast | Sol | |
|---|---|---|
| Что это | уровень обслуживания запроса | семейство моделей: GPT-6.1 Sol, GPT-6 Sol, GPT-5.6 Sol |
| Где задаётся в API | поле service_tier | поле model |
| На что влияет | скорость генерации выходных токенов и ставка за токен | качество ответа и базовая ставка |
| Соседние варианты | Standard, Fast | GPT-6 Astra (сильнее и дороже), GPT-6 Luna (дешевле) |
Путаница возникла из-за названий. В августе OpenAI показала Ultrafast на примере GPT-5.6 Sol, а 29 сентября в анонсе GPT-6.1 Sol назвала рядом два продукта: GPT-6 Astra Ultrafast и GPT-6.1 Sol Ultrafast. «GPT-6.1 Sol Ultrafast» — не отдельная модель, а GPT-6.1 Sol, запущенная в режиме Ultrafast: в запросе меняется только service_tier.
Ultrafast также не то же самое, что Fast mode. Fast — отдельный уровень с ценой вдвое выше Standard (до 30 июля 2026 года он назывался Priority processing), Ultrafast — вшестеро выше Standard той же модели, и для GPT-6.1 Sol, и для GPT-6 Astra.
Какие модели Sol работают в Ultrafast: с 8 октября — GPT-6.1 Sol
Из моделей Sol в Ultrafast для всех открыта только GPT-6.1 Sol. Состояние по документации OpenAI на 10 октября 2026 года:
| Модель | Ultrafast в API | Ultrafast в Codex и ChatGPT Work | Цена Ultrafast в прайсе |
|---|---|---|---|
| GPT-6.1 Sol | да, с 8 октября, всем пользователям API | да, на Pro за $500 и подходящих планах Enterprise и Edu | $12 / $0,60 / $60 за 1 млн токенов |
| GPT-6 Astra | да, с 29 сентября, всем пользователям API | да, на тех же тарифах | $60 / $6 / $300 за 1 млн токенов |
| GPT-6 Sol | в руководстве не упоминается | нет | нет |
| GPT-5.6 Sol | в текущем руководстве не упоминается | нет | нет |
Цена в таблице — входные, кешированные входные и выходные токены при запросе до 272 000 входных токенов.
Три первоисточника OpenAI говорят одно и то же. Руководство по Ultrafast пишет, что режим «широко доступен для GPT-6 Astra и GPT-6.1 Sol» и открыт всем пользователям API; на вкладке Ultrafast в прайсе две строки, gpt-6-astra и gpt-6.1-sol; страница о скорости в Codex указывает, что Ultrafast поддерживает GPT-6 Astra и GPT-6.1 Sol. Между анонсом 29 сентября и запуском 8 октября GPT-6.1 Sol в Ultrafast не было ни в руководстве, ни в прайсе: режим был только объявлен.
Про GPT-5.6 Sol: в августовском анонсе OpenAI открыла ограниченную предварительную версию Ultrafast с этой моделью для отдельных клиентов, без опубликованной цены. В текущем руководстве GPT-5.6 Sol уже не названа — там только GPT-6 Astra и GPT-6.1 Sol. Закрыт ли этот предварительный доступ, OpenAI публично не сообщает.
Помимо OpenAI API, AWS 8 октября объявила, что Ultrafast для GPT-6.1 Sol доступен в Amazon Bedrock; регионы и цены AWS приводит в документации Bedrock.
Сколько будет стоить GPT-6.1 Sol Ultrafast: официально $12 и $60
Цена опубликована на вкладке Ultrafast в прайсе OpenAI API. За 1 млн токенов:
| Ставка | GPT-6.1 Sol Ultrafast, до 272 000 входных | GPT-6.1 Sol Ultrafast, длинный контекст | GPT-6 Astra Ultrafast, до 272 000 входных |
|---|---|---|---|
| Входные | $12 | $24 | $60 |
| Кешированные входные | $0,60 | $1,20 | $6 |
| Запись в кеш | $15 | $30 | $75 |
| Выходные | $60 | $90 | $300 |
Каждая ставка ровно в 6 раз выше Standard: у GPT-6.1 Sol в Standard $2 / $0,10 / $2,50 / $10. Против GPT-6 Astra в Ultrafast Sol дешевле в 5 раз по входным и выходным токенам и в 10 раз по кешированным.
В объявлении о запуске OpenAI пишет, что $12 и $60 — это «всего в 1,2 раза дороже Astra». Здесь сравнение идёт с GPT-6 Astra в Standard ($10 и $50), а не в Ultrafast. Иными словами, за цену чуть выше обычной Astra вы получаете Sol на максимальной скорости, а Astra на той же скорости стоит в пять раз больше.
Цифры $12 и $60 встречались в новостях ещё до запуска как оценка: VentureBeat 29 сентября умножил стандартные ставки на шесть. Опубликованная цена с этой оценкой совпала; ставку за запись в кеш ($15) она не учитывала. Ставки $15 и $75, которые показывает, например, Venice AI, — цена сторонней площадки, а не OpenAI. На региональных конечных точках OpenAI (резидентность данных) ставки выше на 10 %.
Сколько стоит запрос: $1,32 в Sol Ultrafast, $7,20 в Astra Ultrafast
Один и тот же запрос стоит $0,22 на GPT-6.1 Sol в Standard, $1,32 на GPT-6.1 Sol в Ultrafast и $7,20 на GPT-6 Astra в Ultrafast. Ставки из прайса OpenAI API по состоянию на 10 октября 2026 года, за 1 млн токенов, для запросов до 272 000 входных токенов:
| Модель и режим | Входные | Кешированные входные | Выходные | Запрос из примера |
|---|---|---|---|---|
| GPT-6.1 Sol, Standard | $2 | $0,10 | $10 | $0,22 |
| GPT-6.1 Sol, Fast | $4 | $0,20 | $20 | $0,44 |
| GPT-6.1 Sol, Ultrafast | $12 | $0,60 | $60 | $1,32 |
| GPT-5.6 Sol, Standard | $4 | $0,40 | $20 | $0,48 |
| GPT-6 Astra, Standard | $10 | $1 | $50 | $1,20 |
| GPT-6 Astra, Fast | $20 | $2 | $100 | $2,40 |
| GPT-6 Astra, Ultrafast | $60 | $6 | $300 | $7,20 |
Запрос из примера: 50 000 новых входных токенов, 200 000 входных токенов из кеша и 10 000 выходных. Формула одна для всех строк — доля миллиона, умноженная на ставку:
- GPT-6.1 Sol, Standard: 0,05 × $2 + 0,2 × $0,10 + 0,01 × $10 = $0,22
- GPT-6.1 Sol, Ultrafast: 0,05 × $12 + 0,2 × $0,60 + 0,01 × $60 = $1,32
- GPT-6 Astra, Standard: 0,05 × $10 + 0,2 × $1 + 0,01 × $50 = $1,20
- GPT-6 Astra, Ultrafast: 0,05 × $60 + 0,2 × $6 + 0,01 × $300 = $7,20
Отсюда соотношения:
- Astra Ultrafast дороже Sol Ultrafast в 5,45 раза ($7,20 ÷ $1,32), разница — $5,88 на каждом запросе. Это больше пятикратной разницы в ставках, потому что кешированные токены у Sol дешевле в 10 раз.
- Sol Ultrafast дороже Sol Standard в 6 раз и Sol Fast — в 3 раза.
- Против GPT-6 Astra в Standard Sol Ultrafast дороже всего в 1,1 раза ($1,32 против $1,20). Без кеша (250 000 новых входных и 10 000 выходных) соотношение возвращается к заявленным 1,2: $3,60 против $3,00.
В масштабе разница заметнее: 1 000 таких запросов в день в течение 30 дней — это $6 600 на Sol в Standard, $39 600 на Sol в Ultrafast и $216 000 на Astra в Ultrafast. Это иллюстрация на одном составе токенов, а не прогноз вашего счёта.
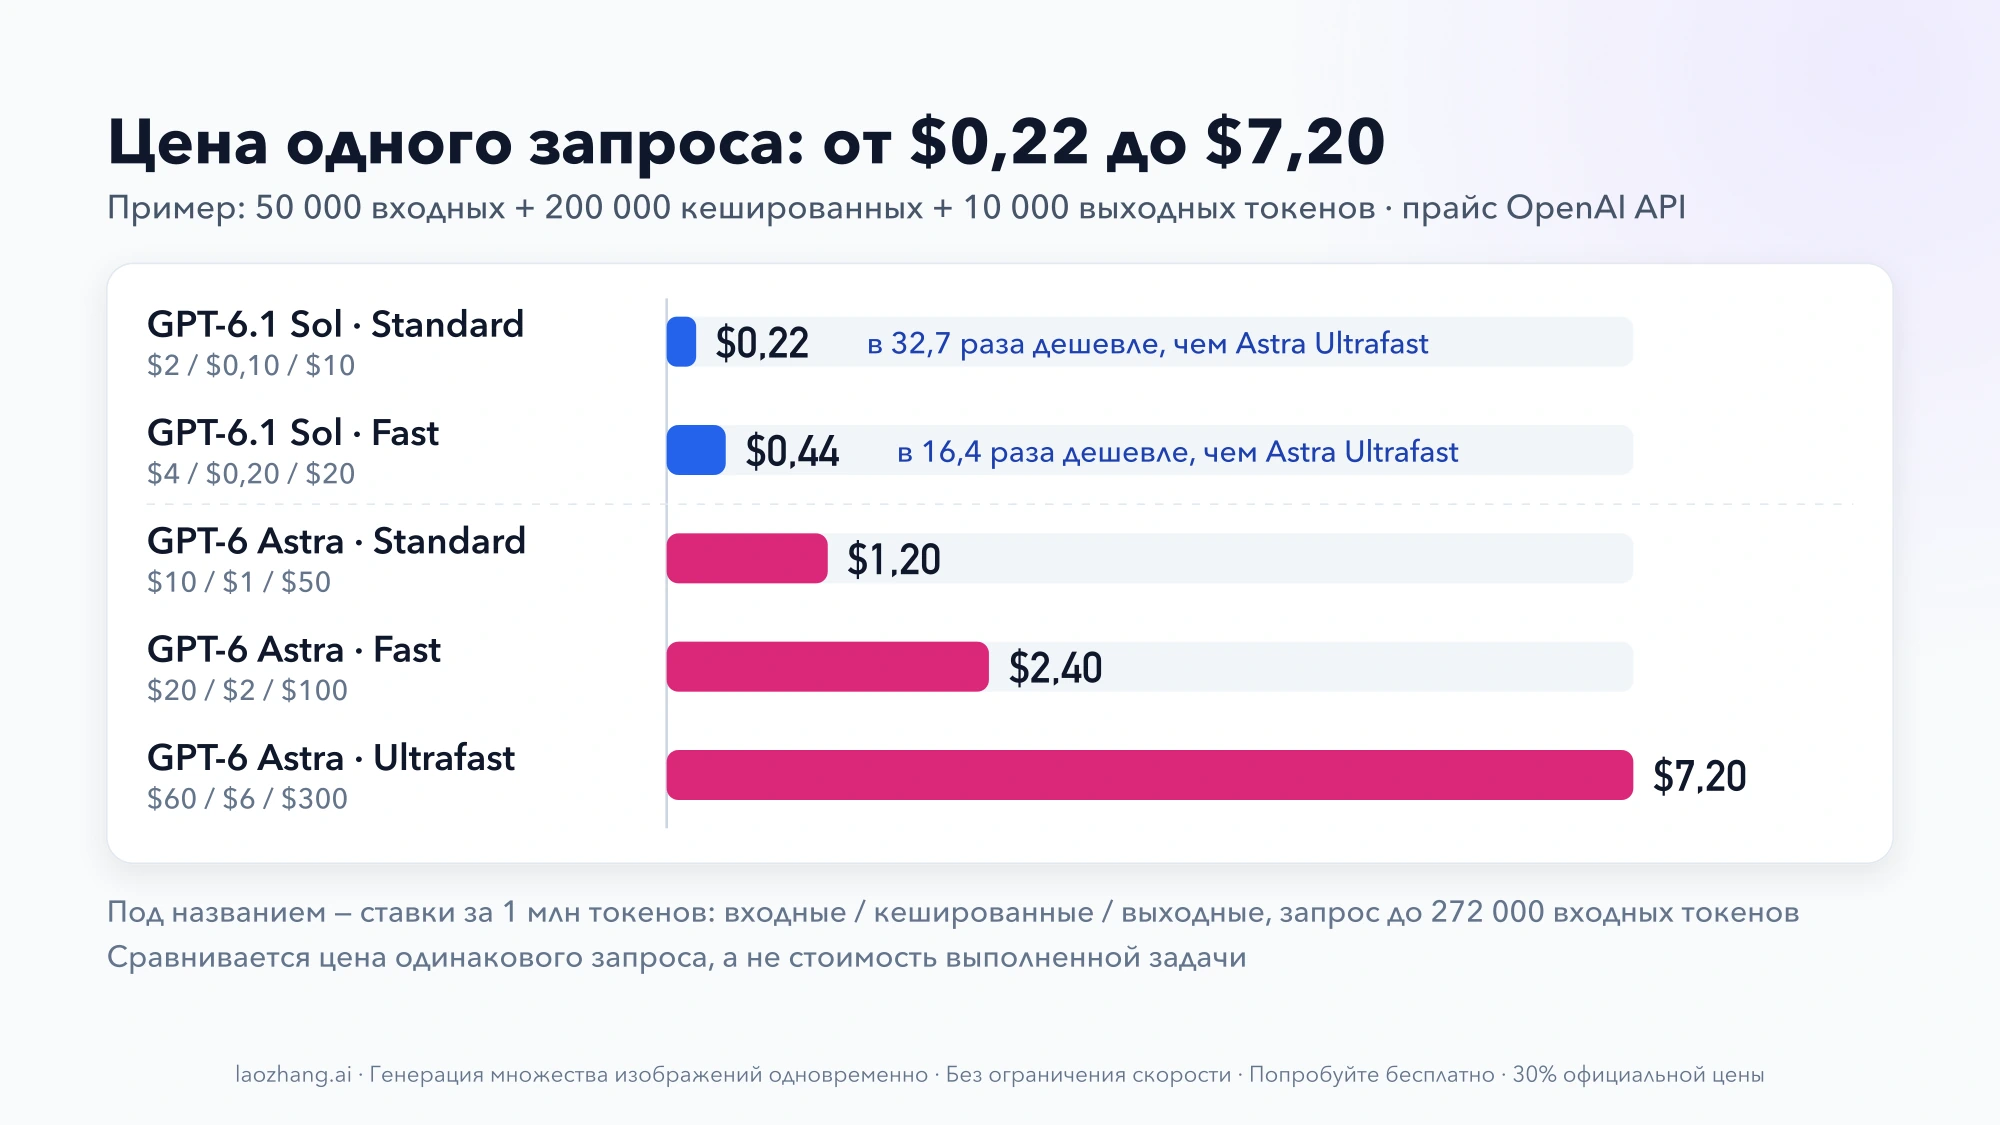
У расчёта есть границы. Плата за запись в кеш в него не входит. Цена GPT-5.6 Sol — акционная, по примечанию в прайсе она действует как минимум до 21 ноября 2026 года. При запросе длиннее 272 000 входных токенов действуют ставки длинного контекста: GPT-6.1 Sol в Ultrafast — $24 / $1,20 / $90, GPT-6 Astra в Ultrafast — $120 / $12 / $450, GPT-6.1 Sol в Standard — $4 / $0,20 / $15.
Главное допущение — одинаковое число токенов на всех строках. На реальной задаче разные модели тратят разное количество токенов, поэтому таблица сравнивает цену одинакового запроса, а не стоимость выполненной задачи. Как это расхождение выглядит для Sol на замерах, показано в материале GPT-6.1 Sol vs Claude Opus 5.5: сравнение цен и режимов скорости.
Как включить Ultrafast в API: service_tier и WebSocket
Чтобы запрос ушёл в Ultrafast, в Responses API нужно указать модель gpt-6.1-sol (или gpt-6-astra) и service_tier со значением ultrafast. Отдельной модели или отдельного ключа не требуется. HTTP-запрос по образцу из руководства OpenAI:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-sol",
    "input": "Explain why the sky is blue in one sentence.",
    "service_tier": "ultrafast"
  }'
В примерах самого руководства стоит gpt-6-astra; для Sol меняется только значение model, как и сказано в тексте руководства. Запрос платный: он тарифицируется по ставкам Ultrafast.
HTTP поддерживается, но OpenAI настойчиво рекомендует WebSocket, особенно для агентов, которые делают много вызовов инструментов подряд: без постоянного соединения сетевые задержки съедают часть выигрыша. В SDK соединение открывается через client.responses.connect(), а каждый запрос отправляется вызовом connection.response.create(...) с теми же model и service_tier. Следующий ход диалога передаёт идентификатор предыдущего ответа в previous_response_id, и одно соединение используется повторно для новых реплик и результатов инструментов.
У Ultrafast отдельные лимиты, не общие со Standard и Fast. По умолчанию, в токенах в минуту:
| Уровень использования API | GPT-6.1 Sol Ultrafast | GPT-6 Astra Ultrafast |
|---|---|---|
| Build | 1 000 000 | 500 000 |
| Launch | 4 000 000 | 1 000 000 |
| Grow | 40 000 000 | 5 000 000 |
Build, Launch и Grow — нынешние названия платных уровней: они открываются после пополнений на $5, $100 и $500 суммарно, по описанию лимитов. Раньше руководство по Ultrafast обозначало уровни номерами с 1-го по 5-й. Лимиты выше — по запросу через менеджеров OpenAI, если у организации есть команда сопровождения.
Ещё два условия стоит проверить до того, как закладывать Ultrafast в архитектуру:
- Размещение данных. GPT-6.1 Sol в Ultrafast поддерживает резидентность данных в США и ЕС и глобальную обработку; GPT-6 Astra в Ultrafast — только США и глобальную обработку. Региональные конечные точки стоят на 10 % дороже.
- Проверка режима. Что именно возвращает ответ API для запроса в Ultrafast, документация не описывает. Перед запуском в продакшн стоит отправить пробный запрос и сверить ответ и списание по ставкам Ultrafast.
Ultrafast в Codex и ChatGPT Work: нужен Pro за $500
В Codex и ChatGPT Work режим Ultrafast есть только на тарифе Pro за $500 в месяц и на подходящих планах Enterprise и Edu — теперь и для GPT-6 Astra, и для GPT-6.1 Sol. На Plus, Pro за $100 и $200 и Business его на старте нет, даже если докупить кредиты. Условия приведены на странице о скорости и в описании тарифов.
| Режим в Codex | Расход включённого в подписку лимита | Купленные кредиты и оплата по факту в Enterprise |
|---|---|---|
| Standard | 1× | 1× |
| Fast | 2,5× | 2× |
| Ultrafast (GPT-6 Astra и GPT-6.1 Sol) | 8× | 6× |
Эти множители описывают расход, а не ускорение. На Pro за $500 Ultrafast сначала тратит включённый лимит, затем доступные кредиты. В рабочих пространствах Enterprise он по умолчанию выключен: владелец включает его для отдельных пользователей или всего пространства. Обработку в Европе (ЕЭЗ и Швейцария) поддерживает только GPT-6.1 Sol в Ultrafast, GPT-6 Astra в Ultrafast — только в США.
На купленных кредитах тот же запрос из примера выше стоит 5,5 кредита на GPT-6.1 Sol в Standard (0,05 × 50 + 0,2 × 2,5 + 0,01 × 250), 11 в Fast и 33 в Ultrafast; на GPT-6 Astra — 30 в Standard и 180 в Ultrafast. Записи в кеш Codex отдельно не тарифицирует. Сколько это в долларах, зависит от тарифа, а для включённого лимита OpenAI прямо предупреждает, что токенные расчёты его не предсказывают.
Fast включается командой /fast в CLI; чтобы сделать его режимом по умолчанию, в config.toml задают service_tier = "fast" и fast_mode = true в секции [features]. Если Codex работает с ключом API, а не через подписку, множители кредитов не применяются: расход считается по долларовым ставкам API из разделов выше.
Насколько Ultrafast быстрее: «до 8 раз» — про генерацию токенов
Все официальные цифры скорости — это максимумы для генерации выходных токенов, а не время выполнения задачи. Ниже собраны заявления OpenAI и их пересказ в прессе: это не результаты измерений.
| Что заявлено | Цифра | Кто заявил |
|---|---|---|
| GPT-6.1 Sol Ultrafast против Sol в Standard | до 8 раз быстрее генерация токенов | OpenAI, анонс GPT-6.1 Sol (в Codex) и объявление о запуске 8 октября |
| GPT-6 Astra Ultrafast в Codex против Astra в Standard | до 8 раз быстрее | OpenAI, страница о скорости в Codex |
| Ultrafast в API | до 6 раз быстрее, до 300 токенов в секунду | VentureBeat со ссылкой на материалы DevDay |
| GPT-5.6 Sol Ultrafast, предварительная версия | до 14 раз быстрее стандартной обработки, до 750 выходных токенов в секунду | OpenAI, анонс от 13 августа 2026 года |
Для Astra OpenAI прямо оговаривает, что сравнение «до 8 раз» измеряет скорость генерации токенов, а не ставки и не общее время выполнения задачи; в журнале изменений API Ultrafast для Sol описан так же — как сокращение времени между выходными токенами. Скорость в токенах в секунду для GPT-6.1 Sol ни в Standard, ни в Ultrafast компания не публикует, как и скорость Fast mode в API.
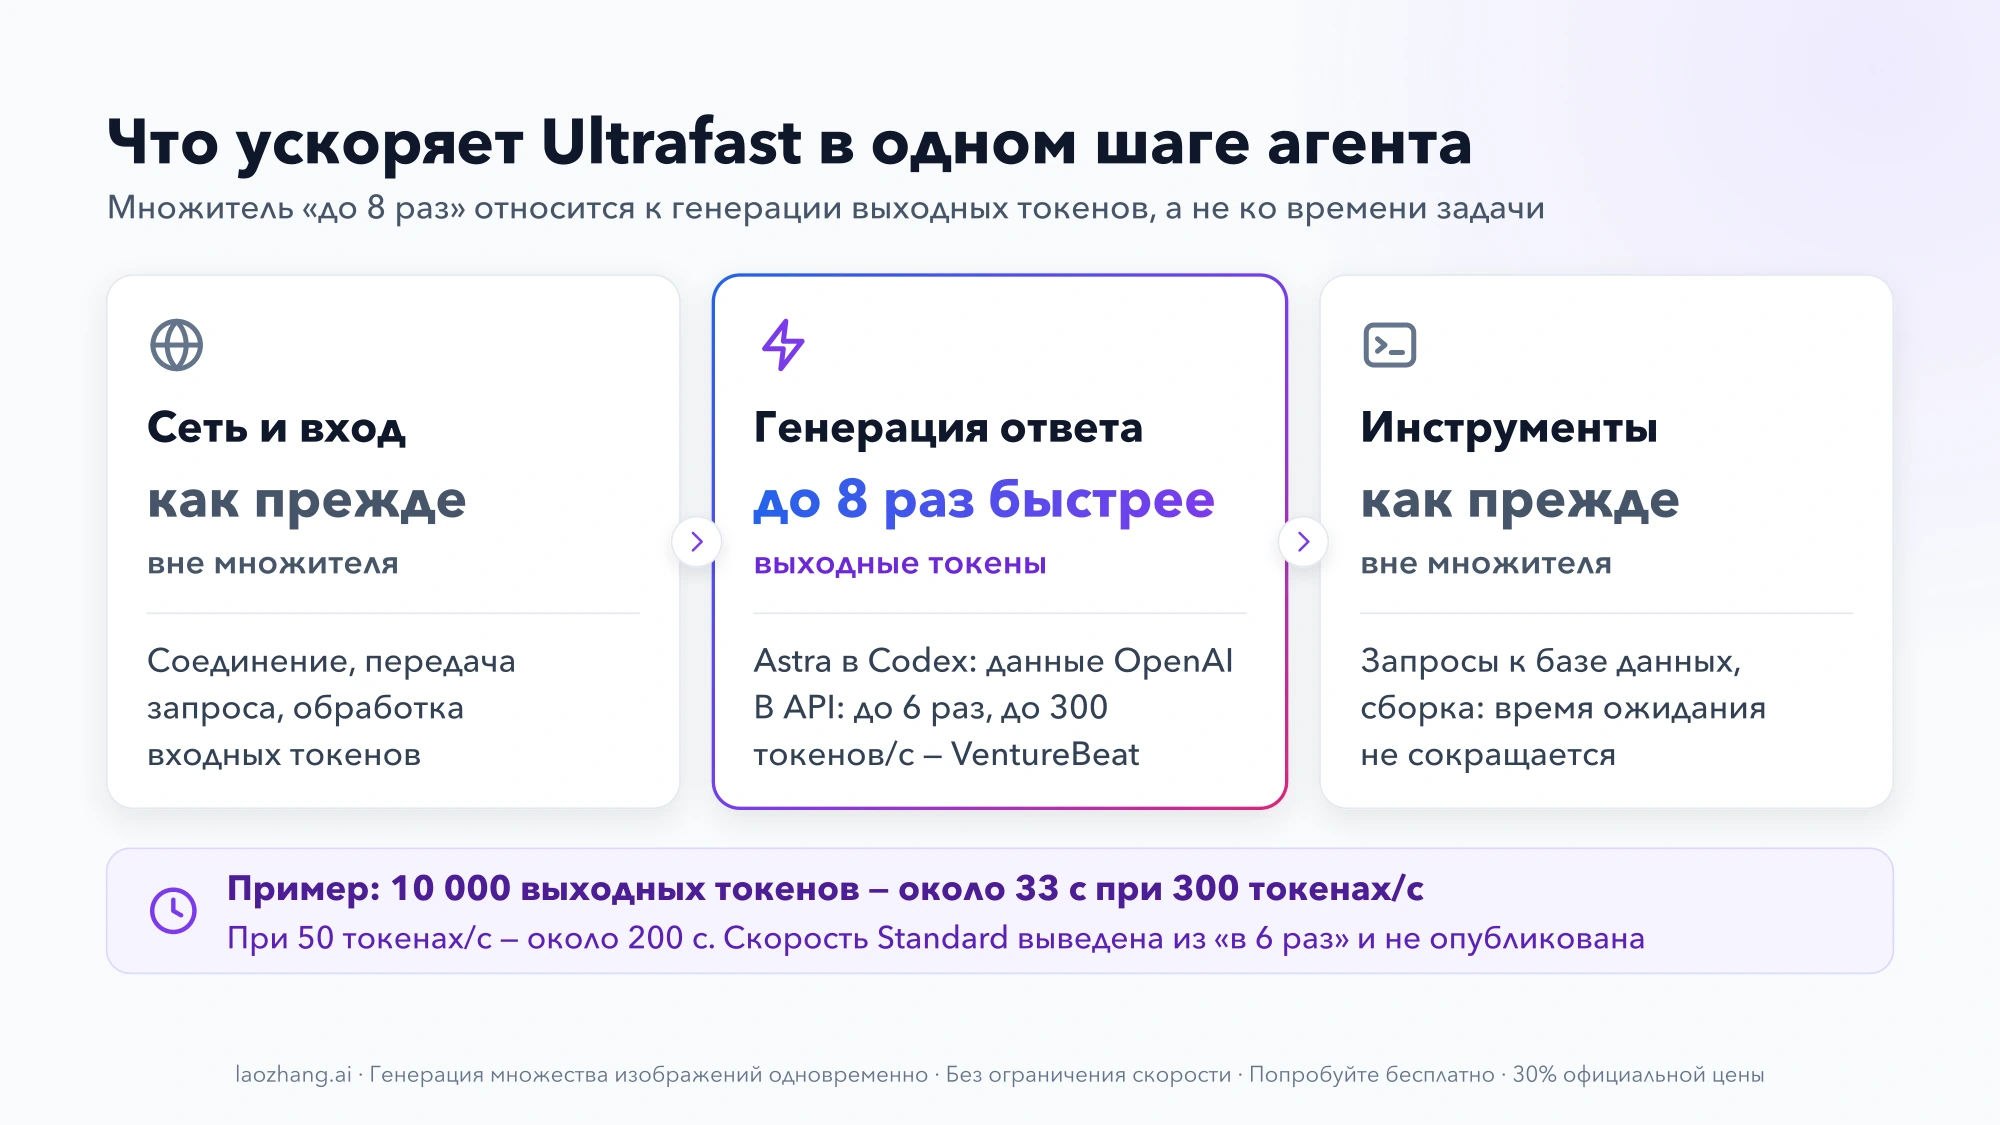
Чтобы представить порядок величин, можно взять потолок из пересказа VentureBeat: при 300 токенах в секунду 10 000 выходных токенов генерируются примерно 33 секунды (10 000 ÷ 300). Эта цифра относится к контексту GPT-6 Astra на DevDay, а не к замеру Sol. Сколько секунд Ultrafast сэкономит на вашей задаче, без опубликованной скорости Standard не посчитать — это даёт только замер. Цена же известна точно: запрос из примера на GPT-6.1 Sol стоит в Ultrafast на $1,10 дороже, чем в Standard ($1,32 против $0,22).
За пределами множителя остаются сетевые обмены, обработка входных токенов и выполнение инструментов. Агент, который большую часть времени ждёт ответа базы данных или сборки, от Ultrafast ускорится заметно меньше, чем в 8 раз. Длинный ответ, который читает человек или озвучивает голосовой интерфейс, выиграет больше всего.
Что выбрать: Sol в Standard, Fast или Ultrafast, либо Astra Ultrafast
Для большинства задач разумно оставаться на GPT-6.1 Sol в Standard, а Ultrafast подключать там, где ожидание ответа стоит дороже токенов. По ситуациям:
- Фоновые и пакетные задачи, разбор документов, рутинные правки кода. GPT-6.1 Sol в Standard: $0,22 за запрос из примера. Скорость здесь мало что меняет.
- Нужно быстрее, но без шестикратной цены. Fast mode: ровно вдвое дороже Standard, $0,44. Насколько он ускоряет модели GPT-6 в API, OpenAI не публикует, поэтому выигрыш придётся измерить на своих запросах.
- Важна каждая секунда, а качества Sol достаточно. GPT-6.1 Sol в Ultrafast: $1,32, в 6 раз дороже Standard. Среди сценариев OpenAI называет отладку во время сбоя, агентов, которые управляют приложениями, и живые сценарии, где важна каждая секунда.
- Нужно качество Astra, а скорость не критична. GPT-6 Astra в Standard стоит $1,20 — почти столько же, сколько Sol в Ultrafast. При одном бюджете на запрос выбор сводится к тому, что важнее: скорость Sol или качество Astra.
- Нужны и качество Astra, и максимальная скорость. GPT-6 Astra в Ultrafast: $7,20, в 5,45 раза дороже Sol в Ultrafast на одинаковом запросе.
- Данные должны обрабатываться в ЕС. Подходит GPT-6.1 Sol в Ultrafast (региональная конечная точка дороже на 10 %); GPT-6 Astra в Ultrafast работает только с резидентностью в США.
- Работа идёт в Codex по подписке. Ultrafast доступен только на Pro за $500 и подходящих Enterprise и Edu; на Plus и Business остаются Standard и Fast. С ключом API Codex платит по ставкам API.
Простой способ проверить, оправданна ли переплата: посчитать по формуле выше разницу в цене своего типичного запроса и сравнить её со стоимостью времени, которое этот запрос экономит. Опубликованной скорости Standard для этого нет, поэтому сэкономленное время стоит получить замером: один и тот же запрос в Standard и в Ultrafast с фиксацией времени до последнего токена.
Короткие ответы про Ultrafast, Fast mode и тариф Pro
Работает ли уже GPT-6.1 Sol Ultrafast?
Да, с 8 октября 2026 года. В API режим открыт всем пользователям (с отдельными лимитами): модель gpt-6.1-sol, service_tier: "ultrafast", цена $12 и $60 за 1 млн входных и выходных токенов. В Codex и ChatGPT Work он доступен на Pro за $500 и подходящих планах Enterprise и Edu; в Enterprise его сначала должен включить администратор.
Почему OpenAI пишет, что Sol Ultrafast «в 1,2 раза дороже Astra»?
Потому что база сравнения — GPT-6 Astra в Standard: $12 против $10 за входные и $60 против $50 за выходные токены. С GPT-6 Astra в Ultrafast ($60 и $300) Sol в Ultrafast дешевле в 5 раз по ставкам и в 5,45 раза на запросе из примера.
Чем Ultrafast отличается от Fast mode?
Это два разных уровня обслуживания. Fast стоит вдвое дороже Standard, Ultrafast — вшестеро; оба доступны для GPT-6.1 Sol и GPT-6 Astra. Скоростной множитель OpenAI публикует только для Ultrafast — до 8 раз в генерации токенов. В Codex Fast расходует включённый лимит в 2,5 раза быстрее, Ultrafast — в 8 раз.
Что даёт тариф Pro за $500 в отношении Ultrafast?
Pro за $500 в месяц — единственный тариф с самостоятельной оплатой, на котором в Codex и ChatGPT Work доступны GPT-6 Astra Ultrafast и GPT-6.1 Sol Ultrafast. Сначала расходуется включённый лимит, затем кредиты. Для вызовов через API подписка не нужна: там Ultrafast оплачивается по токенам и открыт всем пользователям API. Где ещё доступна Astra и по каким ценам, разобрано в материале Как пользоваться GPT-6 Astra: на Plus — только в Work и Codex.
Есть ли модель дешевле Sol и когда её достаточно?
Да, GPT-6 Luna: по прайсу она в 20 раз дешевле GPT-6 Sol. Ставки обеих моделей и условия, при которых Sol окупается, разобраны отдельно: GPT-6 Luna или Sol: сколько стоят и когда Sol окупается. Тот материал написан до выхода GPT-6.1 Sol.