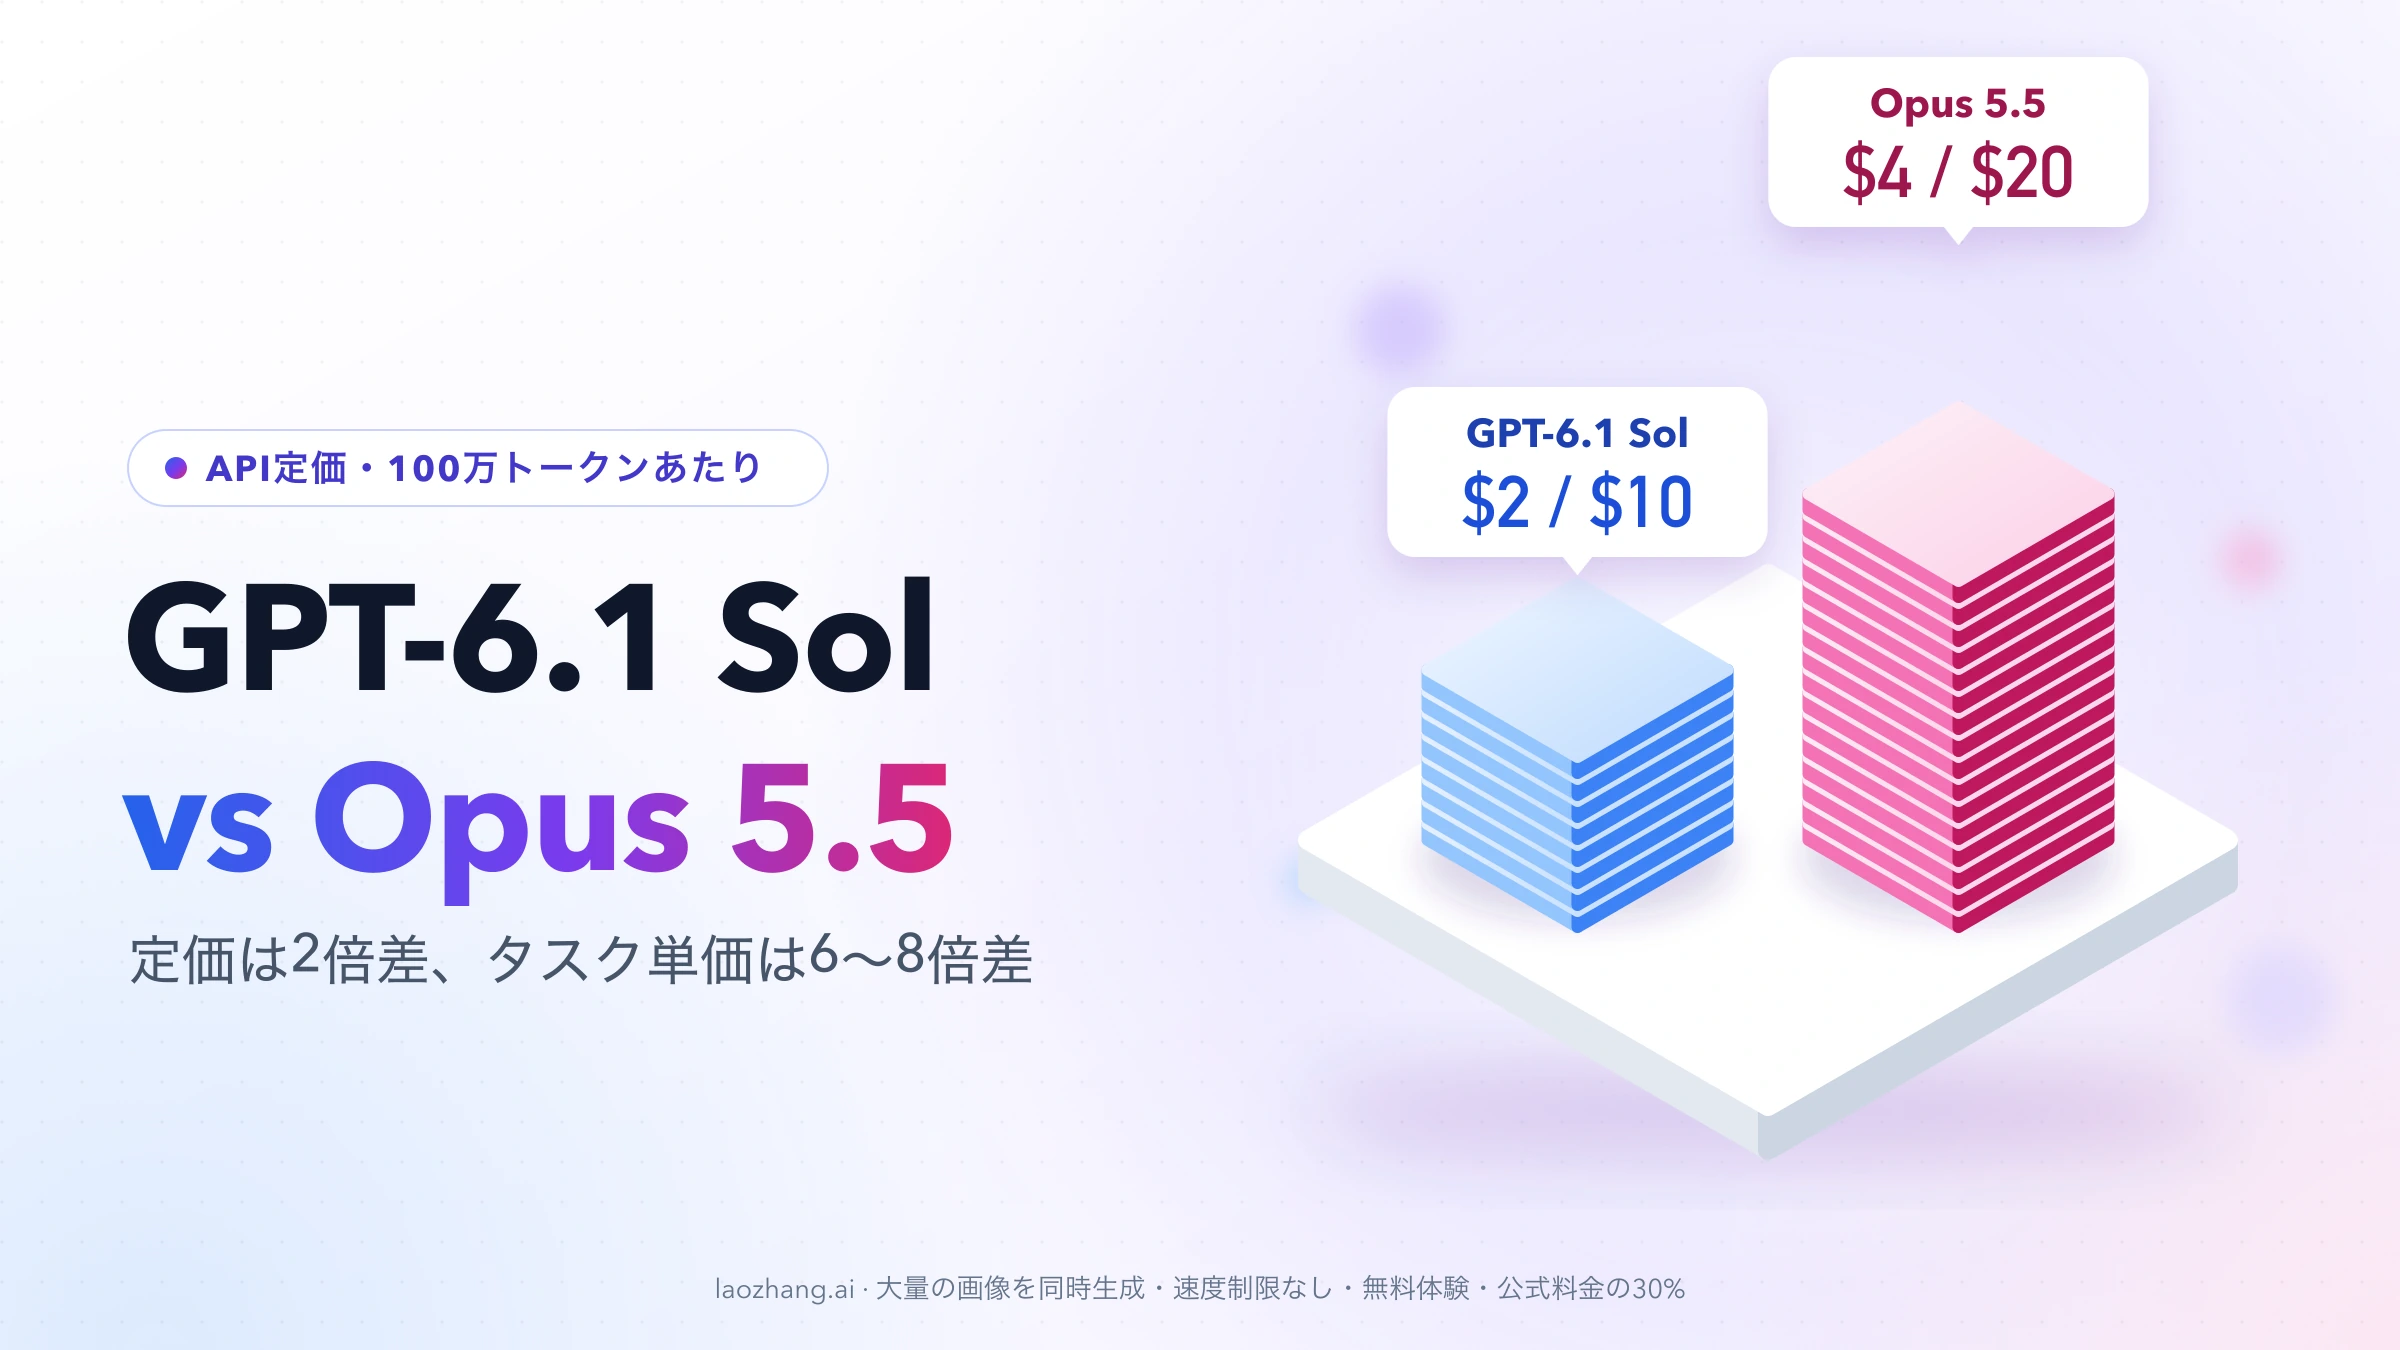
2026年10月10日時点で、GPT-6.1 Sol(gpt-6.1-sol)のAPI定価は100万トークンあたり入力$2・出力$10、Claude Opus 5.5(claude-opus-5-5)は入力$4・出力$20で、ちょうど2倍の差です。ところが、Artificial Analysisが同じ課題一式を解かせて計測したタスク単価は、既定の推論強度(medium)で$0.21対$1.34とOpus 5.5が約6.4倍高く、強度を変えると4.2〜8.9倍の幅で動きます。スコアは最も低い強度(low)で42対42の同点、最も高い強度(max)では52対58でOpus 5.5が6ポイント上です(Artificial Analysisの強度別比較)。
既定モデルの出発点は次のとおりです。
- 自動テストで合否が決まり、量をこなす作業はGPT-6.1 Solを既定にします。Opus 5.5が必ず合格すると仮定しても、Solの合格率が約16%を割らない限りSolのほうが安く済みます。
- 失敗したときの確認ややり直しに人の時間がかかる難しい作業は、Opus 5.5を残したまま両方の合格率を測ります。1回の確認に$5かかり、Solの合格率が70%なら、Opus 5.5が85%を超えるかどうかで結論が入れ替わります。
- 応答の速さを買いたい場合、10月8日に始まったSol Ultrafast(入力$12・出力$60)は、同じリクエストでOpus 5.5のFast mode($8・$40)の1.5倍、Opus 5.5標準の3倍の請求になります。Opus側のFast modeはウェイトリスト制のリサーチプレビューです。
- 入力が272Kトークンを超える処理では費用差が1〜7%まで縮むので、品質だけで選べます。
以下の数字はベンダーの公表値と第三者の計測値で、どちらなのかと計測条件はそれぞれの箇所に付けています。料金はすべて米ドル・税別の直販API定価で、クラウド事業者や再販経由の価格は含みません。
どちらを既定にするか:定型作業はSol、難所はOpus 5.5
| 作業 | 先に試すモデル | 理由 |
|---|---|---|
| テストで合否が決まるコード修正、大量の文書処理、バッチ処理 | GPT-6.1 Sol | 定価が半額で、計測されたタスク単価は4分の1以下。失敗しても再実行が安い |
| 長時間のエージェント作業、設計判断を含む実装 | Opus 5.5を残し、Solを並行で試す | high以上の強度ではOpus 5.5のスコアが4〜6ポイント上。Solの合格率が足りれば移す |
| 毎回人がレビューする成果物 | 合格率で決める | 確認の手間が費用の大半になると、API料金の差より合格率の差が効く |
| 対話的なデバッグなど、待ち時間を減らしたい作業 | 標準速度の特性で選び、速度モードは単価を見て判断 | 標準ではOpus 5.5が出力が速く、Solが最初の回答を早く返す。Sol UltrafastはOpus Fast modeの1.5倍の単価 |
| 入力が272Kトークンを超える長文・大規模リポジトリ | 品質で選ぶ | Solの入力単価が$4に上がり、費用差は1〜7% |
| セキュリティ関連の作業 | 拒否と代替モデルの扱いを先に確認 | Opus 5.5は安全分類器が断ることがあり、設定次第で別モデルが応答する |
すでにgpt-6-solを使っている処理 | GPT-6.1 Sol | 入出力単価は同じで、キャッシュ入力が半額になる |
GPT-6.1 SolとOpus 5.5の違い:料金・スコア・速度モード・提供先
「Sol 6.1」「GPT 6.1」と呼ばれているのは、OpenAIのGPT-6.1 Sol(API名gpt-6.1-sol)です。GPT-6 Solの改良版で、APIの変更履歴では2026年9月29日に公開されました。OpenAIの最上位モデルは引き続きGPT-6 Astraで、GPT-6.1 AstraやGPT-6.1 Lunaというモデルはありません(OpenAIの発表)。比較相手のClaude Opus 5.5は2026年9月22日のリリースで、claude-opus-5のOpus 5はその1つ前の世代です。
| 項目 | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| 標準のAPI定価(100万トークン、入力 / 出力) | $2 / $10(272K以下) | $4 / $20(1Mまで同じ) |
| 長い入力の割増 | 272K超はリクエスト全体が$4 / $15 | なし |
| 入力の上限 | 最大入力922,000トークン(コンテキスト1,050,000) | コンテキスト1M |
| 最大出力 | 128,000トークン | 128K(Message Batchesのベータでは300K) |
| 速度モード | Fast(2倍の単価)、Ultrafast(6倍の単価、10月8日開始) | Fast mode(2倍の単価、リサーチプレビュー) |
| 推論強度 | low / medium(既定) / high / xhigh / max。noneとminimalは不可 | low / medium(既定) / high / xhigh / max。適応型の思考は常に有効 |
| Artificial Analysisのスコア | low 42、medium 48、max 52 | low 42、medium 51、max 58 |
| 1タスクの出力トークン(medium) | 約8k | 約26k |
| 標準速度での出力速度(medium) | 52トークン/秒 | 79トークン/秒 |
| 最初の回答トークンまで(medium) | 5.93秒 | 21.89秒 |
| 提供先 | OpenAI API、ChatGPTのWorkとCodex | Claude API、Amazon Bedrock、Google Cloud、Microsoft Foundry、Claude Platform on AWS、Claudeアプリ、Claude Code |
| 知識のカットオフ | 2026年4月30日 | 2026年6月 |
仕様の出典は、OpenAIのモデルページと料金表、AnthropicのOpus 5.5の概要と料金ページです。GPT-6.1 Solでツール呼び出しを使うにはResponses APIが必要で、Chat Completionsはツール呼び出しなしでのみ対応しています。
API料金:272K以下はSolが半額、900K入力では差が約1%
標準の各単価は、272Kトークン以下ならGPT-6.1 SolがOpus 5.5のちょうど半額です。
| 100万トークンあたり | GPT-6.1 Sol | Opus 5.5 |
|---|---|---|
| 入力 | $2 | $4 |
| キャッシュ読み取り | $0.10 | $0.20 |
| キャッシュ書き込み | $2.50 | $5(5分)、$8(1時間) |
| 出力 | $10 | $20 |
| Batch(入力 / 出力) | $1 / $5 | $2 / $10 |
| 272K超の入力 / 出力 | $4 / $15 | $4 / $20(割増なし) |
キャッシュ読み取りはどちらも入力単価の5%で、割引率は同じです。データ所在地を指定するエンドポイントはSolが10%増し、Opus 5.5の米国内推論(inference_geo)は1.1倍です。OpenAIの料金表で「少なくとも2026年11月21日まで」と注記されているプロモーション価格はGPT-5.6 Solのもので、GPT-6.1 Solの単価には付いていません。Opus 5.5の料金と移行時の注意はClaude Opus 5.5の料金と使い方:Opus 5からの移行で確認することにまとめています。
272Kを超えたとき:900K入力の請求はSol $3.75、Opus 5.5 $3.80
GPT-6.1 Solは、入力が272Kトークンを超えたリクエスト全体に入力2倍・キャッシュ2倍・出力1.5倍の単価がかかります。ちょうど272,000トークンまでは短い側の単価です。Opus 5.5は1Mトークンまで同じ単価です。キャッシュなしで計算すると次のようになります。
| 入力 / 出力 | GPT-6.1 Sol | Opus 5.5 | Solが安い割合 |
|---|---|---|---|
| 272,000 / 20,000 | 0.272 × $2 + 0.02 × $10 = $0.744 | 0.272 × $4 + 0.02 × $20 = $1.488 | 50% |
| 273,000 / 20,000 | 0.273 × $4 + 0.02 × $15 = $1.392 | 0.273 × $4 + 0.02 × $20 = $1.492 | 約7% |
| 300,000 / 20,000 | 0.3 × $4 + 0.02 × $15 = $1.50 | 0.3 × $4 + 0.02 × $20 = $1.60 | 約6% |
| 900,000 / 10,000 | 0.9 × $4 + 0.01 × $15 = $3.75 | 0.9 × $4 + 0.01 × $20 = $3.80 | 約1% |
入力が1,000トークン増えて272Kを超えただけで、Solのリクエストは$0.744から$1.392へ$0.648(87%)上がります。境界付近で動く処理は、不要な履歴やファイルを削って272K以下に収める価値があります。
900Kトークン前後の入力は、Solの最大入力922,000トークンに近い大きさです。それを超える入力はSolでは送れず、1Mまで受け付けるOpus 5.5に分があります。速度モードでは差の向きが変わり、同じ900,000 / 10,000をSol Ultrafastで送ると0.9 × $24 + 0.01 × $90 = $22.50、Opus 5.5のFast modeは割増がないので0.9 × $8 + 0.01 × $40 = $7.60で、約3倍の開きになります。
速度モードの料金:Sol UltrafastはOpus Fast modeの1.5倍
Sol FastとSol Ultrafast、Opus 5.5のFast modeは、別のモデルではありません。同じモデルを高い単価で速く動かす処理モード(サービスティア)です。
| モード | 100万トークンあたり(入力 / キャッシュ読み取り / 出力) | ベンダーが示す速さ | 使える人と場所 |
|---|---|---|---|
| Sol 標準 | $2 / $0.10 / $10 | 基準 | API利用者全員 |
| Sol Fast | $4 / $0.20 / $20(長文 $8 / $0.40 / $30) | 料金表に倍率の記載なし | 料金表の処理ティア(7月30日にPriority processingから改称) |
| Sol Ultrafast | $12 / $0.60 / $60(長文 $24 / $1.20 / $90) | 標準の最大8倍(出力生成) | API利用者全員(Responses APIのみ、専用のレート制限)。CodexとChatGPT WorkではPro $500と対象のEnterprise/Eduのみ |
| Opus 5.5 標準 | $4 / $0.20 / $20 | 基準 | Claude APIと各クラウド |
| Opus 5.5 Fast mode | $8 / $0.40 / $40(全コンテキストで同じ) | 出力トークン/秒が最大2.5倍 | Claude APIのみのリサーチプレビュー(ウェイトリスト制)。Claude Codeでは/fastを使用量クレジットで |
Ultrafastの単価はOpenAIの料金表、使い方はUltrafast modeのガイド、Opus側はFast modeのドキュメントにあります。キャッシュ書き込みはSol Fastが$5、Sol Ultrafastが$15です。Opus 5.5 Fast modeのキャッシュ読み取り$0.40は、表に載った行ではなく「キャッシュの倍率はFast modeの単価にさらに掛かる」という説明から、入力$8の5%として計算した値です。
同じリクエストの請求額:Ultrafastは標準の6倍
トークン数が同じと仮定し、キャッシュ書き込みを除いて2通りのリクエストを計算します。
| モード | A:入力100,000、出力10,000(キャッシュなし) | B:新規入力50,000+キャッシュ読み取り200,000、出力10,000 |
|---|---|---|
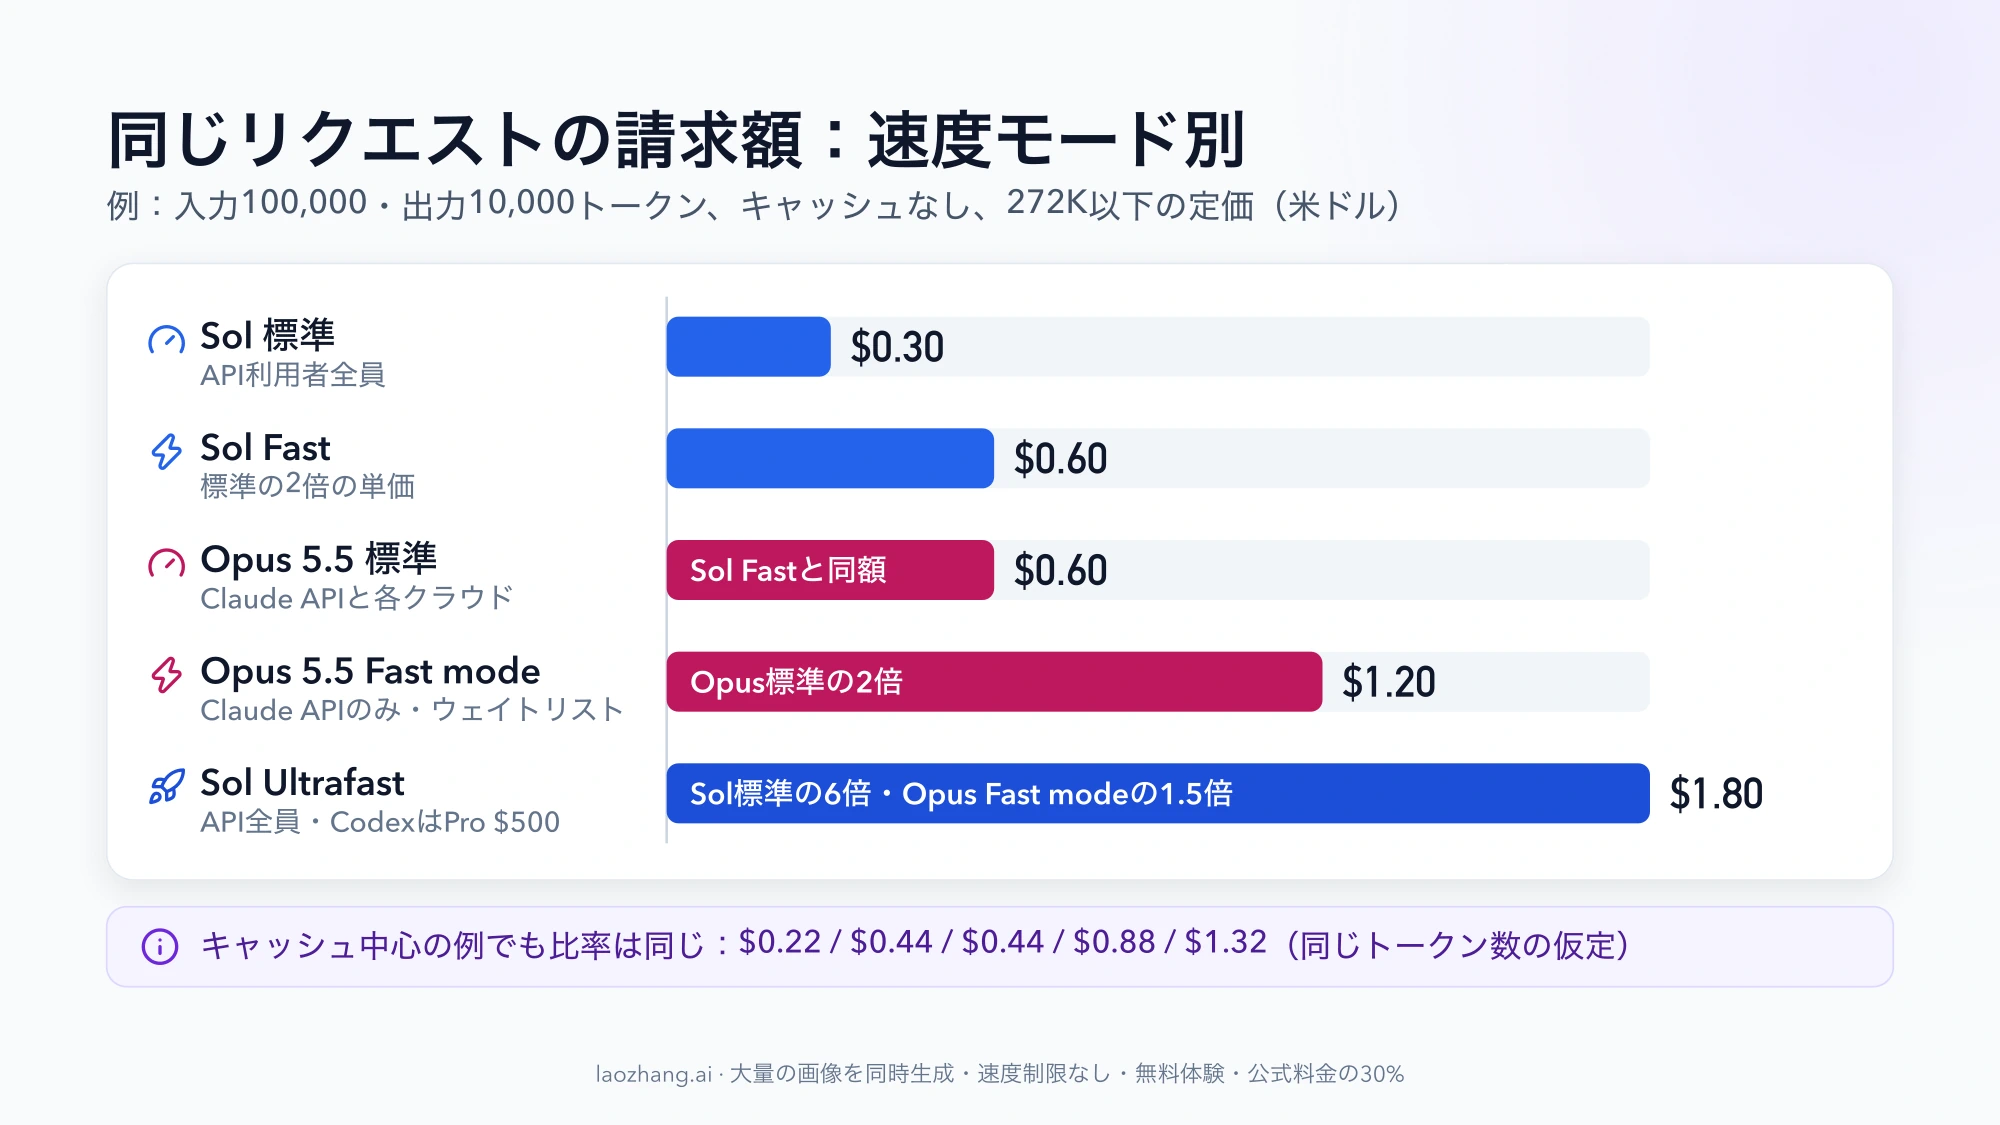
| Sol 標準 | 0.1 × $2 + 0.01 × $10 = $0.30 | 0.05 × $2 + 0.2 × $0.10 + 0.01 × $10 = $0.22 |
| Sol Fast | 0.1 × $4 + 0.01 × $20 = $0.60 | $0.44 |
| Opus 5.5 標準 | 0.1 × $4 + 0.01 × $20 = $0.60 | 0.05 × $4 + 0.2 × $0.20 + 0.01 × $20 = $0.44 |
| Opus 5.5 Fast mode | 0.1 × $8 + 0.01 × $40 = $1.20 | 0.05 × $8 + 0.2 × $0.40 + 0.01 × $40 = $0.88 |
| Sol Ultrafast | 0.1 × $12 + 0.01 × $60 = $1.80 | 0.05 × $12 + 0.2 × $0.60 + 0.01 × $60 = $1.32 |
どちらの組み合わせでも、Sol FastはOpus 5.5標準と同額、Sol UltrafastはOpus 5.5 Fast modeの1.5倍、Opus 5.5標準の3倍、Sol標準の6倍です。
ただし、実際の作業では「同じトークン数」になりません。Opus 5.5は1タスクで約3倍の出力トークンを書くため(次の節)、タスク単位の比較は変わります。Artificial Analysisのmediumのタスク単価$0.21に6倍を掛けると、Sol Ultrafastでの1タスクはおよそ$1.26で、Opus 5.5標準の$1.34とほぼ並びます。Ultrafastでも標準と同じ量のトークンを書くと仮定した概算です。
Sol UltrafastとOpus Fast modeで何秒速くなるか
2026年10月10日時点で、どちらの速度モードについても第三者が計測した1秒あたりのトークン数は公開されていません。「最大8倍」と「最大2.5倍」はそれぞれ自社の標準速度に対するベンダーの上限値で、基準が違うため、並べて比べたり秒数に換算したりはできません。
標準速度での計測値なら、Artificial Analysisにあります。mediumでは出力速度がOpus 5.5の79.2トークン/秒に対しSolが52.4トークン/秒で、最初の回答トークンが届くまではSolが5.93秒、Opus 5.5が21.89秒です。Opus 5.5は流れ出すと速く、Solは返し始めるのが早いという違いです。AnthropicによるとOpusのFast modeの効果は出力速度に向けたもので、最初のトークンまでの時間を縮めるものではありません。
運用上の注意も1つずつあります。Opus 5.5は標準とFast modeを切り替えるとプロンプトキャッシュが共有されず、キャッシュミスになります。Sol Ultrafastはservice_tier: "ultrafast"をResponses APIで指定し、OpenAIは速さを保つためにWebSocket接続を勧めています。
「OpenAIがSolを約50%高速化」はAPIの話ではない
2026年10月5日、OpenAIのTibo Sottiaux氏が、GPT-6 AstraとGPT-6.1 Solの既定の速度をサブスクリプション経由で約50%速くしたとXに投稿しました。対象はChatGPTのサブスクリプションと、「Sign in with ChatGPT」でつなぐ製品です。投稿にはAPIへの言及も、1秒あたりのトークン数もなく、APIの変更履歴にも該当する項目はありません。APIの速度比較に使える数字ではありません。
Sol Ultrafast単体の詳しい料金と、GPT-6 Astra版との違いはOpenAI UltrafastとSolの違い:Sol版は$12/$60でAstra版の5分の1で扱っています。
AIのトークン数比較:Opus 5.5は1タスクで約3倍を出力する
定価の差が2倍なのにタスク単価の差が4〜9倍に開くのは、Opus 5.5が同じ課題に対して多くのトークンを出力するからです。Artificial Analysisが自社の評価課題一式(Intelligence Index)を解かせたときの数字は次のとおりです(medium同士、max同士)。
| 指標 | Sol(medium) | Opus 5.5(medium) | Sol(max) | Opus 5.5(max) |
|---|---|---|---|---|
| 1タスクの出力トークン | 8k | 26k | 38k | 119k |
| うち推論トークン | 3k | 12k | 25k | 84k |
| タスクあたりの費用(cost per task) | $0.21 | $1.34 | $0.72 | $5.98 |
| 指数全体の実行費用(cost to run the index) | $361 | $1,627 | $1,082 | $8,708 |
出力トークンはどちらの組でもOpus 5.5が約3.1〜3.3倍です。出力単価2倍に出力量約3倍を掛けると約6倍になり、mediumのタスク単価の比6.4倍とほぼ合います。タスクあたりの費用と指数全体の実行費用では倍率が違い(mediumで6.4倍と4.5倍)、どちらの指標の話かで数字が変わる点に注意してください。
Vals Indexでも傾向は同じで、評価全体で使われたトークンはOpus 5.5が入力285.7億・出力4.78億、GPT-6.1 Solが入力45.0億・出力1.05億でした(Vals Index)。
トークナイザーの違いも残ります。Anthropicは、Claude 4.7以降のトークナイザーが同じ文章で以前より約30%多くトークンを数えると説明していますが、OpenAIのトークナイザーとの比率は公開されていません。自分の文書でどれだけ差が出るかは、各APIのusageフィールドで実際に測るのが確実です。出力量を左右する推論強度の選び方はClaude Opus 5.5のeffort設定:5段階の選び方と費用・キャッシュへの影響が参考になります。
Artificial Analysisの強度別スコア:low同点、maxでOpusが6点上
Artificial Analysisは両モデルを5段階の推論強度すべてで計測しています(強度別の比較ページ、2026年10月10日時点の値)。Opus 5.5の行は、拒否されたリクエストを別のClaudeモデルが代わりに処理した分を含む設定(Default Fallback)での計測です。
| 推論強度 | Intelligence Index(Sol / Opus 5.5) | 差 | タスク単価(Sol / Opus 5.5) | 費用の倍率 | 出力速度(トークン/秒) | 最初の回答トークンまで |
|---|---|---|---|---|---|---|
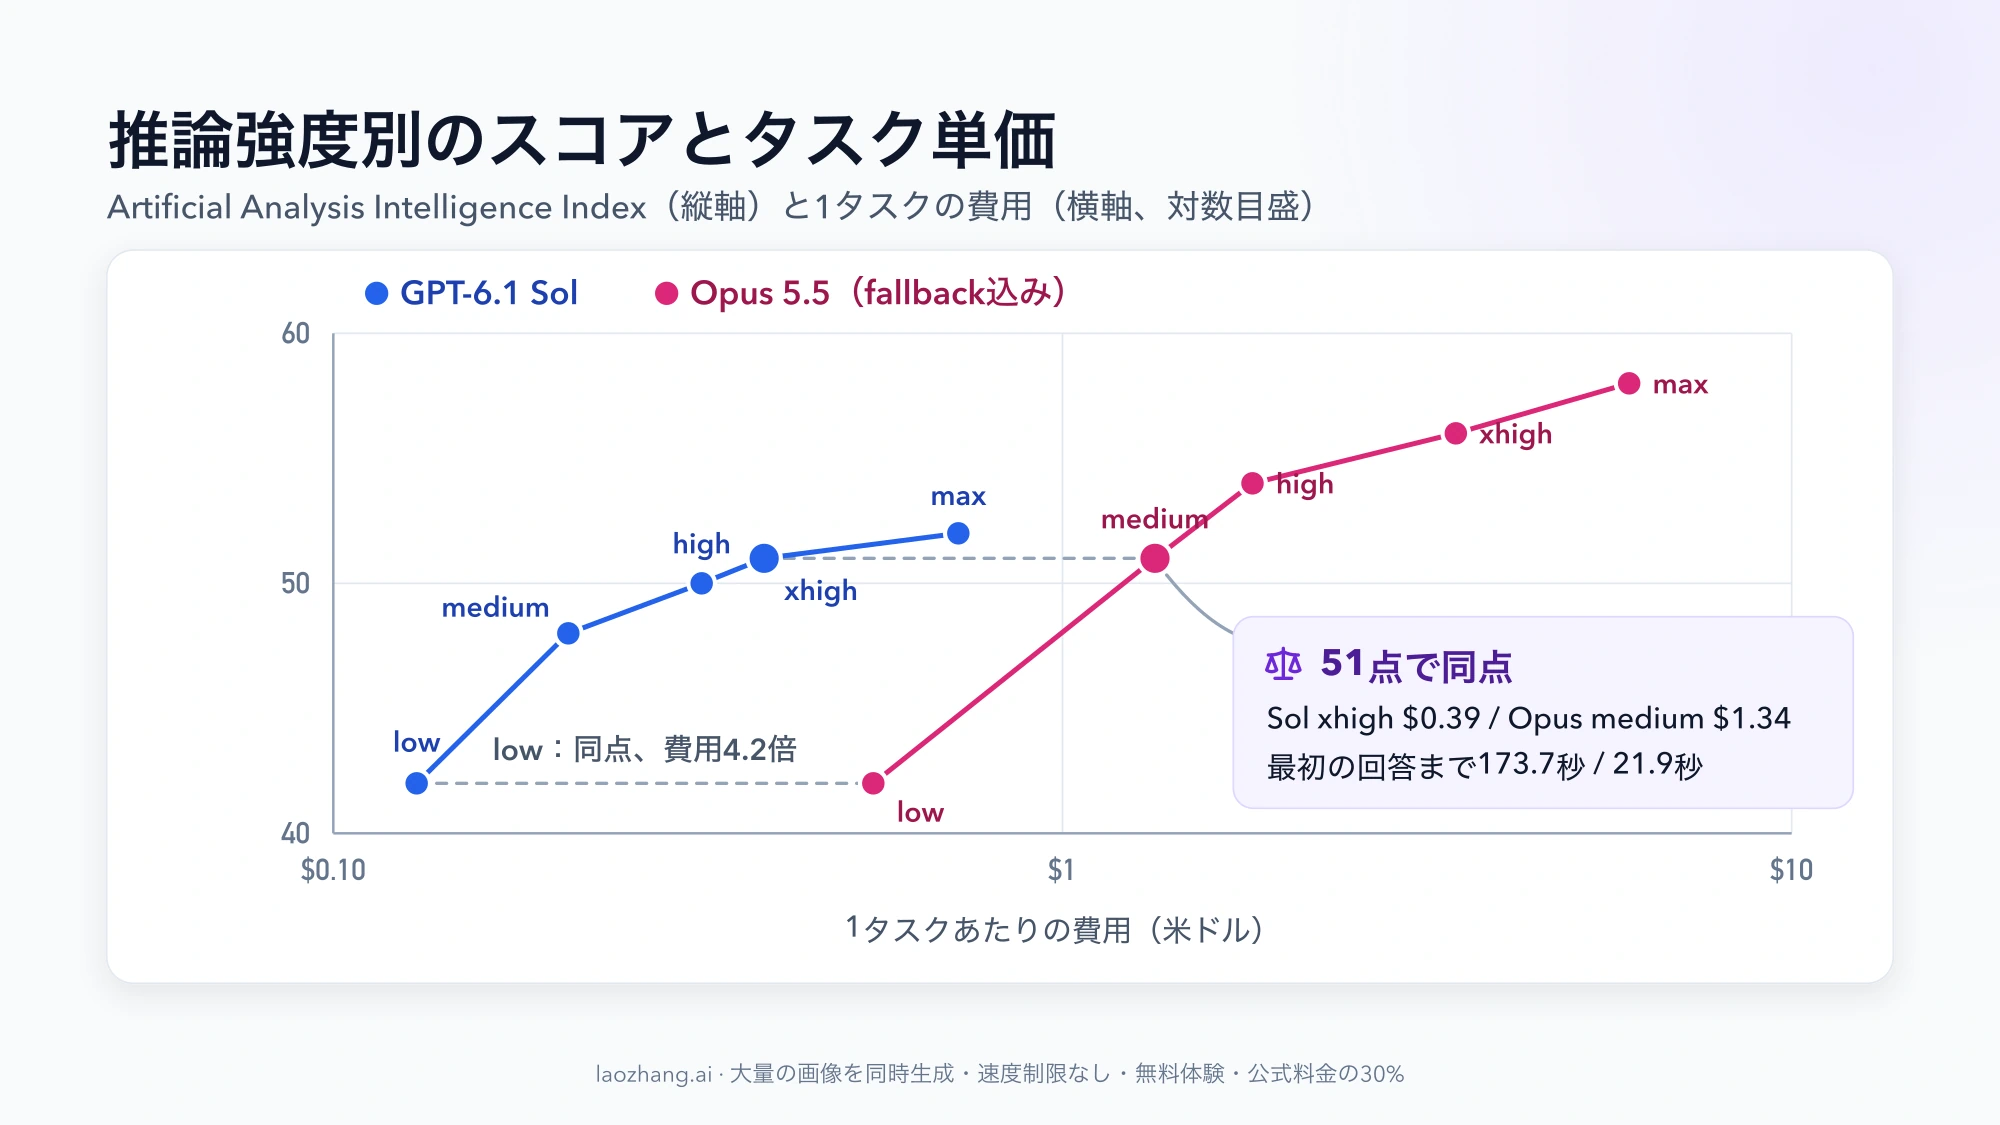
| low | 42 / 42 | 0 | $0.13 / $0.55 | 4.2倍 | 51 / 78 | 3.04秒 / 8.70秒 |
| medium | 48 / 51 | 3 | $0.21 / $1.34 | 6.4倍 | 52 / 79 | 5.93秒 / 21.89秒 |
| high | 50 / 54 | 4 | $0.32 / $1.82 | 5.7倍 | 53 / 80 | 62.25秒 / 39.56秒 |
| xhigh | 51 / 56 | 5 | $0.39 / $3.46 | 8.9倍 | 55 / 83 | 173.70秒 / 127.85秒 |
| max | 52 / 58 | 6 | $0.72 / $5.98 | 8.3倍 | 59 / 97 | 309.04秒 / 704.18秒 |
この表から読めることは3つあります。
- 強度を上げるほどスコア差が開きます。lowでは同点なので、Opus 5.5を選ぶと同じスコアに4.2倍の費用を払うことになります。
- 強度をまたいで比べると、Solのxhigh(51、$0.39)はOpus 5.5のmedium(51、$1.34)と同点で、タスク単価は約3.4分の1です。ただし最初の回答トークンまで173.7秒かかり、Opus 5.5のmediumの21.9秒の約8倍待ちます。Solのmax(52、$0.72)もOpus 5.5のmediumを1点上回り、費用は54%です。待ち時間が問題にならないバッチ処理なら、この組み合わせは試す価値があります。
- 内訳では強度ごとに結果が分かれます。Terminal-Bench 4.0はmediumでSol 48.0%対Opus 5.5 52.5%、maxで56.1%対59.6%とOpus 5.5が上です。一方、GDP.pdfでは5段階すべてでSolがOpus 5.5を上回っています(highで32.0%対28.8%)。
出力速度は計測時の負荷で動き、10月初めから値が変わっています。発表直後の計測で、今後も更新される前提で読んでください。
Vals Indexでは5.82ポイント差、fallbackを失敗扱いにすると3.90ポイント
Vals Index v2.1(2026年10月7日更新)では、Opus 5.5が66.97%、GPT-6.1 Solが61.15%でした。テスト1件あたりの費用はOpus 5.5が$32.14、Solが$3.24で約9.9倍、所要時間は1時間19分と43分10秒です。Valsの注記によると、Opus 5.5のスコアには、拒否のあと代替モデルが処理した課題が含まれています。それを失敗として数えると65.05%に下がり、Solとの差は3.90ポイントに縮みます。
同じ表ではClaude Sonnet 5.5が67.04%で、Opus 5.5とほぼ並び、テスト1件あたりの費用は$21.34です。各行の推論強度は表に記載がありません。
OpenAIの発表値:mediumではSol、maxではOpus 5.5
OpenAIはGPT-6.1 Solの発表で、Opus 5.5と並べた結果を示しています。課題と設定を選んだのはOpenAIで、Opus 5.5の数字は同社が自分で走らせたものではなく公開されている報告から取ったと脚注にあり、Opus 5.5は「fallbackあり」と表記されています。
| 評価 | 設定 | GPT-6.1 Sol | Opus 5.5 |
|---|---|---|---|
| GDP.pdf | high | 32.0%($0.35) | 28.8%($0.83) |
| AutomationBench 1.0.6 | medium | 31.7%($0.19) | 29.5%($0.65) |
| AutomationBench 1.0.6 | max | 36.1%($0.30) | 42.5%($1.44) |
| Terminal-Bench Science 0.1 | max | 57.0%($5.47) | 63.3%($23.21) |
括弧内はタスクあたりの費用です。mediumとhighではSolが上で費用は半分以下、maxではOpus 5.5が6ポイント台上で費用は4倍以上という構図で、第三者の計測と同じ方向です。Anthropic側の発表表(Terminal-Bench 4.0で66.4%など)にはGPT-6.1 Solの行がなく、発表値どうしを直接比べることはできません。
Opus 5.5の行に付く「fallback」とは
Opus 5.5には安全分類器があり、リクエストを断ることがあります。そのときAPIはstop_reason: "refusal"を返します。呼び出し側がベータ機能のサーバー側fallback(fallbacks: "default")を指定していれば、同じリクエストが別のClaudeモデルで再実行され、その分はそのモデルの単価で課金されます(Refusals and fallback)。Anthropicは、サイバーセキュリティ関連の大半のタスクをOpus 4.8に回すとしています。
つまり、第三者の表にあるOpus 5.5のスコアと費用には、別モデルが出した結果が一部混ざっています。出力前の拒否が課金されるのはbio、frontier_llm、reasoning_extractionの3カテゴリだけです(2026年9月24日以降)。頻度は作業内容によるので、セキュリティ寄りの処理が多い場合は、応答のmodelフィールドを記録して、実際にどのモデルが答えたかを確かめてください。
既定モデルを替えるかの計算:合格1件あたりの費用 =(c + R)÷ p
スコアとタスク単価を別々に見ても結論は出ません。自分の作業で試した数字を1つの式に入れます。
1回の試行のAPI費用をc、1回ごとに人が確認する費用をR、合格率をpとし、合格するまでやり直すとすると、次のようになります。
合格1件あたりの費用 = (c + R) ÷ p
Opus 5.5が安くなる条件:p_opus ÷ p_sol > (c_opus + R) ÷ (c_sol + R)
cにArtificial Analysisのmediumのタスク単価(Sol $0.21、Opus 5.5 $1.34)を入れると、確認の手間によって結論がまったく違います。
| 条件 | 必要な合格率の比 | 意味 |
|---|---|---|
| 確認は自動、人の手間ゼロ(R = 0) | 1.34 ÷ 0.21 ≒ 6.38 | Opus 5.5が必ず合格しても、Solの合格率が1 ÷ 6.38 ≒ 15.7%を下回らない限りSolが安い |
| 1回の確認に$5(時給$60の人が5分) | 6.34 ÷ 5.21 ≒ 1.217 | Solの合格率が70%なら、Opus 5.5は85.2%を超えれば安い |
2つ目の場合を両側で確かめます。
- Opus 5.5の合格率90%:6.34 ÷ 0.9 = $7.04。Solは5.21 ÷ 0.7 = $7.44で、Opus 5.5が安い
- Opus 5.5の合格率80%:6.34 ÷ 0.8 = $7.93。Solは$7.44で、Solが安い
人の確認が費用の大半を占める作業では、API料金の6倍差はほとんど効かず、合格率の十数ポイントの差で結論が入れ替わります。速度モードを使う場合はcをその単価に置き換えます。たとえばSol Ultrafastなら、上の概算どおりcは約$1.26になり、R = 0でもOpus 5.5標準との費用差はほぼなくなり、合格率がわずかでも高いほうが安くなります。
ここでの70%や$5は計算例で、cもRもpも自分の値を入れて使います。各試行が独立で、確認時間が毎回同じという単純化もしています。手順は、代表的な課題を10〜20件選び、両モデルに同じ推論強度で解かせ、usageから1件あたりの費用を、結果から合格率を出して式に入れるだけです。
Codex・Claude Code・月額20ドルのプランで使う場合
月額プランでは、両社とも使える回数を数字で公表していないため、量で比べることはできません。
| 項目 | ChatGPT(GPT-6.1 Sol) | Claude(Opus 5.5) |
|---|---|---|
| 月額20ドルのプラン | Plus $20。GPT-6.1 SolはWorkとCodexで使え、通常のチャット(Chat)にはない | Pro $20(年払いなら月$17)。Opus 5.5とClaude Codeが使える |
| 上限の目安 | Plusのローカルメッセージは5時間あたり15〜160の推定幅 | Opus 5.5の具体的な回数は非公開 |
| 上位プラン | Pro $100 / $200 / $500。Proには5時間の上限がない | Max $100から(Proの5倍または20倍) |
| 速度モード | UltrafastはPro $500と対象のEnterprise/Eduのみ。含まれる使用量を標準の8倍、クレジットを6倍の速さで消費し、ほかのプランはクレジットを買っても使えない | Claude Codeの/fastはPro/Max/Team/Enterpriseで使えるが、プランの上限ではなく使用量クレジットからのみ課金 |
出典はChatGPTの料金ページ、Proの各プランの説明、Claudeの料金ページ、Claude Codeのfast modeです。
変更点が2つあります。OpenAIのヘルプセンターによると、新しく契約するPro 200は以前より少ない使用量になり、価格は月$200のままです。2026年9月22日から9月29日(太平洋時間午前10時)の間に契約が有効だった人は、10月29日まで従来の使用量を使えます。どれだけ減ったかの数字は公表されていません。Claude側では、MaxとTeamに月$100〜$200のAPIクレジットが付くようになりました。受け取り方はClaude MaxのAPIクレジット:受け取り方とClaude Codeで使える条件にあります。
調査会社SemiAnalysisは2026年10月6日の記事で、エージェント作業ではClaudeのプランがGPT-6.1 Solのプランより「API換算で約5倍」(別の箇所では約4倍)の価値があると推計しています。これは使用量メーターの動きを自社の作業構成のAPI定価で換算したもので、Opus 5.5のトークン単価がもともと2倍であるぶん大きく出ます。「5倍の作業ができる」という意味ではありません。
月額料金をAPI単価で割って「何回分」と見積もる方法は成り立たないので、選ぶ基準は使う場所と作業の形になります。Codexでコーディングエージェントを回すならChatGPT側、チャットでも同じモデルを使いたいならClaude側が合います(GPT-6.1 SolはChatGPTのチャットにありません)。上限への当たり方は、小さな作業を数多く回すか大きな作業を数件こなすかで変わるため、1か月ずつ試して5時間の枠がどこまで持つかを見るのが確実です。GPT-6系のCodexでの数え方はGPT-6 SolとLunaの料金比較:APIとCodexでどう違う?にあります。
既存のコードを切り替えるときの変更点
GPT-6 SolからGPT-6.1 Solへ
モデルIDをgpt-6-solからgpt-6.1-solに替えます。入力$2・出力$10と272Kの割増ルールは同じで、キャッシュ入力が$0.20から$0.10に下がります。
注意するのは推論強度です。gpt-6.1-solはnoneとminimalを受け付けません。GPT-6 Solで推論を切っていた呼び出しはlow以上に変える必要があり、そのぶん出力トークンと応答時間が増える可能性があります。ツール呼び出しはResponses APIで行います。APIの利用ティアは10月6日に5段階からBuild、Launch、Growの3段階に整理され、Solの標準のレート制限はBuildで毎分5,000リクエスト・100万トークンです。
OpenAIのモデルからOpus 5.5へ
Opus 5.5へ移す、または併用する場合は、次の2点がエラーの原因になります(Anthropicのリリースノート)。
- 思考は無効にできません。
thinking: {"type": "disabled"}や{"type": "enabled", ...}は400エラーになるので、thinkingを省き、深さはeffortで調整します。 tool_choiceのanyとtoolは400エラーになります。autoと厳密なツール使用(strict tool use)で代替します。
旧世代のSolと比べた場合の費用の分かれ方はClaude Opus 5.5とGPT-5.6 Sol比較:費用が分かれる条件にあります。
GPT-6.1 SolとOpus 5.5についてのよくある質問
GPT-6.1 Solの料金は期間限定のプロモーション価格ですか
いいえ。OpenAIの料金表で、GPT-6.1 Solの単価にプロモーションの表示はありません。「少なくとも2026年11月21日まで」という注記はGPT-5.6 Solに付いているものです。GPT-6.1 Solの現在の単価がいつまで続くかは公表されていません。
GPT-6.1 Sol Ultrafastはいくらですか
100万トークンあたり入力$12、キャッシュ入力$0.60、キャッシュ書き込み$15、出力$60です(入力272Kトークン以下)。272Kを超えると$24 / $1.20 / $30 / $90になります。標準のちょうど6倍で、2026年10月8日からResponses APIでservice_tier: "ultrafast"を指定して使えます。APIは利用者全員が対象ですが、CodexとChatGPT WorkではPro $500と対象のEnterprise/Eduに限られます。単価が2倍のFastモード($4 / $20)とは別のモードです。
Opus 5.5のほうが賢いなら、常にOpus 5.5を使うべきですか
いいえ。Artificial Analysisでのスコア差は、同じ推論強度で0〜6ポイントです。その差が自分の作業の合格率にどれだけ現れるかで決まります。合否を自動で判定できる作業では、Solの合格率が約16%を下回らない限りSolのほうが安く、人の確認に時間がかかる作業では合格率の差が十数ポイントあればOpus 5.5が安くなります。
GPT-6.1 Solの推論強度を上げれば、Opus 5.5のmediumの代わりになりますか
スコアだけならなります。Artificial Analysisでは、Solのxhighが51でOpus 5.5のmediumと同点、タスク単価は$0.39対$1.34です。ただし最初の回答トークンまでの時間は173.7秒対21.9秒で、Solのほうが大幅に待ちます。待ち時間が問題にならないバッチ処理向けの組み合わせです。
GPT-6.1 SolはChatGPTのチャットで使えますか
使えません。GPT-6.1 Solが使えるのはChatGPTのWorkとCodexで、Plus、Pro、Business、Enterprise、Eduが対象です。10月7日からチャット(Chat)に入ったのはGPT-6で、有料プランの中身はGPT-6 Sol、無料プランとGoはGPT-6 Lunaです(OpenAIの発表)。GPT-6系をChatGPTで使う場所の違いはGPT-6 Astraの使い方:PlusはWorkとCodexで、Chatには出ないにあります。
GPT-6.1 SolとOpus 5.5以外の選択肢はありますか
あります。Claude Sonnet 5.5はGPT-6.1 Solと同じ入力$2・出力$10で、Vals Indexでは67.04%とOpus 5.5の66.97%をわずかに上回っています。品質を最優先するならOpenAI側の最上位はGPT-6 Astra($10 / $50)です。Gemini 4 Argonも含めた比較はGemini 4 ArgonとOpus 5.5・Sonnet 5.5の使い分けにあります。
GPT-6.1 SolとOpus 5.5のAPI料金は日本円でいくらになりますか
両社のAPI料金は米ドル建てです。円での請求額は請求時の為替、決済方法、税の扱いで変わるため、各社のコンソールの請求画面で確認してください。