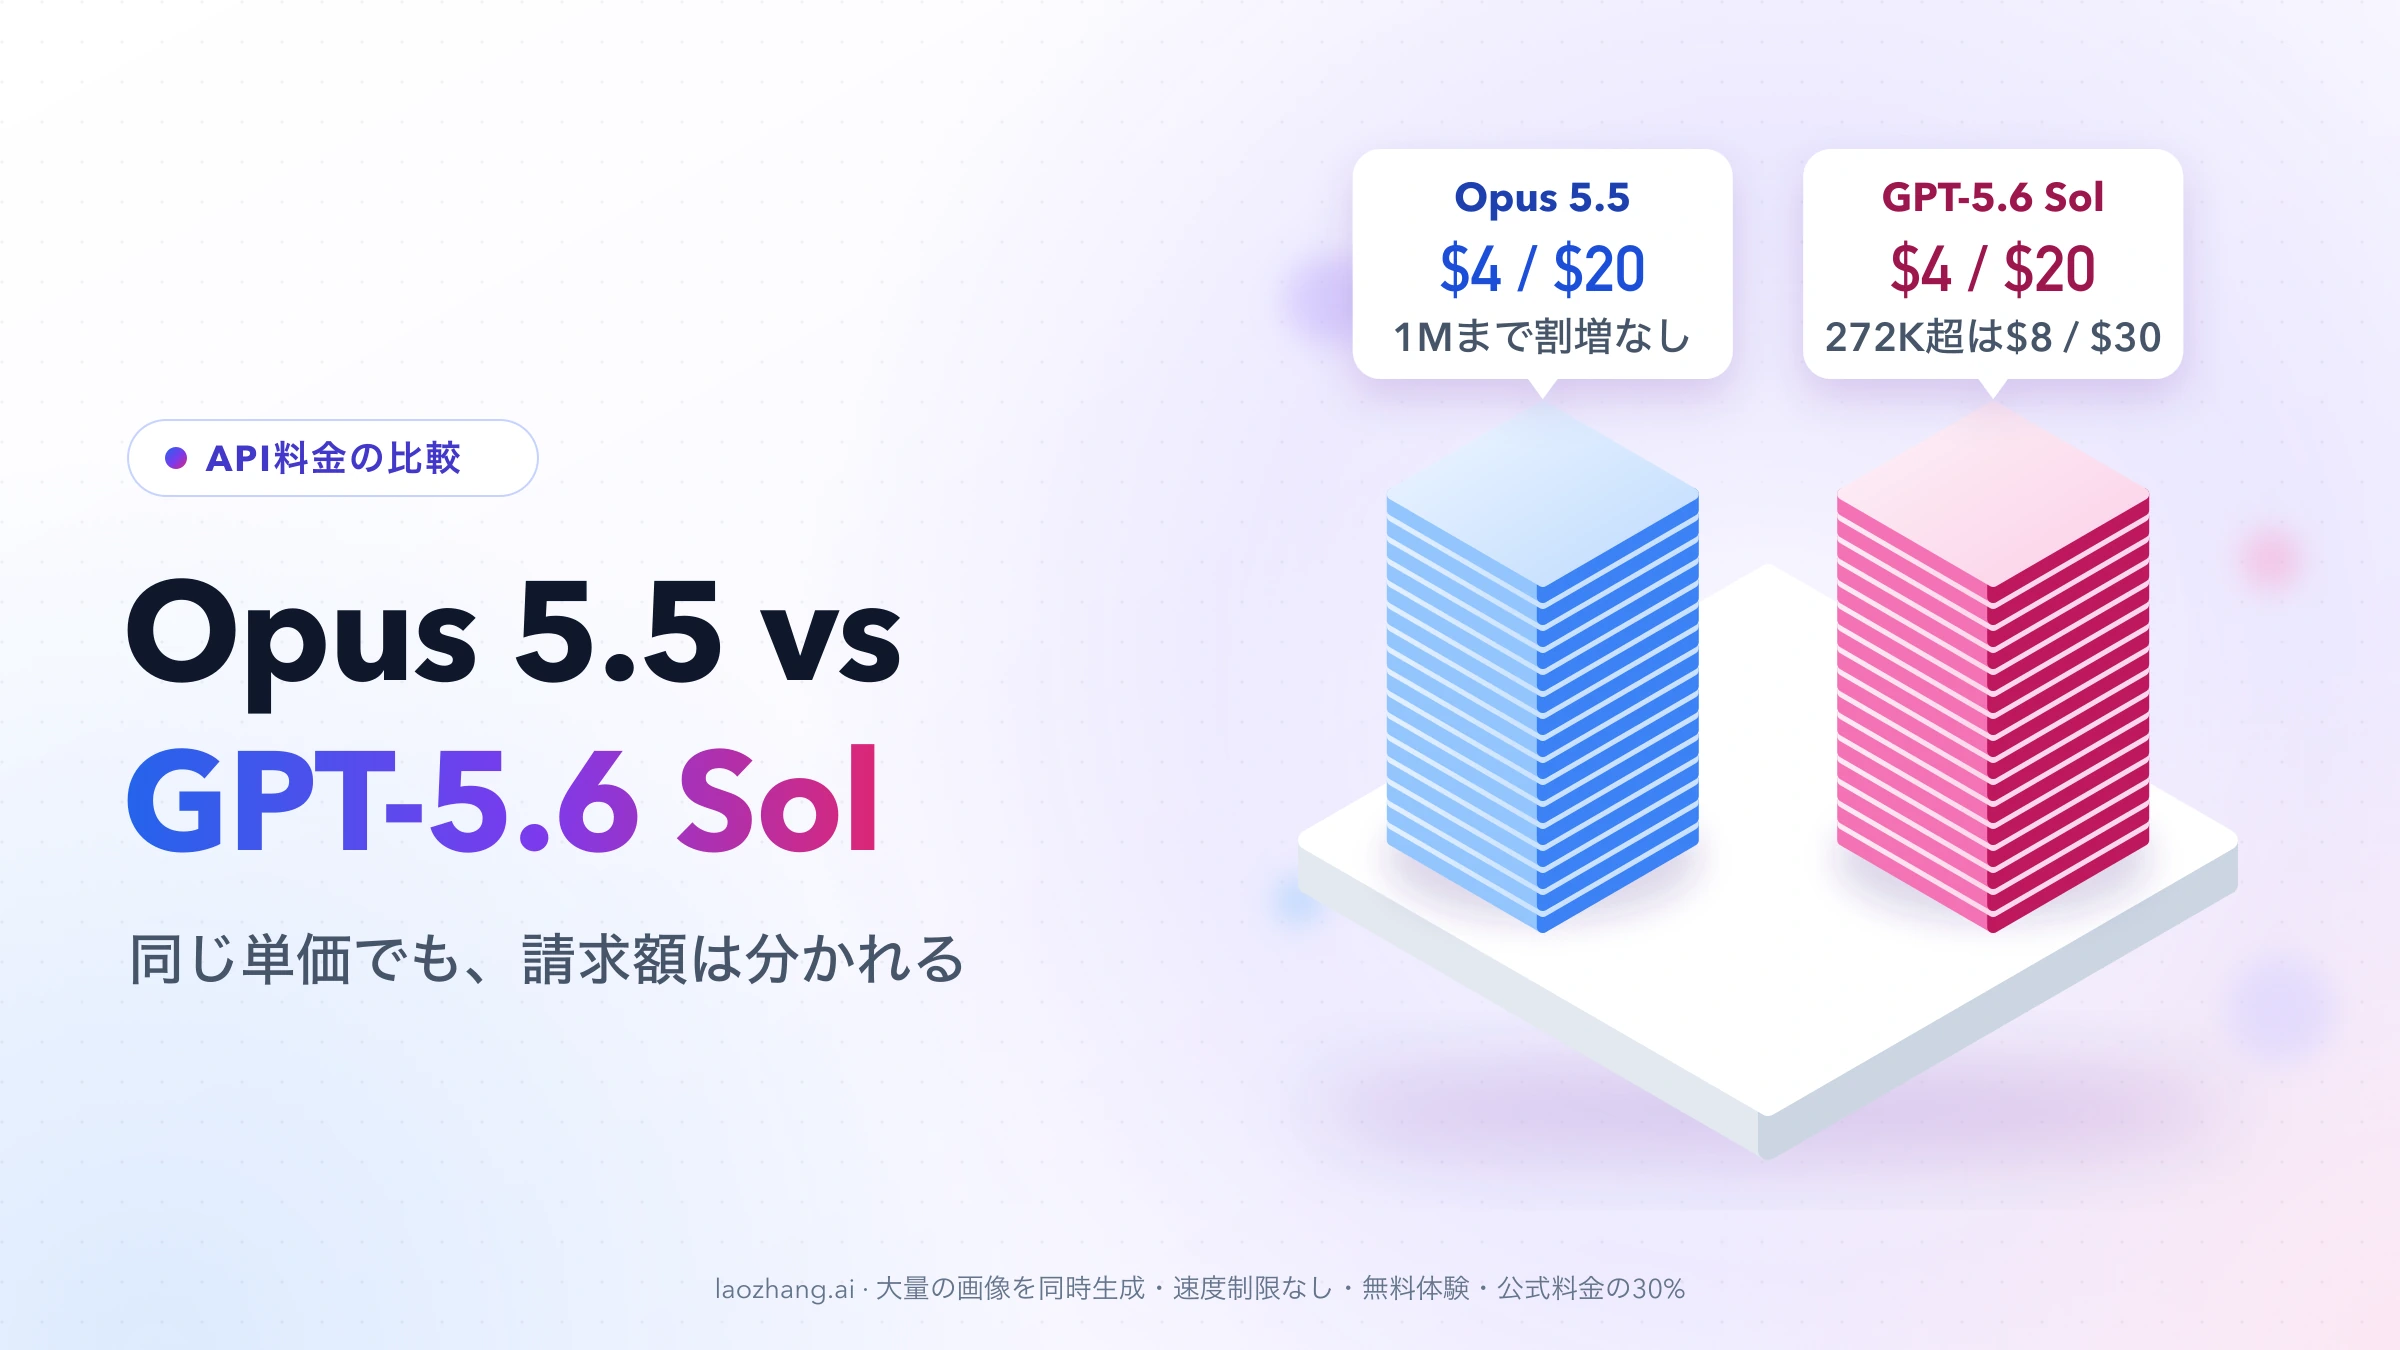
2026年9月24日時点で、Claude Opus 5.5(claude-opus-5-5)とGPT-5.6 Sol(gpt-5.6-sol)の直販APIの標準単価は、どちらも100万トークンあたり入力$4・出力$20です。ただしGPT-5.6 Solのこの単価は、OpenAIが「少なくとも2026年11月21日まで」と表示しているプロモーション価格です。単価が同じでも、請求額は次の3点で分かれます。
- 入力が272Kトークンを超えるか:GPT-5.6 Solはリクエスト全体が長文用の単価になり、Opus 5.5は1Mトークンまで同じ単価です。
- キャッシュ読み取りが多いか:Opus 5.5は$0.20、GPT-5.6 Solは$0.40です。
- 出力と推論がどれだけ長くなるか:独立系の測定では、Opus 5.5のほうがタスクあたりの出力トークンが多く出ています。
もう1つ、GPT-5.6 Solを使っている人には判断を変える材料があります。Opus 5.5と同じ2026年9月22日にOpenAIが出したGPT-6 Sol(gpt-6-sol)は、全課金項目がGPT-5.6 Solの半額です。
| 自分の使い方 | 先に試すモデル | 理由 |
|---|---|---|
| 272Kトークンを超える入力を送る | Opus 5.5(OpenAIに残るならGPT-6 Sol) | GPT-5.6 Solはリクエスト全体が入力$8・出力$30になる |
| 長い共通部分をキャッシュして繰り返し読む | Opus 5.5またはGPT-6 Sol | キャッシュ読み取りは両者$0.20、GPT-5.6 Solは$0.40 |
| プロンプトは短く、出力や推論が長くなる | GPT-5.6 SolまたはGPT-6 Sol | Opus 5.5(medium)はGPT-5.6 Sol(high)の約2倍の出力トークンを使う測定がある |
| 難しい長時間のエージェント作業で、合格率を最優先する | Opus 5.5を候補に加えて試験する | 独立系の指標ではOpus 5.5のスコアが高い。ただし評価者は1社 |
| GPT-5.6 Solで運用中で、品質に不満はない | まずGPT-6 Sol | エンドポイントとeffortの段階が同じまま単価が半分。品質が同等かは自分のタスクで確認する |
どれを選ぶにしても、最後は単価ではなく「合格した成果1件あたりのコスト」で決めます。測り方は後半の試験手順にまとめました。
単価の比較:GPT-5.6 Solの$4/$20はプロモーション価格
3モデルの直販APIの標準(Standard)単価です。単位はすべて米ドル/100万トークンで、GPT系は入力が272K以下と272K超の2段階を「272K以下 / 272K超」の順に並べています。
| 課金項目 | Claude Opus 5.5 | GPT-5.6 Sol | GPT-6 Sol |
|---|---|---|---|
| 入力 | $4 | $4 / $8 | $2 / $4 |
| キャッシュ読み取り | $0.20 | $0.40 / $0.80 | $0.20 / $0.40 |
| キャッシュ書き込み | $5(5分保持)、$8(1時間保持) | $5 / $10 | $2.50 / $5 |
| 出力 | $20 | $20 / $30 | $10 / $15 |
| 長文の割増 | なし(1Mまで同じ単価) | 入力272K超でリクエスト全体に適用 | 入力272K超でリクエスト全体に適用 |
| コンテキスト / 最大出力 | 1M / 128K | 1,050,000 / 128,000 | 1,050,000(最大入力922,000)/ 128,000 |
税、データ所在地を指定したときの上乗せ(Claudeはinference_geoで米国を指定すると全項目1.1倍、OpenAIは対象モデルの地域処理エンドポイントで10%増)、ツール料金、クラウド経由の価格は含みません。出典はAnthropicの料金ページ、Opus 5.5のモデル概要、OpenAIの料金ページ、GPT-5.6 Solのモデルページ、GPT-6 Solのモデルページです。
用語を2つだけ補足します。キャッシュ書き込みは、繰り返し使うプロンプトの共通部分を最初に保存するときの料金です。キャッシュ読み取りは、保存済みの部分を次のリクエストで再利用するときの料金で、OpenAIの料金表では「cached input」と表記されています。Opus 5.5でキャッシュできるプロンプトは512トークン以上です。
GPT-5.6 Solの価格で注意したいのは次の点です。
- GPT-5.6は2026年7月9日に公開され、そのときのSolは入力$5・出力$30でした(OpenAIのGPT-5.6発表)。現在の$4/$20はそれより安い設定です。
- プロモーション価格の期限は「少なくとも2026年11月21日まで」で、終了日が決まっているわけではありません。終了後の価格は、2026年9月24日時点の公式ページに記載がありません。
- 予算の感度を見たいときは、公開時の定価$5/$30に置き換えて再計算できます。これは公開時の価格で計算した場合の数字であって、終了後の価格の予測ではありません。
effort(推論にどれだけ取り組ませるかの設定)も費用に効きます。Opus 5.5は思考が常に有効で、既定値はmediumです。GPT-5.6 SolとGPT-6 Solはnone、low、medium(既定)、high、xhigh、maxから選べます。段階を上げるほど推論と出力のトークンが増えやすくなります。Opus 5.5の段階ごとの選び方はClaude Opus 5.5のeffort設定:5段階の選び方と費用・キャッシュへの影響で扱っています。
同じトークン数で計算すると、どこで差が出るか
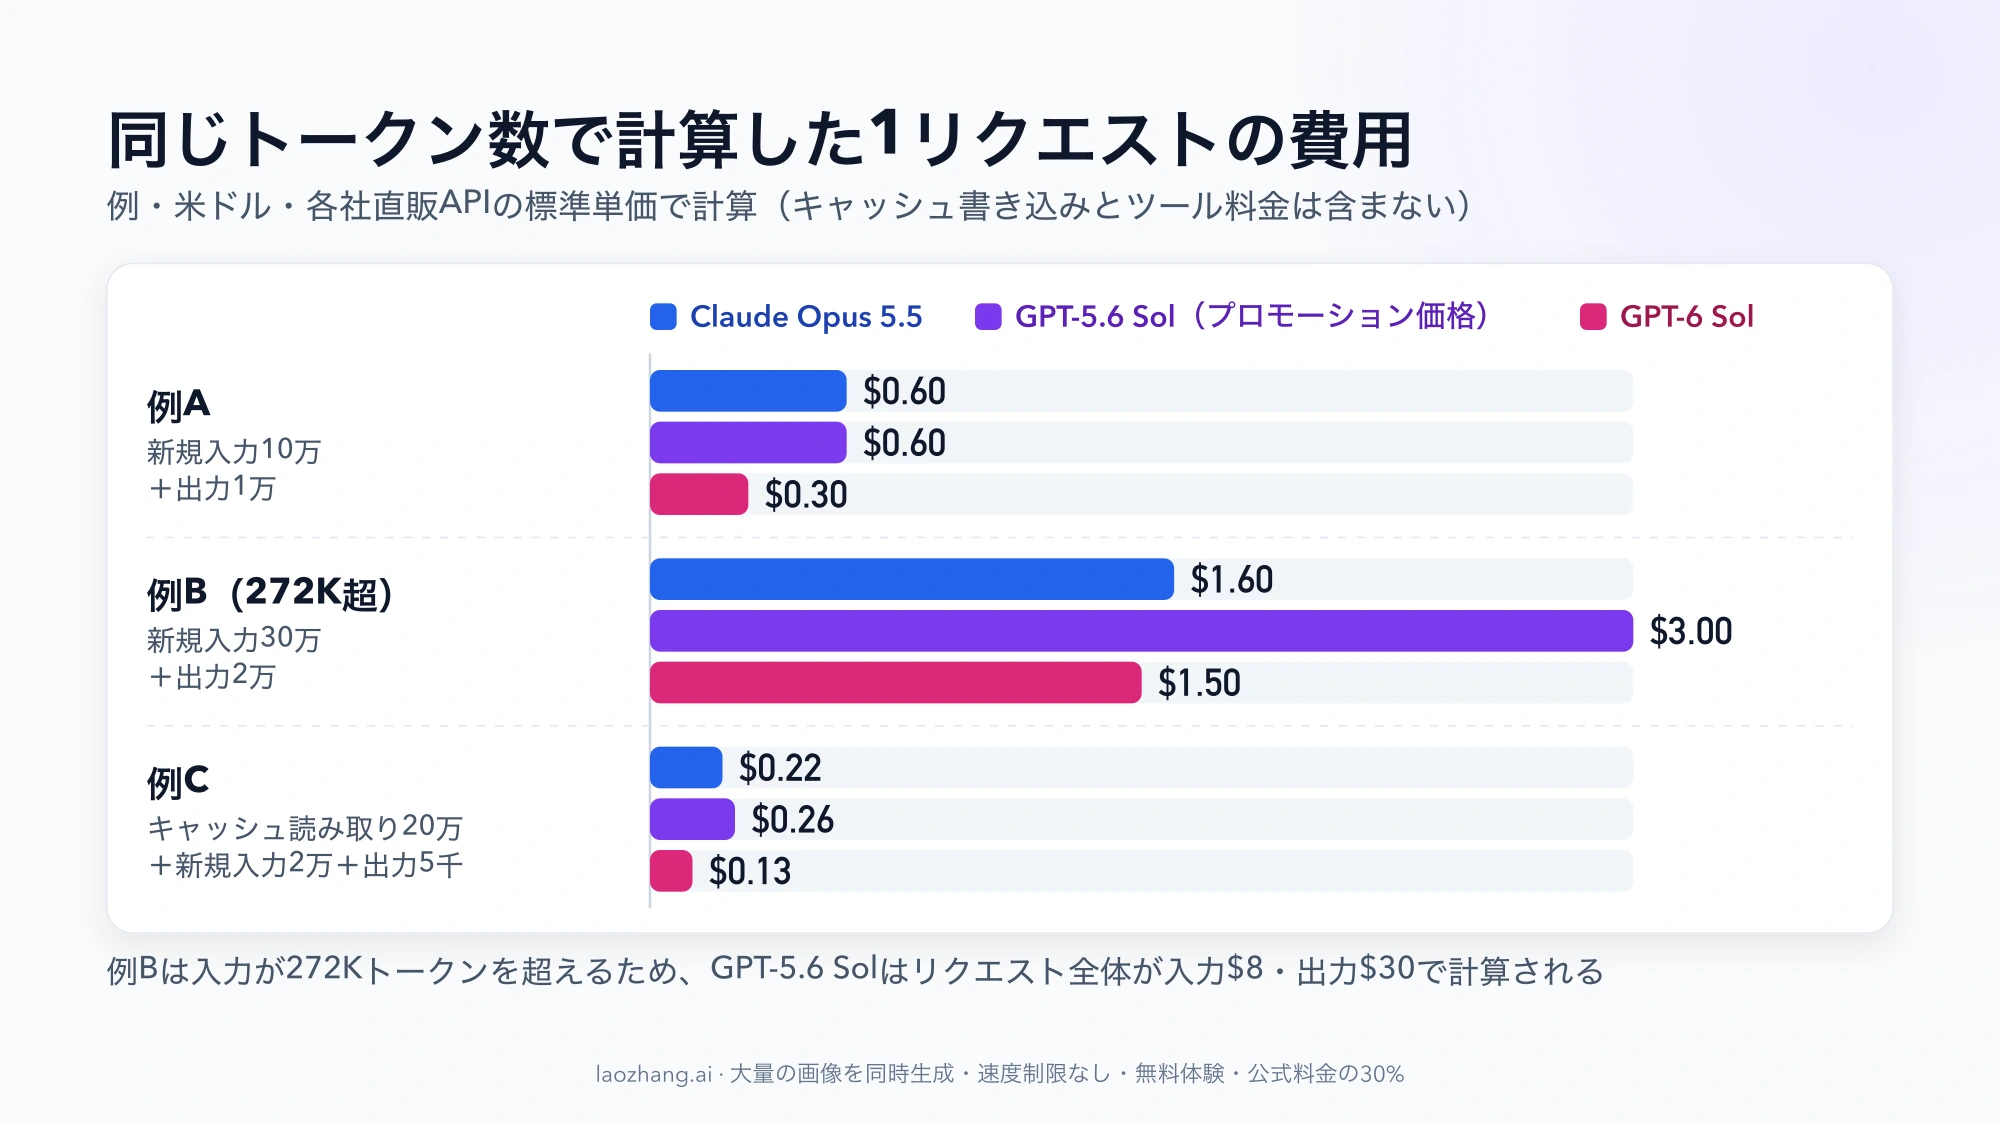
3つの典型的なリクエストを、同じトークン数と仮定して計算します。キャッシュ書き込みやツール呼び出しは含めていません。
| 例 | Claude Opus 5.5 | GPT-5.6 Sol | GPT-6 Sol |
|---|---|---|---|
| A:新規入力10万+出力1万 | $0.60 | $0.60(公開時の定価なら$0.80) | $0.30 |
| B:新規入力30万+出力2万(272K超) | $1.60 | $3.00 | $1.50 |
| C:キャッシュ読み取り20万+新規入力2万+出力5千 | $0.22 | $0.26 | $0.13 |
計算式は次のとおりです(トークン数を100万で割った値×単価)。
- A:Opus 5.5とGPT-5.6 Solは0.1×$4+0.01×$20=$0.60。公開時の定価では0.1×$5+0.01×$30=$0.80。GPT-6 Solは0.1×$2+0.01×$10=$0.30。
- B:Opus 5.5は0.3×$4+0.02×$20=$1.60。GPT-5.6 Solは入力と出力の両方が長文単価になり、0.3×$8+0.02×$30=$3.00。GPT-6 Solは0.3×$4+0.02×$15=$1.50。
- C:Opus 5.5は0.2×$0.20+0.02×$4+0.005×$20=$0.22。GPT-5.6 Solは0.2×$0.40+0.02×$4+0.005×$20=$0.26。GPT-6 Solは0.2×$0.20+0.02×$2+0.005×$10=$0.13。
短い入力(例A)ではOpus 5.5とGPT-5.6 Solは同額です。272Kを超える長文(例B)ではGPT-5.6 SolがOpus 5.5の2倍近くになり、Opus 5.5とGPT-6 Solはほぼ並びます。OpenAIの長文単価は「272Kを超える」リクエストに適用されるので、入力がちょうど272,000トークンなら通常の単価です。キャッシュを多く読む処理(例C)では、キャッシュ読み取り単価の差がそのまま効きます。
実際には同じトークン数にならない
上の表は比較の出発点にすぎません。同じ作業でも、次の2つの理由でトークン数がずれます。
1つはトークナイザー(文章をトークンに分割する仕組み)の違いです。AnthropicはClaude 4.7以降のモデルで使うトークナイザーについて、同じ文章から以前のトークナイザーより約30%多くトークンが出ると説明しています(料金ページ)。一方、同じ文章でClaudeとOpenAIのトークン数がどれだけ違うかの比率は公開されていません。日本語の文書で比べるなら、自分の実データを両方に送ってusageの値を見るのが確実です。
もう1つは出力量の違いです。Artificial Analysisの測定では、Opus 5.5(medium)とGPT-5.6 Sol(high)のタスクあたり出力トークンは26kと13k、そのうち推論トークンは12kと6kでした。単価が同じでも、指標一式を実行した費用はOpus 5.5が$1,627、GPT-5.6 Solが$1,487で、Opus 5.5が約9%高くなっています。両方をmaxにした場合は$8,708と$3,465で、約2.5倍の差です(medium対high、max同士)。出力が長くなる処理ほど、この差が請求額に表れます。
性能:両社の発表表は並べて比べられない
AnthropicはOpus 5.5の発表で、GPT-5.6 Solとの比較表を出しています(Claude Opus 5.5の発表ページ)。
| ベンチマーク(Anthropicの表) | Claude Opus 5.5 | GPT-5.6 Sol |
|---|---|---|
| Terminal-Bench 4.0 | 66.4%(xhigh) | 37.3% |
| FrontierCode v1.1 | 54.4% | 47.5% |
| CursorBench 4.0 | 57.8% | 41.7% |
| GDPval-AA v2.1 | 1846 | 1588 |
| AutomationBench(Zapierが実施) | 40.0% | 28.8% |
一方、OpenAIがGPT-5.6の発表で出したSolの表は、Terminal-Bench 2.1が88.8%、SWE-Bench Proが64.6%、OSWorld 2.0が62.6%、BrowseCompが90.4%と、項目も版も違います(GPT-5.6の発表)。両方の表に載っているAutomationBenchでも、GPT-5.6 SolはAnthropicの表で28.8%、OpenAIの表で18.1%です。同じ名前のベンチマークでも実行環境、版、effort、日付が違えば数字が変わるということであり、どちらの実行が正しいかを示すものではありません。各社の表から数字を1つずつ抜き出して並べる比較は避けたほうが安全です。
同じ評価者が同じ指標一式で2つのモデルを測った独立系の数字としては、Artificial Analysisのものがあります。
| 項目(Artificial Analysis) | Opus 5.5(medium) | GPT-5.6 Sol(high) |
|---|---|---|
| Intelligence Index | 51 | 42 |
| タスクあたり出力トークン | 26k | 13k |
| 出力速度 | 78トークン/秒 | 69トークン/秒 |
| 最初の回答トークンまでの時間 | 21.62秒 | 14.72秒 |
| 指標一式の実行費用 | $1,627 | $1,487 |
両方をmaxにした場合のIndexは58と47です。この測定では、Opus 5.5はスコアが高い代わりにトークンを多く使い、GPT-5.6 Solは最初の回答が早く返っています。ただし評価者は1社で、数値は更新されることがあります。比較の組み合わせもOpus 5.5のmediumとGPT-5.6 Solのhighで、設定名がそろっているわけではありません。自分の作業でこの差がどれだけ意味を持つかは、次の試験で確かめます。
GPT-5.6 Solを使っているなら、GPT-6 Solも比べる
いまGPT-5.6 Solで動かしている処理がある場合は、Opus 5.5と並べてGPT-6 Solも必ず比べます。OpenAIのAPIのまま単価が半分になる選択肢だからです。
- 単価は全項目でGPT-5.6 Solの半額です(入力$2、キャッシュ読み取り$0.20、キャッシュ書き込み$2.50、出力$10。272K超は$4 / $0.40 / $5 / $15)。
- コンテキスト1,050,000、最大出力128,000、
effortの段階、対応エンドポイント(Chat Completions、Responses、Batch)はGPT-5.6 Solと同じです。知識のカットオフは2026年4月20日で、GPT-5.6 Solの2026年2月16日より新しくなっています。 - OpenAIの2026年9月22日の変更履歴には、GPT-6 SolとGPT-6 LunaがCodexとChatGPT Workで「GPT-5.6の前身より低いトークン価格で」展開されると書かれています(ChatGPTの変更履歴)。
- GPT-5.6 Solの提供終了日は、2026年9月24日時点の公開ページに記載がありません。すぐに移行を迫られる状況ではありませんが、プロモーション終了後にGPT-5.6 Solの単価が上がれば、GPT-6 Solとの差はさらに開きます。
GPT-6 SolがGPT-5.6 Solと同じ品質を自分のタスクで出せるかは、公開データからは判断できません。第三者の例として、DataCampが1つのファイルでテトリスを作る課題(重力反転つき)を1回ずつ試した結果では、GPT-6 Solが6ターン・ツール呼び出し9回で$0.26、評価5.0、Opus 5.5が3ターン・ツール呼び出し2回で$0.87、評価4.3でした(DataCampの比較記事)。課題1つ・1回の実行なので優劣の結論にはなりませんが、ターン数やツール呼び出しの回数と、費用や出来栄えが同じ方向に動くとは限らない例です。
GPT-6 SolのCodexでの課金やLunaとの違いはGPT-6 SolとLunaの料金比較:APIとCodexでどう違う?、GPT-5.6系のモデルIDとTerra・Lunaの使い分けはOpenAIの最新テキストモデル比較 2026:GPT-5.6 Sol・Terra・Lunaの選び方を参照してください。
切り替える前に:合格した成果1件あたりのコストを測る
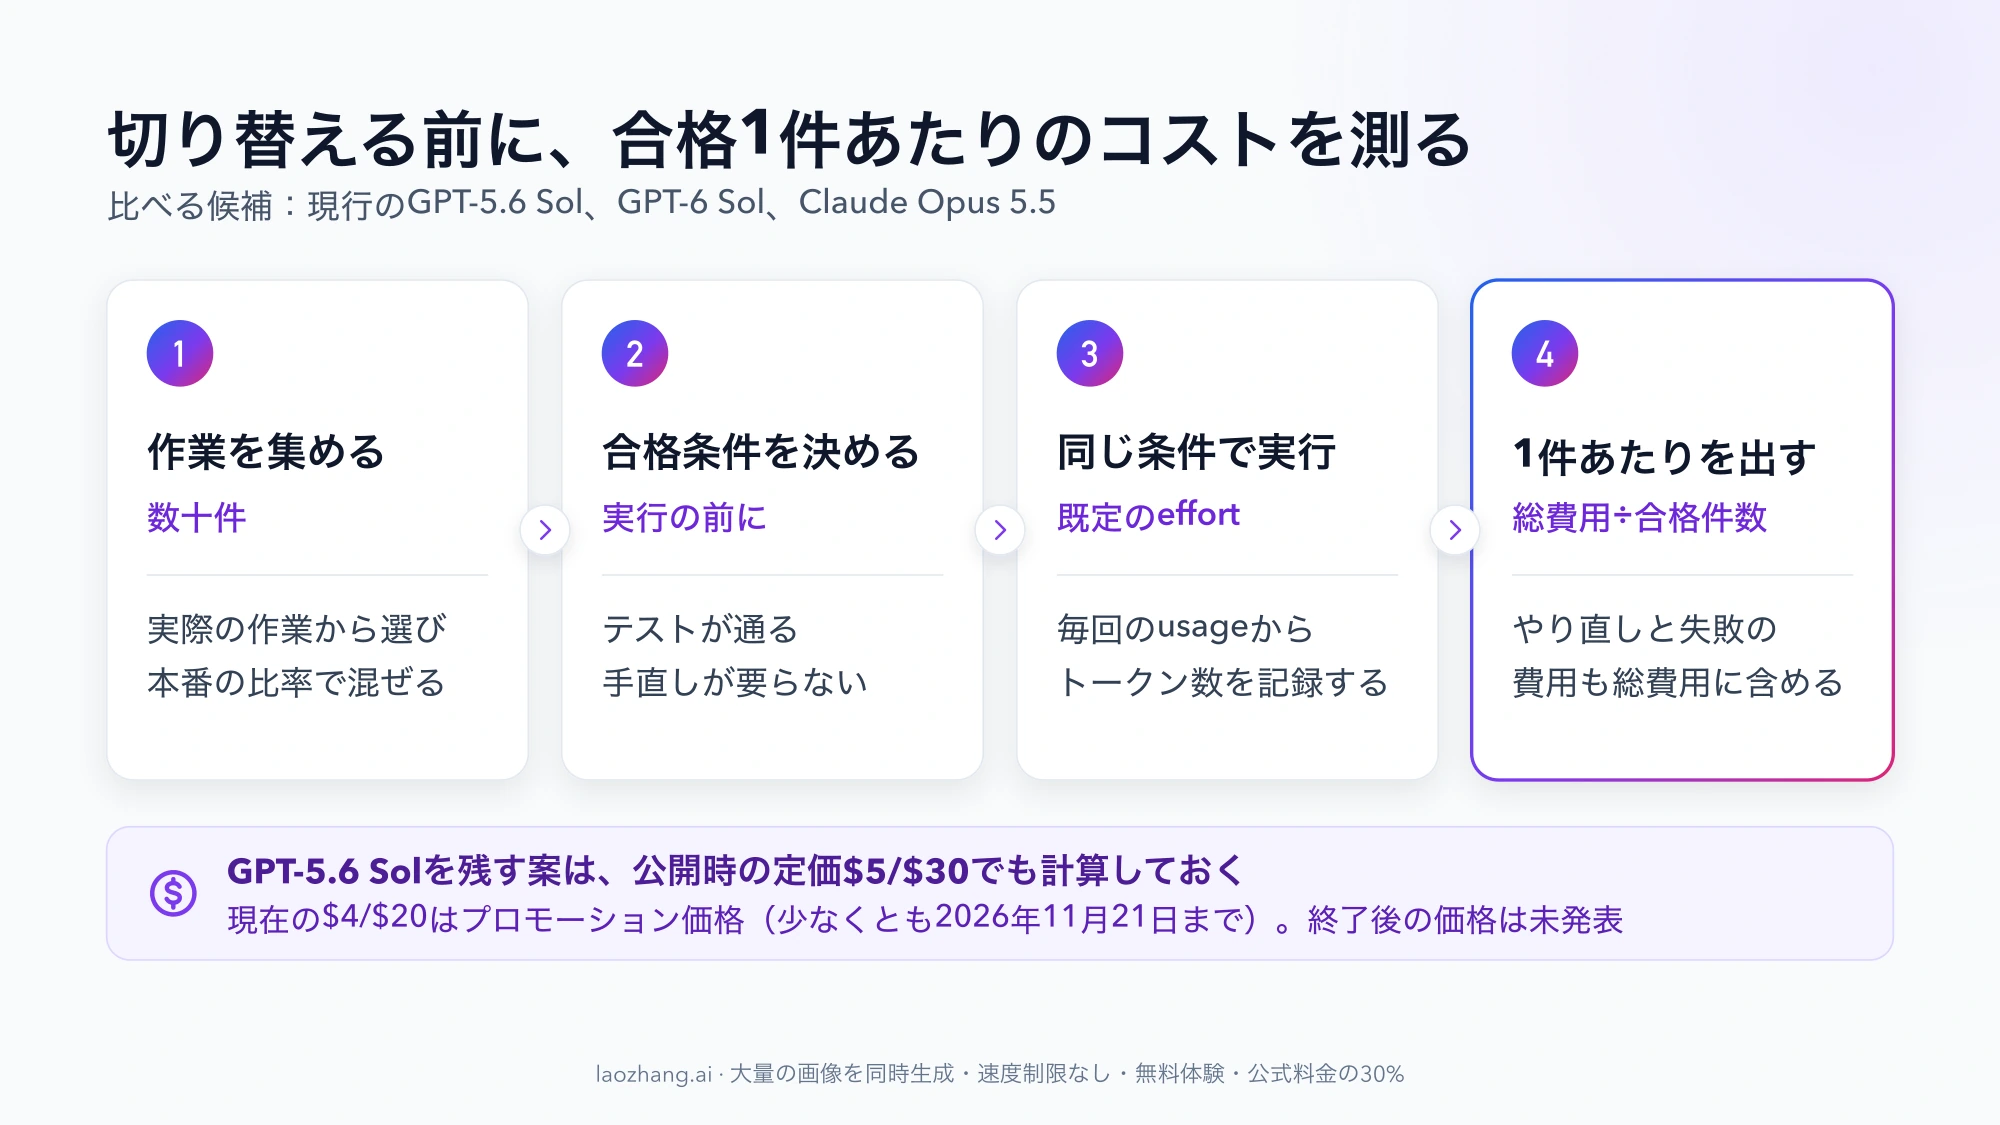
公開されている数値は、どれも自分とは違う作業で測られたものです。切り替えを決める前に、自分の作業で小さな試験をします。GPT-5.6 Solの利用者なら、現行のGPT-5.6 Solを基準に、GPT-6 SolとOpus 5.5の3つを並べるのが効率的です。
- 実際の作業から数十件を選びます。短い依頼、272Kを超える資料、キャッシュを使う定型処理などを、本番での比率に近づけて混ぜます。
- 合格の条件を先に決めます。テストが通る、レビューで手直しが要らない、決まった形式で返る、などです。
- 各モデルを既定の
effort(どれもmedium)で実行し、必要なら段階を変えた実行を追加します。どの段階で測ったかを記録しておきます。 - レスポンスのusageから、新規入力、キャッシュ読み取り、キャッシュ書き込み、出力(推論分を含む)のトークン数を記録します。usageの内訳の返し方は両社で違うので、キャッシュ分が入力数に含まれているかを確認してから計算に使います。
- リクエストごとの費用を単価表で計算し、やり直しや失敗した実行も含めた費用の合計を合格件数で割ります。これが合格した成果1件あたりのコストです。
- GPT-5.6 Solを残す案は、公開時の定価$5/$30でも計算して、プロモーションが終わった場合にどれだけ差が動くかを見ておきます。
計算には次のようなPythonを使えます。単価は2026年9月24日時点の値なので、使う前に料金ページで確認してください。
# 100万トークンあたりの米ドル単価(2026年9月24日時点、各社直販APIのStandard)
RATES = {
    "claude-opus-5-5": {
        # キャッシュ書き込みは5分保持の単価。1時間保持なら8.00
        "short": {"input": 4.00, "cache_read": 0.20, "cache_write": 5.00, "output": 20.00},
        "long": None,  # 1Mトークンまで長文の割増なし
    },
    "gpt-5.6-sol": {  # プロモーション価格(少なくとも2026年11月21日まで)
        "short": {"input": 4.00, "cache_read": 0.40, "cache_write": 5.00, "output": 20.00},
        "long": {"input": 8.00, "cache_read": 0.80, "cache_write": 10.00, "output": 30.00},
    },
    "gpt-6-sol": {
        "short": {"input": 2.00, "cache_read": 0.20, "cache_write": 2.50, "output": 10.00},
        "long": {"input": 4.00, "cache_read": 0.40, "cache_write": 5.00, "output": 15.00},
    },
}
LONG_THRESHOLD = 272_000  # OpenAIは入力がこれを「超える」とリクエスト全体に長文単価


def request_cost(model, fresh_input, output, cache_read=0, cache_write=0):
    table = RATES[model]
    total_input = fresh_input + cache_read + cache_write
    # キャッシュ分を閾値に数えるかは公開ページに明記がないため、含めて判定する
    use_long = table["long"] is not None and total_input > LONG_THRESHOLD
    r = table["long"] if use_long else table["short"]
    usd = (fresh_input * r["input"] + cache_read * r["cache_read"]
           + cache_write * r["cache_write"] + output * r["output"]) / 1_000_000
    return round(usd, 4)


def cost_per_pass(model, runs):
    """runs: [(新規入力, 出力, キャッシュ読み取り, キャッシュ書き込み, 合格したか), ...]"""
    total = sum(request_cost(model, fi, out, cr, cw) for fi, out, cr, cw, _ in runs)
    passed = sum(1 for *_, ok in runs if ok)
    return round(total / passed, 4) if passed else None


if __name__ == "__main__":
    for m in RATES:
        print(m,
              request_cost(m, 100_000, 10_000),                    # 例A
              request_cost(m, 300_000, 20_000),                    # 例B
              request_cost(m, 20_000, 5_000, cache_read=200_000))  # 例C
    # 3回試して2回合格した場合の、合格1件あたりのコスト
    runs = [(80_000, 12_000, 0, 0, True), (95_000, 30_000, 0, 0, False), (70_000, 9_000, 0, 0, True)]
    print(cost_per_pass("gpt-6-sol", runs))
実行すると、例A〜Cの金額が上の表と同じ値(Opus 5.5は0.6、1.6、0.22、GPT-5.6 Solは0.6、3.0、0.26、GPT-6 Solは0.3、1.5、0.13)で出力され、最後の行に合格1件あたりのコスト0.5が表示されます。記録したトークン数をrunsに入れ替えれば、自分の試験結果で計算できます。
結果の読み方は次のとおりです。
- 合格率がほぼ同じなら、合格1件あたりのコストが低いモデルを選びます。GPT-5.6 Solの利用者で、GPT-6 Solの合格率が落ちず、使うトークン数も大きく変わらなければ、費用はほぼ半分になります。
- 難しい作業でOpus 5.5の合格率が明らかに高いなら、1回あたりの費用が高くても、やり直しが減る分だけ合格1件あたりでは逆転することがあります。
- 272Kを超える入力やキャッシュ読み取りが大半を占めるなら、GPT-5.6 Solは不利です。OpenAIに残るならGPT-6 Sol、それ以外ならOpus 5.5が候補になります。
Opus 5.5に移す場合、Opus 5向けに書いたコードをモデルIDだけ替えて動かすと、思考を無効にする設定やツール指定の強制がエラーになります。確認すべき点はClaude Opus 5.5の料金と使い方:Opus 5からの移行で確認することにまとめています。Claudeの中でOpusと別のモデルを選ぶ場合はClaude Opus 5.5とFable 5.1を比較:料金と使い分けが参考になります。
よくある質問
GPT-5.6 Solの料金はいくらですか?
2026年9月24日時点のAPI標準単価は、100万トークンあたり入力$4、キャッシュ入力$0.40、キャッシュ書き込み$5、出力$20です。入力が272Kトークンを超えるリクエストは全体が$8 / $0.80 / $10 / $30になります。これはOpenAIが「少なくとも2026年11月21日まで」と表示しているプロモーション価格で、2026年7月9日の公開時は入力$5・出力$30でした。
GPT-5.6 Solとは何ですか?いつ公開されましたか?
OpenAIが2026年7月9日に公開したGPT-5.6の3モデル(Sol、Terra、Luna)のうち、最も単価の高いモデルです。APIのモデルIDはgpt-5.6-solで、コンテキストは1,050,000トークン、最大出力は128,000トークンです。2026年9月22日には後継のGPT-6 Solが出ています。
プロモーション価格が終わったら、Opus 5.5のほうが安くなりますか?
終了後の価格は発表されていないため、確定的なことは言えません。公開時の定価$5/$30で計算すると、例Aの新規入力10万+出力1万は$0.80で、Opus 5.5の$0.60より高くなります。ただしこれは仮の計算で、予測ではありません。
Opus 5.5とGPT-5.6 Sol、性能はどちらが上ですか?
同じ指標一式で両モデルを測ったArtificial Analysisでは、Opus 5.5(medium)が51、GPT-5.6 Sol(high)が42でした。一方でOpus 5.5はタスクあたりの出力トークンが約2倍です。両社の発表表は項目も条件も違うため並べて比べられません。自分の作業で合格率と費用の両方を測って判断してください。