Claude APIでOpus 5.5とFable 5.1を選ぶなら、まずOpus 5.5を試すのが実務的です。標準料金では、新規入力、出力、キャッシュ書き込み、キャッシュ読み取りのすべてでOpusのほうが安くなっています。Fableを使う理由は料金ではなく、難しい作業で合格率を上げたり、再試行や人の修正を減らしたりできるかどうかにあります。モデルを上げる前に、まずeffortを調整し、それでも足りなければモデルを変える順で考えると無駄が出にくくなります。
2026年10月8日時点の現行モデルは、Fable 5.1、Opus 5.5、Sonnet 5.5(2026年9月28日公開)、Haiku 5.5(2026年10月7日公開)の4つです(Anthropicのモデル一覧)。Sonnet 5とHaiku 4.5は旧モデルとして引き続き利用できます。日常のコード作業や文書処理ならSonnet 5.5、分類・抽出・ルーティングのような大量処理ならHaiku 5.5から試せます。
料金はAnthropicの直接APIの標準料金が前提です。Claudeのサブスクリプション、Fast mode、Batch、クラウド事業者経由の料金には、そのまま当てはめられません。
同じ使用量ならOpus 5.5がFable 5.1より安い
Anthropicの料金表に掲載された標準の従量料金は次のとおりです。単位はすべて100万トークン当たりの米ドルです。
| 課金対象 | Opus 5.5 | Fable 5.1 |
|---|---|---|
| 新規入力 | $4 | $10 |
| 出力 | $20 | $50 |
| 5分キャッシュへの書き込み | $5 | $12.50 |
| 1時間キャッシュへの書き込み | $8 | $20 |
| キャッシュ読み取り | $0.20 | $0.25 |
たとえば1回の試行で、新規入力3万、キャッシュ読み取り6万、出力5,000トークン(プロンプト合計9万トークン)を使い、キャッシュ書き込みやその他の料金は発生しないと仮定します。Opusは 0.03 × 4 + 0.06 × 0.20 + 0.005 × 20 = $0.232、Fableは 0.03 × 10 + 0.06 × 0.25 + 0.005 × 50 = $0.565 で、Fableが約2.4倍です。これは同じトークン量を使った場合の請求例であり、実際の処理で両モデルが同量を使うという予測ではありません。
以前のOpus 5とFable 5.1の比較では、Fableのキャッシュ読み取り単価が低いため、再利用量によって料金が逆転する条件がありました。Opus 5.5にはその条件を持ち込めません。 現行の標準料金ではキャッシュ読み取りもOpusが$0.20、Fableが$0.25です。同じトークン内訳なら、キャッシュ比率を増やしてもFableの請求額がOpusを下回ることはありません。
一方、同じ「完了した仕事」でも、出力トークン数や呼び出し回数はモデルによって変わります。Fableが少ない試行で合格し、レビューや修正の時間も減らせる仕事なら、単価の差だけでは最終費用を決められません。
性能表を見る前にeffortの条件をそろえる
APIのモデルIDは、Opus 5.5が claude-opus-5-5、Fable 5.1が claude-fable-5-1 です(Opus 5.5の仕様、Fable 5.1の仕様)。両モデルともコンテキストは100万トークン、標準の最大出力は12万8000トークンです。違いが出やすいのは既定のeffortで、Opusは medium、Fableは high です。何も指定せずに比べると、Fableのほうが多く考えた結果と比べることになります。
effortの説明によると、現行4モデルはいずれも low、medium、high、xhigh、max の5段階を指定できます。既定値はFable 5.1とSonnet 5.5が high、Opus 5.5とHaiku 5.5が medium です。Anthropicのモデル選択ガイドも、モデルを切り替えるよりeffortを調整するほうが効果的なことが多いとしています。
AnthropicがOpus 5.5の発表で示したTerminal-Bench 4.0の66.4%対55.8%、CursorBench 4.0の57.8%対51.8%は、特定の評価環境でのOpus対Fableの結果です。Terminal-BenchではOpusが xhigh、Fableが high で測られています。既定設定のAPI呼び出しでも同じ差が出るという意味にはなりません。Anthropic自身も、実際の利用での差はベンチマークほど大きくないとしています。
また、同じ発表の「実行費用を40%削減」はOpus 5との比較です。Fable 5.1より40%安く完了できるという実測値として扱わないでください。どちらの公表値も、手元の作業での合格率を測る代わりにはなりません。
Opusから始め、Fableを試す条件を決める
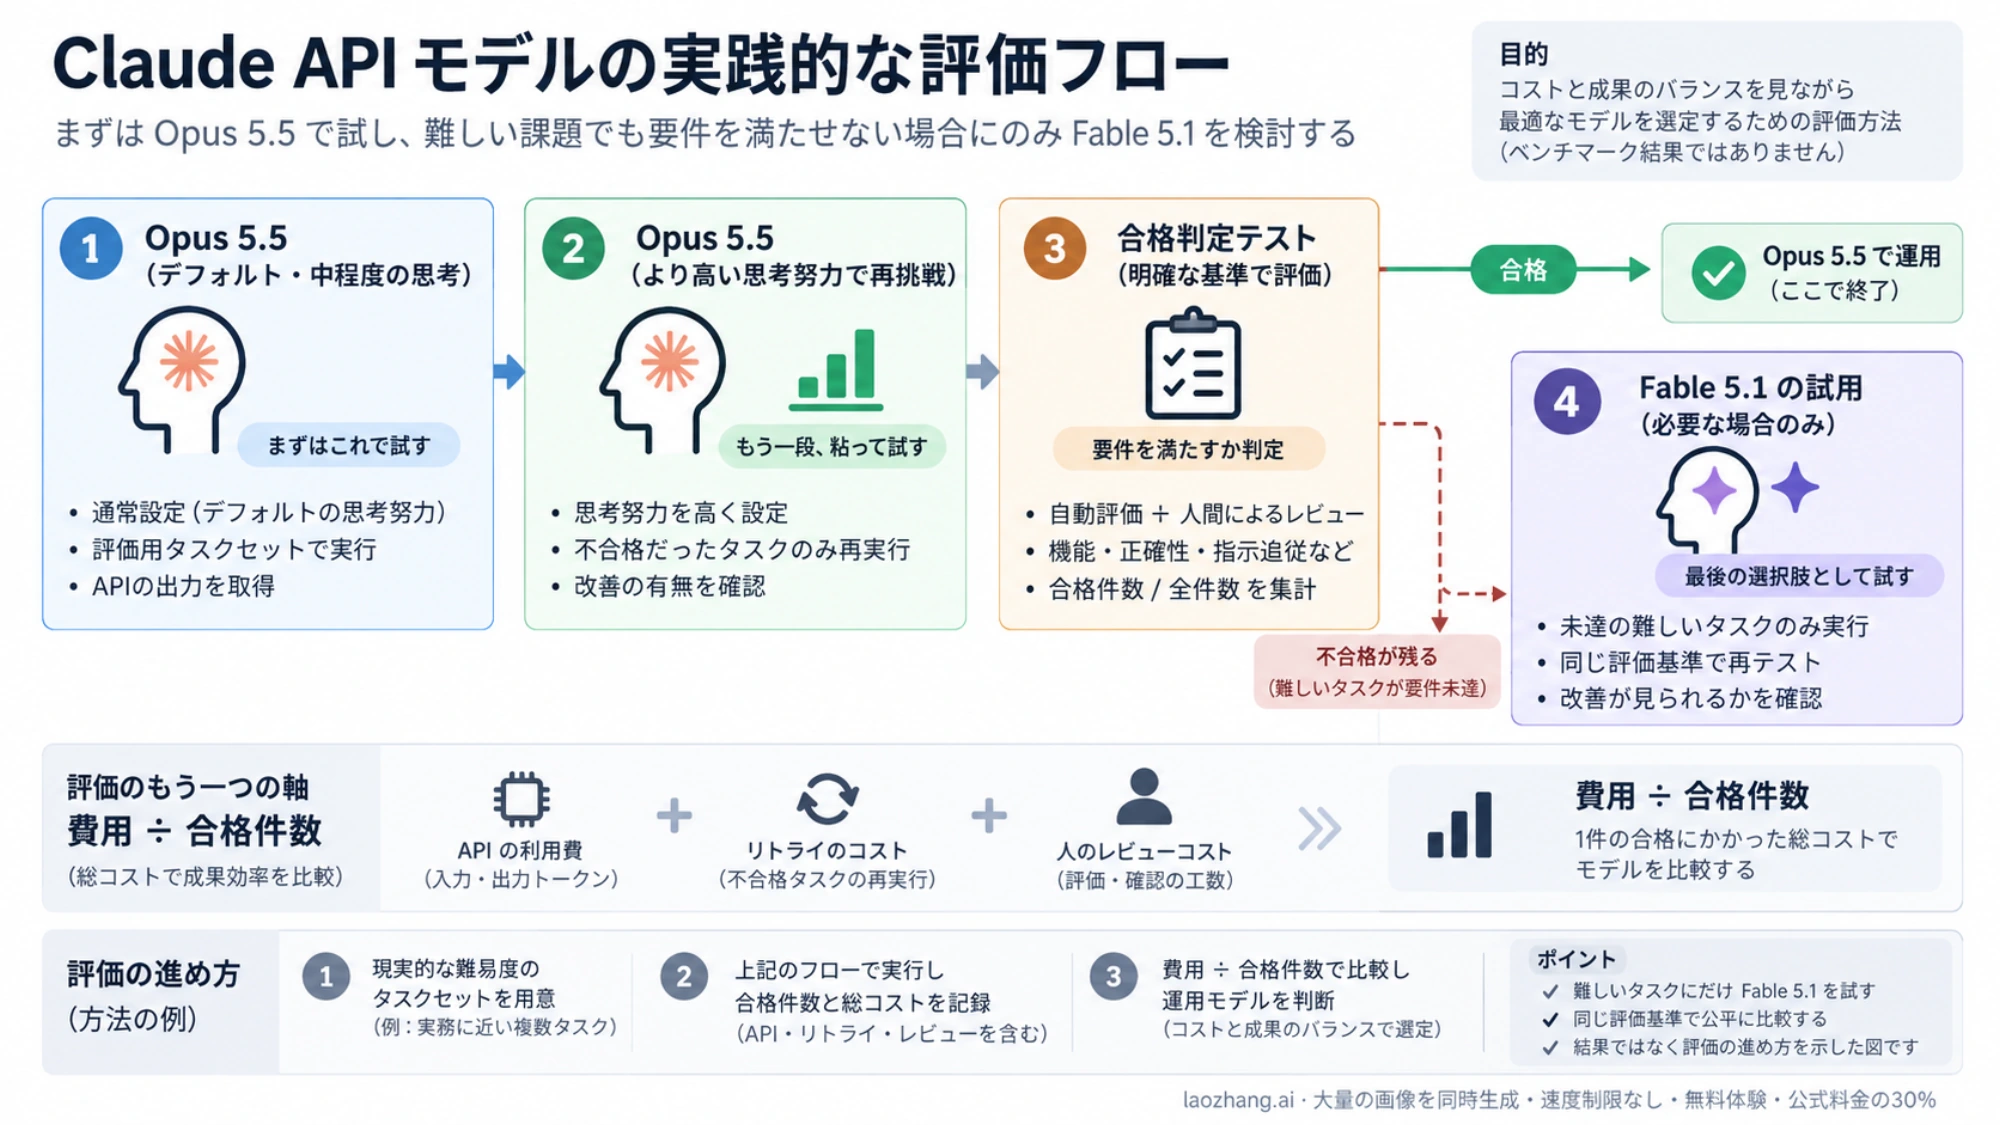
Anthropicのモデル選択ガイドは、多くの仕事をOpus 5.5から始め、xhigh や max のeffortでも難しい推論や長時間のエージェント作業で要求を満たせないときにFable 5.1へ移る流れを示しています。
実際には、次の順で進めると判断しやすくなります。
- 合格条件を先に定める。 たとえばテストの通過、レビューでの重大な指摘数、修正後の受け入れ可否など、仕事に合う条件を選びます。
- Opus 5.5を既定の
mediumで試す。 合格し、費用や所要時間も許容範囲なら、そこで選択を終えられます。 - 不足する場合はeffortを上げる。 より多い推論コストで、失敗や手戻りが減るかを確かめます。
xhighやmaxまで上げても求める結果に届かない難所なら、Fable 5.1を同じ合格条件で試します。 - Fableの改善を作業全体の費用で判定する。 API請求額だけでなく、再試行、実行時間、レビュー、修正を含めて比べます。難所だけをFableへ振り分ける運用も可能です。
モデル比較では、入力、ツール、権限、時間制限、停止条件をそろえます。Claude Codeで一方を使い、もう一方を素のAPIスクリプトで動かすなら、モデルの能力に加えて実行環境も違う比較になります。比較した条件を残しておけば、結果の理由を追いやすくなります。
| 記録するもの | 何を見分けるためか |
|---|---|
| 新規入力・キャッシュ書き込み・読み取り・出力トークン | 請求額が増減した理由 |
| 初回合格・再試行後の合格・不合格 | どちらが仕事を完了しやすいか |
| 実行時間と人によるレビュー・修正時間 | 単価に表れない負担 |
| 失敗したツール呼び出しやループ、やり直し | 長時間の処理での安定性 |
比較単位は、総費用 ÷ 合格したタスク数 です。総費用にはAPIの料金に加え、必要ならツール代、再試行、人の確認や修正にかかった費用を含めます。これは評価方法であり、Opus 5.5とFable 5.1を同条件で実測した結果ではありません。
Fable・Opus・Sonnet・Haikuの違い:料金・速度・向く作業
4モデルの違いは、単価と速度の段差、そしてAnthropicが想定する用途にまとめられます。2026年10月8日時点のモデル一覧と料金表では次のとおりです。
| 項目 | Fable 5.1 | Opus 5.5 | Sonnet 5.5 | Haiku 5.5 |
|---|---|---|---|---|
| 入力/出力(100万トークン当たり) | $10/$50 | $4/$20 | $2/$10 | $0.10/$0.50(プロンプト10万トークン以下) |
| キャッシュ読み取り | $0.25 | $0.20 | $0.10 | $0.01(同上) |
| 相対的な速度 | 遅め | 中程度 | 速い | 最速 |
| 既定のeffort | high | medium | high | medium |
| Anthropicが示す用途 | 難しい推論、長時間のエージェント作業 | 長時間のエージェント型コーディング、知識労働 | 速度と性能のバランス(日常のコード、エージェント、業務処理) | 分類・抽出・ルーティングなど大量で遅延に敏感な処理 |
| モデルID | claude-fable-5-1 | claude-opus-5-5 | claude-sonnet-5-5 | claude-haiku-5-5 |
4モデルとも、コンテキストは100万トークン、最大出力は12万8000トークン、信頼できる知識は2026年6月までです。トークナイザーも4モデル共通になったため、同じ文章なら同じトークン数で比べられます。
前の節と同じ1回の試行(新規入力3万、キャッシュ読み取り6万、出力5,000)と、キャッシュを多く使うエージェント実行(8万トークンのキャッシュ済みプレフィックスを20ターン読み直し、計160万トークンの読み取り+新規入力5万+出力1万、最初のキャッシュ書き込みは除く)で比べると、次のようになります。エージェント実行でも1回のリクエストは10万トークン以下に収まるため、Haikuは低い料金帯で計算しています。
| 試算(同じトークン量) | Haiku 5.5 | Sonnet 5.5 | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|
| 1回の試行 | $0.0061 | $0.116 | $0.232 | $0.565 |
| エージェント実行20ターン | $0.026 | $0.36 | $0.72 | $1.40 |
たとえばエージェント実行のOpusは 1.6 × 0.20 + 0.05 × 4 + 0.01 × 20 = $0.72、Haikuは 1.6 × 0.01 + 0.05 × 0.10 + 0.01 × 0.50 = $0.026 です。1回の試行では、SonnetがHaikuの約19倍、OpusがSonnetの2.0倍、FableがOpusの約2.4倍になります。実際の仕事では、考える量や出力の長さ、やり直しの回数がモデルごとに変わるため、この倍率は請求額の目安にとどまります。
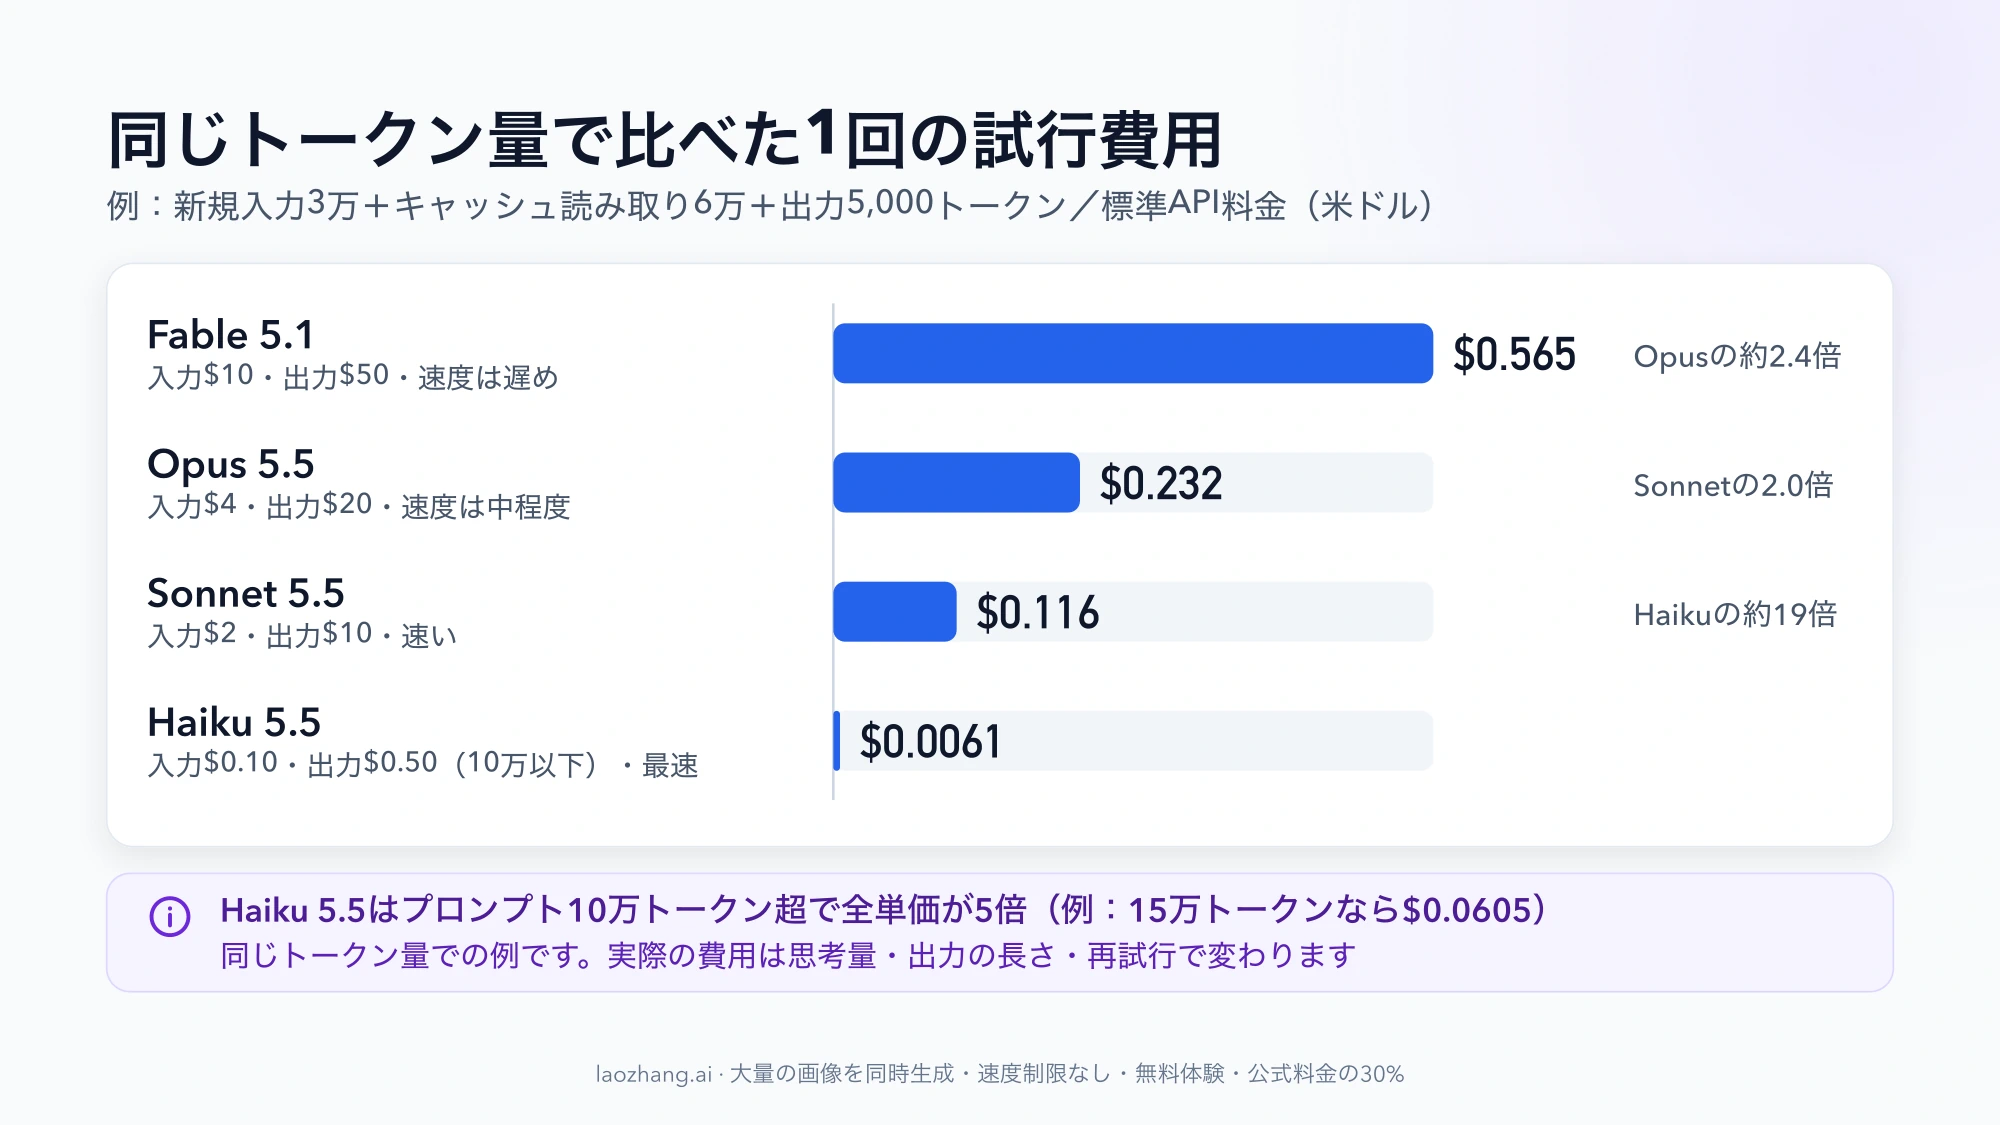
選び方の出発点は、仕事の性質で変わります。
- 大量で、結果を自動で検査できる処理(分類、抽出、振り分け、サブエージェント):Haiku 5.5から試します。Anthropicも効率を優先する場合はHaiku 5.5から始め、足りない部分だけ上げる方法を示しています。
- 普段のコード作業、文書処理、分析:Sonnet 5.5を起点にし、失敗時の負担が大きい仕事や複雑な作業でOpusへ上げます。
- 長時間のエージェント作業や難しい推論:Opus 5.5を先に評価し、合格条件に届かない部分をFable 5.1で確かめます。
どの段でも、モデルを上げる前にeffortを1段上げて合格率が変わるかを見ます。安価なモデルが一度で合格する仕事に、上位モデルを使う理由は乏しくなります。反対に、単価が安くても再試行や人の修正が増えるなら、上のモデルにしたほうが仕事全体の費用を抑えられる場合があります。
Haiku 5.5の10万トークン条件:超えると全単価が5倍
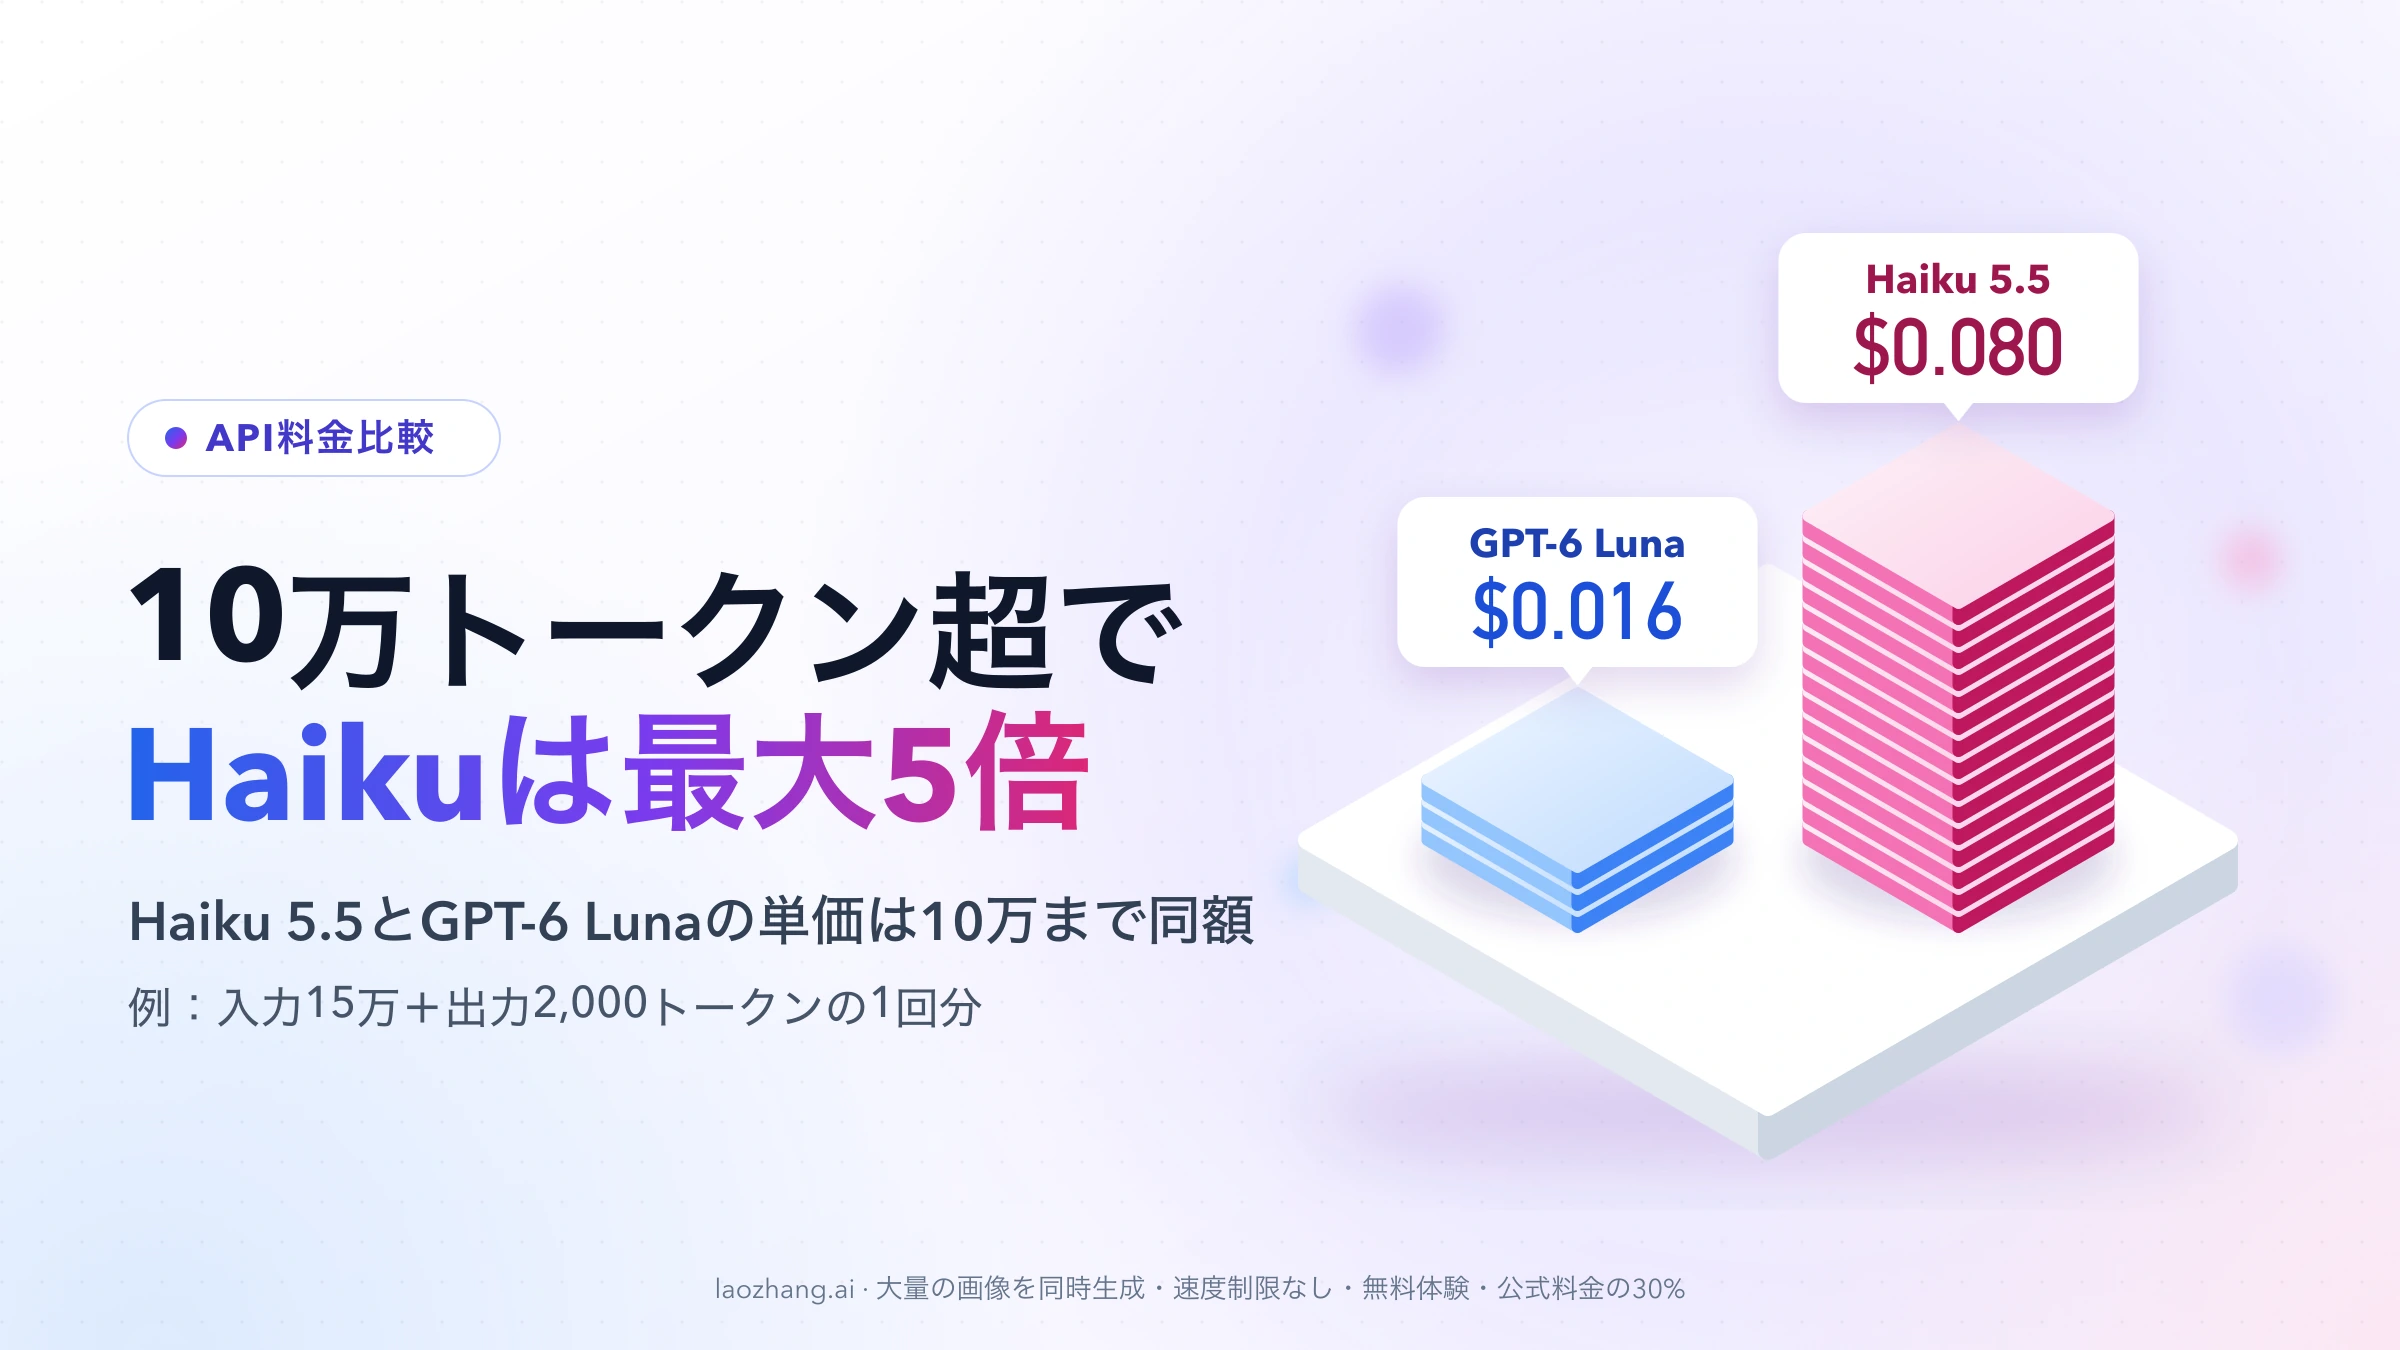
Haiku 5.5の$0.10/$0.50は、プロンプトが10万トークン以下のときの料金です。10万トークンを超えると、入力$0.50、キャッシュ読み取り$0.05、出力$2.50と、すべての項目が5倍になります。ほかの3モデルは、100万トークンまで同じ標準料金です。
上の1回の試行を、新規入力9万+キャッシュ読み取り6万(プロンプト15万トークン)に広げると、Haikuは高い料金帯で 0.09 × 0.50 + 0.06 × 0.05 + 0.005 × 2.50 = $0.0605、Sonnet 5.5は $0.236 です。高い料金帯でもHaikuはSonnetの約4分の1ですが、10万トークン以下のときの差(約19分の1)ほどは開きません。なお、キャッシュ読み取りが10万トークンの判定に含まれるかは料金表に記載がなく、この計算は含まれる前提です。
Anthropicは、Haiku 4.5と比べて10万トークン以下のプロンプトで9割、超える場合で5割安いとしています。ただしHaiku 5.5は新しいトークナイザーを使うため、同じ文章がHaiku 4.5より約30%多くのトークンとして数えられます。OpenAIの小型モデルと比べたい場合は、Claude Haiku 5.5とGPT-6 Luna料金比較:10万トークン超で最大5倍で料金帯の境目を詳しく扱っています。
Claudeアプリでの使い分け:OpusはPro以上、FableはProではクレジット
Claudeのサブスクリプションでは、トークン単価ではなくプランごとの利用上限の中で4モデルを使い分けます。Claudeの料金ページのモデル表は次のとおりです(モデルは世代名なしで「Haiku」「Sonnet」のように記載されています)。
| プラン | Haiku | Sonnet | Opus | Fable |
|---|---|---|---|---|
| Free | 利用可 | 利用可 | 不可 | 不可 |
| Pro | 利用可 | 利用可 | 利用可 | 従量の利用クレジットで利用 |
| Max 5x/20x | 利用可 | 利用可 | 利用可 | 週間上限の最大50%まで |
| Team/Enterprise | 利用可 | 利用可 | 利用可 | 利用可 |
上限の減り方は、Claude Academyのモデル選択ガイドによるとHaikuが最も軽く、Sonnet、Opusの順に重くなり、Fableが最も重くなります。何倍違うかは公表されていません。Claude Codeのヘルプでも、大半のコード作業はSonnetで足りるとしています。Pro(米国で月額$20)とMaxの上限の違いは、Claude ProとMaxの利用制限を比較:5倍・20倍でも週間上限は残るで確認できます。
Claude Codeのモデル設定では、/model の別名 sonnet がSonnet 5.5、haiku がHaiku 5.5、opus がOpus 5.5、fable がFable 5.1を指します。Pro、Max、Team、EnterpriseとAnthropic APIでの既定(default)はOpus 5.5です。計画をOpus 5.5、実行をSonnet 5.5に分ける opusplan も使えます。
APIでOpus 5.5へ切り替えるときに確認すること
既存のOpus 5やFable 5.1の呼び出しをOpus 5.5へ置き換える場合は、モデルIDだけでなく、effort、max_tokens、thinking、tool choice、キャッシュの設定と実際のヒット状況を確認します。Opus 5.5の変更点と移行ガイドには、常時有効のthinkingや一部の強制的なtool choiceが使えないことなど、実装に影響する条件が記載されています。切り替え後は成功応答だけでなく、失敗時の処理も試してください。
下位2モデルを旧版から移す場合も、モデルIDの置き換えだけでは済みません。
- Sonnet 5からSonnet 5.5:入出力単価は同じ$2/$10で、キャッシュ読み取りは$0.20から$0.10に下がりました。effortの段階が調整し直されたため、以前の設定のまま比べず、effortごとに結果を取り直します。thinkingの無効化は
between_toolsに置き換わり、強制的なツール使用はエラー(400)になります(Sonnet 5.5の概要)。 - Haiku 4.5からHaiku 5.5:thinkingが既定で有効(effortは
medium)になり、temperature、top_p、top_kに既定以外の値を渡すと400エラーになります。プレフィルも使えません。トークン数はHaiku 5.5で数え直します(Haiku 5.5の変更点)。
ここに示した料金は標準の直接APIに限ります。料金表ではBatch(入出力とも半額)やOpus 5.5のFast modeが別に示されており、地域や利用経路でも請求条件が変わり得ます。導入先の料金を確かめてから試算してください。モデル固有の仕様は、Claude Opus 5.5の料金と使い方:Opus 5からの移行で確認することとClaude Fable 5.1:料金・API変更・移行ガイドにまとめています。
Claude Sonnet・Opus・Haikuの選び方で迷いやすい点
Claude Sonnet 5とHaiku 4.5はまだ使えますか?
使えます。2026年10月8日時点で、Sonnet 5とHaiku 4.5は旧モデルとして引き続き提供されています。Haiku 4.5の提供終了は「2026年10月15日以降」と最短日だけが示され、具体的な終了日はモデルの廃止予定に掲載されていません。料金面では、同じトークン量の試算でHaiku 4.5は1回の試行$0.061、エージェント実行$0.26で、Haiku 5.5の約10倍です。Sonnet 5は$0.122と$0.52で、キャッシュ読み取りが多い仕事ほどSonnet 5.5との差が広がります。Haiku 4.5は旧トークナイザーのため同じ文章のトークン数が少なく、実際の差はこれより小さくなります。
Claude SonnetとOpusはどちらが良いですか?
普段のコード作業や文書処理ならSonnet 5.5で足りることが多く、単価もOpus 5.5の半分です。長時間のエージェント作業や、失敗したときの手戻りが大きい仕事ではOpus 5.5を先に評価します。Sonnetでeffortを上げても合格条件に届かない仕事が、Opusへ上げる目安です。
Opus 5.5とFable 5.1で迷っているなら、Opus 5.5を基準に実タスクを評価するのが出発点です。Fable 5.1へ進む判断材料は、キャッシュの割合ではなく、Opusで満たせなかった合格条件と、それをFableがどの費用で満たせたかです。