2026年10月13日、Gemini 4 Argon(gemini-4-argon)の一般提供(GA)が始まり、3モデルとも開発者が使える状態になりました。Argonの入口は、Gemini APIの有料枠、Google AI Pro/Ultra契約者向けのGeminiアプリと検索のAIモード、Ultra契約者向けのGoogle Antigravity、GitHub Copilot(Pro+・Max・Business・Enterprise)です。どの入口にも無料枠はありません。Googleの一般提供の発表
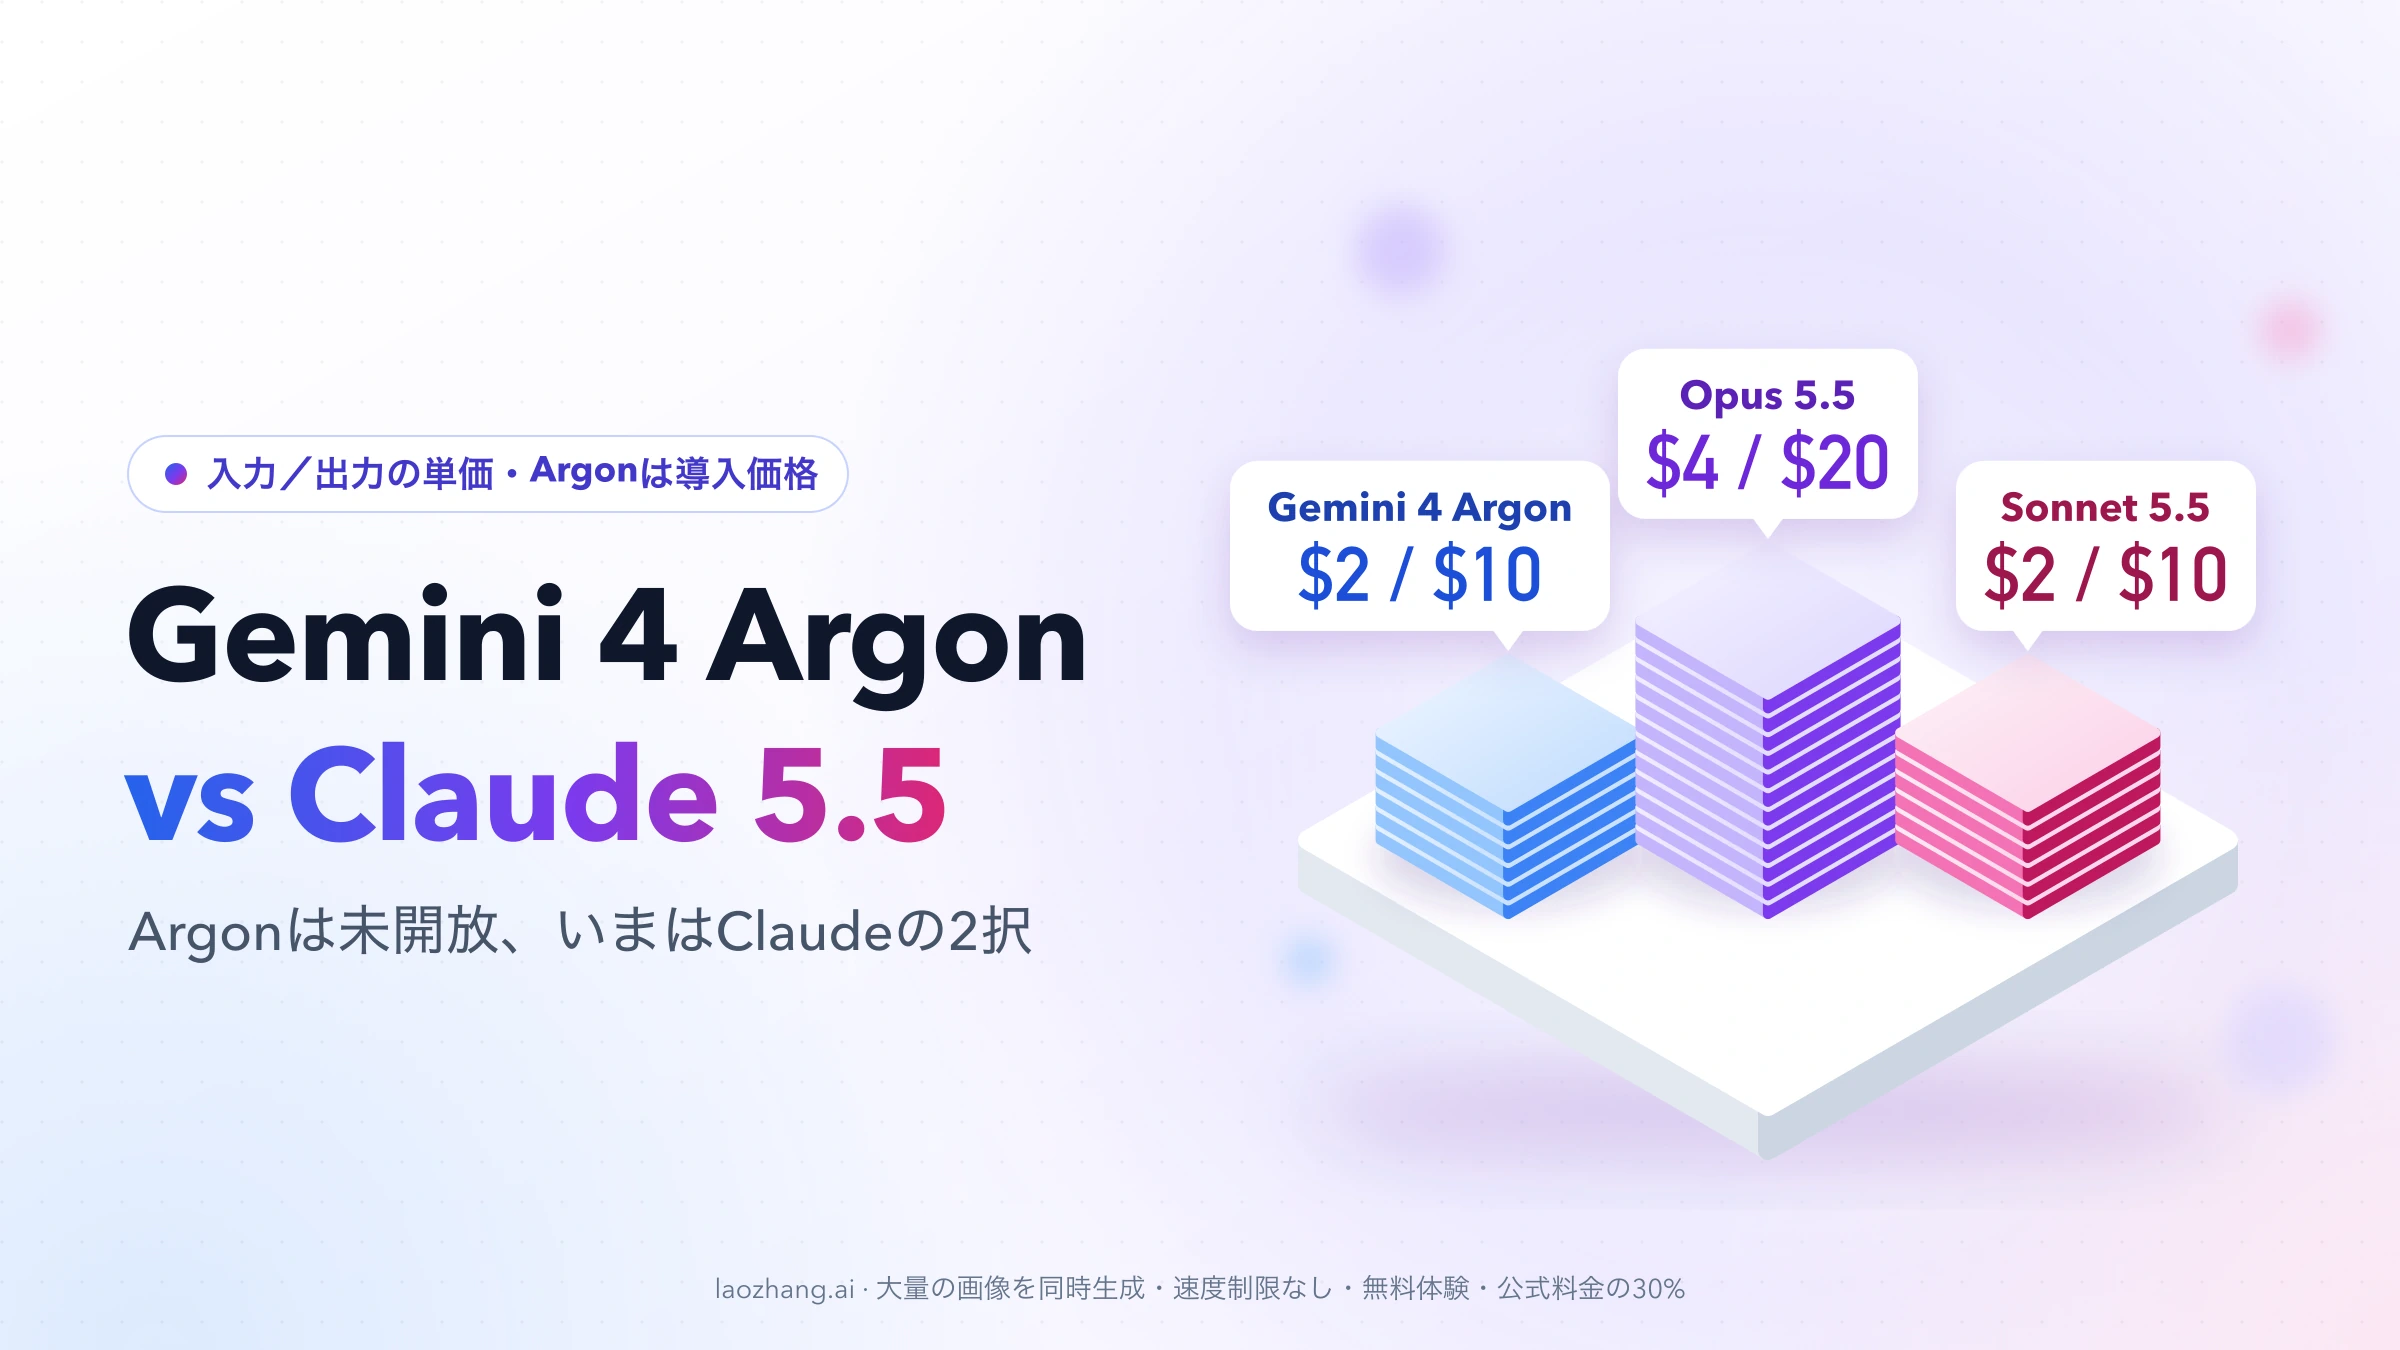
料金は時期で変わります。Gemini APIの単価は、2026年11月30日までが導入価格の入力$2/出力$10で、Claude Sonnet 5.5と同額です。12月1日からは$4/$20に上がり、Claude Opus 5.5と同額になります。Gemini APIの料金ページ
選び方は2段階で考えます。Claude側は、範囲のはっきりした日常的な作業はSonnet 5.5、数時間続く自律的なコーディングや大規模なリファクタリングはOpus 5.5から始めるのが、Anthropicの指針と公表値に沿った選び方です。Argonは、導入価格の続く11月30日までに自分が使える入口で同じタスクを試し、12月1日以降はOpus 5.5と同じ単価になる前提で費用を見積もってから乗り換えを決めます。
| 項目 | Gemini 4 Argon | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|---|
| 提供状況 | 2026年10月13日に一般提供(9月30日発表) | 2026年9月22日から提供 | 2026年9月28日から提供 |
| APIのモデルID | gemini-4-argon | claude-opus-5-5 | claude-sonnet-5-5 |
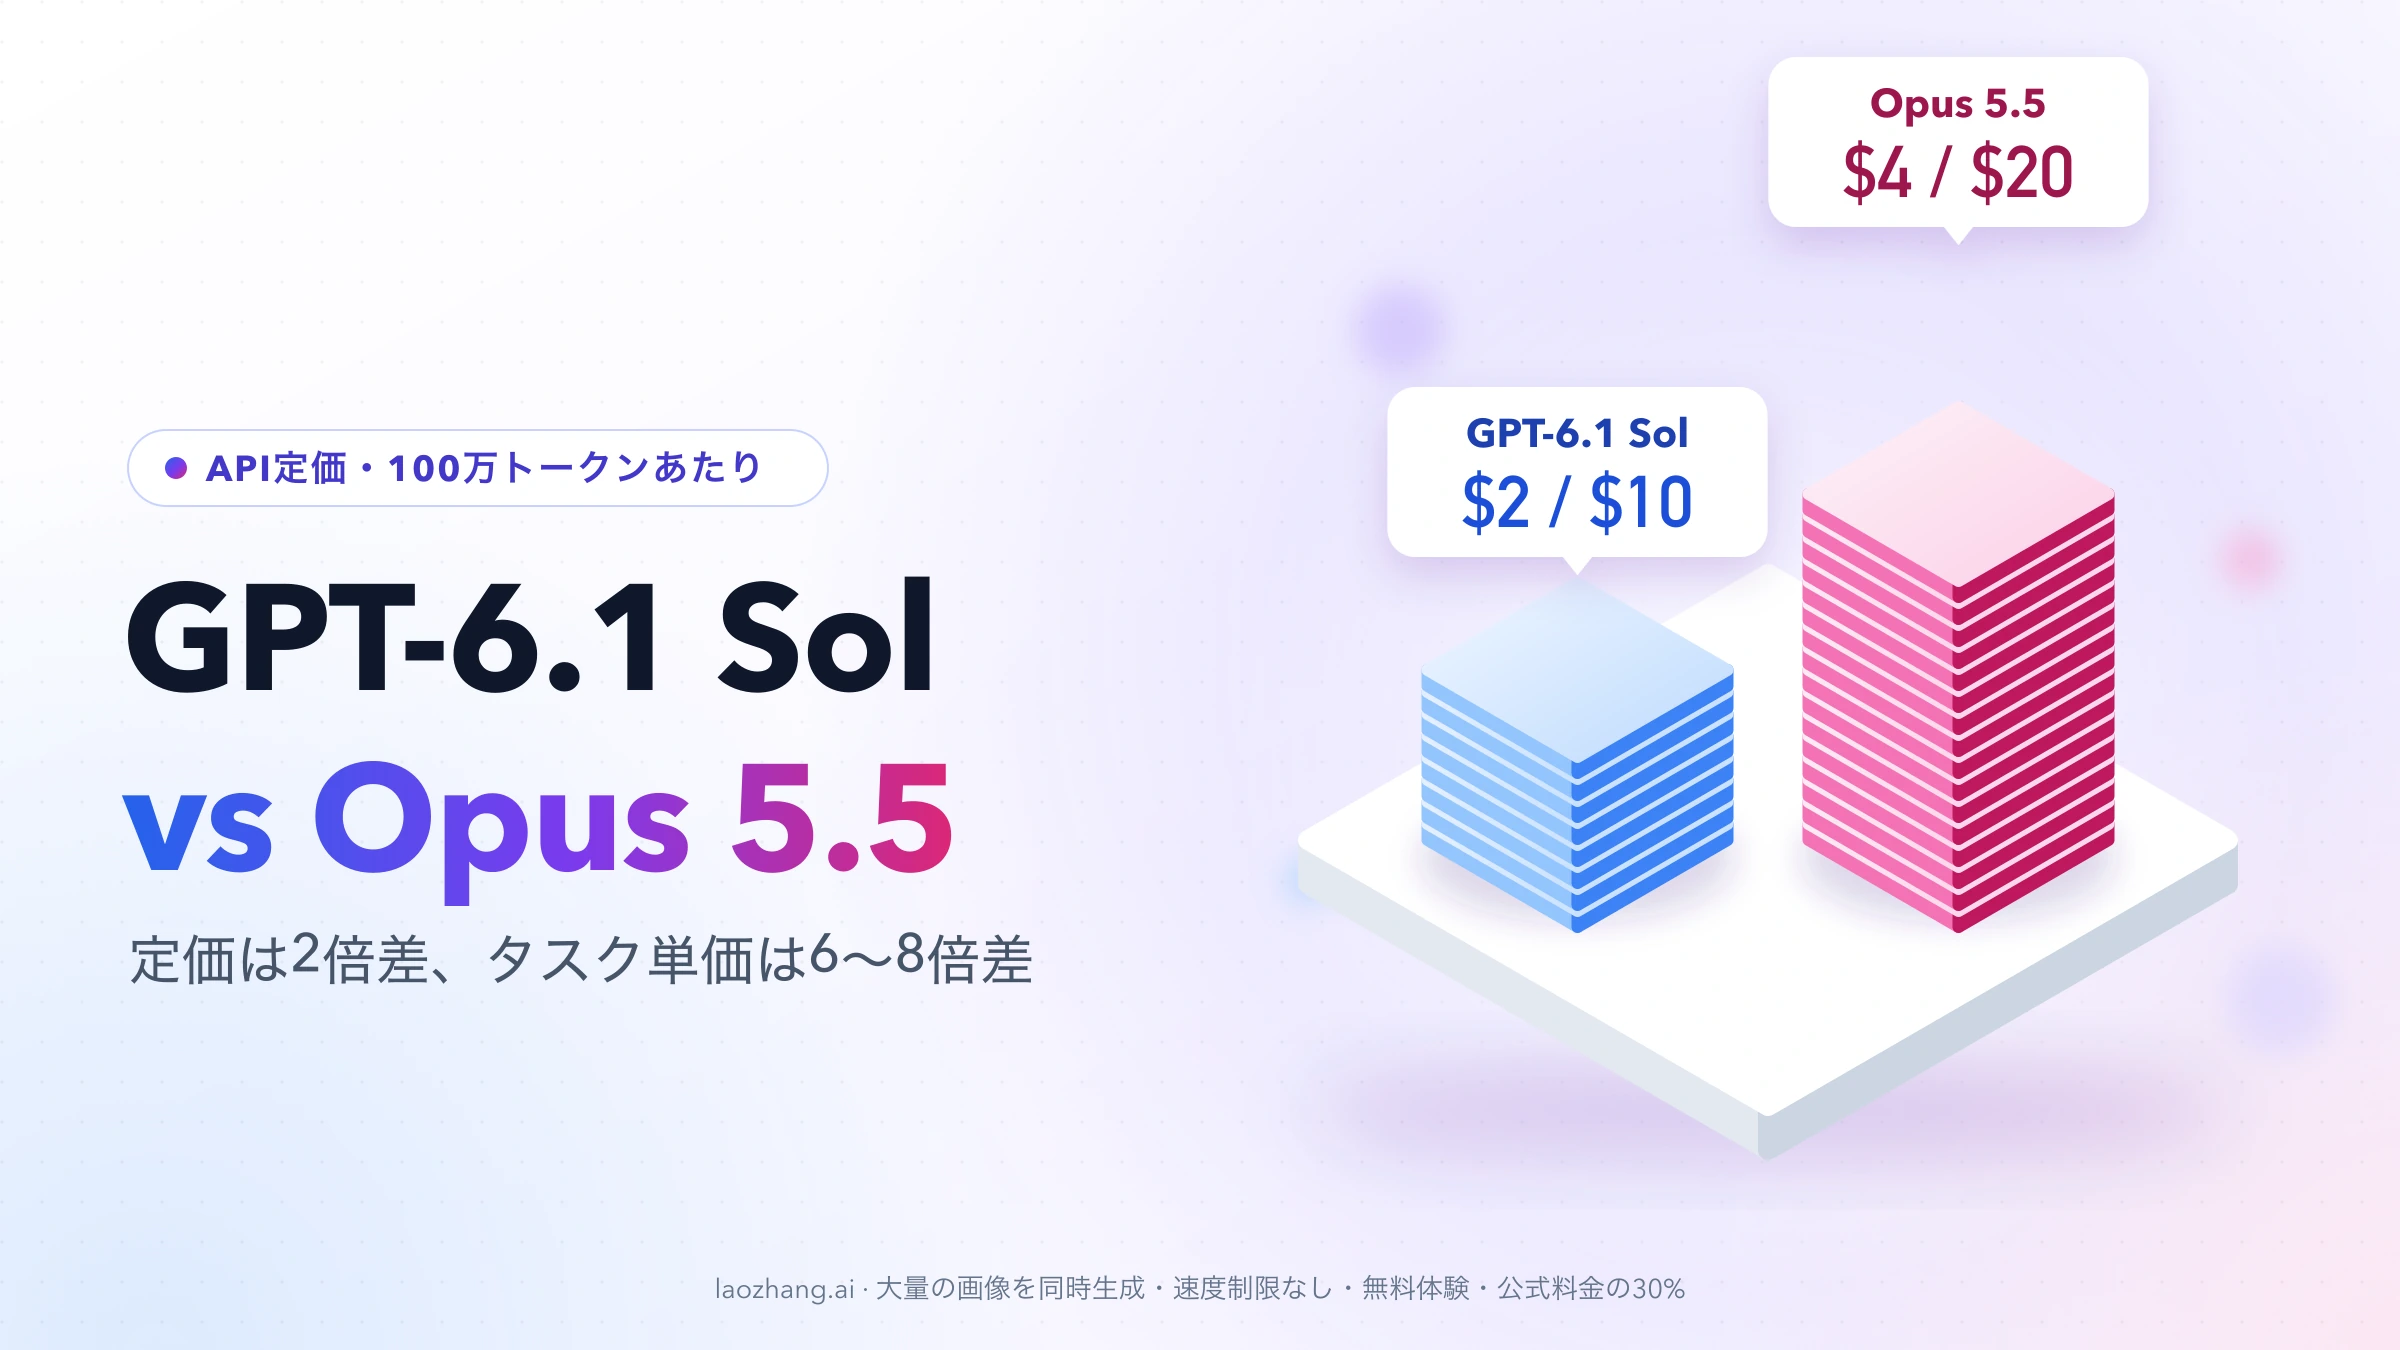
| 入力/出力の単価 | $2/$10(11月30日まで)、$4/$20(12月1日から) | $4/$20 | $2/$10 |
| キャッシュ読み取りの単価 | $0.10(11月30日まで)、$0.20(12月1日から) | $0.20 | $0.10 |
| コンテキストウィンドウ | 1,048,576トークン(入力と出力の合計) | 100万トークン | 100万トークン |
| 最大出力 | 65,536トークン(既定の同期出力)、long decodeで最大1,048,576トークン | 128Kトークン | 128Kトークン |
単価は米ドル・100万トークンあたり・税抜の公式価格で、2026年10月14日時点の値です。Claudeの最大出力は通常の同期リクエストの値です。
3モデルはどこで使えるか:Argonは10月13日に一般提供
Gemini 4 Argonの入口とプラン
Gemini APIの変更履歴は10月13日付でArgonを一般提供とし、モデルページでは安定版(Stable)として載っています。9月30日の発表時点では、セキュリティ防御の組織が参加するFairwind Programと一部のテスターに限られていました。一般提供後の入口は次のとおりです。
| 入口 | Argonを使える条件 | 費用の払い方 |
|---|---|---|
| Gemini API(Google AI StudioやAndroid Studioから) | 有料枠のAPIキー(Cloud Billingを有効化) | 従量課金。$2/$10、12月1日から$4/$20 |
| Google AI Studioの画面上のプラン枠 | Google AI Ultra | 月額プランに含まれる |
| Geminiアプリ、Google検索のAIモード | Google AI Pro、Google AI Ultra | 月額プランに含まれる |
| Google Antigravity | Google AI Ultra、企業向け契約 | 月額プランや契約に含まれる |
| GitHub Copilot | Copilot Pro+・Max・Business・Enterprise | 従量課金(プロバイダーの定価) |
| Gemini for business | 企業向け | 契約に含まれる |
Argonを使えないのは、Gemini APIの無料枠、Geminiアプリの無料プラン(Flash-Liteモデル)、Google AI Plus(米国で月$4.99、Flashモデル)、Google AI Studioの無料プランとAI Proプラン、Copilot FreeとCopilot Proです。Geminiのプラン一覧では、米国の月額はGoogle AI Proが$19.99、Google AI Ultraが$99.99または$199.99です。日本円の価格は国ごとのプランページで確認してください。
「Google AI Pro」の意味は場所によって違うので注意が必要です。Gemini APIの料金ページにある「Google AI Proプランでは使えない」は、AI Studioの画面で使えるプラン枠のことです。AI Studio向けプランの説明でもAI ProではArgonを使えず、AI Ultraでは使えるとされています。一方、GeminiアプリとAIモードでは、AI Pro契約者もArgonを選べます。AI StudioでAPIキーを使う呼び出しは、どのプランとも別に従量課金されます。
Copilotでは、VS Code、Visual Studio、Copilot CLI、Copilot coding agent、JetBrains IDE、Xcode、Eclipseなどのモデル選択に表示されます。BusinessとEnterpriseでは、管理者がモデルポリシーで無効にしていなければ自動で有効になります。課金は「プロバイダーの定価」による従量課金と案内されていますが、導入価格と12月1日以降の価格のどちらが当てはまるかは書かれていません。GitHubの変更履歴 GeminiアプリもCopilotも段階的に展開しているため、契約していても選択肢にまだ出ない場合があります。
上限の数え方もClaudeと違います。Argonの1,048,576トークンは入力と出力を合わせた上限で、たとえば90万トークンを入力すると、出力に使えるのは残りの約14.8万トークンです。同期リクエストの出力は既定で65,536トークンまでで、それを超える出力には継続用の仕組み(long decode)を使います。
Claude Opus 5.5とSonnet 5.5は提供中
2モデルはClaude APIの全利用者に提供されており、Amazon Bedrock(anthropic.claude-opus-5-5/anthropic.claude-sonnet-5-5)、Google Cloud、Microsoft Foundry、Claude Platform on AWSでも使えます。クラウド側のリージョンや利用権限はアカウントごとに異なります。Anthropicのモデル一覧
共通する仕様は、100万トークンのコンテキスト、同期リクエストで128Kトークンの最大出力、2026年6月までの知識、テキストと画像の入力・テキストの出力です。違いは次の3点に出ます。
| 違い | Opus 5.5 | Sonnet 5.5 |
|---|---|---|
| 応答速度の区分 | Moderate | Fast |
| 既定のeffort | medium | high |
| 思考の設定 | adaptive thinkingが常時有効 | adaptive。thinking: {"type":"between_tools"}で冒頭の思考を省ける(effortがlow・medium・highのとき) |
既定のeffortが違うため、設定を何も変えずに2モデルを比べると、Sonnet 5.5のほうが高いeffortで動いた結果を見ることになります。比較するときはeffortをそろえるか、それぞれ明示してください。
既存のコードを5.5系へ移す場合、両モデルともtool_choiceのanyとtool(ツールの強制指定)は400エラーになり、旧computer_20251124ツールも受け付けません。Opus 5.5はthinking: {"type":"disabled"}も拒否します。Sonnet 5.5の変更点 エラーになる設定の全体はClaude Opus 5.5の料金と使い方:Opus 5からの移行で確認することにまとめてあります。
料金:Argonは11月末までSonnet 5.5、12月からOpus 5.5と同じ単価
Gemini APIの標準料金は、11月30日までが入力$2/出力$10(思考トークンを含む)、12月1日から$4/$20です。前者はSonnet 5.5、後者はOpus 5.5の標準価格とちょうど同額です。キャッシュ読み取りとBatchも同じ関係で、Argonのどの項目も12月1日に2倍になります。
| 課金対象(100万トークンあたり) | Argon 11月30日まで | Argon 12月1日から | Opus 5.5 | Sonnet 5.5 |
|---|---|---|---|---|
| 入力 | $2 | $4 | $4 | $2 |
| 出力 | $10 | $20 | $20 | $10 |
| キャッシュ読み取り | $0.10 | $0.20 | $0.20 | $0.10 |
| 5分キャッシュ書き込み | なし | なし | $5 | $2.50 |
| 1時間キャッシュ書き込み | なし | なし | $8 | $4 |
| Batch(入力/出力) | $1/$5 | $2/$10 | $2/$10 | $1/$5 |
キャッシュの仕組みは両社で違います。Argonが対応するのは暗黙的キャッシュだけです。これは、同じ前置き部分を含むリクエストが続いたときにGoogle側が自動で再利用し、再利用できた入力にだけキャッシュ単価を適用する方式で、書き込み料金はありません。その代わり、どの部分がキャッシュに当たるかを開発者が指定することはできません。Claudeは開発者がキャッシュする範囲を指定する方式で、書き込み時に入力単価の1.25倍(5分)または2倍(1時間)を払い、読み取りは入力単価の5%です。Anthropicの料金表
ほかに、Argonには応答を優先するPriority(入力$3.60/出力$18、12月1日から$7.20/$36)と、Batchと同額のFlexがあります。Google検索によるグラウンディングは、Gemini 3以降のモデル全体で月5,000件まで無料、その後は1,000件あたり$14です。Claude側では、Opus 5.5にClaude API限定の研究プレビューとしてfast mode(入力$8/出力$40)があり、米国内に限定した推論は1.1倍になります。BedrockやGoogle Cloudの価格は各社が別に定めています。
同じトークン数で計算した場合
入力10万トークン、出力2万トークン、キャッシュなしの1回の処理で比べます。
- Sonnet 5.5:
0.1 × $2 + 0.02 × $10 = $0.40 - Opus 5.5:
0.1 × $4 + 0.02 × $20 = $0.80 - Argon(11月30日まで):
0.1 × $2 + 0.02 × $10 = $0.40 - Argon(12月1日から):
0.1 × $4 + 0.02 × $20 = $0.80
Opus 5.5はSonnet 5.5のちょうど2倍で、Argonは11月30日まではSonnet 5.5と、12月1日からはOpus 5.5と同額になります。
キャッシュを多く使うエージェントの1ターン
キャッシュ読み取り20万トークン、新規の入力2万トークン、出力5,000トークンの場合です。
- Sonnet 5.5:
0.2 × $0.10 + 0.02 × $2 + 0.005 × $10 = $0.11 - Opus 5.5:
0.2 × $0.20 + 0.02 × $4 + 0.005 × $20 = $0.22 - Argon(11月30日まで):
0.2 × $0.10 + 0.02 × $2 + 0.005 × $10 = $0.11 - Argon(12月1日から):
0.2 × $0.20 + 0.02 × $4 + 0.005 × $20 = $0.22
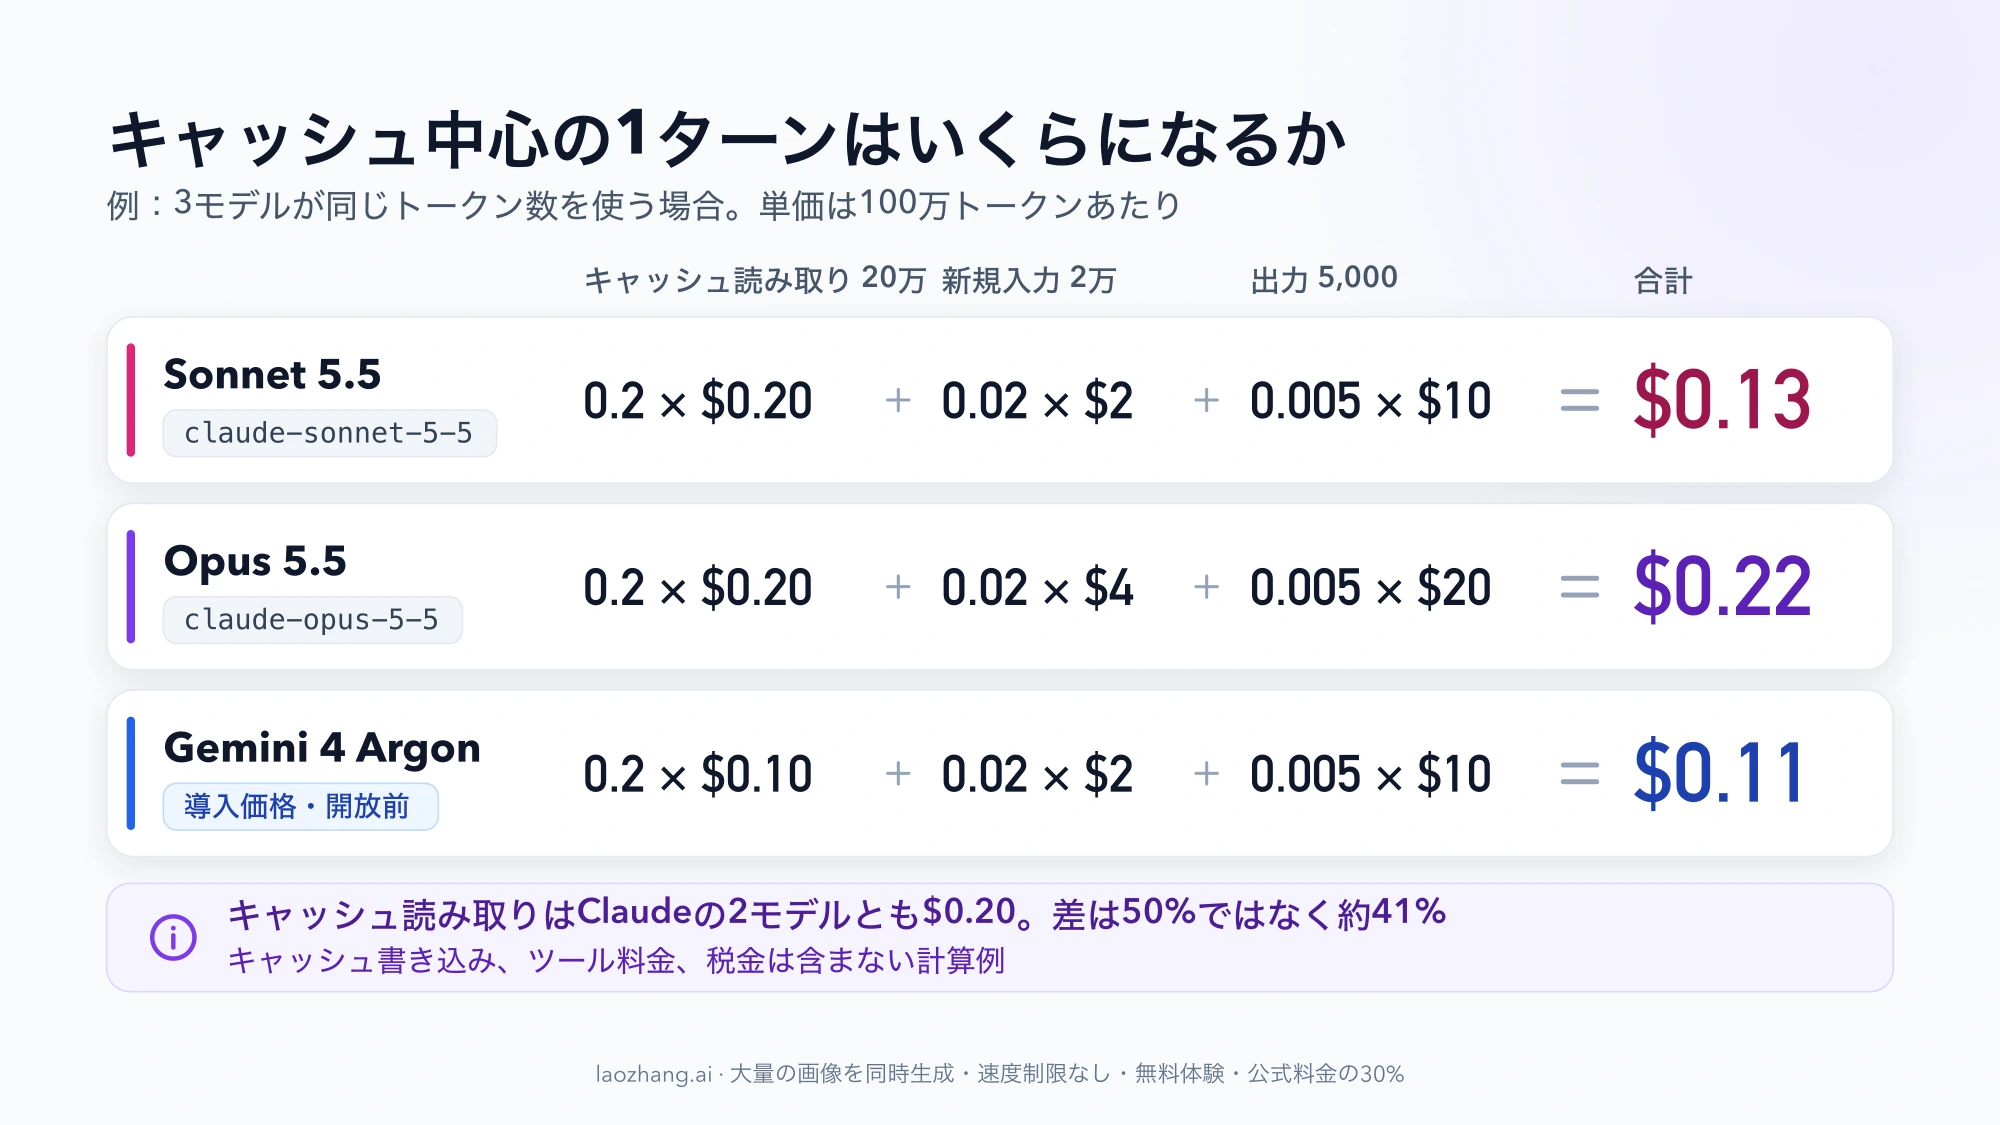
Sonnet 5.5のキャッシュ読み取りは$0.10なので、キャッシュの多い処理でもSonnet 5.5はOpus 5.5のちょうど半額です。Argonはここでも、時期によってどちらか一方と同額になります。
この計算は、どのモデルもキャッシュがすべて当たった状態を仮定しています。条件が崩れると、次のように差が出ます。
- Claudeのキャッシュ書き込み:最初にキャッシュを作るターンでは、20万トークンの5分キャッシュ書き込みがSonnet 5.5で
0.2 × $2.50 = $0.50、Opus 5.5で0.2 × $5 = $1.00加わります。 - Argonのキャッシュが当たらなかった場合:20万トークンが通常の入力として請求され、11月30日までは
0.2 × $2 + 0.02 × $2 + 0.005 × $10 = $0.49、12月1日からは0.2 × $4 + 0.02 × $4 + 0.005 × $20 = $0.98になります。
どちらの計算も、3モデルが同じトークン数を使うという仮定に基づく例で、ツール料金と税金は含めていません。実際には、トークナイザー、effortや思考レベル、思考の量によってモデルごとにトークン数が変わるため、単価が同じでもタスクあたりの費用は同じになりません。思考に使われたトークンが請求にどう現れるかは、推論トークンを二重計上しない:Gemini・OpenAI・Claudeのusage検算で3社分を確認できます。
ベンチマーク:誰が測った数字かで分けて読む
以下の数値はすべてベンダーまたは第三者の公表値です。3モデルが同じ尺度に並ぶのはVals IndexとArtificial Analysisの指数の2つで、両者の順位は逆になっています。Googleの比較表にSonnet 5.5はなく、AnthropicもArgonとの比較は出していません。
3モデルが並ぶVals Index
Vals Indexは、金融・コーディング・法務・税務のタスクを重み付けして集計する第三者のリーダーボードです。2026年10月13日更新のバージョン2.1では次のとおりです。
| モデル | スコア | 1テストあたりの費用 | 所要時間 |
|---|---|---|---|
| Gemini 4 Argon | 68.90% | $15.68 | 46分33秒 |
| Claude Sonnet 5.5 | 67.04% | $21.34 | 1時間18分 |
| Claude Opus 5.5 | 66.97% | $32.14 | 1時間19分 |
ここから読み取れるのは2点です。Argonは約1.9ポイント差で先頭にあり、費用と時間も最も少ない値になっています。Sonnet 5.5とOpus 5.5の差は0.07ポイントで、Vals自身が実質的に同点と説明しており、Sonnet 5.5の費用はOpus 5.5の約3分の2です。
読むときの注意も2点あります。Argonの費用が導入価格と12月1日以降の価格のどちらで計算されたかは、ページに明記されていません。また、このリーダーボードは再実行や構成の変更で値が動きます。数字を引用するときは、日付とバージョンを添えてください。
Artificial Analysisの指数ではClaudeが上
Artificial AnalysisのIntelligence Index v4.3.2では、順位がVals Indexと逆になります。
| モデル(推論設定) | 指数 | 指数全体の実行費用 |
|---|---|---|
| Claude Opus 5.5(Max) | 58 | $8,708 |
| Claude Sonnet 5.5(Max) | 56 | $7,260 |
| Gemini 4 Argon(High) | 53 | $2,407 |
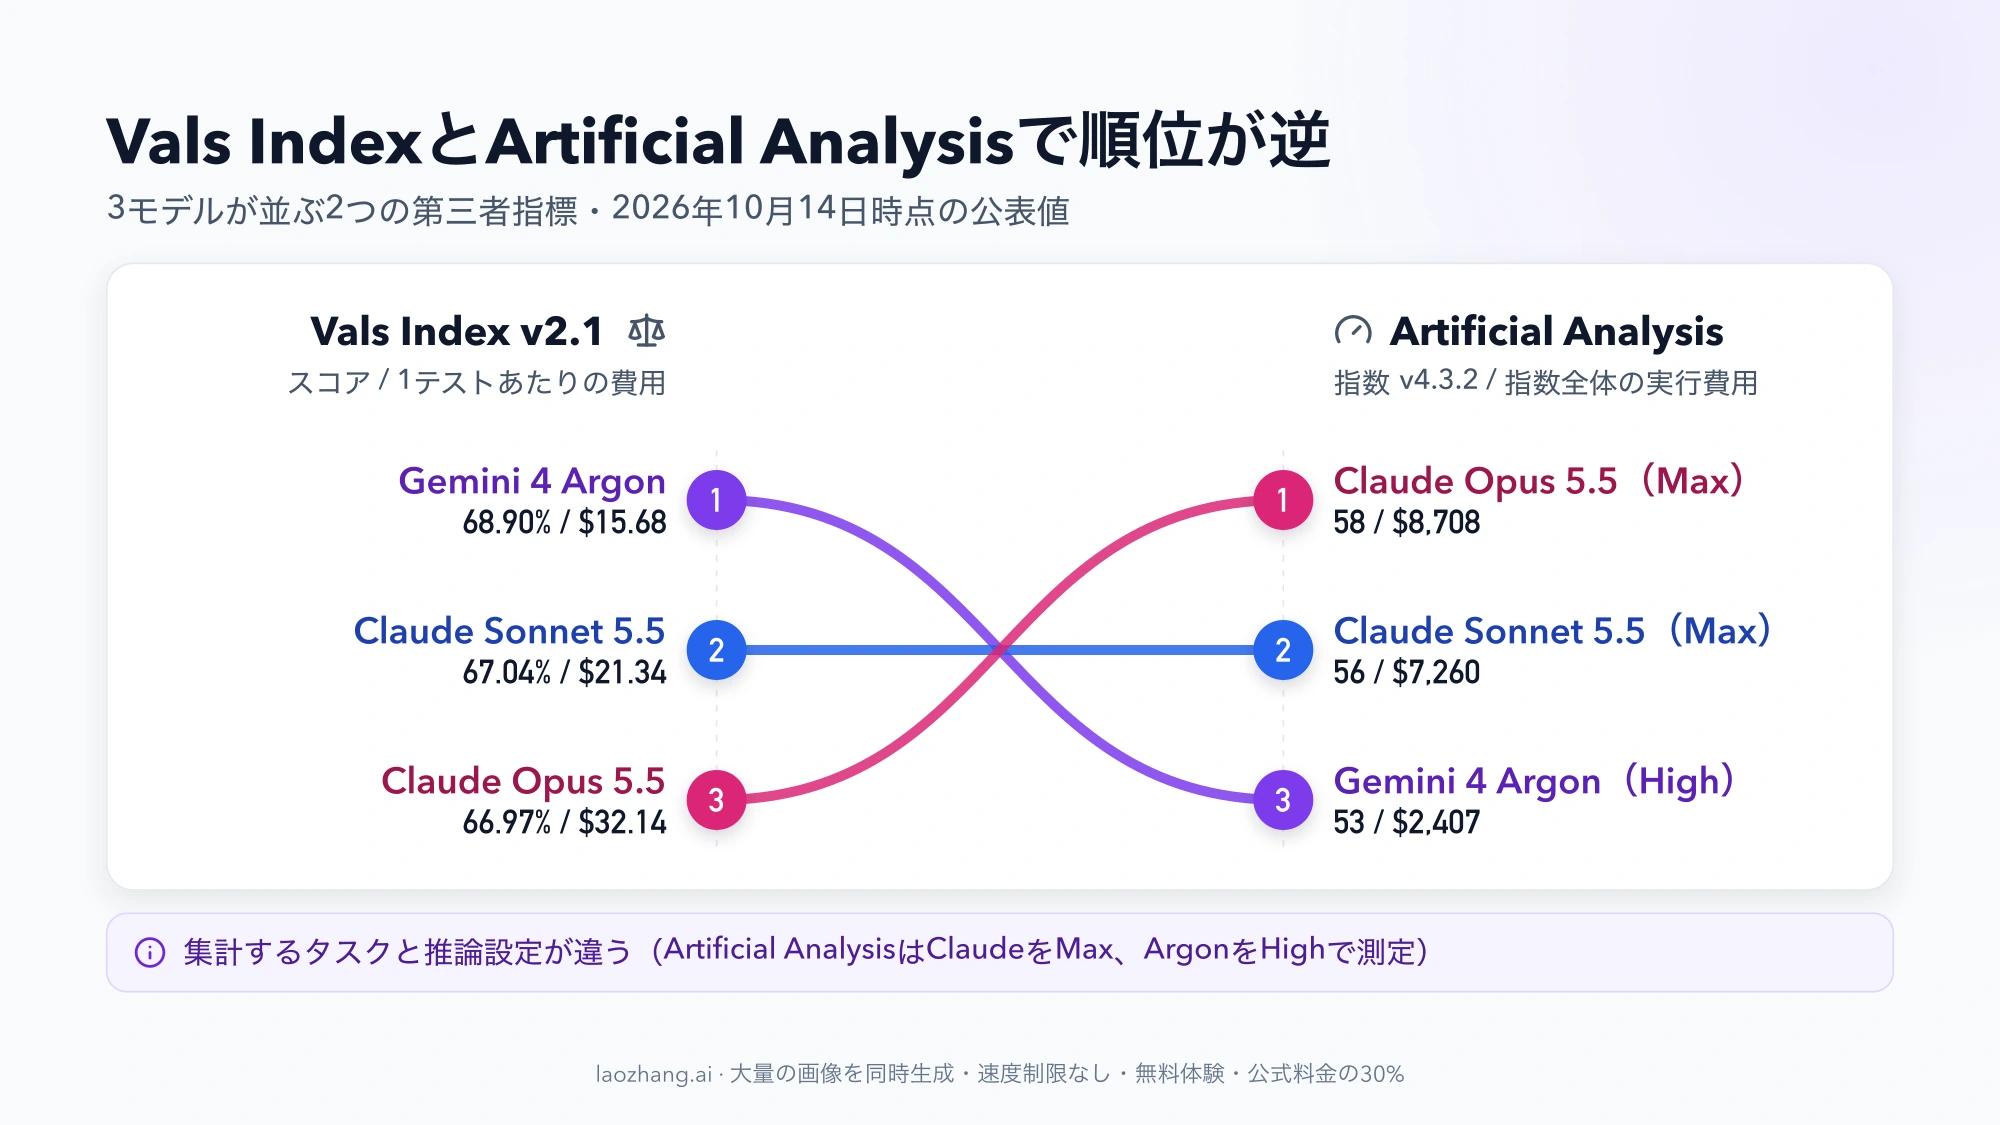
食い違う理由は、測っているものと条件の両方にあります。Vals Indexは金融・法務・税務を含む業務タスクの重み付き集計で、Artificial Analysisは独自のテスト群を集計した指数です。また、この指数ではClaudeの2モデルが最大のMax設定、ArgonがHigh設定で測られています。Sonnet 5.5との比較ページも同じ条件です。
どちらの尺度でも差は数ポイントで、実行費用ではArgonが目立って少なくなっています。つまり「どれが一番賢いか」は尺度しだいです。2つの尺度で共通しているのは、Argonの実行費用が3モデルの中で最も少ないことです。自分の用途での順位は、自分のタスクで比べるまで決まりません。
Googleの比較表はArgon対Opus 5.5
Googleのモデルページの表から、ArgonとOpus 5.5の列を抜き出します。単位はすべて%で、2026年10月14日時点の値は9月30日の発表時から変わっていません。
| 分野 | ベンチマーク | Gemini 4 Argon | Claude Opus 5.5 |
|---|---|---|---|
| 知識労働 | Vals Index | 68.9 | 67.0 |
| 知識労働 | AutomationBench | 51.3 | 42.5 |
| 知識労働 | Vals Finance Agent v2 | 65.4 | 58.6 |
| 知識労働 | Harvey Legal Agent Benchmark | 19.6 | 3.8 |
| コーディング | DeepSWE v1.1 | 77.9 | 74.2 |
| コーディング | Vibe Code Bench | 91.9 | 90.3 |
| コーディング | FrontierSWE v2 | 55.0 | 62.3 |
| コーディング | Terminal-Bench 4.0 | 57.4 | 66.4 |
| 機械学習エンジニアリング | PostTrainBench | 45.3 | 49.3 |
| 科学・数学 | Terminal-Bench Science 0.1 | 57.6 | 63.3 |
| 科学・数学 | LABBench 2 | 88.8 | 73.1 |
| 科学・数学 | RiemannBench | 76.0 | 69.6 |
| 長文脈 | GraphWalks(128kまで) | 99.7 | 90.6 |
| 長文脈 | GraphWalks(256k〜1M) | 84.2 | 66.8 |
| コンピュータ操作 | Agent's Last Exam | 39.5 | 38.2 |
| マルチモーダル | Chartography | 71.6 | 66.3 |
| マルチモーダル | LVBench | 91.7 | 83.7 |
| サイバーセキュリティ | CWE-bench v1 | 68.0 | 67.0 |
太字はOpus 5.5が上回る4項目です。残りの14行ではArgonが上で、差が大きいのは法務エージェント、長文脈のGraphWalks、LABBench 2、動画理解のLVBenchです。Opus 5.5が上回るのは、FrontierSWE、ターミナル操作を伴う2つのベンチマーク、モデルの追加学習を行うPostTrainBenchで、長時間のエンジニアリング作業に偏っています。DeepSWEなどこの表の項目にSonnet 5.5の値はなく、Anthropicの発表にもDeepSWEの数値はありません。
この表はベンダーが項目を選んだものです。Googleの評価方法の説明によると、条件は次のとおりです。
- Argonは最も高い思考設定で実行。他社モデルは原則として各社の自己申告値か公開リーダーボードの値で、最大の推論設定、なければ最良の公表値を採用
- PostTrainBench、LABBench 2、GraphWalks、LVBenchは全モデルをGoogleが自社で実行
- LVBenchは「APIの制約」を理由に入力フレーム数がモデルごとに異なる(Geminiは1FPS、Opus 5.5は600フレーム)
- DeepSWE、Terminal-Bench 4.0、Terminal-Bench Science、Agent's Last ExamのArgonの値はGoogleの自社実行で、他社の値は公開リーダーボードなどから引用
つまり、実行者や実行環境がモデルごとに違う行が混ざっています。1〜2ポイントの差(Vibe Code Bench、Agent's Last Exam、CWE-bench)を優劣の根拠にするのは無理があり、傾向として読むのが妥当です。
Anthropicが公表するSonnet 5.5とOpus 5.5の差
AnthropicのSonnet 5.5発表には、2モデルを並べた数値があります。
| ベンチマーク | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 66.4% |
| FrontierCode 1.1 | 46.2%(max)/52.1%(xhigh) | 54.4% |
| CursorBench 4.0 | 55.5% | 57.8% |
| GDPval-AA v2.1 | 1844 | 1846 |
| AA-Briefcase v1.1 | 1811 | 1822 |
| Humanity's Last Exam(ツールあり) | 64.5% | 67.7% |
| OSWorld 2.1 | 80.1% | 81.8% |
| Chartography(ツールなし) | 61.6% | 64.4% |
Terminal-Bench 4.0のOpus 5.5は、最も良い結果が出たxhighでの値です。この項目だけSonnet 5.5が上回り、残りはOpus 5.5が上か、ほぼ同じです。差が開くのはFrontierCodeとHumanity's Last Examで、GDPval-AAのような業務タスクの指標では2ポイント差しかありません。
Anthropicはこの結果を踏まえ、Sonnet 5.5を「範囲のはっきりした日常的なタスク」向けとし、複雑で終わりの決まっていない作業ではOpus 5.5が「明確に強い」と説明しています。同じ発表にある「出力が30%以上速い」「タスクあたりの費用が最大30%低い」はSonnet 5との比較で、Opus 5.5やGeminiとの比較ではありません。
なお、Opus 5.5のChartographyはこの表で64.4%、Googleの表で66.3%と一致しません。実行や設定が異なる値なので、2つの表の列を混ぜて順位を付けないでください。
いま使うならSonnet 5.5とOpus 5.5のどちらが良いか
Anthropicのモデル選択ガイドは「ほとんどのワークロードはOpus 5.5から始める」としたうえで、用途を次のように分けています。
| 作業の性質 | 先に試すモデル | 根拠 |
|---|---|---|
| コード生成、データ分析、文章作成、画像の読み取り、ツールを使う定型的なエージェント | Sonnet 5.5 | Anthropicの推奨用途。Vals IndexでOpus 5.5と実質同点、1テストあたりの費用は約3分の2 |
| 数時間続く自律的なコーディング、大規模なリファクタリング、複雑なシステム設計 | Opus 5.5 | Anthropicの推奨用途。FrontierCodeで54.4%対46.2〜52.1% |
| コンピュータ操作、画像を多用するワークフロー | Opus 5.5 | Anthropicの推奨用途。OSWorld 2.1は81.8%対80.1%で差は小さい |
| 応答の速さを優先する対話や大量処理 | Sonnet 5.5 | 速度区分がFast。Batchは入力$1/出力$5 |
迷う場合は、失敗したときのやり直しの費用で決めます。1回の失敗が数十分の再実行や人手の確認につながる作業では、単価が2倍でもOpus 5.5のほうが総額で安くなる余地があります。短く区切れて結果をすぐ検証できる作業は、Sonnet 5.5で始めて不足が出た部分だけOpus 5.5に回すほうが無駄がありません。
Argonをこの表に加えるなら、比べる相手は時期で変わります。11月30日まではSonnet 5.5と同じ単価なので「Sonnet 5.5の作業をArgonに置き換えて結果が良くなるか」、12月1日からはOpus 5.5と同じ単価なので「Opus 5.5の作業をArgonに任せられるか」を確かめることになります。
モデルを切り替える前に試す価値があるのがeffortです。Anthropicは、effortの調整はモデルの切り替えより有効な手段であることが多いと案内しています。Opus 5.5の5段階の選び方はClaude Opus 5.5のeffort設定:5段階の選び方と費用・キャッシュへの影響、Claudeのほかのモデルを含めた比較はClaude Opus 5.5とFable 5.1を比較:料金と使い分けを参照してください。
Gemini 4 Argonを試すなら:12月1日の値上げ前に確かめること
導入価格の期間は、同じ費用でSonnet 5.5の代わりになるかを試せる期間です。次の順に確かめると、12月1日以降も使い続けるかを判断できます。
- 測る入口を決める トークン数と費用を正確に比べられるのはGemini APIの有料枠です。GeminiアプリやCopilotは使い心地の確認には向きますが、Claudeとタスクあたりの費用を比べる材料としては使いにくい入口です。Copilotがどちらの時期の単価で課金するかは公表されていません。
- 自分のタスクでのトークン数 同じ入力を3モデルに渡し、入力・出力・思考のトークン数と完了までの費用を記録します。単価が同じでも、ここが違えば費用は変わります。
- 暗黙的キャッシュの当たり方 Argonではキャッシュを指定できないため、usageの記録でキャッシュ単価が適用された入力トークンの割合を見ます。当たらなければ、上のキャッシュ中心の例は$0.11ではなく$0.49になります。
- 結果の差が出やすい作業 Googleの表でArgonが大きく上回るのは長文脈の探索、動画理解、法務・金融のエージェント作業です。逆にターミナル操作を伴う長いエンジニアリング作業ではOpus 5.5が上でした。自分の用途がどちらに近いかで、試す優先度が決まります。
- 出力の長さ 1回の応答で128Kトークンを超える出力が必要な用途は、Claudeの同期リクエストでは収まりません。Argonでも既定は65,536トークンなので、long decodeの設定が必要です。
- APIの違い Argonの思考レベルは
low・medium・highの3段階で、5段階あるOpus 5.5のeffortとは設定の刻みが違います。明示的なキャッシュとLive APIには対応していません。既存のコードがそのまま動く前提では計画しないでください。 - 12月1日以降の費用 Argonの試算結果を2倍にし、Opus 5.5で同じ作業をした場合と比べます。そこで結果も費用もOpus 5.5を上回らないなら、乗り換える理由は薄くなります。
モデル名と単価を設定値として切り出しておけば、12月1日の前後で比べ直す作業は小さく済みます。
よくある質問
Gemini 4 Argonはいつから使えますか?
2026年10月13日から一般提供されています。Gemini APIの有料枠、Geminiアプリと検索のAIモード(Google AI Pro/Ultra)、Google Antigravity(Ultra)、GitHub Copilot(Pro+・Max・Business・Enterprise)で同じ日に提供が始まりました。GeminiアプリとCopilotは段階的に展開しているため、表示されるまで時間がかかる場合があります。9月30日の発表から10月12日までは、Fairwind Programの参加組織と一部のテスターに限られていました。
Gemini 4 Argonは無料で使えますか?
使えません。Gemini APIの料金ページでは、Argonの無料枠はすべての項目で「Not available」です。Geminiアプリの無料プランとGoogle AI Plus、AI Studioの無料プランとAI Proプラン、Copilot FreeとCopilot Proも対象外です。費用がかからないのは審査のある申請だけで、研究者向けにGoogle Antigravityの最上位枠を6か月無料で使える募集と、セキュリティ防御の組織向けのFairwind Programがあります。
無料で試せるGeminiのAPIが必要なら、無料枠のあるGemini 3.8 Flashが候補です。有料枠の単価は2026年12月31日まで入力$0.75/出力$3.75です。詳しくはGemini 3.8 Flash APIガイド:モデルID・料金・仕様・移行とGemini APIの無料枠は今も使える?上限の確認方法と課金の境界を参照してください。
Gemini 4 Argonはどこで使えますか?
開発者はGemini APIの有料枠(Google AI StudioやAndroid Studioで発行したAPIキー)、一般の利用者はGoogle AI ProかUltraを契約したうえでGeminiアプリと検索のAIモード、Ultra契約者はGoogle AntigravityとAI Studioの画面、Copilot利用者はPro+・Max・Business・Enterpriseのモデル選択で使えます。企業向けにはGemini for businessもあります。条件と課金方法の一覧は、上の「Gemini 4 Argonの入口とプラン」の表にあります。
Google AI ProでもGemini 4 Argonは使えますか?
GeminiアプリとGoogle検索のAIモードでは使えます。AI Studioの画面とGoogle Antigravityでは、AI ProではArgonを選べず、Google AI Ultraが必要です。APIキーで呼び出す場合はどのプランとも関係なく、有料枠の従量課金になります。
Gemini 4 Argonは結局Opus 5.5より高性能ですか?
尺度によって答えが変わります。Googleの比較表では18行中14行でArgonが上、4行でOpus 5.5が上で、第三者のVals IndexでもArgonが68.90%、Opus 5.5が66.97%です。一方、Artificial Analysisの指数ではOpus 5.5(Max)が58、Argon(High)が53でOpus 5.5が上です。公表値から言えるのは「長文脈・動画・法務や金融のエージェント作業ではArgon、ターミナル中心の長いエンジニアリング作業ではOpus 5.5」という傾向までです。一般提供が始まったので、自分のタスクで比べられます。
Sonnet 5.5はOpus 5.5の半額で同じ性能ですか?
単価は半額ですが、性能が同じとは言えません。Vals Indexでは0.07ポイント差の実質同点で、1テストあたりの費用は半分ではなく約3分の2でした。Anthropicの数値では、FrontierCodeやHumanity's Last ExamでOpus 5.5が上回ります。範囲の決まった作業なら差は出にくく、複雑で長い作業ほど差が出やすいと読むのが妥当です。
Argonの導入価格ならSonnet 5.5より安くなりますか?
単価の上ではほぼ同じです。11月30日までは入力$2/出力$10、キャッシュ読み取り$0.10がすべてSonnet 5.5と同額で、キャッシュ中心の計算例でもどちらも$0.11でした。差が出るのはキャッシュの扱いで、Sonnet 5.5は最初の書き込みに料金がかかり、Argonは書き込み料金がない代わりにキャッシュが当たるかを指定できません。実際の費用は、自分のタスクでのトークン数とキャッシュの当たり方で決まります。12月1日からはArgonの単価が2倍になり、Opus 5.5と同額になります。