截至 2026 年 10 月 8 日,按三家官方标准价(每百万 token,输入 / 输出)对齐档位,结论是:
- 低价档几乎同价:Gemini 2.5 Flash-Lite $0.10 / $0.40,GPT-6 Luna 和 Claude Haiku 5.5 都是 $0.10 / $0.50。每月 50 万次短请求(每次 1,500 输入 + 500 输出 token),三者只差 $25。
- 中档 Gemini 3.8 Flash 最便宜:$0.75 / $3.75,但这是 2026 年 12 月 31 日前的价格,2027 年 1 月 1 日起变为 $1.50 / $7.50,仍低于 GPT-6.1 Sol 和 Claude Sonnet 5.5 的 $2 / $10。Gemini 3.1 Pro Preview 是 $2 / $12,输出反而比这两家贵。
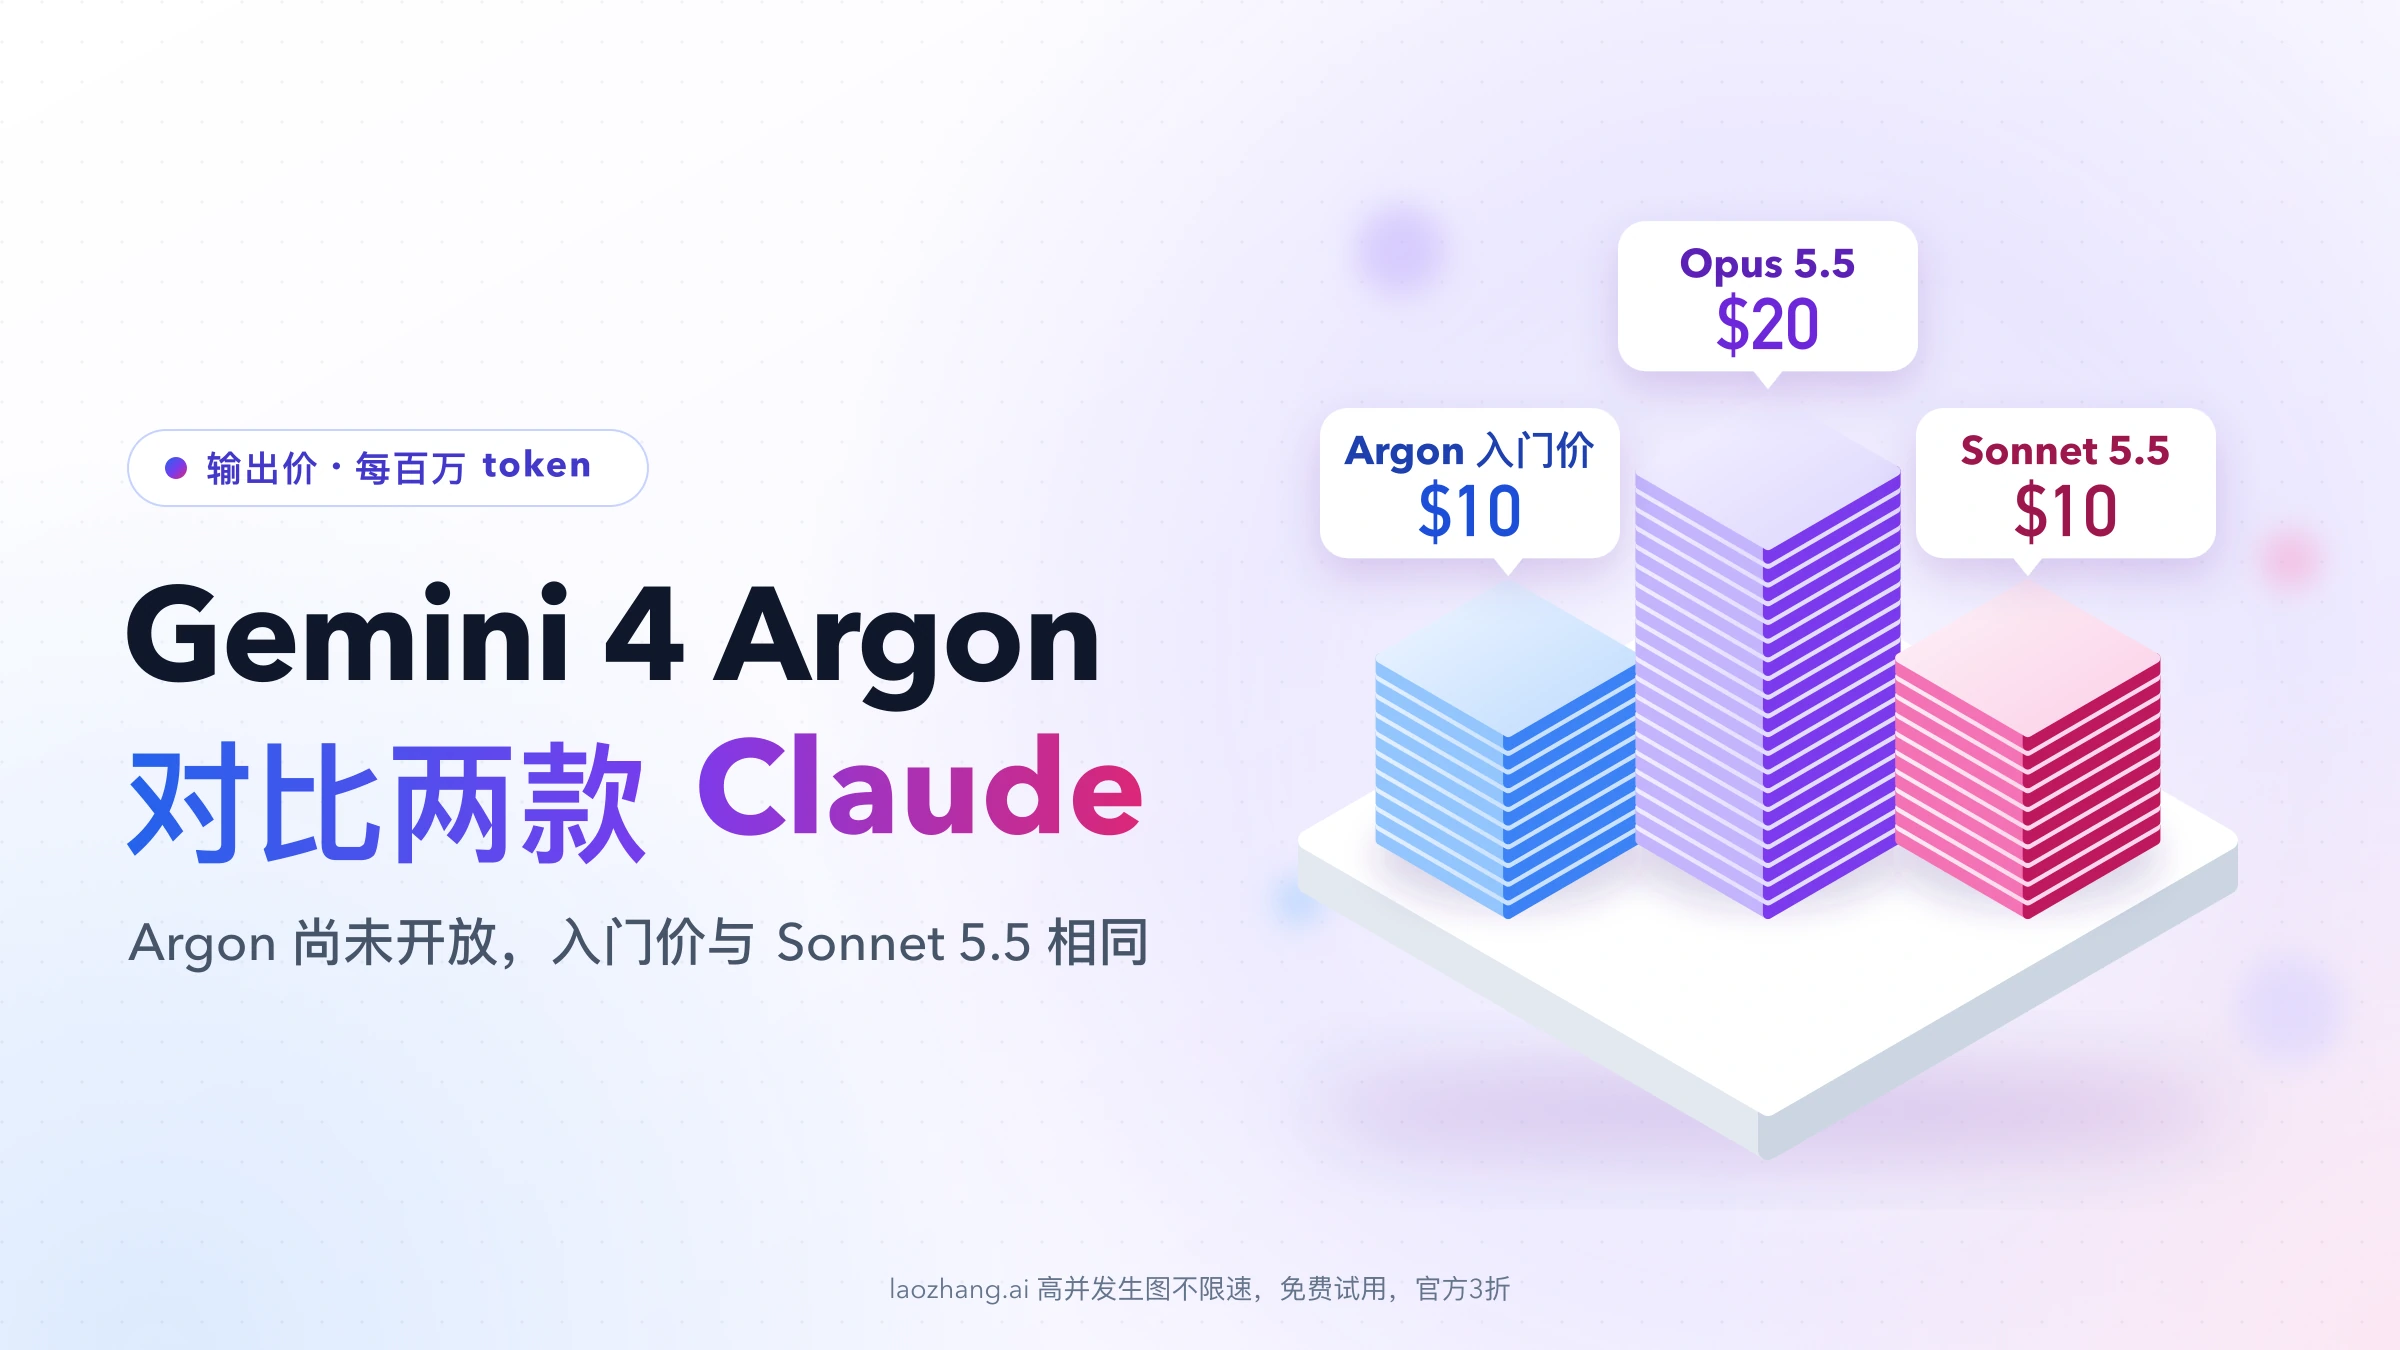
- 旗舰档 Claude Opus 5.5 标价最低:$4 / $20;GPT-6 Astra 和 Claude Fable 5.1 同为 $10 / $50。Google 的 Gemini 4 Argon 只向受邀测试者开放,没有公开价格。
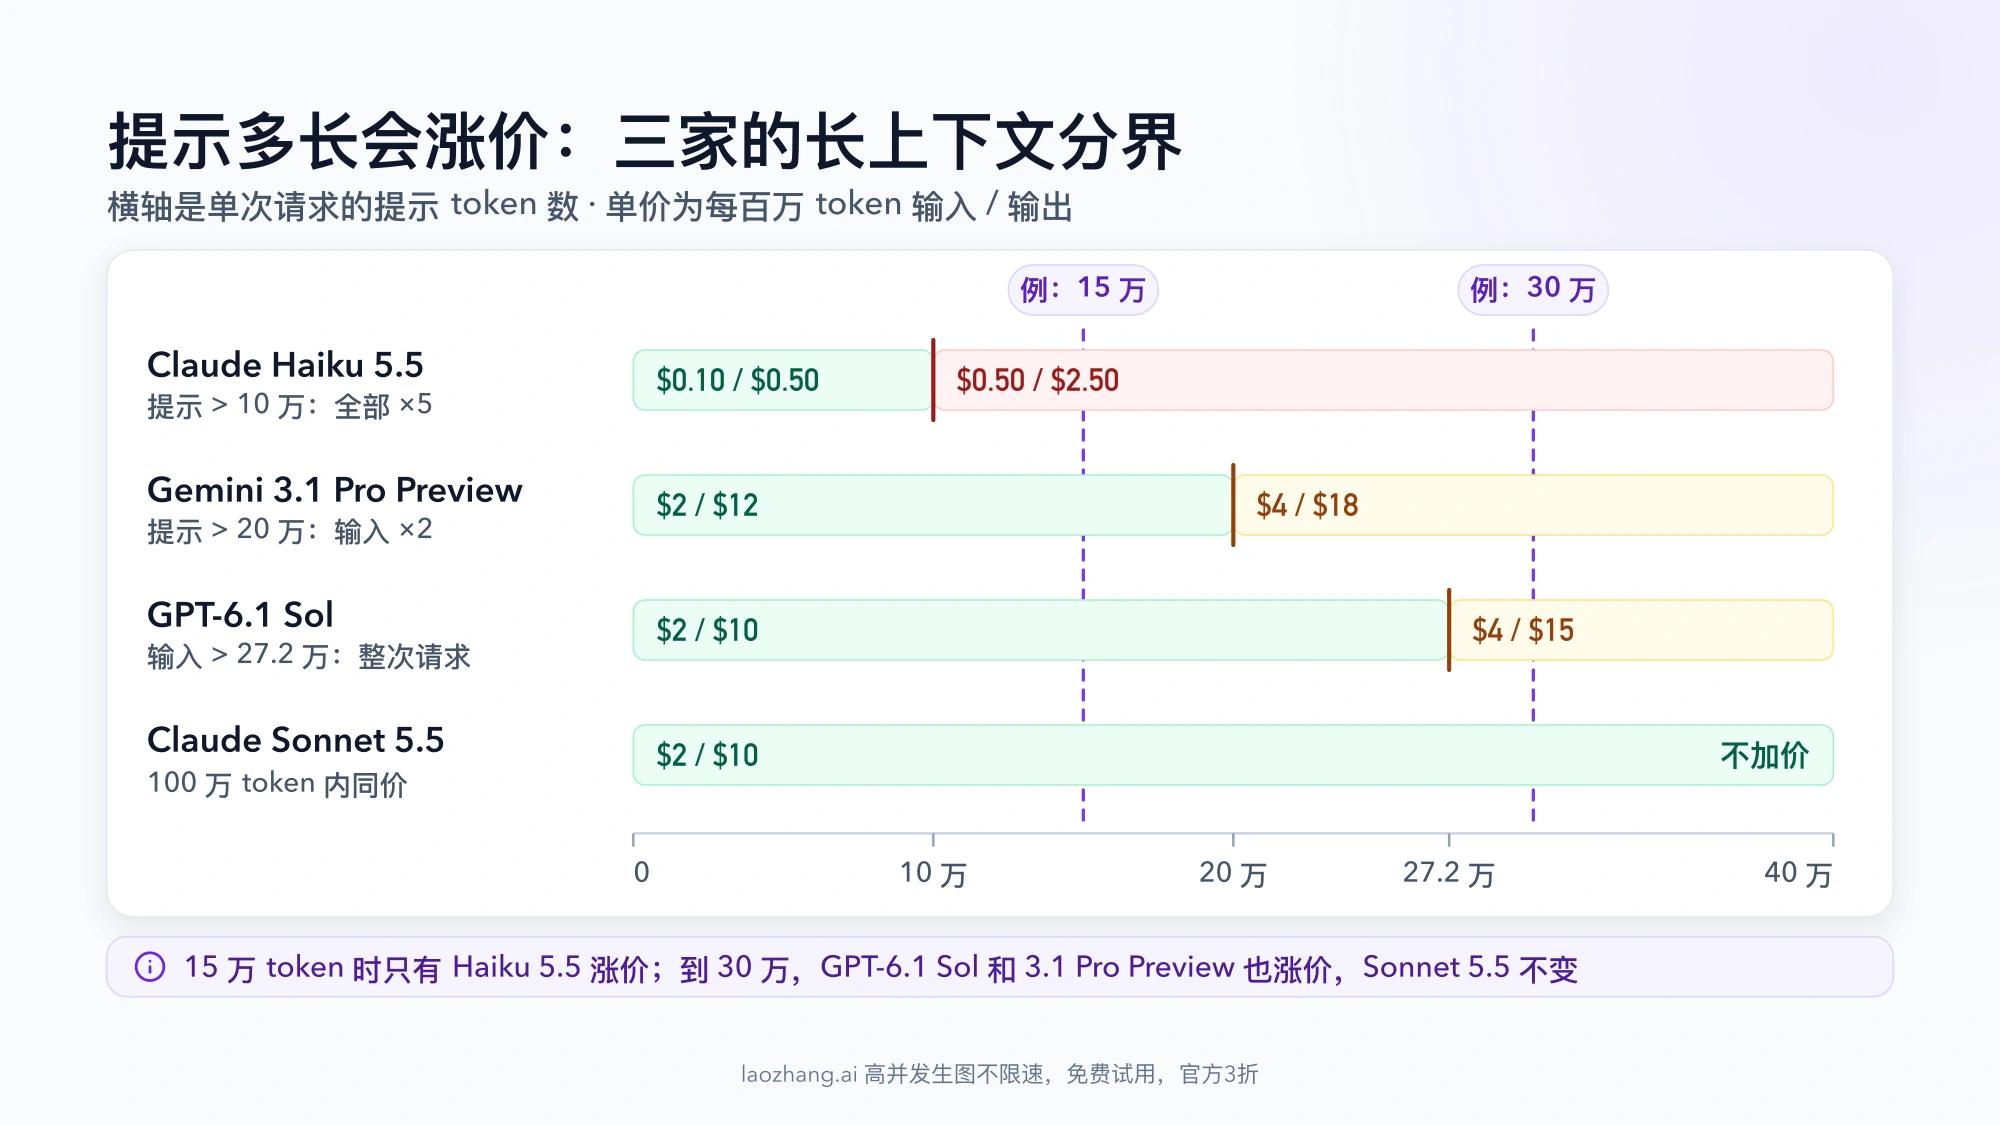
所以“Gemini 每一档都最便宜”已经不成立。真正让账单偏离标价的是这几条规则:Claude Haiku 5.5 的提示超过 10 万 token 后所有单价乘 5;OpenAI GPT-6 系列的输入超过 27.2 万 token 时整次请求改按长上下文价;Gemini Pro 系列的提示超过 20 万 token 涨价;三家的思考 token 都按输出价计费;Batch 都是半价。按负载怎么选,直接看文末的规则表。
三家 API 分档价格对比:Gemini 已不是每一档都最便宜
档位按价格带和厂商自己的产品定位划分,同一档的模型能力并不相等,选定之前仍要用自己的任务测一遍输出质量。
| 档位 | Google Gemini | OpenAI | Anthropic Claude |
|---|---|---|---|
| 低价档 | 2.5 Flash-Lite:$0.10 / $0.40 | GPT-6 Luna:$0.10 / $0.50 | Haiku 5.5:$0.10 / $0.50(提示 ≤10 万 token) |
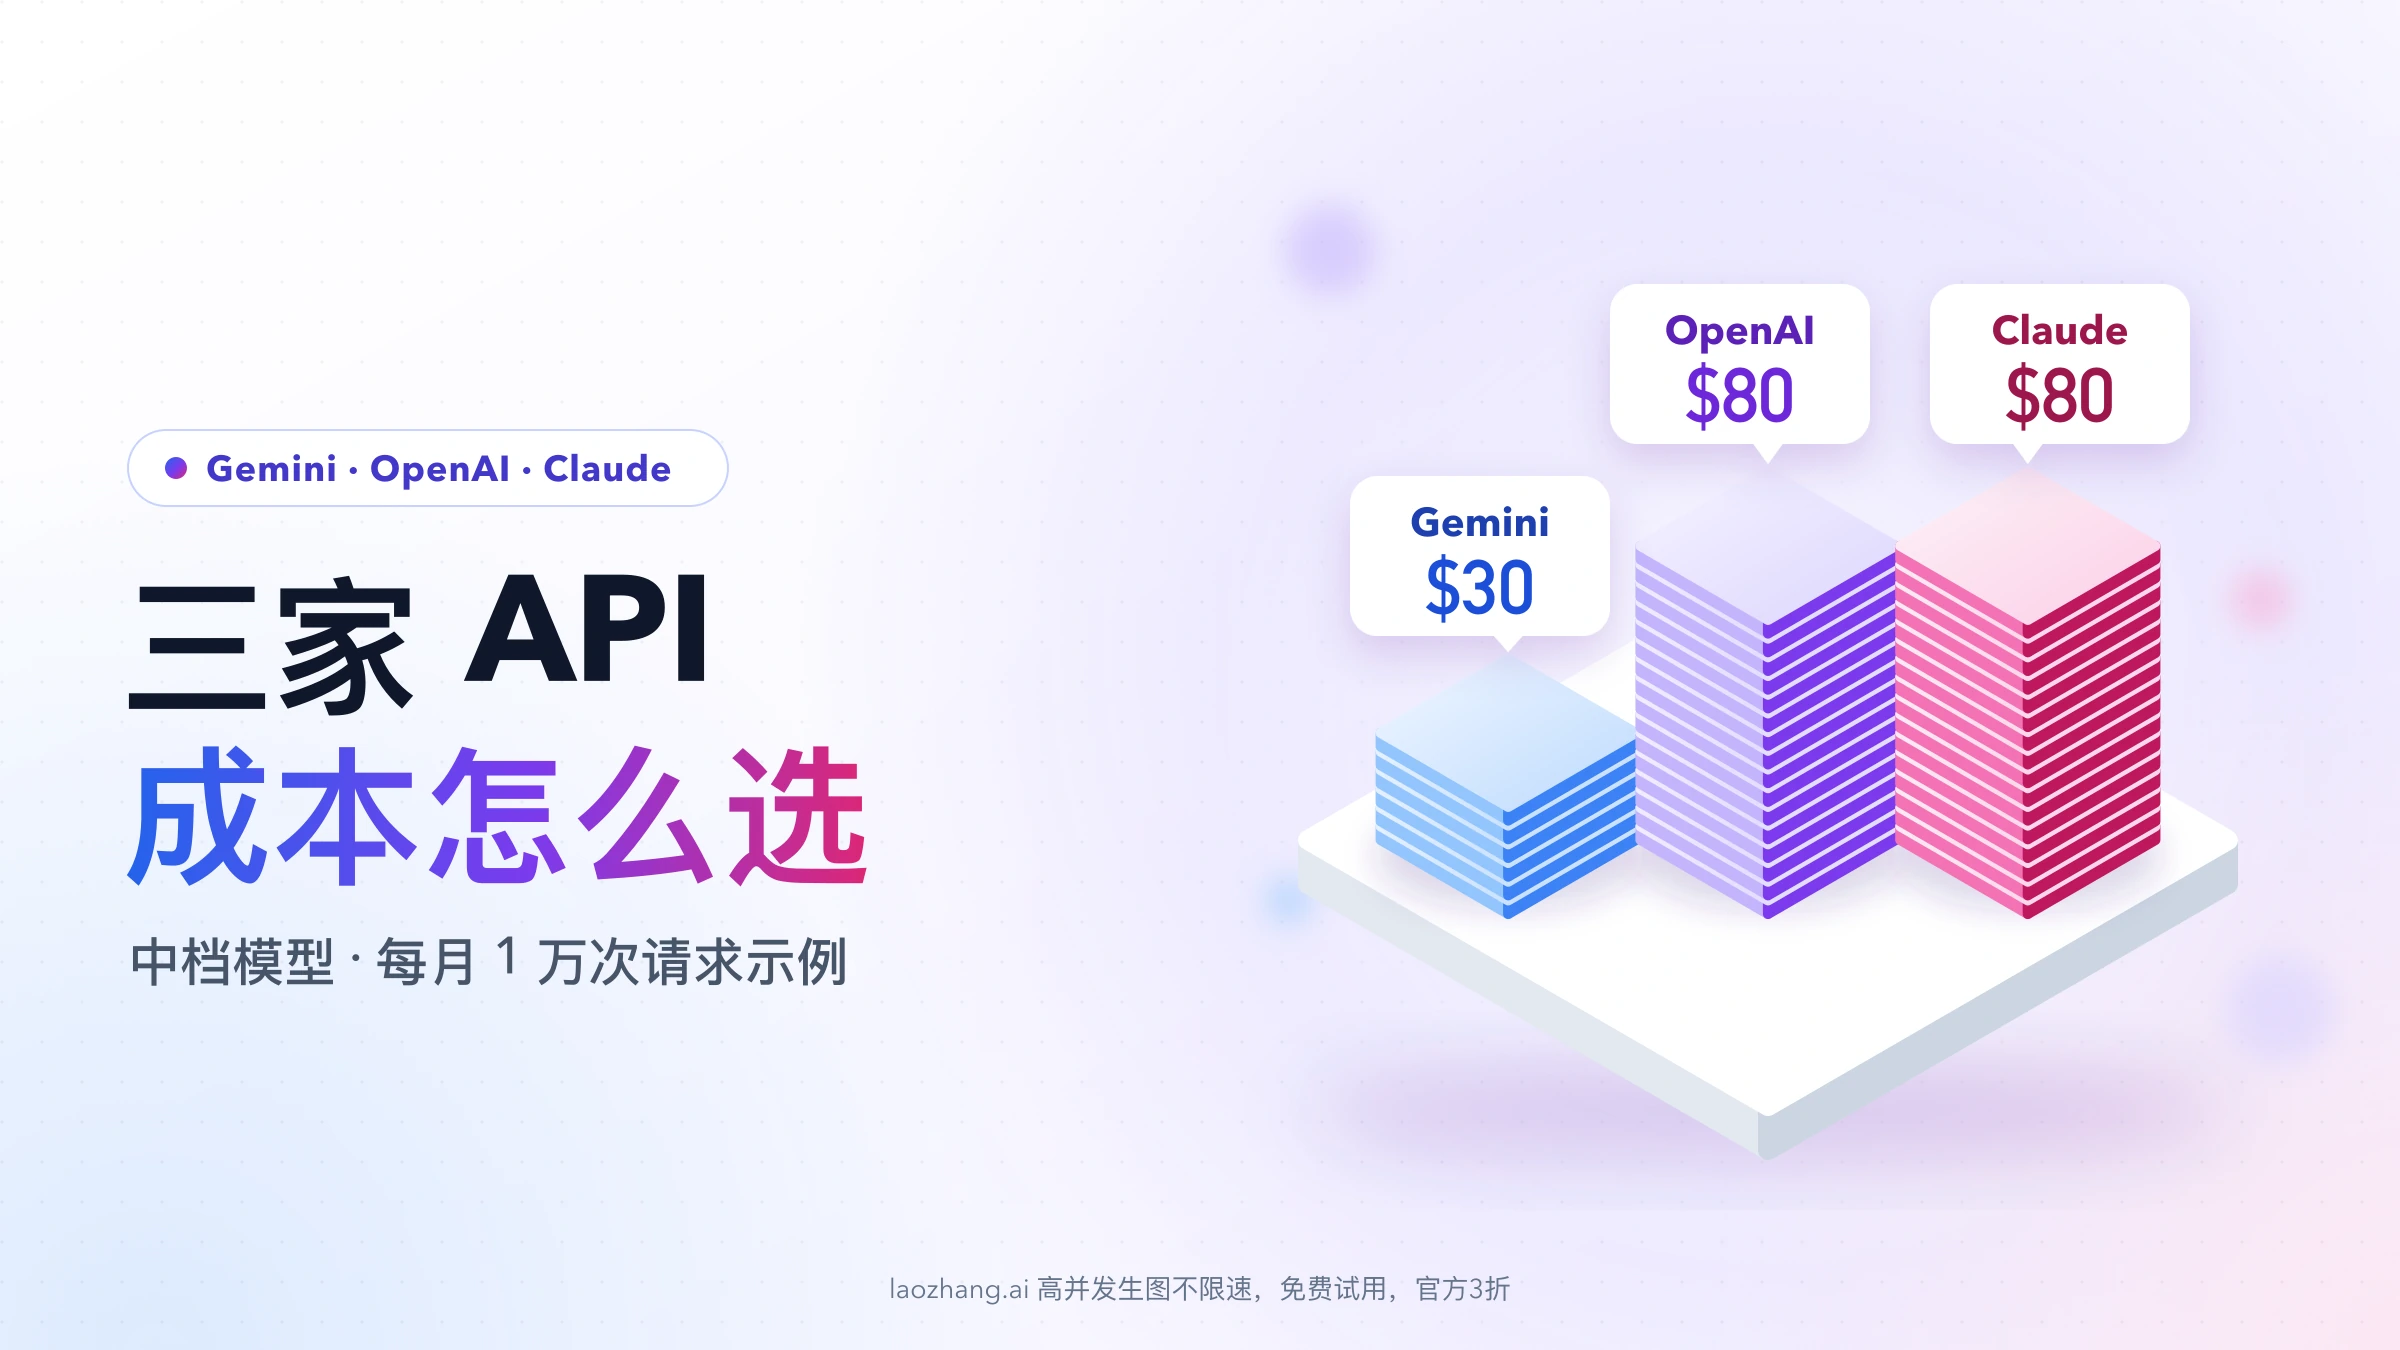
| 中档 | 3.8 Flash:$0.75 / $3.75(至 2026 年底);3.1 Pro Preview:$2 / $12 | GPT-6.1 Sol:$2 / $10 | Sonnet 5.5:$2 / $10 |
| 旗舰档 | Gemini 4 Argon:受邀测试,无公开价 | GPT-6 Astra:$10 / $50 | Opus 5.5:$4 / $20;Fable 5.1:$10 / $50 |
单位均为美元 / 每百万 token,标准(Standard)实时调用,不含缓存和 Batch 折扣。来源:Gemini API 定价、OpenAI API 定价、Claude API 定价。
Google Gemini API 价格:Flash-Lite 最低,3.8 Flash 优惠价到 2026 年底
| 模型 | 输入 | 输出 | 提示超过 20 万 token | 免费层 |
|---|---|---|---|---|
| Gemini 2.5 Flash-Lite | $0.10 | $0.40 | — | 有 |
| Gemini 3.1 Flash-Lite | $0.25 | $1.50 | — | 有 |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | — | 有 |
| Gemini 2.5 Flash | $0.30 | $2.50 | — | 有 |
| Gemini 3.6 / 3.7 / 3.8 Flash | $0.75(2027 年起 $1.50) | $3.75(2027 年起 $7.50) | — | 有 |
| Gemini 3.5 Flash | $1.50 | $9.00 | — | 有 |
| Gemini 2.5 Pro | $1.25 | $10 | $2.50 / $15 | 有 |
| Gemini 3.1 Pro Preview | $2 | $12 | $4 / $18 | 无 |
表里只有 Pro 系列按 20 万 token 分段。Batch 和 Flex 都是标准价的一半,Priority 是 1.8 倍。一个容易看漏的地方:较新的 3.6 / 3.7 / 3.8 Flash 在 2026 年内输入只有 3.5 Flash 的一半、输出不到一半,可它们的优惠价有明确截止日,做 2027 年预算要按 $1.50 / $7.50 算。免费层的具体额度不在定价表里,用法和限制见Gemini API 免费层还能用吗?先检查模型、项目和地区。
OpenAI API 价格:GPT-6 Luna 到 GPT-6 Astra,27.2 万 token 是分界
| 模型 | 输入 | 缓存输入 | 缓存写入 | 输出 | 输入超过 27.2 万 token(整次请求) |
|---|---|---|---|---|---|
| GPT-6 Luna | $0.10 | $0.01 | $0.125 | $0.50 | 输入 $0.20、缓存 $0.02、输出 $0.75 |
| GPT-6.1 Sol | $2 | $0.10 | $2.50 | $10 | 输入 $4、缓存 $0.20、输出 $15 |
| GPT-6 Sol | $2 | $0.20 | $2.50 | $10 | — |
| GPT-6 Astra | $10 | $1 | $12.50 | $50 | 输入 $20、缓存 $2、输出 $75 |
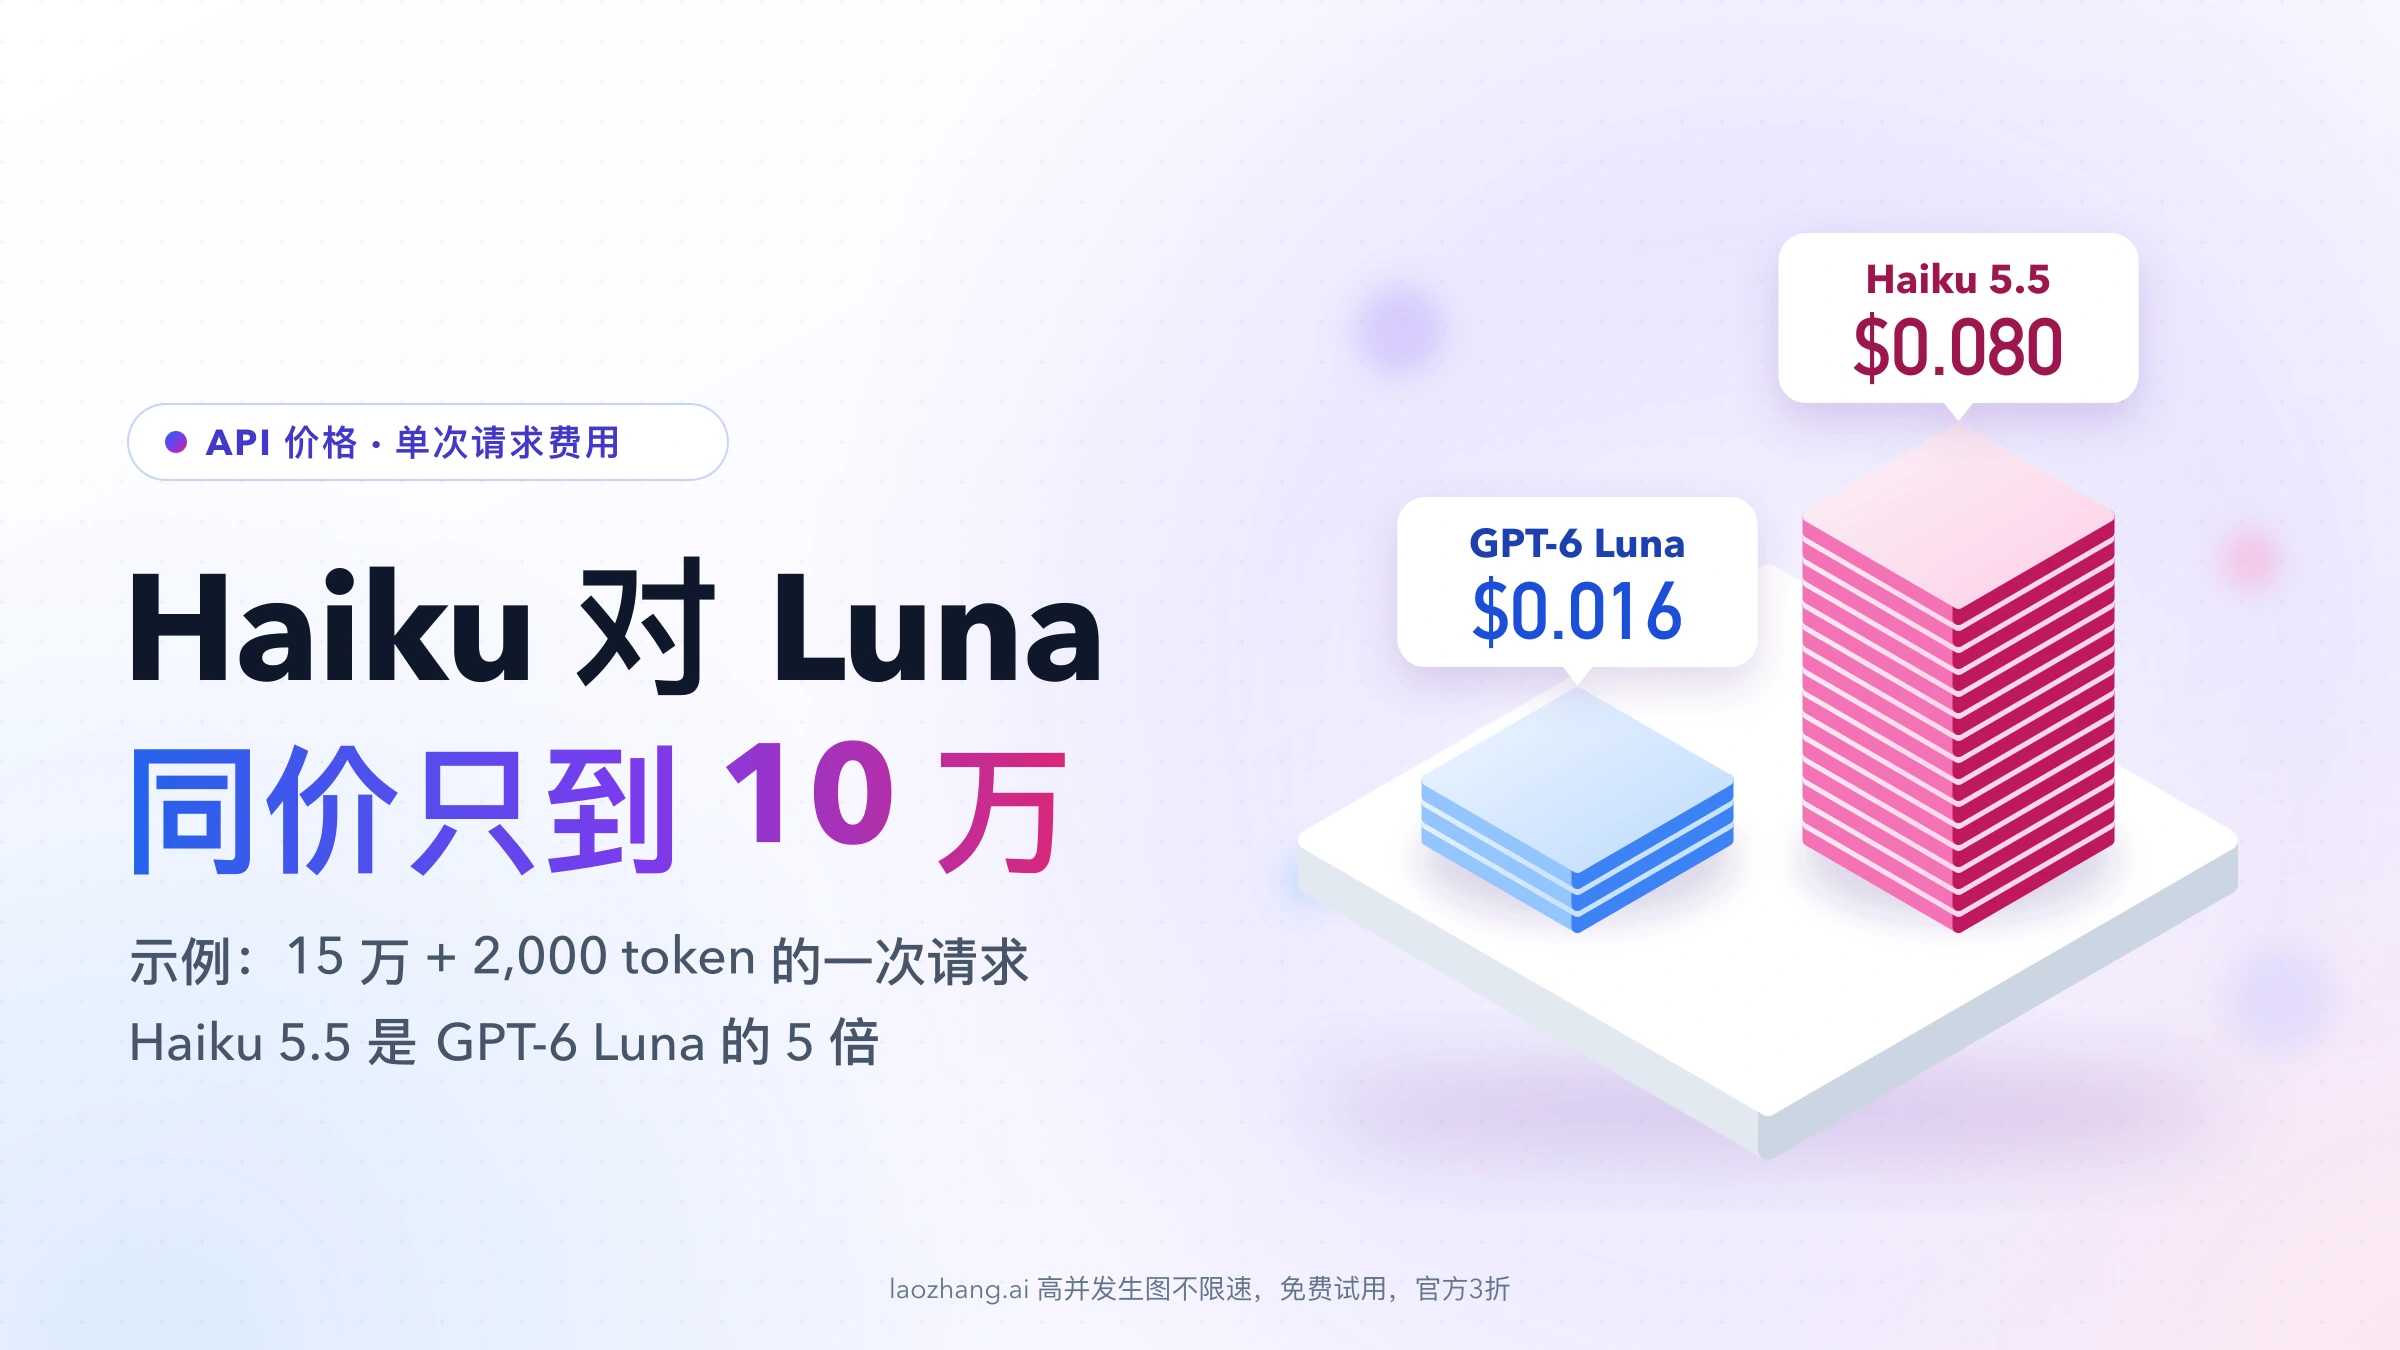
GPT-6.1 Sol 和上一版 GPT-6 Sol 的输入、输出同价,区别在缓存输入:6.1 Sol 是 $0.10,只有标准输入的 5%。Batch 和 Flex 半价;Fast 模式是 2 倍,Ultrafast 是 6 倍且只有 Astra 提供。低价档的细节对比见Claude Haiku 5.5 对比 GPT-6 Luna API 价格:同价只到 10 万 token。
Claude API 价格:Haiku 5.5 只在 10 万 token 内是 $0.10
| 模型 | 输入 | 缓存读取 | 输出 | 长提示规则 |
|---|---|---|---|---|
| Claude Haiku 5.5 | $0.10 | $0.01 | $0.50 | 提示超过 10 万 token 时全部乘 5:$0.50 / $0.05 / $2.50 |
| Claude Sonnet 5.5 | $2 | $0.10 | $10 | 100 万 token 上下文内同价 |
| Claude Opus 5.5 | $4 | $0.20 | $20 | 100 万 token 上下文内同价 |
| Claude Fable 5.1 | $10 | $0.25 | $50 | 100 万 token 上下文内同价 |
Batch 半价;缓存写入按 5 分钟缓存 1.25 倍、1 小时缓存 2 倍收;Opus 5.5 的快速模式是 $8 / $40。四档之间怎么取舍,见Opus 5.5 和 Fable 5.1 怎么选?Claude 四档模型的价格与能力边界。
月度账单算例:短请求看标价,长文档看分界
标价要换算成月度总额才好比较。计算方法:
月费 = 请求数 × (每次输入 token × 输入单价 + 每次输出 token × 输出单价) ÷ 1,000,000
例如 Gemini 2.5 Flash-Lite 的起步负载:10,000 × (1,500 × $0.10 + 500 × $0.40) ÷ 1,000,000 = $3.50。下表全部按标准价计算,不含缓存、Batch 和思考 token,提示超过阈值时套用对应的长上下文价。
| 模型 | 起步:1 万次 × (1,500 输入 + 500 输出) | 增长:50 万次 × 同上 | 长文档:2 万次 × (15 万输入 + 2,000 输出) |
|---|---|---|---|
| Gemini 2.5 Flash-Lite | $3.50 | $175 | $316 |
| GPT-6 Luna | $4 | $200 | $320 |
| Claude Haiku 5.5 | $4 | $200 | $1,600 |
| Gemini 3.8 Flash(2026 年价) | $30 | $1,500 | $2,400 |
| Gemini 3.8 Flash(2027 年价) | $60 | $3,000 | $4,800 |
| GPT-6.1 Sol | $80 | $4,000 | $6,400 |
| Claude Sonnet 5.5 | $80 | $4,000 | $6,400 |
| Gemini 3.1 Pro Preview | $90 | $4,500 | $6,480 |
| Claude Opus 5.5 | $160 | $8,000 | $12,800 |
| GPT-6 Astra | $400 | $20,000 | $32,000 |
| Claude Fable 5.1 | $400 | $20,000 | $32,000 |
从表里能读出三件事:
- 短请求负载里,排序就是标价排序。起步和增长两档里同一档模型差距很小,低价档在 50 万次请求时也只差 $25,选哪家主要看输出质量和你已有的接入,不必为这点差价换厂商。
- 长文档负载里,Claude Haiku 5.5 从 $200 级跳到 $1,600。每次 15 万 token 的提示超过了它的 10 万 token 分界,所有单价乘 5,账单是 GPT-6 Luna 的 5 倍。Luna 的分界在 27.2 万 token,15 万还在低价区;Gemini 2.5 Flash-Lite 没有分段。Gemini 3.1 Pro Preview 在 20 万 token 以内,所以只比 Sol 和 Sonnet 多 $80。
- Gemini 3.8 Flash 的优势有期限。按 2027 年价格,起步负载从 $30 变成 $60,仍比 GPT-6.1 Sol 和 Claude Sonnet 5.5 的 $80 便宜,但差距从 $50 缩到 $20。
如果单次提示再长一些,越过 OpenAI 和 Gemini Pro 的分界,排序会再变一次。以 2 万次 × (30 万输入 + 2,000 输出) 为例,按同一公式:Claude Sonnet 5.5 仍是 $2 / $10,月费 $12,400;GPT-6.1 Sol 整次请求改按 $4 / $15,月费 $24,600;Gemini 3.1 Pro Preview 改按 $4 / $18,月费 $24,720;Claude Opus 5.5 不涨价,月费 $24,800,几乎和 Sol 持平。Gemini 3.8 Flash 不按长度分段,月费 $4,650(2027 年价 $9,300)。长度跨过分界时,同为 $2 / $10 的 Sol 和 Sonnet 会差出一倍。
账单为什么和标价对不上:五个隐性成本
上面的算例只用到可见的输入和输出。实际账单还会被下面几条规则改写,算预算时逐条代入。
思考 token:三家都按输出价计费
开启推理(思考)的模型会先生成一段不出现在最终回答里的思考内容,这部分 token 在三家都按输出单价收费:OpenAI 写明推理 token 按输出 token 计费,Claude 的扩展思考按输出计费,Gemini 定价页也注明输出价包含思考 token。上面多数模型的输出单价是输入的 5 倍左右,同样多的 token 记在输出上,花费也就高出数倍。
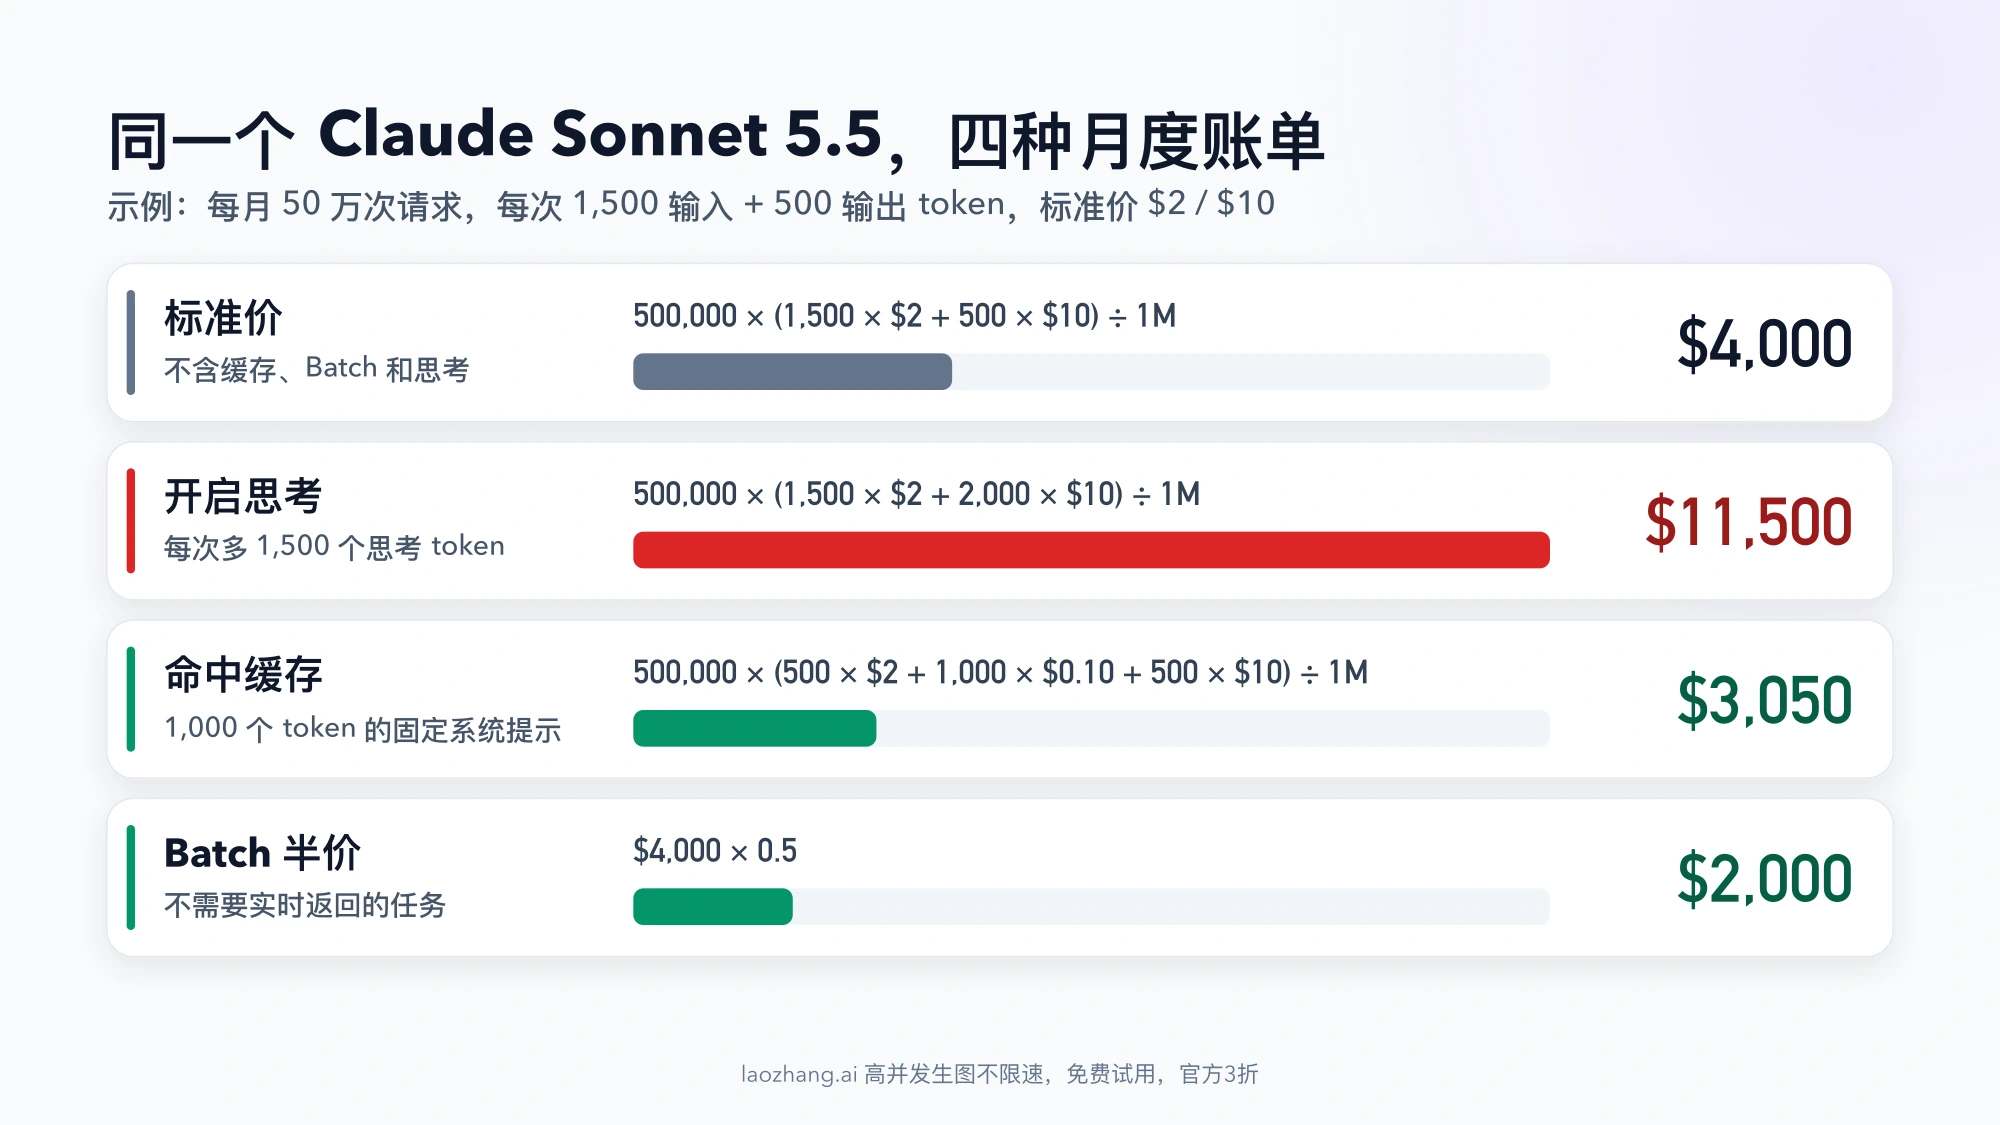
用增长负载算一下:如果每次请求除了 500 个可见输出 token,还多生成 1,500 个思考 token,Claude Sonnet 5.5 的月费从 $4,000 变成 500,000 × (1,500 × $2 + 2,000 × $10) ÷ 1,000,000 = $11,500,接近原来的 3 倍。思考 token 在用量记录里怎么拆分、怎么和账单对上,见推理 Token 到底怎么计费?Gemini、OpenAI、Claude 的去重对账方法。
长上下文阈值:10 万、20 万、27.2 万 token
三家的分界位置和计价方式都不同:
| 模型 | 分界 | 超过后怎么收费 |
|---|---|---|
| Claude Haiku 5.5 | 提示 10 万 token | 输入、缓存、输出全部乘 5 |
| Gemini 2.5 Pro、3.1 Pro Preview | 提示 20 万 token | 输入翻倍,输出 1.5 倍(3.1 Pro Preview:$4 / $18) |
| OpenAI GPT-6 Luna、6.1 Sol、Astra | 输入 27.2 万 token | 整次请求按长上下文价 |
| Claude Sonnet 5.5、Opus 5.5、Fable 5.1 | 无 | 100 万 token 上下文内同价 |
做 RAG 或长文档问答时,先统计提示长度的分布,而不只看平均值:只要有一部分请求越过分界,这部分就按高价计费。Claude 的上下文窗口规则见 Claude 上下文窗口文档。
缓存:命中价是标准输入的 2.5% 到 10%
反复发送同一段长系统提示或同一份文档时,缓存命中的部分按低价计费:
- OpenAI:GPT-6.1 Sol 缓存输入 $0.10,是标准输入的 5%;GPT-6 Luna、GPT-6 Sol 和 Astra 是 10%。
- Claude:Sonnet 5.5 和 Opus 5.5 的缓存读取是 5%,Fable 5.1 是 2.5%,Haiku 5.5 是 10%。写入缓存要多付:5 分钟缓存 1.25 倍,1 小时缓存 2 倍。
- Gemini:2.5 Flash-Lite、3.8 Flash、2.5 Pro 和 3.1 Pro Preview 的上下文缓存价都是标准输入的 10%(3.8 Flash 在 2026 年内是 $0.075),另按缓存 token 数和保留时长收存储费,例如 3.8 Flash 每百万 token 每小时 $0.50。
还是用增长负载算:如果 1,500 个输入 token 里有 1,000 个是每次相同、几乎总能命中缓存的系统提示,GPT-6.1 Sol 和 Claude Sonnet 5.5 每次请求的成本变为 500 × $2 + 1,000 × $0.10 + 500 × $10,月费从 $4,000 降到 $3,050。这个数没有算缓存写入,命中率越低,节省越少。
Batch 与 Flex 半价,Priority 和 Fast 加价
三家都提供半价的异步处理:Gemini 的 Batch 和 Flex、OpenAI 的 Batch 和 Flex、Claude 的 Batch 都是标准价的 50%。不需要实时返回的任务(批量摘要、离线分类、数据清洗)用它们,账单直接减半,例如增长负载下的 Sonnet 5.5 从 $4,000 变为 $2,000。
反方向也有加价档:Gemini Priority 是 1.8 倍,OpenAI Fast 是 2 倍、Astra 的 Ultrafast 是 6 倍,Claude Opus 5.5 快速模式是 $8 / $40。为降低延迟打开这些选项之前,先把倍数乘进预算。
分词差异:同一段文本在三家算出的 token 数不同
三家用各自的分词器,同一段中文或代码在不同厂商那里得到的 token 数不一样,而各家之间的换算比例没有公开数据。上面的算例假设三家 token 数相同,这只是为了让标价可比。要得到可靠数字,用同一批真实请求分别调用,按各家用量记录里的输入、输出(含思考)token 计算。
按负载怎么选厂商和档位:七条规则
| 你的负载 | 先选 | 依据 | 什么情况改选 |
|---|---|---|---|
| 高频短请求(分类、抽取、客服首轮) | 低价档任一:Gemini 2.5 Flash-Lite、GPT-6 Luna、Claude Haiku 5.5 | 50 万次 / 月三者只差 $25 | 质量不够时在同一家升到中档,比换厂商更直接 |
| 单次提示 10 万至 27.2 万 token(长文档问答、合同审阅) | Gemini 2.5 Flash-Lite 或 GPT-6 Luna;需要中档时 Gemini 3.8 Flash | Haiku 5.5 越过 10 万 token 后单价乘 5,长文档负载 $1,600 对 Luna 的 $320 | 提示稳定在 10 万 token 以下时 Haiku 5.5 恢复同价 |
| 单次提示超过 27.2 万 token(整本手册、大段代码库) | 价格优先选 Gemini 3.8 Flash;要在 $2 / $10 这一档里选时用 Claude Sonnet 5.5,而不是 GPT-6.1 Sol 或 Gemini 3.1 Pro Preview | 30 万 token 算例:3.8 Flash $4,650,Sonnet $12,400,Sol $24,600 | 能把提示切到分界以下时重新比较 |
| 中档通用任务(编程助手、RAG 生成、内容改写) | 2026 年内 Gemini 3.8 Flash;已绑定 OpenAI 或 Claude 生态时 GPT-6.1 Sol 或 Sonnet 5.5 | 3.8 Flash 起步负载 $30,Sol / Sonnet $80 | 2027 年 3.8 Flash 涨到 $1.50 / $7.50 后差距缩小,按新价重算 |
| 每次都带同一段长系统提示 | GPT-6.1 Sol、Claude Sonnet 5.5 或 Opus 5.5 | 缓存读取是标准输入的 5% | 命中率低或提示经常变化时,缓存帮不上忙 |
| 可以等几小时的离线批量任务 | 任意一家的 Batch | 三家都是半价 | 需要实时返回时不适用 |
| 旗舰级难题 | 先用 Claude Opus 5.5 测 | 旗舰档里标价最低:$4 / $20 | 自己的测试显示 Opus 5.5 不够时,再比较 GPT-6 Astra 和 Claude Fable 5.1(都是 $10 / $50) |
Gemini 3.1 Pro Preview 在这张表里没有出现,原因是它的输入与 Sol、Sonnet 同为 $2,输出却是 $12,而且没有免费层;只有在你的任务上它的效果明显更好时,才值得多付这部分输出成本。GPT-6.1 Sol 和 Opus 5.5 在真实任务里的成本差距,见GPT-6.1 Sol 对比 Opus 5.5:标价差 2 倍,任务成本差 6 倍。
Gemini、OpenAI、Claude API 价格常见问题
2026 年哪个 AI API 最便宜?
截至 2026 年 10 月 8 日,三家里标价最低的是 Gemini 2.5 Flash-Lite($0.10 / $0.40),Batch 再减半为 $0.05 / $0.20。GPT-6 Luna 和 Claude Haiku 5.5 输入同为 $0.10,输出 $0.50,只略贵一点。提示超过 10 万 token 时,Haiku 5.5 会变成三者中最贵的一个。
Gemini API 需要付费吗?
不一定。Gemini 2.5 Flash-Lite、各版 Flash 和 Flash-Lite 以及 Gemini 2.5 Pro 都有免费层,适合原型和小流量测试;Gemini 3.1 Pro Preview 没有免费层。付费层按上面的价格表计费,免费层的具体额度和条件见Gemini API 免费层还能用吗?先检查模型、项目和地区。
每月 10 万次请求大概要花多少钱?
按每次 1,500 输入 + 500 输出 token、标准价计算:Gemini 2.5 Flash-Lite $35,GPT-6 Luna 和 Claude Haiku 5.5 各 $40,Gemini 3.8 Flash $300(2027 年价 $600),GPT-6.1 Sol 和 Claude Sonnet 5.5 各 $800,Gemini 3.1 Pro Preview $900,Claude Opus 5.5 $1,600,GPT-6 Astra 和 Claude Fable 5.1 各 $4,000。开启思考、命中缓存或改用 Batch 后,按上面的方法重新代入。
从 OpenAI 换到 Gemini 能省多少?
取决于档位。中档从 GPT-6.1 Sol 换到 Gemini 3.8 Flash,起步负载从 $80 降到 $30,2027 年按新价是 $60;低价档从 GPT-6 Luna 换到 Gemini 2.5 Flash-Lite,只从 $4 降到 $3.50。换厂商还涉及提示改写、输出质量复测和接入改造,低价档这点差价通常不足以抵消这些工作。如果你在考虑反方向,从 Gemini 换走,见便宜 Gemini API 还是换替代方案?2026 年什么时候切换才真省钱。
中国大陆可以直接调用 Gemini、OpenAI 和 Claude 的 API 吗?
截至 2026 年 10 月 8 日,中国大陆和香港都不在三家 API 的支持国家和地区列表中。名单见 Gemini API 可用地区、OpenAI API 支持的国家和地区 和 Anthropic 支持的国家和地区。