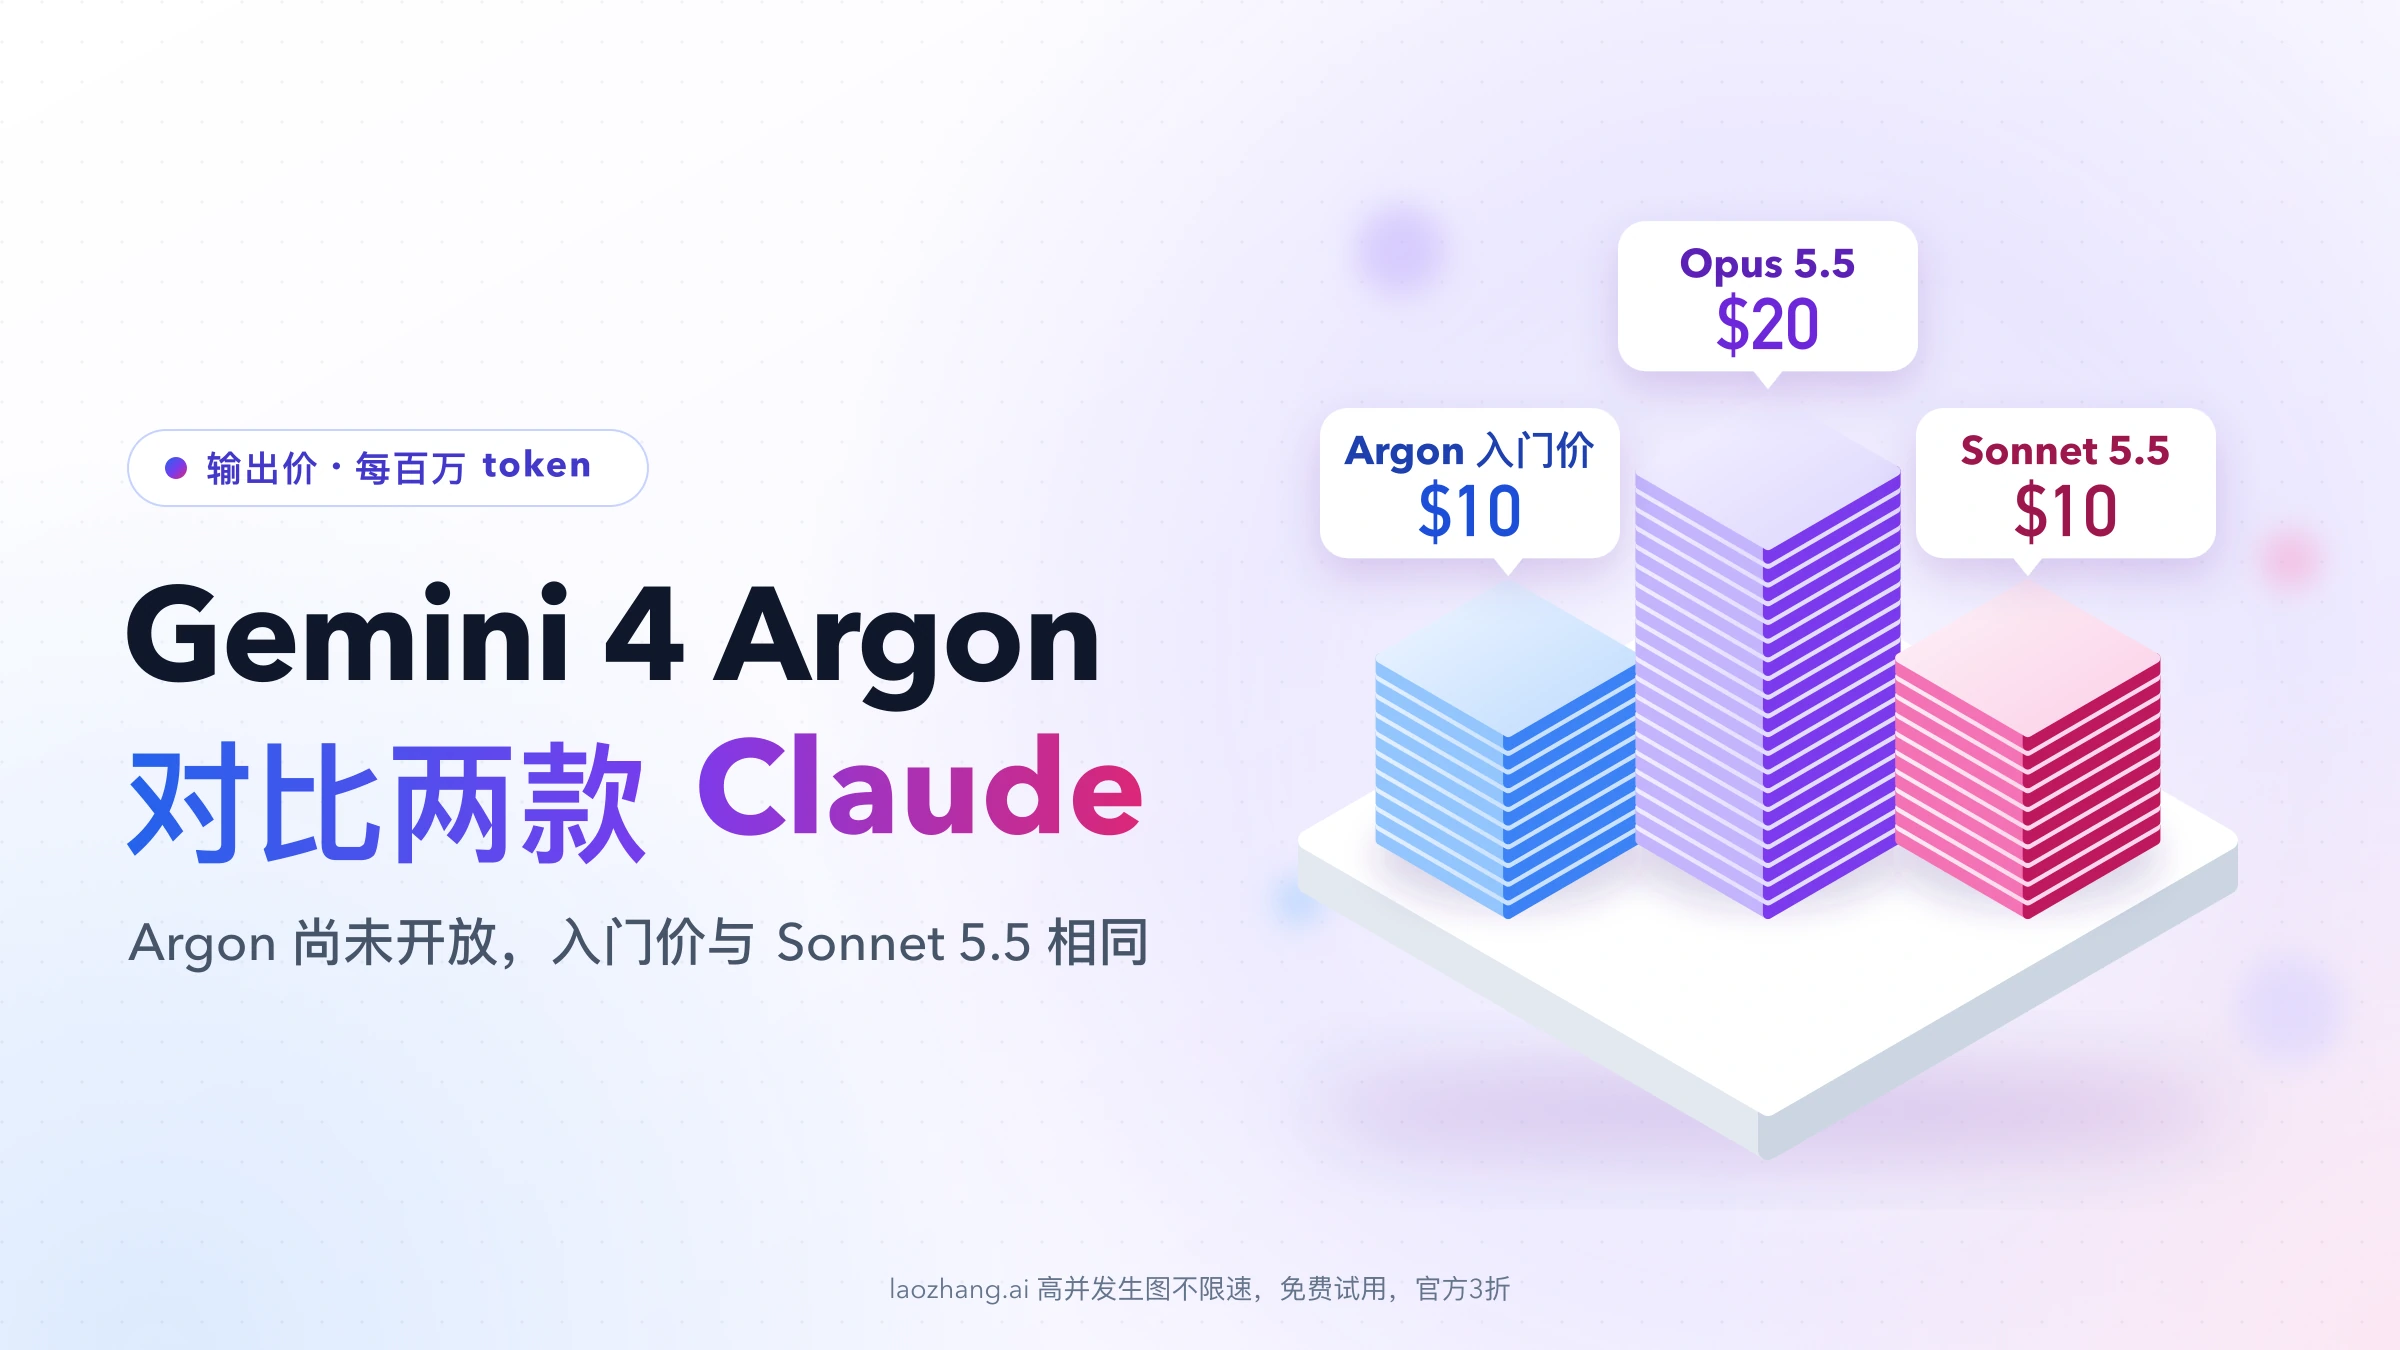
截至 2026 年 10 月 14 日,三款模型都能用了。Gemini 4 Argon 在 10 月 13 日正式上线,Gemini API 里的型号 ID 是 gemini-4-argon,状态为 Stable(见 Gemini API 更新日志)。开发者通过 API 付费层调用;普通用户要有 Google AI Pro 或 Ultra 订阅,才能在 Gemini 应用里选到它。
它的 API 价格分两段:11 月 30 日前每百万 token 输入 $2、输出 $10,和 Claude Sonnet 5.5 完全相同;12 月 1 日起 $4/$20,和 Claude Opus 5.5 完全相同(Gemini API 定价页)。所以先看你现在用的是哪一款:
- 在用 Sonnet 5.5:11 月 30 日前换成 Argon,单价一分不变,值不值只看质量、速度和 token 用量;12 月 1 日起 Argon 的单价是 Sonnet 5.5 的两倍。范围明确的日常任务继续用 Sonnet 5.5。
- 在用 Opus 5.5:11 月 30 日前 Argon 的单价只有一半,是实测它的好时机;12 月 1 日起两者同价,长期选谁只看你的任务上谁做得更好。终端操作和长程工程任务,连 Google 自己公布的数字也是 Opus 5.5 更高。
- 准备试 Argon:在你有权限的入口里,拿同一批真实任务跑一遍,记下质量和实际账单。Argon 标准档的输入、输出、缓存三项单价在 12 月 1 日都正好翻倍,11 月的实测账单乘以 2,就是之后的成本。
三款模型都能调用了:Argon 10 月 13 日正式上线
| Gemini 4 Argon | Claude Opus 5.5 | Claude Sonnet 5.5 | |
|---|---|---|---|
| 发布时间 | 2026 年 9 月 30 日公布,10 月 13 日正式上线 | 2026 年 9 月 22 日 | 2026 年 9 月 28 日 |
| API 谁能调用 | Gemini API 付费层(免费层不可用) | 所有 Claude API 客户 | 所有 Claude API 客户 |
| 型号 ID | gemini-4-argon | claude-opus-5-5 | claude-sonnet-5-5 |
| 其他入口 | Gemini 应用、搜索 AI 模式、Google Antigravity、GitHub Copilot(各有套餐要求,见下一节) | Amazon Bedrock、Google Cloud、Microsoft Foundry、Claude Platform on AWS | 同左 |
| 上下文窗口 | 1,048,576 token,输入和输出共用 | 1M token | 1M token |
| 最大输出 | 默认 65,536 token;开启 long decode 最多 1,048,576 | 128K token(同步请求) | 128K token(同步请求) |
| 思考深度设置 | thinking 档位 low / medium / high | effort,默认 medium | effort,默认 high |
| 官方延迟标注 | 模型页没有这一项 | Moderate | Fast |
| 缓存 | 只支持隐式缓存 | 显式缓存,写入另计费 | 显式缓存,写入另计费 |
Argon 一列来自 Gemini 4 Argon 模型页,两款 Claude 来自 Anthropic 的模型总览。
Argon 的 1M 要读仔细:1,048,576 token 是输入和输出加在一起的总额度,发 90 万 token 的提示,留给输出的只剩约 14.8 万。默认的同步请求一次最多输出 65,536 token,比两款 Claude 的 128K 还少;要拿到更长的输出,得按文档配置长输出模式(long decode)和它的续写协议。
两款 Claude 都是文本和图片输入、文本输出,可靠知识截止到 2026 年 6 月。Argon 支持文本、图片、视频、音频和 PDF 输入,输出文本,并支持函数调用、结构化输出、代码执行、使用 Google 搜索建立依据和 computer use(预览)。云平台上的区域开通情况因账号而异。
Argon 的入口与套餐:API 付费层、AI Pro/Ultra 和 Copilot
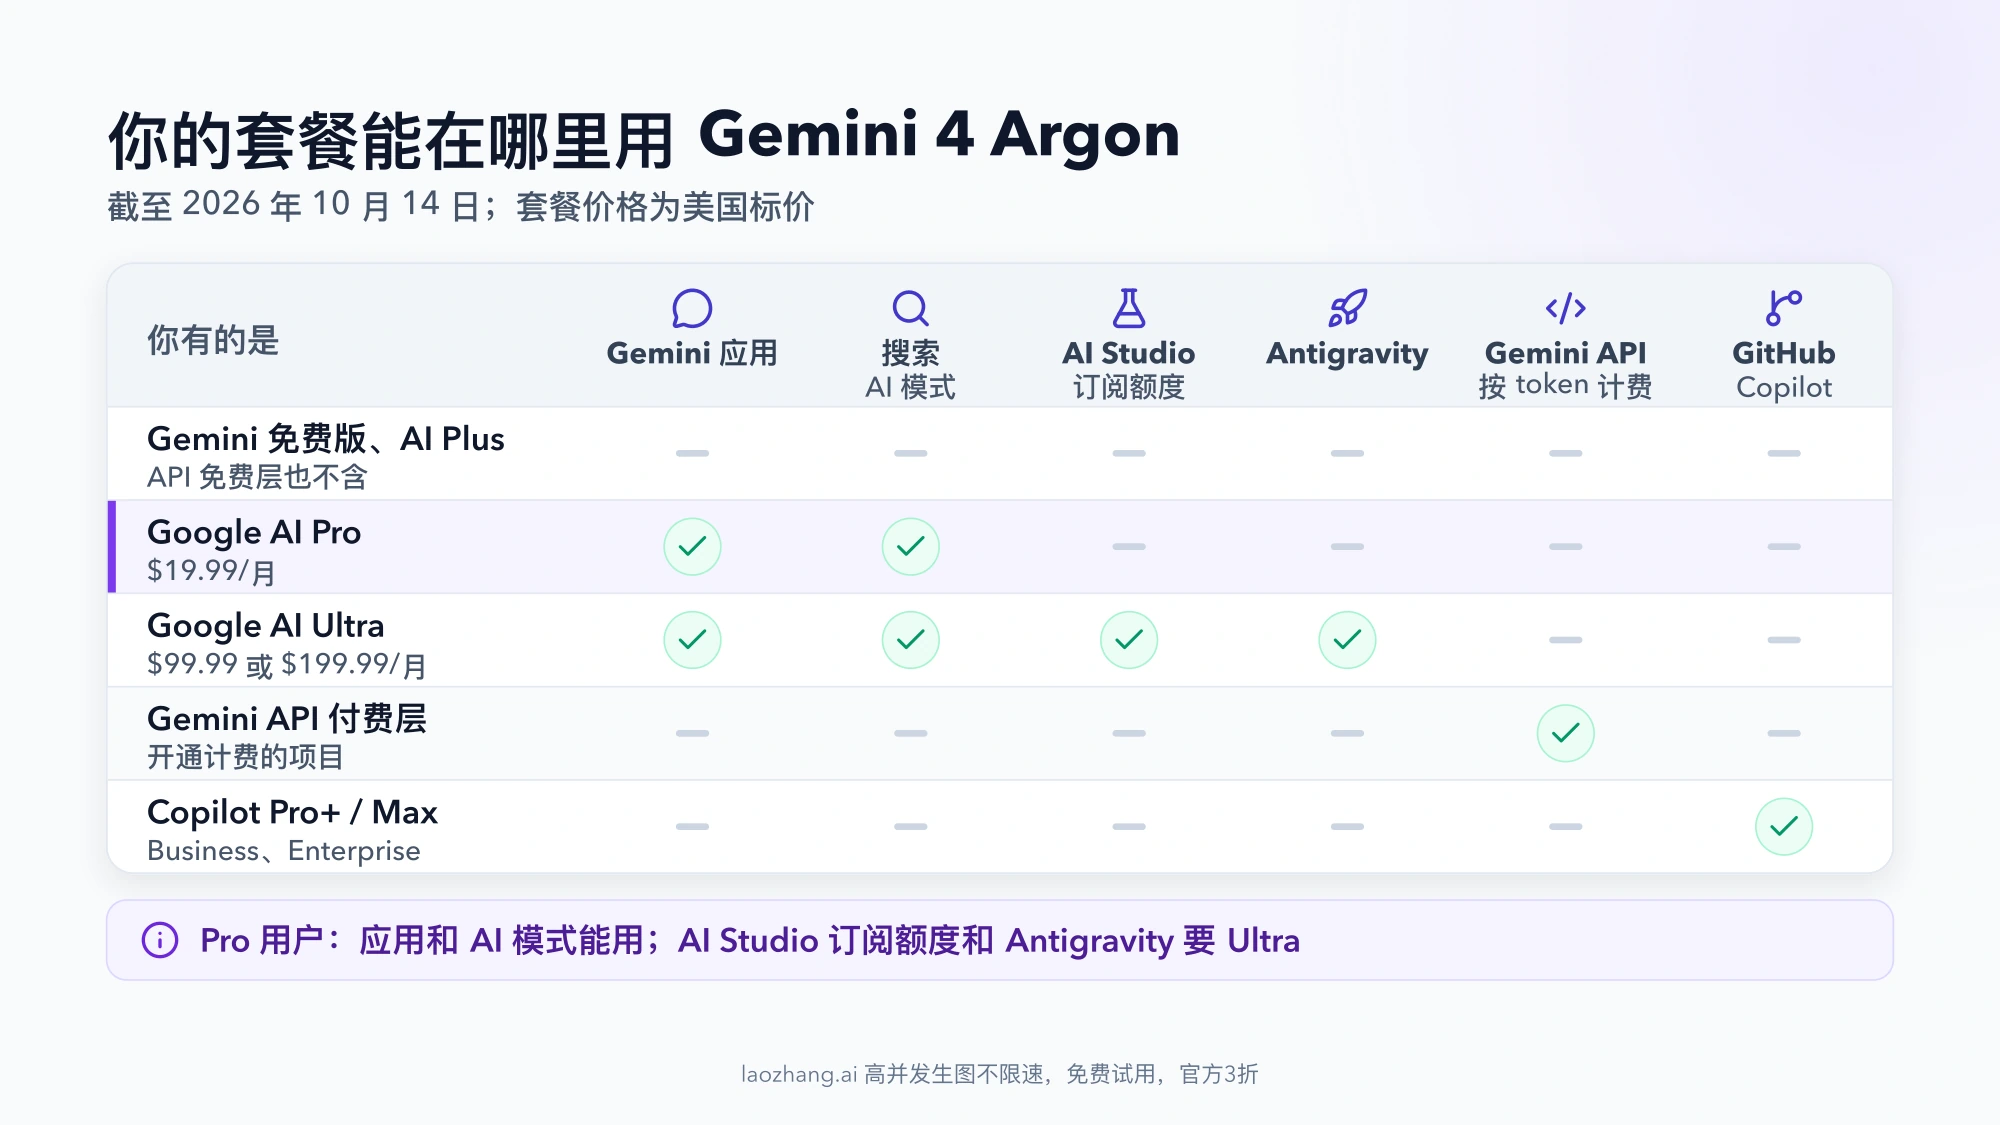
Google 的上线公告写的是“今天起逐步向全球推送”,下表是各入口的门槛。套餐价格是美国标价,其他地区不同。
| 入口 | 谁能用 Argon | 怎么付费 | 要注意的地方 |
|---|---|---|---|
| Gemini API(AI Studio、Gemini 平台、Android Studio) | 开通付费层的项目 | 按 token 计费,见下一节 | 免费层每一项都标着“Not available” |
| AI Studio 网页(用订阅额度) | 仅 Google AI Ultra | 订阅 | AI Pro 不含 Argon;订阅额度只在 AI Studio 网页里有效,API key 另外计费 |
| Gemini 应用 | Google AI Pro($19.99/月)、Google AI Ultra($99.99 或 $199.99/月) | 订阅 | 免费版只有 Flash-Lite,Google AI Plus($4.99/月)不含 Argon |
| 搜索里的 AI 模式 | Google AI Pro、Google AI Ultra | 订阅 | 与 Gemini 应用共用同一份订阅 |
| Google Antigravity | Google AI Ultra | 订阅 | 科研人员可申请 6 个月免费使用最高用量档,需审核,名额有限 |
| GitHub Copilot | Copilot Pro+、Max、Business、Enterprise | 按供应商标价走用量计费 | Copilot Free 和 Pro 不在名单里;逐步推送;按 Argon 哪一段价格计费没有写明 |
各行依据:AI Studio 的 Google AI 套餐说明、Gemini 订阅页、Gemini 应用更新说明和 GitHub 的更新日志。企业用户另外可以在 Gemini for business、API 和 Antigravity 里使用。
最容易看糊涂的是 Google AI Pro。定价页那句“not available on the Google AI Pro plan”说的是 AI Studio 里的订阅额度,不是 Gemini 应用:Pro 用户在 Gemini 应用和 AI 模式里能选 Argon,到了 AI Studio 网页里却用不了订阅额度,要么升级 Ultra,要么用开了付费层的 API key 按量付费。
Copilot 的 Business 和 Enterprise 默认会自动启用新模型,管理员可以在模型策略里关掉 Argon;如果团队里看不到它,先查这一项,再等推送。
Argon 价格:11 月 30 日前同 Sonnet 5.5,之后同 Opus 5.5
下表是官方美元标价,单位为每百万 token,不含税。Argon 来自 Gemini API 定价页(输出价包含思考 token),Claude 来自 Claude API 定价页。
| 输入 | 输出 | 缓存读取 / 缓存输入 | Batch(输入 / 输出) | |
|---|---|---|---|---|
| Gemini 4 Argon(11 月 30 日前) | $2 | $10 | $0.10 | $1 / $5 |
| Gemini 4 Argon(12 月 1 日起) | $4 | $20 | $0.20 | $2 / $10 |
| Claude Sonnet 5.5 | $2 | $10 | $0.10 | $1 / $5 |
| Claude Opus 5.5 | $4 | $20 | $0.20 | $2 / $10 |
三个关系值得记住:
- 11 月 30 日前,Argon 的输入、输出、缓存和 Batch 价格与 Sonnet 5.5 逐项相同;12 月 1 日起,与 Opus 5.5 逐项相同。两边的缓存价都是各自输入价的 5%。
- Sonnet 5.5 的缓存读取价现在是 $0.10,正好是 Opus 5.5 的一半。按 $0.20 推出的“缓存越多、两款 Claude 的差距越小于一半”已不成立:输入、输出、缓存写入和读取,Sonnet 5.5 每一项都是 Opus 5.5 的一半。
- 缓存的计费方式不同。Claude 先要写入缓存:5 分钟缓存写入 Sonnet 5.5 $2.50、Opus 5.5 $5,1 小时缓存写入 $4、$8,之后命中才按读取价算。Argon 只支持隐式缓存(自动命中,不能手动建缓存),价格页只列命中价;你没法指定缓存哪些内容,命中率也就没有保证。
其他档位和附加费用:Argon 的 Flex 与 Batch 同价;Priority 11 月 30 日前 $3.60/$18,12 月 1 日起 $7.20/$36;使用 Google 搜索建立依据每月 5,000 次免费(Gemini 3 及更新的模型共用),之后每 1,000 次 $14。Claude 一侧,Opus 5.5 另有 fast mode(研究预览,仅 Claude API)$8/$40,Sonnet 5.5 没有;指定仅美国推理时价格乘 1.1;Bedrock 和 Google Cloud 各自定价。Argon 在 Vertex AI 上的价格,以及 Copilot 按哪一段价格计费,公开页面都没有写。
算例 A:10 万输入、2 万输出,不用缓存
费用 = 输入 token(百万)× 输入单价 + 输出 token(百万)× 输出单价。
| 模型 | 算式 | 合计 |
|---|---|---|
| Sonnet 5.5 | 0.1 × $2 + 0.02 × $10 | $0.40 |
| Opus 5.5 | 0.1 × $4 + 0.02 × $20 | $0.80 |
| Argon(11 月 30 日前) | 0.1 × $2 + 0.02 × $10 | $0.40 |
| Argon(12 月 1 日起) | 0.1 × $4 + 0.02 × $20 | $0.80 |
token 数相同且不用缓存时,结果就是单价关系本身:Sonnet 5.5 是 Opus 5.5 的一半,Argon 在 11 月 30 日前后分别等于这两款。
算例 B:缓存占大头的一轮代理调用
假设一轮调用读取 20 万缓存 token,新增 2 万输入、5,000 输出。Agent 场景里每一轮都要把之前的上下文带上,账单的大头往往就在缓存这一项。
| 模型 | 缓存读取 | 新输入 | 输出 | 合计 |
|---|---|---|---|---|
| Sonnet 5.5 | 0.2 × $0.10 = $0.02 | 0.02 × $2 = $0.04 | 0.005 × $10 = $0.05 | $0.11 |
| Opus 5.5 | 0.2 × $0.20 = $0.04 | 0.02 × $4 = $0.08 | 0.005 × $20 = $0.10 | $0.22 |
| Argon(11 月 30 日前) | 0.2 × $0.10 = $0.02 | 0.02 × $2 = $0.04 | 0.005 × $10 = $0.05 | $0.11 |
| Argon(12 月 1 日起) | 0.2 × $0.20 = $0.04 | 0.02 × $4 = $0.08 | 0.005 × $20 = $0.10 | $0.22 |
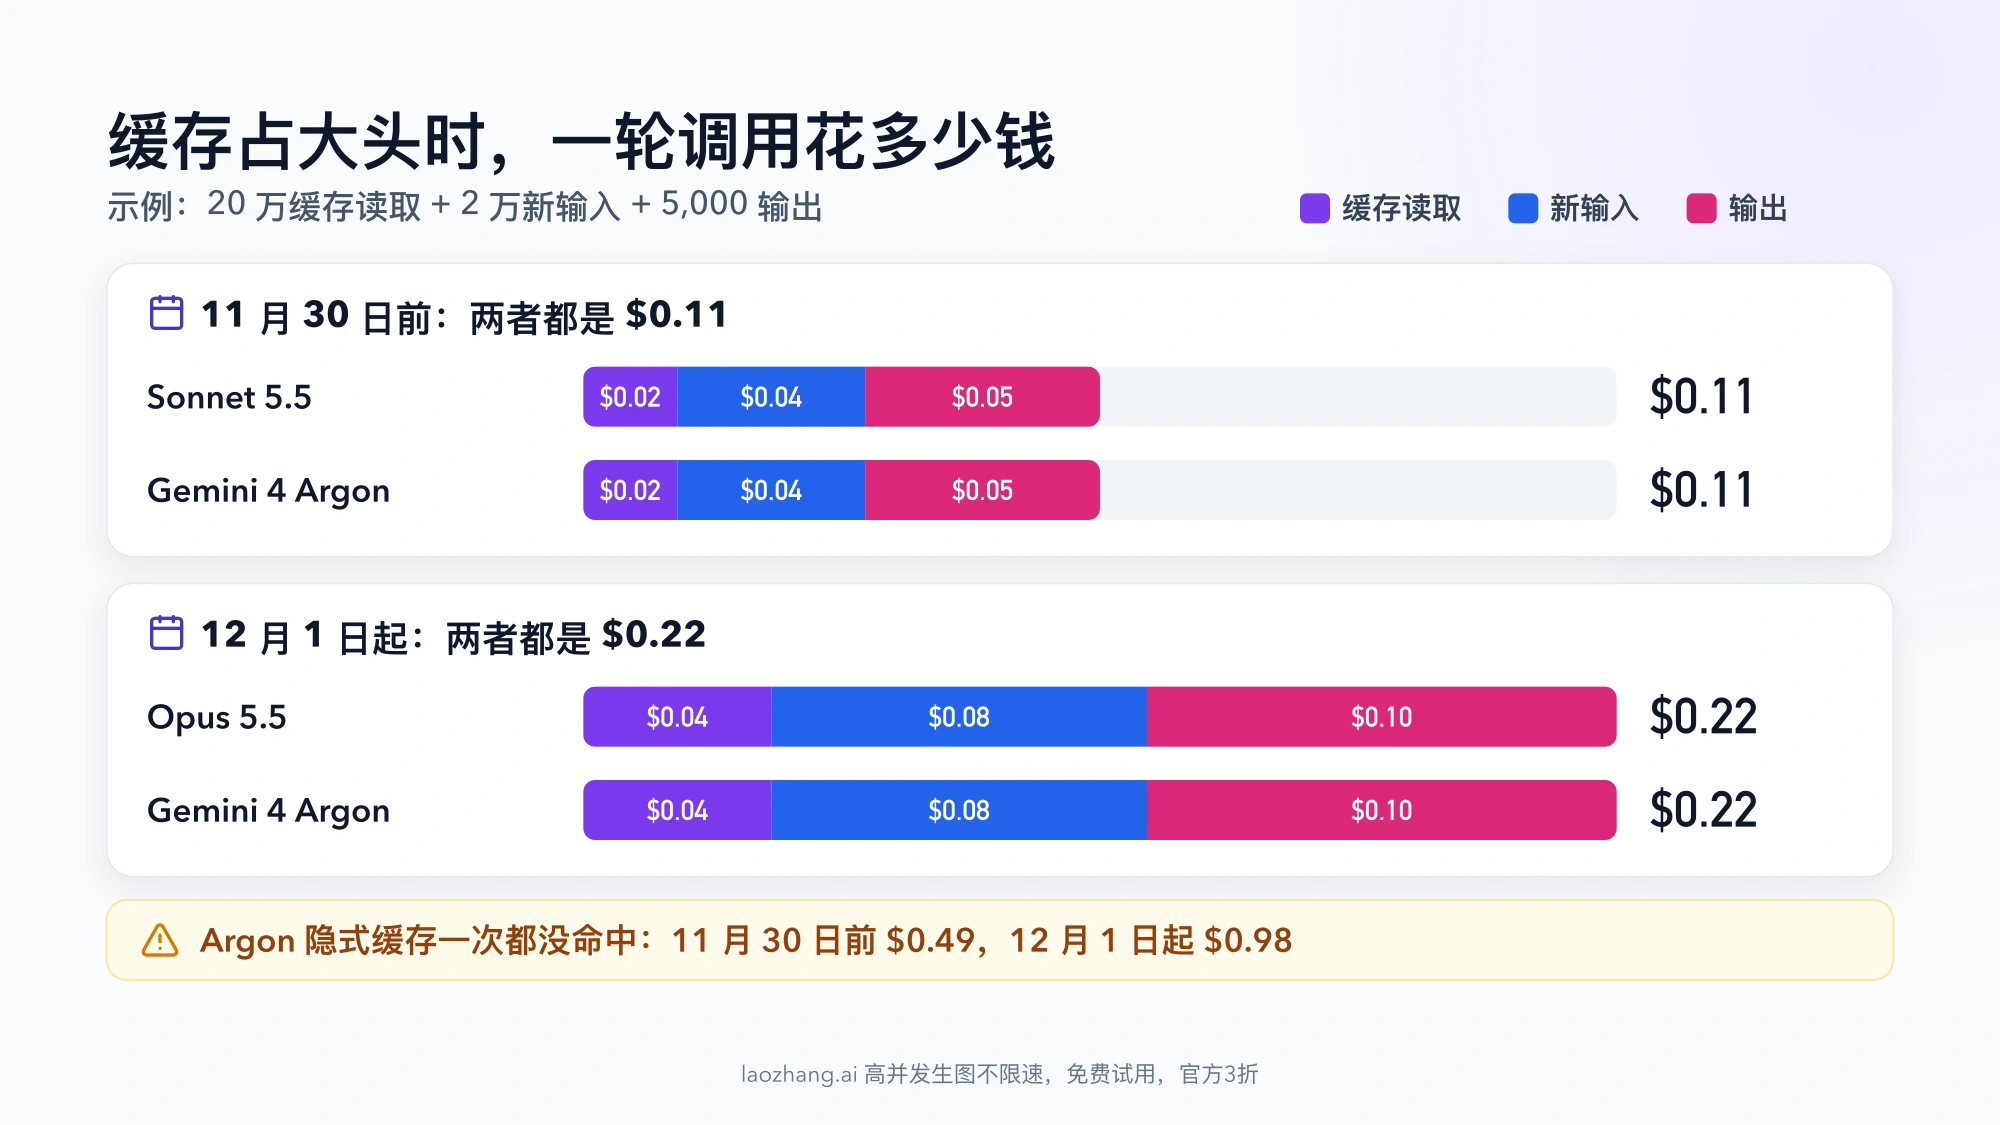
这一轮里 Sonnet 5.5 正好是 Opus 5.5 的一半,Argon 在 11 月 30 日前与 Sonnet 5.5 打平,12 月 1 日起与 Opus 5.5 打平。
表里有两个前提,真实账单最容易在这里偏开:
- Claude 的缓存写入没算进去。 这 20 万 token 第一次写入 5 分钟缓存时,Sonnet 5.5 要 0.2 × $2.50 = $0.50,Opus 5.5 要 0.2 × $5 = $1.00,摊到后面每一轮里。
- Argon 的隐式缓存假设全部命中。 如果一次都没命中,这 20 万 token 按输入价计费:11 月 30 日前是 0.22 × $2 + $0.05 = $0.49,12 月 1 日起是 0.22 × $4 + $0.10 = $0.98,约为命中时的 4.5 倍。实测时要看用量里缓存命中了多少 token。
两个算例都假设三款模型消耗的 token 数完全相同,没有计入工具费用和税。
单价相同不等于单任务成本相同
真实任务里,不同模型的分词方式、思考深度和输出长度都不一样,同一道题消耗的 token 数可以差出很多。Vals Index 公布了每道测试题的实际花费:Sonnet 5.5 每题 $21.34,Opus 5.5 每题 $32.14,前者约为后者的三分之二(21.34 ÷ 32.14 ≈ 0.66),而不是单价表上的一半。Argon 每题 $15.68,约为 Opus 5.5 的一半,但 Vals 没有写明它按 Argon 哪一段价格计算。
换成你自己的任务,这些比例还会变。思考 token 怎么进账单、怎么和用量报表对上,见推理 Token 到底怎么计费?Gemini、OpenAI、Claude 的去重对账方法。
基准数字是谁测的:Vals 把 Argon 排第一,AA 排第三
下面的数字都来自厂商或第三方榜单,条件随每条给出。Vals Index 和 Artificial Analysis(AA)这两份覆盖三款模型的独立榜单给出了相反的排序;Argon 已经能调用,这些数字更适合用来决定先测哪些任务,而不是直接替你选。
Vals Index:Argon 第一,两款 Claude 基本打平
Google 的对比表里没有 Sonnet 5.5,Anthropic 的对比里没有 Argon。Vals Index 是第三方榜单,按 GDP 权重汇总金融、编程、法律和税务任务,下面是 2026 年 10 月 13 日更新的 v2.1:
| 模型 | 得分 | 每题成本 | 用时 |
|---|---|---|---|
| Gemini 4 Argon | 68.90% | $15.68 | 46 分 33 秒 |
| Claude Sonnet 5.5 | 67.04% | $21.34 | 1 小时 18 分 |
| Claude Opus 5.5 | 66.97% | $32.14 | 1 小时 19 分 |
能支持的结论有两条。其一,Argon 领先两款 Claude 约 1.9 个百分点,每题成本约为 Opus 5.5 的一半(15.68 ÷ 32.14 ≈ 0.49),用时也更短。其二,Sonnet 5.5 和 Opus 5.5 只差 0.07 个百分点,Vals 自己的说法是两者基本打平。
不能支持的结论也有两条。Vals 没有说明 Argon 的每题成本按哪一段价格计算;如果用的是 11 月 30 日前的价格,12 月 1 日后单价翻倍,这个成本优势会明显收窄。另外榜单会随重跑变动,0.07 个百分点的差距重跑一次就可能换位,引用时要带上日期。
Artificial Analysis 智能指数:两款 Claude 排在 Argon 前面
Artificial Analysis 的对比页上,智能指数 v4.3.2 的排序正好反过来(Sonnet 5.5 的数字见另一张对比页):
| 模型 | 测试设置 | 智能指数 | 跑完整套指数的成本 |
|---|---|---|---|
| Claude Opus 5.5 | Max | 58 | $8,708 |
| Claude Sonnet 5.5 | Max | 56 | $7,260 |
| Gemini 4 Argon | High | 53 | $2,407 |
两份独立榜单排序相反,能看到的原因有两个:测的是不同的任务组合,Vals 汇总的是金融、编程、法律和税务任务,Artificial Analysis 用的是自己的另一套测试;设置也不同,这里两款 Claude 用的是 Max 档,Argon 用的是 High 档。
两份榜单在成本上倒是一致的:Argon 跑完同一套测试都更便宜。Artificial Analysis 给 Argon 和 Sonnet 5.5 标的都是 $2/$10,单价相同,$2,407 对 $7,260 的差距就来自用量。如果按 12 月 1 日后的单价、用量不变重算,Argon 约为 2 × $2,407 = $4,814,仍低于两款 Claude。
谁更强,两份榜单的答案相反,差距(Vals 不到 2 个百分点,Artificial Analysis 3 到 5 分)都不足以替你的任务做决定。
Google 的对比表:Argon 对 Opus 5.5
Google 的模型页列出了 Argon 和 Opus 5.5 的逐项成绩,单位都是 %。18 项里 Argon 领先 14 项,Opus 5.5 领先 4 项。“数字来源”一列取自 Google 的评测方法说明。
| 基准 | Argon | Opus 5.5 | 数字来源 |
|---|---|---|---|
| Vals Index | 68.9 | 67.0 | Vals AI |
| AutomationBench | 51.3 | 42.5 | Zapier 公开榜单 |
| Vals Finance Agent v2 | 65.4 | 58.6 | Vals AI |
| Harvey Legal Agent Benchmark | 19.6 | 3.8 | Vals AI |
| DeepSWE v1.1 | 77.9 | 74.2 | Argon 为 Google 自测,Opus 5.5 取自其 system card |
| Vibe Code Bench | 91.9 | 90.3 | Vals AI 公开榜单 |
| LABBench 2 | 88.8 | 73.1 | 两款均为 Google 自测 |
| RiemannBench | 76.0 | 69.6 | Surge 公开榜单 |
| GraphWalks(≤128k) | 99.7 | 90.6 | 两款均为 Google 自测 |
| GraphWalks(256k–1M) | 84.2 | 66.8 | 两款均为 Google 自测 |
| Agent's Last Exam | 39.5 | 38.2 | Argon 为 Google 自测,Opus 5.5 取自公开榜单 |
| Chartography | 71.6 | 66.3 | Surge 公开榜单,不带工具 |
| LVBench | 91.7 | 83.7 | 两款均为 Google 自测,抽帧数不同 |
| CWE-bench v1 | 68.0 | 67.0 | 公开榜单 |
| FrontierSWE v2 | 55.0 | 62.3 | Proximal 公开榜单 |
| Terminal-Bench 4.0 | 57.4 | 66.4 | Argon 为 Google 自测,Opus 5.5 取自公开榜单 |
| PostTrainBench | 45.3 | 49.3 | 两款均为 Google 自测 |
| Terminal-Bench Science 0.1 | 57.6 | 63.3 | Argon 为 Google 自测,Opus 5.5 取自公开榜单 |
读这张表要带上三个条件:
- 基准是 Google 挑的。Argon 用最高思考档;竞品数字默认取最高推理档,没有公布时取已有的最好成绩。
- 差距最大的几项里,LABBench 2、GraphWalks 和 LVBench 是 Google 自己跑的两边成绩。LVBench 上 Gemini 按每秒 1 帧取帧,Opus 5.5 只用 600 帧,Google 的解释是 API 限制,两边的输入并不对等。
- Opus 5.5 领先的 4 项集中在终端操作和长程工程任务:FrontierSWE v2、Terminal-Bench 4.0、PostTrainBench、Terminal-Bench Science。
可以带走的判断是方向而不是幅度:Argon 在长上下文、法律和金融代理、科研和长视频理解上公布的数字更高,Opus 5.5 在终端和长程工程任务上更高。这张表不能说明 Argon 相对 Sonnet 5.5 的位置。
Anthropic 的数字:Sonnet 5.5 对 Opus 5.5
Sonnet 5.5 的发布页给出了它和 Opus 5.5 的对比,同样是厂商自测:
| 基准 | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 66.4%(xhigh,其最好成绩) |
| FrontierCode 1.1 | 46.2%(max;xhigh 为 52.1%) | 54.4% |
| CursorBench 4.0 | 55.5% | 57.8% |
| GDPval-AA v2.1 | 1844 | 1846 |
| AA-Briefcase v1.1 | 1811 | 1822 |
| Humanity's Last Exam(带工具) | 64.5% | 67.7% |
| OSWorld 2.1 | 80.1% | 81.8% |
| Chartography(不带工具) | 61.6% | 64.4% |
8 项里 Sonnet 5.5 只在 Terminal-Bench 4.0 上领先,其余 7 项 Opus 5.5 更高,但差距都不大:按百分比计分的几项相差 1.7 到 3.2 个百分点(FrontierCode 1.1 取 Sonnet 5.5 在 xhigh 下的 52.1%)。Anthropic 的结论是:Sonnet 5.5 适合范围明确的日常任务,复杂、开放式的工作上 Opus 5.5“仍然明显更强”。
两处容易读错:
- 发布页说 Sonnet 5.5 输出速度快 30% 以上、单任务成本最多降 30%,比较对象都是上一代 Sonnet 5,不是 Opus 5.5,也不是 Gemini。
- Opus 5.5 的 Chartography 在这里是 64.4,在 Google 的表里是 66.3。两个数字出自不同的运行,各自留在各自的表里看,不要拿 Sonnet 5.5 的 61.6 去和 Argon 的 71.6 直接相减。
现在用哪款 Claude
Anthropic 的选型文档说“多数工作负载从 Opus 5.5 开始”,Vals 的数据则显示两者在综合任务上基本打平、Sonnet 5.5 每题便宜三分之一。两种说法并不矛盾,区别在任务类型:
| 你的任务 | 先用 | 依据 |
|---|---|---|
| 代码生成、数据分析、内容创作、常规工具调用,范围明确 | Sonnet 5.5 | Anthropic 的推荐用途;Vals Index 上与 Opus 5.5 相差 0.07 个百分点,每题成本约三分之二 |
| 多小时的自主编码代理、大规模重构、复杂系统工程 | Opus 5.5 | Anthropic 的推荐用途;FrontierCode 1.1 上 54.4% 对 52.1%(Sonnet 5.5 的 xhigh 成绩) |
| 视觉密集的流程、computer use | Opus 5.5 | Anthropic 的推荐用途;OSWorld 2.1 上 81.8% 对 80.1% |
| 对响应速度敏感的交互场景 | Sonnet 5.5 | 官方延迟标注为 Fast,Opus 5.5 为 Moderate |
| 需要 fast mode | Opus 5.5 | 只有 Opus 5.5 提供(研究预览,仅 Claude API) |
| 缓存占比很高的代理任务 | 先试 Sonnet 5.5 | 缓存写入和读取也都是 Opus 5.5 的一半,算例 B 正好省 50%;省不省得下来,取决于 Sonnet 5.5 能否一次做完同样的任务 |
两条补充。第一,Anthropic 明确写了调 effort“往往比换模型更有效”:Opus 5.5 默认 medium,Sonnet 5.5 默认 high,同一任务换档后的成本和质量都会变,档位怎么选见 Claude Opus 5.5 的 effort 怎么选?五档设置与任务成本比较。第二,两款 5.5 的接口行为和旧版不同,例如都会拒绝强制工具调用(tool_choice 设为 any 或 tool 会返回 400),从旧模型切过来之前先看 Claude Opus 5.5 已发布:API 价格、能力与从 Opus 5 迁移的检查项。
如果你的候选里还有 Fable 5.1 或更小的 Claude 模型,各档之间的边界见 Opus 5.5 和 Fable 5.1 怎么选?Claude 四档模型的价格与能力边界。
要不要换到 Argon:11 月 30 日前用同一批任务实测
要不要换,先看你现在付的是哪一档的钱:
- 从 Sonnet 5.5 换过来:11 月 30 日前单价相同,换不换只取决于质量、速度和 token 用量。12 月 1 日起 Argon 每个 token 贵一倍,除非它在你的任务上用一半左右的 token 就能做完,或者质量明显更好,否则 Sonnet 5.5 仍然更省。
- 从 Opus 5.5 换过来:11 月 30 日前 Argon 单价是一半;12 月 1 日起同价,比的就只剩任务结果和实际用量。长期预算按 $4/$20 来做,不要按 11 月 30 日前的价格。
- 优先拿来实测的任务:超长上下文里做检索和推理(GraphWalks 256k–1M 上 84.2 对 66.8)、法律和金融类代理、科研工具链、长视频理解,或者单次输出要超过 128K token(Argon 开启 long decode 后可以,两款 Claude 同步请求最多 128K)。
- 可以不着急:以终端操作和长程工程任务为主。Google 自己的表里,这几项是 Opus 5.5 领先。
实测的做法:
- 选一个能看到成本的入口。API 付费层能拿到逐次用量,最适合算账;Gemini 应用和 AI 模式适合先感受回答质量,算不出 API 成本;Copilot 按用量计费,但按 Argon 哪一段价格扣费没有写明。
- 用同一批真实任务分别跑 Argon 和你现在用的 Claude,记录是否一次完成、输入 token、缓存命中 token、输出 token(含思考)和实际费用。
- Argon 的账单直接乘以 2,得到 12 月 1 日后的成本(标准档的三项单价都正好翻倍;搜索建立依据之类的附加费用不在其中)。
- 缓存命中明显偏低时,按算例 B 里“未命中”的那一行估算成本,再决定是否值得换。
如果你只是想要一个更便宜的 Gemini 模型,而不是旗舰级的 Argon,可以看 Gemini 3.8 Flash API 指南:型号、价格、规格与迁移。
常见问题
Gemini 4 Argon 现在能通过 API 调用吗?
能。2026 年 10 月 13 日起,Gemini API 付费层可以调用,型号 ID 是 gemini-4-argon。11 月 30 日前每百万 token 输入 $2、输出 $10,12 月 1 日起 $4/$20;免费层不能用。9 月 30 日公布时它只开放给 Fairwind 计划内的安全防御团队,现在已经不是这样了。
Gemini 4 Argon 免费吗?
不免费。Gemini API 的免费层不能用它;免费版 Gemini 应用只有 Flash-Lite,Google AI Plus 也不含 Argon;AI Studio 网页的免费和 Pro 套餐不含;GitHub Copilot Free 和 Pro 也不在名单里。能用它的途径都要付费:API 按量计费、Google AI Pro 或 Ultra 订阅、Copilot Pro+ 及以上的用量计费。
不花钱的途径只有两个申请制计划:科研人员可以申请 6 个月免费使用 Antigravity 的最高用量档,需要审核和筛选;网络安全防御人员可以申请加入 Fairwind 计划。Gemini API 免费层还能用哪些模型,见 Gemini API 免费层还能用吗?先检查模型、项目和地区。
Gemini 4 Argon 在哪里能用?
开发者用 Gemini API 付费层(AI Studio 生成的 key、Gemini 平台、Android Studio);普通用户在 Gemini 应用和搜索的 AI 模式里用,需要 Google AI Pro 或 Ultra 订阅;Google Antigravity 和 AI Studio 网页的订阅额度只对 Ultra 开放;GitHub Copilot 里需要 Pro+、Max、Business 或 Enterprise。各入口的付费方式和注意事项见上面的入口对照表。
“Gemini 4 Pro”和 Gemini 4 Argon 是同一个模型吗?
发布前的泄露消息用过“Gemini 4 Pro”这个名字,Google 正式公布的名称是 Gemini 4 Argon,API 型号 ID 是 gemini-4-argon。泄露稿里的价格和“实测”数字不是官方信息,以 9 月 30 日的公告和 10 月 13 日上线后的定价页为准。
Gemini 4 Argon 比 Opus 5.5 强吗?
看哪份数据。Google 公布的 18 项基准里,Argon 领先 14 项,Opus 5.5 领先 4 项(终端和长程工程类);第三方的 Vals Index v2.1 上 Argon 68.90%、Opus 5.5 66.97%。但 Artificial Analysis 智能指数 v4.3.2 上 Opus 5.5 是 58,Argon 是 53。这些都不是在你的任务上测的,Argon 已经能调用,用自己的任务跑一遍最可靠。
Gemini 4 Argon 比 Sonnet 5.5 便宜吗?
11 月 30 日前一样贵:输入、输出都是 $2/$10,缓存命中都是 $0.10。12 月 1 日起 Argon 涨到 $4/$20、缓存 $0.20,是 Sonnet 5.5 的两倍。按任务算可能更省:Artificial Analysis 上两者单价相同,Argon 跑完整套测试的成本约为 Sonnet 5.5 的三分之一($2,407 对 $7,260),说明它在那套测试里用的 token 少得多。换成你的任务要实测。
Sonnet 5.5 的价格是 Opus 5.5 的一半,用它就能省一半吗?
按单价算是一半:输入、输出、缓存写入和缓存读取($0.10 对 $0.20)都是 Opus 5.5 的一半,所以 token 数相同时,不管用不用缓存都省 50%。但真实任务里两者的用量不一样,Vals Index 上 Sonnet 5.5 的每题成本约为 Opus 5.5 的三分之二。