多数复杂任务先试 Claude Opus 5.5。按截至 2026 年 10 月 8 日的 Claude 直接 API 标准价格,它的新输入、输出、缓存写入和缓存读取单价都低于 Fable 5.1。Fable 5.1 值得留在候选名单里:当你的高难推理或长时间 Agent 任务,在 Opus 5.5 提高 effort 后仍达不到验收标准,再用相同任务比较 Fable 的通过率、时间和总成本。这是 Anthropic 当前的模型选择建议给出的顺序。
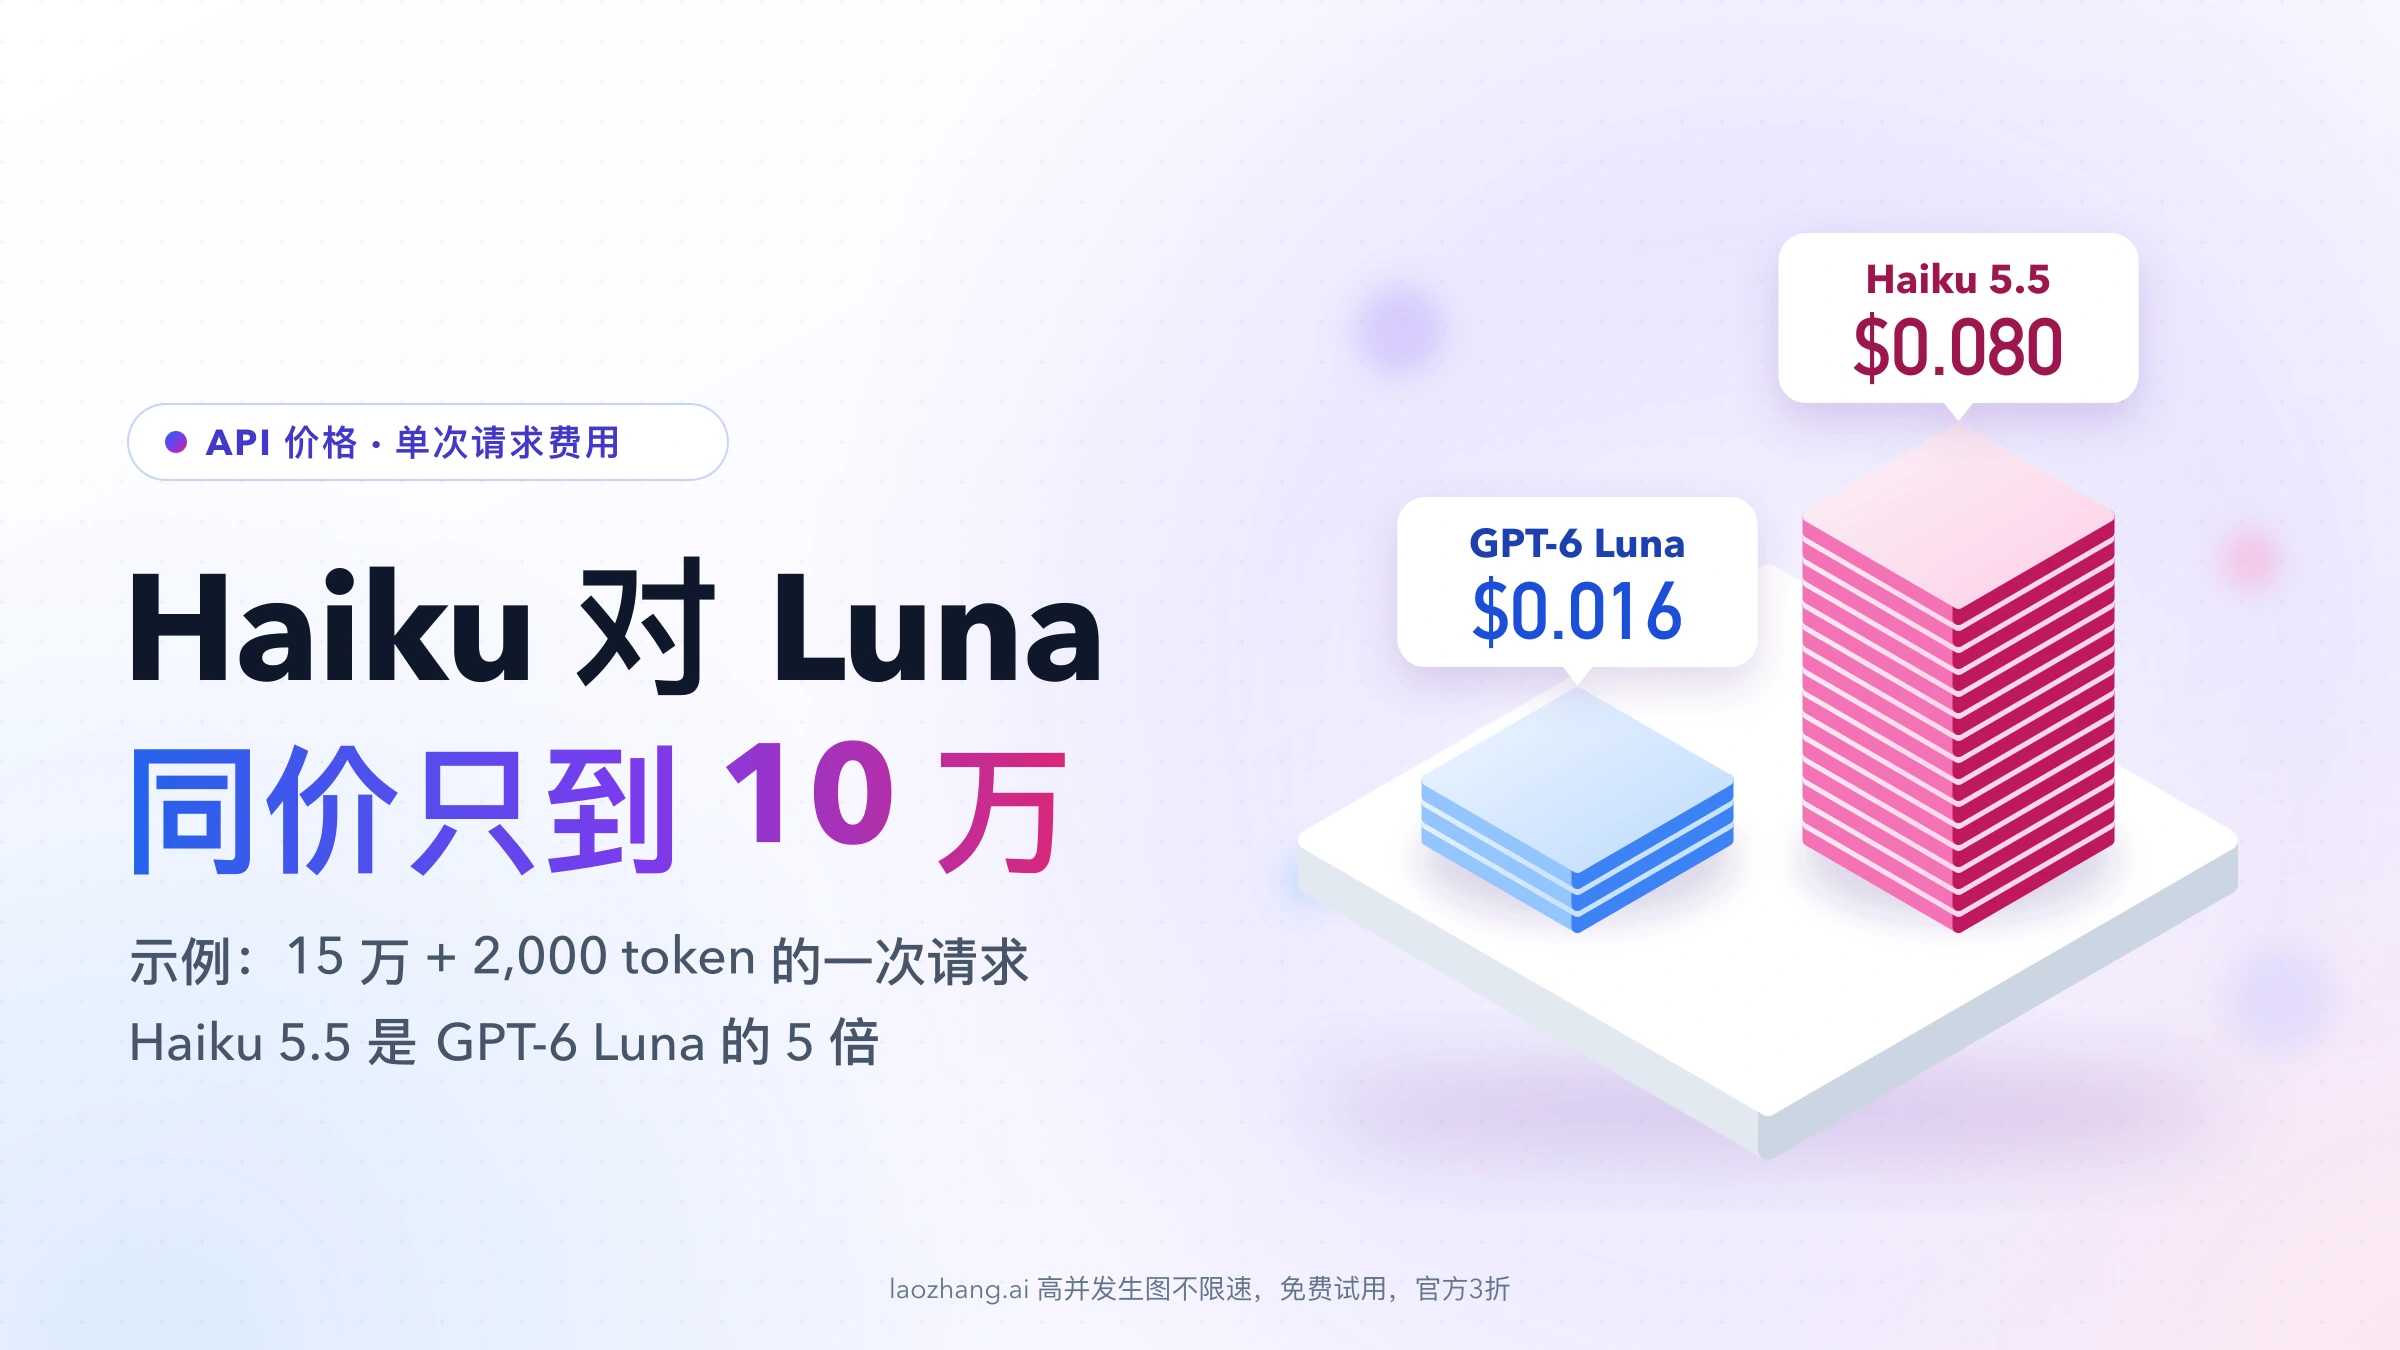
下面两档刚换代:Sonnet 5.5 于 2026 年 9 月 28 日发布,Haiku 5.5 于 2026 年 10 月 7 日发布,Sonnet 5 和 Haiku 4.5 仍可调用,但已列为旧版。Sonnet 5.5 的输入、输出单价与 Sonnet 5 相同($2 / $10),缓存读取减半;Haiku 5.5 在单次提示词不超过 10 万 token 时只要 $0.10 / $0.50,比 Haiku 4.5 低九成,超过 10 万 token 后所有单价乘 5。高并发、对成本敏感的简单任务,官方建议直接从 Haiku 5.5 起步,不够再往上换。
这些数字针对按 token 计费的 Claude 直接 API 标准模式。它们不等于 Claude Pro、Max 或 Claude Code 的订阅额度,也不能直接套用到 Fast、Batch、云平台或第三方网关;订阅里怎么选见后文单独一节。
四档 Claude 模型,先按任务选起点
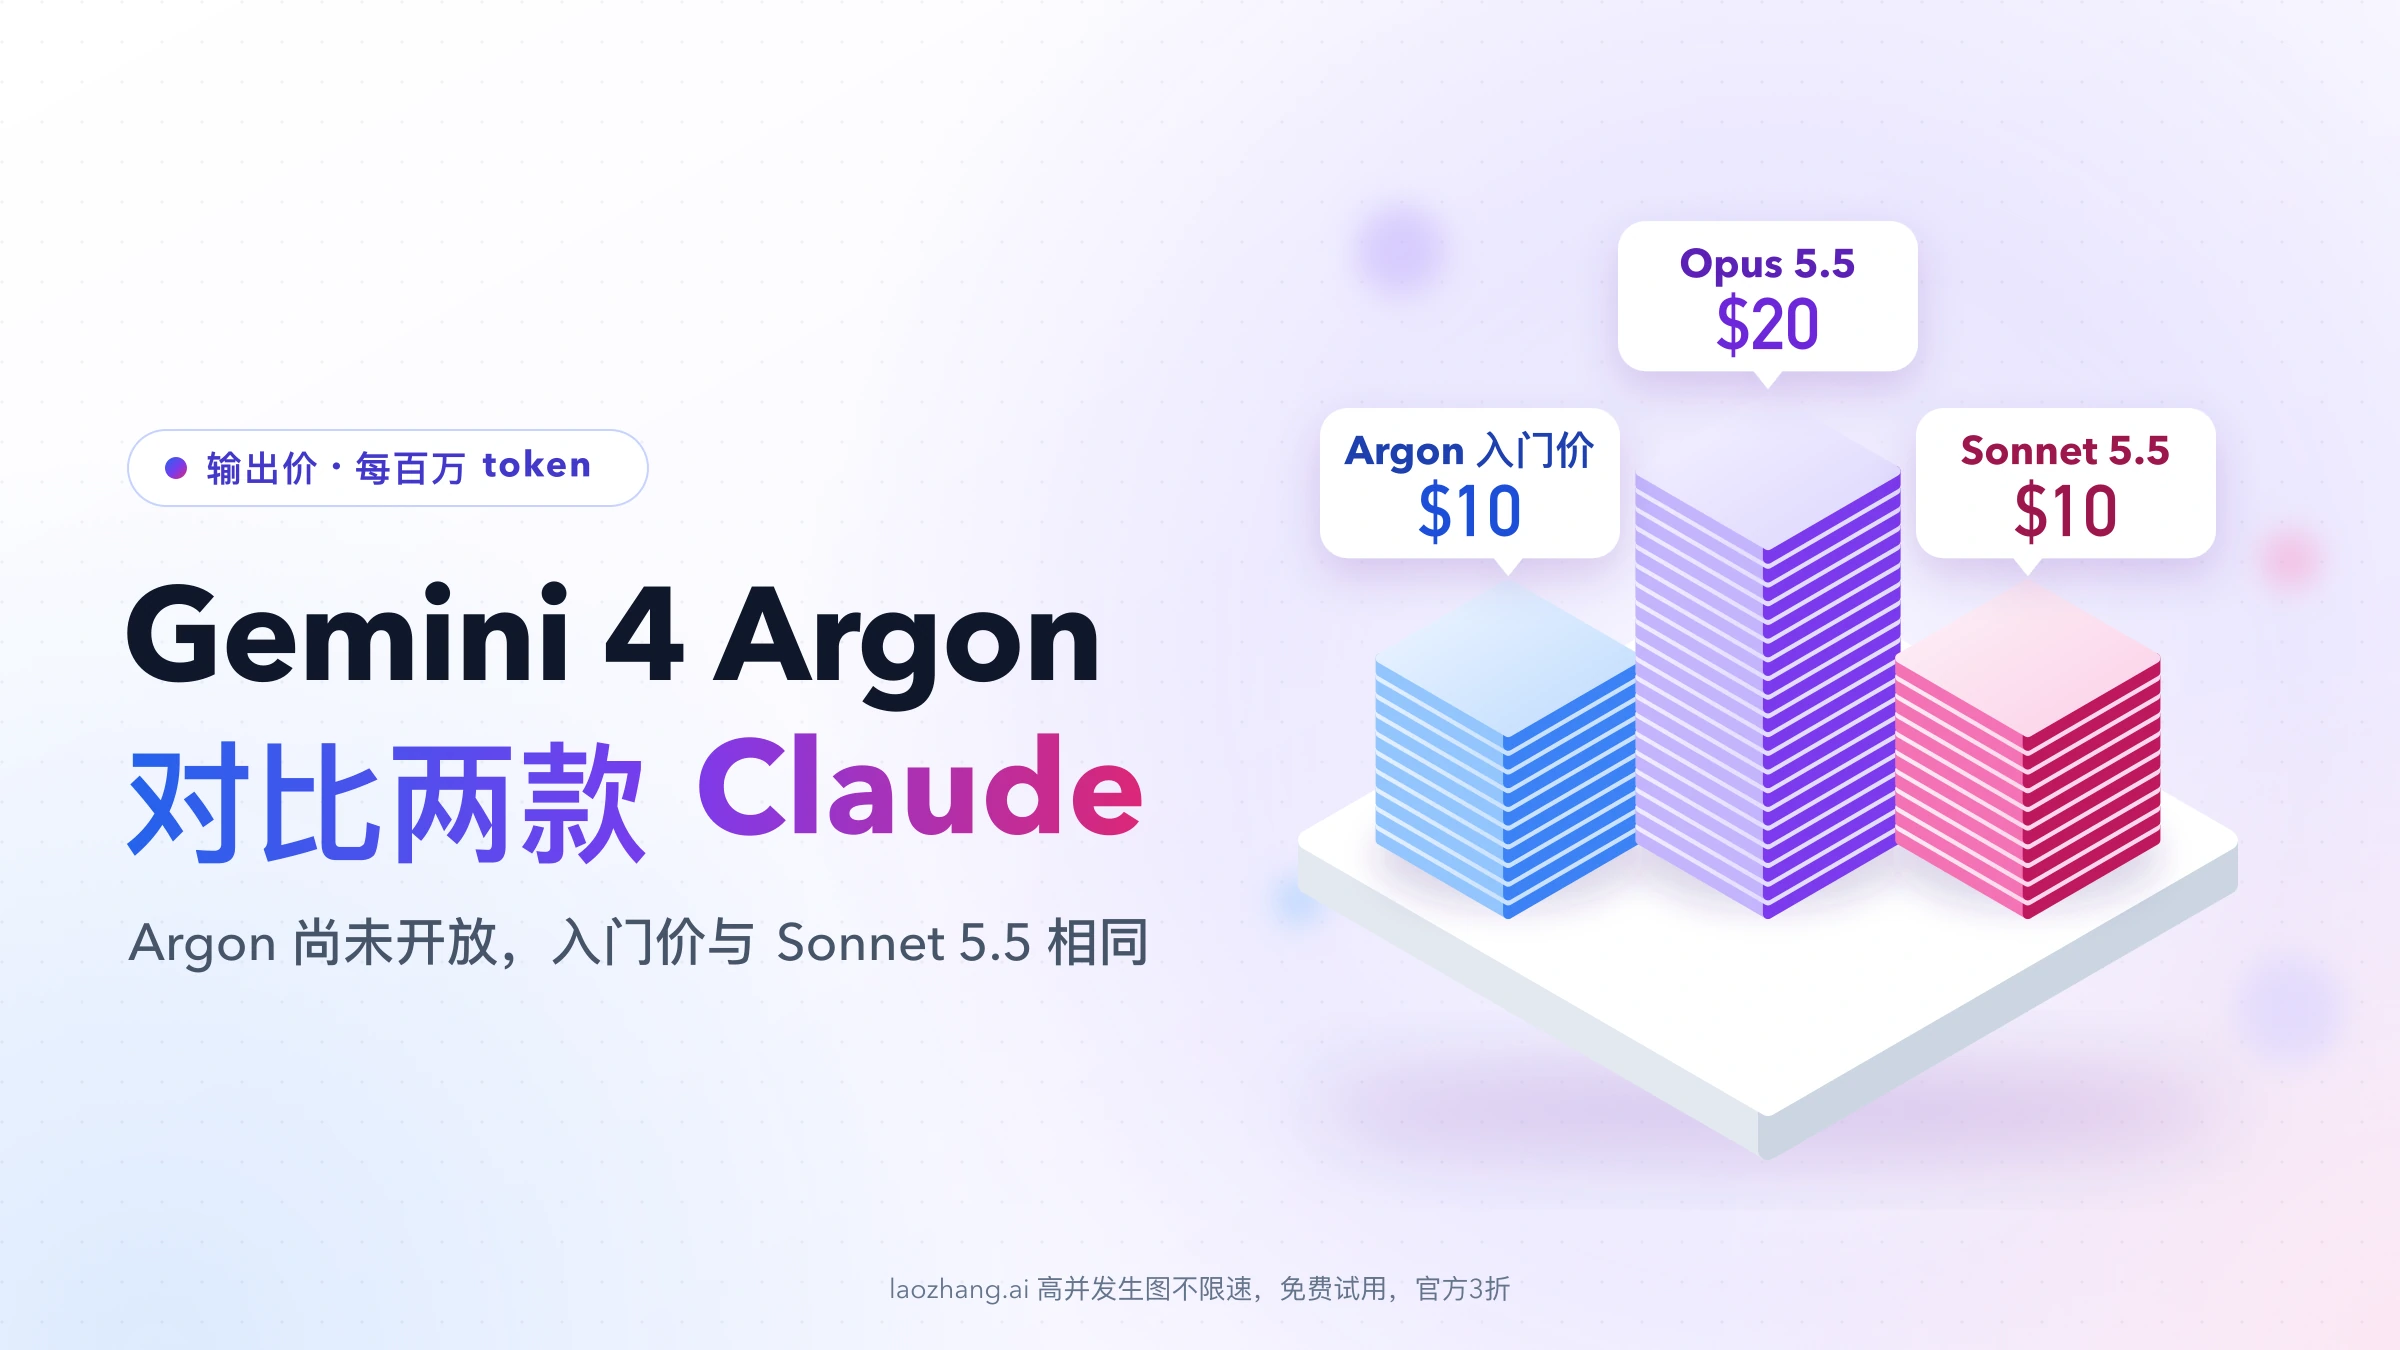
| 起点 | 适合先试的任务 | 什么时候往上看 | 标准 API 新输入 / 输出,美元每百万 token |
|---|---|---|---|
| Haiku 5.5 | 分类、抽取、路由、实时响应和大批量请求,也适合当子代理;失败容易自动识别 | 把 effort 调到 high 后,准确率或复杂步骤仍达不到验收线 | $0.10 / $0.50(提示词 ≤10 万 token);超过时 $0.50 / $2.50 |
| Sonnet 5.5 | 日常编码、Agent 和企业工作负载,兼顾速度与能力 | 多步骤任务反复失败,或人工修复过多 | $2 / $10 |
| Opus 5.5 | 复杂 Agent 编码和知识工作;官方建议的多数负载起点 | 调高 effort 并优化任务后仍有明确能力缺口 | $4 / $20 |
| Fable 5.1 | 高难推理、长时间 Agent,且已有任务集能验证收益 | 用合格任务成本决定是否保留,而非只看型号等级 | $10 / $50 |
价格来自 Anthropic 费率表,任务定位参照官方选型指南。这张表给的是起点,不是“Haiku 一定能完成抽取”或“Fable 一定比 Opus 更准”的承诺。真正的分界线是你的失败模式:可批量验证的简单任务先压低单次成本;需要复杂推理时从 Opus 5.5 建立基线;只有基线不足才支付 Fable 的溢价。
四档的上下文窗口都是 100 万 token,标准模式最大输出 12.8 万 token,可靠知识截止都在 2026 年 6 月,effort 都支持 low、medium、high、xhigh、max 五级(见模型总览和 effort 文档)。真正不同的是速度、默认设置和订阅里能不能用:
| 截至 2026 年 10 月 8 日 | Haiku 5.5 | Sonnet 5.5 | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|
| API 模型 ID | claude-haiku-5-5 | claude-sonnet-5-5 | claude-opus-5-5 | claude-fable-5-1 |
| 官方给的相对速度 | 最快 | 快 | 中等 | 较慢 |
API 默认 effort | medium | high | medium | high |
| 思考(thinking) | 默认开启,high 及以下可关闭 | 默认开启,最低可设 between_tools | 始终开启 | 始终开启 |
| Claude 订阅可用范围 | Free 起 | Free 起 | Pro 起 | Pro 按用量额度付费;Max 最多占每周限额的 50% |
订阅可用范围来自 Claude 价格页。该页按 Haiku、Sonnet 这样的系列列出,不写版本号。
Sonnet 5.5 和 Haiku 5.5 换代:旧版仍可用,账单怎么变
Sonnet 5.5 与 Sonnet 5 的新输入和输出单价一样,都是 $2 / $10,变的是缓存读取:从 $0.20 降到 $0.10。按费率表,重复读取大段缓存上下文的 Agent 和编码任务会直接受益。迁移时注意三处:Sonnet 5.5 的 effort 档位重新校准过,原来在 Sonnet 5 上调好的档位要重新对比一遍;思考不能再关闭,最低设为 between_tools;强制工具调用会返回 400 错误。完整清单见 Sonnet 5.5 模型页。
Haiku 5.5 的价格结构和以前不同,按单次请求的提示词长度分两段:
| 美元每百万 token | Haiku 5.5,提示词 ≤10 万 | Haiku 5.5,提示词 >10 万 | Haiku 4.5(旧版) |
|---|---|---|---|
| 新输入 | $0.10 | $0.50 | $1 |
| 缓存读取 | $0.01 | $0.05 | $0.10 |
| 输出 | $0.50 | $2.50 | $5 |
按 Anthropic 的发布说明,Haiku 5.5 比 Haiku 4.5 便宜九成只在 10 万 token 以内成立,超过后便宜一半。还有两点会抵消一部分差价:
- 同一段文字在 Haiku 5.5 上多约 30% token。 它换用了更新的分词器,四档现行模型现在共用这一套,所以四档之间按 token 比较是同一把尺子;但拿 Haiku 4.5 的历史用量估算 Haiku 5.5 的预算,要用新模型重新计数(见 Haiku 5.5 模型页)。
- 缓存读取算不算进 10 万门槛,公开文档没有写。 提示词接近 10 万 token 的工作负载,按高档价格做预算更稳妥。
Haiku 5.5 还把上下文从 20 万扩到 100 万 token,默认开启思考;temperature、top_p、top_k 传非默认值,或者使用预填充(prefill)都会报错,见新特性说明。旧的 claude-haiku-4-5 仍是可用状态,弃用页写明退役时间不早于 2026 年 10 月 15 日,截至 10 月 8 日尚无弃用通知。要拿 Haiku 5.5 和 OpenAI 的小模型比价,看 Claude Haiku 5.5 对比 GPT-6 Luna API 价格:同价只到 10 万 token。
同样的 token 四档各花多少:两组算例
下面两组算例把用量固定,只换单价,计算方法是:费用 = 新输入(百万 token)× 输入价 + 缓存读取 × 读取价 + 输出 × 输出价。两组都不含首次缓存写入,单次提示词都不超过 10 万 token,所以 Haiku 5.5 按低档计价。
- 算例 A,一次请求:3 万新输入 + 6 万缓存读取 + 5,000 输出,提示词共 9 万 token。
- 算例 B,一次 Agent 运行:20 轮,每轮重读 8 万 token 的缓存前缀(共 160 万缓存读取),另加 5 万新输入、1 万输出。
| 型号 | 算例 A | 算例 B |
|---|---|---|
| Haiku 5.5 | $0.0061 | $0.026 |
| Sonnet 5.5 | $0.116 | $0.36 |
| Opus 5.5 | $0.232 | $0.72 |
| Fable 5.1 | $0.565 | $1.40 |
| Haiku 4.5(旧版) | $0.061 | $0.26 |
| Sonnet 5(旧版) | $0.122 | $0.52 |
以 Haiku 5.5 的算例 A 为例:0.03×0.10 + 0.06×0.01 + 0.005×0.50 = $0.0061。在这组用量下,Sonnet 5.5 约是 Haiku 5.5 的 19 倍,Opus 5.5 是 Sonnet 5.5 的 2 倍,Fable 5.1 约是 Opus 5.5 的 2.4 倍。算例 B 的缓存读取占比更高,Sonnet 5.5 比 Sonnet 5 便宜了 $0.16,Fable 与 Opus 的差距缩到约 1.9 倍。
把算例 A 的提示词加到 15 万 token(9 万新输入 + 6 万缓存读取,输出不变),Haiku 5.5 进入高档,若缓存读取也计入门槛,一次是 $0.0605,Sonnet 5.5 是 $0.236:Haiku 仍约为 Sonnet 的四分之一,但每类 token 的单价都已是低档的 5 倍。
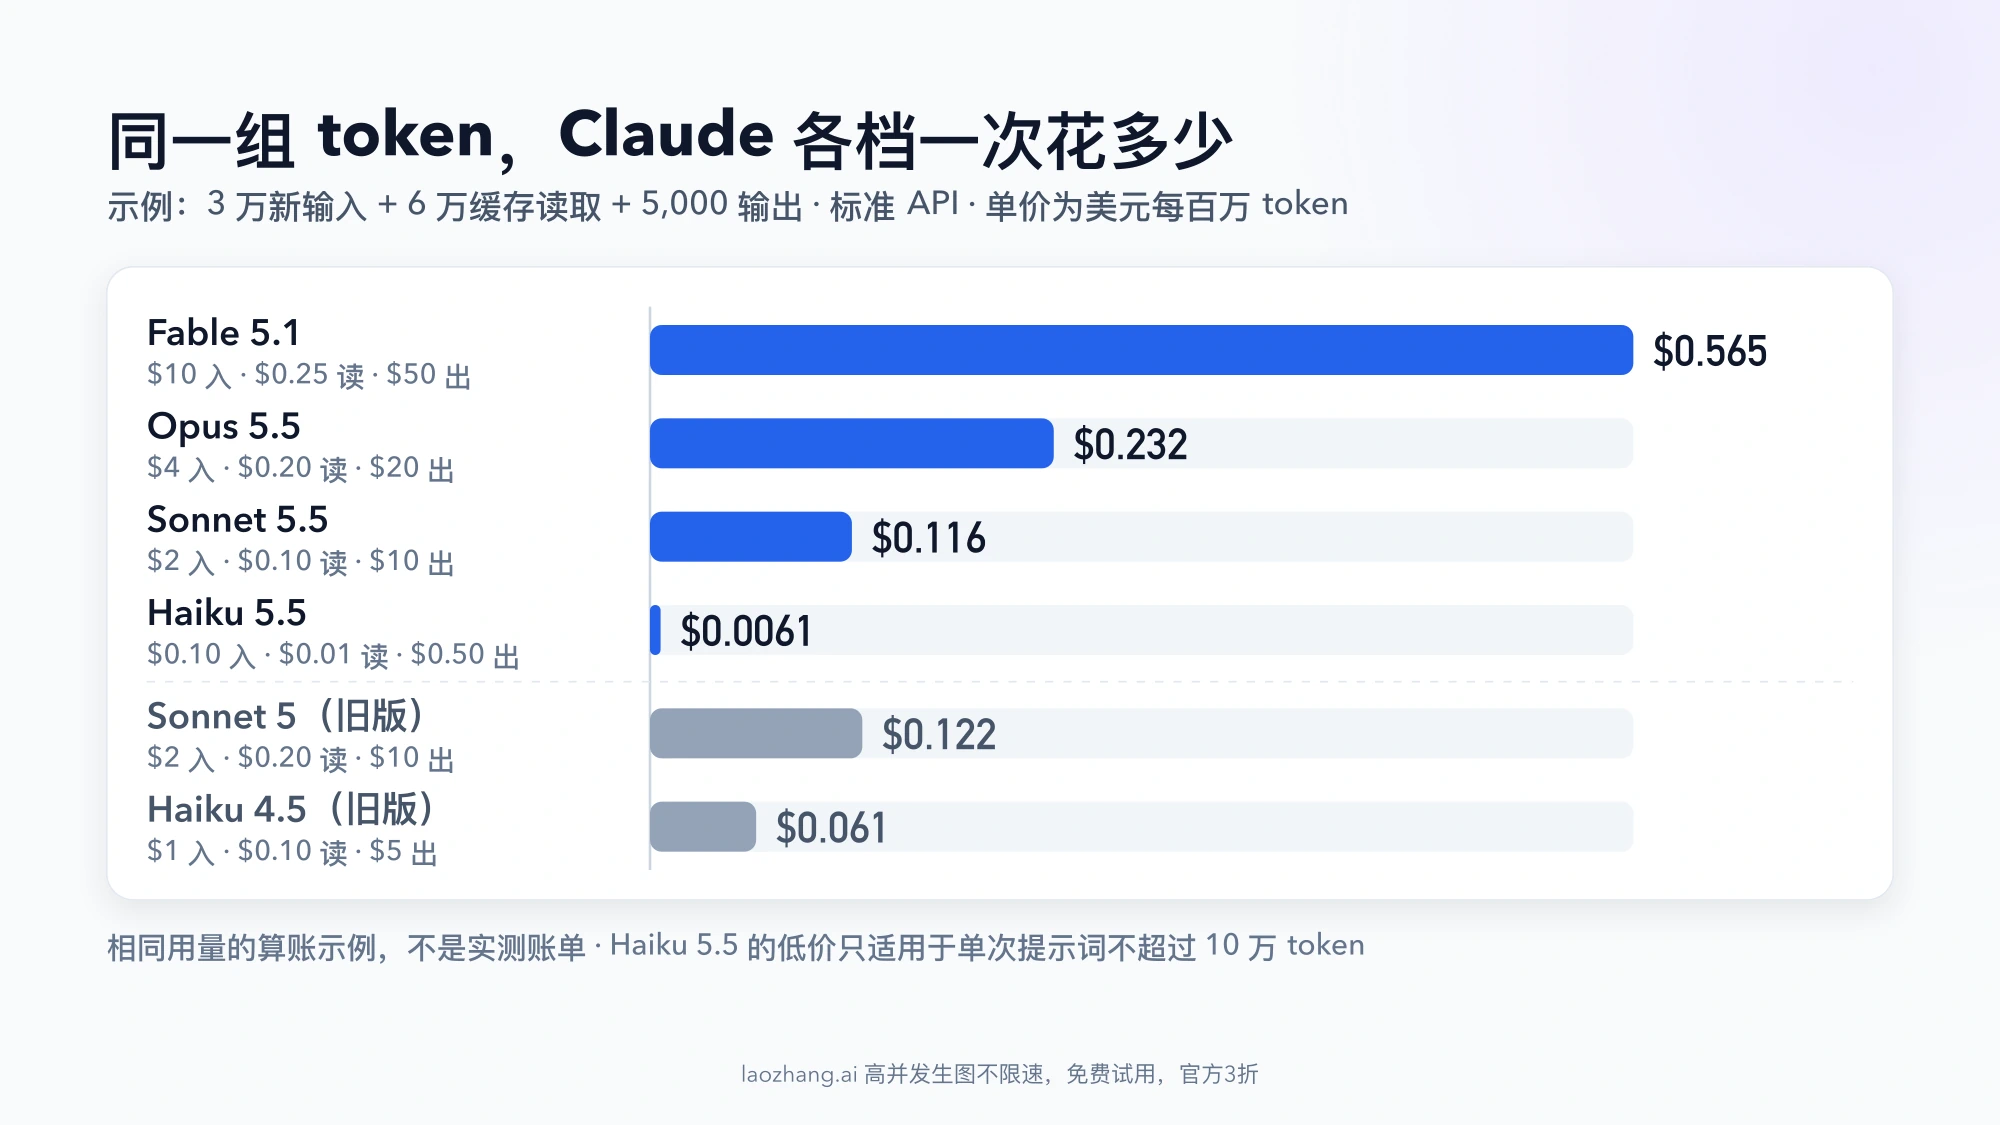
这些是相同用量的算账例子,不是四个模型跑同一任务的实测账单。不同模型会生成不同长度的思考和输出、调用不同次数的工具,重试次数也不一样,所以真正要比的是每个合格结果的成本,方法见后文。
Opus 5.5 与 Fable 5.1:价格差已经没有缓存反转
两款模型的直接 API ID 分别是 claude-opus-5-5 和 claude-fable-5-1。价格须按同一种计费入口、同一类 token 比较:
| 标准 Claude 直接 API,美元/百万 token | Opus 5.5 | Fable 5.1 |
|---|---|---|
| 未缓存的新输入 | $4 | $10 |
| 输出 | $20 | $50 |
| 5 分钟缓存写入 | $5 | $12.50 |
| 1 小时缓存写入 | $8 | $20 |
| 缓存读取 | $0.20 | $0.25 |
数据见 Anthropic 价格页。在各类 token 用量相同且为正的前提下,Opus 5.5 的 token 账单一定更低:上面的算例 A 中是 $0.232 对 $0.565,算例 B 中是 $0.72 对 $1.40。旧版 Opus 5 的缓存读取是 $0.50,高于 Fable 5.1 的 $0.25,那时读缓存足够多的任务,Fable 可能反而更便宜;Opus 5.5 降到 $0.20 后,这种反转不再成立。
有两组常见数字不能混用:Opus 5.5 的新输入、输出和缓存写入标价比 Opus 5 低 20%;Anthropic 报告的典型任务成本低约 40%,同样是与 Opus 5 比,且包含 token 用量变化。发布说明没有说它比 Fable 5.1 的真实任务成本固定低 40%。此外,Opus 5.5 是四档里唯一提供 Fast 模式的型号($8 / $40),那是另一档价格,不能拿其延迟优势与标准模式的 $4 / $20 混算。
能力怎么比:公开分数能提示方向,不能代替你的验收
Anthropic 的 Opus 5.5 发布资料给出 Terminal-Bench 4.0 的 66.4% 对 55.8%,以及 CursorBench 4.0 的 57.8% 对 51.8%(前者均为 Opus 5.5,后者为 Fable 5.1),并称 Opus 5.5 在多数工作上达到 Fable 5.1 的水平。这些是有测试环境和设置的厂商报告:Opus 5.5 的表格成绩大多使用 max effort,Terminal-Bench 使用 xhigh。不能把这些分数当作默认 medium 下的通过率,再与默认模式的价格拼成一条“质量更高且成本更低”的结论。
API 默认 effort 也不同:Opus 5.5 为 medium,Fable 5.1 为 high,见选型指南。做自己的对照时,先记录各自默认设置的结果,再单独记录提高 Opus effort 后的结果;不要把不同设置的费用、延迟和通过率塞进同一行。对于你自己的任务,“更强”应表现为更高的验收通过率、更少的人工返工,或在约定时限内完成更困难的工作。
从 Opus 5.5 升级到 Fable 5.1,先找出失败在哪里
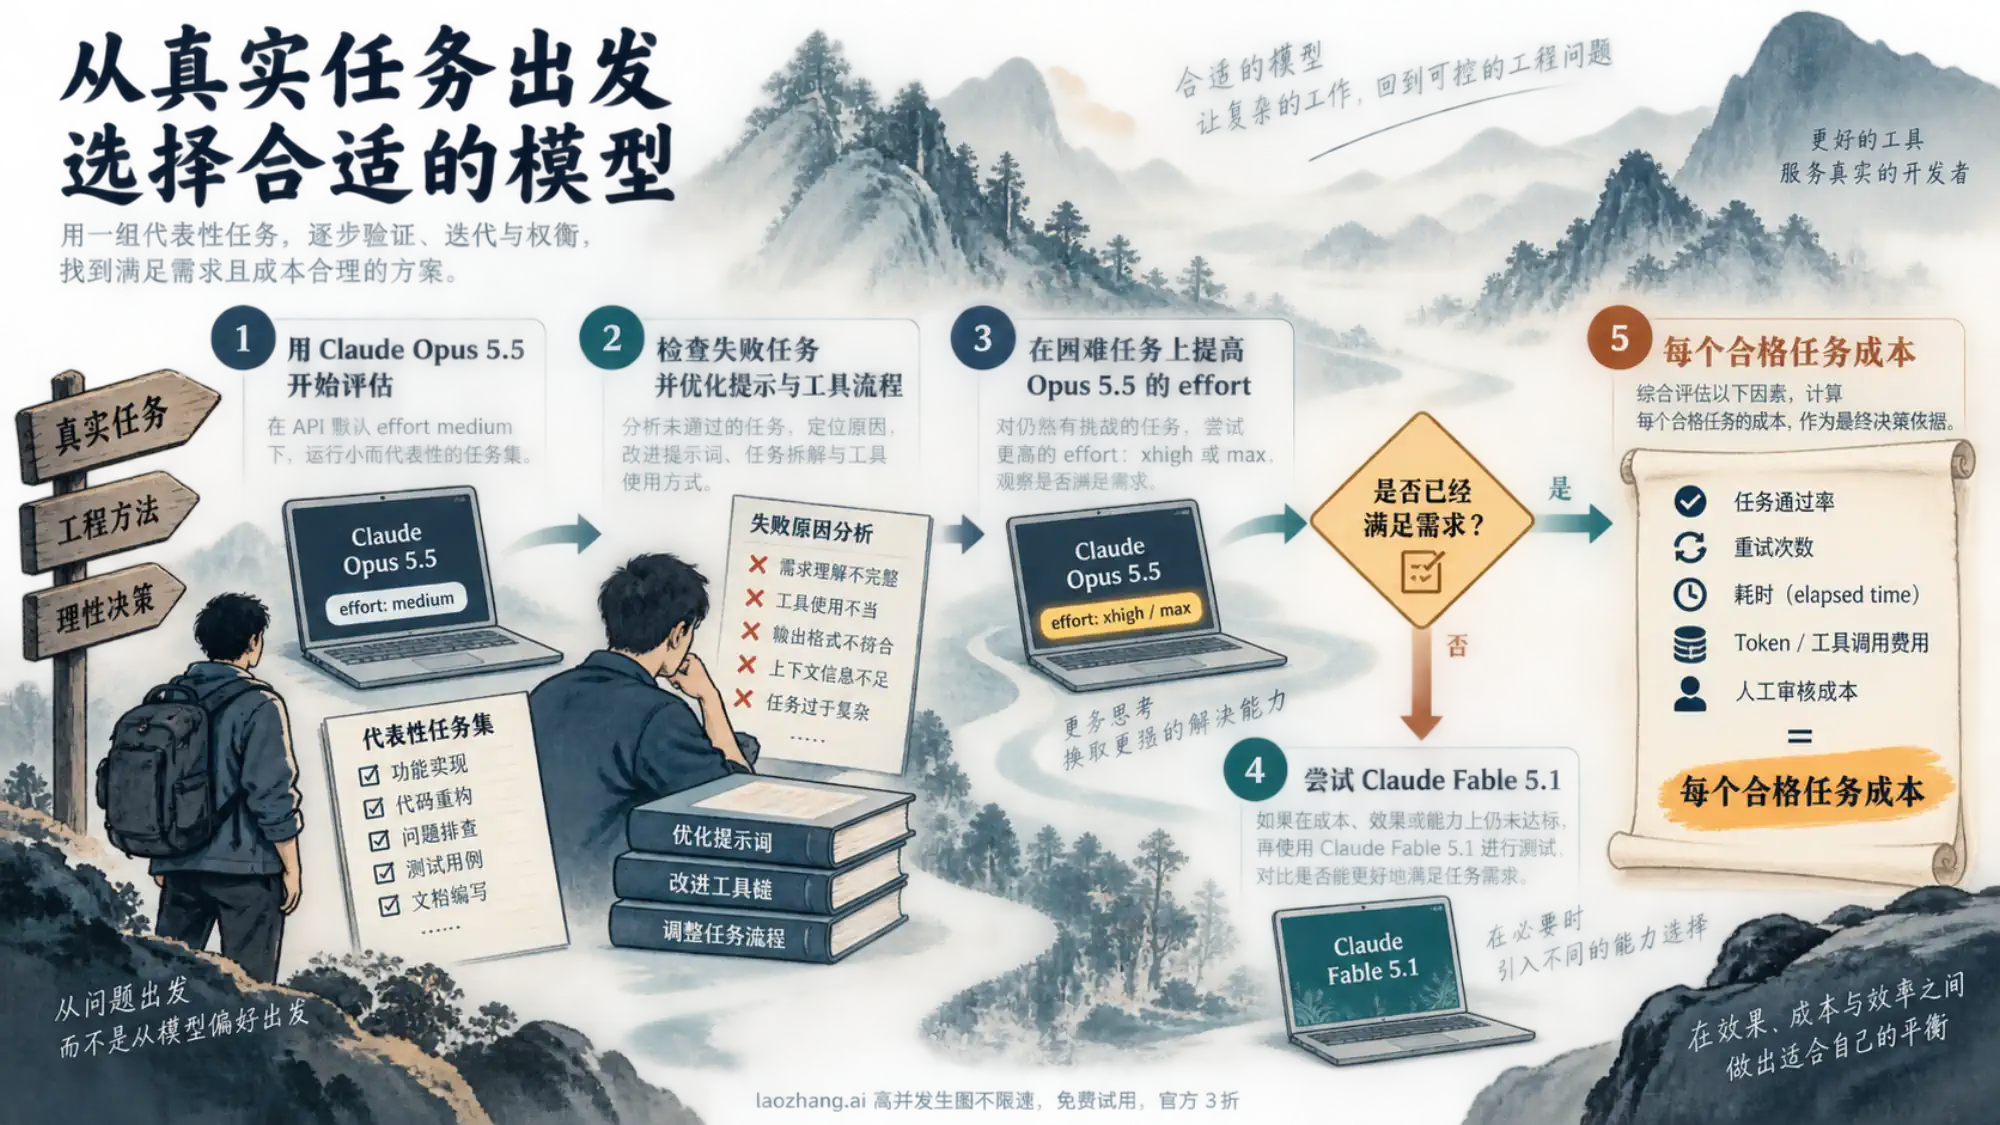
拿一批真实任务做小规模试跑:包含常见请求、复杂请求和曾经失败的边缘案例,输入、工具权限、超时与停止条件保持一致。每项任务写出可核验的终点,如测试通过、结构化输出能通过 schema、引用与原文一致,或 Agent 实际完成操作。只统计 HTTP 200、模型自称“已完成”,会高估可用性。
对每个配置记录首次通过率、重试后通过率、失败原因、墙钟时间、实际新输入/缓存写入/缓存读取/输出 token、工具费用,以及审核和返工时间。然后比较:
每个合格任务成本 =(API 与工具费用 + 重试费用 + 人工审核和返工成本)÷ 合格任务数
若 Opus 5.5 在默认 medium 已稳定通过,就没有仅凭型号名称升级的理由。若失败集中在复杂推理或长时间任务,先优化提示和工具流程,再提高 Opus 的 effort;到 xhigh 或 max 仍不达标,才按官方建议测试 Fable 5.1。Fable 单次 token 更贵,但如果它减少足够多的失败、重试或人工修复,合格结果的总成本仍可能更低。是否发生这种反转,只能用你的任务数据回答。
先调 effort 再换模型:Haiku 5.5 到 Sonnet 5.5 也一样
选型指南的原话是“调 effort 往往比换模型更有效”。往下省钱时同样适用:Opus 5.5 已稳定通过的任务,可以先把 effort 降一级再看通过率,再考虑换成 Sonnet 5.5。
从低成本一侧起步时,按 effort 文档的建议:
- Haiku 5.5 从
medium开始,Agent 编码也一样;聊天、简短工具调用和大批量简单请求可以降到low,但在很长的 Agent 提示里,low可能跳过搜索或提前停止;知识工作、较长的 Agent 任务和严格遵循指令用high。调到xhigh或max时,就该拿同一批任务和 Sonnet 5.5 比一比。 - Sonnet 5.5 默认
high;Agent 编码建议从medium开始,聊天用medium或low。 - Opus 5.5 默认
medium,思考不能关闭;Fable 5.1 从high开始。
在 Claude 订阅和 Claude Code 里怎么选
订阅里没有按 token 计价,四档的差别变成能不能用、占多少额度。按 Claude 价格页,Haiku 和 Sonnet 在 Free、Pro、Max 都能用;Opus 从 Pro 起;Fable 不在 Free,Pro 用户从第一次请求起按标准 API 价格消耗用量额度(usage credits),Max 5x 和 20x 最多可把每周限额的 50% 用在 Fable 上,这部分从原有周限额里扣,不是额外容量(见 Fable 套餐说明)。
额度消耗的顺序是 Haiku 最少、Sonnet 中等、Opus 较多、Fable 最多,Claude Academy 的选型教程把 Sonnet 当作拿不准时的默认选择。Anthropic 没有公布每个模型具体按几倍扣额度。Pro 和 Max 的限额怎么算,见 Claude Max 和 Pro 限额差在哪?5x、20x 升级后仍有周上限。
Claude Code 里的别名已经指向新型号(见 模型配置文档):
| 别名 | 截至 2026 年 10 月 8 日对应 |
|---|---|
default | Opus 5.5(Pro、Max、Team、Enterprise 和 Anthropic API) |
sonnet | Sonnet 5.5 |
haiku | Haiku 5.5 |
opus | Opus 5.5 |
fable | Fable 5.1 |
opusplan | 用 Opus 5.5 规划,用 Sonnet 5.5 执行 |
默认是 Opus 5.5,不代表日常编码都该用它。Claude Code 帮助中心写明大多数编码工作用 Sonnet 就合适,Opus 每轮消耗是 Sonnet 的数倍;额度紧张时,先用 /model sonnet 或 opusplan,机械性的小改动交给 haiku。
接入前,核对版本和计费入口
新项目应在请求和用量记录里写清模型 ID,避免把 claude-sonnet-5、claude-haiku-4-5 或旧 claude-opus-5 的价格留在预算表里。从 Haiku 4.5 迁到 Haiku 5.5 时,用新模型重新统计提示词 token,并去掉 temperature、top_p、top_k 和预填充;从 Sonnet 5 迁到 Sonnet 5.5 时,按上文处理思考设置、强制工具调用和 effort 档位。迁往 Opus 5.5 时还要检查 thinking、强制工具选择、计算机使用工具等兼容变化,Claude Opus 5.5 已发布:API 价格、能力与从 Opus 5 迁移的检查项承接具体改法;Claude Fable 5.1:价格、API 变化与迁移指南可用于核对 Fable 的规格与接入条件。
最后把报价入口分开:上面的数字是标准 Claude 直接 API。Batch 把输入和输出都减半(例如 Sonnet 5.5 为 $1 / $5,Haiku 5.5 低档为 $0.05 / $0.25);Fast、美国限定推理、Bedrock、Google Cloud 或其他平台另有价格;Claude 订阅套餐还有各自的额度规则。先确定自己实际付费的入口,再拿对应费率和真实用量复算,才能决定让 Haiku、Sonnet、Opus 或 Fable 承担哪一类请求。
Sonnet、Opus、Haiku、Fable 的区别:常见问题
Sonnet 比 Opus 差多少?
按 API 单价,Opus 5.5 是 Sonnet 5.5 的 2 倍($4 / $20 对 $2 / $10),缓存读取是 $0.20 对 $0.10。能力上,官方把 Sonnet 5.5 定位为日常编码、Agent 和企业工作负载,把 Opus 5.5 定位为复杂 Agent 编码和知识工作,没有给出一个统一的分数差。你的任务在 Sonnet 5.5 上已经能稳定通过,换 Opus 就只是多花钱;Sonnet 反复失败时,再用同一批任务比较两者的合格任务成本。
Claude 哪个模型最厉害?
按 Anthropic 的选型表,能力上限最高的是 Fable 5.1,适合最难的推理和长时间 Agent 任务。但 Opus 5.5 在官方报告的 Terminal-Bench 4.0 和 CursorBench 4.0 上分数高于 Fable 5.1,新输入和输出单价还低 60%,所以多数任务先用 Opus 5.5,只有它调到 xhigh 或 max 仍不够时,Fable 才值得那份溢价。
Claude 有哪几种模型?Sonnet、Opus、Haiku 是什么意思?
Haiku、Sonnet、Opus、Fable 是 Anthropic 按能力和价格分的四个系列,后面的数字是版本。截至 2026 年 10 月 8 日,现行版本是 Haiku 5.5、Sonnet 5.5、Opus 5.5 和 Fable 5.1,从左到右越来越强、越来越慢、越来越贵;Sonnet 5、Haiku 4.5、Opus 5、Fable 5 等旧版仍可调用,见模型总览。