截至 2026 年 9 月 24 日,Claude Opus 5.5 和 GPT-5.6 Sol 的 API 标价相同:每百万 token 输入 $4、输出 $20。但 GPT-5.6 Sol 的这个价格是 OpenAI 自己标注的促销价,模型页写明"至少持续到 2026 年 11 月 21 日",它在 7 月发布时的标价是 $5/$30。两者真正分开的地方有三处:单次输入超过 272K token 时,GPT-5.6 Sol 整次请求改按 $8/$30 计费,Opus 5.5 在 1M 上下文内始终同价;缓存读取 Opus 5.5 是 $0.20,GPT-5.6 Sol 是 $0.40;在 Artificial Analysis 的独立评测里,Opus 5.5 每个任务输出的 token 约是 GPT-5.6 Sol 的两倍,所以标价一样,账单未必一样。
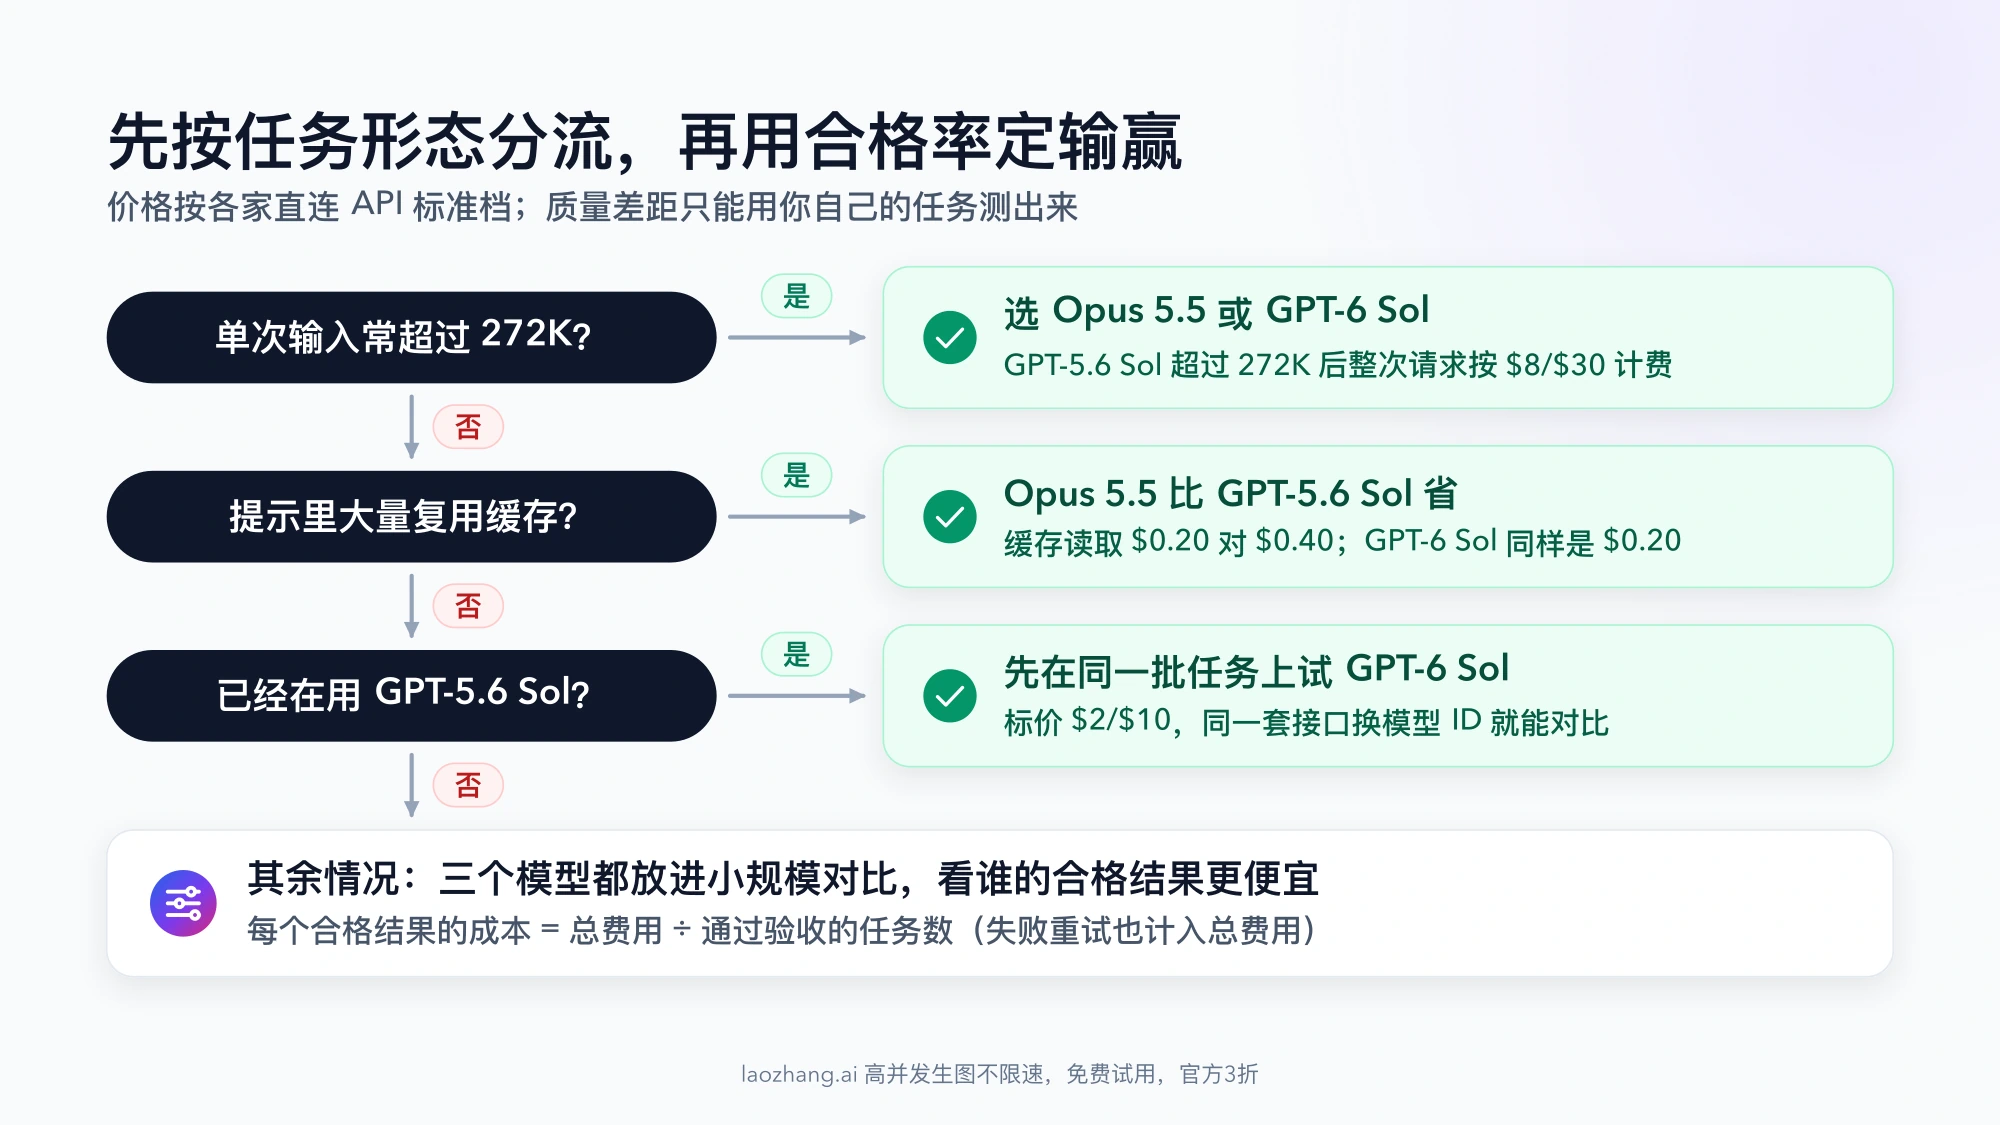
据此可以先这样分流:长文档、大量复用缓存的任务,Opus 5.5 比 GPT-5.6 Sol 便宜;短提示、输出量大的任务,谁便宜取决于各自实际输出多少 token,要用你自己的任务测。另外,OpenAI 在同一天(2026 年 9 月 22 日)发布了 GPT-6 Sol,标价 $2/$10,是两者的一半。如果你现在用的是 GPT-5.6 Sol,先在同一批任务上试 GPT-6 Sol,改动比迁到 Opus 5.5 小;如果你更看重独立评测里的高分和长时间代理编码,再把 Opus 5.5 加进同一轮对比。
先看结论:四类任务各先试谁
下表的金额都按"两家处理的 token 数相同"计算,只用来判断方向;计算过程在后面的账单一节。
| 任务形态 | 账单方向 | 先试 | 会改变结论的条件 |
|---|---|---|---|
| 短提示,不用缓存 | 10 万输入 + 1 万输出:Opus 5.5 与 GPT-5.6 Sol 都是 $0.60,GPT-6 Sol $0.30 | 比质量就两家都试;只看成本先试 GPT-6 Sol | 实际输出 token 数差多少,以及哪家一次就能通过验收 |
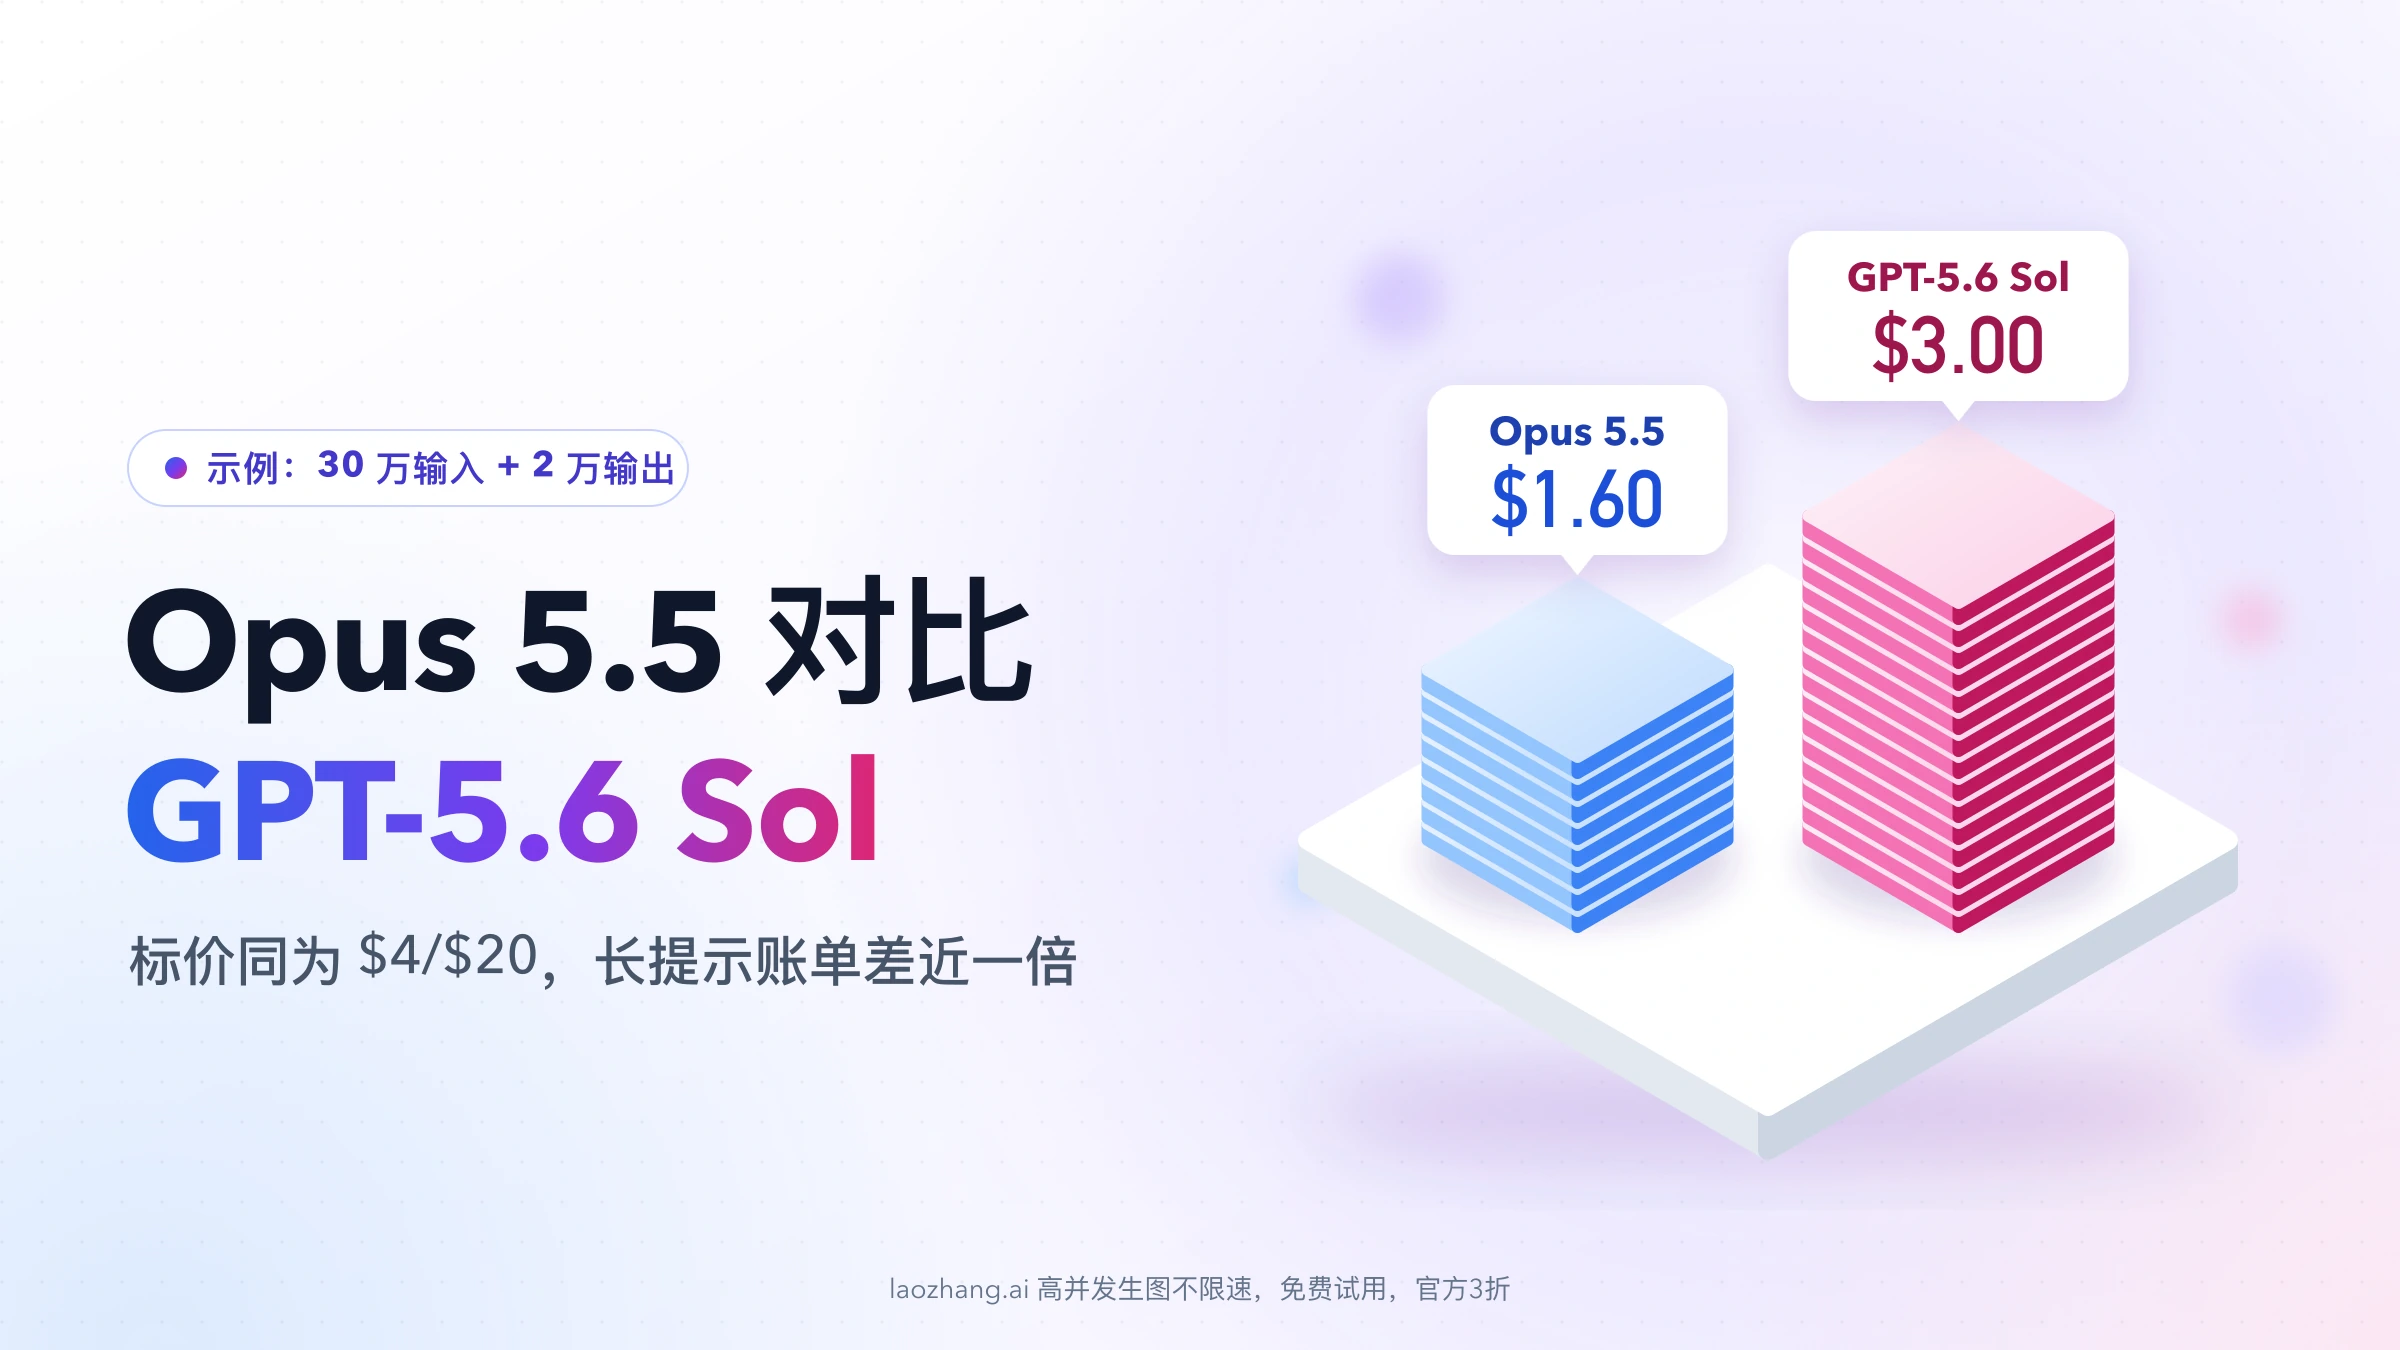
| 单次输入超过 272K token | 30 万输入 + 2 万输出:GPT-5.6 Sol $3.00,Opus 5.5 $1.60,GPT-6 Sol $1.50 | Opus 5.5 或 GPT-6 Sol,不用 GPT-5.6 Sol | 能否把输入切到 272K 以下;两家分词后的真实 token 数 |
| 大量复用缓存 | 20 万缓存读取 + 2 万新输入 + 5 千输出:Opus 5.5 $0.22,GPT-5.6 Sol $0.26,GPT-6 Sol $0.13 | Opus 5.5 比 GPT-5.6 Sol 省;成本最低是 GPT-6 Sol | 缓存命中率和缓存写入次数 |
| 输出多、推理链长 | 同样的标价下,独立评测测到 Opus 5.5(medium)每个任务的输出 token 约为 GPT-5.6 Sol(high)的两倍 | 成本优先选 OpenAI 的两个 Sol;要更高分再加上 Opus 5.5 并控制档位 | 你调低或调高的 effort 档位,以及重试次数 |
已经在用 GPT-5.6 Sol 的团队还有一条:促销价至少维持到 11 月 21 日,而 OpenAI 的模型页目前没有给出 GPT-5.6 Sol 的停用日期,所以不必当天迁移,先用一两周跑完下面的小规模对比再决定。
价格:同样是 $4/$20,差在哪几行
以下都是各自直连 API 的标准档价格,单位是美元 / 每百万 token,不含税、数据驻留加价、工具调用费,也不含云平台或第三方转售的加价。
| 项目 | Claude Opus 5.5 | GPT-5.6 Sol | GPT-6 Sol |
|---|---|---|---|
| 模型 ID | claude-opus-5-5 | gpt-5.6-sol | gpt-6-sol |
| 输入 | $4 | $4(促销价) | $2 |
| 缓存读取 | $0.20 | $0.40 | $0.20 |
| 缓存写入 | $5(5 分钟)/ $8(1 小时) | $5 | $2.50 |
| 输出 | $20 | $20(促销价) | $10 |
| 单次输入超过 272K | 不加价,1M 内同价 | 整次请求按 $8 / $0.80 / $10 / $30 | 整次请求按 $4 / $0.40 / $5 / $15 |
| 上下文 / 最大输出 | 1M / 128K | 1,050,000 / 128,000 | 1,050,000(输入上限 922,000)/ 128,000 |
| Batch | $2 / $10 | 标准价的一半 | 标准价的一半 |
几点说明,都会直接影响你的账单:
- Opus 5.5:Anthropic 的价格页写明 Claude 4.6 及之后的模型在整个 1M 上下文内按标准价计费,90 万 token 的请求与 9 千 token 的请求单价相同。模型 ID、上下文与输出上限见模型规格页。
- GPT-5.6 Sol:模型页和价格页都把 $4/$20 标为促销价,"至少"到 2026 年 11 月 21 日,没有写之后的价格。2026 年 7 月 9 日的发布文章里 Sol 是 $5/$30。促销结束后会不会回到这个价,OpenAI 没有说明,所以下文用 $5/$30 算的只是"按发布价"的情景,不是预测。
- 272K 门槛:OpenAI 写的是"超过 272K",输入正好 272K 仍按短上下文价;一旦超过,整次请求的输入、缓存和输出全部按长上下文价计,而不只是超出的那部分。
- GPT-6 Sol:价格与上限来自它的模型页。它和 GPT-5.6 Sol 只差一个版本号,看别处的报道时注意每个数字对应的是哪一个 Sol。
GPT-6 Sol 自己的 Codex credits 和 Luna 的计费方式,放在GPT-6 Luna 与 Sol 价格对比:API 和 Codex 分别怎么算里;GPT-5.6 家族内 Sol、Terra、Luna 的分工见OpenAI 2026 最新文本模型怎么选:GPT-5.6 Sol、Terra、Luna 对比。
三笔可以自己复算的账单
每次请求的费用按下面的式子算,token 数除以 100 万再乘单价:
费用 = 新输入 token × 输入价 + 缓存读取 token × 缓存读取价 + 缓存写入 token × 缓存写入价 + 输出 token × 输出价
用 OpenAI 的两个 Sol 时,先看这次输入是否超过 272K;超过就把四个单价整体换成长上下文价。下面三笔都假设两家处理的 token 数完全相同,不含工具调用和此前的缓存写入。
| 场景 | Claude Opus 5.5 | GPT-5.6 Sol(促销价) | GPT-6 Sol |
|---|---|---|---|
| A. 10 万新输入 + 1 万输出 | 0.1 × $4 + 0.01 × $20 = $0.60 | 0.1 × $4 + 0.01 × $20 = $0.60 | 0.1 × $2 + 0.01 × $10 = $0.30 |
| B. 30 万新输入 + 2 万输出(超过 272K) | 0.3 × $4 + 0.02 × $20 = $1.60 | 0.3 × $8 + 0.02 × $30 = $3.00 | 0.3 × $4 + 0.02 × $15 = $1.50 |
| C. 20 万缓存读取 + 2 万新输入 + 5 千输出 | 0.2 × $0.20 + 0.02 × $4 + 0.005 × $20 = $0.22 | 0.2 × $0.40 + 0.02 × $4 + 0.005 × $20 = $0.26 | 0.2 × $0.20 + 0.02 × $2 + 0.005 × $10 = $0.13 |
场景 A 如果按 GPT-5.6 Sol 的发布价 $5/$30 算,是 0.1 × $5 + 0.01 × $30 = $0.80,比现在贵三分之一。
从这三笔可以读出两件事。第一,场景 B 是分水岭:只要单次输入越过 272K,GPT-5.6 Sol 的费用接近 Opus 5.5 的两倍,GPT-6 Sol 同样改按长上下文价计费,但起点低,最后与 Opus 5.5 差不多。如果你的长文档可以拆成 272K 以下的几段,这个差距就不存在了。第二,场景 C 里 Opus 5.5 的优势来自缓存读取价只有 GPT-5.6 Sol 的一半,缓存读取在请求里占比越大,差距越明显;Claude 能缓存的提示最短 512 token。
还有一个算不进上表的变量:同一段文字在两家被切成的 token 数并不相同。Anthropic 在价格页里提到,Claude 4.7 之后的新分词器处理同样文字,比它以前的分词器多出约 30% 的 token;但 Claude 与 OpenAI 之间同一文本的 token 比例,没有公开来源给出。所以"单价相同"只说明每个 token 一样贵,一份文档要花多少钱,要看两家响应里 usage 字段记下的真实 token 数。
标价相同,为什么跑同一批任务 Opus 还是更贵
独立评测机构 Artificial Analysis 把 Opus 5.5(medium)与 GPT-5.6 Sol(high)放在同一套测试里,结果是:
| 指标 | Opus 5.5(medium) | GPT-5.6 Sol(high) |
|---|---|---|
| 智能指数 | 51 | 42 |
| 每个任务的输出 token | 约 2.6 万 | 约 1.3 万 |
| 其中推理 token | 约 1.2 万 | 约 6 千 |
| 跑完整套指数的费用 | $1,627 | $1,487 |
| 输出速度 | 78 token/秒 | 69 token/秒 |
| 首个答案 token 的等待时间 | 21.62 秒 | 14.72 秒 |
两家单价相同,Opus 5.5 每个任务的输出却多出约一倍,所以跑完同一套测试,它的总费用高约 9%(1,627 ÷ 1,487 ≈ 1.09)。输出翻倍没有让总费用也翻倍,说明输入等其他部分在总费用里占了不小比重;你的任务里输出费用占比越高,两家的费用差距就越接近输出量的差距。
把两边都调到最高档位后,差距更大:智能指数 58 对 47,跑完整套测试的费用 $8,708 对 $3,465,约 2.5 倍,Opus 5.5 的输出 token 总量是 2.6 亿,GPT-5.6 Sol 是 9 千万。
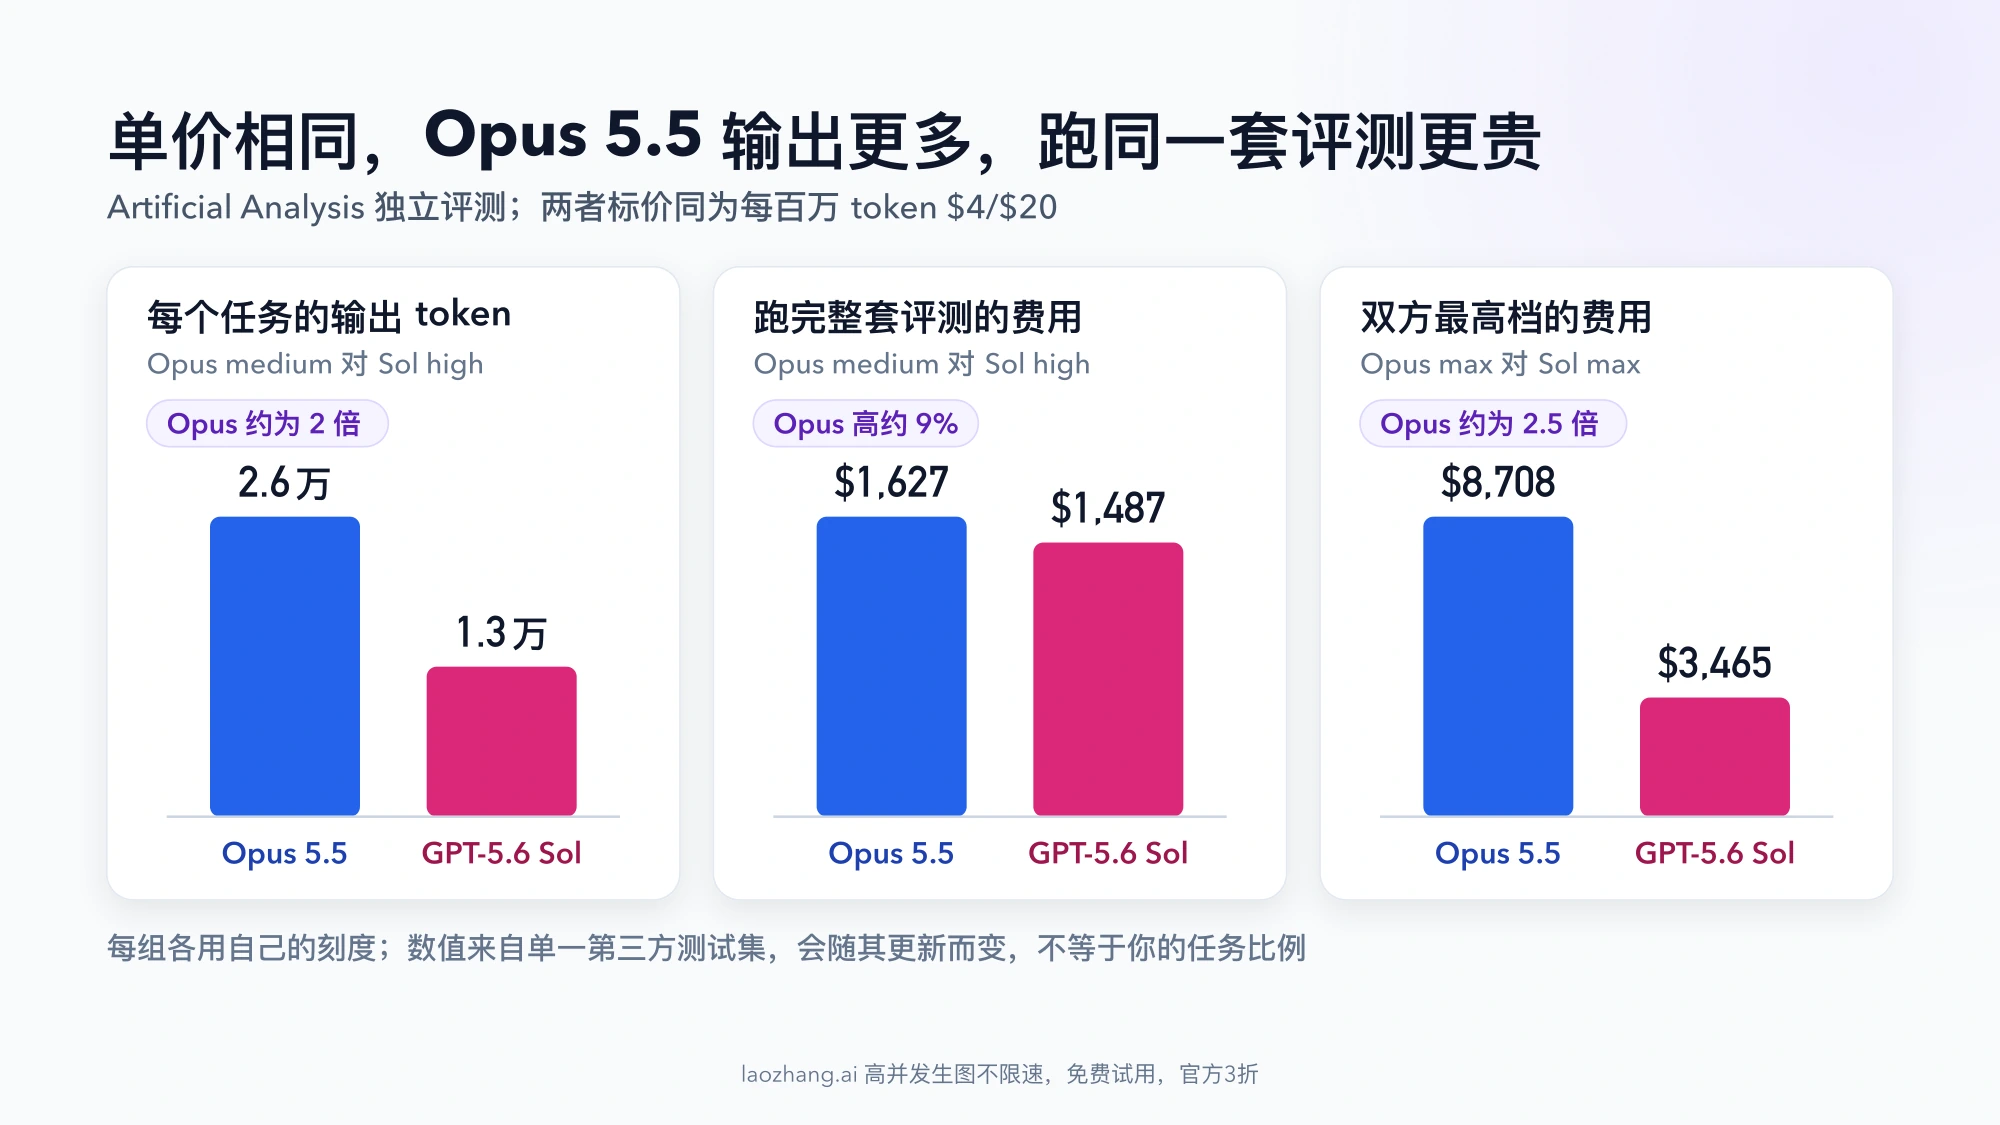
这里的 effort 指推理强度档位,档位越高,模型想得越多、输出 token 也越多。Opus 5.5 的思考始终开启,默认档是 medium;GPT-5.6 Sol 可选 none、low、medium(默认)、high、xhigh、max。上面第一组对比用的是 Opus 的 medium 对 Sol 的 high,两边并不是同名档位。你自己对比时应把档位记下来,Opus 5.5 各档位的成本差异可以看Claude Opus 5.5 的 effort 怎么选?五档设置与任务成本比较。
这些都是 Artificial Analysis 一家的测试集和测试框架,数值会随它的更新而变,也不等于你的任务会得到同样的比例。
基准测试:两家发布表不能逐行对比
Anthropic 在 Opus 5.5 发布页里直接列了 GPT-5.6 Sol 的对照:
| 基准 | Opus 5.5 | GPT-5.6 Sol |
|---|---|---|
| Terminal-Bench 4.0(代理编码) | 66.4%(xhigh 档) | 37.3% |
| FrontierCode v1.1 Main | 54.4% | 47.5% |
| CursorBench 4.0 | 57.8% | 41.7% |
| GDPval-AA v2.1(知识工作) | 1846 | 1588 |
| AutomationBench(业务流程,Zapier 运行) | 40.0% | 28.8% |
这张表里 Opus 5.5 每一行都领先,但它是 Anthropic 挑选的项目和测试框架,GPT-5.6 Sol 各行用的档位也没有写明。
OpenAI 在 GPT-5.6 发布时给 Sol 列的是另一组项目:Terminal-Bench 2.1 为 88.8%,SWE-Bench Pro 64.6%,OSWorld 2.0 62.6%,BrowseComp 90.4%,GDPval-AA v2 为 1,747.8 Elo。两张表几乎没有版本相同的项目:Terminal-Bench 一个是 4.0、一个是 2.1,88.8% 和 37.3% 不能拿来互相印证;GDPval-AA 也分 v2.1 和 v2。两边都出现、又没有标出不同版本的只有 AutomationBench,GPT-5.6 Sol 在 Anthropic 表里(Zapier 运行)是 28.8%,在 OpenAI 自己的表里是 18.1%。同一个模型、同一个基准名给出两个分数,说明测试框架、日期和档位一变,分数就不能跨表比较,但这并不能说明哪一次跑分才"对"。
所以这些分数更适合用来决定"把谁放进对比",而不是直接决定选谁:Opus 5.5 在 Anthropic 的表和 Artificial Analysis 的独立评测里都更高,值得放进你的试验;最终以你自己任务的合格率为准。
GPT-6 Sol 同日发布:GPT-5.6 Sol 用户先考虑它
2026 年 9 月 22 日,Opus 5.5 发布当天,OpenAI 也上线了 GPT-6 Sol。它的标准价是输入 $2、缓存读取 $0.20、缓存写入 $2.50、输出 $10,超过 272K 时整次请求按 $4/$0.40/$5/$15 计,每一项都正好是 GPT-5.6 Sol 促销价的一半。OpenAI 的更新日志也说,GPT-6 Sol 和 Luna 以低于 GPT-5.6 前代的 token 价格进入 Codex 和 ChatGPT Work。
对正在用 GPT-5.6 Sol 的团队,这比"要不要换 Claude"更先要回答:两者都支持 Chat Completions、Responses 和 Batch 接口,换模型 ID 就能在同一批任务上对比;上下文同为 1,050,000 token,但 GPT-6 Sol 另外标了 922,000 的输入上限,接近满上下文的请求要留意。两代 Sol 在你的任务上谁更好,价格表回答不了,也不要从标价更低去推断质量,只能用同一批任务测出来。
单个任务的结果也可能和标价给人的印象不同。DataCamp 用一个单文件俄罗斯方块任务(带重力翻转)对比了 GPT-6 Sol 与 Opus 5.5:GPT-6 Sol 用了 6 轮、9 次工具调用,花费 $0.26,评分 5.0;Opus 5.5 用了 3 轮、2 次工具调用,花费 $0.87,评分 4.3。这只是一个任务跑一次,不能当结论,但它说明了一点:单价、轮数和最终质量之间没有固定关系,所以要按"每个合格结果花了多少钱"来比。
用自己的任务做一次小规模对比
下面的步骤不需要搭评测平台,一个脚本加一张表格就能完成:
- 挑任务:从真实工作里抽 20 到 30 个任务,覆盖你最常见的几种提示长度;如果有超过 272K 的长文档任务,单独列一组。每个任务先写好验收标准,比如测试全部通过、字段抽取完全正确、人工评分达到 4 分。
- 定档位:先用各自默认档(Opus 5.5、GPT-5.6 Sol、GPT-6 Sol 都是 medium)跑一遍,再视结果加档,每次记下档位。
- 记用量:每次调用从响应的 usage 里记下新输入、缓存读取、缓存写入和输出 token 数,OpenAI 的请求另外标出输入是否超过 272K。
- 算成本:按上一节的公式算每次费用,失败后的重试也要计入。
- 比结果:每个合格结果的成本 = 该模型的总费用 ÷ 通过验收的任务数。同时看平均等待时间,Artificial Analysis 测到的首个答案 token 时间 Opus 5.5 比 GPT-5.6 Sol 长约 7 秒,对交互式场景有影响。
- 做决定:GPT-6 Sol 的合格率与 GPT-5.6 Sol 相当,就换 GPT-6 Sol;Opus 5.5 的合格率明显更高,且每个合格结果的成本你能接受,就把对应任务切到 Opus 5.5;长文档任务单独看场景 B 的结果。
正式切换前,还要在自己的账号里确认速率限制和所在地区能否调用,这两项因账号而异。原来用 Opus 5 的代码不能只改模型 ID:Opus 5.5 不能关闭思考,强制指定工具会直接报错,具体检查项见Claude Opus 5.5 已发布:API 价格、能力与从 Opus 5 迁移的检查项。如果你还在 Claude 家族内部比较 Opus 与更便宜的型号,可以看Opus 5.5 和 Fable 5.1 怎么选?Claude 四档模型的价格与能力边界。
常见问题
GPT-5.6 Sol 促销结束后会回到 $5/$30 吗?
不知道。OpenAI 只写了促销价"至少"持续到 2026 年 11 月 21 日,没有给出之后的价格。$5/$30 是它 7 月发布时的标价,可以用来算一个"按发布价"的情景(场景 A 从 $0.60 变成 $0.80),但不要当成确定的涨价。
输入正好 272K token 会按长上下文计费吗?
不会。OpenAI 的条件是"超过 272K",正好 272K 仍按短上下文价。超过之后是整次请求重新计价,不是只对超出部分加价。缓存命中的 token 是否计入这个门槛,模型页没有单独写明,最稳妥的办法是用真实请求的 usage 和账单核对一次。
长文档分析该用哪个?
单次输入经常超过 272K 时,不要用 GPT-5.6 Sol:按场景 B,它的费用约为 Opus 5.5 的两倍。Opus 5.5 与 GPT-6 Sol 在这类请求上费用接近($1.60 对 $1.50),再由两者在你文档上的准确率决定。
Opus 5.5 值得在同样的单价下多付那部分输出费用吗?
取决于它能不能减少返工。Artificial Analysis 的独立评测里 Opus 5.5 分数更高,但输出也更多,跑同一套测试贵约 9%;如果它让你的任务一次通过的比例明显提高,每个合格结果的成本反而可能更低。这个判断只能来自你自己的合格率数据。