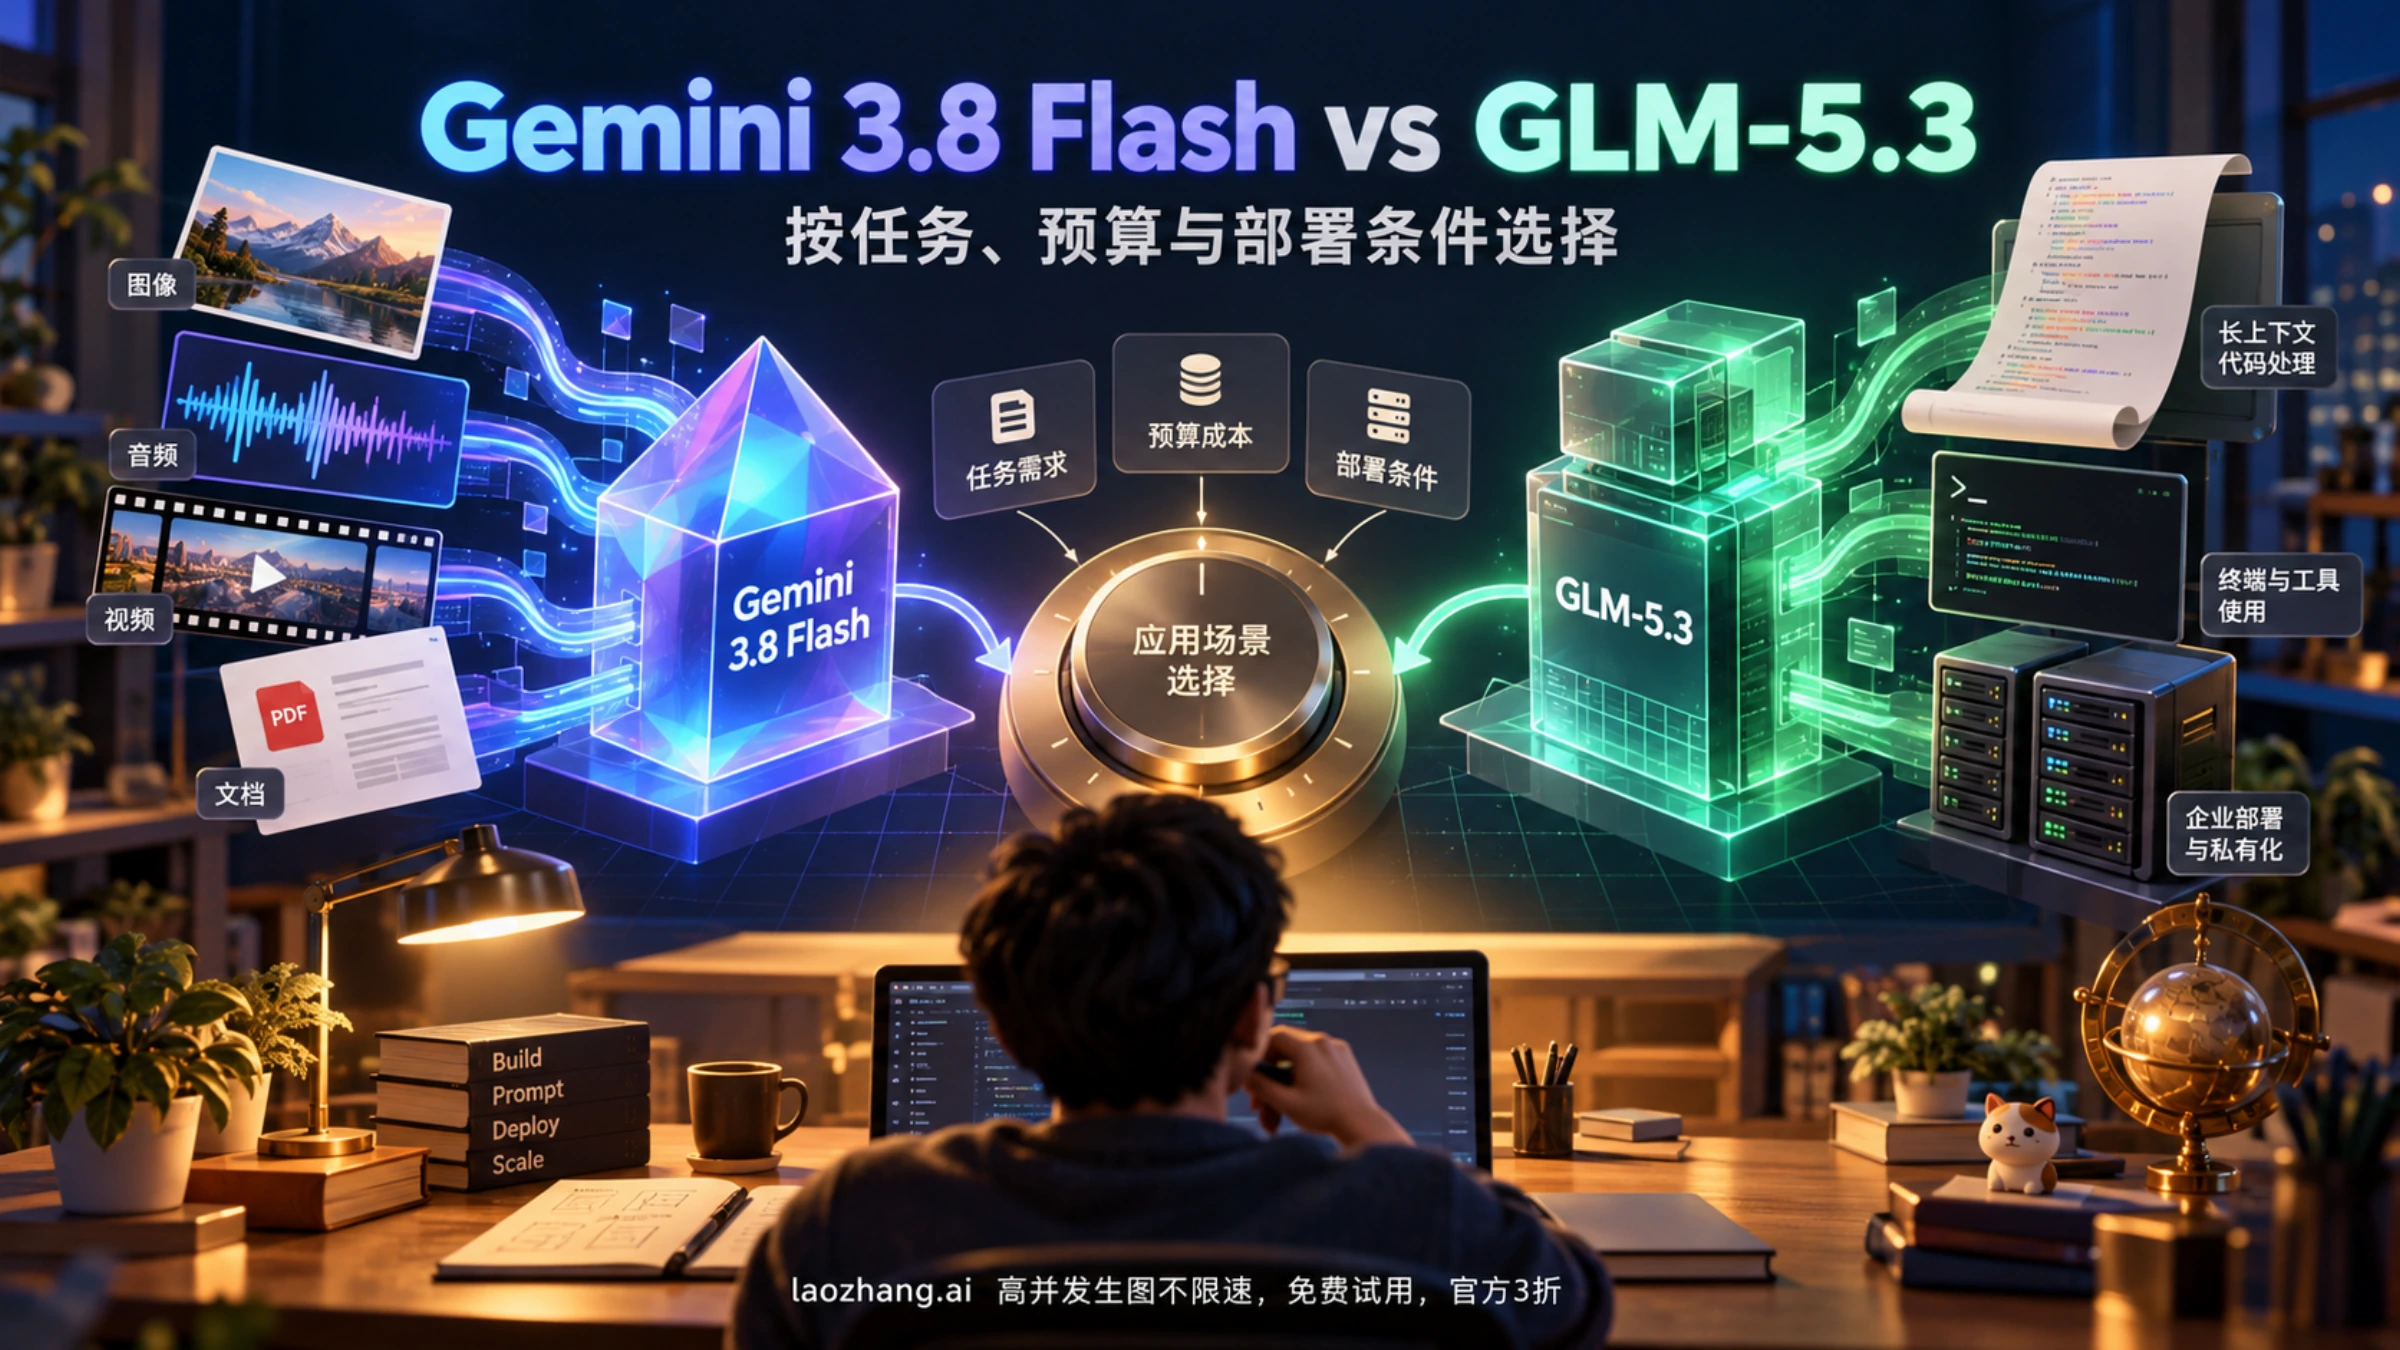
需要直接读图、音频、视频或 PDF,先考虑 Gemini 3.8 Flash;需要开放权重、自行部署,或一次生成超过 65,536 tokens 的长文本,优先评估 GLM-5.3。两者的能力边界比一张综合排行榜更能决定能否接入你的工作流。Gemini 官方规格与 GLM-5.3 官方文档分别给出了这些限制,GLM 的部署选项另见官方模型卡。
如果任务是纯文本编程或长程执行,两者都值得进入候选。外部测试给了 GLM-5.3 一些优先试用的理由,但不足以保证它在你的项目里更省钱或更快。截至 2026 年 10 月 28 日,Gemini 的官方标准 API 单价较低;Google 已公告从 2027 年 1 月 1 日起调价。长期预算应同时看这两个时段。Google 价格表、Z.AI 价格表
本文比较的是 gemini-3.8-flash 与旗舰 glm-5.3,后者不是 glm-5.3-flash。价格按两家官方美元按量 API 口径整理;没有进行本站 API 性能实测。
先按输入、输出和部署条件筛选
| 你要确认的条件 | Gemini 3.8 Flash | GLM-5.3 |
|---|---|---|
| 输入内容 | 文本、图片、视频、音频、PDF | 文本 |
| 输出内容 | 文本 | 文本 |
| 长输入容量 | 输入上限 1,048,576 tokens | 上下文窗口 1M tokens |
| 最大输出 | 65,536 tokens | 128K tokens |
| 推理档位 | low、medium、high,默认 medium | low、high、max,默认 max |
| 工具与结构化结果 | 函数调用、结构化输出、缓存等 | 函数调用、结构化输出、缓存等 |
| 自部署依据 | 本文采用 Google 托管 API 路线 | 官方提供开放权重与部署说明 |
规格来源:Gemini 模型页、Gemini 推理说明、GLM-5.3 模型页、GLM-5.3 模型卡。Google 标的是输入上限,Z.AI 标的是上下文窗口,不能仅凭“约 1M”就认为两者可容纳的请求完全相同。GLM 的 1M、128K 沿用官方写法,不擅自换算成精确整数。
以客服工单为例:如果输入包含截图、录音或附件 PDF,Gemini 可以直接接收这些内容;若选择 GLM-5.3,就要先把相关信息转换成文本,并评估转换后的信息损失和额外费用。这里的优势是少一道输入处理环节,并不等于已经证明 Gemini 对每种附件都理解得更准确。
若输入本来就是代码、日志和文字需求,多模态差异的重要性便会下降。此时应关注任务能否完成、工具调用是否稳定、长回答是否容易中断。GLM 更大的输出上限能容纳更长的单次回答,但不能单凭这个上限判断代码质量。
两者的默认推理档也不相同。把同一个提示词直接交给默认配置,实际上是在比较 Gemini 的 medium 与 GLM 的 max。GLM-5.3 必须启用推理,沿用关闭推理的配置会失败;Gemini 3.8 Flash 则不接受 minimal。接入前先核对这些参数,才能避免把配置错误当成模型能力问题。Gemini 参数说明、GLM 参数说明
当前 Gemini 单价更低,2027 年要重新算预算
下面统一比较官方 Standard/标准按量 API,单位均为美元/百万 tokens。普通输入指未命中缓存的输入;Google 的输出价格包含推理 tokens。
| 费用项目 | Gemini:截至 2026-12-31 | Gemini:公告自 2027-01-01 起 | GLM-5.3:2026-10-28 标价 |
|---|---|---|---|
| 普通输入 | $0.75 | $1.50 | $1.40 |
| 缓存命中输入 | $0.075 | $0.15 | $0.26 |
| 输出 | $3.75 | $7.50 | $4.40 |
| 缓存存储,每百万 tokens 每小时 | $0.50 | $1.00 | 暂时免费,未注明结束日期 |
来源:Google Gemini API 定价、Z.AI 模型 API 定价。未来一列是 Google 已公布的价格安排,不是当前扣费。表中不含工具调用、税费,也不代表第三方平台报价、人民币渠道价格或订阅套餐。
同样输入 1 万、输出 2 千 tokens,要花多少钱?
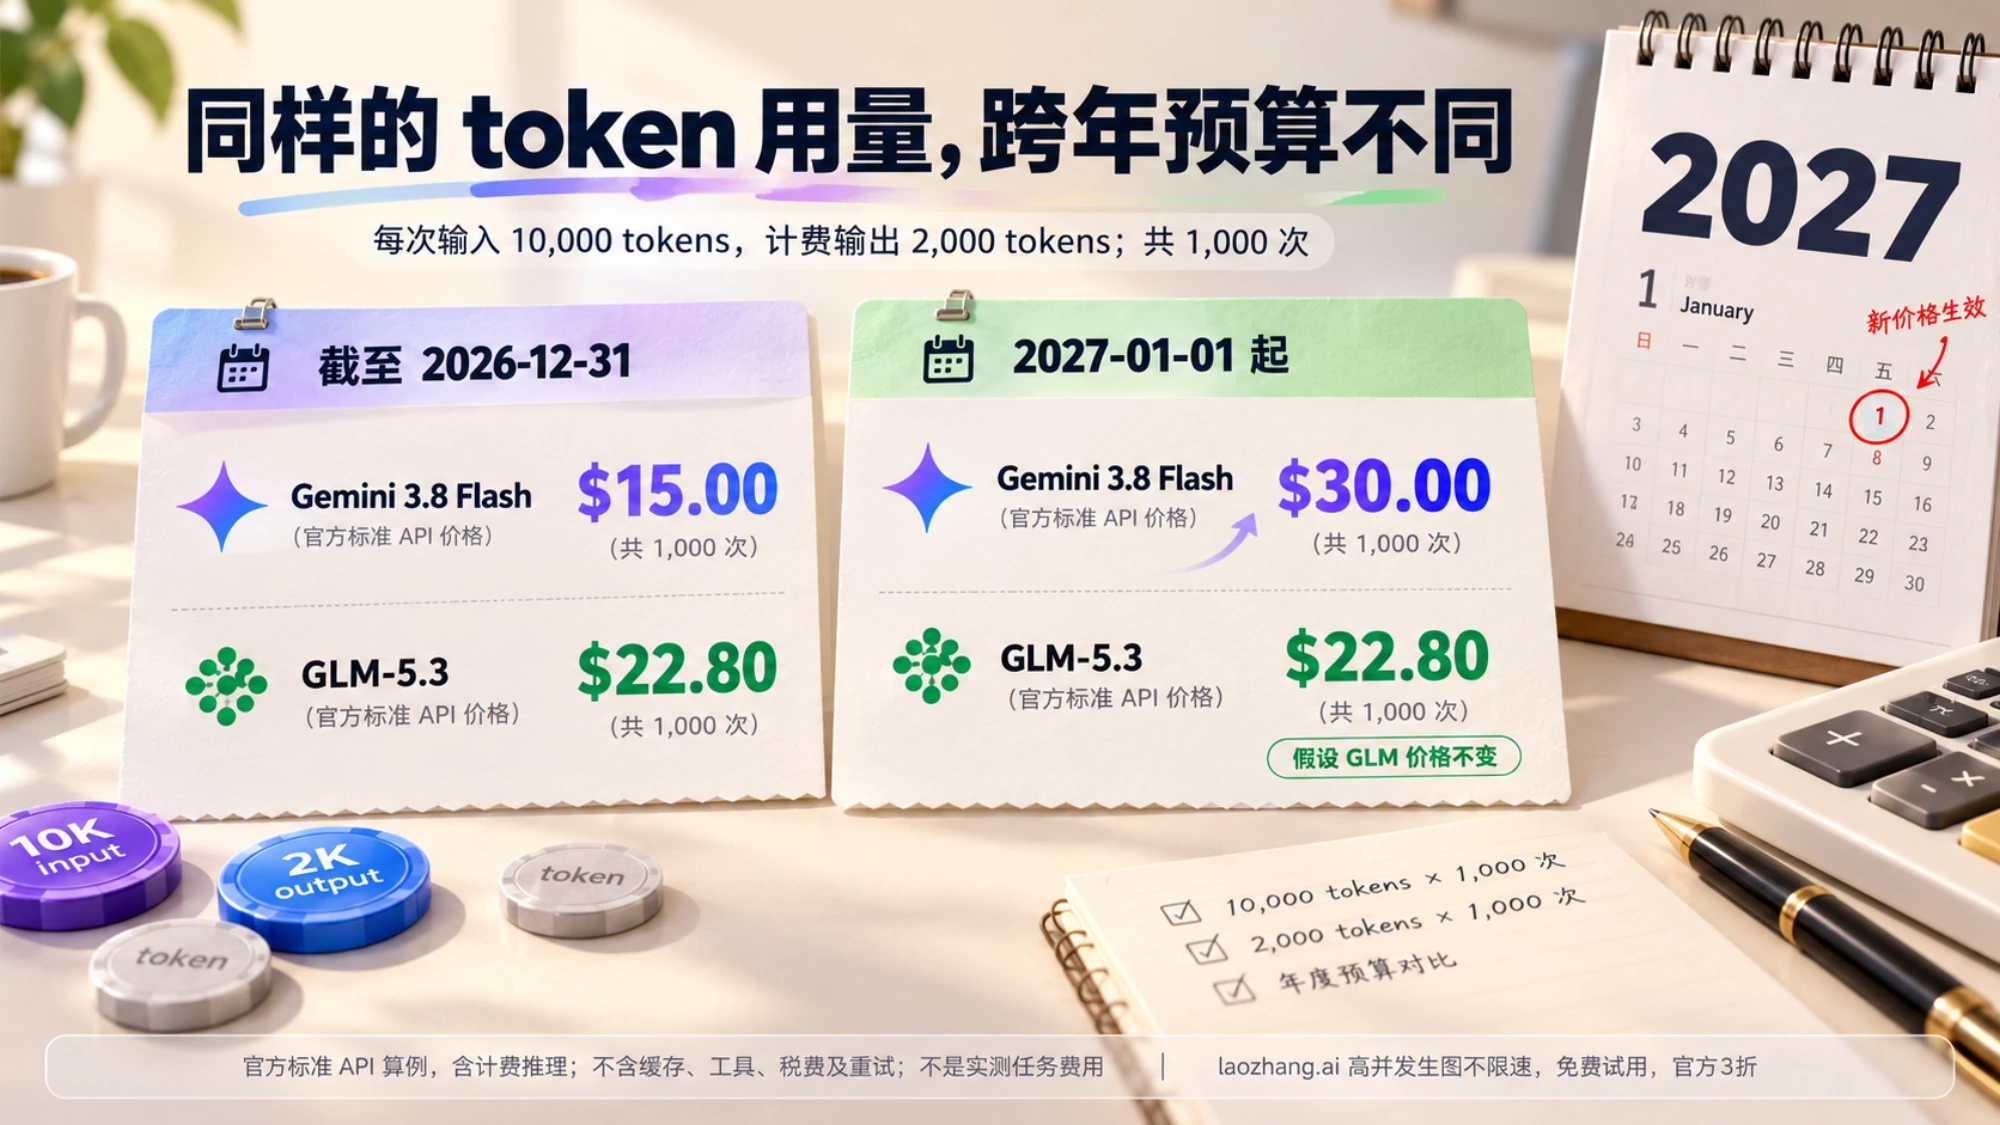
假设每次请求有 10,000 个未缓存输入 tokens、2,000 个计费输出 tokens,输出数量已包含适用的推理消耗,两边计费数量完全相同。公式为:
费用 = 输入 tokens ÷ 1,000,000 × 输入单价 + 计费输出 tokens ÷ 1,000,000 × 输出单价
| 相同 token 数量的算例 | 一次请求 | 1,000 次请求 |
|---|---|---|
| Gemini,2026 年当前价格 | $0.015 | $15.00 |
| GLM-5.3,当前价格 | $0.0228 | $22.80 |
| Gemini,2027 年公告价格 | $0.030 | $30.00 |
这是基于上方Google与 Z.AI费率的算术示例,不是同一真实任务的运行账单。工具、缓存、存储、重试和失败请求均未计入。
这个算例说明了两件事:当前按相同计费量调用,Gemini 更便宜;如果 GLM 价格保持不变,Google 的公告价格生效后,普通输入和输出单价都会高于 GLM,算例也会变成 GLM 更便宜。GLM 是否届时调价仍未知,不能把今天的报价当成明年的承诺。
缓存业务要单独计算。Gemini 公告调价后的缓存命中单价仍低于 GLM 当前价,但还要加上存储时长;GLM 的存储暂时免费,也没有已读的截止日期。长时间保存大段上下文的应用,不能只比较“缓存输入每百万多少钱”。
真正采购时,建议记录“完成一项可用任务的总费用”:包含各轮输入、推理、输出、工具及返工。某个模型单价更低,却为了完成任务多走几轮,最终账单未必更低。
编程和长程任务:GLM 有测试优势,仍要看具体工作
在 2026 年 10 月 28 日读取的 Artificial Analysis 精确对比页中,比较对象是 Gemini 3.8 Flash(High)与 GLM-5.3(Max),页面所列 Intelligence Index 版本为 v4.3.2:
| 外部测试指标 | Gemini 3.8 Flash(High) | GLM-5.3(Max) |
|---|---|---|
| Intelligence Index v4.3.2 | 41 | 45 |
| Terminal-Bench 4.0 | 20% | 42% |
这份快照支持一个有限判断:在所列推理档位和测试范围内,GLM-5.3 的综合分与终端任务成绩更高,可以作为优先评估它处理纯文本编程、工具执行任务的依据。42% 对 20% 不是你的项目成功率,也不代表 GLM 在所有编程任务上都领先。
还需注意,该机构的方法页已更新至 v5.0,测试组成和权重有变化。因此,上表应当作为注明版本的历史快照阅读,不能冠以“最新排名”,也不能与 v5.0 分数直接拼在一起比较。综合指数主要覆盖文本与英语任务,不是中文写作、视觉理解或你所在行业的专门测评。
对于长程任务,更有用的验证方式是拿同一组真实需求,让两个模型使用相同的工具权限和验收条件,分别记录:是否完成、是否引入错误、需要人工接手多少次、总耗时以及总计费量。推理档位应明确记录;名称相近的档位并不保证计算预算相同。
如果你的主要工作是修改仓库、运行终端、持续执行多轮任务,可先让 GLM-5.3 跑代表性样本;如果任务还要读取界面截图、音频或文档附件,Gemini 的输入能力可能比这张文本测试表更有决定性。这是根据能力与外部测试作出的试用顺序建议,不是本站实测结论。
“先返回 token”与“先看到答案”是两回事
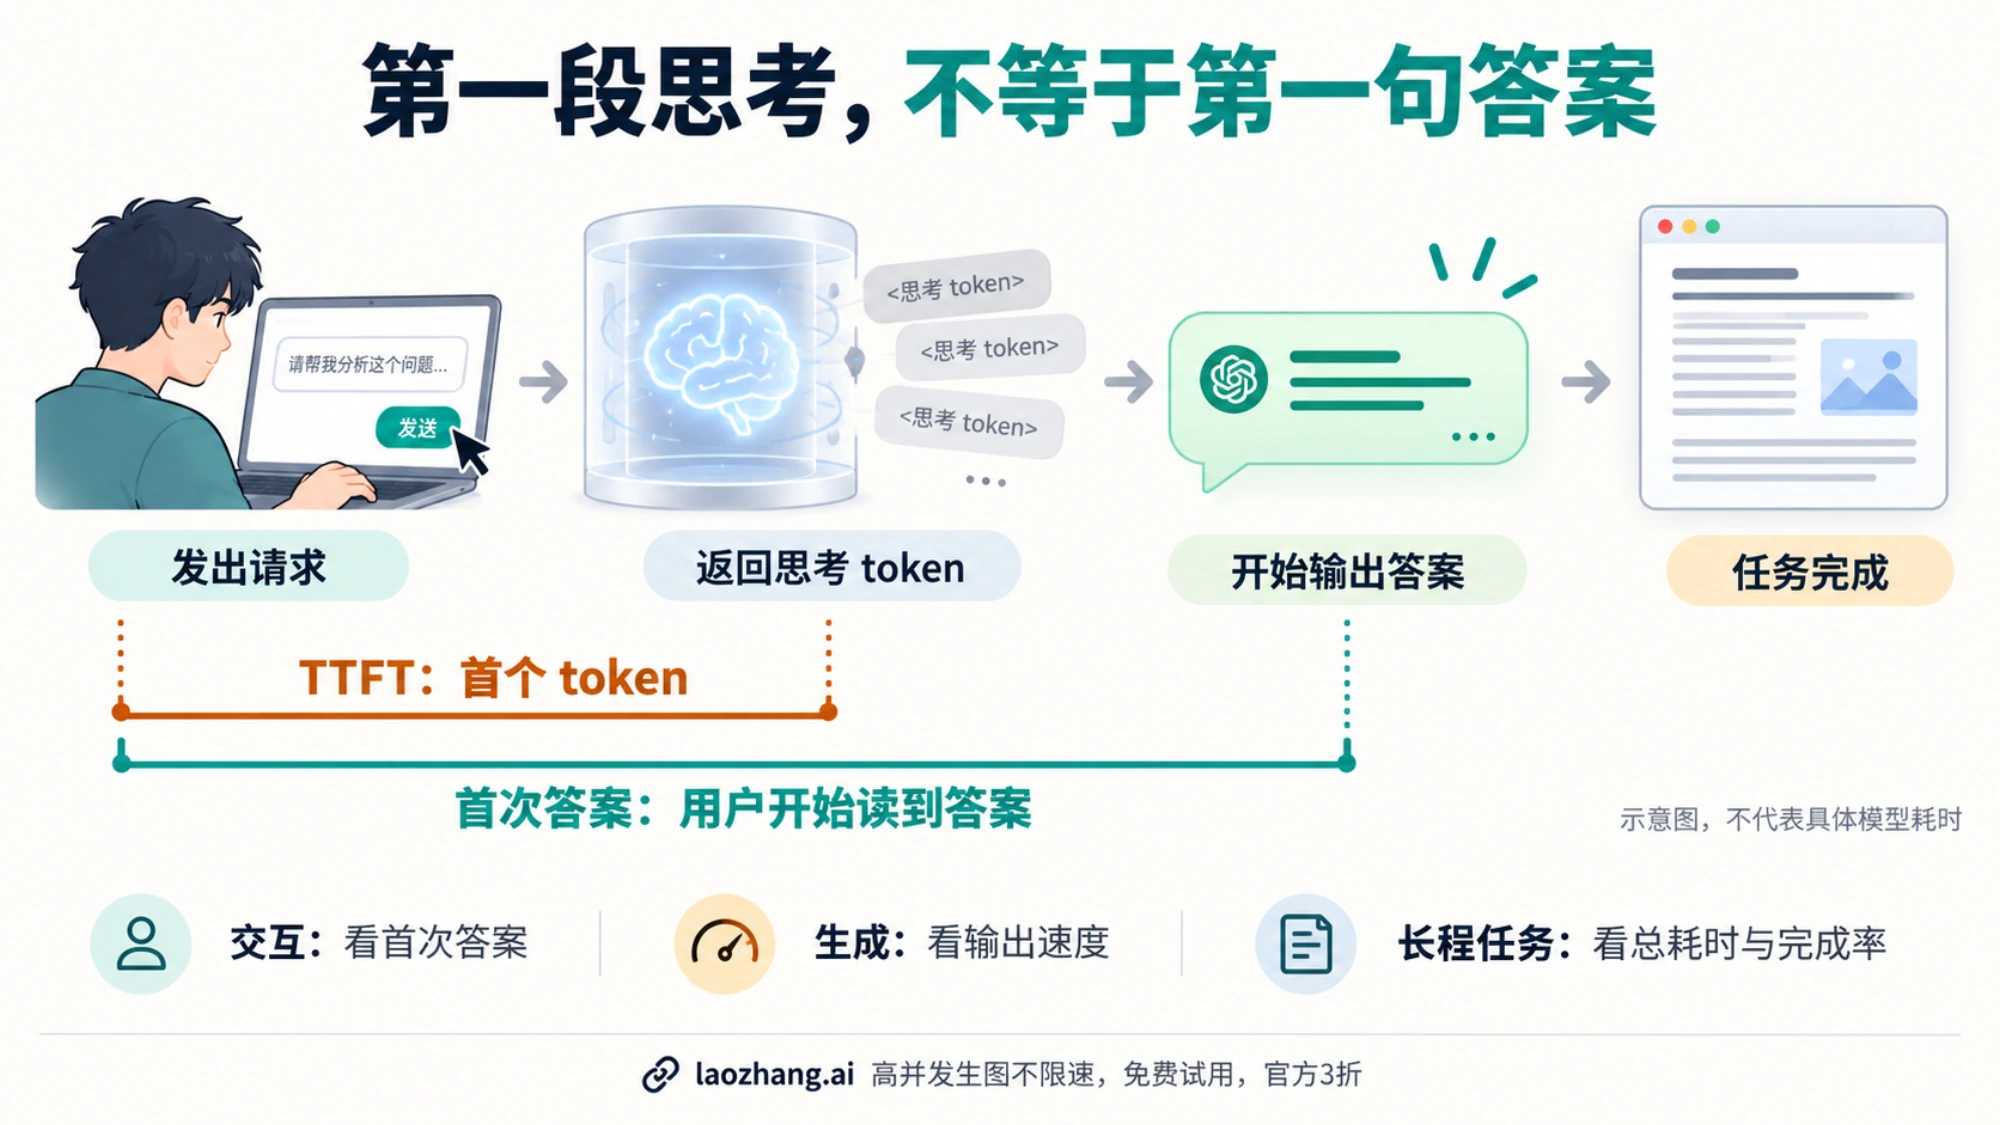
同一份 Artificial Analysis 快照还显示了一个容易误读的现象:GLM 更早返回首个 token,但 Gemini 的首次答案时间略短。
| 速度指标,同一页面快照 | Gemini 3.8 Flash(High) | GLM-5.3(Max) |
|---|---|---|
| 输出速率 | 131 tokens/秒 | 81 tokens/秒 |
| 首 token 等待时间(TTFT) | 25.27 秒 | 2.74 秒 |
| 首个答案 token 等待时间 | 25.27 秒 | 27.47 秒 |
原因在于 TTFT 可能把先返回的思考内容算进去,而首个答案 token 才对应用户开始看到答案的时刻。按照该机构的性能方法,输出速率描述的是开始生成后的速度,也不能替代整项任务耗时。
因此,聊天界面应关注首个答案出现的时间和后续生成速度;后台长程执行应关注完成任务的总时间及失败重试。不要用 2.74 秒的 TTFT 宣称 GLM 能在约三秒内给出完整答案,也不要用 131 tokens/秒保证 Gemini 在每个网络环境都更快。上述数字会随工作负载、服务端和网络变化,测试采用的统一 token 口径也不是 API 的原生计费数量。
想自部署,GLM-5.3 有权重,但资源门槛不低
GLM-5.3 的官方权重仓库提供本地部署路径,采用自定义 GLM-5.3 License,并非 MIT 或 Apache 2.0。部署和商用前应阅读具体条款,不能把“开放权重”理解为没有许可条件。
官方模型卡链接的 vLLM 部署配方列出 8 张 H200 或 H20 的单节点 FP8 示例;完整 1M 上下文的示例采用 8 张 B200,并考虑 KV 缓存。它们是部署示例,不是本文实测的最低配置,量化方式、上下文长度和并发都会改变资源需求。
这意味着:如果你的目标是控制模型运行环境,GLM 值得进入基础设施评估;如果只是希望降低少量 API 调用的费用,不能因为权重可下载就推断自部署更便宜。还要计入硬件、运维、容量闲置与服务稳定性的成本。
确定候选后,怎样避免选型失误
先用硬条件淘汰不合适的路线,再用真实任务验证性能与费用:
- 确认输入。有原始图片、音频、视频或 PDF 时,先评估 Gemini;若准备用 GLM,明确文本转换由谁完成、会丢失什么。
- 固定调用条件。写下精确模型 ID、提供方、推理档位、工具权限和最大输出设置,不混入 GLM-5.3-Flash 或其他 Gemini 变体。
- 按验收结果记账。以代码能否运行、问题是否解决、结果能否使用为标准,记录全部调用费用及人工返工,而非只比较一次回答的长度。
- 确认账户和长期成本。在实际账户核对可用入口、地区资格、额度与付款方式;预算跨入 2027 年时重新检查两家价格。本文没有验证各地区账号的实际可调用性。
选定 Gemini 后,可继续阅读Gemini 3.8 Flash API 指南:型号、价格、规格与迁移。选定 GLM 后,先核对模型文档中的账户和协议限制:Coding Plan 与按量模型 API 不是同一套费用,入口也不能仅凭“兼容 OpenAI”就认定适用于所有账户。
常见问题
GLM-5.3 和 GLM-5.3-Flash 可以当成同一个模型吗?
不能。本文使用旗舰 glm-5.3 的能力、价格和外部测试。glm-5.3-flash 是另一个型号,不能把它的报价或体验直接用于判断旗舰模型。GLM-5.3 官方文档
Gemini 3.8 Flash 能直接生成图片或音频吗?
本文所指的 gemini-3.8-flash 接受多模态输入,但输出为文本,不支持图像生成、音频生成或 Live API。识别图片、理解音频与生成这些内容是不同能力,不能由“多模态”三个字互相推导。Gemini 3.8 Flash 官方规格
订阅了 Coding Plan,还能直接按这里的 token 单价计算套餐额度吗?
不能。表中 GLM 价格是 Z.AI 按量模型 API 的单价,Coding Plan 是另一种产品收费方式;月费除以 token 单价得不到确定的套餐额度。比较已有订阅是否划算,应看对应套餐当前规则与实际使用,而不是套用本文的按量算例。Z.AI 定价说明