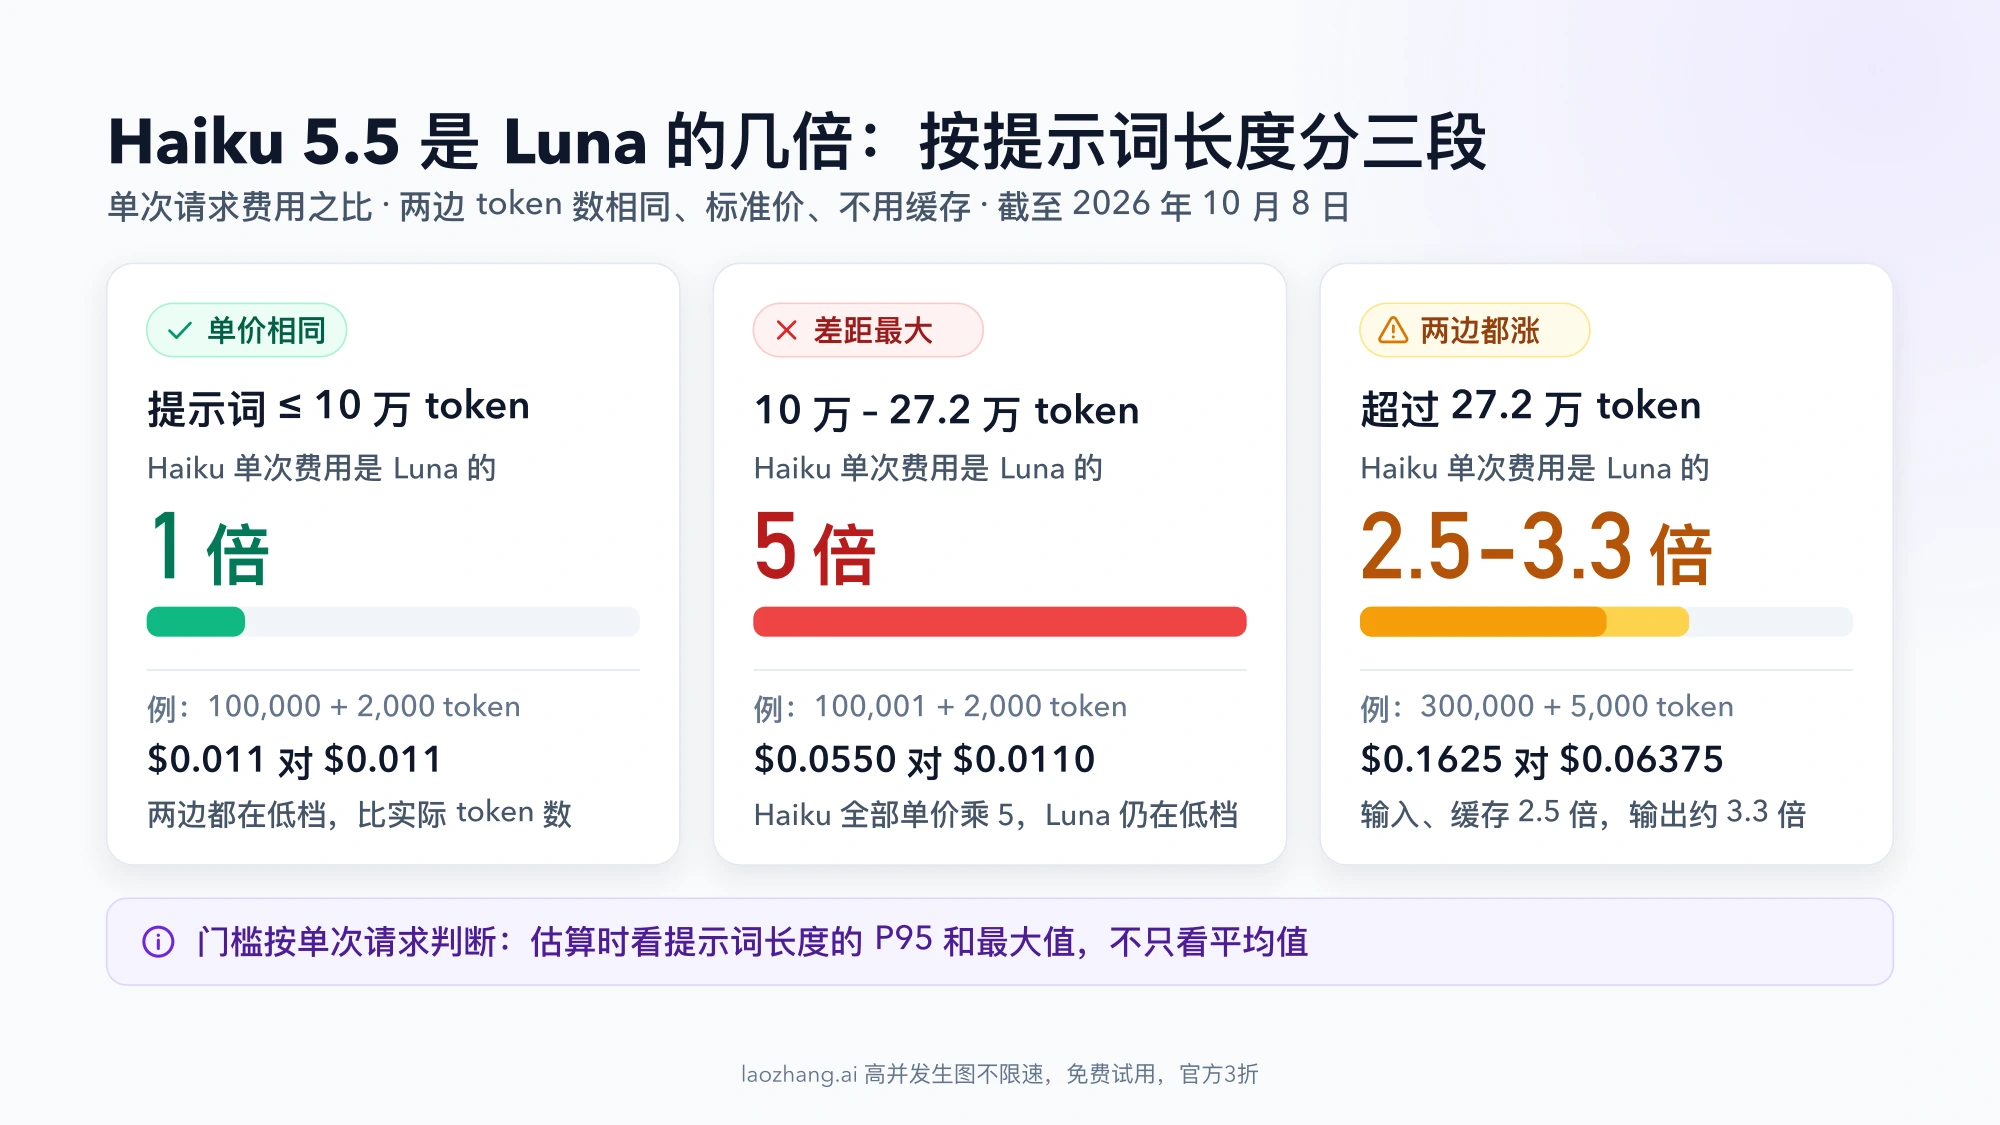
截至 2026 年 10 月 8 日,Claude Haiku 5.5(claude-haiku-5-5)和 GPT-6 Luna(gpt-6-luna)的官方标价确实一样:每百万 token 输入 $0.10、缓存命中 $0.01、输出 $0.50。但这个"一样"只持续到 Haiku 的提示词达到 10 万 token。从第 100,001 个 token 开始,Haiku 这一次请求的输入、缓存和输出全部按 5 倍计价;Luna 要到输入超过 27.2 万 token 才涨,而且只涨到 1.5 到 2 倍。
按请求大小,价格结论分三段:
- 提示词不超过 10 万 token:token 数相同,两边账单完全相同。差别只来自各自实际用掉多少 token。
- 10 万到 27.2 万之间:同样大小的请求,Haiku 正好是 Luna 的 5 倍。
- 超过 27.2 万:两边都在高档,Haiku 是 Luna 的 2.5 到 3.3 倍。
单价相同也不等于每个任务花一样多。Artificial Analysis 在 Haiku 5.5 发布次日的评测里,两个模型都用 medium 档时,Haiku 每个任务约产出 33k 输出 token,Luna 约 11k,每任务成本 $0.05 对 $0.02;不过 Haiku 同档的综合分也更高(34 对 30),把分数拉到相近再比,差距缩小到 1 到 1.7 倍。
可以这样起步:分类、抽取、路由这类提示词远低于 10 万的短请求,价格分不出胜负,拿真实样本比质量和每条请求的输出 token;单次输入经常越过 10 万的长文档任务,以及上下文一路变长的多轮 Agent,默认先用 Luna,除非你能把 Haiku 的每次请求压在 10 万以内。另外,两家官方 API 的支持地区都不包括中国大陆和香港,具体见后文。
Haiku 5.5 和 GPT-6 Luna 的标价:10 万 token 以内完全相同
下表是两家官方定价页上的标准价,单位为美元 / 百万 token,截至 2026 年 10 月 8 日(Anthropic 定价页、OpenAI 定价页)。
| 计费项 | Haiku 5.5 提示词 ≤ 100,000 | Haiku 5.5 提示词 > 100,000 | Luna 输入 ≤ 272K | Luna 输入 > 272K |
|---|---|---|---|---|
| 输入 | $0.10 | $0.50 | $0.10 | $0.20 |
| 缓存写入(Haiku 为 5 分钟缓存) | $0.125 | $0.625 | $0.125 | $0.25 |
| 1 小时缓存写入 | $0.20 | $1.00 | 无此项 | 无此项 |
| 缓存命中 | $0.01 | $0.05 | $0.01 | $0.02 |
| 输出 | $0.50 | $2.50 | $0.50 | $0.75 |
| Batch | 上述价格的一半 | 上述价格的一半 | 一半(Flex 同价) | 一半(Flex 同价) |
几处容易看错的细节:
- 两家的门槛口径不同。 Anthropic 写的是"提示词长度超过 100,000 token 的请求付更高的价格",正好 100,000 仍算低档;系统提示词、对话消息、工具结果、图片、文档和工具定义都算进提示词。OpenAI 写的是输入 token 超过 272K 时,整次请求的输入和缓存按 2 倍、输出按 1.5 倍计价。Luna 这条规则和 GPT-6 Sol 一样,两者的对比见《GPT-6 Luna 与 Sol 价格对比:API 和 Codex 分别怎么算》。
- Haiku 的高档也管输出。 定价表按提示词长度给输出单独列了 $2.50 一行,所以长提示词那一次请求的输出也是 5 倍价。
- 缓存 token 算不算进门槛,两家都没写。 Anthropic 的上下文窗口文档说缓存读取、缓存写入和普通输入都计入上下文窗口,但定价页、缓存文档都没说它们是否计入 100,000 的计价门槛;OpenAI 对 272K 也没有说明。下文的算例都按"计入"处理,做预算时这样更稳妥。
- 其他加价和不支持的选项。 Haiku 5.5 用
inference_geo: "us"指定仅在美国推理时,所有计费项乘 1.1;它不支持 Priority Tier,也没有 fast mode。Luna 的 Fast 档是标准价的 2 倍。
规格上两者也很接近:Haiku 5.5 上下文 1M、最大输出 128K,默认 effort 为 medium(Haiku 5.5 概览);Luna 上下文 1,050,000、最大输入 922,000、最大输出 128,000,默认 reasoning effort 也是 medium。所以选择通常不卡在规格上,而是卡在请求有多长、每次输出多少。
按请求大小算账:提示词过 10 万后 Haiku 是 Luna 的 5 倍
单次请求的费用这样算,两边公式相同,只是单价按各自的档位取:
单次费用 = (未缓存输入 × 输入单价 + 缓存写入 × 写入单价
           + 缓存命中 × 命中单价 + 输出 × 输出单价) ÷ 1,000,000
下面假设两边 token 数相同、不用缓存和工具、按标准价:
| 每次请求(输入 + 输出 token) | Haiku 5.5 | GPT-6 Luna | Haiku ÷ Luna |
|---|---|---|---|
| 2,000 + 200(短分类) | $0.0003 | $0.0003 | 1 倍 |
| 20,000 + 1,000 | $0.0025 | $0.0025 | 1 倍 |
| 100,000 + 2,000 | $0.011 | $0.011 | 1 倍 |
| 100,001 + 2,000 | $0.0550 | $0.0110 | 5 倍 |
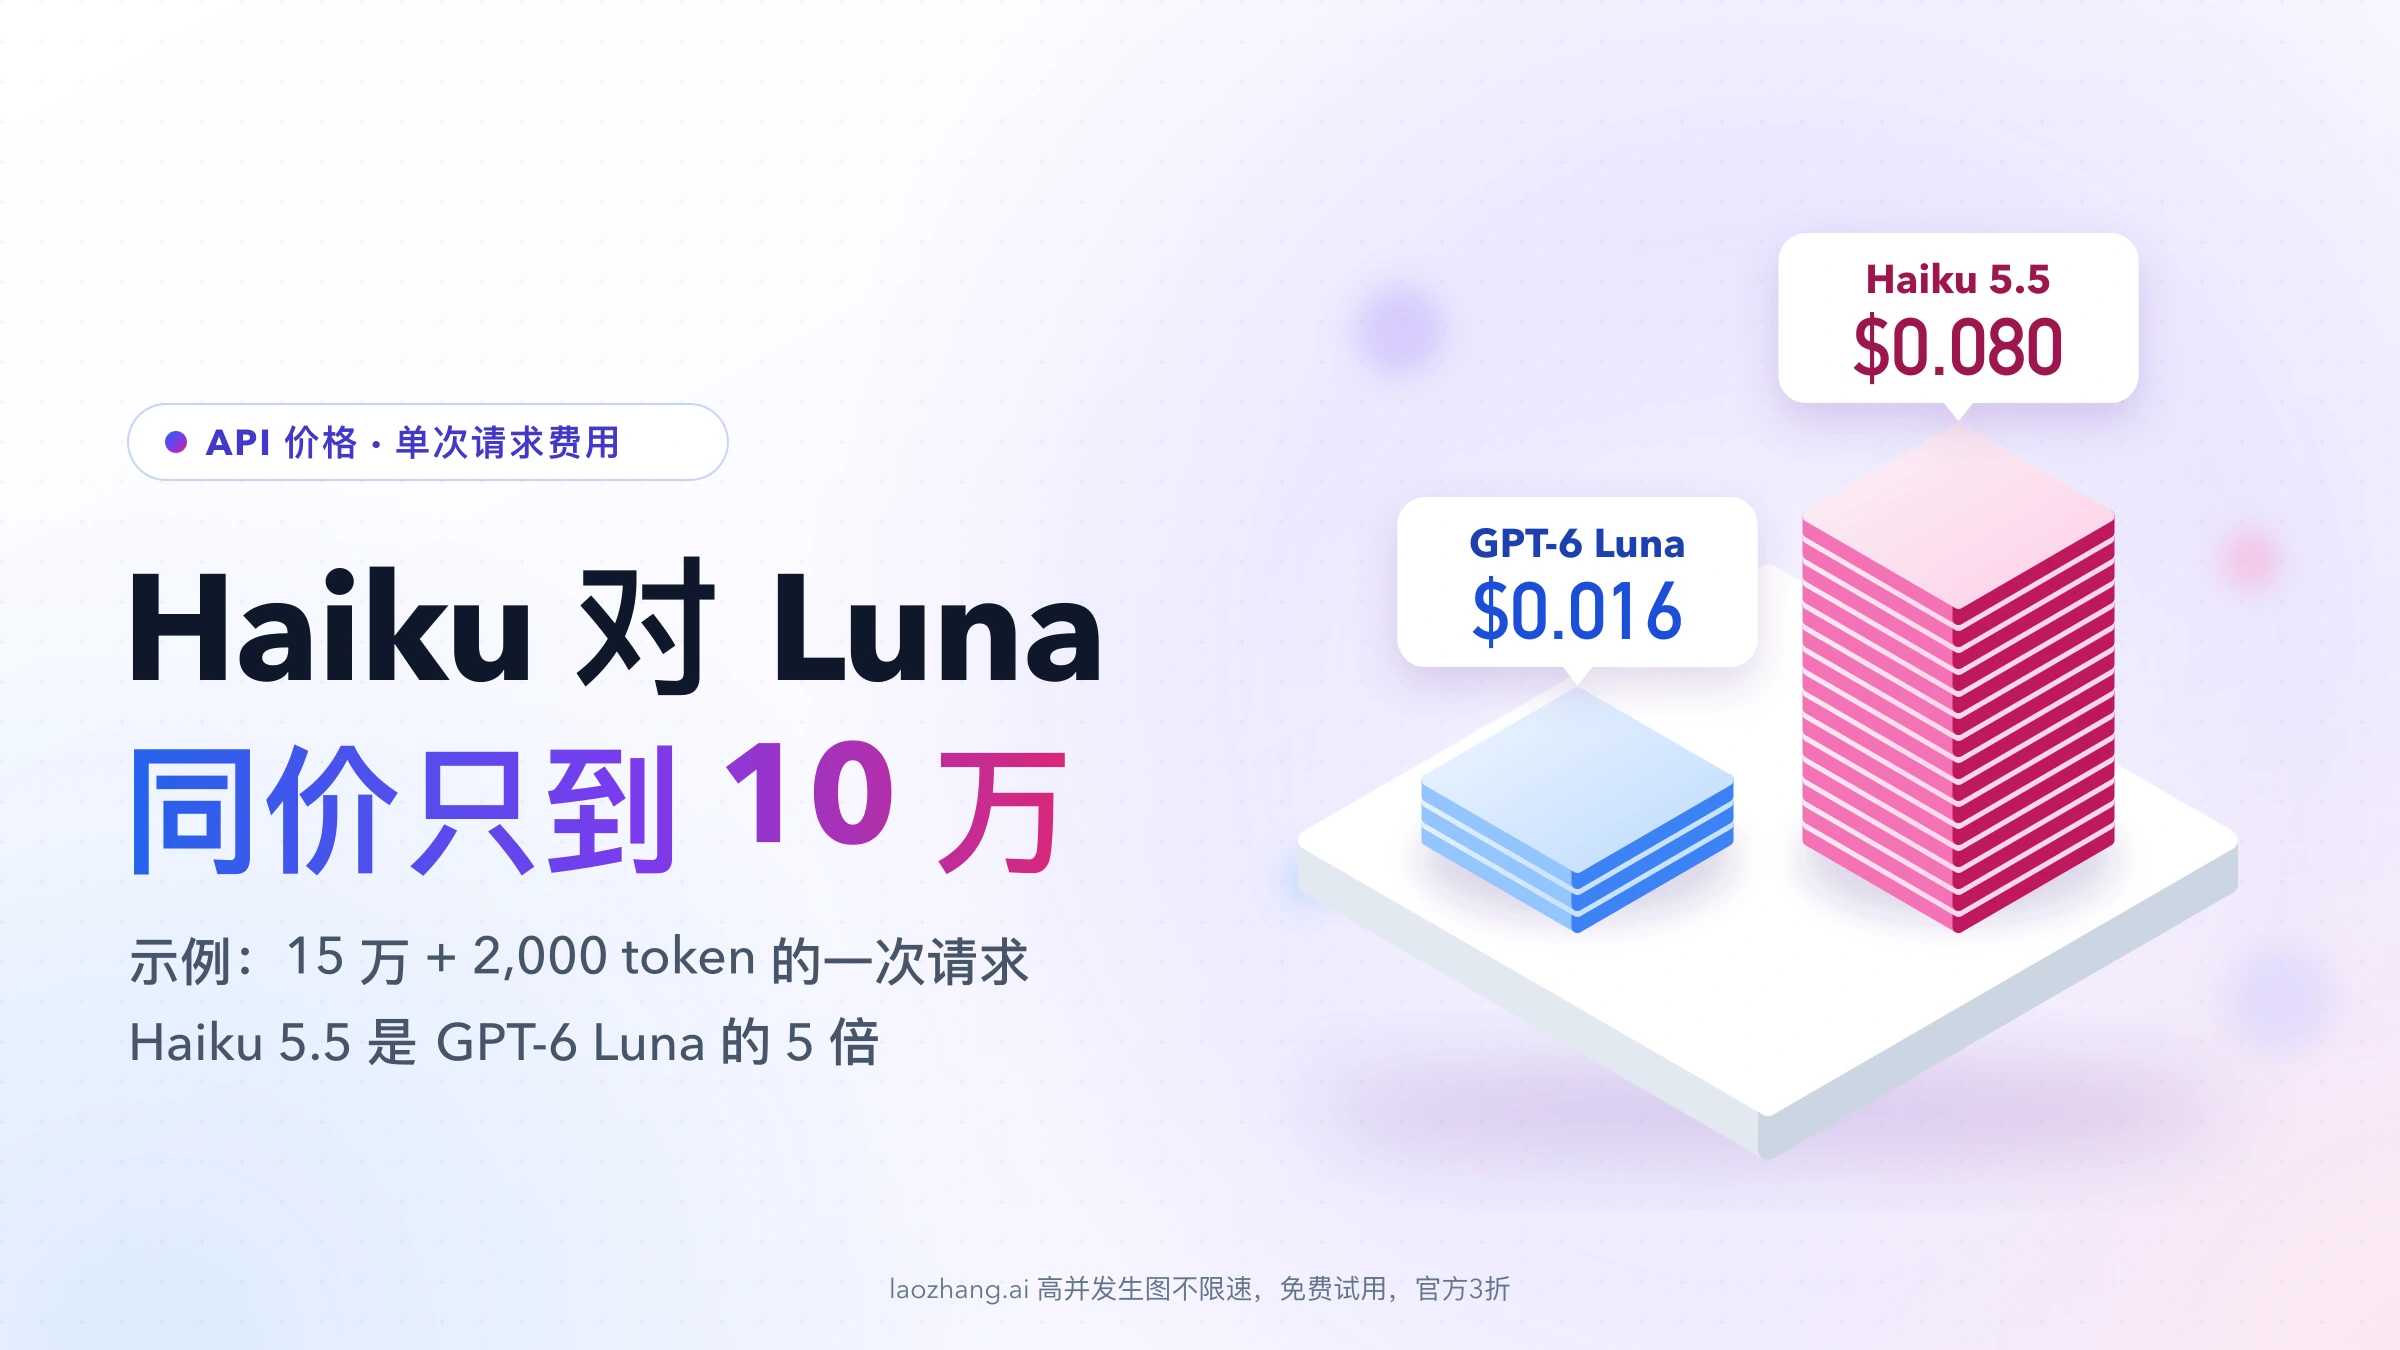
| 150,000 + 2,000 | $0.080 | $0.016 | 5 倍 |
| 272,000 + 2,000 | $0.141 | $0.0282 | 5 倍 |
| 300,000 + 5,000 | $0.1625 | $0.06375 | 2.55 倍 |
拿第一行验算:Haiku 是 2,000 × $0.10 + 200 × $0.50 = $300 / 百万次请求,Luna 一样,100 万次这样的分类请求两边都是 $300。再看第四行:只多 1 个 token,Haiku 那次请求就从 $0.011 跳到 $0.055,因为 100,001 × $0.50 + 2,000 × $2.50 已经全部按高档算。
这张表能读出三条规则:
- 10 万以内,单价不会造成任何差额。 账单差多少,完全由两边实际计出的 token 数决定(下一节会讲为什么它们往往不相等)。
- 10 万到 27.2 万之间,倍数恒为 5。 Haiku 高档每一项都是低档的 5 倍,而 Luna 还在低档,所以不管输入输出怎么配比,结果都是 5 倍。
- 超过 27.2 万,倍数落在 2.5 到 3.3 之间。 输入、缓存这几项的比例是 $0.50 ÷ $0.20 = 2.5,输出是 $2.50 ÷ $0.75 ≈ 3.3,输出占比越高越接近 3.3。
Batch 不会改变这个比例,两边都是半价:150,000 + 2,000 的请求走 Batch,Haiku $0.040,Luna $0.008。
因为门槛按单次请求判断,估算时要看提示词长度的分布,尤其是 P95 和最大值,平均值会掩盖问题。平均 3 万 token 的业务,只要一小部分请求越过 10 万,Haiku 的账单就可能被这一小部分拉高,后面"混合流量"一节有具体算例。
多轮 Agent 账单:上下文过 10 万后 Haiku 是 Luna 的 2 倍多
Agent、子代理和长对话的麻烦在于提示词会一轮轮变长,前面的请求都在低档,后面几轮悄悄越过 10 万。下面是一个可以复算的示例,不是实际账单:
- 一次会话 20 轮,第 1 轮提示词 12,000 token,之后每轮增加 6,000(工具结果、历史消息),第 20 轮为 126,000;
- 每轮输出 1,500 token;
- 第 16 到 20 轮的提示词超过 10 万;
- 两边 token 数相同,标准价;使用缓存时,每轮从缓存读取上一轮的提示词,新增的 6,000 token 按 5 分钟缓存写入计价,并假设缓存 token 计入 10 万门槛。
| 一次 20 轮会话 | Haiku 5.5 | GPT-6 Luna | Haiku ÷ Luna |
|---|---|---|---|
| 不用缓存 | $0.396 | $0.153 | 2.59 倍 |
| 使用缓存 | $0.0949 | $0.0433 | 2.19 倍 |
| 使用缓存,第 16 轮前把上下文压缩到 4 万 token(不含压缩本身的费用) | $0.0441 | $0.0433 | 约 1 倍 |
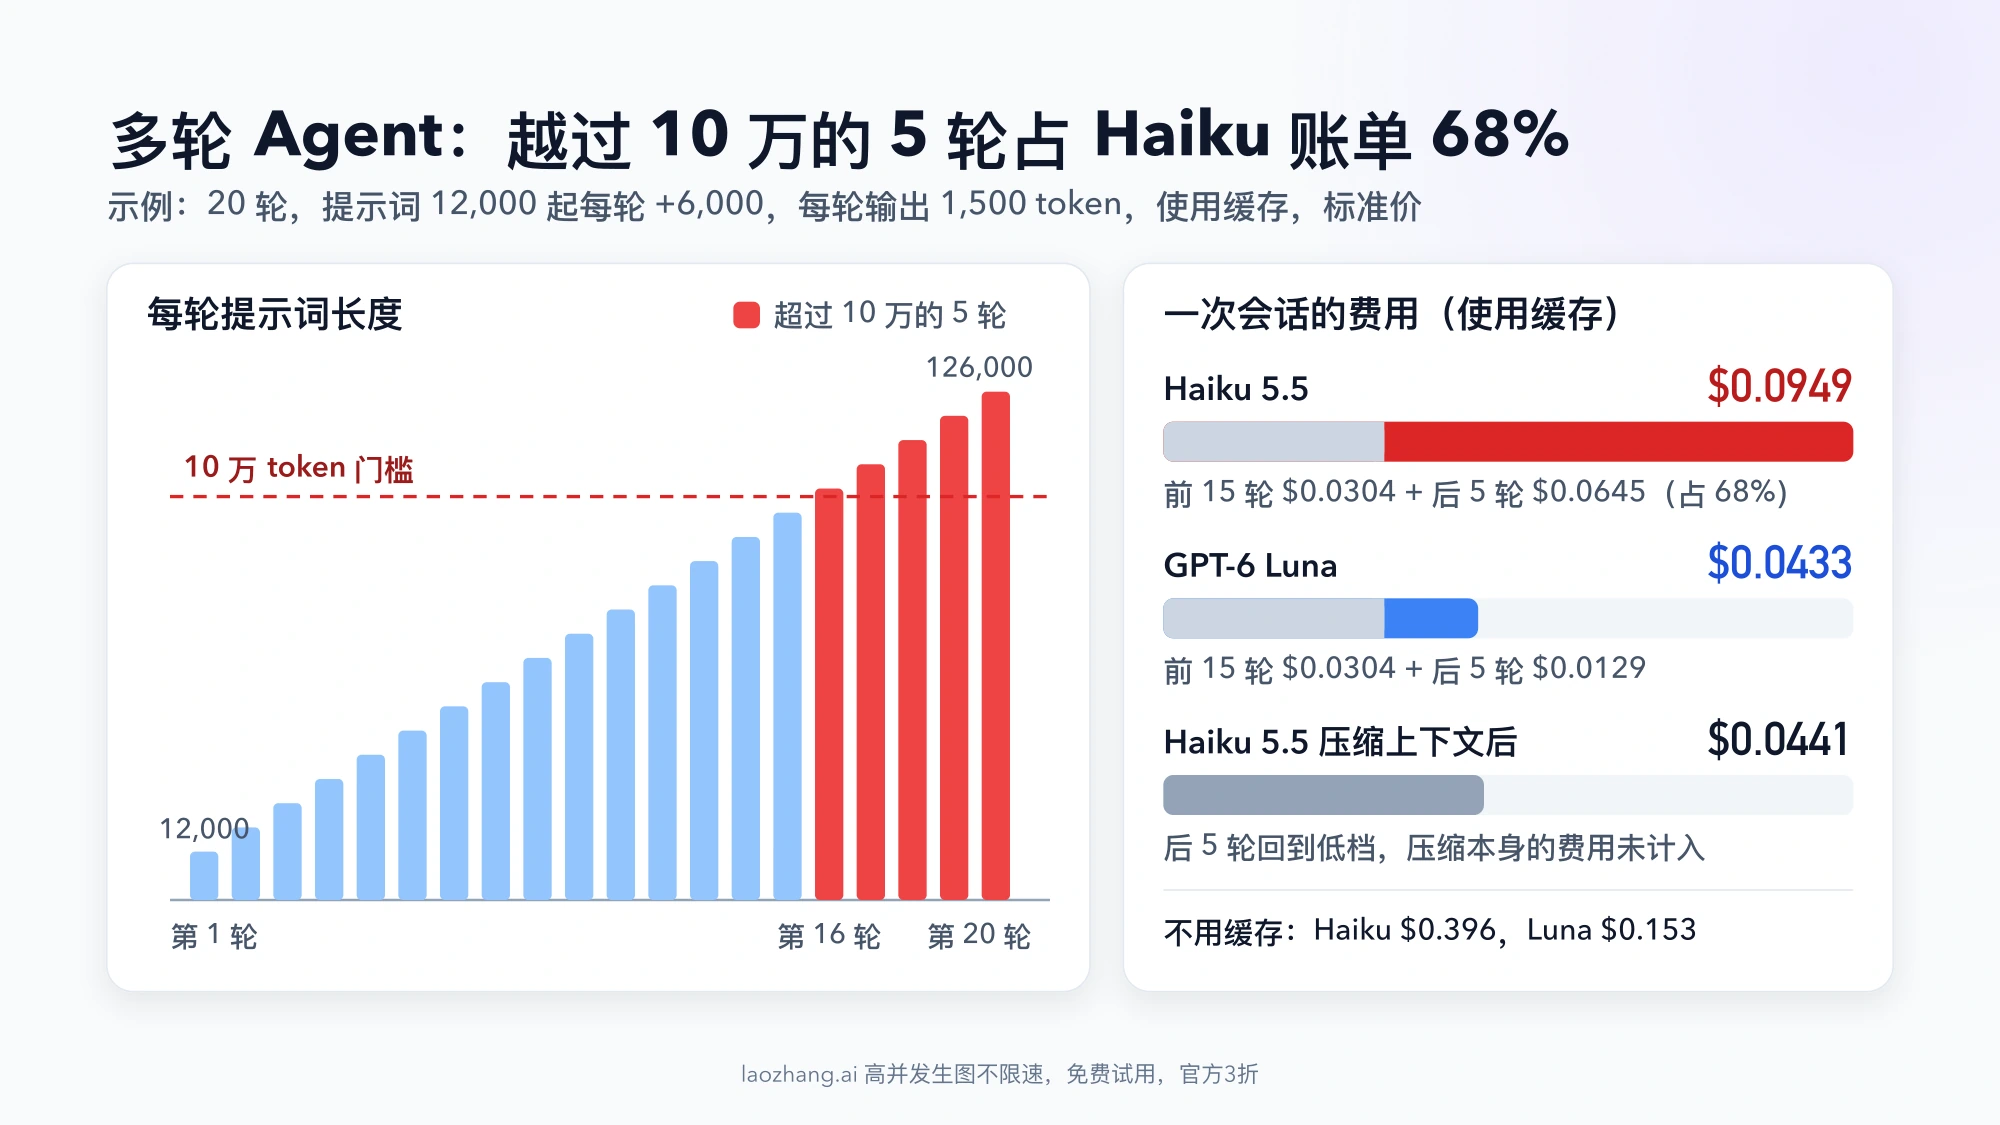
换成每 1,000 次会话,不用缓存是 $396 对 $153,用缓存是 $94.9 对 $43.3。用缓存时,Haiku 那 $0.0949 里有 $0.0645(68%)来自最后 5 轮;前 15 轮两边都是 $0.0304,一分不差。也就是说,多轮任务里 Haiku 贵出来的部分几乎全部来自越线的那几轮。
这个示例有两处会让真实情况对 Haiku 更不利:
- Haiku 5.5 默认保留之前的思考块。 这些思考块留在上下文里,后续请求按输入计费,所以 Haiku 的上下文会比示例里涨得更快,越过 10 万也会更早(上下文窗口文档)。
- 两边的 token 数并不相同。 Haiku 同档位下输出更多(见后文),输出又会进入下一轮的上下文。
反过来,如果缓存读取其实不计入门槛,Haiku 的账单会比表中低。在官方写清楚之前,按计入做预算更稳妥。
想让 Haiku 在长会话里保持和 Luna 同价,办法只有一个:让每次请求的提示词留在 10 万以内,比如定期总结、压缩历史,清理旧的思考块,或者把一个长任务拆成几个上下文更短的子代理。
单价相同账单不同的原因:输出 token、思考块和分词器
10 万以内两边的单价一模一样,同一件事的账单仍可能不同,原因在 token 数上:
1. 思考 token 按输出计费,而且 Haiku 同档写得更多。 Haiku 5.5 的思考 token 按输出价收费,也计入 max_tokens;Artificial Analysis 统计的每任务输出 token 也包含了两边的推理部分。它的数据里,同为 medium 档,Haiku 每任务输出约 33k(其中推理约 20k),Luna 约 11k(推理约 6k);只算输出这一项,就是 33,000 × $0.50 ÷ 1,000,000 = $0.0165 对 $0.0055。low 档差得更远:17k 对 2k。思考 token 在用量和账单里怎么对上,可以看《推理 Token 到底怎么计费?Gemini、OpenAI、Claude 的去重对账方法》。
2. Haiku 保留的思考块会变成后续请求的输入。 这是 Haiku 5.5 的默认行为,单轮请求不受影响,多轮对话的每一轮都会多出一截输入。
3. 分词器不同,同一段文字的 token 数不同。 Haiku 5.5 用的是 Claude 4.7 之后的新分词器,Anthropic 说同样的文字比 Haiku 4.5 多出约 30% 的 token,具体取决于内容(Haiku 5.5 新特性)。Haiku 5.5 和 Luna 对同一段中文或代码各计多少 token,目前没有公开的对比数据,只能用你自己的样本测。
把这些差异换算成钱,可以用一个简单的敏感度:在低档,每次请求多 100 个输出 token,100 万次请求就多 100,000,000 × $0.50 ÷ 1,000,000 = $50;一个 2,000 token 的提示词如果在某一边多计 10%(200 token),100 万次请求多 $20。短请求里,输出长度比分词器差异更值得盯。
每任务成本:同一 effort 档 Luna 便宜,分数对齐后接近
下面的数字来自 Artificial Analysis 的 Intelligence Index v4.3.2(10 项评测),在 Haiku 5.5 发布次日公布,同一档位名称两两对比:
| 档位(两边相同) | 综合指数 Haiku / Luna | 每任务成本 Haiku / Luna | 每任务输出 token Haiku / Luna | 首 token 延迟 Haiku / Luna |
|---|---|---|---|---|
| Low | 29 / 22 | $0.02 / $0.0045 | 17k / 2k | 9.93 秒 / 3.05 秒 |
| Medium(两边默认) | 34 / 30 | $0.05 / $0.02 | 33k / 11k | 13.40 秒 / 未显示 |
| High | 38 / 33 | $0.08 / $0.03 | 55k / 20k | 28.01 秒 / 21.08 秒 |
| Max | 43 / 38 | $0.21 / $0.07 | — | 432 秒 / 111 秒 |
同一个档位名,Haiku 分数更高,也花得更多。但两家的 effort 档位各自定义,名字相同不代表做同样多的工作。按分数把两边对齐,结论就变了:
| 分数接近的组合 | 综合指数 | 每任务成本 |
|---|---|---|
| Haiku Low 对 Luna Medium | 29 对 30 | $0.02 对 $0.02 |
| Haiku Medium 对 Luna High | 34 对 33 | $0.05 对 $0.03 |
| Haiku High 对 Luna Max | 38 对 38 | $0.08 对 $0.07 |
在相近的分数上,Haiku 的每任务成本是 Luna 的 1 到约 1.7 倍;最高这一组 Haiku High 的首 token 延迟是 28 秒,Luna Max 是 111 秒。
用这些数字时要记住几个边界:这是一家机构的一套测试框架,发布第二天的数据,之后可能修订;Max 档的数字取自 Max 对 Max 的默认对比页;Haiku 的每任务成本在页面上带星号,对比页没有给出说明;评测里有长上下文项目(AA-LCR),其中是否有请求越过了 Haiku 的 10 万门槛不得而知。最重要的是,综合指数不等于你的任务。它的用处是告诉你该怎么设计测试:别只拿两边的默认档比,要拿"Haiku 低一档"对"Luna 默认档"也比一次。
旗舰模型之间也有同样的"标价差和任务成本差不是一回事",见《GPT-6.1 Sol 对比 Opus 5.5:标价差 2 倍,任务成本差 6 倍》。
按自己的流量估算:混合请求的算法与判断规则
月账单可以按提示词长度分档估算:
月账单 ≈ Σ(该档请求数 × 该档单次费用)
单次费用 = 按上文公式,用实测的平均输入、缓存和输出 token 代入
一个混合流量的示例(假设两边 token 数相同):每月 100 万次请求,95% 是 2,000 + 200 的短请求,5% 是 150,000 + 2,000 的长文档请求。
- Haiku 5.5:950,000 × $0.0003 + 50,000 × $0.080 = $285 + $4,000 = $4,285
- GPT-6 Luna:950,000 × $0.0003 + 50,000 × $0.016 = $285 + $800 = $1,085
短请求部分两边都是 $285,差额全部来自那 5% 的长请求。这就是为什么要先看提示词长度分布,再看单价。
据此可以得出几条判断规则:
- 几乎所有请求都在 10 万以内(按 Haiku 5.5 的实际计数):单价打平,比的是"每个合格结果用多少 token"。两边都用默认档时 Luna 通常更省;如果 Haiku 用
low或关闭思考就能通过你的验收,而 Luna 要medium才行,两者成本接近,这时按质量、延迟和你已有的 SDK 选。 - 有一部分请求落在 10 万到 27.2 万之间:Luna 更便宜,除非你能把这部分请求裁剪或拆分到 10 万以内,或者 Haiku 在这类任务上的质量提升值得多付的钱。也可以把长请求单独路由给 Luna,短请求按质量选。
- 经常超过 27.2 万:Haiku 是 Luna 的 2.5 到 3.3 倍,选 Luna。
- 上下文持续变长的多轮 Agent:默认 Luna;如果坚持用 Haiku,压缩和清理要保证每轮都不越过 10 万。
可以用这句话检验自己的结论:"按我的流量,X 更便宜,除非……"。对大多数短请求业务,"除非"后面是 Haiku 在更低档位上的合格率;对长上下文业务,"除非"后面是能不能把 Haiku 的每次请求压在 10 万以内。
切换前先测的 5 项数据和要调的参数
不用大规模压测,拿一两百条有代表性的真实请求,两边各跑一遍,记下这些数:
- 用 Haiku 5.5 重新计数的提示词长度。 Anthropic 的迁移指南明确要求用
model设为claude-haiku-5-5重新计数,不要沿用 Haiku 4.5 的数字。记下 P50、P95 和最大值,看离 10 万有多远。Luna 一侧读响应usage里的输入和缓存 token。 - 每个任务的输出 token,含思考或推理部分。 这是 10 万以内唯一会让两边账单拉开的变量。
- 多轮任务每一轮的提示词增长。 重点看 Haiku 保留思考块后每轮多出多少,以及第几轮越过 10 万。
- 各档位的合格率。 至少测 Haiku 的
low、关闭思考、medium,以及 Luna 的none、low、medium,用同一套验收标准打分,再按"每个合格结果的成本"比。 - 一次带缓存、总长超过 10 万的请求实际按哪一档计费。 构造一条未缓存部分不到 10 万、加上缓存读取超过 10 万的请求,在用量或账单页面看它按哪一档收费,就能确认缓存是否计入门槛。
调参时用得上的开关:
- Haiku 5.5:
effort默认medium,可以往下调;在high及以下可以用thinking: {"type": "disabled"}关闭思考,但 Anthropic 更建议用调低 effort 来换速度和成本。从 Haiku 4.5 迁移时,temperature、top_p、top_k传非默认值和 assistant 预填都会返回 400;安全分类器可能返回stop_reason: "refusal",没有服务端降级,代码里要处理。最小可缓存提示词为 512 token。 - GPT-6 Luna:reasoning effort 有
none、low、medium(默认)、high、xhigh、max;不急的任务走 Batch 或 Flex 半价,Fast 档按 2 倍计价。
如果小模型在你的任务上怎么调都过不了验收,往上一级看会比继续压参数更省时间,Claude 这边见《Claude Opus 5.5 已发布:API 价格、能力与从 Opus 5 迁移的检查项》。
从 Haiku 4.5 升级:"降九成"按同一段文字算约少 87%
Anthropic 的说法是,10 万 token 以内的请求比 Haiku 4.5 低 90%,超过 10 万低 50%,按它自己的流量平均约低 75%(发布公告)。这里的 90% 和 50% 是每 token 单价的比较,同一段文字在新分词器下会多计约 30%:
- 10 万以内:同一段文字的费用约为原来的 1.3 × 0.1 = 0.13,少约 87%。例如 Haiku 4.5 上 10,000 token 的提示词加 500 token 输出,费用 $0.0125;同样内容在 Haiku 5.5 上约 13,000 token,费用 $0.00155。
- 超过 10 万:约为原来的 1.3 × 0.5 = 0.65,少约 35%,没有"降九成"那么多。
- 门槛提前了。 Haiku 5.5 的 100,000 token 约相当于 Haiku 4.5 计数下的 76,900 token(100,000 ÷ 1.3)。原来 8 万多 token 的请求,换过来可能已经进了高档。
1.3 只是平均值,以重新计数为准。另外 Haiku 5.5 默认开启思考,输出长度也可能和 4.5 不同。截至 2026 年 10 月 8 日,Haiku 4.5 仍是 Active 状态,退役时间"不早于 2026 年 10 月 15 日",还没有发出弃用通知。这个日期只是下限,之后随时可能公布弃用安排,规划迁移前到 模型弃用页面 再看一次。
中国大陆能不能直接调用 Claude 和 OpenAI 的官方 API
不能。Anthropic 和 OpenAI 公布的 API 支持地区名单都不包括中国大陆和香港(Anthropic 支持地区、OpenAI 支持地区)。OpenAI 还写明,在名单以外的地区访问或提供访问,可能导致账号被封禁或暂停。
如果你的公司主体和使用地在支持地区内,开通 Claude API 的步骤见《Claude API Key 怎么获取:先买额度,再创建自己的密钥》。
另一条路是第三方 API 平台。以 laozhang.ai 为例,截至 2026 年 10 月 7 日的模型列表里有 gpt-6-luna,标价每百万 token 输入 $0.1、输出 $0.5、缓存读取 $0.01,与 OpenAI 标准价相同;列表里目前没有任何 Claude 模型,FAQ 说明 Claude 系列因资源原因暂时下线,所以它现在不能用来调用 Haiku 5.5。缓存写入价、27.2 万以上的长上下文价格和 Batch 在该列表里都没有写明,用于长请求前先向平台确认。
Haiku 5.5 与 Luna 价格的几个短问题
缓存命中的 token 算不算进 Haiku 5.5 的 10 万门槛?
公开文档没有写。上下文窗口文档只说缓存读取、缓存写入和普通输入都计入上下文窗口,没说是否计入计价门槛;Luna 的 272K 也一样。预算时按计入处理,再用上文第 5 项测试确认。
走 Batch 能缩小 Haiku 5.5 和 Luna 在 10 万以上的差距吗?
不能。两边的 Batch 都是标准价的一半,比例不变:150,000 + 2,000 的请求走 Batch,Haiku $0.040,Luna $0.008,仍是 5 倍。
Claude Haiku 5.5 和 GPT-6 Luna 哪个更强?
在 Artificial Analysis 的综合指数里,同一档位名下 Haiku 都高 4 到 7 分,但它为此用的 token 也多得多;单项上并不全赢,比如 medium 档的 AutomationBench-AA,Luna 是 40%,Haiku 是 29%。Anthropic 自己发布的图表里,Haiku 5.5 在 GDPval-AA v2.1 上得 1620,据媒体转述 Luna 为 1437,这属于厂商自报,不是独立评测。对你的业务来说,哪个更强要看上文第 4 项测试的合格率。
Haiku 5.5 的 10 万门槛按输入算还是按整个请求算?
按提示词长度判断,提示词包括系统提示词、消息、工具结果、图片、文档和工具定义;输出不计入门槛,但一旦提示词超过 10 万,这次请求的输出也按 $2.50 / 百万 token 计价。