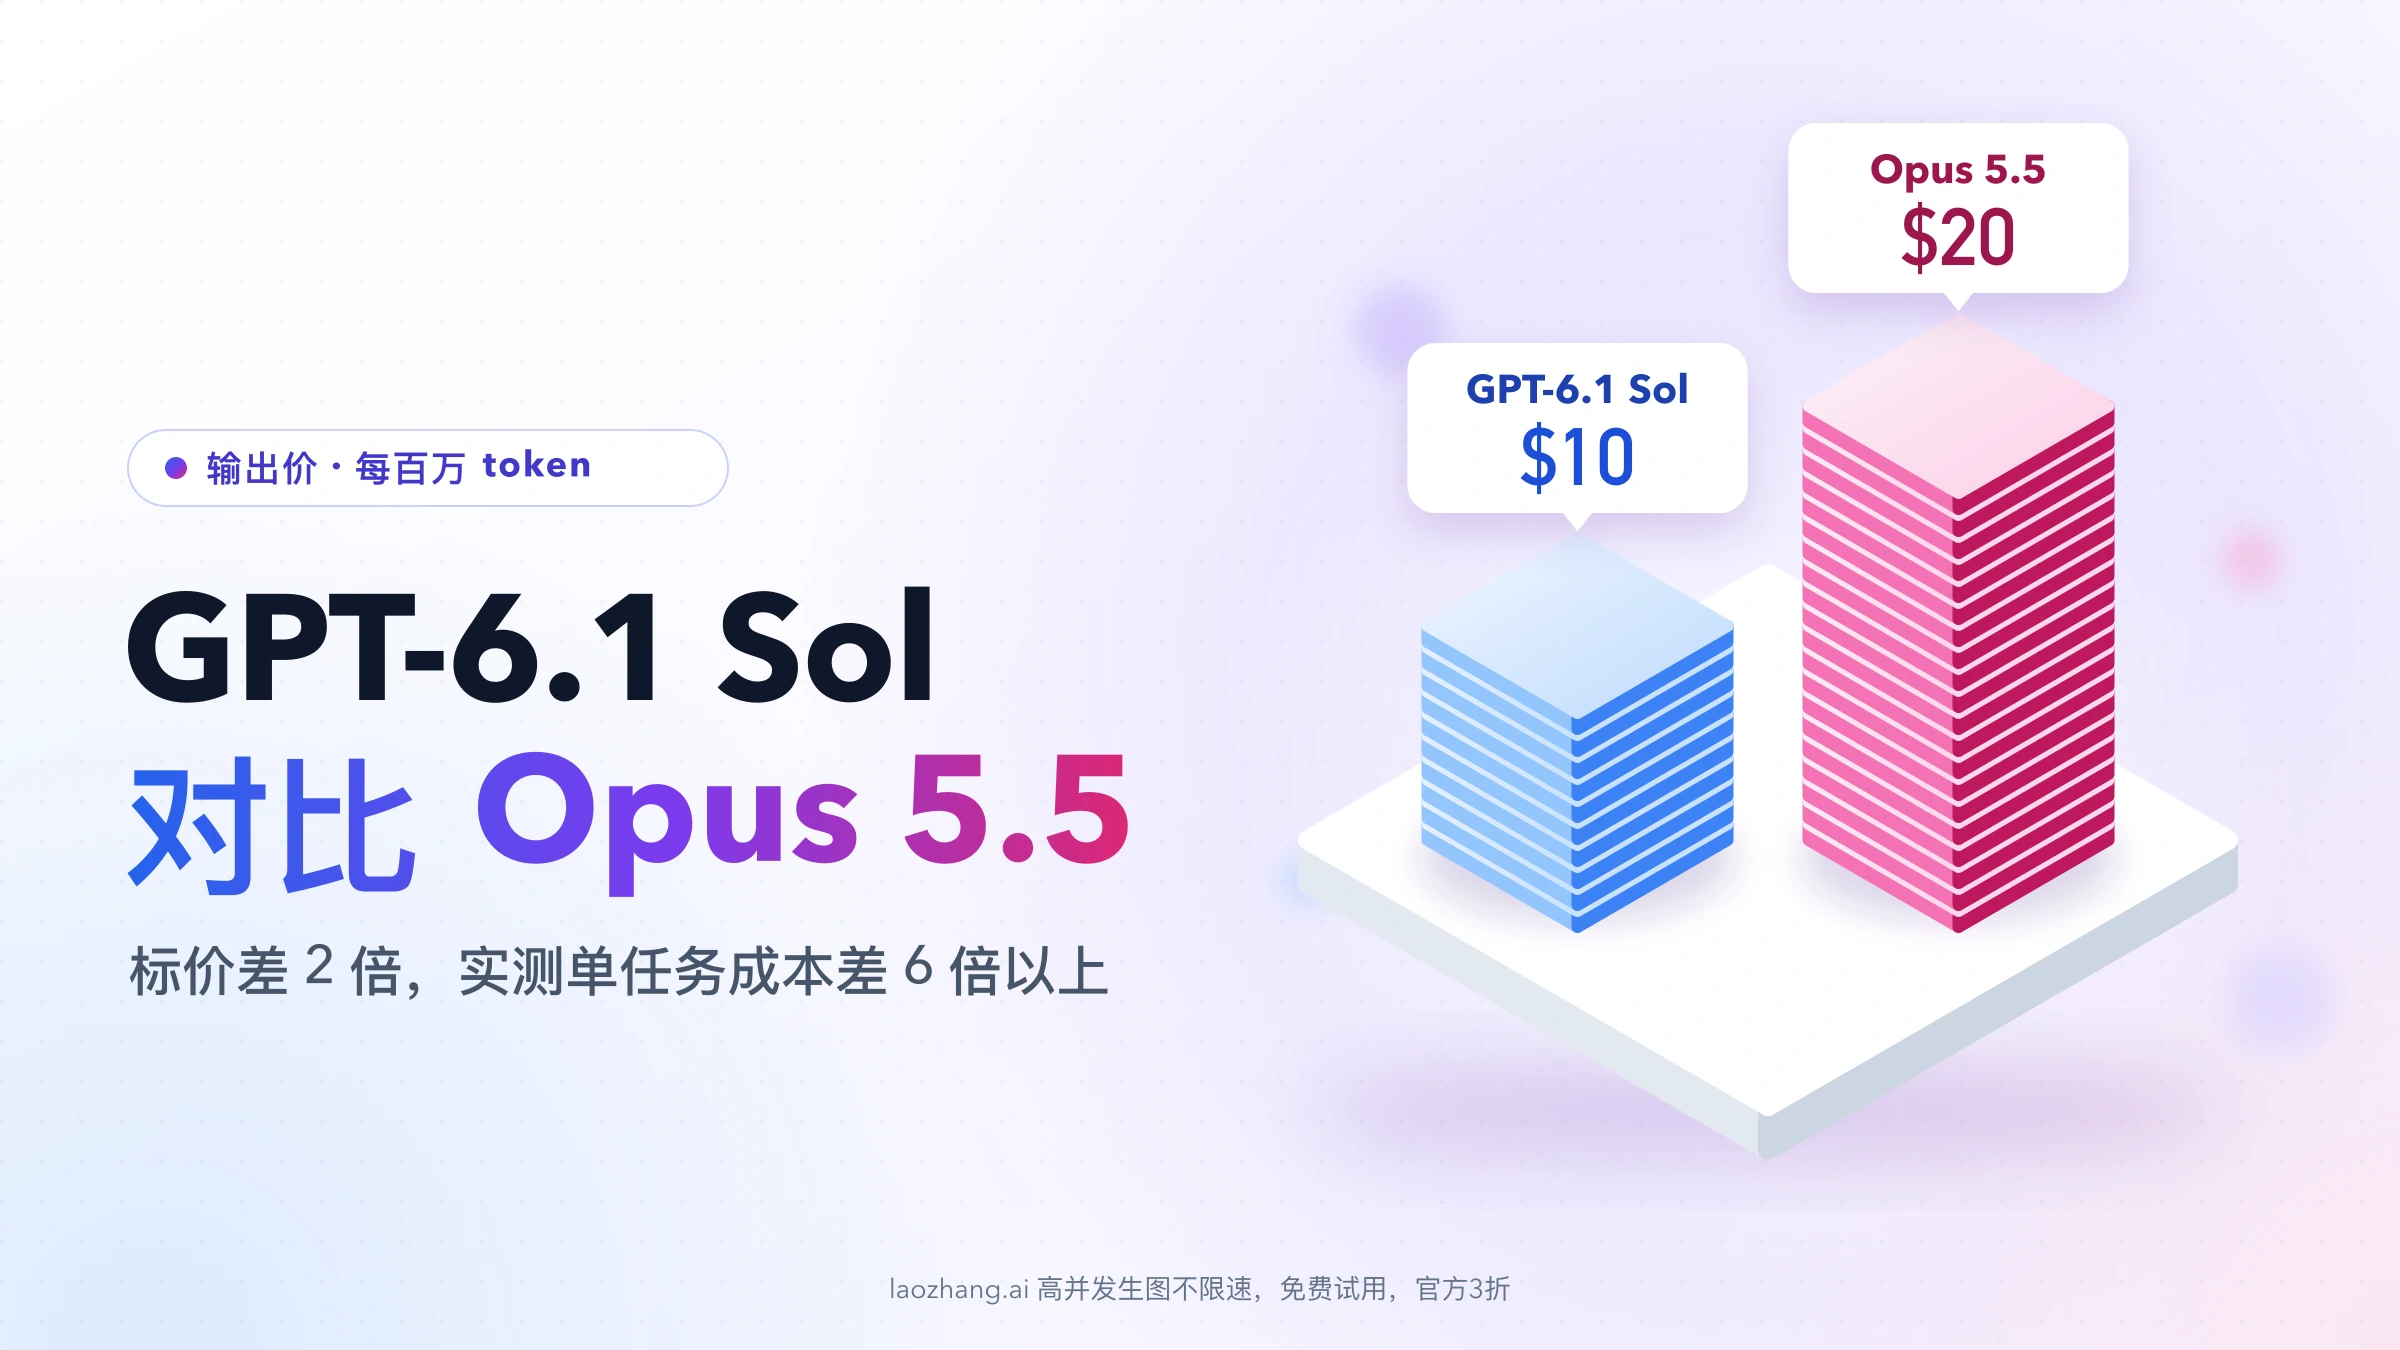
截至 2026 年 10 月 10 日,GPT-6.1 Sol(API 模型 ID gpt-6.1-sol)的标准价是每百万 token 输入 $2、输出 $10,Claude Opus 5.5(claude-opus-5-5)是 $4 和 $20,Sol 刚好便宜一半。真实任务的差距更大:Artificial Analysis 把两款模型的五档推理强度都测了一遍,两边都用默认的 medium 时,每个任务花 $0.21 对 $1.34,约 6.4 倍;五档里差距最小是 low 档的 4.2 倍,最大是 xhigh 档的 8.9 倍。原因是 Opus 5.5 完成同一个任务写出的 token 大约是 Sol 的 3 倍,而输出正是最贵的一项。
分数要分档看:low 档两者都是 42 分,往上每升一档 Opus 5.5 的领先就扩大一点,到 max 档是 58 对 52。可以这样起步:能自动验收、失败了可以重跑的批量任务,默认用 GPT-6.1 Sol;一次做错要花大量人工发现和返工的难题,交给 Opus 5.5;拿不准时,用你自己任务的通过率套后面那条公式。
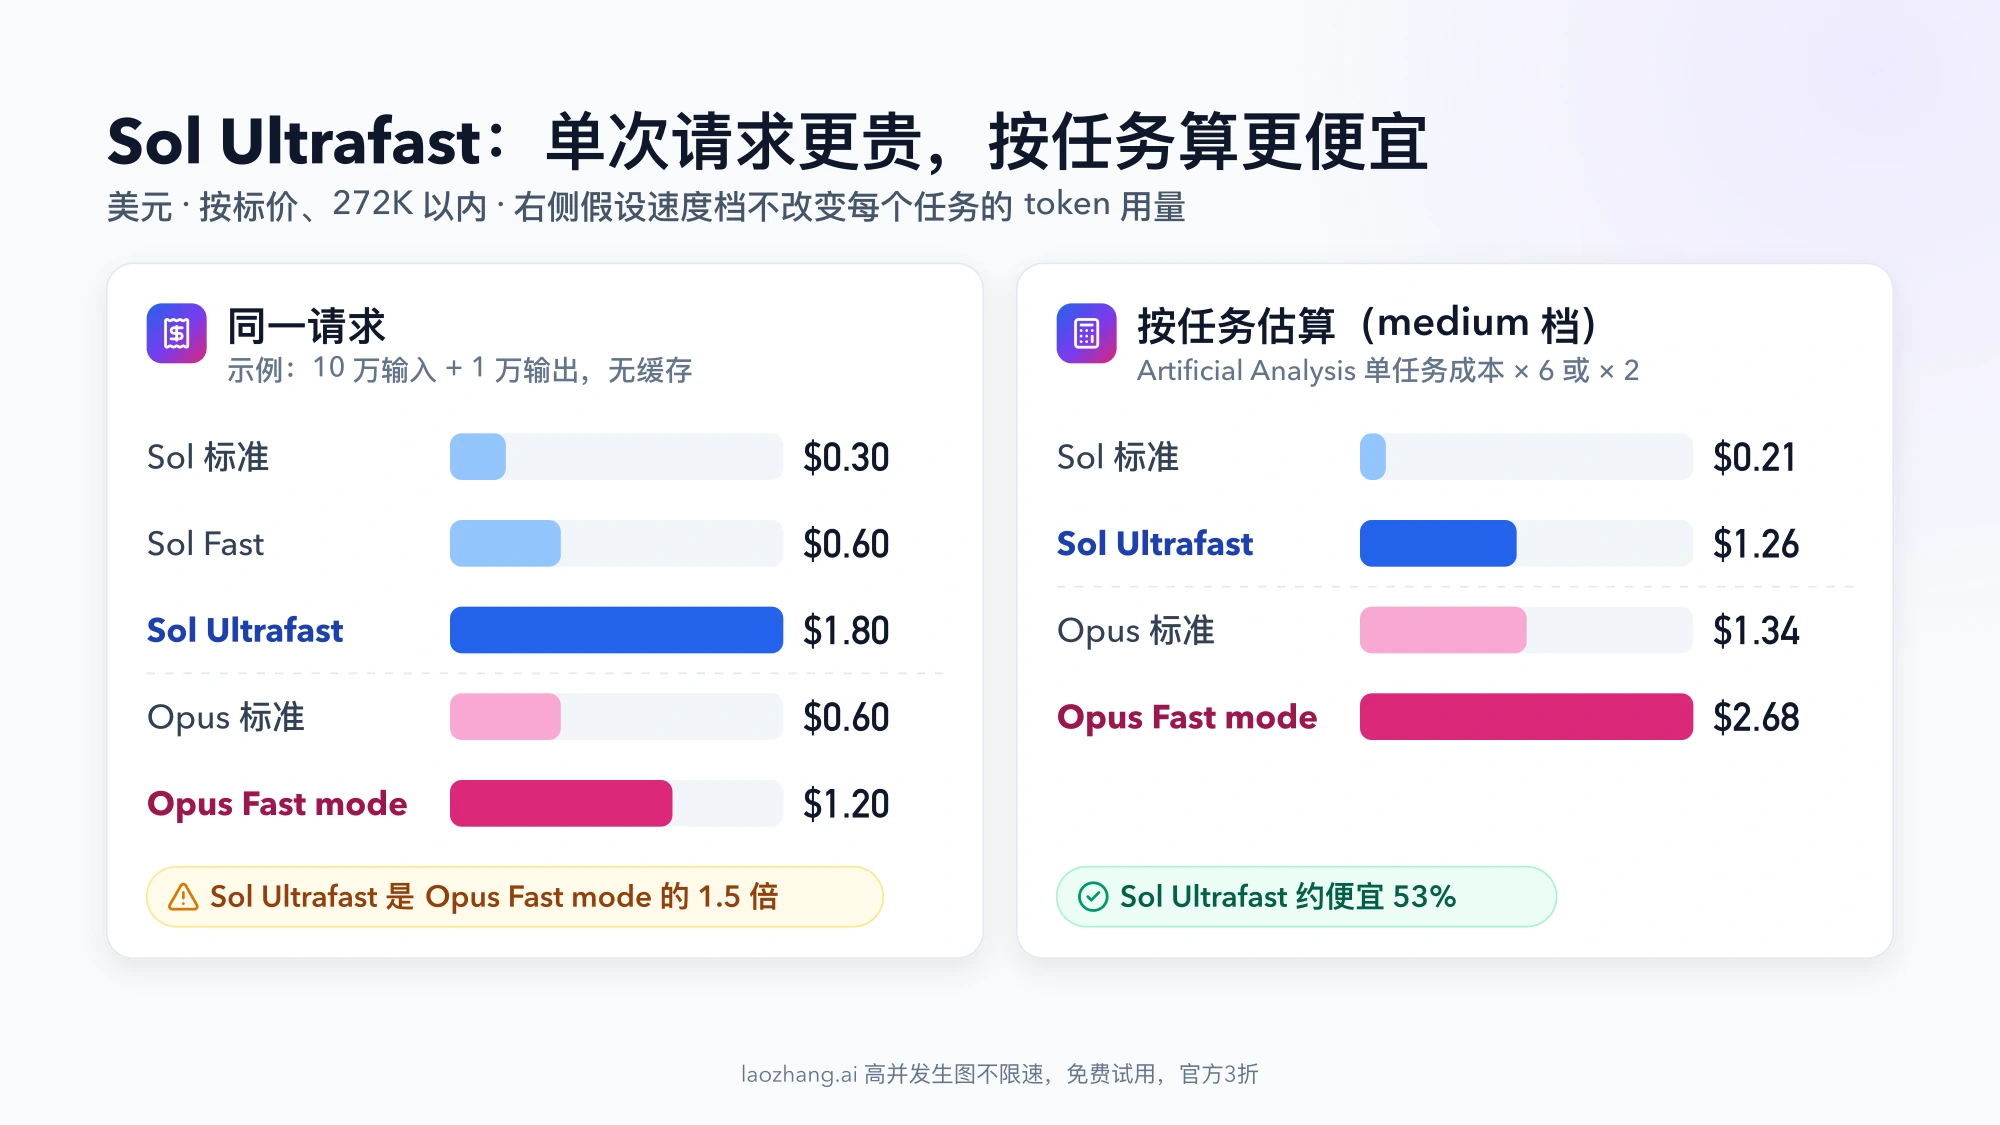
10 月 8 日起还多了一个变量:GPT-6.1 Sol Ultrafast 已经上线,每百万 token 输入 $12、输出 $60,是 Sol 标准价的 6 倍;Opus 5.5 对应的 Fast mode 是 $8 和 $40。token 数相同时,Sol Ultrafast 的一次请求是 Opus Fast mode 的 1.5 倍;但按单任务估算,medium 档 Sol Ultrafast 约 $1.26,Opus Fast mode 约 $2.68,Sol 仍然便宜。Ultrafast 对所有 OpenAI API 用户开放,Opus Fast mode 还要排候补名单。
下面的数字来自两家的文档、公告和第三方评测,测试方与设置随每条给出。
默认用 GPT-6.1 Sol 还是 Opus 5.5:批量任务用 Sol,难题用 Opus
| 任务形态 | 先试 | 依据 | 会改变结论的条件 |
|---|---|---|---|
| 批量、能自动验收、可重试(分类、抽取、常规代码修改、工单处理) | GPT-6.1 Sol | 标价一半;Artificial Analysis 五档的单任务成本都只有 Opus 5.5 的 1/4 到 1/9 | Sol 在你的任务上通过率低到要反复重跑 |
| 难度高、每个结果都要人看、返工代价大(跨模块重构、长时间运行的 Agent) | Claude Opus 5.5 | high 及以上三档领先 4 到 6 分;Vals Index 高约 4 到 6 个百分点 | 复核很便宜,或 Sol 调高推理强度后通过率已接近 |
| 想要中档 Opus 5.5 的分数,但预算紧、不赶时间 | GPT-6.1 Sol xhigh | Artificial Analysis 里同为 51 分,单任务成本约为 1/3.4 | 首个回答 token 平均要等约 174 秒,交互场景受不了 |
| 交互式使用,等待时间比单价重要 | 标准速度下 Sol 先开口;还要更快时看速度档 | Sol Ultrafast 现在就能在 API 里用;Opus Fast mode 是候补制研究预览 | Codex 里的 Ultrafast 只给 Pro $500 和部分企业、教育版 |
| 单次输入超过 272K token 的长文档 | 两个都测 | 超过 272K 后 Sol 输入单价升到 $4,与 Opus 5.5 持平 | 能否把输入切到 272K 以内;两边实际输出多少 token |
| 已经在用 GPT-6 Sol | GPT-6.1 Sol | 标价不变,缓存输入从 $0.20 降到 $0.10 | 代码里用了 none 推理强度,6.1 不接受 |
GPT-6.1 Sol 是什么:没有 6.1 Astra,Opus 5 也不是 Opus 5.5
"GPT 6.1"目前只有一款:GPT-6.1 Sol,也常被写成"Sol 6.1"。没有 GPT-6.1 Astra,也没有 GPT-6.1 Luna。按 OpenAI 的发布公告,它是 GPT-6 Sol 的升级版,标准输入和输出价格是 GPT-6 Astra 的五分之一,而 Astra 仍是 OpenAI 能力最强的模型。API 更新日志把发布日期记为 2026 年 9 月 29 日,即 DevDay 当天。
还有两组名字容易混:Claude Opus 5(claude-opus-5)是上一代,Claude Opus 5.5 是 Anthropic 在 2026 年 9 月 22 日发布的新版本;GPT-6 Sol(没有 .1)是 GPT-6.1 Sol 的前一版,标价相同、缓存输入贵一倍。下文比较的是 GPT-6.1 Sol 和 Opus 5.5。
| 项目 | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| API 模型 ID | gpt-6.1-sol | claude-opus-5-5(Bedrock 为 anthropic.claude-opus-5-5) |
| 上下文窗口 | 1,050,000 token,最大输入 922,000 | 1,000,000 token |
| 最大输出 | 128,000 token | 128,000 token(Message Batches 加 beta 请求头可到 300,000) |
| 推理强度 | low、medium(默认)、high、xhigh、max;不支持 none 和 minimal | 自适应思考始终开启,effort 同样分 low 到 max 五档,默认 medium |
| 知识截止 | 2026 年 4 月 30 日 | 2026 年 6 月(可靠知识截止) |
| API 与云平台 | OpenAI API;工具调用要走 Responses API,Chat Completions 只能不带工具调用 | Claude API、Amazon Bedrock、Google Cloud、Microsoft Foundry、Claude Platform on AWS |
| 订阅里在哪用 | ChatGPT 的 Work 模式和 Codex,Plus、Pro、Business、Enterprise、Edu 可用;不在 Chat 里 | Claude 应用的 Pro、Max、Team、Enterprise,以及 Claude Code |
规格出自 GPT-6.1 Sol 模型页和 Opus 5.5 模型概览。OpenAI 在 10 月 7 日把 GPT-6 推进了 ChatGPT 的 Chat 标签页,但那次更新给付费用户的底层模型是 GPT-6 Sol,给 Free 和 Go 用户的是 GPT-6 Luna,不是 GPT-6.1 Sol;Work 模式和 Codex 用的模型没有变。
按价位,和 GPT-6.1 Sol 同价的是 Claude Sonnet 5.5($2、$10),Opus 5.5 比它高一档。两者价格差一倍、分数有差距,都要放在这个前提下看。
GPT-6.1 Sol 和 Opus 5.5 的 API 价格:272K 以内每项都是一半
两家直连 API 的价格,单位为美元每百万 token,不含税和工具费用:
| 计费项 | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| 输入 | $2 | $4 |
| 缓存读取(缓存输入) | $0.10 | $0.20 |
| 缓存写入 | $2.50 | $5(5 分钟);$8(1 小时) |
| 输出 | $10 | $20 |
| 单次输入超过 272K token | 整次请求改按输入 $4、缓存读取 $0.20、缓存写入 $5、输出 $15 | 不加价,1M 上下文内同一单价 |
| Batch | 输入 $1、输出 $5(Flex 同价) | 输入 $2、输出 $10 |
| Fast | 输入 $4、输出 $20 | Fast mode:输入 $8、输出 $40 |
| Ultrafast | 输入 $12、缓存输入 $0.60、缓存写入 $15、输出 $60 | 无此档 |
| 指定区域处理 | 加价 10% | 仅美国推理(inference_geo)乘 1.1 |
出处是 OpenAI 定价页和 Anthropic 定价页。272K 以内,Sol 的每一项都正好是 Opus 5.5 的一半。
GPT-6.1 Sol 的价格不是促销价。OpenAI 定价页上"促销价至少持续到 2026 年 11 月 21 日"那句说明写的是 GPT-5.6 Sol,GPT-6.1 Sol 那一行没有促销标注。反过来,两家也都没有承诺现价会保持多久。
假设两边处理的 token 数相同,10 万输入加 1 万输出、不用缓存:GPT-6.1 Sol 是 0.1 × $2 + 0.01 × $10 = $0.30,Opus 5.5 是 0.1 × $4 + 0.01 × $20 = $0.60。这个"token 数相同"的前提在真实任务里并不成立,后面五档对照会讲到。
272K 这条线和 90 万 token 的长输入
GPT-6.1 Sol 的规则是:单次输入超过 272K token,整次请求的输入和缓存单价翻倍、输出乘 1.5;正好 272,000 仍按低档算。Opus 5.5 在整个 1M 上下文里同价。把边界两侧都算一遍(不用缓存):
| 输入 + 输出 token | GPT-6.1 Sol | Claude Opus 5.5 | Sol 便宜多少 |
|---|---|---|---|
| 272,000 + 20,000 | 0.272 × $2 + 0.02 × $10 = $0.744 | 0.272 × $4 + 0.02 × $20 = $1.488 | 50% |
| 273,000 + 20,000 | 0.273 × $4 + 0.02 × $15 = $1.392 | 0.273 × $4 + 0.02 × $20 = $1.492 | 约 7% |
| 300,000 + 20,000 | 0.3 × $4 + 0.02 × $15 = $1.50 | 0.3 × $4 + 0.02 × $20 = $1.60 | 约 6% |
| 900,000 + 10,000 | 0.9 × $4 + 0.01 × $15 = $3.75 | 0.9 × $4 + 0.01 × $20 = $3.80 | 约 1% |
输入从 272,000 加到 273,000,Sol 这次请求多花 $0.648,涨了 87%,Opus 5.5 只多 $0.004。过线之后两边输入同价,只剩输出还差 $5,所以 90 万 token 这种长输入,两者几乎一样贵。上限也要留意:Sol 单次最多输入 922,000 token,Opus 5.5 的上下文窗口是 1M token。文档刚好落在 272K 上下时,把输入裁到线内比换模型省得多。
Sol Ultrafast 对 Opus Fast mode:单次请求价是 1.5 倍,门槛也不同
Ultrafast 和 Fast mode 都不是另一个模型,而是同一个模型的速度档:换一种更快的推理配置,按更高的单价计费。OpenAI 在 10 月 8 日的更新日志里为 GPT-6.1 Sol 加上了 Ultrafast(Responses API 里传 service_tier: "ultrafast");Anthropic 的 Fast mode 在 Opus 5.5 发布时就有,至今仍是研究预览。
| 项目 | GPT-6.1 Sol Fast | GPT-6.1 Sol Ultrafast | Claude Opus 5.5 Fast mode |
|---|---|---|---|
| 价格(每百万 token,输入 / 输出) | $4 / $20,标准价 2 倍 | $12 / $60,标准价 6 倍;超过 272K 为 $24 / $90 | $8 / $40,标准价 2 倍,整个上下文同价 |
| 厂商给的提速 | — | 输出生成最高为 Sol 标准速度的 8 倍 | 每秒输出 token 最高为标准速度的 2.5 倍,不针对首 token 时间 |
| API 谁能用 | API 可用(原名 Priority processing,2026 年 7 月 30 日改名) | 所有 API 用户,独立速率限制,只在 Responses API | 研究预览:找客户经理或加入候补名单;仅 Claude API(含 Managed Agents) |
| 云平台与数据驻留 | 支持美国、欧盟数据驻留(加价 10%) | 支持美国、欧盟数据驻留(加价 10%) | 不支持 Bedrock、Google Cloud、Foundry、Claude Platform on AWS |
| 订阅工具里 | Codex 里按标准用量的 2.5 倍消耗 | Codex 和 Work 里只有 Pro $500 和符合条件的 Enterprise(默认关闭)、Edu;按 8 倍消耗额度,用 credits 时按 6 倍 | Claude Code 用 /fast 开启,Pro、Max、Team、Enterprise 都只能走 usage credits,不占套餐额度 |
| 限制 | — | OpenAI 建议用 WebSocket 连接保住延迟优势 | 不能与 Batch 叠加;切换速度会让提示缓存失效 |
价格出自两家定价页;Ultrafast 的接入方式见 OpenAI 的 Ultrafast 指南,Codex 里的权限与消耗倍数见 Codex 速度设置文档和 ChatGPT Pro 套餐说明,Claude Code 的规则见 Claude Code fast mode 文档。OpenAI 说 Sol Ultrafast 的价格是 Astra 的 1.2 倍,比较对象是标准速度的 GPT-6 Astra($10 / $50)。
同一请求在五个价位各花多少
按标价、272K 以内、两边 token 数相同、不计缓存写入,算两种请求:
| 档位 | A:10 万输入 + 1 万输出,无缓存 | B:5 万新输入 + 20 万缓存读取 + 1 万输出 |
|---|---|---|
| GPT-6.1 Sol 标准 | 0.1 × $2 + 0.01 × $10 = $0.30 | 0.05 × $2 + 0.2 × $0.10 + 0.01 × $10 = $0.22 |
| GPT-6.1 Sol Fast | $0.60 | $0.44 |
| GPT-6.1 Sol Ultrafast | 0.1 × $12 + 0.01 × $60 = $1.80 | 0.05 × $12 + 0.2 × $0.60 + 0.01 × $60 = $1.32 |
| Claude Opus 5.5 标准 | 0.1 × $4 + 0.01 × $20 = $0.60 | 0.05 × $4 + 0.2 × $0.20 + 0.01 × $20 = $0.44 |
| Claude Opus 5.5 Fast mode | 0.1 × $8 + 0.01 × $40 = $1.20 | 0.05 × $8 + 0.2 × $0.40 + 0.01 × $40 = $0.88 |
两种请求的比例完全一样:Sol Fast 与 Opus 5.5 标准同价;Sol Ultrafast 是 Opus Fast mode 的 1.5 倍、Opus 5.5 标准价的 3 倍、Sol 标准价的 6 倍。Opus Fast mode 的缓存读取价 $0.40 是按文档"缓存倍率叠加在 Fast mode 价格之上"推出来的($8 的 5%),定价表里没有单列这一行。
按任务算:Sol Ultrafast 仍比 Opus Fast mode 便宜
上面的"token 数相同"只适合比单价。真实任务里 Opus 5.5 写得多,所以要用单任务成本来比。两家的速度档都是对全部 token 单价乘同一个倍数,把 Artificial Analysis 测得的标准速度单任务成本分别乘 6 和 2,就能估出速度档的单任务成本:
| 推理强度 | Sol 标准 → Ultrafast(× 6) | Opus 5.5 标准 → Fast mode(× 2) | Sol Ultrafast 比 Opus Fast mode 便宜 |
|---|---|---|---|
low | $0.13 → $0.78 | $0.55 → $1.10 | 约 29% |
medium | $0.21 → $1.26 | $1.34 → $2.68 | 约 53% |
max | $0.72 → $4.32 | $5.98 → $11.96 | 约 64% |
这是估算,前提有三个:速度档不改变每个任务用掉的 token 数(Sol Ultrafast 只是 gpt-6.1-sol 的一个 service_tier,Anthropic 也写明 Fast mode"智能和能力不变");Artificial Analysis 的成本是四舍五入后的均值;两个速度档本身都没有第三方测过。
速度档到底能快多少:没有可比的实测
"8 倍"和"2.5 倍"都是厂商给的上限,各自相对自己模型的标准速度,不能互相比,也不能换算成省下多少秒。截至 10 月 10 日,Artificial Analysis 和两家文档都没有公布 Sol Ultrafast 或 Opus Fast mode 的实测每秒 token 数。
能参考的只有标准速度。Artificial Analysis 测得 Opus 5.5 吐字更快:medium 档每秒 79.2 对 52.4 个 token,max 档 97.0 对 59.3。Sol 则先开口:medium 档首个回答 token 5.93 秒对 21.89 秒。算上 token 总量,medium 档每个任务的平均耗时是 Sol 156 秒、Opus 5.5 199 秒,Sol 写得少,反而先做完。OpenAI 的 Tibo Sottiaux 10 月 5 日在 X 上说,GPT-6 Astra 和 GPT-6.1 Sol 在订阅产品里的默认速度提高了约 50%,这条说法没有涉及 API。
速度档怎么开、Ultrafast 与 Sol 的完整关系,见 OpenAI Ultrafast 和 Sol 的区别:层级不是模型,Sol 版已上线。
五档推理逐档对照:low 档同为 42 分,max 档差 6 分
Artificial Analysis 的发布对比页把两款模型的五档推理强度各测了一遍(Intelligence Index v4.3.2)。Opus 5.5 各行都标着"Default Fallback",含义见下一节:
| 推理强度 | GPT-6.1 Sol:分数 / 每任务成本 | Opus 5.5:分数 / 每任务成本 | 分差 | 成本倍数(Opus ÷ Sol) | 首个回答 token(Sol / Opus) |
|---|---|---|---|---|---|
low | 42 / $0.13 | 42 / $0.55 | 0 | 4.23 | 3.04 秒 / 8.70 秒 |
medium | 48 / $0.21 | 51 / $1.34 | 3 | 6.38 | 5.93 秒 / 21.89 秒 |
high | 50 / $0.32 | 54 / $1.82 | 4 | 5.69 | 62.25 秒 / 39.56 秒 |
xhigh | 51 / $0.39 | 56 / $3.46 | 5 | 8.87 | 173.70 秒 / 127.85 秒 |
max | 52 / $0.72 | 58 / $5.98 | 6 | 8.31 | 309.04 秒 / 704.18 秒 |
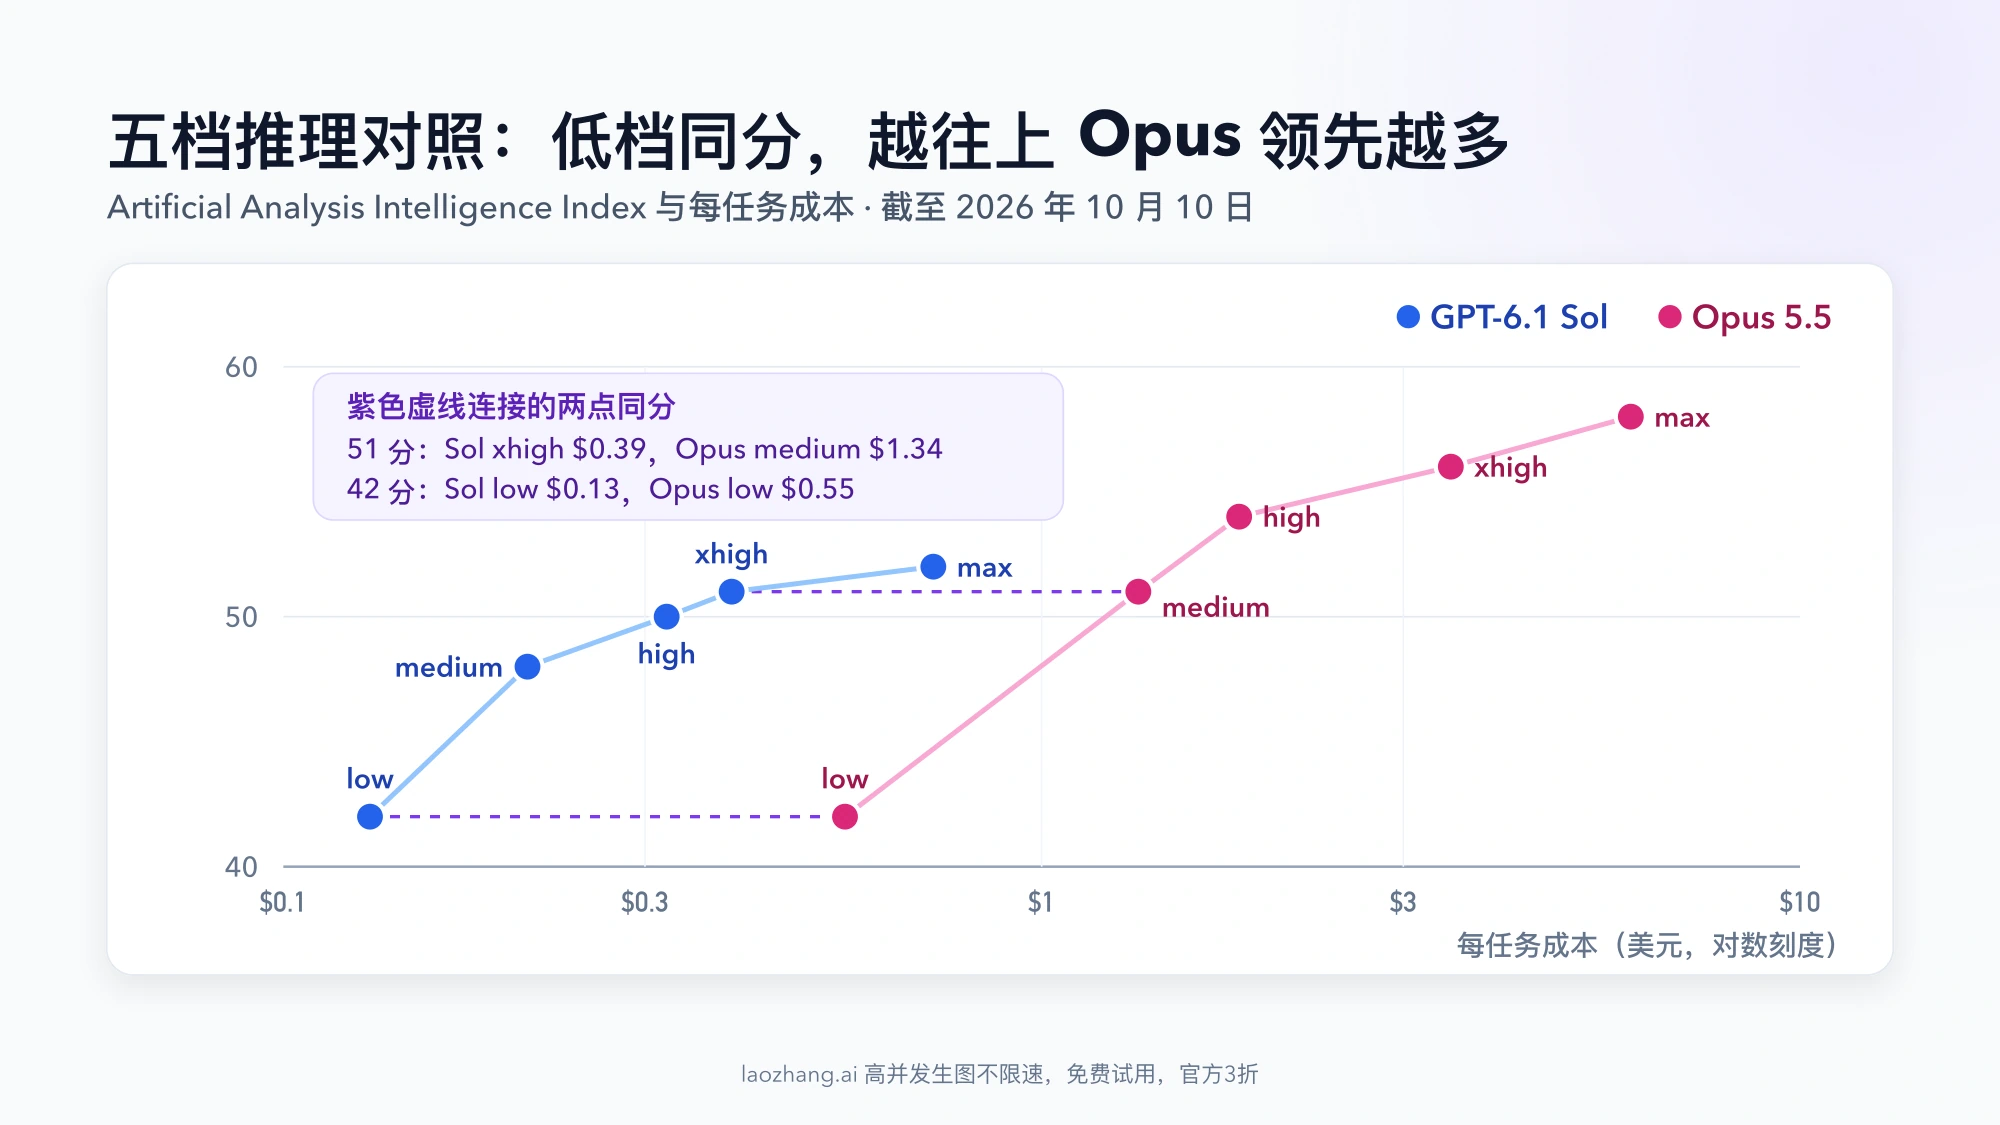
这张表有三点值得记住:
- 低档没有差距。只做简单任务、开
low档时,两者同分,Sol 每个任务便宜约四分之三。 - 差距随档位扩大。越难的任务越需要高档位,Opus 5.5 的领先也越明显,从 3 分扩大到 6 分。
- 错档比较更有用。Sol 开
xhigh得 51 分、每任务 $0.39,与medium档的 Opus 5.5(51 分、$1.34)同分,成本约为 1/3.4;代价是首个回答 token 平均要等 173.7 秒,Opus 只要 21.9 秒。Sol 开到max得 52 分,比中档 Opus 5.5 高 1 分,单任务成本是后者的 54%。想超过这个水平,就只能为高档 Opus 5.5 付每任务 $1.82 到 $5.98。
偏编程的子项方向一致:同一页的 Terminal-Bench 4.0,medium 档 Sol 48.0%、Opus 5.5 52.5%,max 档 56.1% 对 59.6%。这些是截至 2026 年 10 月 10 日的数值,只代表这一家评测机构的题目,以后可能修订。
Opus 5.5 的 token 为什么多出三倍
单任务成本差 4 到 9 倍,而标价只差 2 倍,多出来的部分来自 token 用量。按 Artificial Analysis 的中档对比页,medium 档每个任务的输出 token 是 Sol 8k、Opus 5.5 26k,其中推理 token 3k 对 12k;max 档是 38k 对 119k。单价贵一倍,再乘以三倍多的输出,就到了六倍上下。同一组数据按"跑完整套指数的成本"算是 $361 对 $1,627(4.5 倍)和 $1,082 对 $8,708(8.0 倍),引用倍数时要说清是哪个指标。
还有一层没法从标价看出来:两家的分词器不同。Anthropic 在定价页说明,Claude 4.7 及之后的模型用的新分词器,对同一段文本产生的 token 比旧分词器多约 30%;同一段文本在 OpenAI 和 Claude 各算多少 token,没有公开的换算比例。要估自己的账单,最可靠的办法是拿二三十个真实任务两边各跑一遍,读 API 返回的 usage 字段。Opus 5.5 的 effort 本身就是最大的成本旋钮,五档怎么选见 Claude Opus 5.5 的 effort 怎么选?五档设置与任务成本比较。
GPT-6.1 Sol 和 Opus 5.5 的基准分数:谁测的、算没算回退
Vals Index:Opus 5.5 高 5.8 分,回退算失败后差 3.9 分
Vals Index v2.1(2026 年 10 月 7 日更新,覆盖金融、编程、法律、税务任务)里,Opus 5.5 是 66.97%,GPT-6.1 Sol 是 61.15%。每个测试的成本是 $32.14 对 $3.24,约 9.9 倍;耗时 1 小时 19 分对 43 分 10 秒。
Vals 的脚注写明,Opus 5.5 的分数里有一部分子任务是在被拒绝后由回退模型完成的;把这些任务算作失败,Opus 5.5 降到 65.05%,与 Sol 的差距从 5.82 缩到 3.90 个百分点。同一张榜上,与 Sol 同价的 Claude Sonnet 5.5 是 67.04%,略高于 Opus 5.5;排第一的 Gemini 4 Argon(68.90%)已于 2026 年 10 月 13 日在 Gemini 付费 API 正式上线,11 月 30 日前 $2 / $10,与 Sol 同价,12 月 1 日起 $4 / $20,与 Opus 5.5 同价。
OpenAI 自报的数字:中档 Sol 领先,max 档 Opus 5.5 领先
OpenAI 发布公告里点名 Opus 5.5 的三项基准都是 OpenAI 自己挑的,Opus 5.5 的结果取自公开报告、标注为"带回退机制":
| 基准与档位(OpenAI 发布数据) | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
GDP.pdf,high | 32.0%,每任务 $0.35 | 28.8%,每任务 $0.83 |
AutomationBench 1.0.6,medium | 31.7%,$0.19 | 29.5%,$0.65 |
AutomationBench 1.0.6,max | 36.1%,$0.30 | 42.5%,$1.44 |
Terminal-Bench Science 0.1,max | 57.0%,$5.47 | 63.3%,$23.21 |
即便在厂商自选的基准里,方向也随档位翻转:GDP.pdf 各档和 AutomationBench 中档是 Sol 领先、单任务成本不到一半;max 档的 AutomationBench 和 Terminal-Bench Science 则是 Opus 5.5 高 6 个百分点以上。Anthropic 为 Opus 5.5 公布的成绩(Terminal-Bench 4.0 66.4%、OSWorld 2.1 81.8% 等)早于 GPT-6.1 Sol,表里没有 Sol 的行;Sol 公布的 OSWorld 2.0 离线集 71.4% 是另一个版本,不能直接对比。两家的发布数据里找不到一项版本相同、同时包含两款模型的基准,所以上面两家第三方评测更值得参考。
榜单里的"Default Fallback"是什么意思
Artificial Analysis 标的"Default Fallback"、Vals 脚注里的回退模型、OpenAI 写的"带回退机制",说的是同一件事:被 Opus 5.5 拒绝的请求,改由别的模型完成。
按 Anthropic 的拒绝与回退文档,Opus 5.5 的安全分类器可能拒绝某些请求,响应的 stop_reason 是 "refusal"。调用方可以开启服务端回退(beta 请求头 server-side-fallback-2026-07-01,参数 fallbacks: "default"),API 会改用别的模型重试,按实际作答模型的价格计费。Anthropic 表示,网络安全类任务多数会被路由到 Opus 4.8。对你的影响有三点:
- 回退要自己配置。没配置时,拒绝就是最终结果,榜单上那个带回退的分数你拿不到。
- 榜单里 Opus 5.5 的分数和成本,有一部分来自另一个模型。
- 自 2026 年 9 月 24 日起,在产生输出之前被拒绝的请求,只有
bio、frontier_llm、reasoning_extraction三类会收费。
拒绝多久发生一次取决于任务领域。安全、生物这类容易触发分类器的工作,上线前要单独测拒绝率。
用自己的通过率算:Opus 5.5 要高多少才划算
单任务成本低,不代表拿到一个能用的结果更便宜。便宜的模型如果要多跑几次、每次还要人看一眼,账就要重算:
每个可用结果的成本 =(单次尝试的 token 成本 c + 每次复核的人工成本 R)÷ 通过率 p
由此得出 Opus 5.5 更划算的条件:
Opus 5.5 通过率 ÷ Sol 通过率 >(c_Opus + R)÷(c_Sol + R)
c 可以先借用 Artificial Analysis medium 档的每任务成本(Sol $0.21,Opus 5.5 $1.34),之后换成你自己任务的实测值。R 和通过率只能你自己填,没有公开数据可以代替。代入几种复核成本:
| 每次复核成本 R | 相当于 | 所需通过率之比 | 若 Sol 通过率 70%,Opus 5.5 需要超过 |
|---|---|---|---|
| $0 | 全自动验收 | 1.34 ÷ 0.21 ≈ 6.38 | 做不到(需要 447%) |
| $1 | 时薪 $60 的人看 1 分钟 | 2.34 ÷ 1.21 ≈ 1.93 | 做不到(需要 135%) |
| $5 | 时薪 $60 的人看 5 分钟 | 6.34 ÷ 5.21 ≈ 1.217 | 85.2% |
| $20 | 时薪 $60 的人看 20 分钟 | 21.34 ÷ 20.21 ≈ 1.056 | 73.9% |
以 R = $5、Sol 通过率 70% 验算边界两侧:Sol 每个可用结果是 5.21 ÷ 0.7 ≈ $7.44。Opus 5.5 通过率 90% 时是 6.34 ÷ 0.9 ≈ $7.04,比 Sol 便宜;80% 时是 6.34 ÷ 0.8 ≈ $7.93,比 Sol 贵。分界点就在 85.2%。
从这张表能读出两条结论:
- 能自动验收的任务,token 成本说了算。即使 Opus 5.5 次次通过,Sol 的通过率也要低于 1 ÷ 6.38 ≈ 15.7% 才会输。
- 复核越贵,模型单价越不重要。每次要人看 20 分钟时,Opus 5.5 的通过率只要比 Sol 高 4 个百分点左右就回本。
同一条公式也能比别的组合。如果你打算用 xhigh 档的 Sol 去对标中档 Opus 5.5,把 c_Sol 换成 $0.39;如果要比两个速度档,就换成上一节估出的 $1.26 和 $2.68。这条规则假设每次重试相互独立、每次复核耗时相同,没有计入"错误没被发现"的损失;漏掉一个错误代价很高的任务,应当更偏向通过率高的一方。
$20 套餐、Codex 与 Claude Code:没法按数字比
两家的 20 美元档都包含这两款模型,但都没有公布可以直接相比的额度:
- ChatGPT Plus($20/月):GPT-6.1 Sol 在 Work 模式和 Codex 里用。OpenAI 的定价说明给出的是每 5 小时 15 到 160 条本地消息的区间(GPT-6 Astra 是 5 到 45 条),实际数量取决于任务大小。Pro 有 $100、$200、$500 三档,没有 5 小时限制;Ultrafast 只在 Pro $500 里。按 Pro 套餐说明,新开的 Pro 200 额度比以前低、月费仍是 $200;9 月 22 日到 9 月 29 日(太平洋时间上午 10 点前)在订的用户,旧额度保留到 2026 年 10 月 29 日。新额度少了多少,OpenAI 没有公布。
- Claude Pro($20/月,按年付 $17/月):包含 Opus 5.5 和 Claude Code;Max 从 $100 起,额度是 Pro 的 5 倍或 20 倍。Claude 定价页没有给出 Opus 5.5 的具体额度。Max 和 Team 现在每月附带 $100 到 $200 的 API 额度,怎么领、能不能用在 Claude Code 里,见 Claude Max API 额度怎么领:每月 $100/$200,Claude Code 能不能用。
第三方估算里,SemiAnalysis 10 月 6 日的文章用自己 9 月的 Agent 工作负载测了用量表,按 API 标价折算,认为 Claude 套餐给 Opus 5.5 的"API 等值"约是 ChatGPT 套餐给 GPT-6.1 Sol 的 5 倍(文中另一处写约 4 倍)。这个数按标价算,而 Opus 的 token 本来就贵一倍,再加上 Opus 每个任务多用约三倍 token,所以它不等于"能多做 5 倍的活"。
不能拿月费除以 API 单价去推算额度。只打算留一个订阅的话,更实际的判断是:你常用的工具在哪边(Codex 还是 Claude Code),以及按开头的任务分类,你的活儿更像哪一类。需要提速时还要算上门槛:Codex 里的 Sol Ultrafast 要 Pro $500,Claude Code 里的 /fast 只能另付 usage credits。
不想二选一:Sonnet 5.5、GPT-6 Astra 也在候选里
- Claude Sonnet 5.5:标价和 GPT-6.1 Sol 一样($2 / $10),10 月 7 日缓存读取降到 $0.10,Vals Index 67.04% 与 Opus 5.5 基本持平。想留在 Claude 生态又嫌 Opus 贵,先试它。
- GPT-6 Astra:OpenAI 能力最强的模型,$10 / $50,是 Sol 的 5 倍。Plus 用户在哪里能用,见 GPT-6 Astra 怎么用:Plus 只在 Work 和 Codex 里有。
- 只要更快:GPT-6.1 Sol Ultrafast,价格见上文。
- 三家一起比:Gemini 4 Argon 对比 Opus 5.5、Sonnet 5.5:怎么选。上一代 Sol 与 Opus 5.5 的比较见 Claude Opus 5.5 对比 GPT-5.6 Sol:标价相同时怎么选。
切换前要改的参数:推理强度、工具调用和 thinking
从 GPT-6 Sol 换到 GPT-6.1 Sol
- 模型 ID 从
gpt-6-sol改成gpt-6.1-sol。输入 $2、输出 $10 和 272K 规则不变,缓存输入从 $0.20 降到 $0.10。 gpt-6.1-sol不接受none和minimal推理强度。原来用none压延迟的,要改成low或更高,再重测延迟和输出 token 数。- 工具调用要走 Responses API;Chat Completions 只能在不带工具调用时使用。Ultrafast 也只在 Responses API 里提供。
- OpenAI 在 10 月 6 日把 API 用量等级从五级简化成 Build、Launch、Grow 三级,GPT-6.1 Sol 的标准速率限制分别是每分钟 100 万、400 万、4,000 万 token。旧文档里的"Tier 1 到 Tier 5"已经不再使用。
从 OpenAI 换到 Claude Opus 5.5
- 思考不能关闭:传
thinking: {"type": "disabled"}或{"type": "enabled", ...}都会返回 400,用 effort 参数控制思考深度。 tool_choice传any或tool会返回 400,改用auto加严格工具调用。- 如果任务涉及容易被拒绝的领域,决定要不要配置服务端回退,并在日志里记录实际作答的模型。
- 要用 Fast mode 的,先申请权限;它不能和 Batch 叠加,切换速度会让提示缓存失效。
前两条限制出自 Anthropic 的发布说明,Fast mode 的规则见上文链接的 Fast mode 文档;完整迁移检查项见 Claude Opus 5.5 已发布:API 价格、能力与从 Opus 5 迁移的检查项。
GPT-6.1 Sol 与 Opus 5.5 常见问题
GPT-6.1 Sol 比 Claude Opus 5.5 便宜多少?
按标价是一半:输入 $2 对 $4,输出 $10 对 $20,缓存读取 $0.10 对 $0.20。按第三方评测的单任务成本是 4 到 10 倍:Artificial Analysis 五档推理里 Opus 5.5 是 Sol 的 4.2 到 8.9 倍(默认 medium 档 $0.21 对 $1.34),Vals Index 每个测试 $3.24 对 $32.14。例外有两个:单次输入超过 272K token 时 Sol 输入单价升到 $4,只比 Opus 5.5 便宜 1% 到 7%;开 Ultrafast 后,同样 token 数的一次请求,Sol 反而是 Opus Fast mode 的 1.5 倍。
GPT-6.1 Sol 比 Opus 5.5 强吗?
独立评测里不比它强,差距看档位。Artificial Analysis 的指数在 low 档同为 42 分,medium 档 48 对 51,max 档 52 对 58;Vals Index 是 61.15% 对 66.97%,把回退任务算失败后是 61.15% 对 65.05%。OpenAI 自报的数据里,中档 Sol 在 GDP.pdf 和 AutomationBench 上领先,max 档则是 Opus 5.5 更高。Sol 的优势在同样的分数花钱更少:xhigh 档 Sol 与中档 Opus 5.5 同分,单任务成本约为 1/3.4。
有 GPT-6.1 Astra 或 GPT-6.1 Luna 吗?
没有。截至 2026 年 10 月 10 日,6.1 这个版本号只有 Sol。OpenAI 能力最强的模型仍是 GPT-6 Astra,标价是 GPT-6.1 Sol 的 5 倍;10 月 7 日进入 ChatGPT 聊天的是 GPT-6 Sol 和 GPT-6 Luna,也不是 6.1。
GPT-6.1 Sol Ultrafast 多少钱、谁能用?
2026 年 10 月 8 日上线,272K 以内每百万 token 输入 $12、缓存输入 $0.60、缓存写入 $15、输出 $60,超过 272K 是 $24、$1.20、$30、$90,都是标准价的 6 倍。API 里所有用户都能用(Responses API,独立速率限制);Codex 和 ChatGPT Work 里只有 Pro $500 和符合条件的 Enterprise、Edu 能用,Plus、Pro 100、Pro 200 即使买了 credits 也不行。
写代码该用 GPT-6.1 Sol 还是 Opus 5.5?
能靠测试自动验收的常规修改先用 GPT-6.1 Sol,不够时先把推理强度往上调:xhigh 档的 Sol 在 Artificial Analysis 的指数上与中档 Opus 5.5 相当,成本约为 1/3.4,只是首个回答要等更久。跨模块的大改动、长时间运行的 Agent、每次都要资深工程师审的结果,用 Opus 5.5 更可能回本;两者在 Terminal-Bench 4.0 上 max 档是 56.1% 对 59.6%。具体用"每个可用结果的成本"那条公式代入自己的通过率判断。
GPT-6.1 Sol 和 Opus 5.5 现在的价格会保持多久?
两家都没有承诺。OpenAI 定价页上"至少持续到 2026 年 11 月 21 日"的促销说明只针对 GPT-5.6 Sol,GPT-6.1 Sol 和 Opus 5.5 的价格都没有标注为促销价,也都没有写有效期。上面的金额以两家定价页当日显示为准。