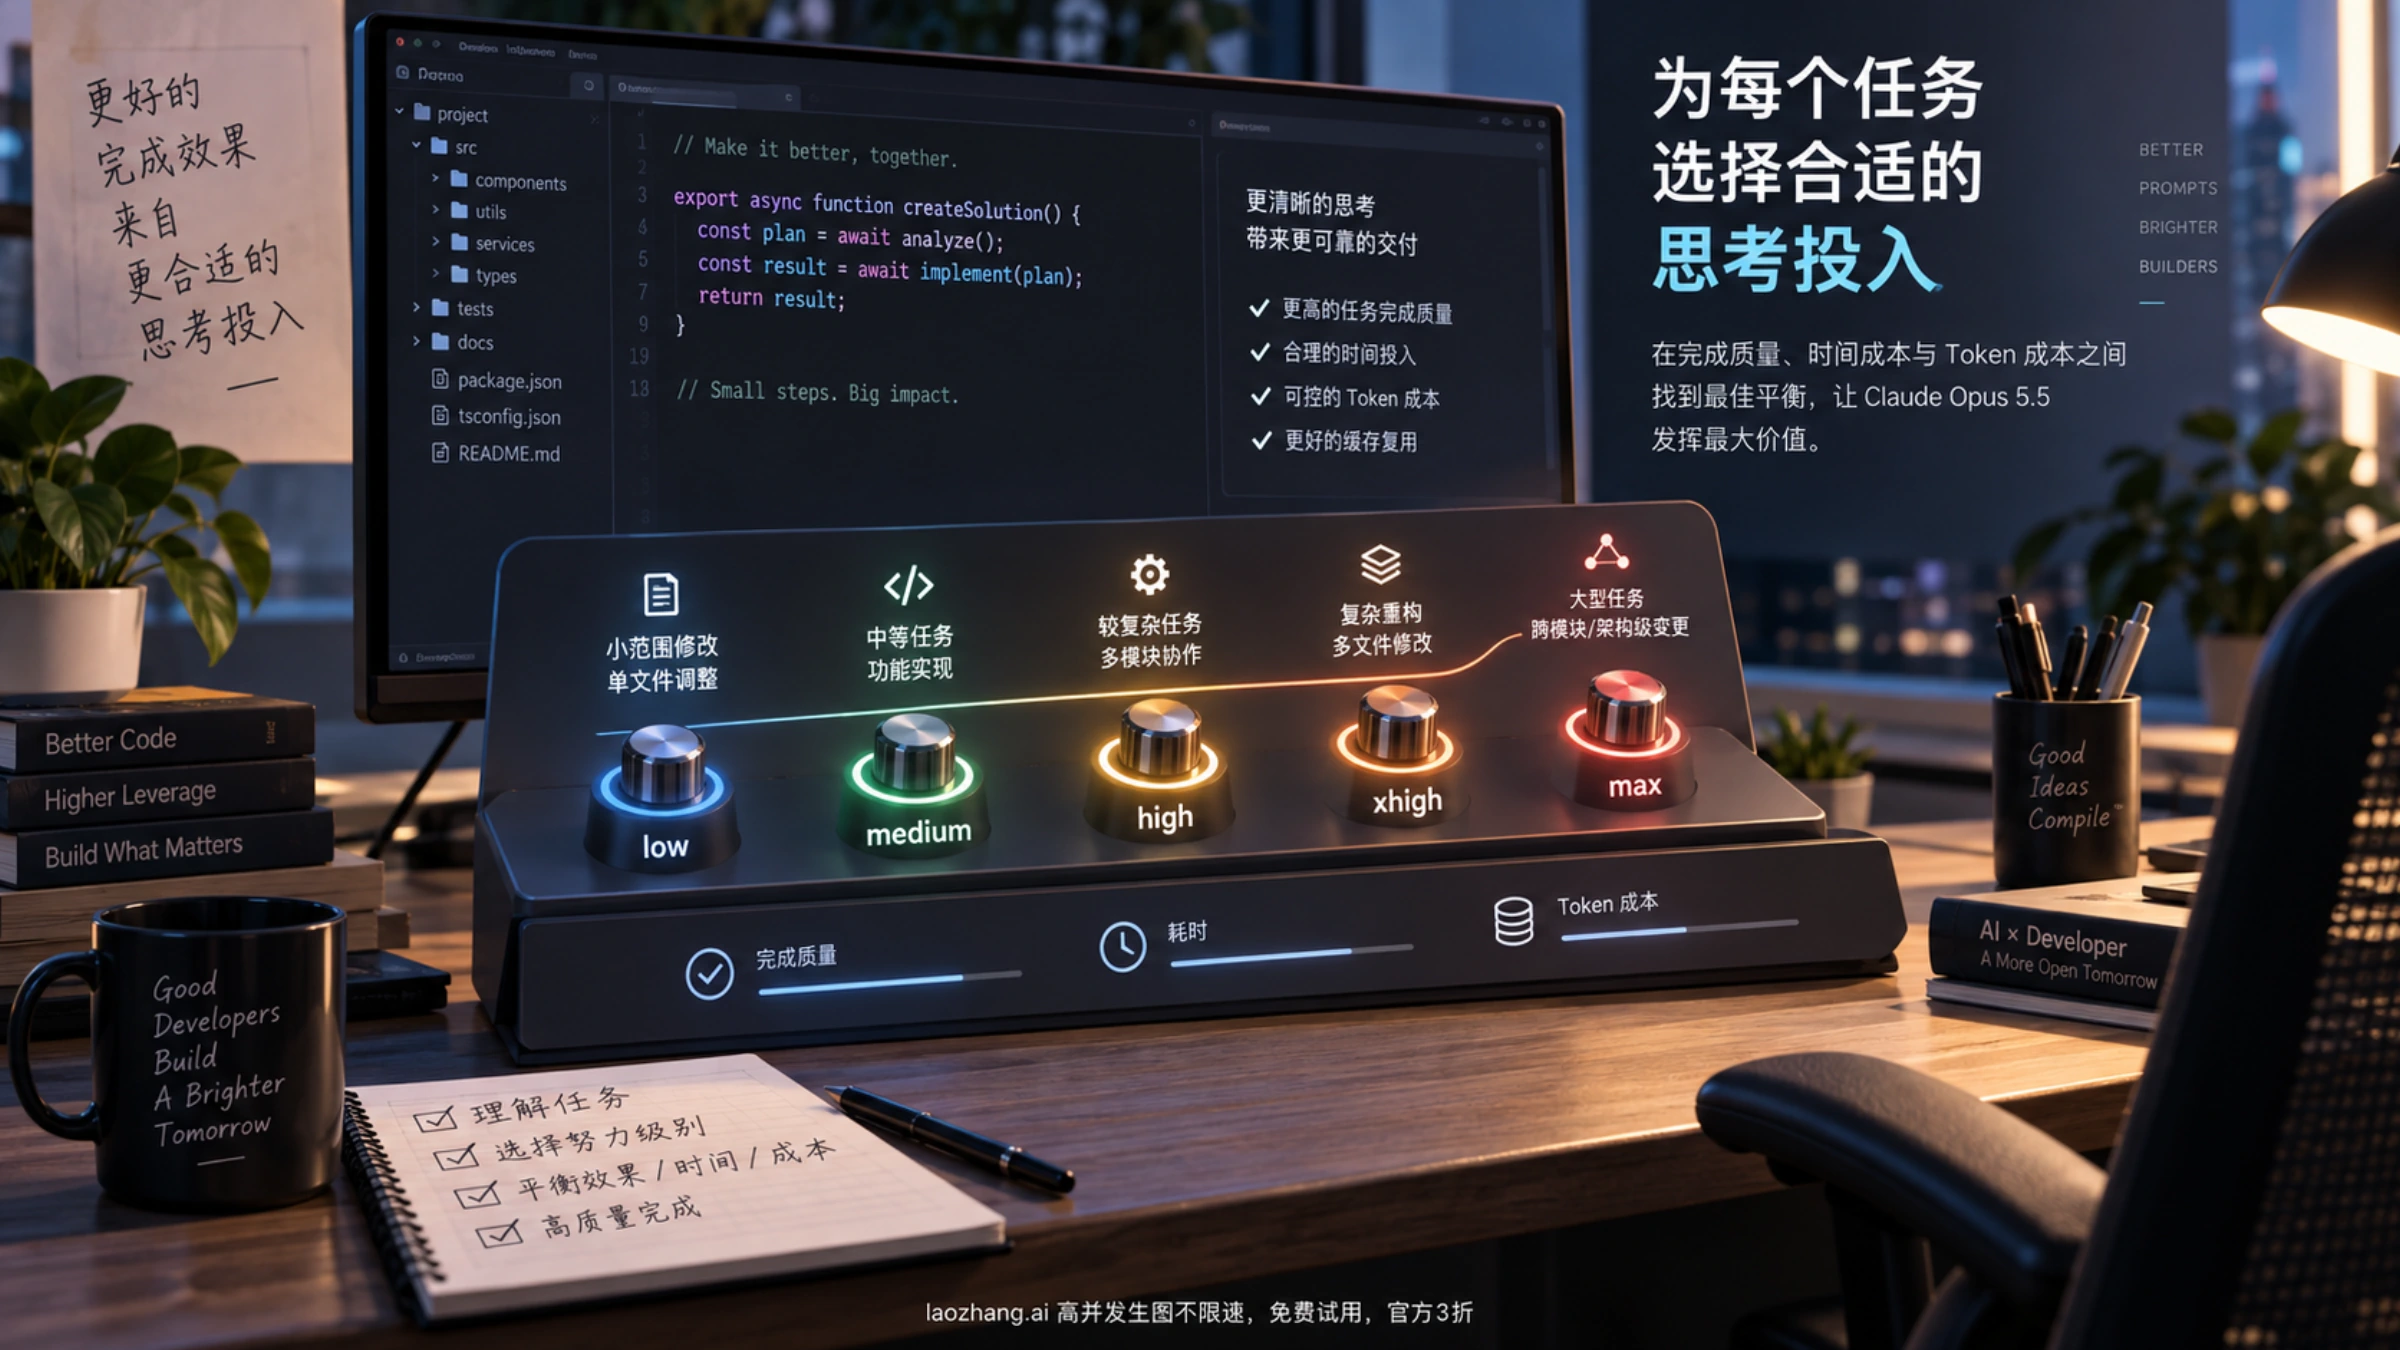
Claude Opus 5.5 的 effort 先用默认的 medium 做基线。 范围清楚、能够运行检查的日常开发任务,可以先看它能否一次完成;跨文件问题反复只修到一层,再试 high。批量机械修改可试 low,长时间、失误代价较高的代理任务再比较 xhigh 与 max。这些是起始选择,不是固定的质量排序或省钱保证。真正要比较的是同一批任务的完成质量、总费用与耗时,而非单轮回答的 Token 数。Anthropic 的 effort 文档也建议针对自己的任务扫档。
如果你在 Claude Code 中操作,先运行 /effort status 看当前档位,再用 /effort high 这样的命令修改;如果你直接调用 Messages API,把 output_config.effort 放在请求中。这两个入口的缓存行为有重要差别,下文分别说明。Opus 5.5 的模型价格、发布时间和迁移兼容项可另看本站的Claude Opus 5.5 概览。
五档分别控制什么
effort 是模型花多少输出 Token 处理请求的行为信号,覆盖最终文字、工具调用以及 adaptive thinking;它不是“最多思考多少 Token”的硬配额。较低档往往更少、更短地调用工具,较高档允许模型更充分地探索,但同一档在简单和困难任务上的实际消耗也会不同。Opus 5.5 支持以下五个准确的参数值,不存在 med 这个值;省略字段等于 medium,而 Opus 5 省略字段时默认是 high。官方档位说明
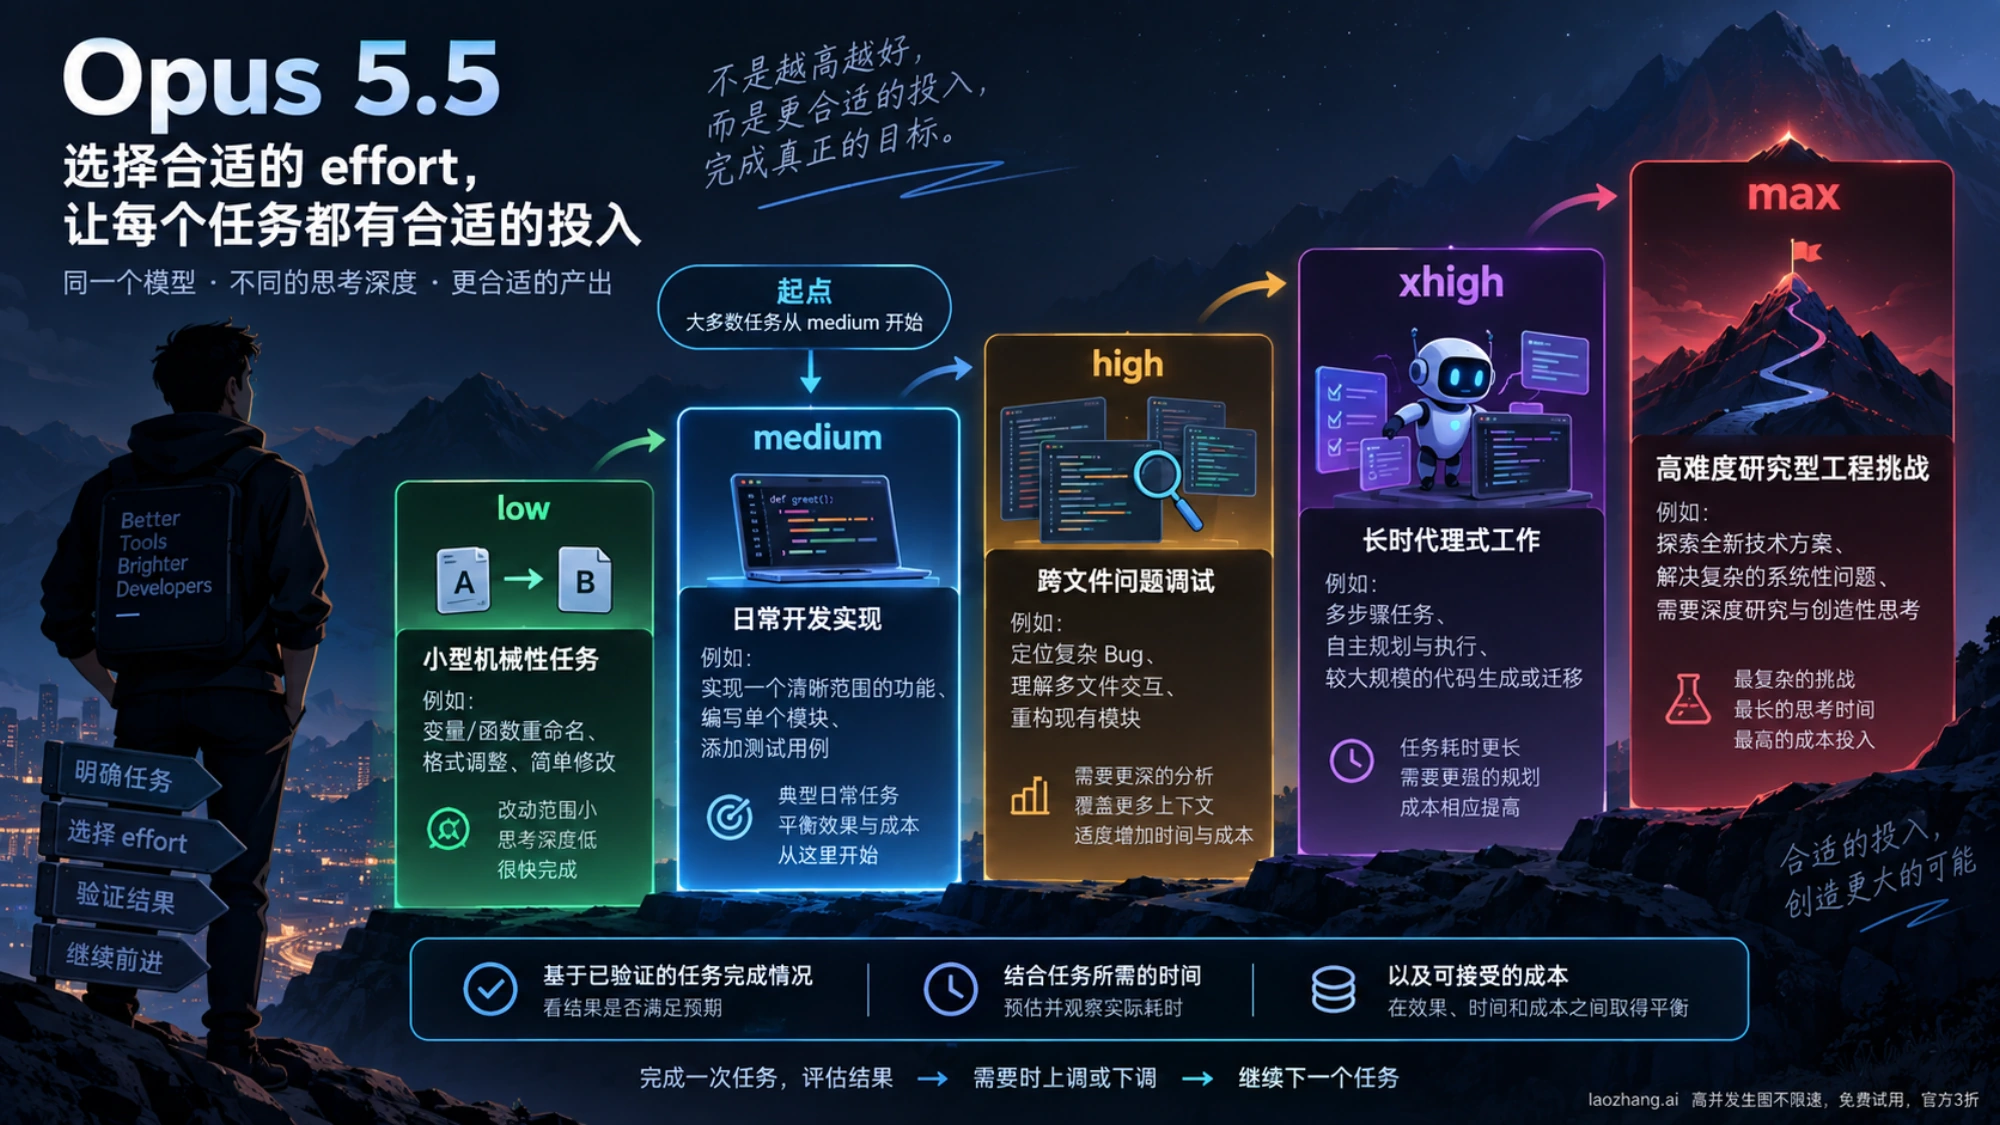
| 档位 | 可以先拿什么任务试 | 看见什么信号再调整 |
|---|---|---|
low | 有明确模式、可自动检查的重命名或小批量机械修改 | 漏改调用处、需要反复解释上下文时回到 medium |
medium(默认) | 范围清楚的日常编码、调试与有监督的代理任务 | 反复只解决局部问题,且检查手段已给足时试 high |
high | 跨文件定位、较难的代码问题与多步工具任务 | 完成率仍不足时再比较更高档;质量已稳定则看时间和费用 |
xhigh | 长时间运行、需要持续探索的代码代理任务 | 相比 high 没有减少失败或返工,就没有充分理由一直保持 |
max | 能从更深入推理中受益、并能承担较高用量的少量难题 | 与 xhigh 的实际完成结果接近时,优先选择成本更低的档位 |
表格是试验顺序,不是模型保证。把旧项目从 Opus 5 升到 Opus 5.5 时,即便代码里都没写 effort,默认档也从 high 变为 medium;反过来,沿用旧项目显式写下的 high 也不等于沿用原来的成本和效果。Anthropic 提醒相同档位在新模型上的思考量可能不同,因此迁移后要重新测。Opus 5.5 更新说明
Claude Code:查看档位、改档以及缓存代价
在使用 Opus 5.5 的 Claude Code 会话里,先输入 /effort status。如果当前任务需要升档,输入 /effort high;要试机械任务的低档,则输入 /effort low。新设置从下一次请求生效。Anthropic 在 Claude Code 的任务成本指南中建议:范围明确的日常任务先用 medium,当它卡住时试 high,机械任务可试 low。遇到一个改名任务只修了服务端、漏了客户端时,先确认代理有机会运行跨层检查;检查本身可能比每轮升档更直接。Claude Code 成本指南
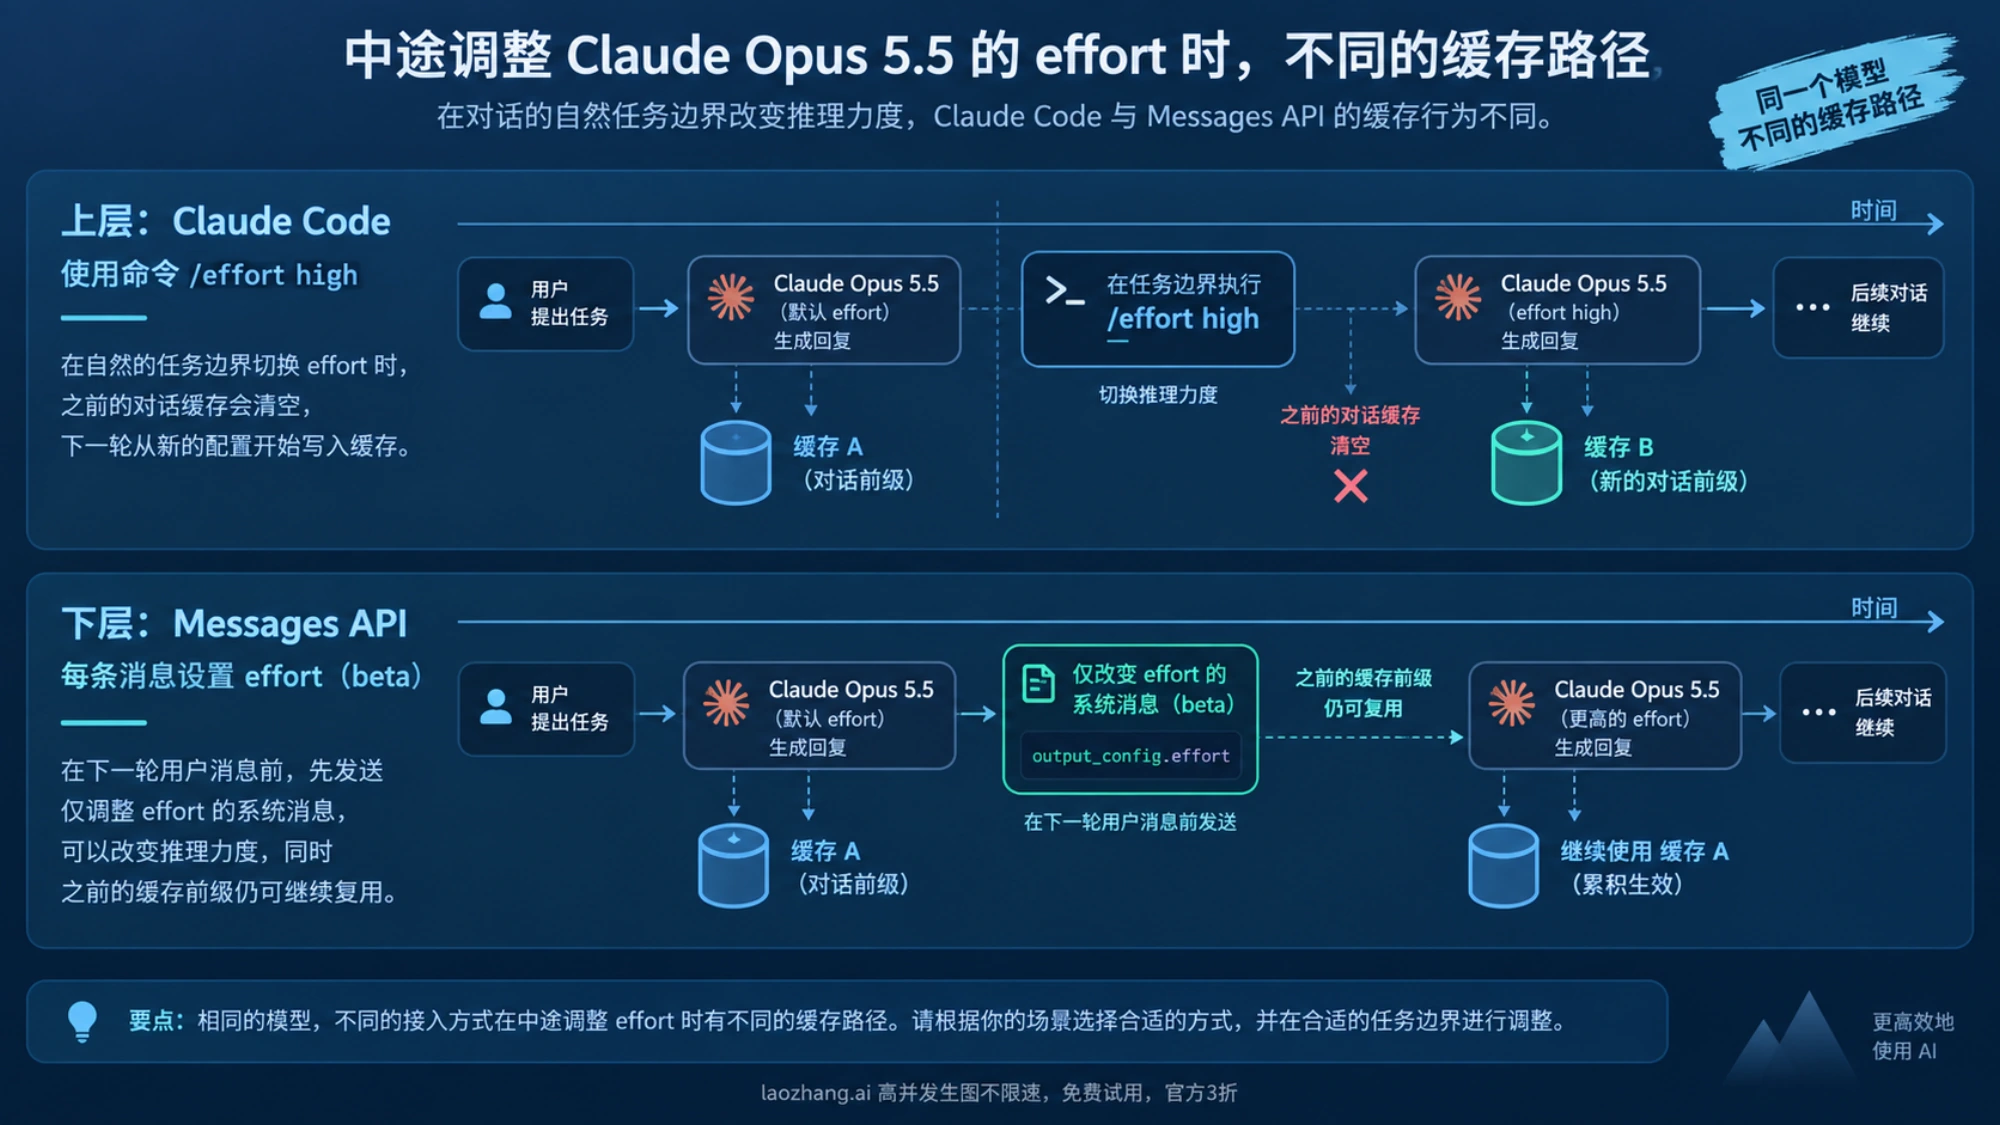
不要在一条长会话里为每一步频繁切档。 Claude Code 改 effort 或 thinking 设置会清除当前会话缓存,下一请求需要重写缓存。长会话已积累大量上下文时,原本为了省输出 Token 的切换,可能增加一次明显的缓存写入费用。较稳妥的做法是在任务开始时选档,或在一个自然的任务间隔调整,再把切换后的费用计入整项任务。官方缓存说明
Claude Code 的 /usage 可查看会话输入、输出、缓存使用及按标价估算的美元费用;订阅用户看到的美元估值是工作量参照,不是套餐账单。比较两种档位时,记下同一任务是否完成、用了多少轮、耗时、输出量和缓存命中情况,再看估算费用,避免把一次缓存失效归咎于模型推理本身。官方测量方法
Messages API:准确字段与请求示例
直接调用 Anthropic Messages API 时,使用 output_config.effort。下面是一个最小 Python 请求;把档位改为另外四个合法值即可做同任务比较。max_tokens 是思考与最终答案合计的输出上限,尤其在高档和长任务中要给足空间;它不是 effort 本身。API 用法与上限说明
pythonimport anthropic

client = anthropic.Anthropic()
response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=8192,
    messages=[{"role": "user", "content": "检查这次接口字段改名需要更新哪些调用方,并说明验证结果。"}],
    output_config={"effort": "medium"},
)

for block in response.content:
    if block.type == "text":
        print(block.text)
示例中的 8192 只是演示值,不是高档任务的通用建议。任务越长,输出和推理越可能撞到上限;出现截断或无法完成时,应先排查 max_tokens 是否太小,再判断是否要升档。Opus 5.5 的 adaptive thinking 始终开启:旧的 thinking: {"type": "disabled"} 或手动预算式 enabled 写法会返回 HTTP 400。应省略 thinking,或按官方文档显式使用 adaptive。Opus 5.5 参数变化
如果一个 API 对话中途需要改档,直接改下一次请求顶层的 output_config.effort 会使之前的缓存前缀无法复用。官方另提供逐消息 effort 的 beta:带 mid-conversation-output-config-2026-07-01 beta header,在消息序列中放入只有 output_config.effort 的 system 消息;新档从下一个 user turn 生效,之前的前缀仍可匹配缓存。这是受支持模型上的 API 机制,不能套用到 Claude Code 的 /effort 命令。逐消息切档说明
升一档究竟值不值:按完成任务算
判断档位时,先挑几类你实际会交付的任务:例如有测试覆盖的局部修复、跨文件字段改名、需要多轮查证的故障定位。每一类保持任务描述、可用工具、验收标准和计费口径一致,分别运行 medium 与相邻档;机械任务再比较 low,真正复杂的任务再比较 xhigh 或 max。逐项记录是否通过验收、需要人工返工几次、总耗时,以及普通输入、输出、缓存读写 Token。完成任务成本 = 同一组任务的总费用 ÷ 通过验收的任务数;只有同时看分母,才不会把“少花 Token 但没做完”误判为便宜。
以 Anthropic 直连 API 的标准美元标价为例,Opus 5.5 普通输入每百万 Token $4、输出 $20、缓存读取 $0.20,五分钟缓存写入 $5、一小时缓存写入 $8。假设一次任务使用 10 万普通输入、2 万输出、50 万缓存读取和 10 万五分钟缓存写入,则费用为 0.1×4 + 0.02×20 + 0.5×0.20 + 0.1×5 = $1.40。这是固定用量的算术示例,不是任何档位的实测费用;换档会改变 Token 用量、轮数与缓存状态。云平台、转售商、税费和其他功能费用也可能不同。Opus 5.5 价格表
独立评测可提供起点,但不能替代你的项目数据。Artificial Analysis 的 Intelligence Index v4.3.2、默认 fallback 条件下,五档的综合得分与每项加权基准任务费用分别是:low 42/$0.55,medium 51/$1.34,high 54/$1.82,xhigh 56/$3.46,max 58/$5.98。这里的美元数是该评测任务的平均成本,不是“你的每次 API 请求要付这么多”,分数也不代表每个仓库任务都按同样幅度变好。low、medium、high、xhigh、max
因此,max 不应成为“难题总是更好”的默认答案:这组评测从 xhigh 到 max 增加了 2 分,也提高了评测任务费用,但你的成功率是否因此上升仍需实测。反过来,如果 medium 常因漏读依赖而返工,high 多用的 Token 可能换来更少的重试和更低的完成任务成本。先定义任务怎样算做完,再决定为哪种失败升档,才有可复核的结论。