预算优先,而且结果容易检查,可以先试 GPT-6.1 Terra;如果工作涉及复杂代码、长时间调查或高成本返工,值得优先把 Claude Opus 5.5 纳入对照。 前者的直接 API 单价较低,后者在 Artificial Analysis 的指定设置综合评测中得分更高。这个判断适合决定先试谁,还不足以替你决定所有任务都用谁。OpenAI 定价、Anthropic 定价和 AA 对比页分别支持费用与评测差异。
如果主要工作是看截图、理解图纸或操作网页,Terra 的官方定位与这些任务直接相关,值得先放进现有流程试跑;目前这组英语文本综合榜单不能判定它与 Opus 谁更擅长你的电脑操作。中文写作同样需要拿自己的材料比较。本文依据截至 2026 年 10 月 28 日的官方文档和第三方评测,未进行两款模型的中文或业务任务实测。Terra 模型说明
先确认型号和入口,避免比较错对象
这里的 OpenAI 模型是 GPT-6.1 Terra,API 标识为 gpt-6.1-terra;另一款是 Claude Opus 5.5,Claude API 标识为 claude-opus-5-5。GPT-6.1 Sol 和 GPT-5.6 Terra 都是其他模型,不能把它们的测试或报价直接移到这组比较里。Terra 规格、Opus 5.5 规格
还要区分两种使用方式:
- 订阅产品内使用:先看自己的账户能否选择模型、工具是否可用、额度是否够完成工作。Terra 已列入 ChatGPT Work 和 Codex 的 Plus、Pro、Business、Enterprise、Edu 方案,不在 Chat 中提供;Enterprise 还受工作区与管理员设置影响。浏览器和电脑操作各有接入条件,产品列表不代表所有地区账户都可用。官方产品更新
- 开发者直接调用 API:按实际输入、输出、缓存及其他计费项目结算。下面的美元报价只比较厂商直接 API,不是 Claude 或 ChatGPT 的月费,也不能换算成订阅套餐能发送多少条消息。
已经订阅其中一个产品的人,先用套餐内实际可选的模型完成同一项工作,通常比根据 API 单价决定换订阅更有参考价值。本文没有核验各套餐的固定额度,也不承诺中国地区账户的可用性。
API 价格:普通请求相差四倍,长输入会缩小价差
在 Standard 模式、输入不超过 272,000 token 时,Terra 的输入、输出和缓存命中单价均为 Opus 5.5 的四分之一。以下单位统一为美元/百万 token,是截至 2026 年 10 月 28 日的直接 API 标价;输出包含计费的内部推理。OpenAI 价格表、Anthropic 价格表
| 计费项目 | GPT-6.1 Terra:输入 ≤272K | GPT-6.1 Terra:输入 >272K | Claude Opus 5.5:完整 1M 上下文 |
|---|---|---|---|
| 未缓存输入 | $1 | $2 | $4 |
| 输出 | $5 | $7.50 | $20 |
| 缓存命中 | $0.05 | $0.10 | $0.20 |
关键是 Terra 超过 272K 输入后,较高费率适用于整次请求:输入及缓存费率乘以 2,输出费率乘以 1.5。并非只给超过门槛的那部分 token 加价。Opus 5.5 的完整 1M 上下文按标准单价收费,没有这项长上下文附加费。Terra 定价说明、Claude 长上下文定价
用相同用量算一次,价差才有可比性
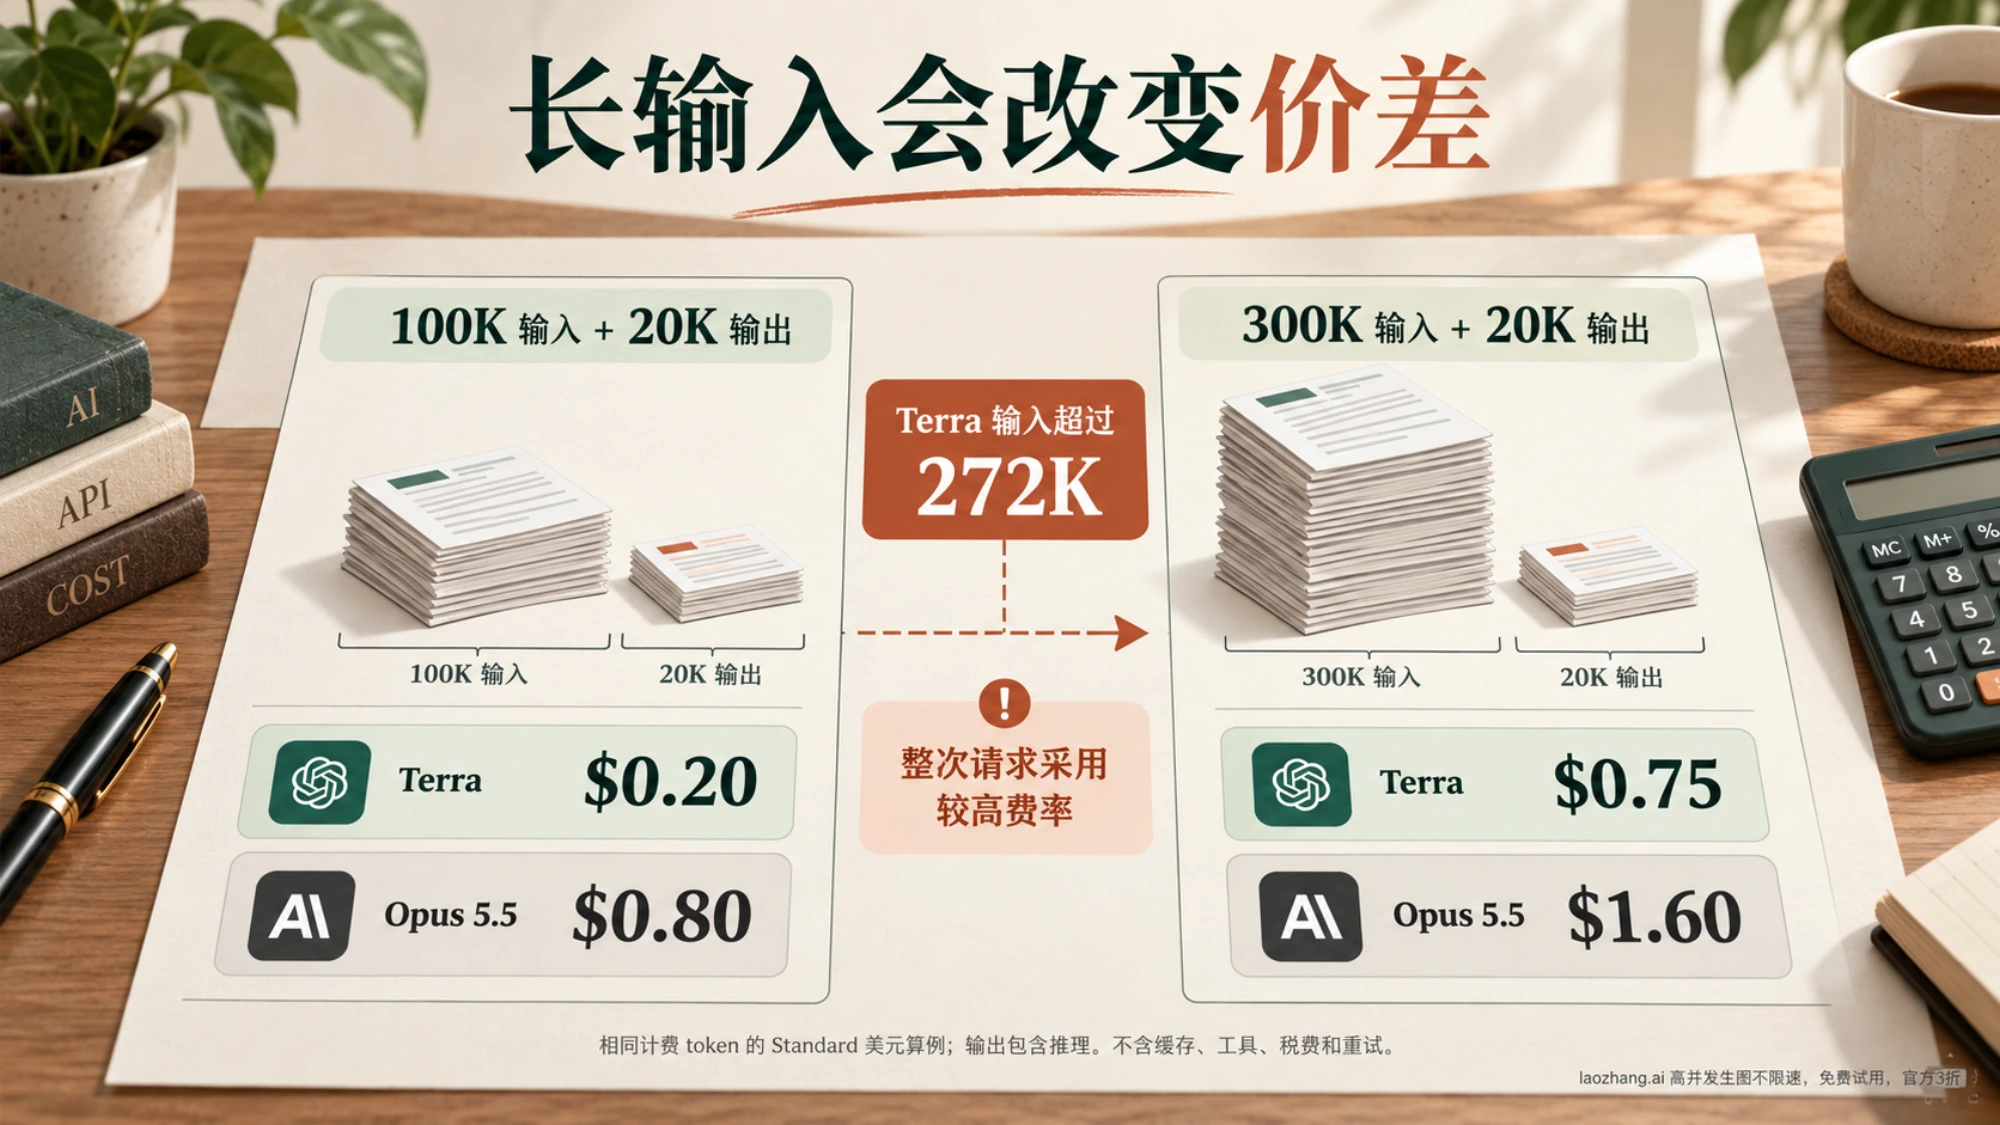
没有缓存及其他费用时,计算式为:输入 token ÷ 1,000,000 × 输入单价 + 输出 token ÷ 1,000,000 × 输出单价。这里的输出是 API 返回的计费输出总数,包含内部推理,不只是读者看到的回答文字。OpenAI 推理计费、Claude 思考计费
按上述官方 Standard 费率计算:
| 单次请求的假设用量 | Terra 费用 | Opus 5.5 费用 |
|---|---|---|
| 10,000 输入 + 2,000 输出 | $0.02 | $0.08 |
| 100,000 输入 + 20,000 输出 | $0.20 | $0.80 |
| 272,000 输入 + 20,000 输出 | $0.372000 | $1.488000 |
| 272,001 输入 + 20,000 输出 | $0.694002 | $1.488004 |
| 300,000 输入 + 20,000 输出 | $0.75 | $1.60 |
这些是相同计费 token 用量的算例,不含缓存、工具、税费、地区附加费或重试,不能当作实际任务报价。门槛两侧的例子说明:仅增加一个输入 token,也可能使 Terra 整次请求进入较高费率。30 万输入的例子中 Terra 仍较便宜,但费用已不再是 Opus 的四分之一。
同一份文档交给两款模型,不一定产生相同 token 数;推理强度、回答长度及重试次数也会改变总量。若一次失败后必须重做,账单应把前一次请求一起计入,而不能只看最后那条成功回答。
缓存、批处理和快速模式要分别比较
表里的“缓存命中”不等于缓存写入。Terra 短输入下的 30 分钟、12 小时缓存写入分别为 $1.25、$2.50/百万 token;Opus 的 5 分钟、1 小时写入分别为 $5、$8。保留时间不同,不适合只拿一列价格判断谁的缓存方案更划算。OpenAI 缓存价格、Claude 缓存价格
如果工作可以异步处理,两款模型的 Batch 输入、输出价格均比各自 Standard 低 50%;Fast 模式则是另一套价格,不能拿一方的 Batch 与另一方的 Standard 比。实际选型时先统一处理模式,再计算自己的用量。OpenAI 模式定价、Claude 模式定价
Opus 的评测分更高,为什么还不能直接宣布胜出
在 2026 年 10 月 28 日读取的 Artificial Analysis Intelligence Index v5.0 中,GPT-6.1 Terra(High)为 42,Claude Opus 5.5(Max, Default Fallback)为 58。这是第三方发布的结果,不是本站测试;两者使用的推理设置不同,也不能据此认定计算预算相同。Terra 测试页面、Opus 测试页面
这套指数以英语文本任务为主,综合知识工作、编程、科学与其他测试。因此,它可以作为“是否值得用 Opus 检验难任务质量”的依据,却不能把 58 解释为 58% 的业务成功率,也不能据此判断中文文案、看图或桌面操作谁更好。AA 指数方法
同一组设置还给出 $0.26 与 $10.04 的每任务成本。这里的“任务”是 AA 评测任务:根据各评测的 token 费用及任务数计算,再按指数权重汇总,包含缓存处理。它既不是修好一个线上故障的报价,也不是每个成功交付结果的平均费用。AA 成本方法、Terra 结果、Opus 结果
这就解释了为什么“单价相差四倍”和“某套评测的任务成本差很多”可以同时成立:模型在不同设置下消耗的推理与答案 token 并不相同。不能从这两个数字推算你公司的失败率或节省比例。
速度也要看测量对象。AA 当时记录的输出速度为 Terra 90.9、Opus 98.4 标准化 token/秒,衡量开始输出后的接收速率;其默认测试条件包括约 10K 输入、美国节点及滚动 72 小时中位数。该快照不能代表中国用户的订阅体验,也没有回答谁更早交付一份可用结果。AA 性能方法、两款模型对比
按工作内容选择先试谁
下面是基于已确认价格、能力定位与评测范围的试用顺序建议,不是未经测试的胜率排名。
| 你的主要工作 | 建议先怎么试 | 什么结果会改变选择 |
|---|---|---|
| 批量提取、常规草稿、规则明确的小改动 | 先试 Terra,确认较低单价能否转化成较低交付成本 | 经常漏项、返工或需要大量人工重写时,再与 Opus 比较总投入 |
| 难复现的代码问题、跨文件修改、长时间调查 | 把 Opus 纳入优先对照,同时保留 Terra 的费用基线 | Opus 没有减少关键错误或返工,就缺少为价差买单的理由 |
| 截图理解、图纸阅读、网页或桌面多步骤操作 | 先在支持相关工具的环境里试 Terra,再用同一流程对照 Opus | 需要检查最终页面或文件是否正确,不能只看模型口头说“已完成” |
| 中文写作、品牌文案、中文资料整理 | 给两款相同资料和读者要求,按成稿质量选择 | 专名、事实、语气或篇章衔接不合要求,应计入修改时间 |
| 已深度接入某一平台的工具链 | 先验证当前平台的模型与参数,再考虑跨平台切换 | 换模型导致工具、历史消息或权限流程失效时,应先处理兼容性 |
Terra 的官方说明明确列出图像理解、技术图纸、应用屏幕操作及文本写作;Opus 5.5 的官方定位侧重长时间运行的编程代理与知识工作。这些定位有助于挑选测试场景,但厂商定位本身不等于两款模型的直接实测结论。Terra 官方说明、Opus 官方说明
切换前,先看工具和推理设置是否兼容
两款模型都接受文本与图片、原生输出文本。Terra 的上下文窗口为 1,050,000 token,最大输入 922,000、最大输出 128,000;Opus 5.5 的上下文窗口为 1M,常规最大输出为 128K。上下文容量说明能容纳多少内容,不能证明长文档中的每个细节都能被准确利用。Terra 规格、Opus 规格
对自建程序,更直接的区别在调用方式:
- Terra:工具调用要求使用 Responses API;
reasoning.effort支持none、low、medium、high、xhigh、max,默认medium。如果原来只按普通聊天接口封装工具流程,先核对接口再换模型。Terra API 说明 - Opus 5.5:adaptive thinking 始终启用,默认 effort 为
medium。旧的手动 thinking 开关和budget_tokens写法不适用;强制tool_choice为any或指定工具会返回 400。thinking 历史还与模型、对话相关。Opus 5.5 兼容变化
因此,“都支持工具”并不代表替换模型 ID 就能保留全部行为。测试时至少要走完一次工具调用、工具结果回传和后续对话。若已经决定从旧 Opus 升级,可继续查看本站的 Opus 5.5 迁移检查项,处理 thinking、工具选择与历史消息的具体变化。
用一次小规模对照,决定是否值得长期切换
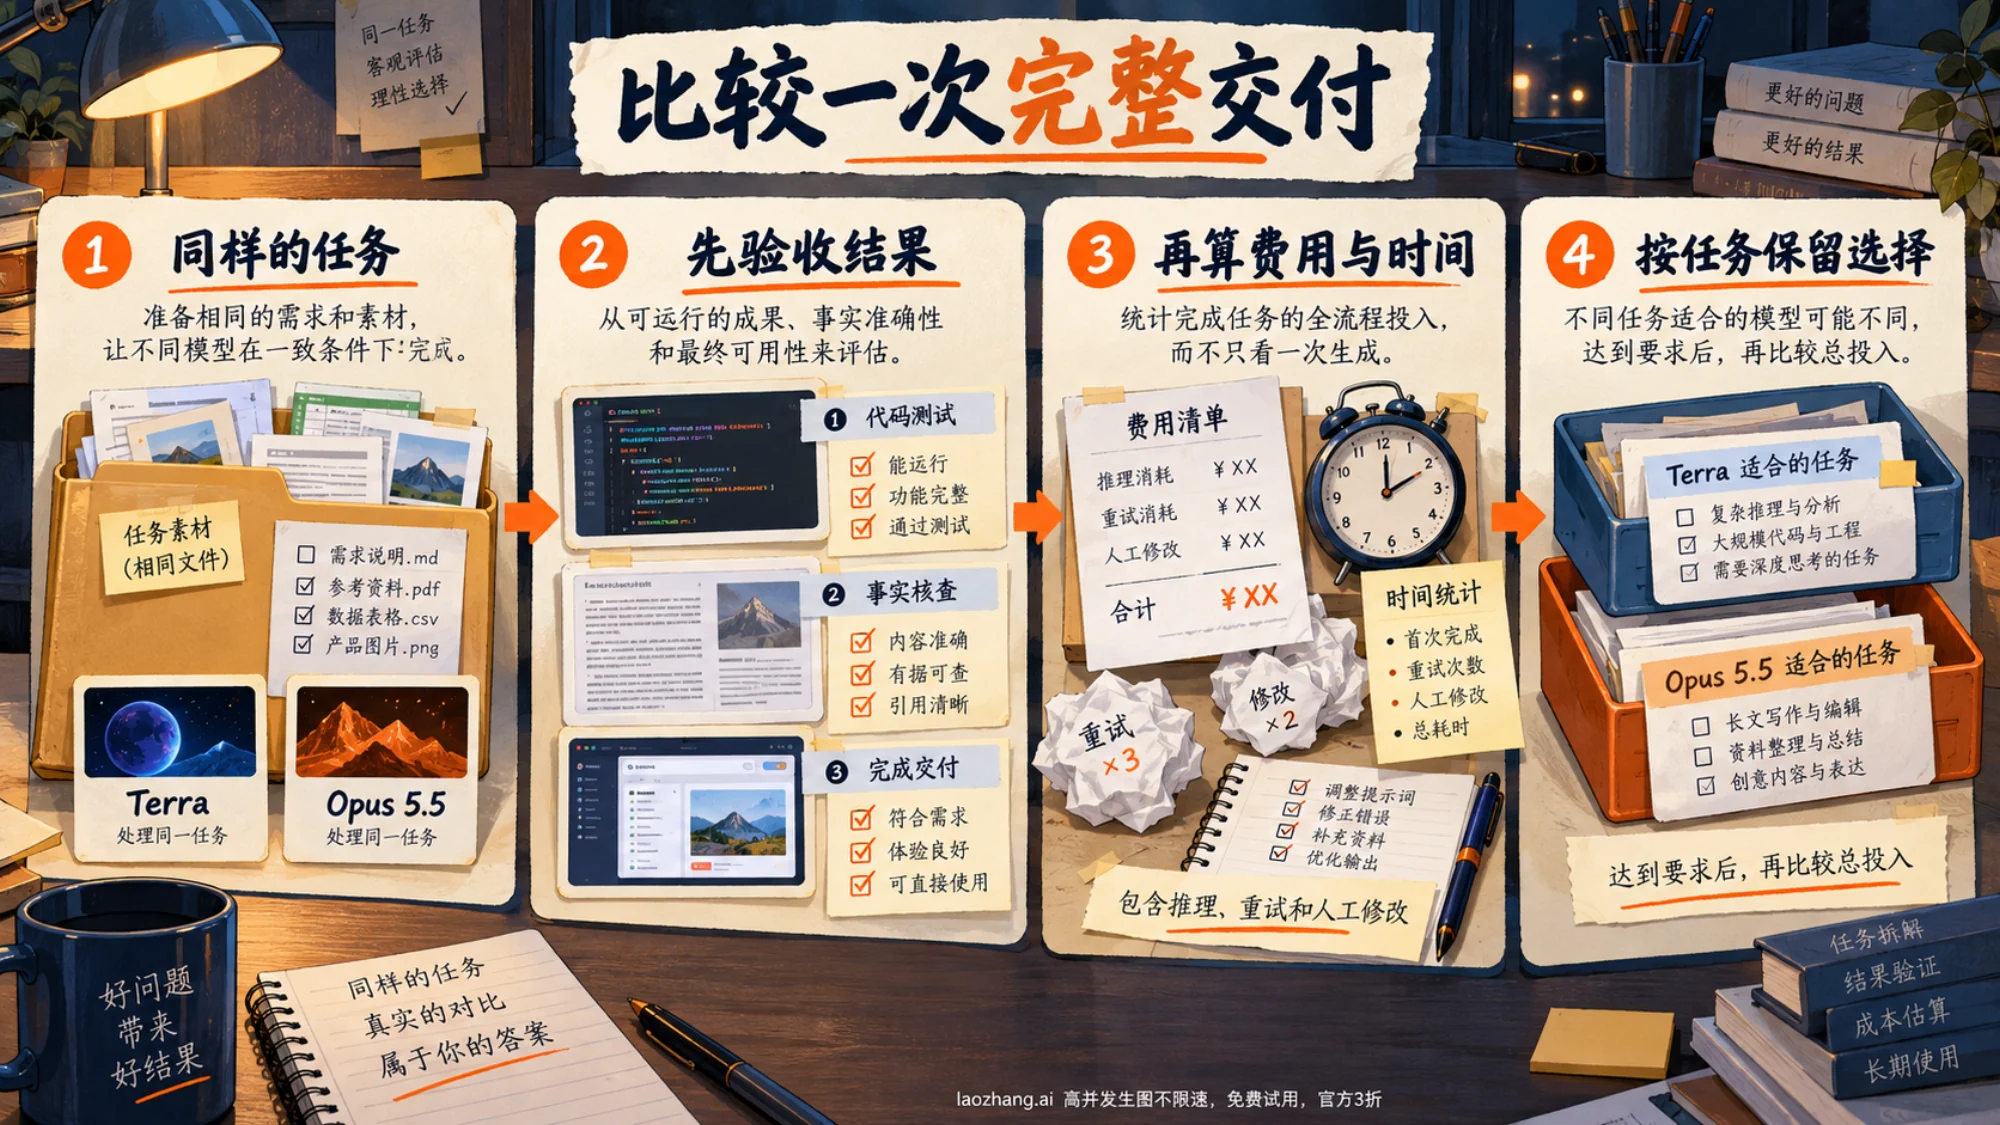
选一组你已经知道怎样验收的真实任务,普通任务和容易失败的任务都要有。让两款模型使用相同原始资料、工具权限和交付要求,记录模型 ID、推理档位及产品或 API 入口;不要把 AA 的 High/Max 设置当成两边相同的“默认模式”。
随后按顺序记录:
- 先判定完成质量。代码看功能与相关测试,资料提取看关键字段,电脑操作看目标状态,写作看事实和读者要求。未达到标准的结果不要计为完成。
- 再算完整花费。API 记录输入、缓存和总输出 token,计入重试;订阅产品则记录是否触及额度以及由此产生的等待。内部推理已包含在计费输出总数中,不能把明细再加一遍。
- 记录到可用结果的时间。包括思考、工具操作、重试和人工修改;流式输出更快不一定更早完成工作。
- 按任务类型保留结果。如果 Terra 已达到要求且总投入较低,就保留它;如果 Opus 在难任务上减少了足以抵消费差的返工,可只把这类任务交给 Opus。无需为了统一模型而忽略两种任务的差异。
API 的推理明细可分别查看 OpenAI 的 usage.output_tokens_details.reasoning_tokens 与 Claude 的 usage.output_tokens_details.thinking_tokens;两者都是输出总数的拆分,不是另收一遍的 token。OpenAI 用量说明、Claude 用量说明
常见问题
GPT-6.1 Terra 是 Opus 5.5 价格的四分之一吗?
在直接 API 的 Standard 模式、Terra 输入不超过 272K、比较相同计费类别和相同 token 用量时,输入、输出与缓存命中单价确实都是四分之一。超过 272K 后 Terra 整次请求采用较高费率;真实任务的推理、输出与重试用量也可能不同,因此不能保证总账单固定便宜 75%。OpenAI 定价、Anthropic 定价
哪款更适合写中文?
现有这组证据不能确认中文写作赢家。AA Intelligence Index 以英语文本任务为主,不能代替中文成稿比较。实际选择时,用同一份材料检查事实、语气、逻辑与修改时间,比只比较综合分更贴近写作需求。AA 评测范围
在 ChatGPT 的 Chat 里找不到 Terra,正常吗?
按 2026 年 10 月 28 日核验的官方说明,Terra 提供于 ChatGPT Work 和 Codex,不在 Chat 中提供。具体账户还受方案、工作区及访问条件影响,不能仅凭订阅名称推定一定可用。官方可用性说明