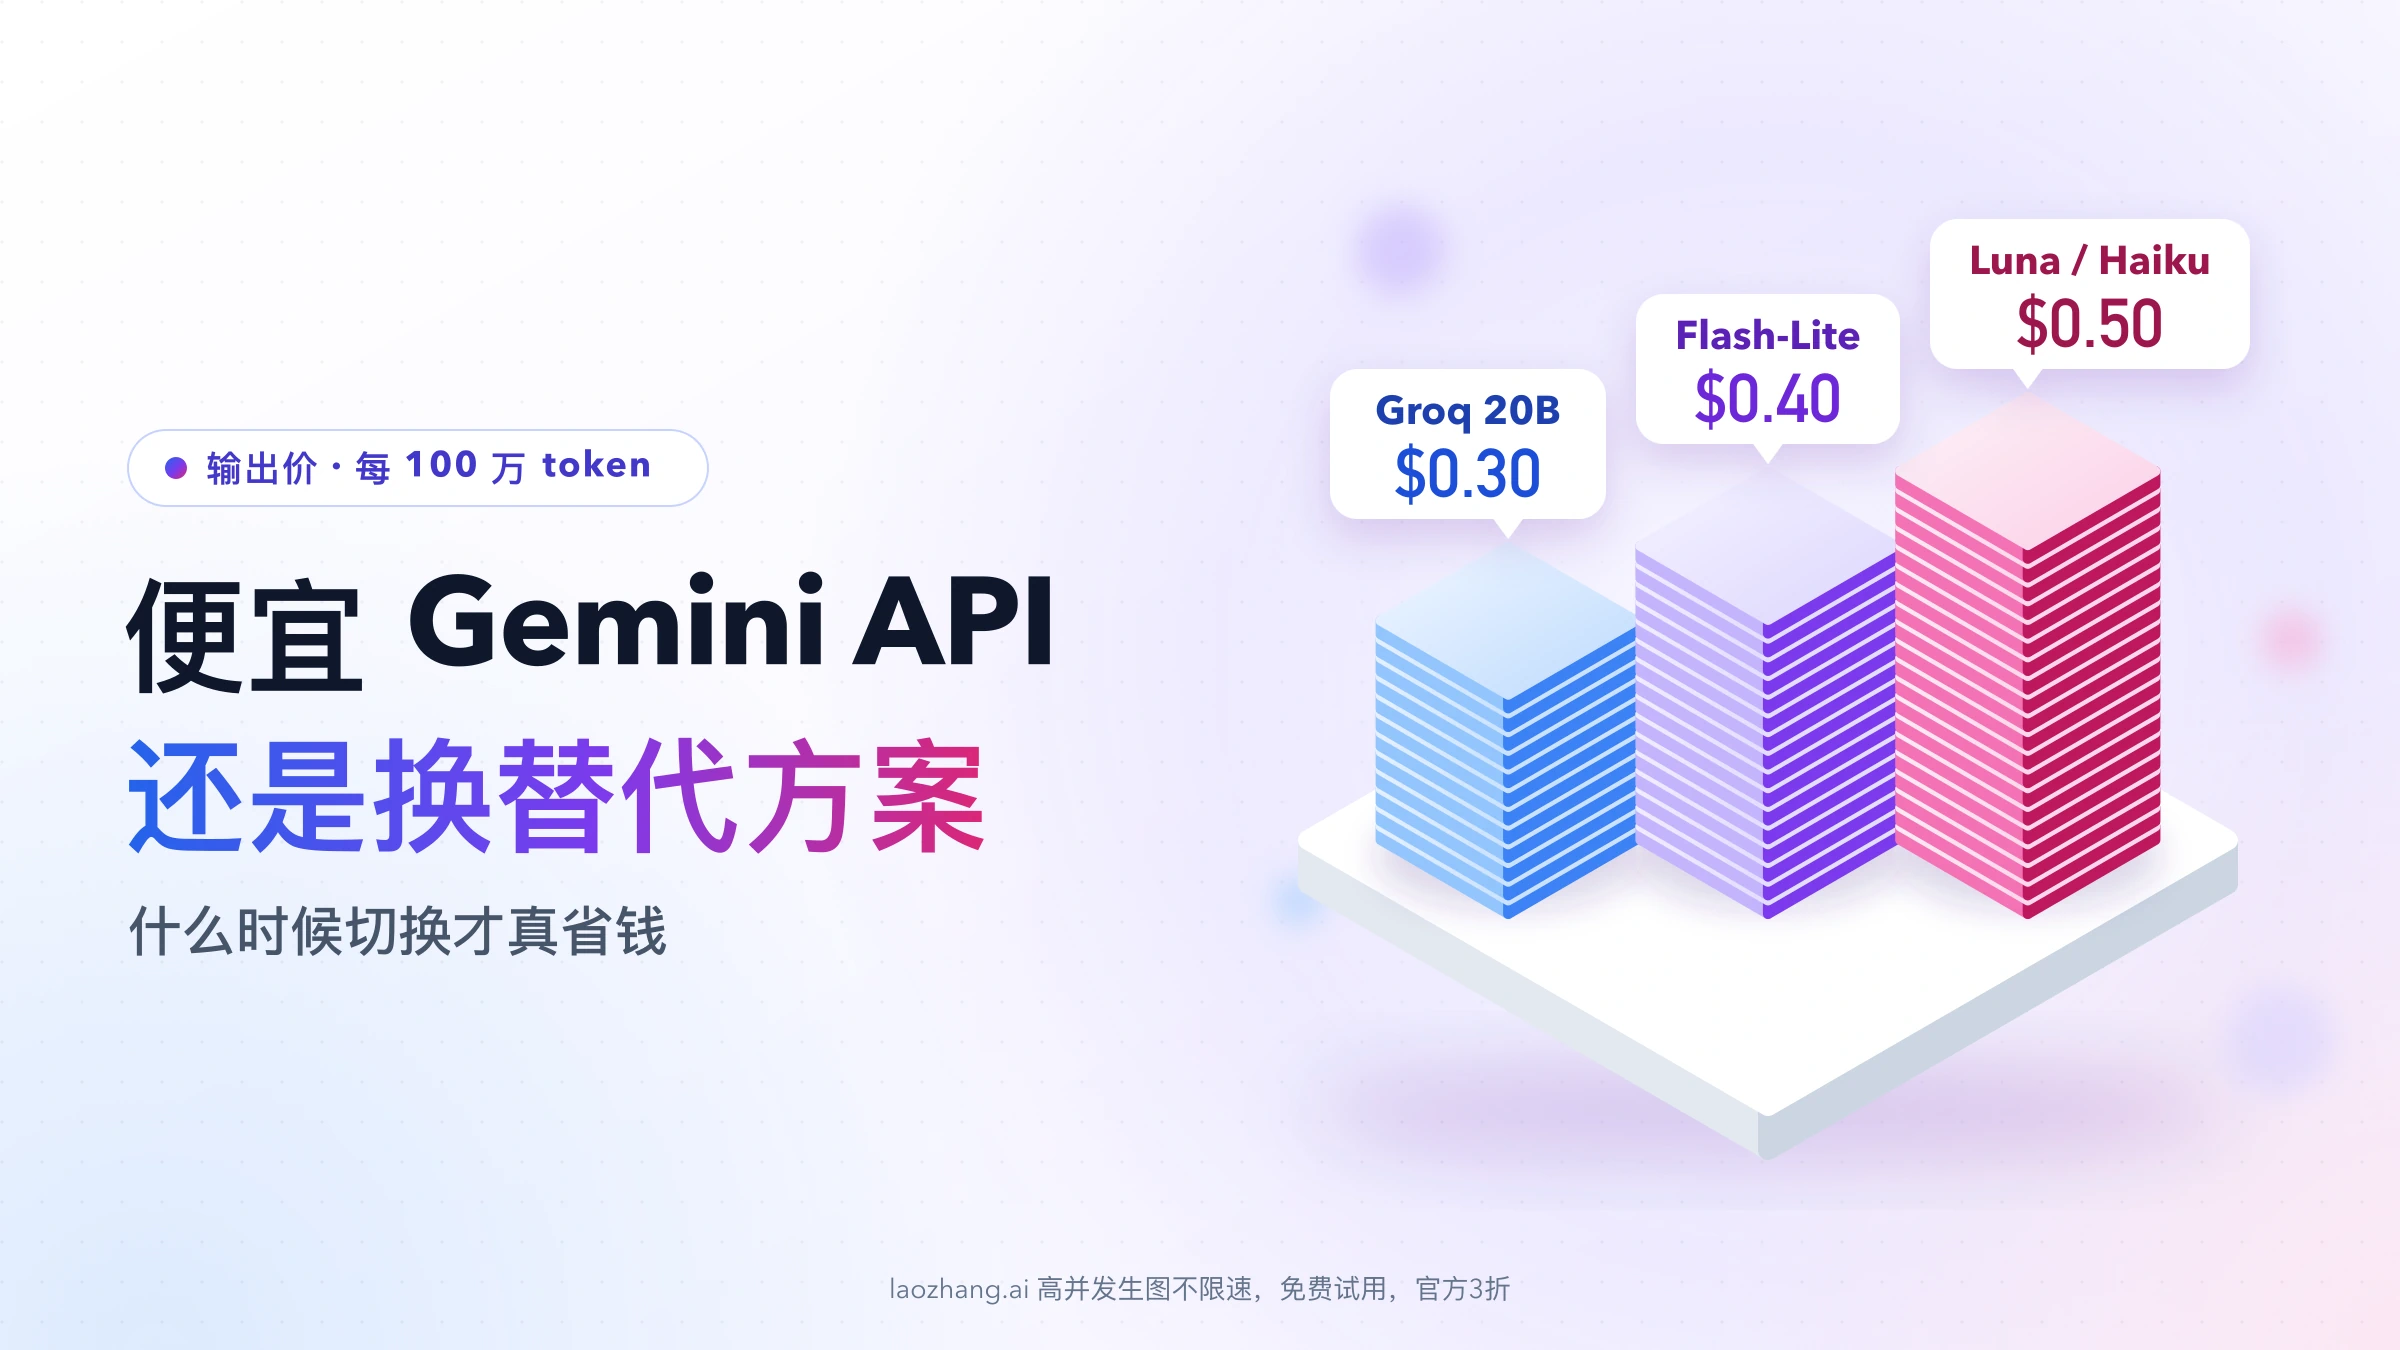
截至 2026 年 10 月 8 日,如果你已经在用 Gemini 2.5 Flash-Lite(每 100 万 token 输入 $0.10、输出 $0.40),换到别家基本省不了钱:GPT-6 Luna 和 Claude Haiku 5.5 输入同价、输出每 100 万 token 贵 $0.10;DeepSeek V4.1-Flash 和 Mistral Small 4 两头都更贵;按标价更便宜的只有 Groq 上的 GPT OSS 20B,同样的负载大约省四分之一。
真正多花钱的,往往是用 Gemini 3.x Flash 或 3.1 Flash-Lite 跑本可以交给 2.5 Flash-Lite 的分类、抽取、摘要(前提是你以前用过 2.5;如果用不了 2.5,Gemini 里最便宜的是 3.1 Flash-Lite)。这种情况先在 Gemini 内部换型号,省得最多,也几乎没有迁移成本。会改变结论的条件主要有四个:输出占比、单次提示长度、能否走 Batch 或缓存,以及你所在的地区能不能直接用这些官方 API。
便宜 Gemini API 和替代方案价格表(截至 2026 年 10 月 8 日)
下表都是各家官方标准价,单位是美元 / 100 万 token,文本输入。模型名链接到对应的官方价格或模型页面。
| 模型 | 标准价:输入 / 输出 | 折扣或缓存 | 会改变价格的条件 |
|---|---|---|---|
| Gemini 2.5 Flash-Lite(以前用过 2.5 的用户) | $0.10 / $0.40 | Batch、Flex $0.05 / $0.20 | 不随提示长度变价;音频输入 $0.30 |
| Gemini 3.1 Flash-Lite | $0.25 / $1.50 | Batch、Flex $0.125 / $0.75 | 比 2.5 Flash-Lite 新,但更贵 |
| Gemini 3.5 Flash-Lite | $0.30 / $2.50 | Batch、Flex $0.15 / $1.25 | 与 Gemini 2.5 Flash 同价 |
| Gemini 3.6 / 3.8 Flash | $0.75 / $3.75 | Batch、Flex 半价 | 2027 年 1 月 1 日起 $1.50 / $7.50;3.7 Flash 已弃用,请求转到 3.8 Flash |
| GPT-6 Luna | $0.10 / $0.50 | Batch、Flex 半价;缓存输入 $0.01 | 输入超过 27.2 万 token,整个请求按 $0.20 / $0.75 |
| Claude Haiku 5.5 | $0.10 / $0.50 | Batch 半价;缓存读取 $0.01 | 提示超过 10 万 token,所有单价 ×5($0.50 / $2.50) |
DeepSeek V4.1-Flash(deepseek-flash) | 闲时 $0.15 / $0.60,高峰 $0.30 / $1.20 | 缓存命中 $0.003–$0.006 | 高峰为周一至周五 UTC 01:00–04:00、06:00–10:00 |
| Mistral Small 4 | $0.15 / $0.60 | — | 接替已退役的 Mistral Small 3.2 |
| Groq GPT OSS 20B | $0.075 / $0.30 | — | 同平台 GPT OSS 120B 为 $0.15 / $0.60 |
几条旧价格已经不能再用:Mistral Small 3.2 在 2026 年 7 月 31 日退役,由 Small 4 接替;Groq 上的 Llama 3.1 8B 和 Llama 3.3 70B 改为企业版"联系销售",不再公开标价;DeepSeek 的旧模型名现在由 V4.1-Flash 提供服务,过去的 V3.2 价格不再适用;Claude Haiku 4.5($1 / $5)已是旧型号,Anthropic 当前的低价型号是 Haiku 5.5。
同样 100 万输入加 20 万输出,各家要花多少钱
单价表不容易直接看出差距,换成同一份负载更清楚。计算方式:
费用 = 输入 token(百万)× 输入单价 + 输出 token(百万)× 输出单价
示例假设:标准价、不走缓存,总共 100 万输入 token、20 万输出 token(输入输出约 5 : 1,接近摘要、抽取、分类类任务),每个请求的提示都在 10 万 token 以内。
| 模型 | 算式 | 费用 | 相对 2.5 Flash-Lite |
|---|---|---|---|
| Groq GPT OSS 20B | $0.075 + 0.2 × $0.30 | $0.135 | 低 25% |
| Gemini 2.5 Flash-Lite(以前用过 2.5 的用户) | $0.10 + 0.2 × $0.40 | $0.18 | 基准 |
| GPT-6 Luna | $0.10 + 0.2 × $0.50 | $0.20 | 高约 11% |
| Claude Haiku 5.5 | $0.10 + 0.2 × $0.50 | $0.20 | 高约 11% |
| Mistral Small 4 | $0.15 + 0.2 × $0.60 | $0.27 | 高 50% |
| DeepSeek V4.1-Flash(闲时) | $0.15 + 0.2 × $0.60 | $0.27 | 高 50% |
| DeepSeek V4.1-Flash(高峰) | $0.30 + 0.2 × $1.20 | $0.54 | 3 倍 |
| Gemini 3.1 Flash-Lite | $0.25 + 0.2 × $1.50 | $0.55 | 约 3.1 倍 |
| Gemini 3.8 Flash(2026 年内价格) | $0.75 + 0.2 × $3.75 | $1.50 | 约 8.3 倍 |
| Gemini 3.8 Flash(2027 年起) | $1.50 + 0.2 × $7.50 | $3.00 | 约 16.7 倍 |
最后一列以 2.5 Flash-Lite 为基准,只适用于以前用过 2.5 的用户。用不了 2.5 时,基准换成 3.1 Flash-Lite 的 $0.55:Groq GPT OSS 20B 低约 75%,GPT-6 Luna 和 Haiku 5.5 低约 64%,Mistral Small 4 和 DeepSeek 闲时低约 51%,DeepSeek 高峰的 $0.54 基本持平,3.8 Flash 是它的约 2.7 倍,2027 年起约 5.5 倍。
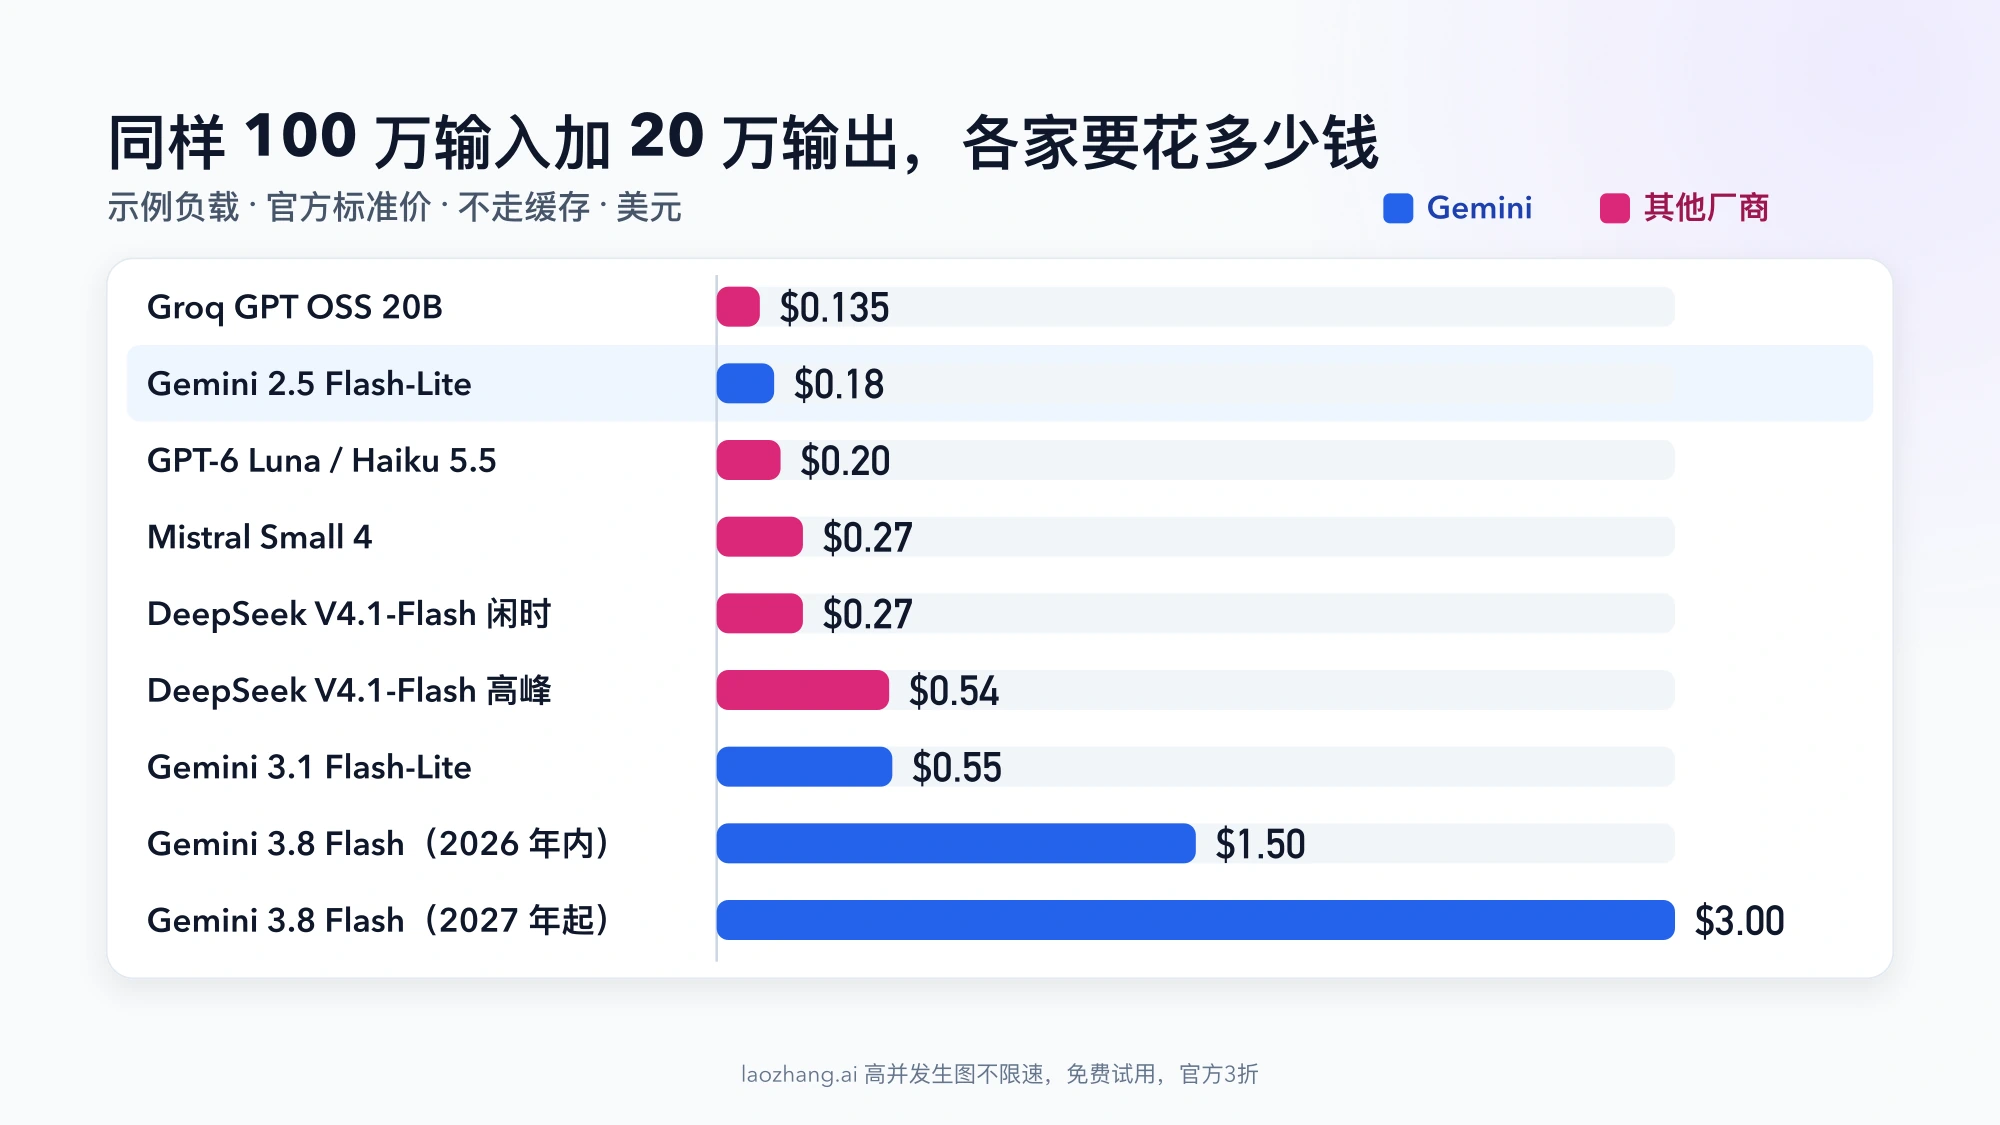
把这份负载放大 100 倍(每月 1 亿输入、2,000 万输出),2.5 Flash-Lite 是 $18(以前用过 2.5 的用户),3.1 Flash-Lite 是 $55,Groq GPT OSS 20B 是 $13.5,GPT-6 Luna 和 Haiku 5.5 是 $20,而 Gemini 3.8 Flash 在 2026 年内是 $150,2027 年起是 $300。替代方案之间的差距是几美元到几十美元,选错 Gemini 型号的差距是几倍到十几倍。
这张表只比标价。不同模型的分词方式不同,同一段文字算出的 token 数会有出入;输出质量、上下文长度、多模态能力和配额也不同,最终要用你自己的样本请求核对质量和实际 token 数。
最便宜的 Gemini API 是哪个:2.5 Flash-Lite,3.x Flash 明年翻倍
Gemini 自己最便宜的文本型号仍是 Gemini 2.5 Flash-Lite。Google 价格页给它的标准价是输入 $0.10、输出 $0.40,Batch 和 Flex 都是一半($0.05 / $0.20),而且这个价格不随提示长度分档。上下文缓存按 $0.01 / 100 万 token 计,另收每 100 万 token 每小时 $1.00 的存储费。
能不能用上它要先确认一件事:Gemini API 退役时间表写明,2.5 系列没有弃用、暂无关闭日期,但只开放给过去实际用过它们的用户,并建议新项目改用 3.5 Flash-Lite 或 3.8 Flash。之前调用过 2.5 的用户可以照下文换型号;如果用不了 2.5,Gemini 内最便宜的是 3.1 Flash-Lite($0.25 / $1.50,退役时间表上最早 2027 年 5 月 7 日关闭,替代型号是 3.5 Flash-Lite),这时跨厂商比较的基准也要换成它。
新型号不等于更便宜:
- Gemini 3.1 Flash-Lite:$0.25 / $1.50,输入是 2.5 Flash-Lite 的 2.5 倍,输出是 3.75 倍。
- Gemini 3.5 Flash-Lite 和 Gemini 2.5 Flash:都是 $0.30 / $2.50。
- Gemini 3.6、3.8 Flash:2026 年 12 月 31 日前是 $0.75 / $3.75,2027 年 1 月 1 日起恢复 $1.50 / $7.50。如果你在做明年的预算,要按后一个价格算。
- Gemini 3.7 Flash 和 3.5 Flash:2026 年 10 月 8 日已弃用,发布说明写明发给它们的请求自动转到 3.8 Flash 和 3.6 Flash,价格页也不再列出这两个型号。3.5 Flash 原来的 $1.50 / $9.00 不再是可选价格;Google 没说明转发请求按哪个型号计价,按实际处理请求的 3.8 / 3.6 Flash 计价只是推测,以 Cloud Billing 报表里按 SKU 列出的费用为准。代码里还写着这两个 ID 的,直接改成
gemini-3.8-flash或gemini-3.6-flash。 - Gemini 2.5 Pro:提示 20 万 token 以内 $1.25 / $10;Gemini 3.1 Pro Preview $2 / $12,没有免费层。
付费层还有一档 Priority,单价是标准价的 1.8 倍,只在你需要优先容量时才值得开。
上面仍在价格页上的型号除 3.1 Pro Preview 外都有免费层;Gemma 4 在 Gemini API 上只有免费层,没有付费档。免费层的具体限额按项目计算、因型号而异,以 AI Studio 显示为准,如何判断你的项目还能不能用,见 Gemini API 免费层还能用吗?先检查模型、项目和地区。
最省事的降本动作是在同一个项目里把一部分简单文本请求的模型名换成 gemini-2.5-flash-lite,和你现在的型号并行跑一批真实请求,对比输出质量。质量过关,就不必再考虑跨厂商迁移。如果用不了 2.5,就用 gemini-3.1-flash-lite 做同样的测试。
GPT-6 Luna 和 Claude Haiku 5.5:输入同价,输出贵 25%,长提示另算
GPT-6 Luna 和 Claude Haiku 5.5 的标准价都是输入 $0.10、输出 $0.50。和 Gemini 2.5 Flash-Lite 比,输入持平,输出贵 25%。所以在提示长度没触发阈值、不走缓存的前提下,这两个模型按标价都不会比 2.5 Flash-Lite 便宜,输出占比越高差距越大。用不了 2.5 时结论相反:对比 3.1 Flash-Lite($0.25 / $1.50),两者输入低 60%、输出低约三分之二,上面的示例负载是 $0.20 对 $0.55。
两者的分歧在长提示上:
- Claude Haiku 5.5:Anthropic 价格页规定提示超过 10 万 token 时所有单价 ×5,变成 $0.50 / $2.50。
- GPT-6 Luna:OpenAI 价格页规定输入超过 27.2 万 token 时,整个请求按 $0.20 / $0.75 计。
- Gemini 2.5 Flash-Lite 和 3.1 Flash-Lite:都不分档。
以单个请求 15 万 token 输入、2,000 token 输出为例:2.5 Flash-Lite 是 0.15 × $0.10 + 0.002 × $0.40 ≈ $0.0158;Luna 是 0.15 × $0.10 + 0.002 × $0.50 = $0.016;Haiku 5.5 已超过 10 万,是 0.15 × $0.50 + 0.002 × $2.50 = $0.080。跑 1,000 次分别约 $15.8、$16 和 $80。用不了 2.5 时,3.1 Flash-Lite 是 0.15 × $0.25 + 0.002 × $1.50 = $0.0405,1,000 次约 $40.5,比 Luna 贵一倍多。
缓存和 Batch 不会颠倒这个排序:Luna 缓存输入 $0.01、Haiku 5.5 缓存读取 $0.01,与 2.5 Flash-Lite 的缓存单价相同(Gemini 另有按小时计的存储费);三家的 Batch 都是半价。
那什么时候值得换到这两家?主要是你的工具链本来就在 OpenAI 或 Anthropic 上,或者在你自己的样本里它们的输出明显更好,省下的返工比多付的输出费更值钱。两者之间怎么选,见 Claude Haiku 5.5 对比 GPT-6 Luna API 价格:同价只到 10 万 token;想了解 Luna 和更高一档的 Sol 怎么计费,见 GPT-6 Luna 与 Sol 价格对比:API 和 Codex 分别怎么算。
DeepSeek、Mistral、Groq:哪个真比 Gemini 2.5 Flash-Lite 便宜
三者里只有 Groq 的 GPT OSS 20B 在输入和输出上都低于 2.5 Flash-Lite。这一节的比较以 2.5 Flash-Lite 为基准,适用于以前用过 2.5 的用户;用不了 2.5 时基准是 3.1 Flash-Lite($0.25 / $1.50),Groq 的两个 GPT OSS 型号、Mistral Small 4 和 DeepSeek 闲时价都比它便宜,DeepSeek 高峰价输入 $0.30 略高,示例负载 $0.54 与 3.1 Flash-Lite 的 $0.55 基本持平。
Groq GPT OSS 20B:Groq 模型页标价 $0.075 / $0.30,是这次比较里唯一按标价更便宜的选项,上面的示例负载能省 25%。同平台更大的 GPT OSS 120B 是 $0.15 / $0.60,就已经比 2.5 Flash-Lite 贵了。GPT OSS 是开放权重的文本模型,适合把纯文本流量(分类、抽取、改写)分出去;需要图片、视频或音频输入的请求仍要留在 Gemini 这类多模态模型上。
DeepSeek V4.1-Flash:DeepSeek 价格页给出的区间是输入 $0.15–$0.30、输出 $0.60–$1.20,闲时是高峰的一半。高峰时段是周一至周五 UTC 01:00–04:00 和 06:00–10:00,换成北京时间是工作日 09:00–12:00 和 14:00–18:00,正好是国内团队的上班时间。也就是说,白天在线调用多半按 $0.30 / $1.20 计,示例负载是 $0.54,是 2.5 Flash-Lite 的 3 倍;把批量任务放到夜间或周末,才是 $0.27。
DeepSeek 的优势在缓存命中:命中部分只要 $0.003–$0.006 / 100 万 token,远低于其他几家的 $0.01。如果你的请求有很长的固定前缀(长系统提示、同一份文档反复提问),并且能稳定命中缓存,结论可能反转,需要按你的命中率重新算。另外,V4.1-Flash 支持 100 万 token 上下文、最多 38.4 万 token 输出;更强的 deepseek-v4-pro 是 $0.66–$1.32 / $1.98–$3.96,不在低价范围。
Mistral Small 4:Mistral 模型页标价 $0.15 / $0.60,输入输出都高于 2.5 Flash-Lite。原来常被拿来做低价对比的 Small 3.2($0.10 / $0.30)已经退役。能用 2.5 Flash-Lite 时,选 Mistral 的理由不会是价格,而是你本来就需要它的平台或模型特性;用不了 2.5 时,它的示例负载 $0.27 不到 3.1 Flash-Lite($0.55)的一半。
什么时候从 Gemini 切换才真省钱:看这五个条件
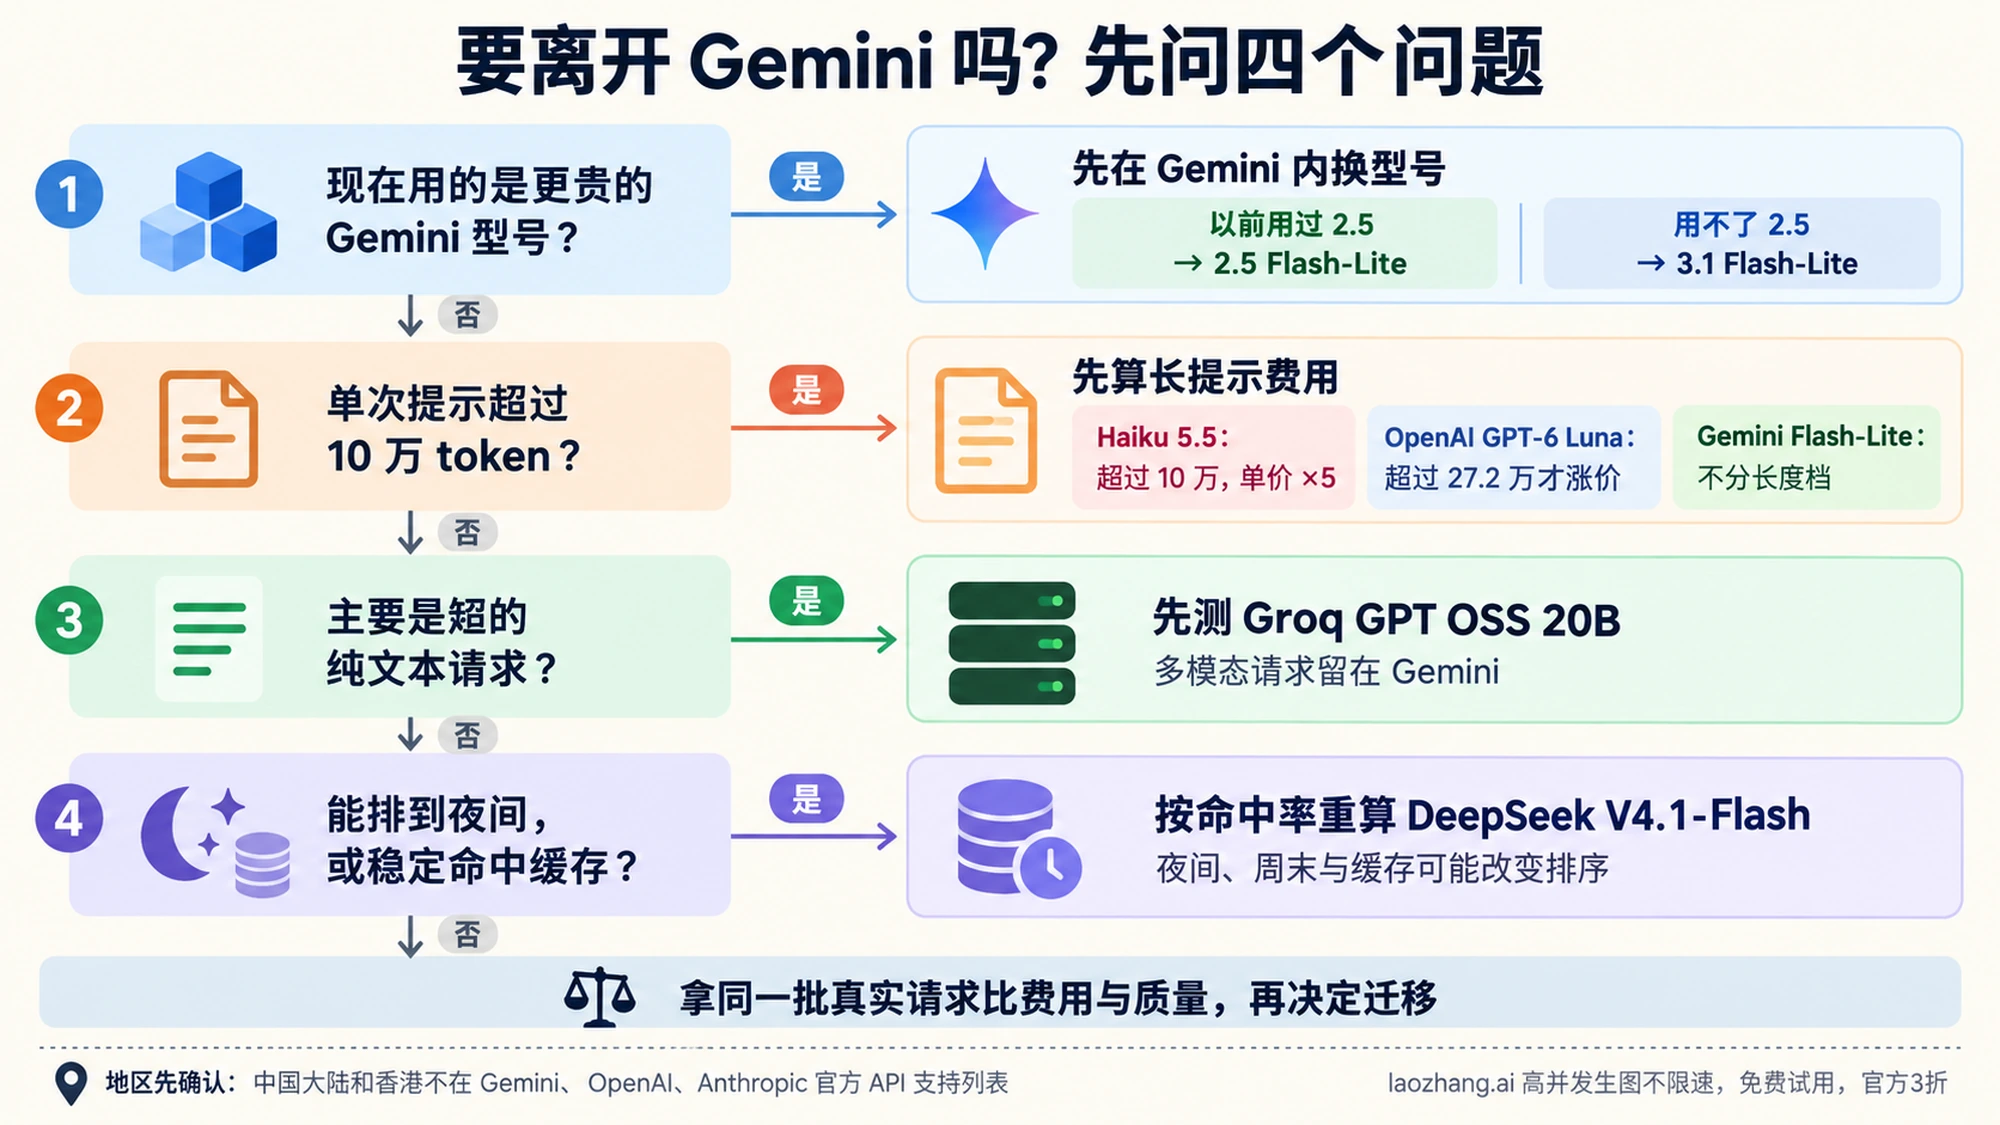
1. 先看你现在用的是哪个 Gemini 型号。 如果不是 2.5 Flash-Lite,先在 Gemini 内部降级测试。以示例负载算,3.8 Flash 换到 2.5 Flash-Lite,费用从 $1.50 降到 $0.18;到 2027 年 1 月 3.x Flash 恢复原价后,差距会从约 8 倍扩大到约 17 倍。这一步不需要改 SDK,也不用换账号;前提是你以前用过 2.5;用不了 2.5 时换到 3.1 Flash-Lite,示例负载是 $0.55。
2. 再看输出占比。 输入多、输出少的任务(分类、抽取、打标签),2.5 Flash-Lite、Luna、Haiku 5.5 几乎打平。输出多的任务差距会拉开:以 20 万输入、100 万输出为例,2.5 Flash-Lite 是 0.2 × $0.10 + 1 × $0.40 = $0.42,Luna 和 Haiku 5.5 是 $0.52(高约 24%),Mistral Small 4 和 DeepSeek 闲时是 $0.63,Groq GPT OSS 20B 是 $0.315。这里的 2.5 Flash-Lite 只适用于以前用过 2.5 的用户;用不了 2.5 时,3.1 Flash-Lite 是 0.2 × $0.25 + 1 × $1.50 = $1.55,输出越多,Luna 和 Haiku 5.5 比它省得越多(这个例子约省三分之二)。
3. 看单次提示长度。 单个请求提示超过 10 万 token,不要用 Haiku 5.5 跑大批量;超过 27.2 万 token,Luna 也会整单涨价。以前用过 2.5 的用户,长文档任务留在不分档的 2.5 Flash-Lite 更稳;用不了 2.5 时,3.1 Flash-Lite 虽然也不分档,但按上面 15 万 token 的例子每 1,000 次约 $40.5,27.2 万 token 以内用 Luna(约 $16)更省。
4. 看能不能异步或复用前缀。 Batch 在 Gemini、OpenAI、Anthropic 都是半价,排序不变;DeepSeek 的闲时价和缓存命中价则可能让它从"更贵"变成"更便宜",前提是任务能挪到北京时间夜间或周末、前缀能稳定命中缓存。
5. 最后算迁移成本和地区。 如果你想继续用 OpenAI 风格的 SDK,不必为此离开 Gemini:Gemini 的 OpenAI 兼容接口说明,用 OpenAI 的 Python 或 TypeScript 库调用 Gemini,只需改 API key、base_url 和模型名三行。反过来,从 Gemini 迁到别家要重新调提示词、监控和多模态链路,省下的几美分往往抵不过工程时间。所在地区的问题见下文。
判断方法可以收成一句话:拿最近一周的真实请求,统计输入和输出 token 总量,用上面的公式分别算 2.5 Flash-Lite(用不了 2.5 时换成 3.1 Flash-Lite)和候选方案的费用,再在同一批样本上比质量。只有费用更低、质量过关、迁移工作量也算得过来,才值得换。很多时候更划算的做法是分流:多模态和长文档请求留在 Gemini,把短的纯文本请求分一部分给 Groq GPT OSS 20B。
撞到 429 是配额问题,不是价格问题:Gemini 限额按项目计
很多人想换 Gemini,是因为免费层或低等级付费层频繁返回 429,而不是账单太贵。这两个问题的解法不同。
Gemini 速率限制文档写明:限额按项目计算,不按 API key 计算,所以在同一个项目里多建几个 key 不会增加额度;每日请求数(RPD)在太平洋时间午夜重置,夏令时期间约为北京时间 15:00,冬令时为 16:00;实时可用的限额要在 AI Studio 里查看;实验和预览型号的限额更严,文档也说明列出的限额不保证、实际容量可能变化。
所以先分清你痛的是哪一项:
- 账单高:按上面的公式比单价,先检查是不是用错了 Gemini 型号。
- 频繁 429:先看项目的使用等级和 AI Studio 里显示的限额,再考虑开通结算、拆分项目,或把一部分纯文本流量分给别家。Gemini 付费等级怎么开、额度怎么升,见 Gemini API Key 怎么付费:官方额度、使用等级与国内选择。
- 迁移成本高:先用 OpenAI 兼容接口,看现有代码能不能少改甚至不改。
跨厂商比较总成本时,还要把缓存、批处理和长上下文的计价规则一起算进去,可以参考 Gemini API vs OpenAI vs Claude:2026 年完整成本决策指南。
在中国大陆能直接用 Gemini API 吗:官方支持地区不含大陆和香港
不能。截至 2026 年 10 月 8 日,Gemini API 支持的国家和地区不包括中国大陆和香港,Google 建议列表外的用户改用 Gemini Enterprise Agent Platform。换到 GPT-6 Luna 或 Claude Haiku 5.5 也解决不了这个问题:OpenAI API 支持的国家和地区和 Anthropic 支持的国家和地区同样不含中国大陆和香港。DeepSeek、Mistral、Groq 的地区限制以各自的服务条款为准。
在官方入口不可用的地区,有人会用 laozhang.ai 这类接入平台,用一个密钥调用多家模型。它不是 Google 或 OpenAI 的官方渠道,也不是更便宜的路线。截至 2026 年 10 月 7 日,laozhang.ai 模型列表里 gemini-2.5-flash-lite 为 $0.1 / $0.4、gpt-6-luna 为 $0.1 / $0.5,与官方同价;gemini-3.6-flash 标 $1.5 / $7.5,高于 Google 在 2026 年内的 $0.75 / $3.75;deepseek-v4-flash 为 $0.44 / $1.32,也高于 DeepSeek 官方价;列表里暂时没有 Claude 模型。上文的费用计算和切换判断,在这类平台上不会变得更便宜,只多了一种接入方式。
便宜 Gemini API 与替代方案常见问题
现在最便宜的 Gemini API 是哪个?
截至 2026 年 10 月 10 日,已在用 Gemini 2.5 的用户是 2.5 Flash-Lite(每 100 万 token 输入 $0.10、输出 $0.40);新项目或用不了 2.5 时,是 gemini-3.1-flash-lite($0.25 / $1.50)。Google 的退役时间表写明 2.5 系列没有弃用,但只开放给过去实际用过它们的用户,并建议新项目改用新模型;2.5 Flash-Lite 的 Batch 和 Flex 是 $0.05 / $0.20,3.1 Flash-Lite 是 $0.125 / $0.75,后者最早 2027 年 5 月 7 日关闭,替代型号是 3.5 Flash-Lite($0.30 / $2.50)。Gemma 4 在 Gemini API 上只有免费层,不能按量付费,所以不算付费路线里的选项。
有没有比 Gemini 2.5 Flash-Lite 更便宜的 API?
已在用 2.5 Flash-Lite 的用户,按标准价输入、输出都更低的只有 Groq GPT OSS 20B($0.075 / $0.30);用不了 2.5 时(Google 也建议新项目改用新模型),Gemini 里最便宜的是 3.1 Flash-Lite($0.25 / $1.50),GPT-6 Luna、Claude Haiku 5.5、Groq GPT OSS 20B 都比它便宜。以 100 万输入加 20 万输出计,2.5 Flash-Lite $0.18、3.1 Flash-Lite $0.55,Groq GPT OSS 20B $0.135,Luna 和 Haiku 5.5 $0.20(提示在 10 万 token 以内),Mistral Small 4 和 DeepSeek V4.1-Flash 闲时 $0.27。DeepSeek V4.1-Flash 在闲时并大量命中缓存时,即使对比 2.5 Flash-Lite 也可能更便宜,要按你的命中率计算。
Gemini 3.1 Flash-Lite 比 2.5 Flash-Lite 便宜吗?
不便宜。3.1 Flash-Lite 是 $0.25 / $1.50,输入是 2.5 Flash-Lite 的 2.5 倍,输出是 3.75 倍。以 100 万输入加 20 万输出计,前者 $0.55,后者 $0.18。不过 2.5 Flash-Lite 只开放给以前用过 2.5 的用户;用不了 2.5 时,Gemini 里最便宜的就是 3.1 Flash-Lite。
GPT-6 Luna 和 Claude Haiku 5.5 哪个更便宜?
提示在 10 万 token 以内时两者同价,都是 $0.10 / $0.50。超过 10 万 token,Haiku 5.5 所有单价 ×5,Luna 要到 27.2 万 token 以上才涨价,这时 Luna 便宜得多。
为了继续用 OpenAI SDK,一定要离开 Gemini 吗?
不用。Gemini 提供 OpenAI 兼容接口,用 OpenAI 的 Python 或 TypeScript 库,把 API key、base_url 和模型名换成 Gemini 的就能调用。
什么时候即使 Gemini 不贵,也应该换或分流?
三种情况:频繁撞到 429 且升级使用等级解决不了;你的大部分流量是短的纯文本请求,可以分一部分给 Groq GPT OSS 20B;或者你所在地区不在 Gemini API 的支持列表里。只因为替代方案多就换,通常省不了钱。