更新(2026 年 10 月 8 日):
gpt-image-1将于 2026 年 10 月 23 日停用,替代型号是gpt-image-2.5-sunburst(编辑精度最高)或gpt-image-2.5-flare(速度最快),gpt-image-1-mini和gpt-image-1.5于 2026 年 12 月 1 日停用(见 OpenAI 弃用说明)。截至 2026 年 10 月 8 日,gpt-image-2.5 模型页列出的限额与 gpt-image-1 相同:Build 档每分钟 20 张(IPM)、Launch 档 150 张、Grow 档 250 张,免费层不支持。中转服务同样受上游限额约束,"突破 50 张/分钟""不限并发"一类说法没有依据。两款 2.5 型号怎么选、怎么接,见 GPT Image 2.5 介绍:Flare 与 Sunburst 怎么选,价格怎么算,API 怎么接。
GPT 图像 API 每分钟能生成多少张图,取决于你的账户层级:截至 2026 年 10 月 8 日,Build 档 20 张、Launch 档 150 张、Grow 档 250 张。gpt-image-1 即将停用,迁移到 gpt-image-2.5 后限额不变。下面说明官方限额怎么算、怎样在限额内提高吞吐量、成本怎么估,以及中转服务能解决什么、不能解决什么。
图像生成已成为很多业务的常规需求:电商平台的商品展示图、内容平台的文章配图、游戏开发的素材制作,都需要大量 AI 生成图片。在接入之前算清每分钟能出几张图,是避免上线后被限流卡住的第一步。
GPT-image-1 API 官方限制是什么:IPM 与 TPM 两道上限
OpenAI 的速率限制可以理解为令牌桶:额度以恒定速率补充,每个请求消耗额度,耗尽后要等待补充。图像模型同时受两个指标约束:IPM(每分钟图片数)和 TPM(每分钟 token 数),先触到哪个就先限流。
截至 2026 年 10 月 8 日,gpt-image-1 模型页和 gpt-image-2.5 模型页列出的限额相同:
| 层级 | 升级条件(累计充值) | TPM | IPM(每分钟图片数) |
|---|---|---|---|
| Free | — | 不支持 | 不支持 |
| Build | $5 | 250,000 | 20 |
| Launch | $100 | 3,000,000 | 150 |
| Grow | $500 | 8,000,000 | 250 |
层级规则见 OpenAI 速率限制文档:升级只看组织的累计充值金额,达到门槛自动升级,没有等待天数要求;旧的 Tier 1–Tier 5 名称已经停用。你的组织实际能用多少,以控制台 Settings > Organization > Limits 页面为准。
AI 模型生成图片和编辑图片的能力限制
除了速率,GPT 图像模型本身也有能力边界。OpenAI 图像生成指南列出的限制包括:
- 延迟:复杂提示词可能需要最长 2 分钟处理
- 文字渲染:图中文字的精确位置和清晰度仍可能出错
- 一致性:多次生成时,反复出现的角色或品牌元素偶尔难以保持一致
- 构图控制:对版式要求严格的构图,元素可能放不到精确位置
所有提示词和生成结果都会按 OpenAI 内容政策过滤。GPT 图像模型提供 moderation 参数,默认 auto 为标准过滤,low 为较宽松的过滤;被拦截的请求应修改内容,而不是反复重试。
GPT-image-1 并发限制带来的业务挑战
用每分钟张数换算日产能:Build 档 20 张/分钟,满负荷 24 小时约 28,800 张;Launch 档 150 张/分钟约 216,000 张;Grow 档 250 张/分钟约 360,000 张。实际还要扣除失败重试、单张最长 2 分钟的处理时间和峰谷差。
- 电商批量出图:日需求 10 万张的平台,Build 档跑满一天也不够,需要 Launch 档以上
- 内容平台实时配图:瓶颈往往不是总量,而是高峰期同时到达的请求,需要排队和优先级
- 游戏素材:除了数量,还要求风格一致,通常要生成多个候选再筛选,实际调用量是成品数的数倍
成本同样需要提前估算。gpt-image-1 按 token 计费,模型页给出的 1024×1024 单张参考价为:低质量 $0.011、中质量 $0.042、高质量 $0.167。按高质量计算,月生成 10 万张约 $16,700。
提高 GPT-image-1 并发的三种方案对比
面对这些挑战,技术团队通常会考虑三种方案:在官方限额内优化、接入API中转服务、多账号轮换。
第一种方案是在官方API基础上优化:升级账户层级(累计充值 $100 进入 Launch 档,每分钟 150 张;$500 进入 Grow 档,每分钟 250 张),配合队列管理、缓存复用和质量分级。这是最稳妥的方案,实现简单、成本可控。
第二种方案是使用API中转服务。用户只需要修改API的endpoint即可调用。它主要解决国内网络和付款问题;能提供多少并发取决于服务商自身的上游额度和限流策略,接入前要向服务商确认并压测,不要把“不限并发”当作承诺。
第三种方案是注册多个账号轮换使用来叠加限额。OpenAI 的使用条款不允许规避速率限制,这种做法有账号被封禁的风险,运维也复杂,不建议采用。
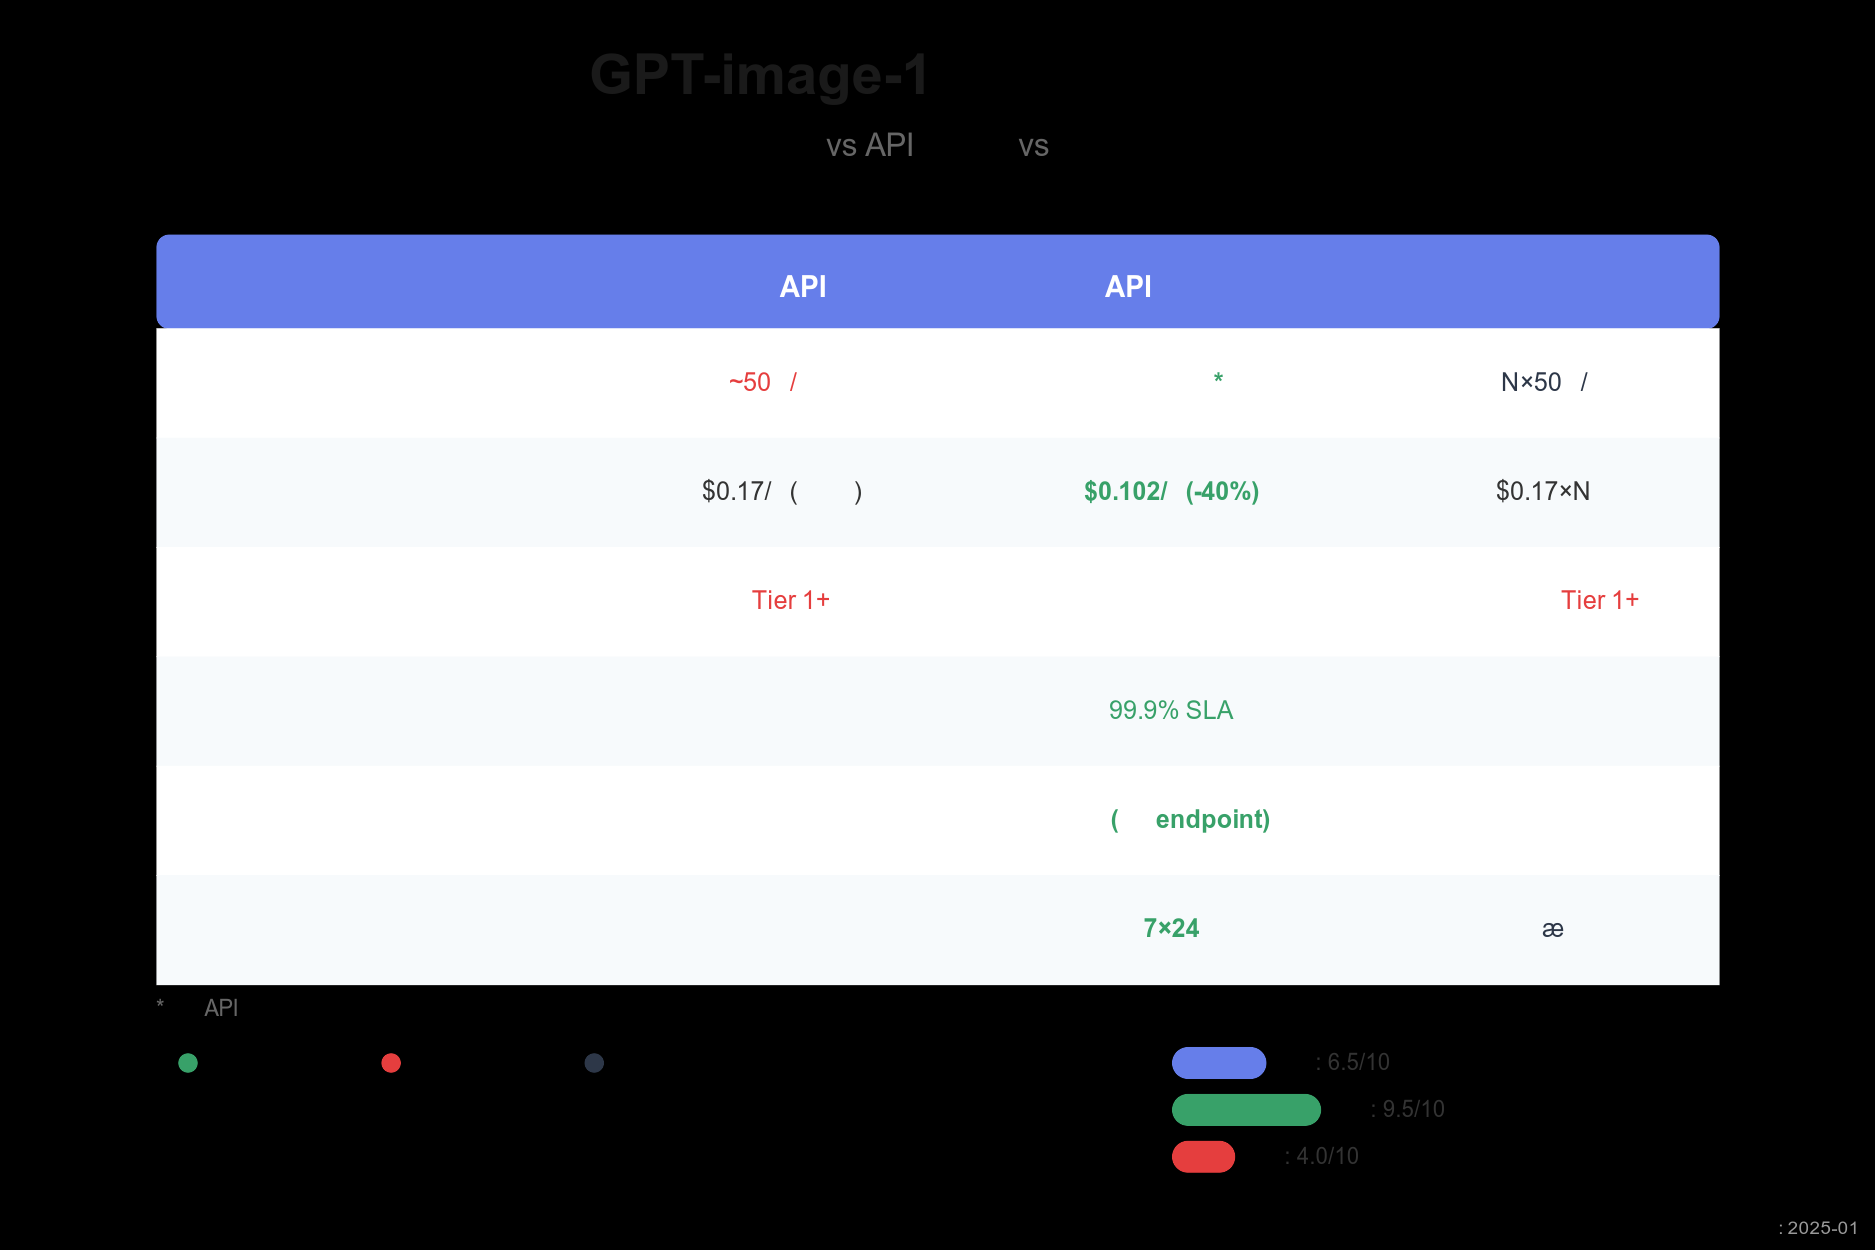
综合来看,先用层级升级和应用层优化解决吞吐量;国内网络或付款受限时,再叠加中转服务。
API 中转服务的典型架构
下面以常见的中转服务架构为例,说明请求经过了哪些环节,便于你评估服务商。
API网关层是用户请求的入口,负责请求的认证、协议转换和初步分发。网关先验证API密钥,再把请求转换为内部格式,加入优先级、超时时间等元数据。
负载均衡层负责把请求分配到服务商的上游通道,并在某个通道变慢或出错时切换。它能改善稳定性,但不会让总吞吐量超过服务商实际拥有的上游额度。
中间件层提供队列、缓存和监控:队列在流量突发时让请求排队而不是丢失,缓存直接返回相同请求的结果,监控在异常时触发告警。
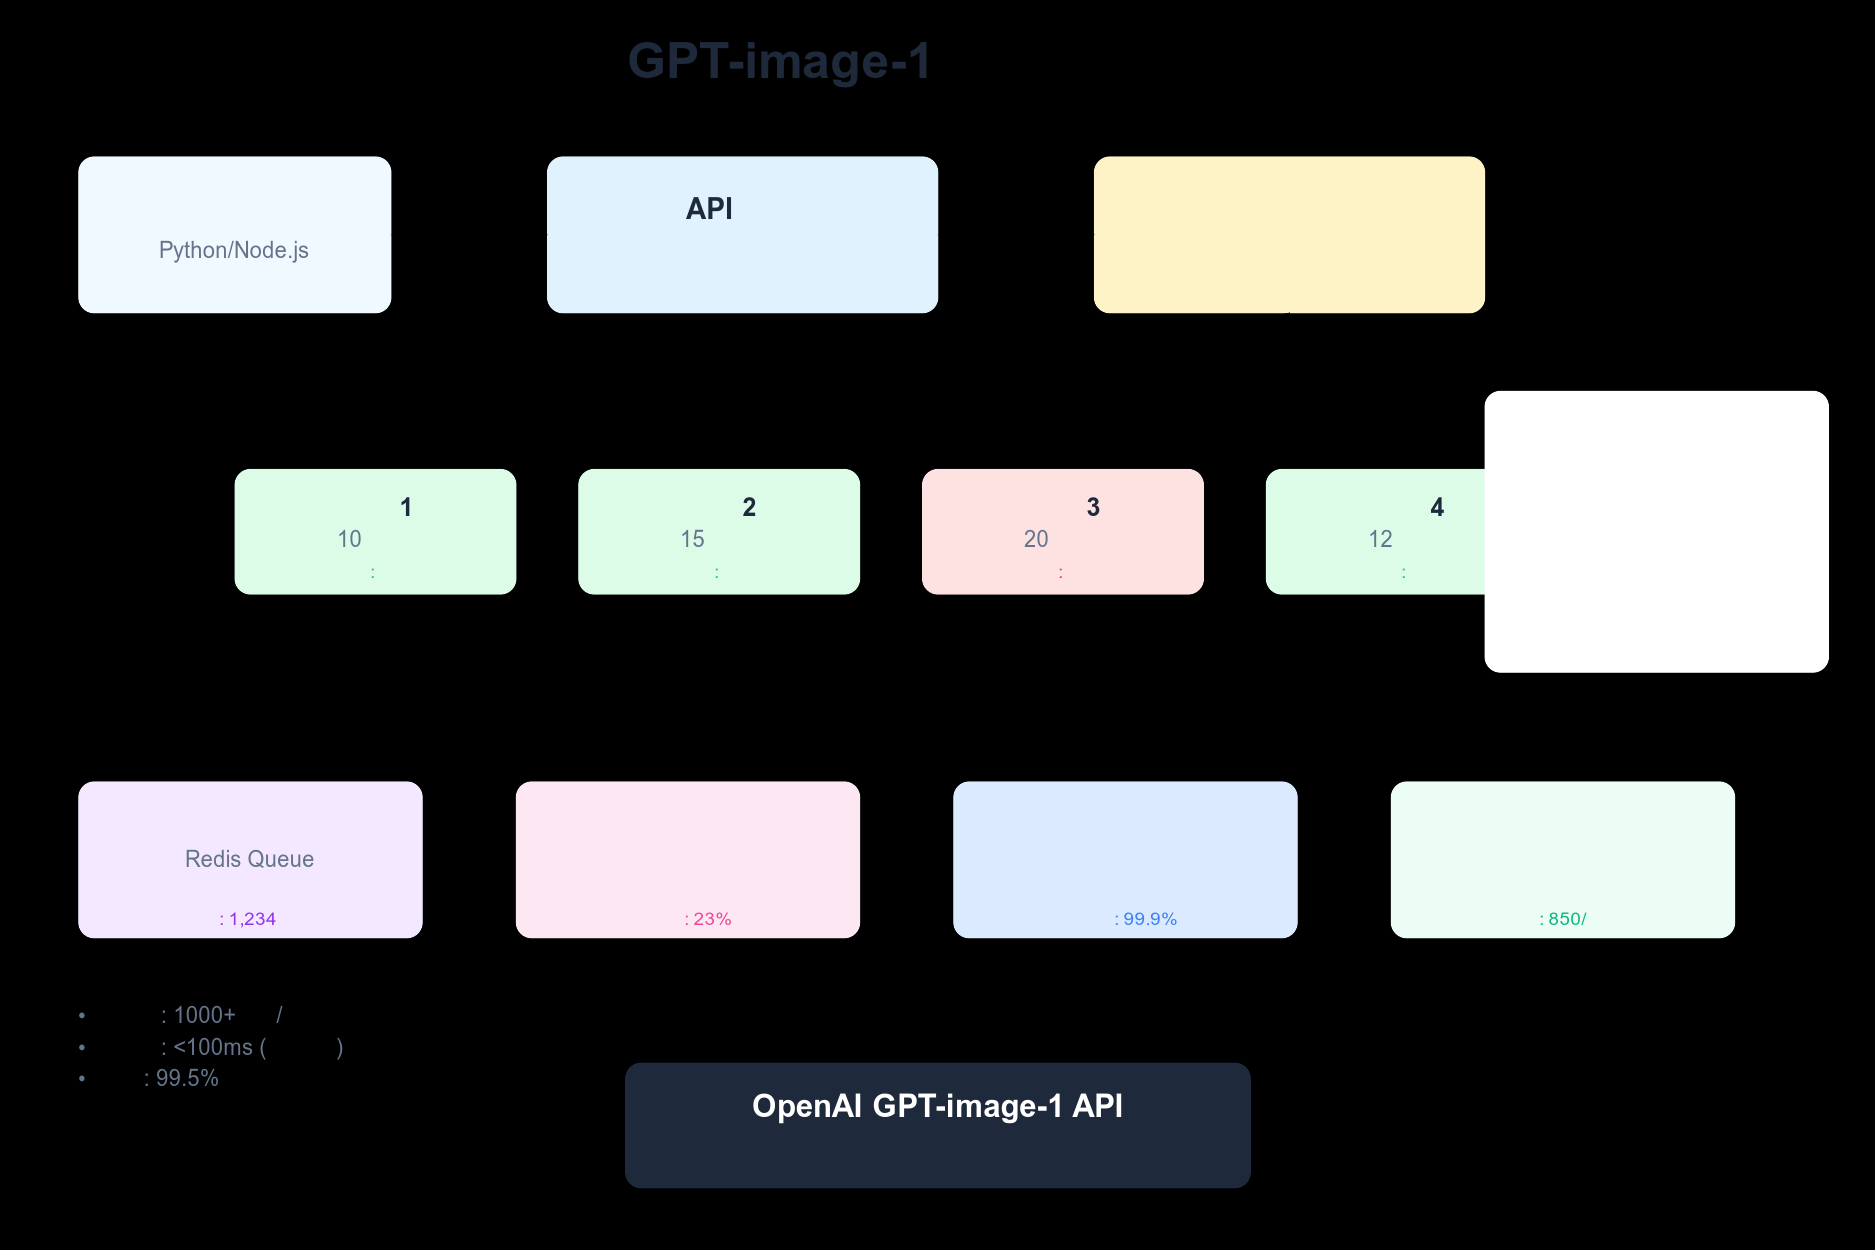
服务商实际能提供多少并发,对用户不可见,只能以压测结果和服务协议为准。
5分钟上手:GPT 图像 API 中转接入教程
接入兼容 OpenAI 格式的中转服务,通常只需要修改 base_url。这里以 laozhang.ai 为例,截至 2026 年 10 月 8 日,它的 gpt-image-2 按次计费 $0.03/次;其他图像模型的可用性和价格以控制台当日显示为准。
注意:GPT 图像模型返回的是 base64 图片数据(b64_json),不是下载链接,需要自己解码保存。
import base64
from openai import OpenAI

# 官方方式
# client = OpenAI(api_key="sk-xxxxxxxxxxxxxx")

# 中转方式 - 仅需修改base_url
client = OpenAI(
    api_key="sk-xxxxxxxxxxxxxx",  # 使用你的中转服务API密钥
    base_url="https://api.laozhang.ai/v1"  # 中转服务endpoint
)

response = client.images.generate(
    model="gpt-image-2.5-flare",  # gpt-image-1 将于 2026-10-23 停用;以服务商实际支持的模型 ID 为准
    prompt="一只可爱的白色暹罗猫坐在窗台上看夕阳",
    size="1024x1024",
    quality="high",
    n=1
)

image_bytes = base64.b64decode(response.data[0].b64_json)
with open("cat.png", "wb") as f:
    f.write(image_bytes)
print("已保存 cat.png")
对于Node.js开发者,接入同样简单:
const OpenAI = require('openai');
const fs = require('fs');

// 创建中转服务客户端
const openai = new OpenAI({
  apiKey: 'sk-xxxxxxxxxxxxxx',
  baseURL: 'https://api.laozhang.ai/v1'
});

async function generateImage() {
  const response = await openai.images.generate({
    model: "gpt-image-2.5-flare",
    prompt: "夜晚的赛博朋克城市街道,霓虹灯闪烁",
    size: "1024x1024",
    quality: "high"
  });

  fs.writeFileSync('city.png', Buffer.from(response.data[0].b64_json, 'base64'));
  console.log('已保存 city.png');
}
中转服务兼容OpenAI的API规范,现有的错误处理、重试逻辑都可以继续使用;它同样可能返回 429 限流错误,重试逻辑不能省。
为了验证接入是否成功,建议先批量生成 10–20 张图片,打开保存的文件确认可以正常显示,并记录是否出现限流错误。
GPT-image-1 批量生成优化技巧
无论直连官方还是走中转,下面几种做法都能在限额内提高效率、降低成本。
异步并发处理是提升效率的关键,但并发数要和限额匹配:并发数 ≈ IPM ÷ 60 × 单张平均耗时(秒)。例如 Launch 档 150 张/分钟、单张平均 30 秒,并发数设在 75 左右;设得更高只会集中触发 429。
import asyncio
import base64
import aiohttp
from typing import List
import time

class BatchImageGenerator:
    def __init__(self, api_key: str, base_url: str, max_concurrent: int = 20):
        self.api_key = api_key
        self.base_url = base_url
        self.max_concurrent = max_concurrent
        self.semaphore = asyncio.Semaphore(max_concurrent)

    async def generate_single(self, session: aiohttp.ClientSession, prompt: str, idx: int) -> dict:
        """生成单张图片并保存"""
        async with self.semaphore:  # 控制并发数
            headers = {"Authorization": f"Bearer {self.api_key}"}
            data = {
                "model": "gpt-image-2.5-flare",
                "prompt": prompt,
                "size": "1024x1024",
                "quality": "medium"
            }

            try:
                async with session.post(
                    f"{self.base_url}/images/generations",
                    headers=headers,
                    json=data
                ) as response:
                    if response.status == 429:
                        return {"prompt": prompt, "status": "rate_limited"}
                    result = await response.json()
                    path = f"image_{idx}.png"
                    with open(path, "wb") as f:
                        f.write(base64.b64decode(result["data"][0]["b64_json"]))
                    return {"prompt": prompt, "path": path, "status": "success"}
            except Exception as e:
                return {"prompt": prompt, "error": str(e), "status": "failed"}

    async def generate_batch(self, prompts: List[str]) -> List[dict]:
        """批量生成图片"""
        async with aiohttp.ClientSession() as session:
            tasks = [self.generate_single(session, p, i) for i, p in enumerate(prompts)]
            return await asyncio.gather(*tasks)

# 使用示例
async def main():
    generator = BatchImageGenerator(
        api_key="sk-xxxxxx",
        base_url="https://api.laozhang.ai/v1",
        max_concurrent=10  # 按所在层级的 IPM 调整
    )

    prompts = [f"未来科技风格的产品展示图 #{i}" for i in range(20)]

    start_time = time.time()
    results = await generator.generate_batch(prompts)
    elapsed = time.time() - start_time

    success_count = sum(1 for r in results if r["status"] == "success")
    print(f"生成完成!成功: {success_count}/{len(prompts)},总耗时: {elapsed:.2f}秒")

asyncio.run(main())
智能队列管理能够确保在高并发场景下的稳定性。实现一个优先级队列,让重要的请求优先处理,同时避免队列堆积:
import heapq
from dataclasses import dataclass, field
from typing import Any

@dataclass(order=True)
class PriorityItem:
    priority: int
    item: Any = field(compare=False)

class PriorityQueue:
    def __init__(self, maxsize: int = 1000):
        self.items = []
        self.maxsize = maxsize

    def put(self, item: Any, priority: int = 5):
        if len(self.items) >= self.maxsize:
            # 队列满时,移除优先级最低的项目
            if priority < self.items[0].priority:
                return False
            heapq.heappop(self.items)

        heapq.heappush(self.items, PriorityItem(priority, item))
        return True

    def get(self):
        if self.items:
            return heapq.heappop(self.items).item
        return None
缓存策略的实施可以显著降低成本。对于电商场景,很多商品描述是相似的,通过匹配可以复用已生成的图片:
import hashlib
from typing import Optional

class ImageCache:
    def __init__(self):
        self.cache = {}

    def get_cache_key(self, prompt: str) -> str:
        # 标准化提示词
        normalized = prompt.lower().strip()
        # 移除数字等变化部分
        normalized = ''.join(c for c in normalized if c.isalpha() or c.isspace())
        return hashlib.md5(normalized.encode()).hexdigest()

    def get(self, prompt: str) -> Optional[str]:
        key = self.get_cache_key(prompt)
        return self.cache.get(key)

    def set(self, prompt: str, path: str):
        key = self.get_cache_key(prompt)
        self.cache[key] = path
缓存能省多少,取决于你的提示词重复率,上线后用命中率统计来评估。
GPT-image-1 成本优化:质量分级与迁移后的计价
成本控制是大规模使用图像模型的关键。
首先是质量分级。gpt-image-1 的 1024×1024 单张参考价为低质量 $0.011、中质量 $0.042、高质量 $0.167(模型页)。并非所有场景都需要高质量:缩略图、预览图用低质量,列表页展示图用中质量,只有详情页主图才用高质量。
迁移到 gpt-image-2.5 后改为纯 token 计价:截至 2026 年 10 月 8 日,OpenAI 价格页列出 gpt-image-2.5-sunburst 和 flare 的图像输入 $8、缓存图像输入 $2、图像输出 $30、文本输入 $5(每百万 token);Batch 处理的图像输出为 $15。官方说明 GPT Image 2 的计算器不能估算 2.5 的 token 消耗,单张成本要用实际返回的 usage 计算。
实施缓存复用机制是另一个重要策略。可以建立多级缓存体系,减少实际的API调用:
class MultiLevelCache:
    def __init__(self):
        # L1: 内存缓存(快速,容量小)
        self.memory_cache = LRUCache(maxsize=1000)
        # L2: Redis缓存(较快,容量中等)
        self.redis_client = redis.StrictRedis()
        # L3: OSS存储(慢,容量大)
        self.oss_client = OSSClient()

    async def get_image(self, prompt: str) -> Optional[str]:
        # 先检查L1
        url = self.memory_cache.get(prompt)
        if url:
            return url

        # 再检查L2
        url = await self.redis_client.get(f"img:{prompt}")
        if url:
            self.memory_cache.put(prompt, url)
            return url

        # 最后检查L3
        url = await self.oss_client.get(prompt)
        if url:
            await self.redis_client.set(f"img:{prompt}", url, ex=86400)
            self.memory_cache.put(prompt, url)
            return url

        return None
中转服务的价格以服务商控制台当日显示为准;截至 2026 年 10 月 8 日,laozhang.ai 的 gpt-image-2 为 $0.03/次(按次计费,不分质量)。
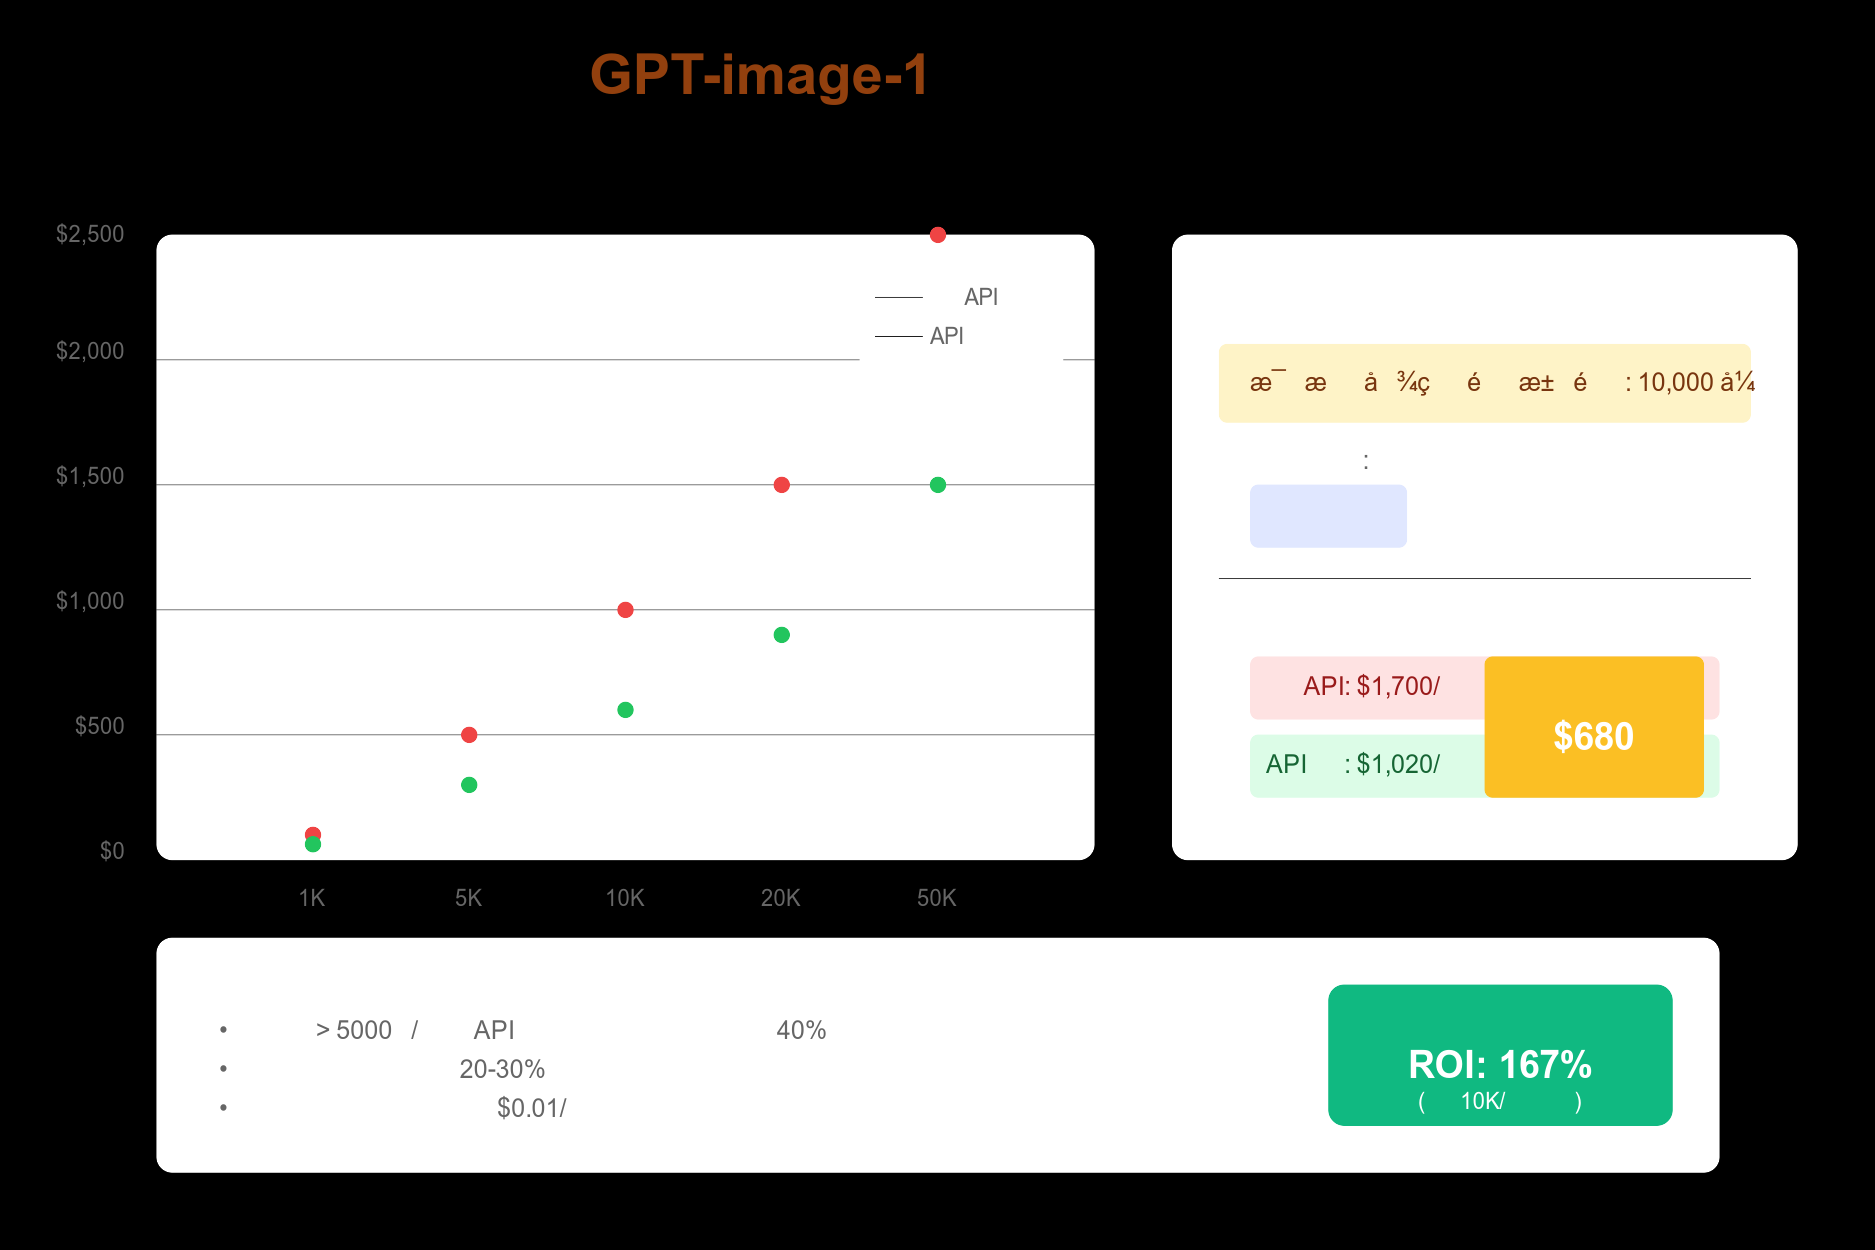
预算控制和监控同样重要。建议设置每日预算上限,并实时监控使用量:
class BudgetController:
    def __init__(self, daily_budget: float):
        self.daily_budget = daily_budget
        # gpt-image-1 1024x1024 单张参考价;迁移到 2.5 后按 usage 实际计算
        self.costs = {"low": 0.011, "medium": 0.042, "high": 0.167}

    async def can_generate(self, quality: str):
        today_usage = await self.get_today_usage()
        cost = self.costs[quality]

        if today_usage + cost > self.daily_budget:
            # 预算即将超支,尝试降级
            if quality == "high" and today_usage + self.costs["medium"] <= self.daily_budget:
                return "medium"  # 建议使用中等质量
            return False

        return True
提高图像生成吞吐量的三种典型做法
下面三种做法适用于不同类型的业务。
电商批量出图:质量分级加模板。 主图用高质量、细节图用中质量、其余用低质量;相似商品复用提示词模板。吞吐量按所在层级的 IPM 规划,日需求超过 Build 档约 2.8 万张的产能时,需要升级到 Launch 档以上。
内容平台实时配图:优先级队列加缓存。 VIP 或付费用户的请求进入高优先级队列;普通请求先查缓存,未命中的进入标准队列,由固定数量的 Worker 处理。复杂提示词可能要 2 分钟,前端要有排队和进度提示。
游戏素材:候选生成加人工筛选。 每个素材生成多个候选版本,用评分或人工复审选出最佳结果。注意 OpenAI 指出模型在多次生成间保持角色一致性仍有局限,关键素材要人工复核。
GPT 图像 API 常见问题:Rate Limit、层级升级、错误处理
“Rate limit exceeded” 怎么办? 先确认是哪种 429:速率限制(降低并发、按 Retry-After 等待后重试)、额度不足或自己设置的 hard spend limit(需要充值或调整限额,重试无效)。旧资料里“充值后要等 24–48 小时才能升级”的说法来自旧层级规则;现行规则只看累计充值金额。
层级升级没有生效? 在 Limits 页面的 Usage Tiers 区域查看当前层级,文档说明可以在那里点击 Upgrade tier;仍未生效时联系 OpenAI 支持并提供组织 ID。
网络超时怎么处理? 复杂提示词最长可能需要 2 分钟,客户端超时应设置在 120 秒以上;跨境访问时,可以在服务器端发起请求,避免客户端直连。超时不代表服务端没有完成生成,要避免用户重复点击产生重复扣费。
图片质量怎么选? 先用中等质量测试,确实需要时才用高质量;gpt-image-1 的中质量单价约为高质量的四分之一($0.042 对 $0.167)。
错误重试怎么做? 不要盲目重试所有错误:429 速率限制和 5xx 服务器错误用指数退避重试;400 请求错误、内容被拦截和额度不足,先修改请求或充值再说。
GPT 图像 API 使用合规指南
OpenAI对图像生成有使用政策,违反可能导致账号封禁。
内容审核是首要考虑。GPT 图像模型会按内容政策自动过滤,作为开发者,你也需要在应用层面实施审核:在用户提交提示词时预检查,对生成的图片用内容审核 API 二次检查。
数据隐私保护同样重要。如果你的应用涉及用户上传的图片或个人信息,确保在提示词中不包含任何可识别个人身份的信息。所有的用户数据都应该加密存储,并设置合理的保留期限。对于欧盟用户,还需要遵守GDPR相关规定。
使用条款方面,OpenAI 禁止规避速率限制,也不向中国大陆提供服务。使用中转服务前,了解服务商的上游来源、数据处理方式和服务协议。
版权问题需要特别注意。AI生成图片的版权归属在不同法域仍有争议。建议在使用条款中说明生成图片可能与现有作品相似、用户需自行承担使用风险;对于商业项目,最好进行人工二次创作。
立即开始:GPT 图像 API 并发方案选择与实施步骤
方案选择可以按日需求量判断:日需求在 Build 档产能(约 2.8 万张/天)以内,直接用官方 API 加优化策略;超过这个量,先升级到 Launch 档(约 21.6 万张/天)或 Grow 档(约 36 万张/天);国内网络或付款受限时,再叠加中转服务并压测。
实施步骤:第一步,在 Limits 页面确认所在层级和图像模型的 IPM、TPM;第二步,把代码里的 gpt-image-1 换成 gpt-image-2.5-flare 或 gpt-image-2.5-sunburst,并改为读取 b64_json;第三步,加上并发控制、队列和带退避的重试;第四步,如果使用中转服务,先迁移20%的流量,观察一周后再扩大。
在实施过程中,记住这些关键点:建立监控体系,跟踪成功率、响应时间、成本等核心指标;定期优化提示词,提高生成质量和缓存命中率;留意 OpenAI 弃用页面上的停用日期。
最后更新:2026 年 10 月 8 日。限额与价格以 OpenAI 官方页面当日显示为准。