Qwen-Image-2.1 是阿里千问团队在 2026 年 9 月 20 日开放权重的图像模型:一套权重同时做文生图和图像编辑,能直接输出透明背景的 PNG,编辑时最多接收 10 张参考图(GitHub 仓库)。权重可以从 ModelScope 和 Hugging Face 免费下载,但许可证是 Qwen Research License,只允许研究和评估用途;要拿来做商业项目,需要另向阿里申请商用授权。
截至 2026 年 10 月 7 日,三条路线的分工很清楚:想先看效果,用免费的在线入口;有 12 GB 以上显存的显卡,本地用 ComfyUI 或 GGUF 量化版跑;要稳定批量出图、接进自己的产品,用阿里云百炼的 qwen-image-2.1-pro,北京地域每张 ¥0.25。下面的选择表按你手上的硬件和用途给出起步方式。
按显存、出图量和是否商用选:在线试、本地部署还是百炼 API
| 你的情况 | 先走这条路 | 起步方式 |
|---|---|---|
| 没有独立显卡,只想看看效果 | 在线免费试 | 中国大陆用户用 wuli.art;也可以用 ModelScope 在线生成或 Hugging Face Space |
| 12–16 GB 显存的显卡 | 本地部署 | GGUF Q4_K_M 量化版,1024×1024,一次一张 |
| 24 GB 及以上显存 | 本地部署 | INT8/FP8 版从 512×512 起步,或 GGUF Q4_K_M 跑 1024×1024 |
| 只有 6 GB 显存 | 能跑,但要卸载到内存 | FP8 + 卸载,Unsloth 估计速度慢不到 2 倍,需要足够的系统内存 |
| Mac,12–16 GB 以上统一内存 | 本地部署 | GGUF 量化版 |
| 每天要出成百上千张图,或要接进产品 | 百炼 API | qwen-image-2.1-pro,北京地域 ¥0.25/张,每分钟 20 次请求 |
| 生成的图要用于商业项目 | 先解决授权 | 开源权重需另申请商用许可;API 按阿里云服务协议使用 |
显存一栏的数字来自 Unsloth 的 Qwen-Image-2.1 文档,它明确写着这些是估算的起步配置,不是实测下限;分辨率和卸载设置都会改变实际占用。
改变选择的几个条件:
- 项目要商用:本地跑开源权重不在研究许可范围内,后文"能商用吗"一节说明了边界和申请方式。
- 显存低于 6 GB 或没有显卡:纯 CPU 也能起步(12–16 GB 内存配 GGUF),但 Unsloth 没有给出纯 CPU 的速度,在线入口和 API 更省事。
- 出图量很小:每月 50 张,按北京地域算是 50 × ¥0.25 = ¥12.5,不值得为它配显卡;反过来,本地部署没有按张计费,适合反复换种子挑图。
Qwen-Image-2.1 是什么:7B 生成模型 + 8B 文本编码器,生成编辑一体
Qwen-Image-2.1 的视觉生成部分是 70 亿参数、32 层的单流 DiT,文本编码器用 Qwen3-VL 8B,同时理解文字指令和输入图片;VAE 是 64 通道的 RGBA 自编码器,所以透明通道是模型原生输出的,不是生成后再抠图(GitHub 仓库的架构说明)。
官方列出的能力:
- 从文字生成普通图或透明背景(RGBA)图,编辑透明图层,从照片里提取主体;
- 一次最多参考 10 张图做多主体合成,比如把几张单人照合成合影,把衣服、鞋、包拼到同一个模特身上;
- 局部编辑可以用圈选、手绘标注或单独的蒙版指定区域,人物和产品的身份特征尽量保留;
- 原生 2K 输出,官方推荐尺寸是 1:1 的 2048×2048、16:9 的 2752×1536、9:16 的 1536×2752 等七种比例。
这些是厂商自己的描述。外部评测方面,Artificial Analysis 在 10 月初公布的榜单里,Qwen-Image-2.1 在文生图和图像编辑两个榜都排第 18,在开放权重模型中两个榜都排第一;榜单会随新模型变动。GIGAZINE 在本地实际试用后的感受是:人物写实度很高,但整体画质不如 ChatGPT、Gemini 这类在线服务,好在本地生成次数不受限,可以换种子多抽几张(GIGAZINE 试用报告)。
和 Qwen-Image 2.0、3.0 的关系:只有 2.1 放出了权重
千问图像模型的版本号不是一条直线:
| 版本 | 发布时间 | 能否下载权重 | 许可 |
|---|---|---|---|
| Qwen-Image | 2025 年 8 月 | 能 | Apache 2.0 |
| Qwen-Image-2.0 | 2026 年 2 月 | 不能,只有 API | 闭源 |
| Qwen-Image-3.0 | 2026 年 7 月 | 不能,只有 API | 闭源 |
| Qwen-Image-2.1 | 2026 年 9 月 20 日 | 能 | Qwen Research License,非商用 |
也就是说,2.1 是 2.0、3.0 两代闭源之后重新开放权重的版本,但许可证从最早的 Apache 2.0 收紧成了研究许可(GIGAZINE、Unite.AI 关于 3.0 的报道)。
2.1 和 3.0 哪个更好,目前没有可靠答案:3.0 发布时没有公布官方评测,两者也没有同条件的公开对比。如果你本来就在用百炼 API,3.0 和 2.1-pro 都能调,价格对比放在后面的 API 一节。
Qwen-Image-2.1 能商用吗:开源权重仅限研究和评估
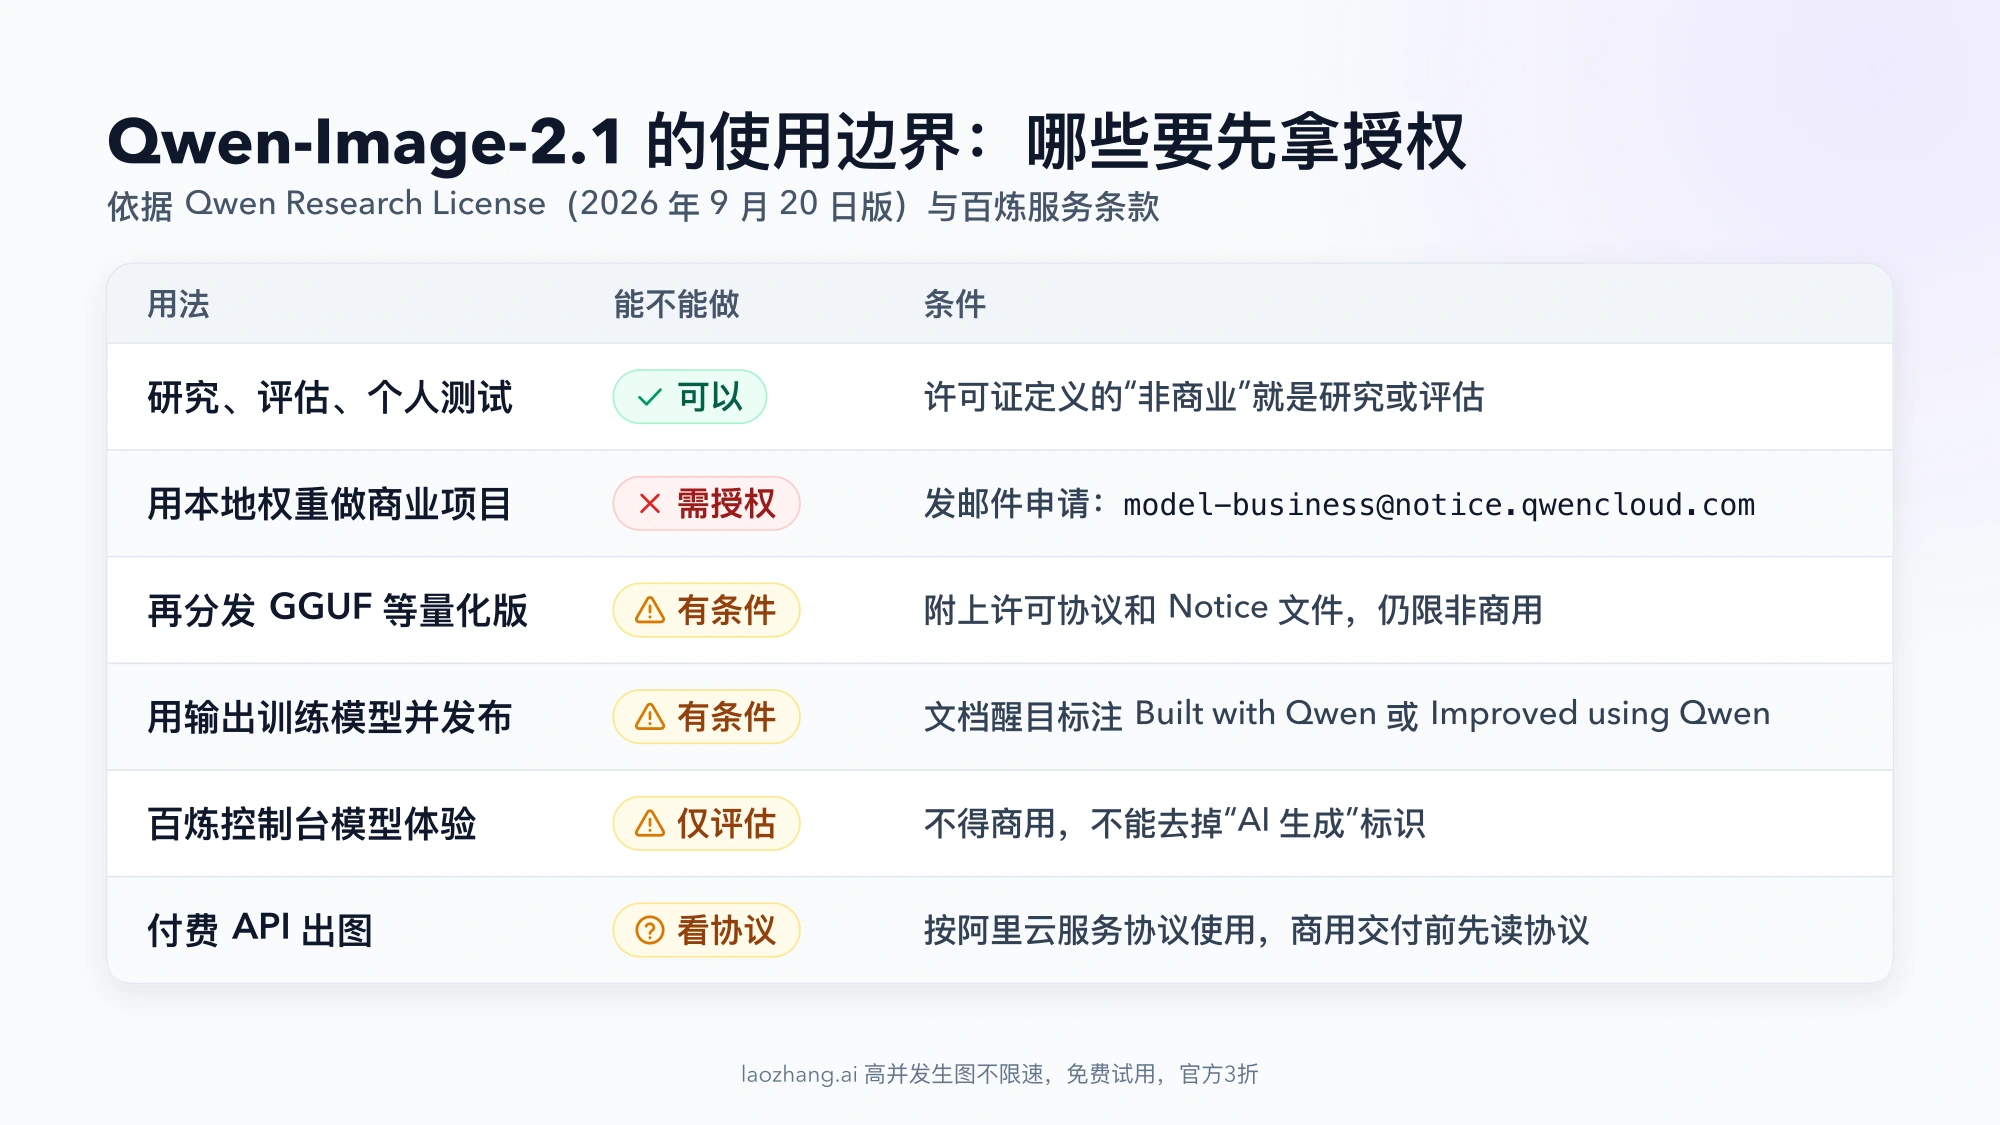
不能直接商用。Qwen Research License(2026 年 9 月 20 日版,许可方是杭州通义实验室科技有限公司)只授予"非商业用途"的使用权,并把"非商业"定义为"仅限研究或评估"。条款里和日常使用关系最大的几条:
- 商用要另外申请:任何商业用途都需要单独的商用许可,申请邮箱是 model-business@notice.qwencloud.com。
- 量化版同样受约束:GGUF、FP8、INT8 这些转换版属于衍生作品,许可条件跟着走;再分发时要附上许可协议和 Notice 文件。
- 用它训练模型要标注:用模型本身或它的输出去训练、微调另一个模型并对外发布,要在文档里醒目标出 "Built with Qwen" 或 "Improved using Qwen"。
- 适用中国法律,争议由杭州的人民法院管辖。
生成的图片归谁,千问官方 X 账号在 9 月 21 日回复过:输出不属于许可材料,用户保留自己生成的图片和其他内容的权利(GIGAZINE 文中嵌入了这条回复)。这句话说的是图片的归属,没有回答"用研究许可的模型给客户出图算不算商业使用"。这条回复也不在许可证正文里。所以只要工作本身是商业性质的,稳妥做法是二选一:申请商用许可,或者改用付费 API,并按下一段确认 API 的使用条款。
付费 API 和免费体验也要分开看。百炼的服务条款写明:控制台"模型体验"里生成的内容只能用来评估模型效果,不得用于包括商业用途在内的其他用途,也不能去掉体验服务加上的"AI 生成"标识。付费 API 调用产出的图片怎么用,不在这份条款里,由阿里云的通用服务协议约束;拿 API 出图做商业交付之前,把你账号签署的协议读一遍。
没有显卡怎么免费用:wuli.art、ModelScope 与 Hugging Face Space
三个免费入口,适合先判断这个模型合不合你的需求:
- wuli.art:官方 README 写明它向中国大陆用户免费提供 Qwen-Image-2.1 的全部功能,对话框和画布两种界面都能用,包括透明背景生成。免费额度的细则没有公开。
- ModelScope:模型页 modelscope.cn/models/Qwen/Qwen-Image-2.1 提供下载,AIGC 专区可以在线生成,还能训练 LoRA,国内用户可以优先用它。
- Hugging Face Space:官方 Demo Qwen/Qwen-Image-2.1 截至 2026 年 10 月 7 日显示运行在 ZeroGPU 上,免费额度和排队时长没有公布,高峰期可能要等。
阿里云百炼国际站给 qwen-image-2.1-pro 提供 10 张免费额度,但只限新加坡地域、90 天内有效,通过控制台模型体验生成的图还受上面"仅限评估"的限制。
想比较其他免费生图工具,可以看 免费 AI 图片生成器哪款最值得用?2026 年 3 月实测比较,那篇写于 2.1 发布之前,不包含它。如果你平时在 Claude 里生图,Claude 生图连接器怎么选怎么加介绍了通过 Hugging Face 连接器调用 Qwen Image Space 的做法。
本地部署要多少显存:Unsloth 给的起步配置
Unsloth 为 Qwen-Image-2.1 做了 GGUF 和 FP8 量化版,并给出了按硬件选择的起步配置。它的说明是:先按表里的分辨率出一张,显存还有余量再往上加。
| 你的硬件 | 起步配置 |
|---|---|
| 12–16 GB 显存 | GGUF Q4_K_M,1024×1024,batch 1 |
| 24 GB 显存 | INT8/FP8 跑 512×512,或 GGUF Q4_K_M 跑 1024×1024 |
| 6 GB 显存 | FP8 + 卸载到内存,速度慢不到 2 倍 |
| 纯 CPU,12–16 GB 内存 | GGUF Q4_K_M,文本编码器用 Q4_K_XL |
| Apple Silicon,12–16 GB 以上统一内存 | GGUF,配合兼容的原生后端 |
来源:Unsloth 文档,标注为估算值而非实测下限。文档开头另有一句"GGUF 版 11 GB 显存可运行",和表格的 12–16 GB 是同一档的不同说法。
几条读表时容易忽略的细节:
- INT8 比 FP8 更接近原画质:Unsloth 的对比里,INT8 文件 7.26 GB、LPIPS 均值 0.064,FP8 文件 7.12 GB、LPIPS 均值 0.112(越低越接近原模型),所以它默认用 INT8。ComfyUI 官方模板加载的也是 INT8 权重。
- 有显卡优先试 FP8/INT8:Unsloth 认为即使需要卸载到内存,FP8 也可能比 GGUF 快,前提是系统内存够大;GGUF 更适合主要靠内存或统一内存的机器,比如 Mac。
- 分辨率是第二个旋钮:尺寸要能被 32 整除。降低步数能加快速度,但解决不了显存不够的问题。
- 提示词改写模型另算内存:官方的提示词改写模型是另一个 9B 模型,开着它就要多装一个模型。
速度方面可以参考 GIGAZINE 的一次试用:Intel Arc Pro B70(32 GB)加 Ryzen 5 7600X,在 ComfyUI 里出 1024×1024、25 步的图,第一张约 45 秒,之后每张约 30 秒。这是单台机器、单次测试的结果,换显卡会差很多。
如果你之前用 Unsloth 在本地跑过大语言模型,量化档位的思路是一样的,只是对象不同,可以对照 Qwen3.8-Flash-Next 本地运行指南:先算清 75GB、96GB 与 128GB。
Qwen-Image-2.1 下载:ModelScope、Hugging Face 与 ComfyUI 模型文件
按你打算用的工具选下载源:
| 用途 | 下载地址 |
|---|---|
| Diffusers、vLLM、SGLang 等原版权重 | ModelScope、Hugging Face Qwen/Qwen-Image-2.1 |
| ComfyUI 原生工作流 | Hugging Face Comfy-Org/Qwen-Image-2.1 |
| GGUF、FP8 量化版 | Unsloth 在 Hugging Face 上的上传,入口见 Unsloth 文档 |
| 提示词改写模型(可选) | Qwen/Qwen-Image-2.1-PE-T2I(文生图)、Qwen/Qwen-Image-2.1-PE-I2I(编辑) |
在国内网络下下载原版权重,可以先试 ModelScope。ComfyUI 用的文件按官方教程放进对应目录:
ComfyUI/models/
├── diffusion_models/
│   ├── qwen_image_2.1_int8_convrot.safetensors   # 模板默认,占用更低
│   └── qwen_image_2.1_bf16.safetensors           # 全精度,占用更高
├── text_encoders/
│   ├── qwen3vl_8b_int8_convrot.safetensors       # 模板默认
│   ├── qwen3vl_8b_bf16.safetensors               # 全精度
│   ├── qwen3.5_9b_qwen_image_2.1_pe_t2i.int8_convrot.safetensors   # 可选,文生图提示词增强
│   └── qwen3.5_9b_qwen_image_2.1_pe_i2i.int8_convrot.safetensors   # 可选,编辑提示词增强
└── vae/
    └── qwen_image_2.1_vae_bf16.safetensors
最少只需要三个文件:一个扩散模型、一个 Qwen3-VL 文本编码器、一个 VAE。两个提示词增强编码器只有打开增强功能时才会用到。
ComfyUI 工作流出第一张图:25 步、cfg 1、1024×1024 起
ComfyUI 从发布当天就原生支持 Qwen-Image-2.1,官方提供文生图、图像编辑、去背景三个模板。步骤:
- 把 ComfyUI 更新到最新版。模板库里搜不到 "Qwen-Image-2.1",或加载后提示缺节点,多半是版本旧;新节点有时先进 Nightly 版,稳定版要等下一次发布。
- 在模板库打开 "Qwen Image 2.1 Text to Image"。如果提示缺模型,点开详情可以一键下载上面那三个文件,下载完刷新页面。
- 第一张图先用 1.0 MP(约 1024×1024)的分辨率,确认能跑通再把 Resolution Selector 调到约 4.0 MP,也就是原生的 2048×2048。
- 写提示词,点运行。生成出图、没有报显存不足,就说明环境没问题。
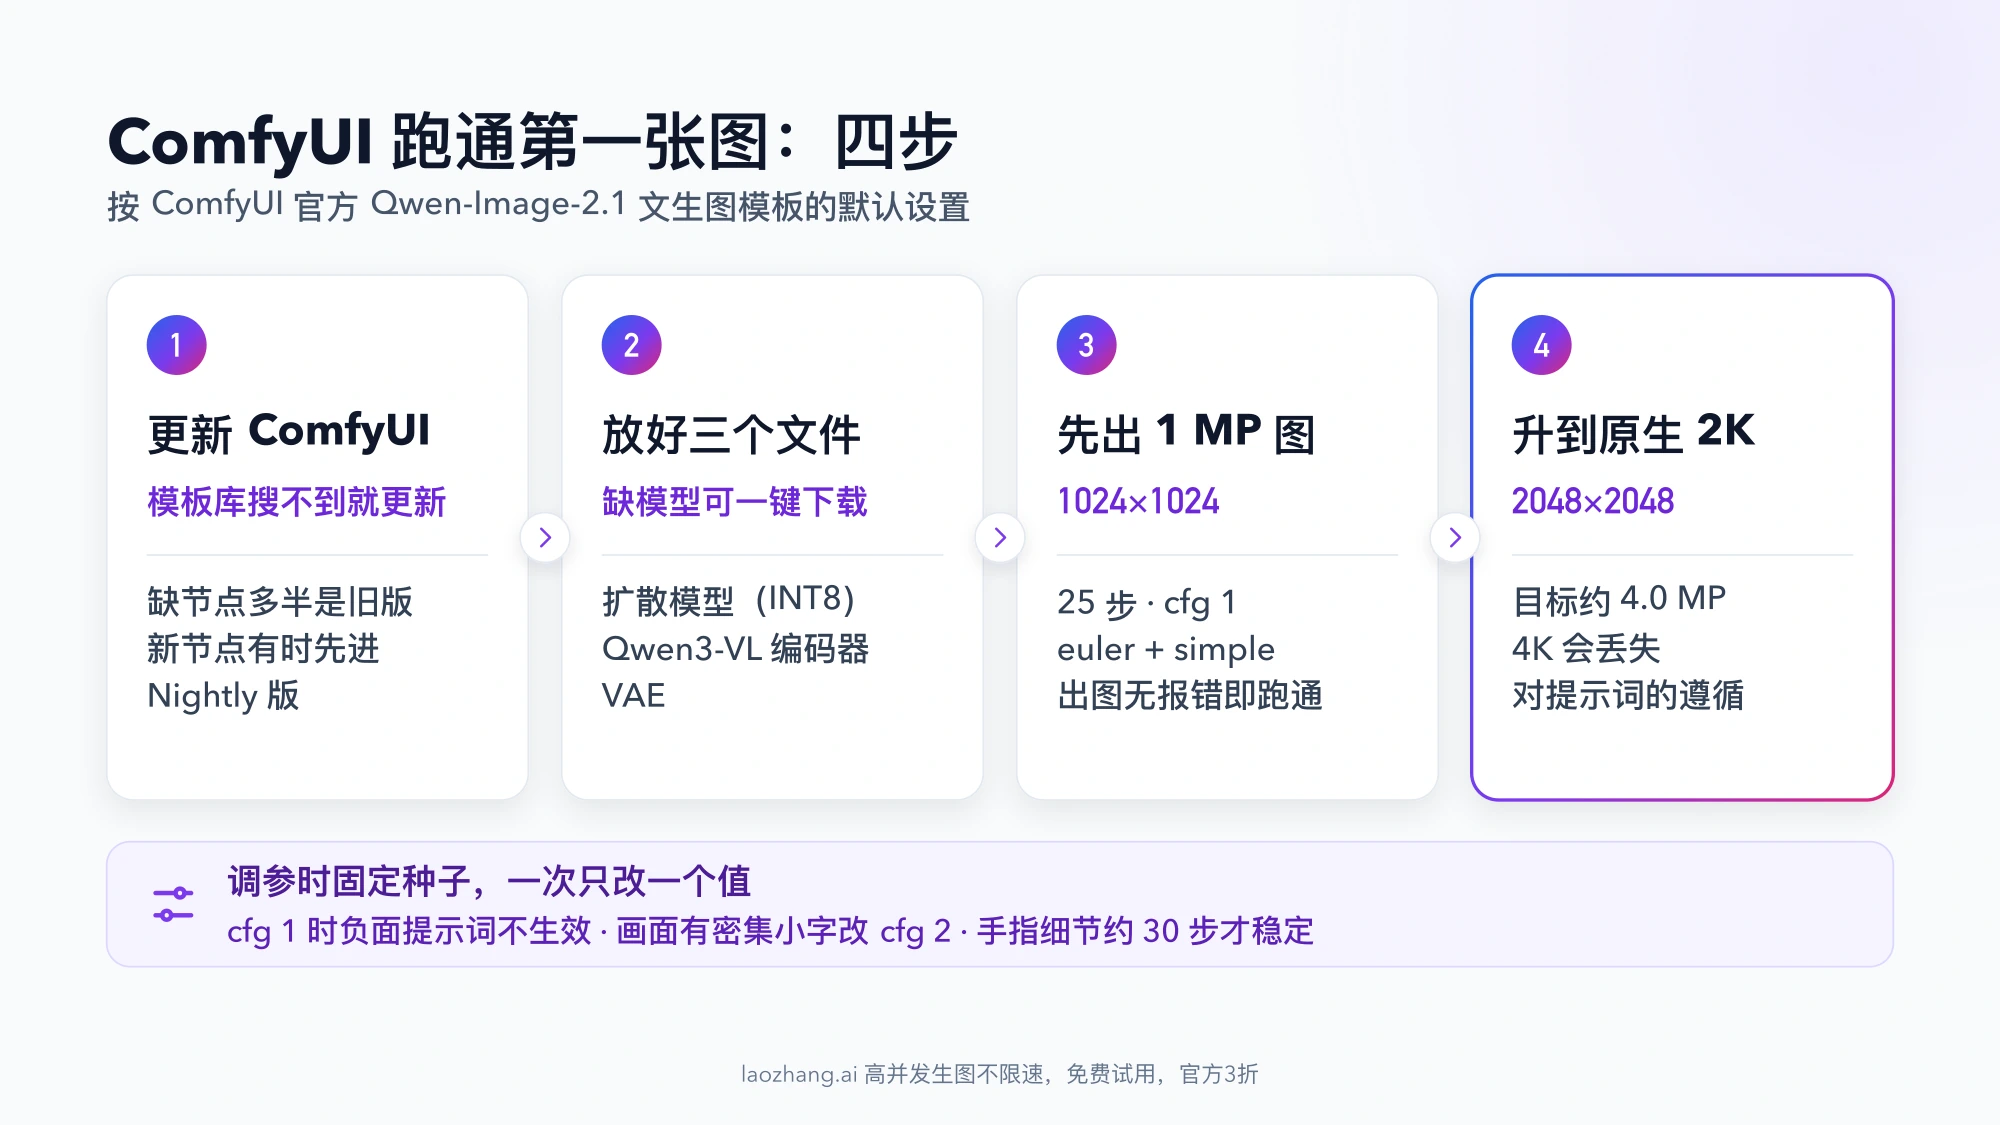
模板的默认采样参数是 25 步、cfg 1、euler 采样器、simple 调度器。调参时一次只改一个值,并固定种子对比:
| 参数 | 默认 | 什么时候改 |
|---|---|---|
| cfg | 1 | cfg 1 时负面提示词不生效。需要负面提示词,或者画面里有密集的小字和数字,改成 2,代价是边缘会过锐;cfg 5 画质明显变差,0.5 会把图弄坏 |
| steps | 25 | 手部、手指这类细节约 30 步才稳定;25 提到 40 能减少细节区域的噪点。只改一件衣服颜色这类简单局部编辑,4–8 步就够 |
| 分辨率 | 模板设置 | 留在 2K 以内。远超训练尺寸(如 4K)会丢失对提示词的遵循 |
用 Diffusers 跑时默认是 40 步,官方发布的流程大约用 40–50 步;ComfyUI 模板从 25 步起,是为了更快出结果。
Qwen-Image-2.1 提示词:透明 PNG、多图参考与局部修改
透明 PNG:用官方的 RGBA 句式
官方推荐的透明图提示词格式是把描述夹在两句固定的话中间:
This is an RGBA image with transparency. <你的描述>. The image has alpha channel and the background is transparent.例如:This is an RGBA image with transparency. A cute cartoon dragon sticker. The image has alpha channel and the background is transparent.
GIGAZINE 的试用里,只在提示词里写"透明 PNG"也得到了完全透明的背景,但那是一次测试;要稳定出透明图,还是用官方句式。生成后如果看到白底或黑底,先别急着判断失败:很多网页预览和聊天软件会把透明通道压平,用 GIMP、Photoshop 这类支持透明的软件打开再确认。
从现有照片里抠主体,用 ComfyUI 的去背景模板,它用的指令是 Remove the background, and output a PNG image。
多参考图编辑:最多 10 张,按编号点名
官方支持的上限是 10 张参考图。ComfyUI 的 Text Encode Qwen Image 2.1 节点虽然有 16 个输入槽(image_1 到 image_16),但官方编辑模板只接了前 10 个,16 只是节点的槽位数,不是模型承诺的能力(ComfyUI 教程)。
image_1 是被编辑的那张图,其余的提供素材;提示词里用 <image1>、<image2> 按编号指代。ComfyUI 教程的例子:
Keep the character and pose in <image1> unchanged, put this light blue denim shirt from <image2> on the character, preserve the original facial features, hair, body shape and pose多图合成的成功率不高。GIGAZINE 用两张图合成发布会场景,需要反复生成很多张才挑出一张合格的,失败图里有多出来的手臂、结构变形。这类任务可以打开模板里的提示词增强(refine_prompt,默认关闭),让改写模型先把短指令扩成详细描述。
局部修改:先在图上画色块,再在提示词里点颜色
只想改图里一块区域时,在 ComfyUI 里右键提供 image_1 的 LoadImage 节点,选 Open in Mask Editor,用 Paint Pen 在要改的区域上涂色并保存。笔迹会写进图片本身,然后在提示词里点出颜色,比如"把红色区域里的夹克换成皮衣"。色块要画在目标区域以内;如果担心标记颜色带进结果,就在提示词里写明想要的最终颜色。
用 Python 部署:Diffusers 的 QwenImage21Pipeline 与 vLLM 服务
不用 ComfyUI 的话,官方推荐 Diffusers。依赖按 README:
pip install "torch>=2.4.0" "transformers>=5.17" accelerate pillow
pip install git+https://github.com/huggingface/diffusers
下面的脚本把 README 的文生图、透明图和省显存写法合在一起,显存不够时用 enable_model_cpu_offload() 把部分模型放到内存:
import torch
from diffusers import QwenImage21Pipeline

# 权重已从 ModelScope 下载到本地时,把模型 ID 换成本地目录路径
pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1", torch_dtype=torch.bfloat16
)
pipe.enable_model_cpu_offload()  # 显存充足时删掉这行,改用 pipe.to("cuda")

image = pipe(
    prompt=(
        "This is an RGBA image with transparency. A cute cartoon dragon sticker. "
        "The image has alpha channel and the background is transparent."
    ),
    width=1024,
    height=1024,
    num_inference_steps=40,
    generator=torch.Generator("cuda").manual_seed(42),
).images[0]

image.save("dragon.png")  # 模型生成透明图时保存为 RGBA
做编辑时,给 pipe() 传 image= 参数:单张传一个 PIL 图片,多参考图传图片列表(最多 10 张)。不传 width/height 时默认输出 2048×2048。
要给团队或应用提供服务,vLLM-Omni 可以起一个 OpenAI 风格的图片接口:
vllm serve Qwen/Qwen-Image-2.1 --omni --port 8091

curl http://localhost:8091/v1/images/generations \
  -H "Content-Type: application/json" \
-d '{"model": "Qwen/Qwen-Image-2.1", "prompt": "A ceramic teapot on a wooden table", "size": "1024x1024", "num_inference_steps": 40, "seed": 42}'SGLang(sglang generate)和 LightX2V 也在发布当天提供了支持,README 里还列出了 AMD ROCm 和 FlagOS 多芯片平台的运行方式。注意:自己架服务给别人用,仍然受研究许可约束。
百炼 API 多少钱:qwen-image-2.1-pro 北京 ¥0.25/张,1,000 张 ¥250
阿里云百炼把 2.1 作为托管模型 qwen-image-2.1-pro 出售,输入文字和图片、输出图片,按成功生成的张数计费。截至 2026 年 10 月 7 日,百炼中文文档列出的原价(不含限时优惠):
| 地域 | 价格 | 每分钟请求数 |
|---|---|---|
| 华北 2(北京) | ¥0.25/张 | 20 |
| 新加坡(国际) | ¥0.283404/张 | 20 |
| 美国(弗吉尼亚)、德国(法兰克福)、日本(东京)、中国香港 | ¥0.25/张 | 20 |
阿里云国际站价格页用美元标价:新加坡 $0.04/张,含 10 张免费额度(仅新加坡、90 天内有效);同一页注明生成失败不计费。
成本按"张数 × 单价"算:
- 北京地域:1,000 张 × ¥0.25 = ¥250;100 张 = ¥25。
- 新加坡国际站:1,000 张 × $0.04 = $40。
这里只算成功出图的张数,不含税费。生成成功但效果不满意、需要重抽的那些图照样计费,实际花费要按你的重抽比例往上加。
同平台的其他千问图像模型(国际站新加坡地域美元标价):qwen-image-3.0 $0.03/张,qwen-image-3.0-pro 1K $0.04/张、2K $0.075/张,qwen-image-2.0 $0.035/张,qwen-image-2.0-pro $0.075/张;3.0 系列的输入图另收 $0.003/张。
几点需要知道:
- 2.1-pro 和开源权重不一定完全相同:两者的官方描述一样,但阿里没有说明 Pro 是否就是开源那份权重;API 还有
prompt_extend(提示词扩写)这类托管版参数。所以本地效果和 API 效果不能直接互相代表。 - 并发:QwenCloud 模型页给出的限制是 10 个并发、异步队列 200 个任务、每分钟 20 次请求。批量任务要按这个节奏排队。
- 第三方平台:Kie.ai 也提供 Qwen-Image-2.1,1K 图约 $0.02/张、2K 约 $0.04/张,新用户有免费积分;它是否获得阿里的商用授权,页面上没有说明。
请求结构可以参考 QwenCloud 模型页给出的 DashScope 示例。下面的接入地址是 QwenCloud 的;用北京地域时,接入地址和 API Key 在百炼控制台获取,请求体结构相同:
curl --location 'https://maas.qwencloudapi.com/api/v1/services/aigc/multimodal-generation/generation' \
  --header 'Content-Type: application/json' \
  --header "Authorization: Bearer $DASHSCOPE_API_KEY" \
  --data '{
    "model": "qwen-image-2.1-pro",
    "input": {
      "messages": [
        {"role": "user", "content": [{"text": "A neon shop sign that reads \"QWEN IMAGE 2.1\", rainy night"}]}
      ]
    },
    "parameters": {"prompt_extend": true}
  }'
如果你在比较闭源图像 API 的价格和入口,可以对照 Nano Banana 2.1 发布:怎么用、API 价格与 10 月 29 日迁移期限。
Qwen-Image-2.1 跑不起来或效果不对:按症状排查
| 症状 | 先做什么 | 还不行 |
|---|---|---|
| 显存不足(OOM) | 分辨率降到 1024×1024,batch 保持 1,关掉其他占显卡的程序 | 换更小的量化版(GGUF Q4_K_M),或用 CPU 卸载;确认没开提示词增强 |
| ComfyUI 找不到模板或缺节点 | 更新 ComfyUI,必要时用 Nightly 版 | 检查启动日志里是否有节点导入失败 |
| 图像编辑特别慢 | 看 image_1 的像素尺寸。模板默认按参考图原尺寸出图,一张 3000×4000 的照片会变成约 12 MP 的画布 | 把编辑节点的 resolution 设成 1024,画布降到约 1 MP。ComfyUI 在 RTX 5090 上的数据是约 6 秒/步对 0.3 秒/步 |
| 负面提示词没效果 | cfg 1 时负面提示词本来就不生效 | 改成 cfg 2 |
| 图里的文字写错 | 换种子再出几张,或改 cfg 2 | 步数提到 40 |
| 手指畸形、细节发糊 | 步数提到 30–40 | 降低分辨率到 2K 以内 |
| 4K 出图跑偏 | 回到 2048×2048 等官方 2K 尺寸 | 需要大图时先出 2K 再放大 |
| 透明图显示为白底 | 用支持透明的软件打开确认 | 改用官方 RGBA 提示词句式 |
Qwen-Image-2.1 的其他问题
Qwen-Image-2.1 支持 MLX 吗?
官方仓库和 Unsloth 文档里都没有 MLX 版本。Unsloth 给 Apple Silicon 的起步方案是 12–16 GB 以上统一内存配 GGUF 量化版。社区如果出了 MLX 转换版,要自己在 Hugging Face 上找,并留意它同样受研究许可约束。
qwen-image-2.1-pro 和开源的 Qwen-Image-2.1 是同一个模型吗?
阿里没有说明。两者的介绍文字相同,都写着 7B、32 层单流 DiT,但 API 版本带 Pro 后缀,还有提示词扩写参数,也没有公布与开源版的对比数据。不要用 API 的效果推断本地部署的效果,反过来也一样。
可以用 Qwen-Image-2.1 训练 LoRA 吗?
可以。ModelScope 提供在线 LoRA 训练,Unsloth 和 ComfyUI 也能加载 LoRA。许可证允许为研究目的修改和制作衍生作品;如果你用它或它生成的图去训练模型并对外发布,要在文档里标注 "Built with Qwen" 或 "Improved using Qwen",用于商业仍需另行授权。
Qwen-Image-2.1 能写中文提示词吗?
官方文档没有说明支持哪些提示词语言,示例全部是英文。GIGAZINE 用日文提示词测试时能正常出图,中文提示词目前没有公开的测试结果。透明图这类有固定句式的功能,建议保留官方英文句式,只把中间的描述换成中文,出图后和全英文版本对比一次。