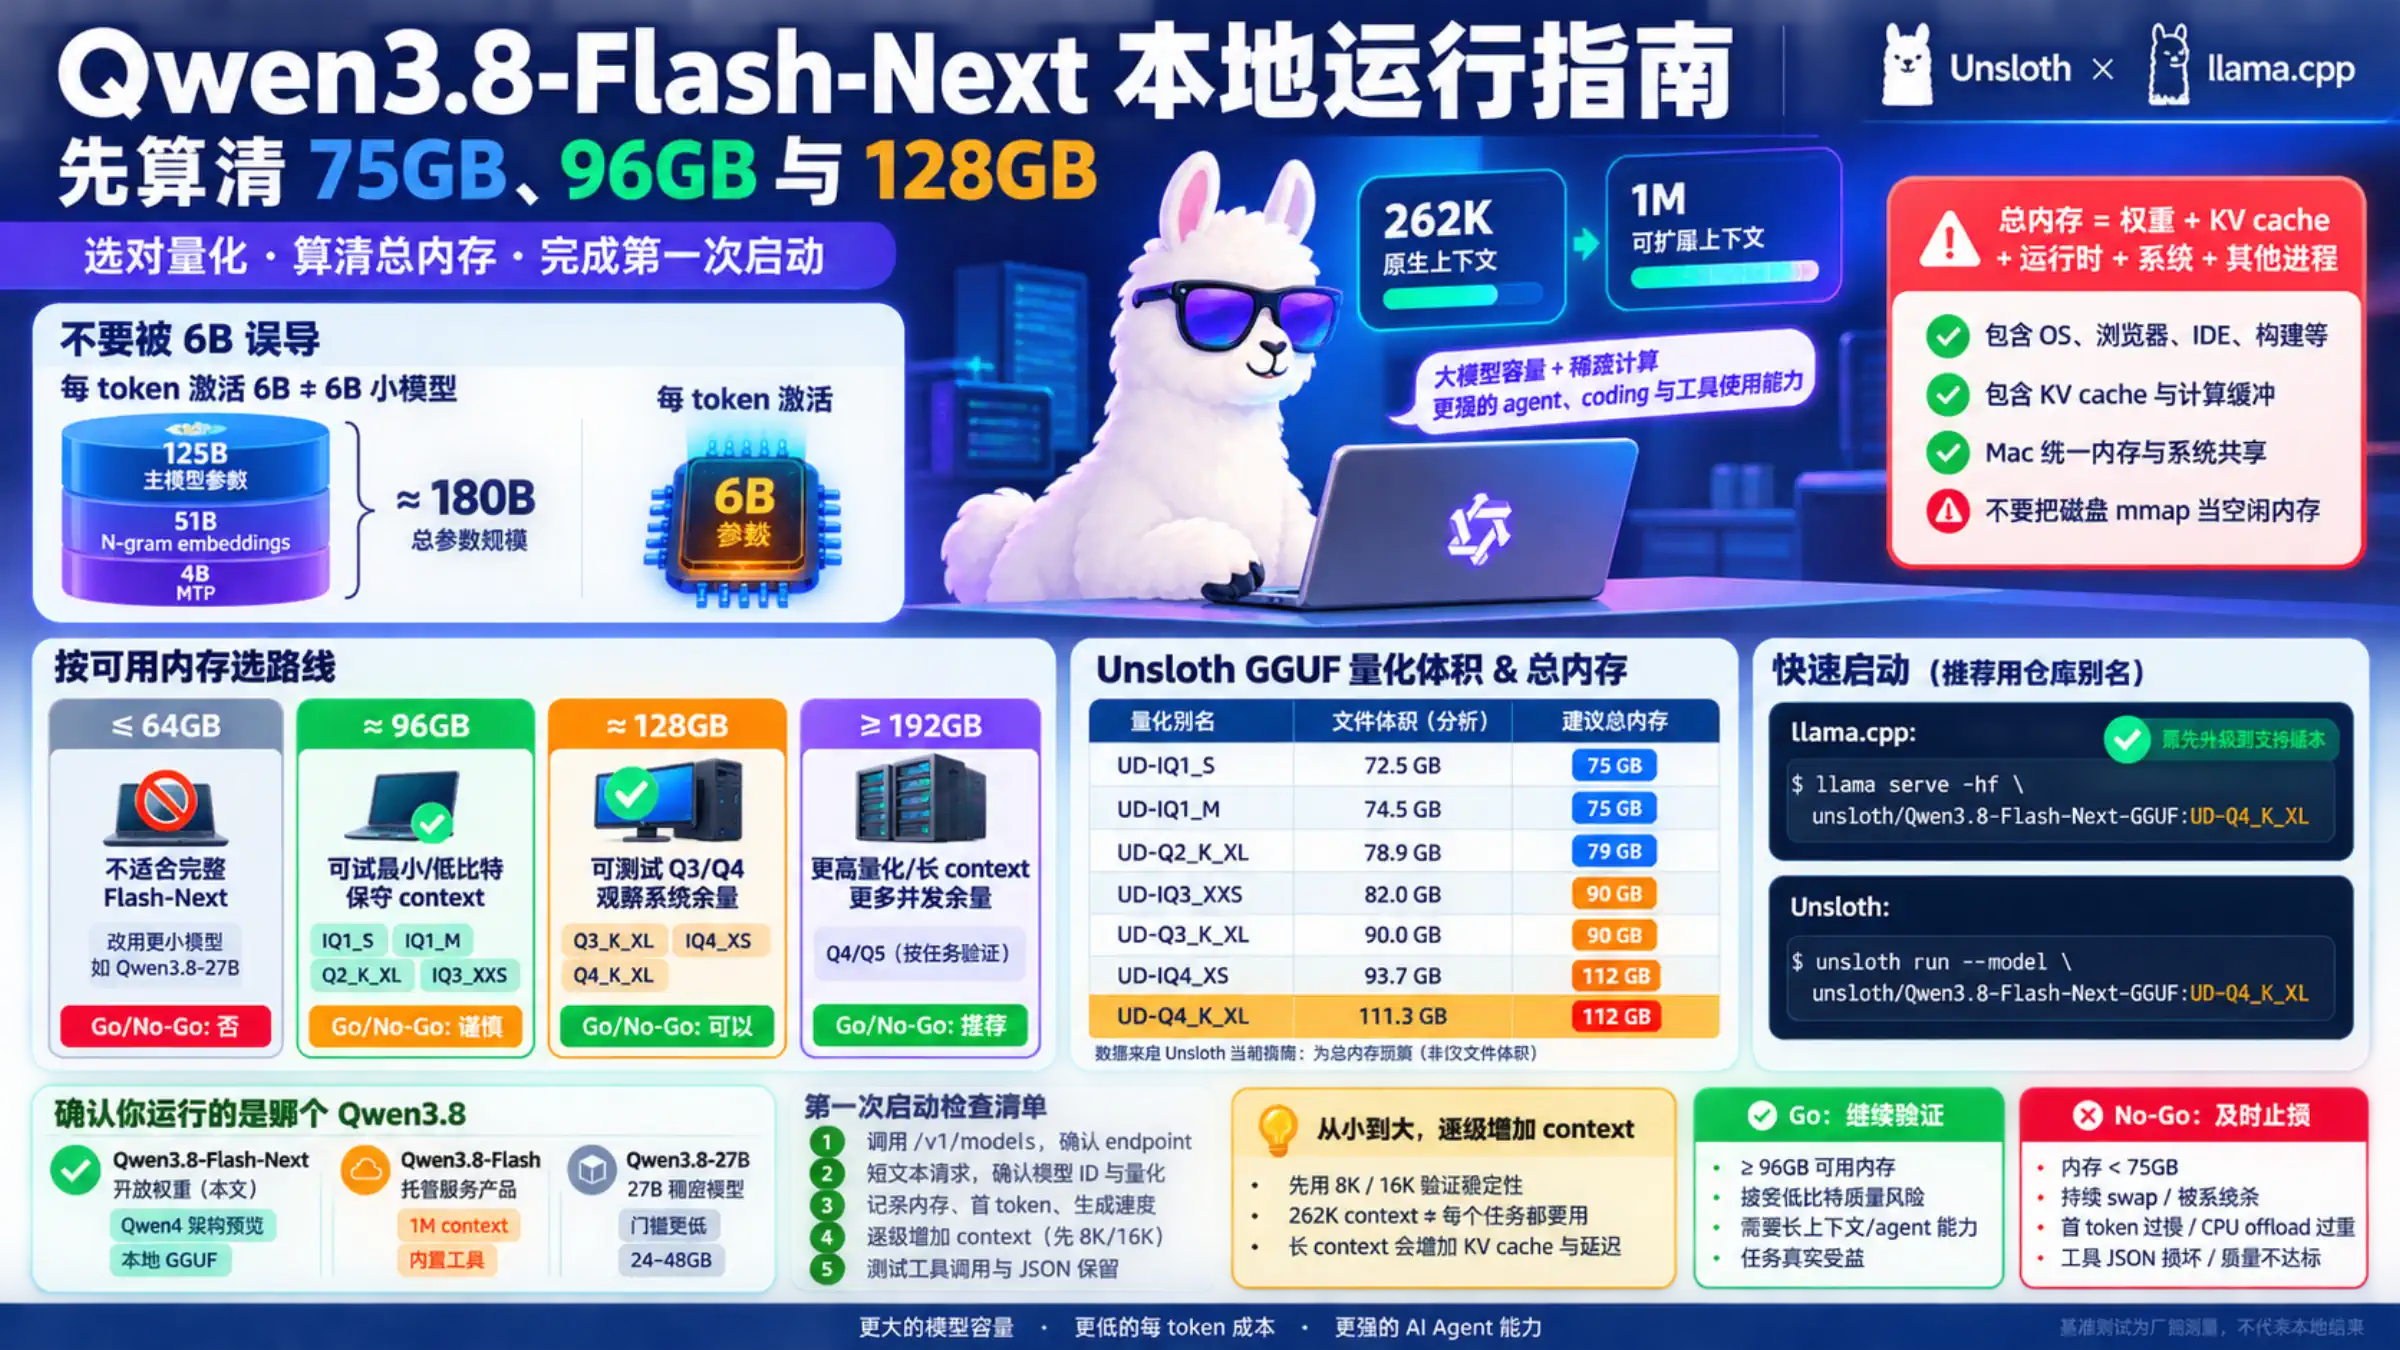
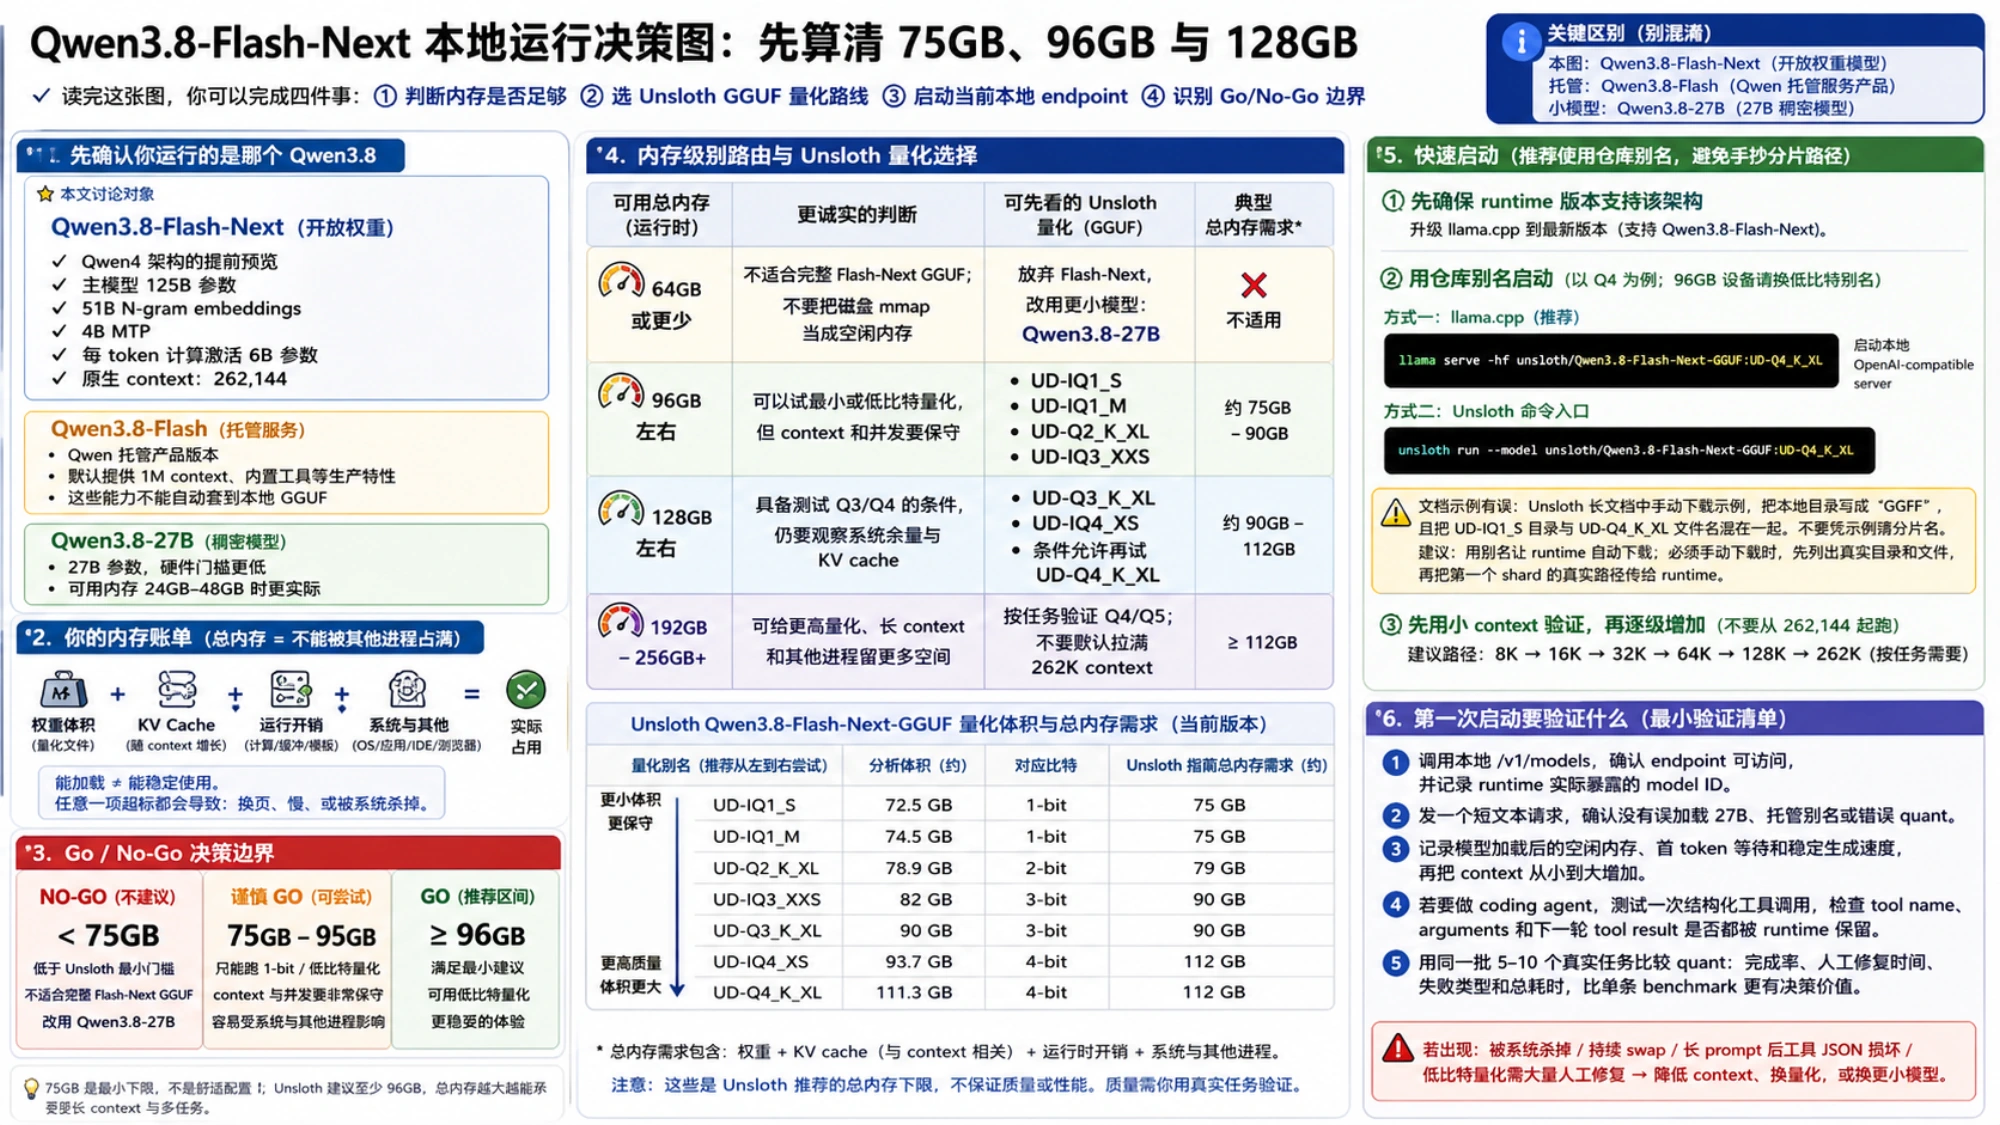
Qwen3.8-Flash-Next 能在本地运行,但它不属于“普通消费级显卡下载后就能直接用”的模型。Unsloth 给出的最小门槛是 75GB 总内存,并明确建议至少准备 96GB RAM 或统一内存;想尝试当前内存需求为 96–114GB 的 4-bit 量化版本,128GB 机器也只是合理起点,不代表可以无视系统和上下文开销。
最容易犯的错误,是把“每 token 激活 6B 参数”理解成“模型只占 6B 的内存”。Qwen 官方模型卡写得很清楚:主模型有 125B 参数,另有 51B N-gram embeddings 和 4B MTP。6B 描述的是一次 token 计算中激活的主模型参数,不是需要保存的全部权重。
你的机器应该选哪条路
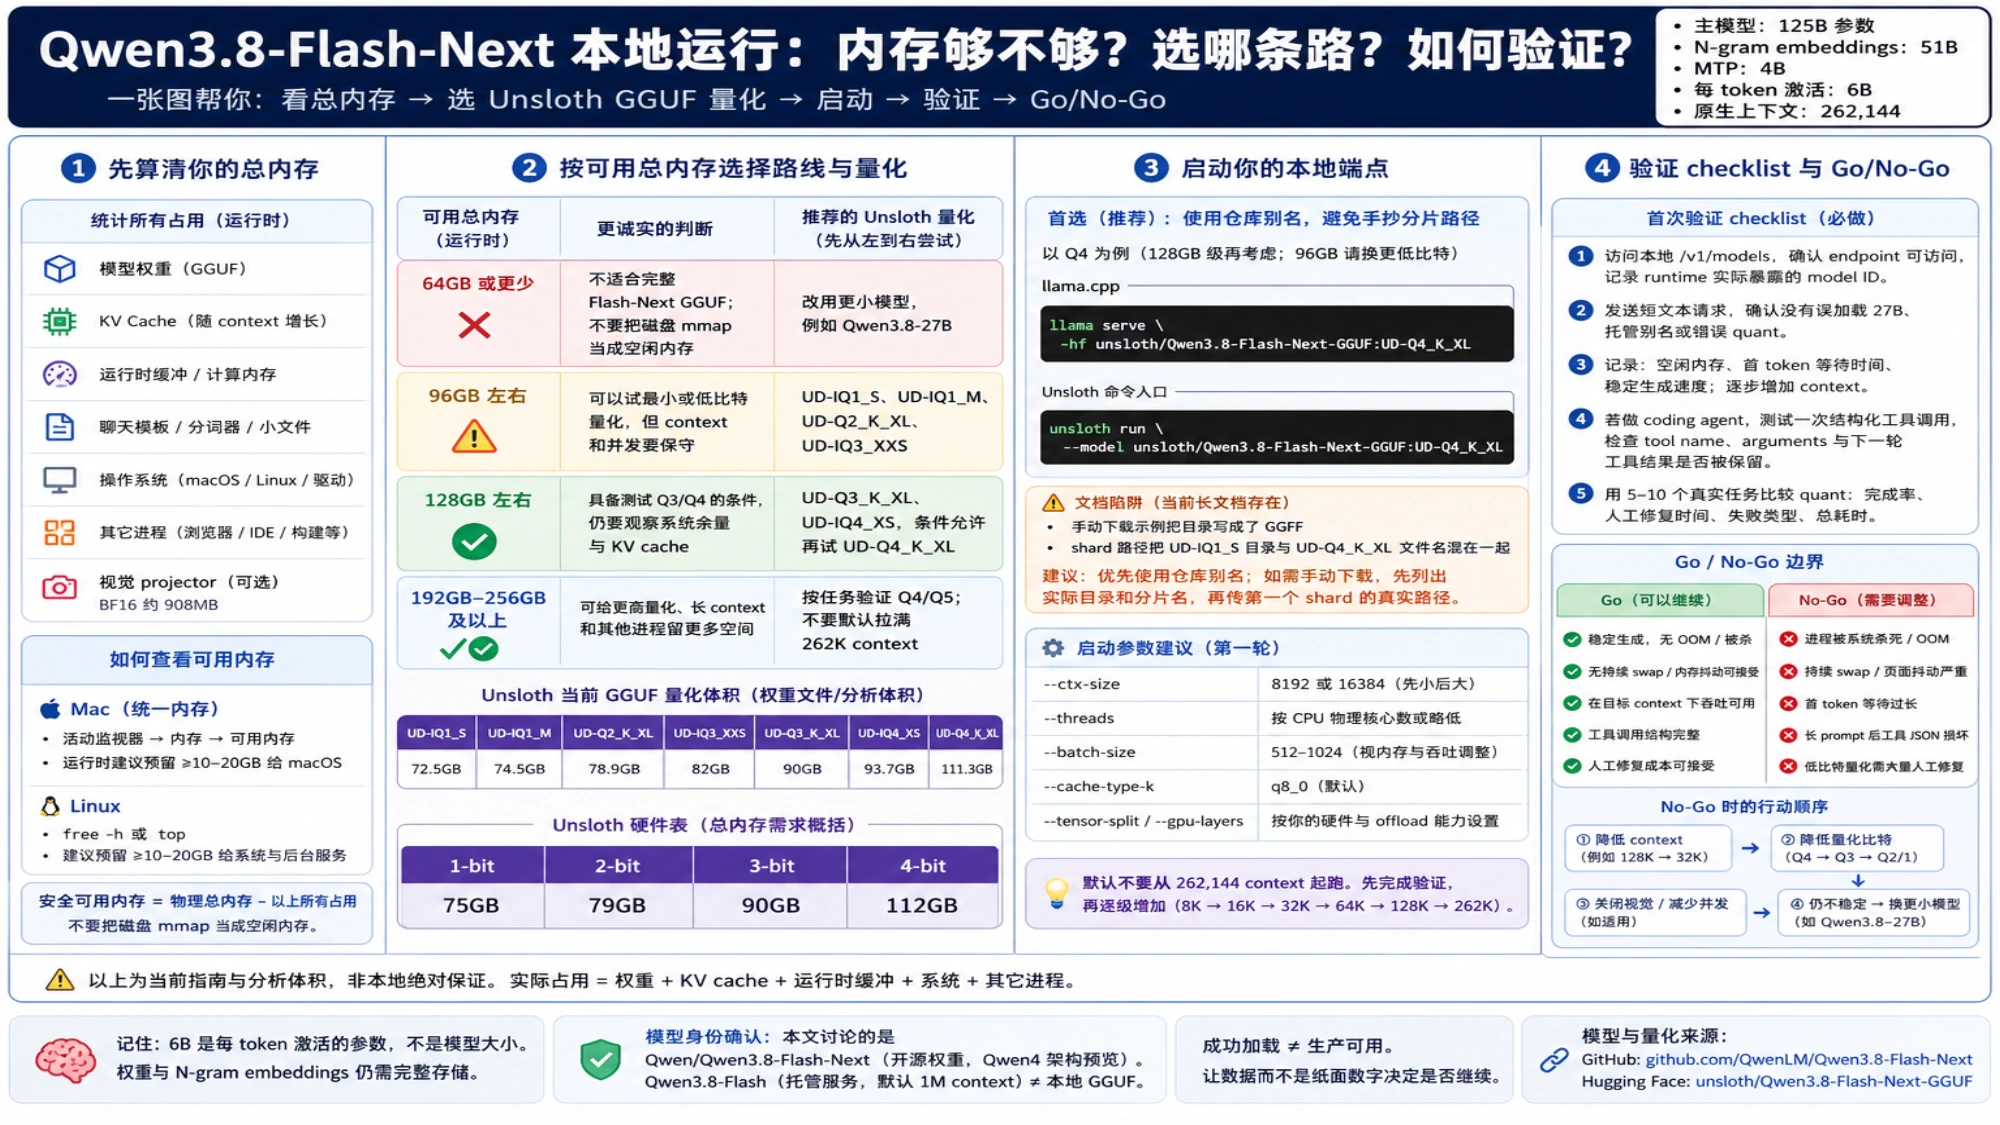
先看机器在模型运行时真正可用的总内存,而不是标称容量。Mac 的统一内存要和 macOS、桌面应用共享;独立 GPU 方案要把 VRAM、系统 RAM 与 offload 一起考虑;构建项目、浏览器和 IDE 也会抢占空间。
| 可用内存级别 | 适用判断 | 可先看的 Unsloth 量化 |
|---|---|---|
| 64GB 或更少 | 不适合完整 Flash-Next GGUF;不要把磁盘 mmap 当成空闲内存 | 改用更小模型,例如 Qwen3.8-27B |
| 96GB 左右 | 可以试最小或低比特量化,但应限制上下文长度和并发量 | UD-IQ1_S、UD-IQ1_M、UD-Q2_K_XL、UD-IQ3_XXS |
| 128GB 左右 | 具备测试 Q3/Q4 的条件,仍要观察系统余量与 KV cache | UD-Q3_K_XL、UD-IQ4_XS,条件允许再试 UD-Q4_K_XL |
| 192GB–256GB 以上 | 可给更高量化、更长的上下文和其他进程留更多空间 | 按任务验证 Q4/Q5;不要默认拉满 262K 上下文 |
Unsloth 当前指南列出的量化文件/分析体积约为:UD-IQ1_S 72.5GB、UD-IQ1_M 74.5GB、UD-Q2_K_XL 78.9GB、UD-IQ3_XXS 82GB、UD-Q3_K_XL 90GB、UD-IQ4_XS 93.7GB、UD-Q4_K_XL 111.3GB。它的硬件表把 1/2/3/4-bit 的总内存需求概括为 75/79/90/96–114GB。
不能用总内存减去文件体积,就推算出可以安全使用的上下文长度。内存还要容纳 KV 缓存、计算缓冲、运行组件、操作系统和客户端。若启用视觉,还要加载独立视觉投影组件(projector);当前 GGUF 仓库中的 BF16 投影组件 约 908MB。模型能加载但系统持续换页、CPU offload 过重或首 token 等待太久,都属于“不适合当前工作流”。
先确认你运行的是哪一个 Qwen3.8
三个相近名称对应不同模型与服务:
Qwen/Qwen3.8-Flash-Next是这里说的开放权重模型,也是 Qwen4 架构的提前预览。Qwen3.8-Flash是 Qwen 托管服务中的产品版本。Qwen 表示它默认提供 1M token 上下文和内置工具等生产特性,这些不能自动套到本地 GGUF。Qwen3.8-27B是 27B 稠密模型,硬件门槛明显更低。如果你只有 24GB–48GB 级可用内存,先看Qwen3.8-27B 本地编程智能体指南更实际。
Flash-Next 的本地吸引力来自架构,而不是“小”。Qwen 把 Gated DeltaNet 与 Qwen Sparse Attention 结合,用 51B N-gram embeddings 扩大容量,并允许这部分更适合放到主机内存。Qwen 报告的编程、智能体与工具调用成绩值得验证,但它们来自厂商指定的评测环境,不能证明 Unsloth 某个量化在你的仓库里也会得到相同结果。
用仓库别名启动,避免手抄分片路径
较不容易配错的方式是让当前 llama.cpp 按仓库和量化别名下载分片。先升级到支持该模型架构的版本,再从一种内存能够容纳的量化版本开始。以下以 Q4 为例;96GB 设备不要照抄 Q4,应换成更低比特别名。
llama serve -hf unsloth/Qwen3.8-Flash-Next-GGUF:UD-Q4_K_XL该命令会启动兼容 OpenAI 接口的本地服务。也可以使用 Unsloth 的命令入口:
unsloth run --model unsloth/Qwen3.8-Flash-Next-GGUF:UD-Q4_K_XL使用仓库别名可以减少手动拼接分片路径的错误。若必须手动下载,先核对所选量化的实际目录和完整文件列表,再把第一个分片的真实路径传给推理程序;不要混用不同量化版本的目录和文件名。
首次启动不要直接设置 262,144 token 的上下文上限。先用 8K 或 16K token 检查模型身份与运行稳定性,再逐级增加。更长的上下文会增加 KV 缓存占用和提示词处理时间;即使模型支持 262K token,也应按实际任务设置上限。
第一次启动要验证什么
下载上百 GB 后,只看到聊天窗口出字还不够。用一组成本很低的检查把问题定位到正确层级:
- 调用本地
/v1/models,确认接口可访问,并记录推理程序实际返回的模型 ID。 - 检查启动日志中的仓库、文件与量化类型,确认没有误加载 27B 或其他版本,再发一个短文本请求验证能否正常生成。
- 记录模型加载后的空闲内存、首 token 等待和稳定生成速度,再逐步提高上下文上限。
- 若要用于编程智能体,测试一次结构化工具调用,而不是只看自然语言答案。检查工具名、参数及下一轮工具结果是否被推理程序正确保留。
- 用同一批 5–10 个真实任务比较量化版本:完成率、人工修复时间、失败类型和总耗时比一次基准测试分数更有决策价值。
如果进程被系统杀掉、持续使用交换空间、处理长提示词后工具 JSON 损坏,或低比特量化需要大量人工修复,就应缩短上下文、换量化,或者直接换更小模型。成功加载是兼容性信号,不是生产可用证明。
什么时候值得继续
当机器至少有 96GB 可用总内存、你接受低比特量化的质量风险,并且任务确实需要 Flash-Next 的智能体和长上下文能力时,它值得做一次受控验证。128GB 级统一内存是更合理的 Q3/Q4 实验平台;若还要并行运行 IDE、构建和多个智能体,额外余量会比标称的最大上下文长度更重要。
若机器低于这个级别,最好的优化通常不是寻找更激进的 mmap 参数,而是换小模型。Flash-Next 的价值是以稀疏计算降低每 token 成本,同时保留很大的模型容量;它没有消除权重和 N-gram embeddings 的存储事实。把这条边界理解清楚,才不会为一次“勉强能加载”支付几小时的等待和反复修复。
最后查看Qwen 官方仓库确认模型身份与当前推理框架支持,再从Unsloth GGUF 仓库选择量化。权重页当前标记为 qwen-community-1.0;商业或再分发使用应直接阅读实际许可文本,而不是只看标签。