Qwen-Image 2.1 — модель Alibaba для генерации и редактирования изображений. Её веса выложены 20 сентября 2026 года на Hugging Face и в репозитории на GitHub. Модель рисует картинки с прозрачным фоном, правит изображение по набору до 10 референсов и генерирует в нативном 2K. Скачать и запустить её можно бесплатно, но лицензия разрешает только исследования и оценку. Для работы на клиента, в магазине или внутри своего сервиса нужна отдельная коммерческая лицензия.
С чего начать, в зависимости от задачи:
- Посмотреть, на что способна модель, — официальное демо на Hugging Face, ничего не устанавливая.
- Генерировать у себя — ComfyUI со встроенными шаблонами. По оценке Unsloth, для старта хватает 12–16 ГБ видеопамяти с квантизацией GGUF Q4_K_M при 1024×1024.
- Подключить генерацию к своему продукту — облачная модель
qwen-image-2.1-proв Alibaba Cloud Model Studio: $0,04 за картинку в Сингапуре и $0,035333 в остальных регионах по состоянию на 7 октября 2026 года. Платный API работает по договорам Alibaba Cloud, а не по исследовательской лицензии весов.
Что умеет Qwen-Image 2.1 и чем она отличается от 2.0 и 3.0
Qwen-Image 2.1 — одна модель на две задачи: генерация по тексту и редактирование по инструкции, без смены чекпойнта. Генерирующая часть — 7 млрд параметров (32 слоя single-stream DiT). Текст и картинки-условия кодирует Qwen3-VL 8B, а VAE работает с четырьмя каналами RGBA, поэтому прозрачный фон модель рисует сама, а не вырезает потом (архитектура в README).
В карточке модели заявлены:
- обычные и прозрачные (RGBA) картинки из текста, правка прозрачных слоёв, вырезание объекта с фотографии;
- до 10 референсных изображений в одном запросе;
- локальные правки: нужную область можно обвести кружком, закрасить или передать отдельной маской;
- сохранение внешности людей и вида товаров при правке;
- нативное 2K: 2048×2048 для квадрата, 2400×1792 для 4:3, 2752×1536 для 16:9, 1536×2752 для 9:16.
Это заявления разработчика. Из сторонних данных есть рейтинг Artificial Analysis: в публикации начала октября 2026 года Qwen-Image 2.1 занимала 18-е место в обоих рейтингах — генерации по тексту (AA-Image-T2I v2.0) и редактирования (AA-Image-Editing v2.0) — и первое среди моделей с открытыми весами. Qwen-Image 2.0 в тех же рейтингах стояла на 72-м и 58-м местах. Рейтинги пересчитываются, так что это снимок на дату публикации. Сравнение Alibaba, где 2.1 обгоняет Nano Banana 2.0 и GPT-Image-1.5, взято из собственного графика компании.
Путаница с версиями объясняется тем, что серия то открывалась, то закрывалась:
| Версия | Когда вышла | Веса | Как пользоваться (цены API — Сингапур) |
|---|---|---|---|
| Qwen-Image | август 2025 | открыты, Apache 2.0 | локально |
| Qwen-Image 2.0 | февраль 2026 | закрыты | только API: $0,035, версия Pro — $0,075 за картинку |
| Qwen-Image 3.0 | июль 2026 | закрыты | только API: $0,03 за картинку |
| Qwen-Image 2.1 | сентябрь 2026 | открыты, исследовательская лицензия | локально; API qwen-image-2.1-pro — $0,04 за картинку |
Даты выпуска — по обзорам GIGAZINE и Unite.AI, цены — по прайсу Alibaba Cloud на 7 октября 2026 года. Сказать, что 2.1 лучше 3.0 или наоборот, нельзя: для 3.0 Alibaba не опубликовала ни весов, ни бенчмарков. Практическая разница другая: 2.1 можно запустить на своём железе, 3.0 — только через облако.
Бесплатно ли Qwen-Image 2.1: что разрешает исследовательская лицензия
Платить за веса не нужно, но это не открытая лицензия в привычном смысле. Qwen Research License Agreement от 20 сентября 2026 года выдаёт права «только для некоммерческих целей», а некоммерческим называет использование «исключительно для исследований или оценки». Для коммерческого использования нужна отдельная лицензия, запрос отправляют на model-business@notice.qwencloud.com (текст лицензии). Первая Qwen-Image 2025 года выходила под Apache 2.0, поэтому привычка «Qwen можно брать в работу» к версии 2.1 не переносится.
Из той же лицензии следует ещё несколько вещей:
- Квантованные сборки GGUF, FP8 и INT8 — это те же веса в другой форме, лицензия на них та же.
- Тот, кто распространяет веса или производные от них, прикладывает текст соглашения и файл Notice с указанием авторских прав, а изменённые файлы помечает.
- Если с помощью модели или её результатов обучена или улучшена другая модель и её выкладывают в общий доступ, в документации нужна пометка «Built with Qwen» или «Improved using Qwen».
- Споры по лицензии разбираются по праву КНР в судах Ханчжоу.
Отдельный вопрос — права на сами картинки. 21 сентября 2026 года официальный аккаунт Qwen в X ответил пользователю, что результаты генерации не входят в лицензируемые материалы и права на сгенерированные изображения остаются у пользователя (ответ приводит GIGAZINE). Это ответ в соцсети, а не пункт лицензии. И он объясняет, кому принадлежат картинки, но не разрешает запускать модель ради заработка.
| Как вы используете модель | Что из этого следует |
|---|---|
| Тестируете, сравниваете с другими моделями, пишете обзор | Исследование или оценка — прямо разрешено лицензией |
| Рисуете для себя, без денег и клиентов | В определении лицензии такого случая нет: там названы только исследования и оценка |
| Делаете картинки для клиента, магазина, рекламы | Коммерческое использование: нужна отдельная лицензия от Qwen |
| Встраиваете модель в свой сервис или продаёте доступ | Коммерческая лицензия плюс условия распространения из лицензии |
| Пробуете бесплатные генерации в консоли Model Studio | Только для оценки модели: без коммерции, без передачи третьим лицам, метки «AI-generated» удалять нельзя (условия Model Studio) |
Вызываете платный API qwen-image-2.1-pro | Действуют договоры Alibaba Cloud, а не исследовательская лицензия весов; что они разрешают вашему проекту, сверьте с договором до запуска |
Это пересказ условий, а не юридическая консультация. Если проект приносит деньги, надёжнее всего получить письменный ответ от Qwen на адрес из лицензии.
Какой путь выбрать для Qwen-Image 2.1: демо, локально или API
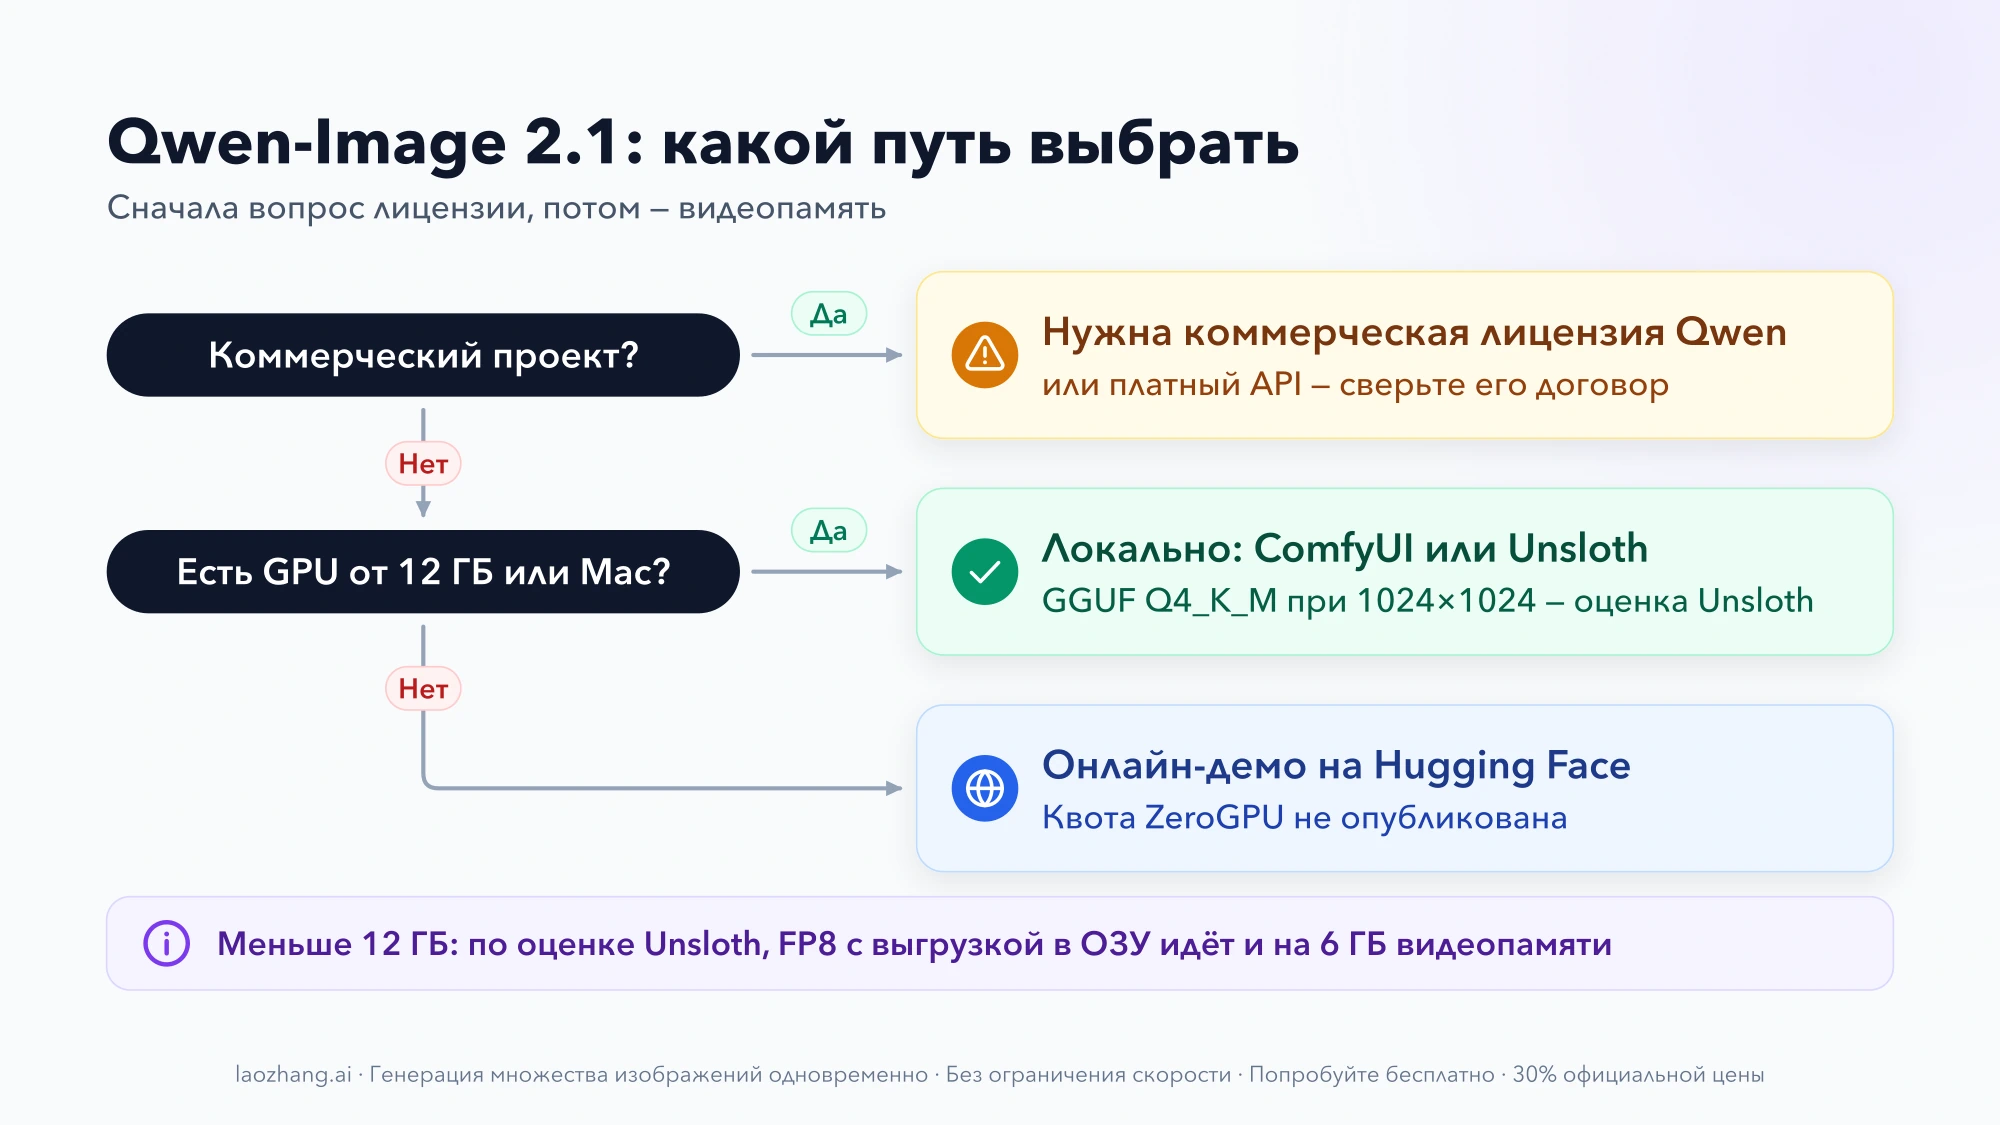
Выбор определяют три вещи: какое у вас железо, сколько картинок нужно в месяц и есть ли в работе коммерция.
| Ваша ситуация | Путь | Что учесть |
|---|---|---|
| Видеокарты нет, хочется посмотреть на модель | Демо на Hugging Face (работает на ZeroGPU) или онлайн-генерация в ModelScope | Квота и очередь ZeroGPU не опубликованы. Бесплатный wuli.art, по README, рассчитан на пользователей из материкового Китая |
| Видеокарта NVIDIA на 12–24 ГБ | ComfyUI со встроенными шаблонами | Генерация, редактирование и удаление фона в одном интерфейсе |
| Mac на Apple Silicon с 12–16 ГБ памяти и больше | Квантованные GGUF-сборки Unsloth | Нужен бэкенд с поддержкой GGUF; скорость Unsloth не приводит |
| Только процессор и 12–16 ГБ ОЗУ | GGUF Q4_K_M с текстовым энкодером Q4_K_XL | Работает по оценке Unsloth, скорость не указана |
| Нужны сотни картинок для продукта, своей GPU нет | API qwen-image-2.1-pro | $0,04 за картинку, не больше 20 запросов в минуту |
| Коммерческий проект на своём железе | Сначала коммерческая лицензия, потом любой локальный путь | Исследовательская лицензия этот случай не покрывает |
Если нужен просто бесплатный онлайн-генератор без установки и вопросов с лицензией весов, посмотрите подборку «Какой бесплатный ИИ-генератор изображений лучше в 2026 году?»: она написана до выхода 2.1, но сравнивает бесплатные лимиты других сервисов.
Сколько VRAM нужно для Qwen-Image 2.1: стартовые конфигурации Unsloth
В README Qwen требований к памяти нет. Ближе всего к ним таблица Unsloth, которая выпустила квантованные сборки. Сама Unsloth называет эти цифры оценками, а не проверенными минимумами: расход памяти зависит от разрешения и настроек выгрузки.
| Ваше железо | С чего начать |
|---|---|
| 6 ГБ видеопамяти | FP8 с выгрузкой (оффлоадом) в ОЗУ; генерация медленнее, но, по Unsloth, не больше чем вдвое |
| 12–16 ГБ видеопамяти | GGUF Q4_K_M, 1024×1024, по одной картинке |
| 24 ГБ видеопамяти | INT8 или FP8 при 512×512, либо GGUF Q4_K_M при 1024×1024 |
| Только процессор, 12–16 ГБ ОЗУ | GGUF Q4_K_M с текстовым энкодером Q4_K_XL |
| Apple Silicon, 12–16 ГБ объединённой памяти (unified memory) и больше | GGUF с совместимым нативным бэкендом |
В вводной части той же страницы указано, что модель запускается на 11 ГБ видеопамяти с GGUF и на 24 ГБ с INT8/FP8. Между INT8 и FP8 Unsloth выбирает INT8: файл весит 7,26 ГБ против 7,12 ГБ, а средняя ошибка LPIPS ниже — 0,064 против 0,112 (чем меньше, тем ближе к полной точности). Размеры картинки должны делиться на 32; в Unsloth допускается до 2048 пикселей по стороне. Начните с 1024×1024 и поднимайте разрешение, пока хватает памяти. Уменьшение числа шагов ускоряет генерацию, но память не освобождает.
Две точки отсчёта по скорости, обе сторонние:
- GIGAZINE запускала модель в ComfyUI на Intel Arc Pro B70 с 32 ГБ и Ryzen 5 7600X: при 1024×1024 и 25 шагах первая картинка заняла около 45 секунд, следующие — около 30. Это одна машина и один тестер.
- В документации ComfyUI правка на холсте около 12 Мп на RTX 5090 идёт примерно 6 секунд на итерацию, а на холсте около 1 Мп — около 0,3 секунды.
Учтите и дополнительный расход: модели переписывания промпта (Qwen-Image-2.1-PE-T2I и PE-I2I) — это отдельные модели на 9 млрд параметров, и с включённым улучшением промпта памяти понадобится больше.
Если Unsloth вам удобнее ComfyUI, порядок такой: в Unsloth Desktop (macOS, Windows, Linux) откройте Images, выберите GGUF- или FP8-сборку Qwen-Image-2.1 и генерируйте с рекомендованными настройками: 40 шагов, guidance 1.0, пустой негативный промпт, 1024×1024. Сама Unsloth пишет, что модель доступна у неё только для генерации по тексту, но ниже на той же странице показывает вкладку Edit. Для редактирования надёжнее ComfyUI. Тот же подход к расчёту памяти для языковой модели разобран в статье «Как запустить Qwen3.8-Flash-Next локально через Unsloth и не ошибиться с памятью».
Установка Qwen-Image 2.1 в ComfyUI: шаблоны и файлы моделей
ComfyUI поддерживает модель штатно, без сторонних нод. Порядок такой:
- Обновите ComfyUI. Если шаблонов Qwen-Image 2.1 в библиотеке нет, версия устарела; если при загрузке воркфлоу не хватает нод, нужна свежая nightly-сборка.
- Откройте библиотеку шаблонов и найдите «Qwen-Image-2.1». Шаблонов три: Text to Image, Image Edit и Remove Background (удаление фона).
- При первом открытии ComfyUI сообщит, что моделей не хватает. Нажмите Show details, затем Download All.
- Перезапустите ComfyUI или обновите страницу, впишите промпт и нажмите Run.
Если скачиваете файлы вручную, они лежат в репозитории Comfy-Org и раскладываются так:
ComfyUI/models/
├── diffusion_models/
│   ├── qwen_image_2.1_int8_convrot.safetensors   # грузят шаблоны, меньше памяти
│   └── qwen_image_2.1_bf16.safetensors           # полная точность, больше памяти
├── text_encoders/
│   ├── qwen3vl_8b_int8_convrot.safetensors       # грузят шаблоны
│   ├── qwen3vl_8b_bf16.safetensors
│   ├── qwen3.5_9b_qwen_image_2.1_pe_t2i.int8_convrot.safetensors   # улучшение промпта, по желанию
│   └── qwen3.5_9b_qwen_image_2.1_pe_i2i.int8_convrot.safetensors   # то же для правки
└── vae/
    └── qwen_image_2.1_vae_bf16.safetensors
Для первого запуска хватит трёх файлов: диффузионной модели INT8, текстового энкодера INT8 и VAE. Энкодеры для улучшения промпта нужны, только если включить refine_prompt — по умолчанию он выключен.
Первый запуск в ComfyUI: 25 шагов, cfg 1 и 4 Мп для 2K
Шаблоны уже настроены на рабочие значения: 25 шагов, cfg 1, сэмплер euler, планировщик simple. Менять стоит по одному параметру при фиксированном seed. Что из этого следует на практике (документация ComfyUI):
- Негативный промпт при cfg 1 не работает: ComfyUI пропускает этот проход. Он начинает действовать, только если поднять cfg.
- Плотный текст и цифры точнее при cfg 2, ценой пересвеченных краёв. При cfg 5 качество сильно падает, при cfg 0,5 изображение разваливается.
- Шаги: официальный пайплайн Qwen рассчитан примерно на 40–50 шагов, шаблон начинает с 25. Простые локальные правки держатся и на 4–8 шагах, руки и пальцы устаканиваются примерно к 30 шагам, а переход с 25 на 40 убирает рябь в мелких деталях.
- Разрешение: в ноде Resolution Selector 1,0 Мп — это примерно 1024×1024. Для нативного квадрата 2048×2048 поставьте около 4,0 Мп. Выше 2K, например в 4K, модель хуже следует промпту.
- Надпись не получилась — смените seed. В тесте GIGAZINE текст газетного заголовка с первого seed не вышел, а со следующего лёг правильно.
О русских промптах в официальных материалах ничего не сказано; японские в тесте GIGAZINE модель понимала. Если русская формулировка срабатывает плохо, попробуйте ту же мысль по-английски — все примеры в документации на английском.
Прозрачный PNG в Qwen-Image 2.1: формат промпта и проверка альфа-канала
Qwen рекомендует оборачивать описание в фиксированные фразы (README, раздел про прозрачность):
This is an RGBA image with transparency. <ваше описание>. The image has alpha channel and the background is transparent.Например: This is an RGBA image with transparency. A cute cartoon dragon sticker. The image has alpha channel and the background is transparent.
В тесте GIGAZINE хватило просто написать в промпте «transparent PNG», и фон тоже вышел полностью прозрачным. Это одна проверка; официальная формулировка надёжнее.
Проверяйте результат в редакторе с поддержкой альфа-канала — GIMP, Krita, Photoshop: прозрачные участки там видны как шахматная сетка. Превью в браузере и мессенджеры часто подставляют сплошной фон, и кажется, что прозрачности нет, хотя в файле она есть. В Diffusers картинка сохраняется в RGBA, если модель сгенерировала прозрачность.
Чтобы убрать фон с готовой фотографии, есть отдельный шаблон Remove Background. Он использует ту же модель правки с промптом Remove the background, and output a PNG image.
Редактирование по референсам: 10 картинок, а не 16 слотов
Официально модель принимает до 10 референсных изображений. Нода Text Encode Qwen Image 2.1 в ComfyUI показывает 16 слотов (от image_1 до image_16), но шаблоны правки подключают только первые 10. Шестнадцать — это число входов ноды, а не заявленная возможность модели, поэтому рассчитывайте на 10 (документация ComfyUI).
Как устроена правка:
image_1— та картинка, которую вы меняете, остальные дают материал. В промпте на них ссылаются по номеру:<image1>,<image2>и так далее. Пример из документации:Keep the character and pose in <image1> unchanged, put this light blue denim shirt from <image2> on the character, preserve the original facial features, hair, body shape and pose.- Размер холста берётся от
image_1. Приresolution0 (так в шаблоне) фото 3000×4000 даёт холст 3008×4000, около 12 Мп, и правка идёт медленно. Приresolution1024 тот же кадр считается примерно в 896×1184. Если правка тормозит, сначала проверьтеresolutionи размер референсов. - Локальная правка: откройте Mask Editor на ноде LoadImage с
image_1, закрасьте область инструментом Paint Pen и сохраните. В промпте назовите цвет метки, например «change the jacket in the red area». Метка должна лежать внутри области, которую вы меняете. - Память: нода Qwen Image 2.1 Cache хранит закешированный префикс. В режиме
cpuкеш лежит в ОЗУ и почти не замедляет работу,int8вдвое уменьшает его размер.
Ждать идеального кадра с первой попытки не стоит: в тесте GIGAZINE сложная правка по двум картинкам удавалась редко, и подходящий результат пришлось выбирать из многих генераций.
Запуск через Diffusers и vLLM-Omni: код с выгрузкой в ОЗУ
Для своего скрипта или сервера есть официальный пайплайн QwenImage21Pipeline в Diffusers. Код ниже собран из примеров README: он генерирует прозрачный стикер 1024×1024 и при нехватке видеопамяти выгружает части модели в ОЗУ. Скачиваются полные веса bf16, а не квантованные, поэтому для выгрузки нужен запас оперативной памяти.
pip install "torch>=2.4.0" "transformers>=5.17" accelerate pillow
pip install git+https://github.com/huggingface/diffusersimport torch
from diffusers import QwenImage21Pipeline
pipe = QwenImage21Pipeline.from_pretrained(
"Qwen/Qwen-Image-2.1", torch_dtype=torch.bfloat16
)
pipe.enable_model_cpu_offload() # если видеопамяти хватает, вместо этого: pipe.to("cuda")
image = pipe(
prompt=(
"This is an RGBA image with transparency. "
"A red fox mascot sticker, flat vector style. "
"The image has alpha channel and the background is transparent."
),
width=1024,
height=1024,
num_inference_steps=40,
generator=torch.Generator("cuda").manual_seed(42),
).images[0]
image.save("fox_sticker.png")По умолчанию пайплайн генерирует 2048×2048 за 40 шагов. Для правки передайте исходник в image=, для нескольких референсов — список картинок.
Если нужен локальный HTTP-сервер, vLLM-Omni поднимает его одной командой и отдаёт эндпоинт /v1/images/generations в стиле OpenAI:
vllm serve Qwen/Qwen-Image-2.1 --omni --port 8091

curl http://localhost:8091/v1/images/generations \
  -H "Content-Type: application/json" \
  -d '{"model": "Qwen/Qwen-Image-2.1", "prompt": "A ceramic teapot on a wooden table", "size": "1024x1024", "num_inference_steps": 40, "seed": 42}'
Ещё в README есть варианты для SGLang (sglang generate), LightX2V, видеокарт AMD через ROCm и чипов через FlagOS. Лицензия от способа запуска не зависит: сервер, который отдаёт картинки клиентам, — коммерческое использование.
Цена API Qwen-Image 2.1: $0,04 за картинку, 1 000 картинок — $40
В Alibaba Cloud Model Studio модель продаётся как qwen-image-2.1-pro: на входе текст и картинки, на выходе изображение. Совпадает ли она байт в байт с открытыми весами, Alibaba не пишет. Описание у неё то же (7 млрд параметров, 32 слоя), но в названии стоит Pro, а в запросе есть параметр prompt_extend для автоматического расширения промпта. Поэтому считайте её облачной версией 2.1, а не гарантированно теми же файлами, что лежат на Hugging Face.
| Регион | Цена за картинку | Бесплатно |
|---|---|---|
| Сингапур | $0,04 | 10 картинок на 90 дней (только в этом регионе) |
| Пекин, Гонконг, Франкфурт, Вирджиния, Токио | $0,035333 | нет |
Цены — по прайсу Alibaba Cloud на 7 октября 2026 года, это базовые тарифы без акций. Неудачные генерации не тарифицируются. Лимиты на странице модели в QwenCloud: 20 запросов в минуту, 10 параллельных задач, очередь асинхронных задач до 200.
Расчёт простой — число картинок × цена:
- 100 картинок: 100 × $0,04 = $4 в Сингапуре или 100 × $0,035333 ≈ $3,53 в других регионах;
- 1 000 картинок: 1 000 × $0,04 = $40 или 1 000 × $0,035333 ≈ $35,33;
- если для одного годного кадра в среднем нужны три попытки (это допущение для примера), 1 000 годных картинок обойдутся в 3 000 × $0,04 = $120.
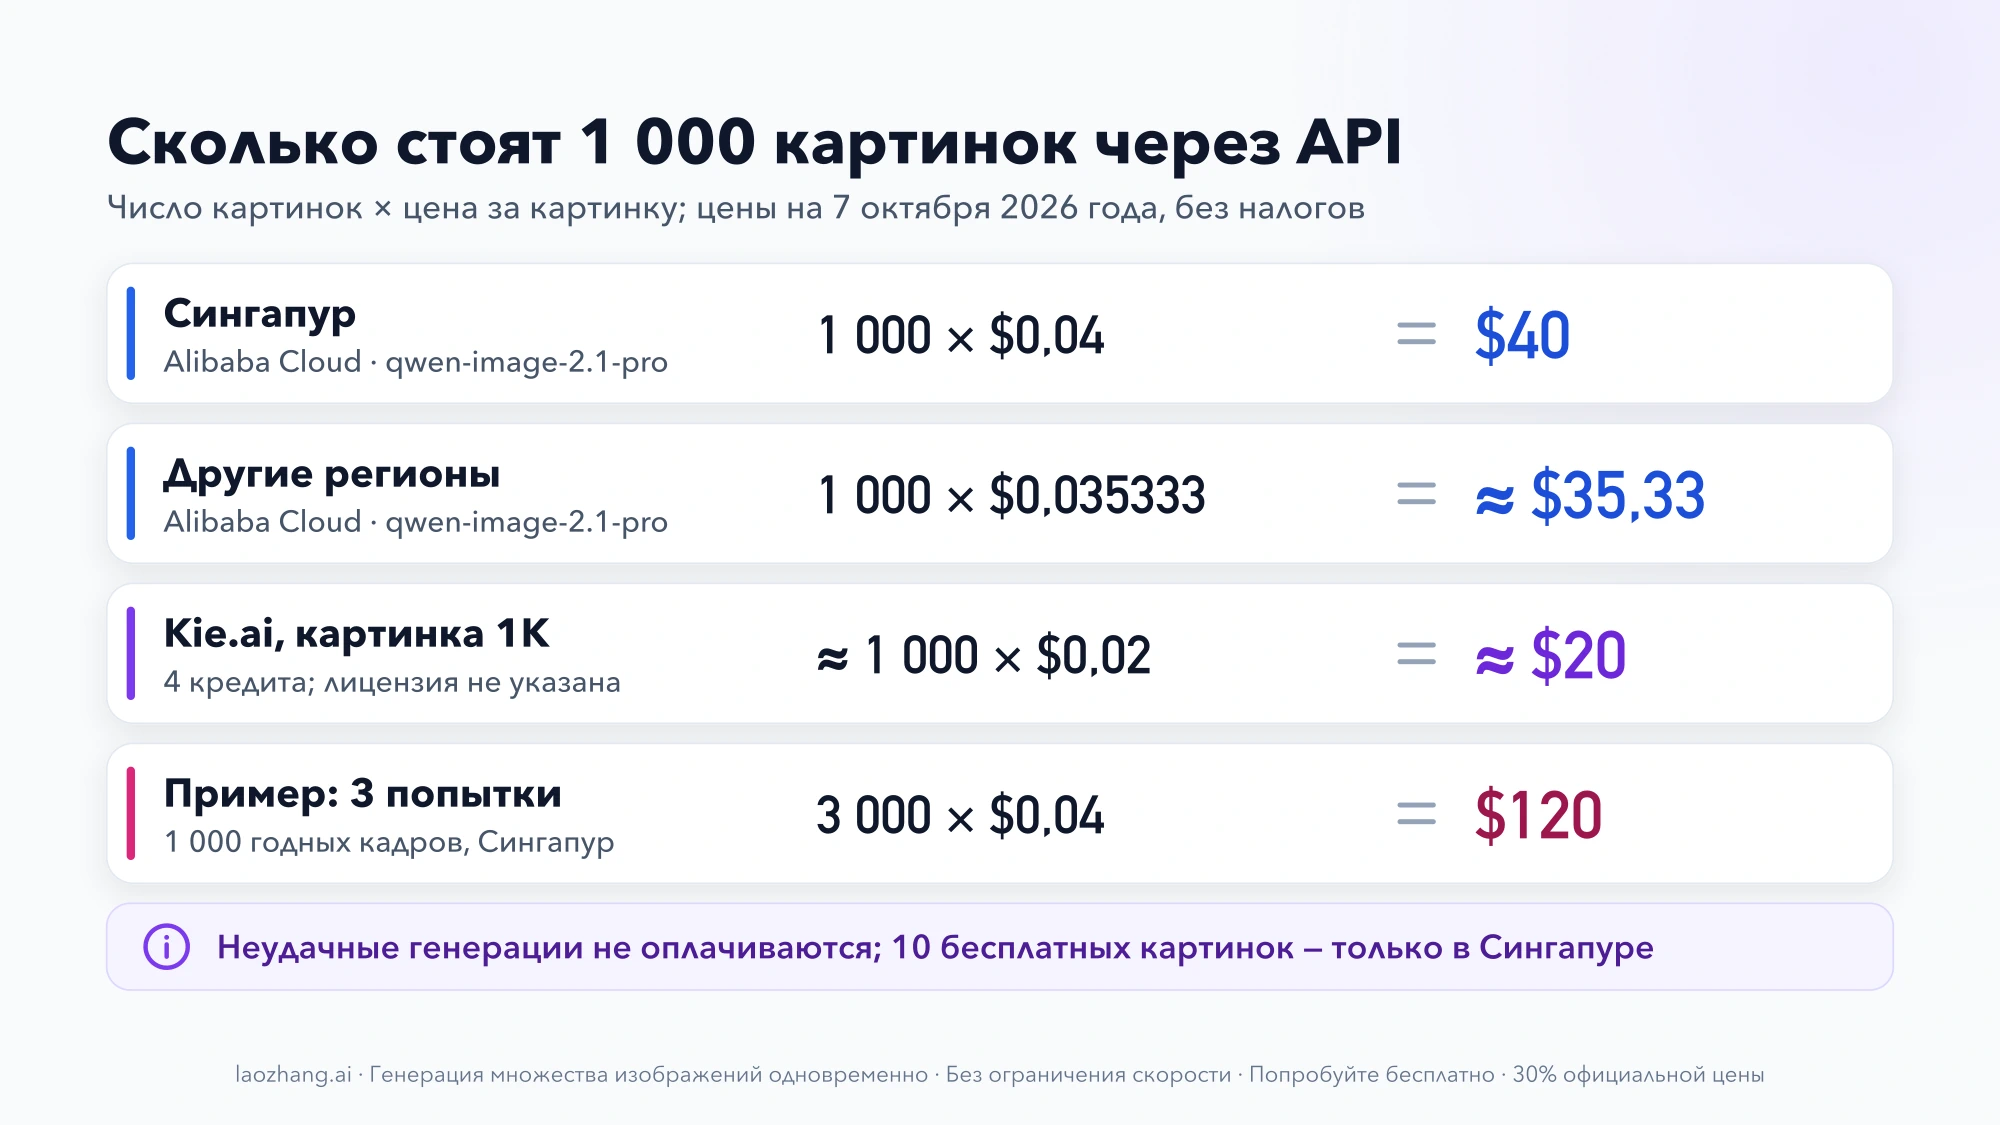
Налоги в расчёт не входят. Для сравнения: закрытая qwen-image-3.0 стоит $0,03 за картинку, то есть $30 за 1 000, но её веса скачать нельзя.
Минимальный запрос из документации QwenCloud выглядит так (ключ в переменной DASHSCOPE_API_KEY):
curl --location 'https://maas.qwencloudapi.com/api/v1/services/aigc/multimodal-generation/generation' \
  --header 'Content-Type: application/json' \
  --header "Authorization: Bearer $DASHSCOPE_API_KEY" \
  --data '{
    "model": "qwen-image-2.1-pro",
    "input": {"messages": [{"role": "user", "content": [{"text": "A neon shop sign that reads \"QWEN IMAGE 2.1\", rainy night"}]}]},
    "parameters": {"prompt_extend": true}
  }'
Сторонний вариант — Kie.ai: 4 кредита (около $0,02) за картинку 1K и 8 кредитов (около $0,04) за 2K, то есть примерно $20 или $40 за 1 000 штук; новым пользователям дают бесплатные кредиты. Есть ли у Kie коммерческая лицензия Alibaba на эту модель, на странице не сказано.
Прежде чем закладывать API в бюджет, проверьте, что сможете подключить способ оплаты к аккаунту Alibaba Cloud или Kie, и прочитайте их договоры в части прав на результаты. Если рассматриваете закрытую модель Google вместо Qwen, цены и условия разобраны в статье «Nano Banana 2.1: чем отличается, цена и переход до 29 октября».
Вопросы о Qwen-Image 2.1: продажа картинок, Mac и негативный промпт
Можно ли продавать картинки, сделанные в Qwen-Image 2.1?
Официальный аккаунт Qwen в X написал, что права на сгенерированные изображения остаются у пользователя. Но лицензия весов разрешает только исследования и оценку, поэтому генерация на продажу — это коммерческое использование модели. Для неё нужна отдельная лицензия от Qwen или платный API, условия которого вы сверили со своим проектом.
Запустится ли Qwen-Image 2.1 на Mac?
По оценке Unsloth — да, на Apple Silicon с 12–16 ГБ объединённой памяти и больше, через GGUF-сборки и бэкенд с их поддержкой. Скорость на Mac в документации Unsloth и в README Qwen не указана.
Почему в Qwen-Image 2.1 не работает негативный промпт?
В шаблонах ComfyUI стоит cfg 1, а при таком значении ComfyUI пропускает проход с негативным промптом. Чтобы он заработал, поднимите cfg, например до 2, и сравните результат на том же seed.