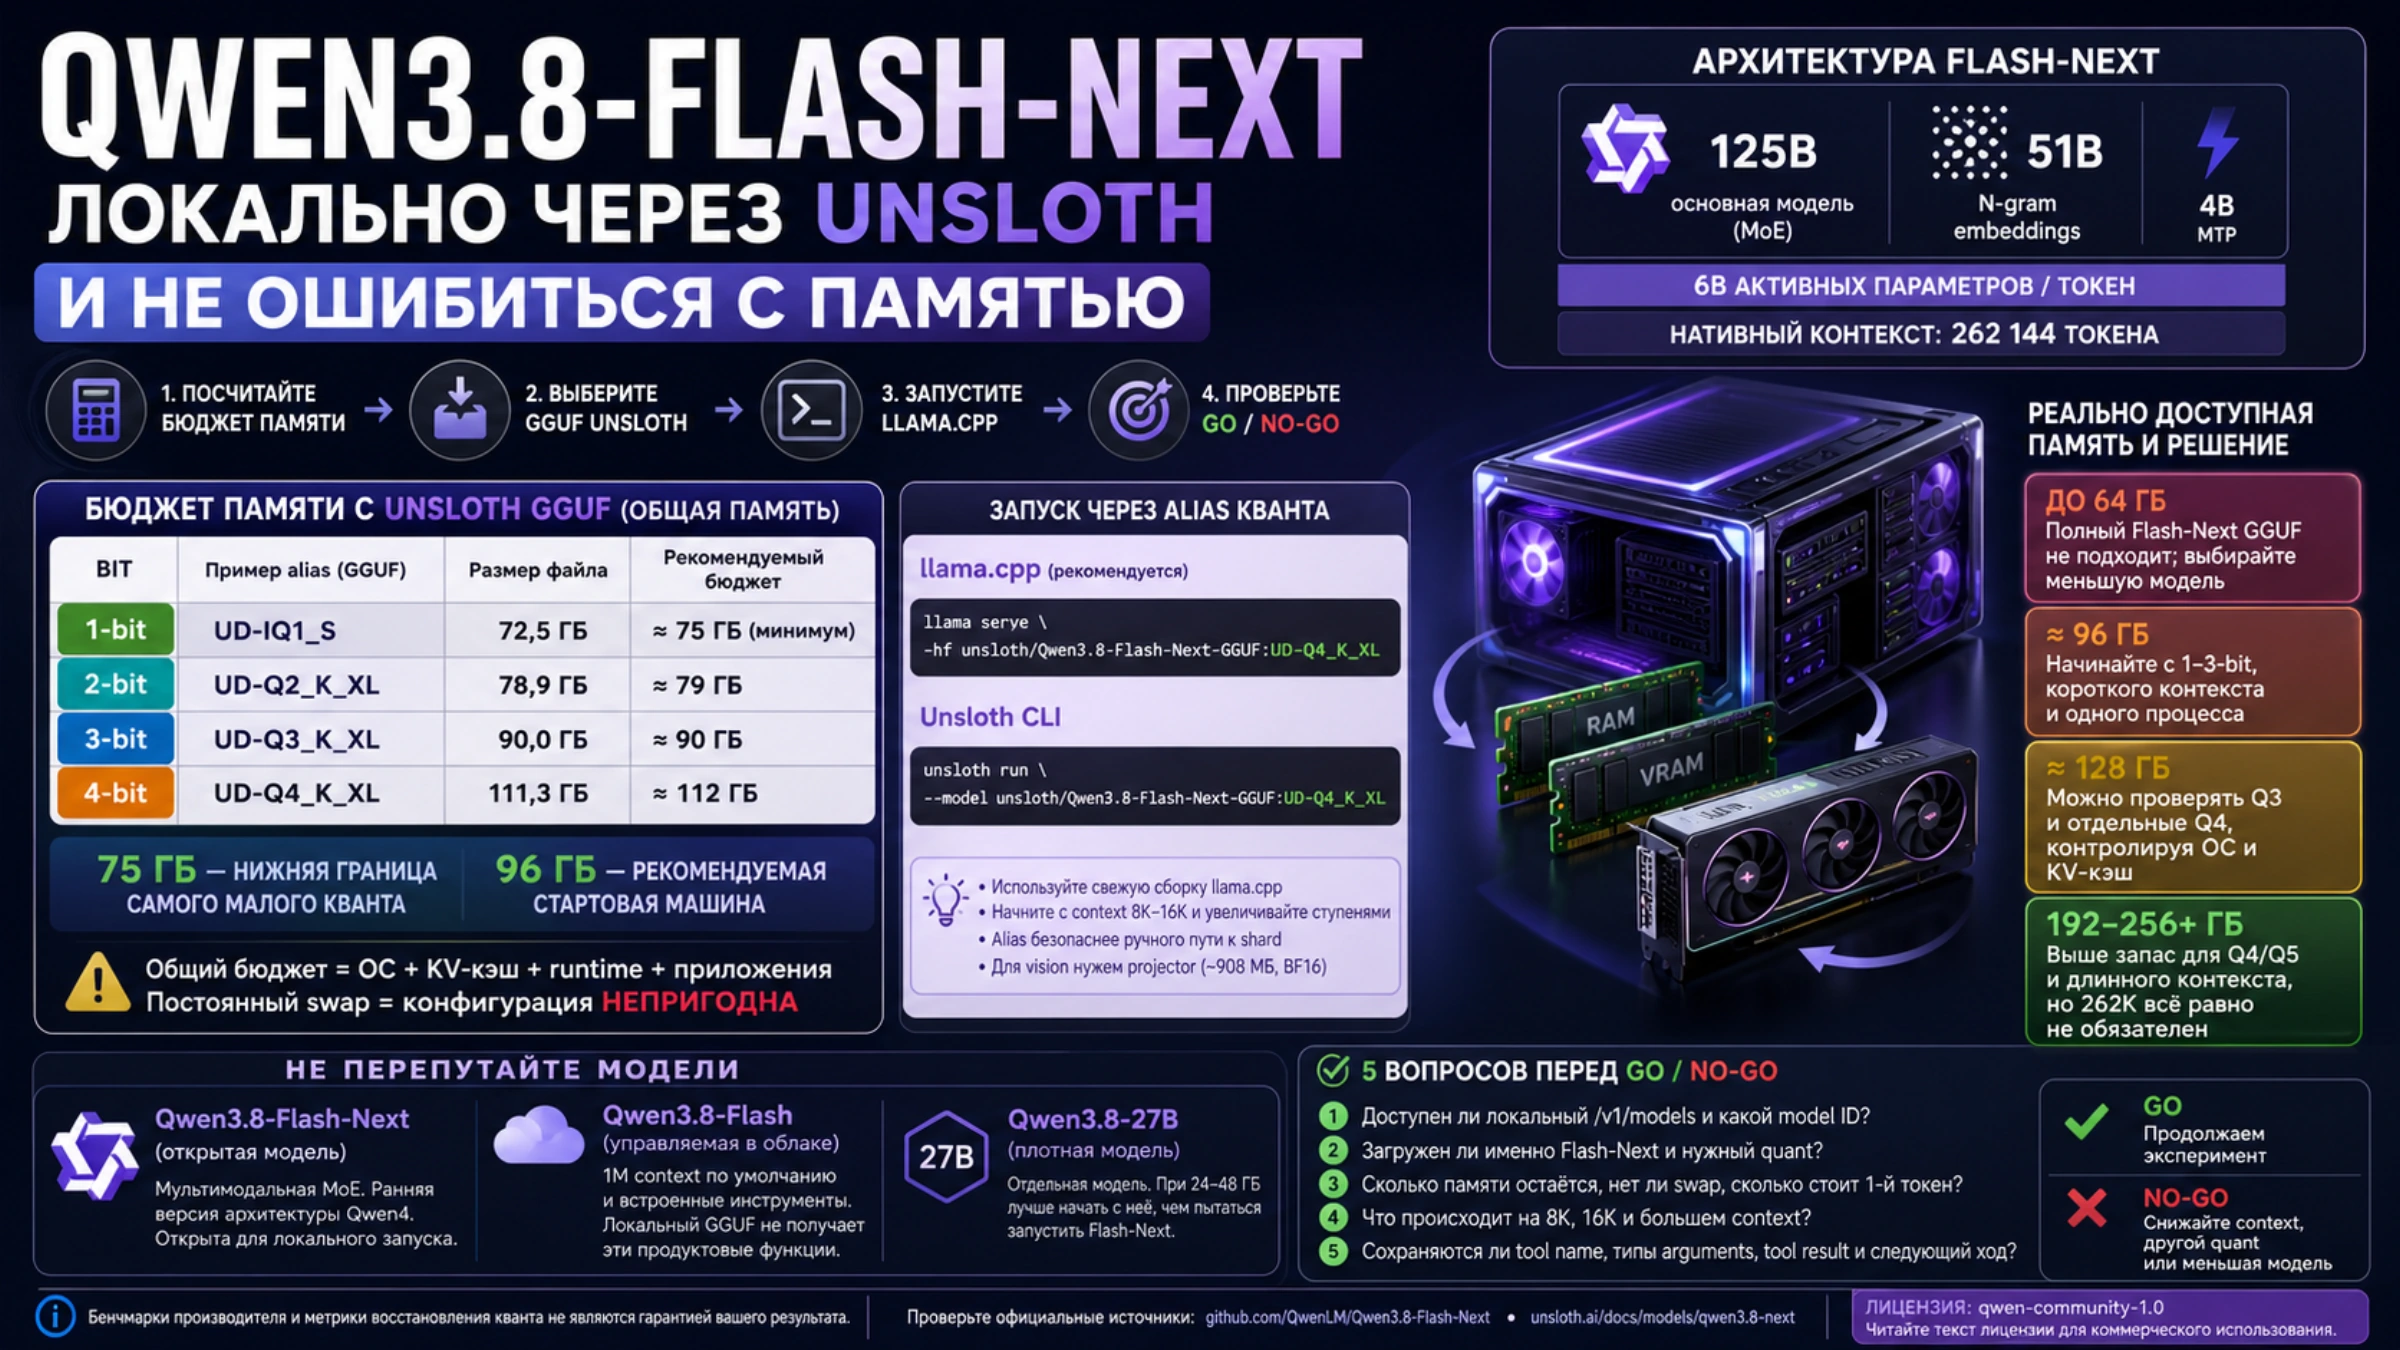
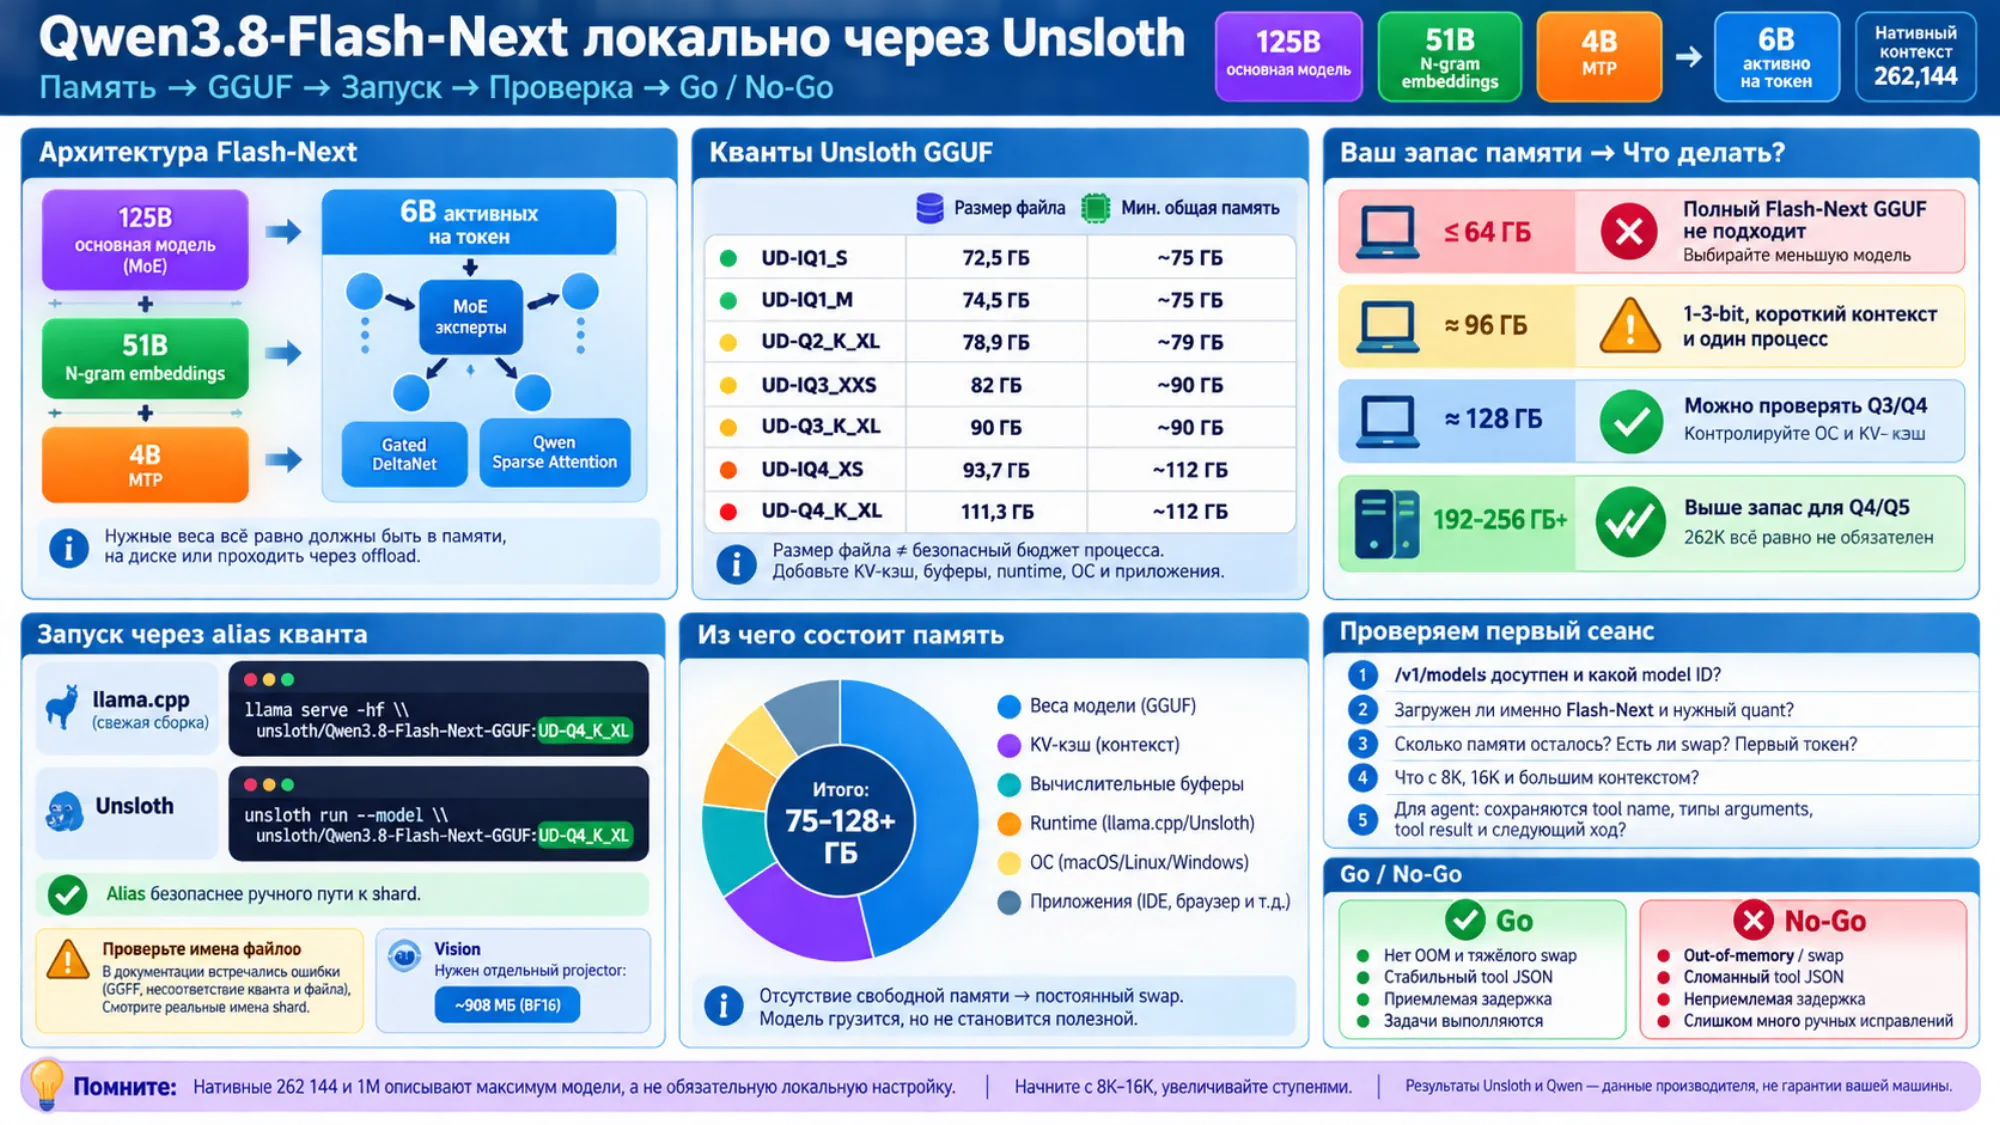
Qwen3.8-Flash-Next можно запустить локально, но это не «модель на 6B», которую достаточно поместить в обычную видеокарту. Шесть миллиардов — число параметров основного MoE, активируемых для одного токена. В официальной карточке Qwen указаны 125B параметров основной модели, ещё 51B в N-gram embeddings и 4B MTP. Нужные веса всё равно должны находиться в памяти, на диске или подгружаться с другого устройства при частичной выгрузке.
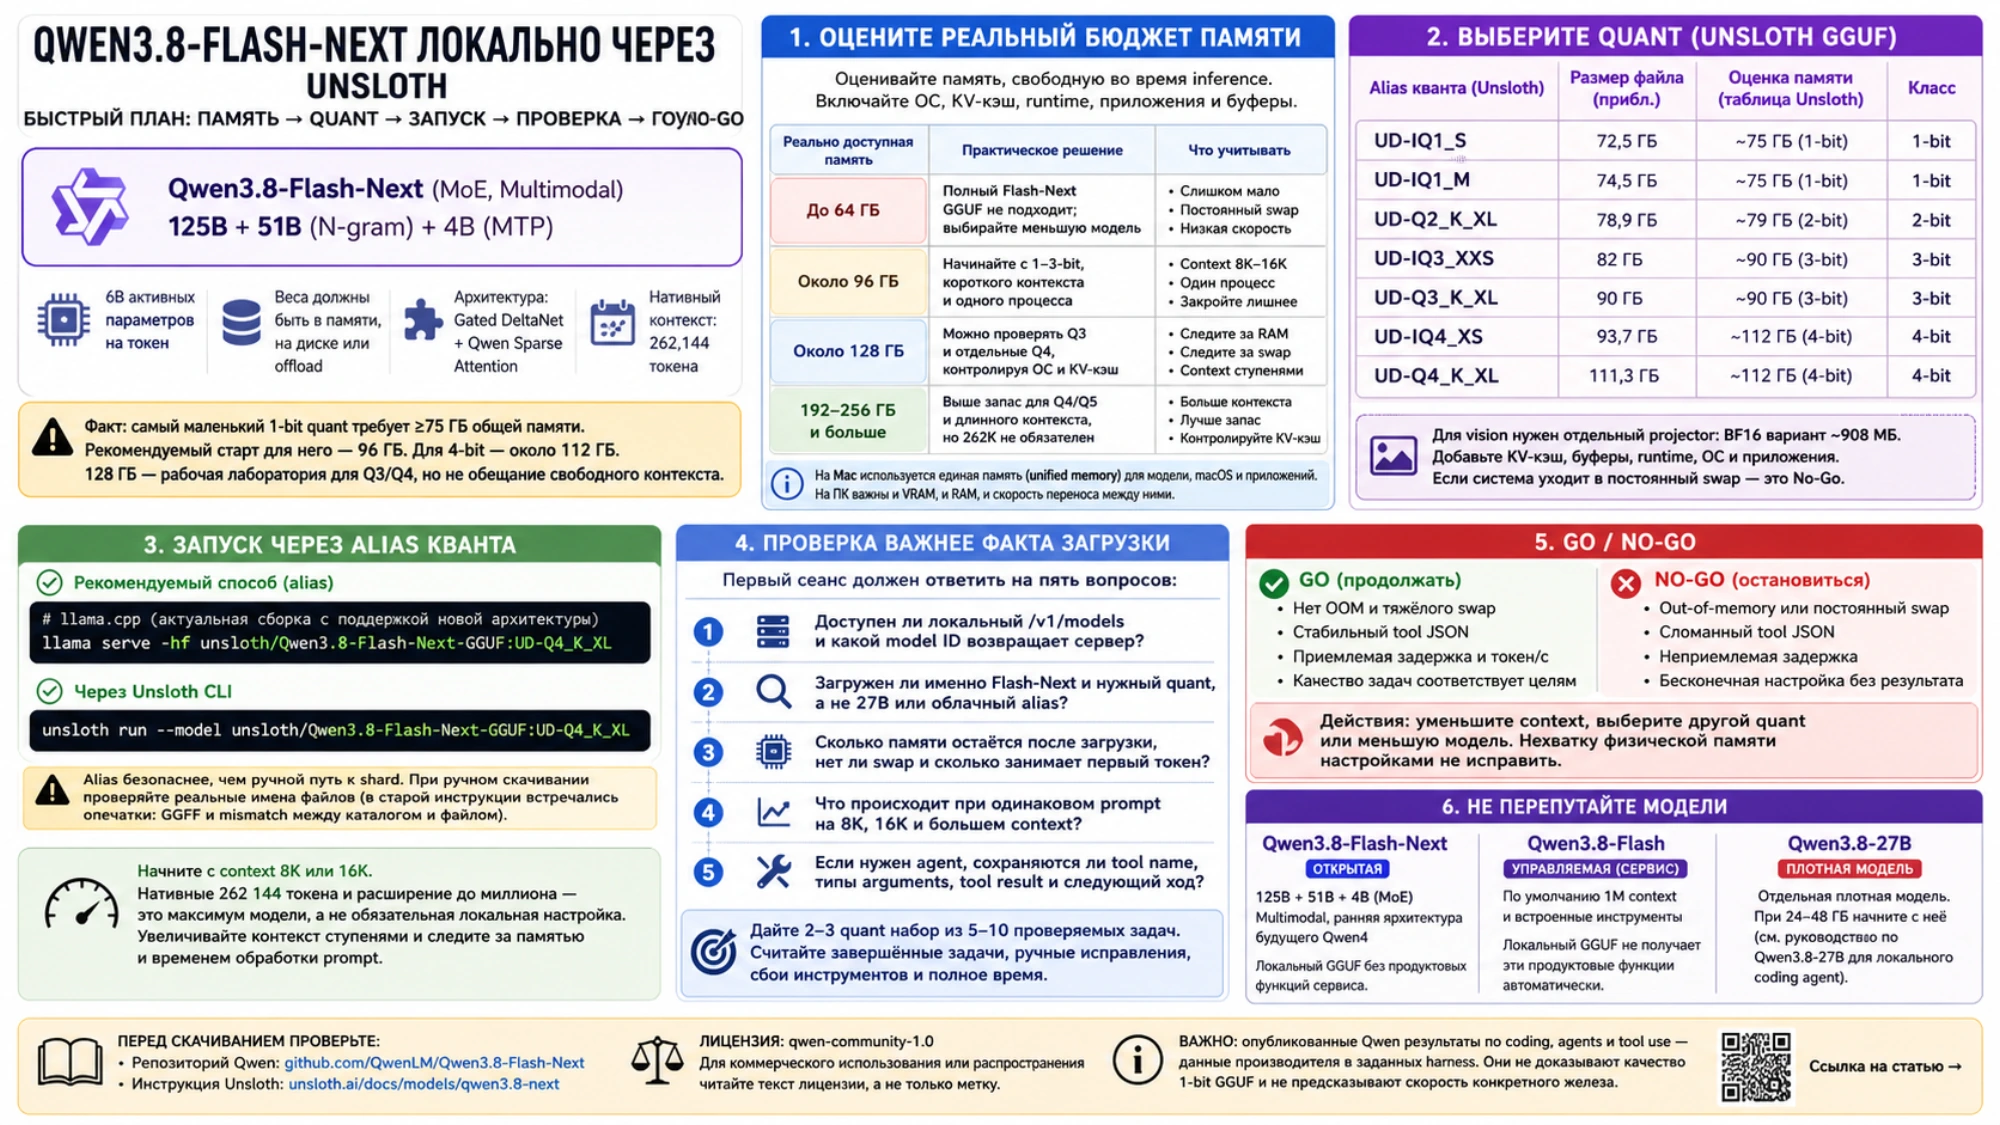
По текущей оценке Unsloth, самая маленькая однобитная сборка требует не менее 75 ГБ общей памяти, а разумная стартовая машина для неё имеет 96 ГБ оперативной или объединённой памяти. Для четырёхбитных сборок в текущей таблице Unsloth указано 96–114 ГБ. Поэтому 128 ГБ позволяют проверять Q3/Q4, но не гарантируют работу с полным контекстом в 262 тысячи токенов.
Быстрый ответ для разных конфигураций
Оценивайте память, свободную во время генерации. На Mac она общая для модели, macOS и приложений. В системе с дискретной GPU важны и VRAM, и RAM, и скорость переноса между ними.
| Реально доступная память | Практическое решение |
|---|---|
| До 64 ГБ | Ниже опубликованного минимума Unsloth; начните с меньшей модели |
| Около 96 ГБ | Начинайте с 1–3-bit, короткого контекста и одного процесса |
| Около 128 ГБ | Можно проверять Q3 и отдельные Q4, контролируя ОС и KV-кэш |
| 192–256 ГБ и больше | Выше запас для Q4/Q5 и длинного контекста, но 262K всё равно не обязателен |
Unsloth публикует следующие размеры: UD-IQ1_S 72,5 ГБ, UD-IQ1_M 74,5 ГБ, UD-Q2_K_XL 78,9 ГБ, UD-IQ3_XXS 82 ГБ, UD-Q3_K_XL 90 ГБ, UD-IQ4_XS 93,7 ГБ и UD-Q4_K_XL 111,3 ГБ. В общей таблице требований одно-, двух-, трёх- и четырёхбитным сборкам отведены 75, 79, 90 и 96–114 ГБ (по состоянию на 12 сентября 2026 года).
Размер файла и безопасный бюджет процесса — разные величины. Добавьте KV-кэш, вычислительные буферы, среду выполнения, ОС и клиент. Для обработки изображений нужен отдельный визуальный проектор; в текущем GGUF-репозитории его BF16-вариант занимает около 908 МБ. Если система уходит в постоянную подкачку на диск, модель формально загрузилась, но конфигурация не стала полезной.
Не перепутайте Flash-Next, Flash и 27B
Qwen/Qwen3.8-Flash-Next — мультимодальная MoE с открытыми весами и ранняя версия архитектуры будущего Qwen4. Qwen сочетает Gated DeltaNet с Qwen Sparse Attention, а N-gram embeddings увеличивают ёмкость и лучше подходят для выгрузки в оперативную память.
Qwen3.8-Flash — управляемая версия в сервисе Qwen. По описанию Qwen, у неё по умолчанию контекст в миллион токенов и встроенные инструменты. Локальный GGUF не получает эти продуктовые функции автоматически.
Qwen3.8-27B — отдельная плотная модель. Если у вас 24–48 ГБ, полезнее начать с руководства по Qwen3.8-27B для локального агента программирования, а не пытаться превратить Flash-Next в маленькую модель постоянной выгрузкой весов на диск.
Результаты Qwen по программированию, агентным задачам и вызову инструментов объясняют интерес к модели, но получены производителем в определённой тестовой среде. Они не доказывают качество 1-bit GGUF и не предсказывают скорость конкретного Mac или GPU+RAM.
Запуск по обозначению квантованной сборки
Используйте свежую сборку llama.cpp, где есть поддержка новой архитектуры. Текущая страница Unsloth GGUF позволяет выбрать квантованную сборку по её обозначению:
llama serve -hf unsloth/Qwen3.8-Flash-Next-GGUF:UD-Q4_K_XLНа машине класса 96 ГБ замените Q4 на вариант, который помещается с запасом. Команда Unsloth выглядит так:
unsloth run --model unsloth/Qwen3.8-Flash-Next-GGUF:UD-Q4_K_XLОбозначение сборки помогает избежать ошибки при ручном указании пути. В инструкции Unsloth, проверенной 12 сентября, пример запуска всё ещё сочетает каталог UD-IQ1_S с именем файла UD-Q4_K_XL. При ручном скачивании сверяйте реальные имена частей модели и передавайте движку путь к первой части выбранной сборки.
Начните с контекста в 8 или 16 тысяч токенов. Нативные 262 144 токена и расширение до миллиона описывают максимум модели, а не обязательную локальную настройку. Увеличивайте контекст ступенями и следите за памятью и временем обработки запроса.
Проверка важнее факта загрузки
Первый сеанс должен ответить на пять вопросов:
- Доступен ли локальный
/v1/modelsи какой идентификатор модели возвращает сервер? - Загружена ли выбранная квантованная сборка Flash-Next, а не 27B или облачная модель?
- Сколько памяти остаётся после загрузки, нет ли постоянной подкачки и сколько занимает первый токен?
- Что происходит при одинаковом запросе и контексте в 8, 16 тысяч токенов и больше?
- Если нужен агент, правильно ли передаются имя инструмента, типы аргументов, результат функции и следующий ход?
После этого дайте двум-трём квантованным сборкам один набор из 5–10 проверяемых задач. Считайте завершённые задачи, ручные исправления, сбои инструментов и полное время. Измерение Unsloth по KLD и top-1 recovery полезно для предварительного выбора, но оно не показывает долю успешно выполненных задач вашего проекта.
Нехватка памяти, постоянная подкачка, некорректный JSON вызова инструмента после длинного запроса или неприемлемая задержка — основания отказаться от этой конфигурации. Сократите контекст, выберите другую квантованную сборку или меньшую модель. Бесконечная настройка не исправляет нехватку физической памяти.
Когда эксперимент оправдан
Flash-Next имеет смысл проверять, если доступно хотя бы около 96 ГБ, вы принимаете ограничения низкобитного квантования и вам действительно нужна большая ёмкость для агентных задач или работы с длинным контекстом. Для Q3/Q4 заметно удобнее реально свободные 128 ГБ, особенно если на машине можно закрыть IDE, браузер и сборки.
Если нужен лёгкий фоновый помощник или потолок составляет 64 ГБ, меньшая модель даст более предсказуемую задержку и меньше времени на настройку. Архитектура Flash-Next снижает вычисления на токен, но не отменяет хранение большой таблицы весов и N-gram embeddings.
Перед скачиванием проверьте официальный репозиторий Qwen и актуальную инструкцию Unsloth. На страницах весов сейчас указана лицензия qwen-community-1.0; для коммерческого использования или распространения нужно читать сам текст лицензии, а не только метку.