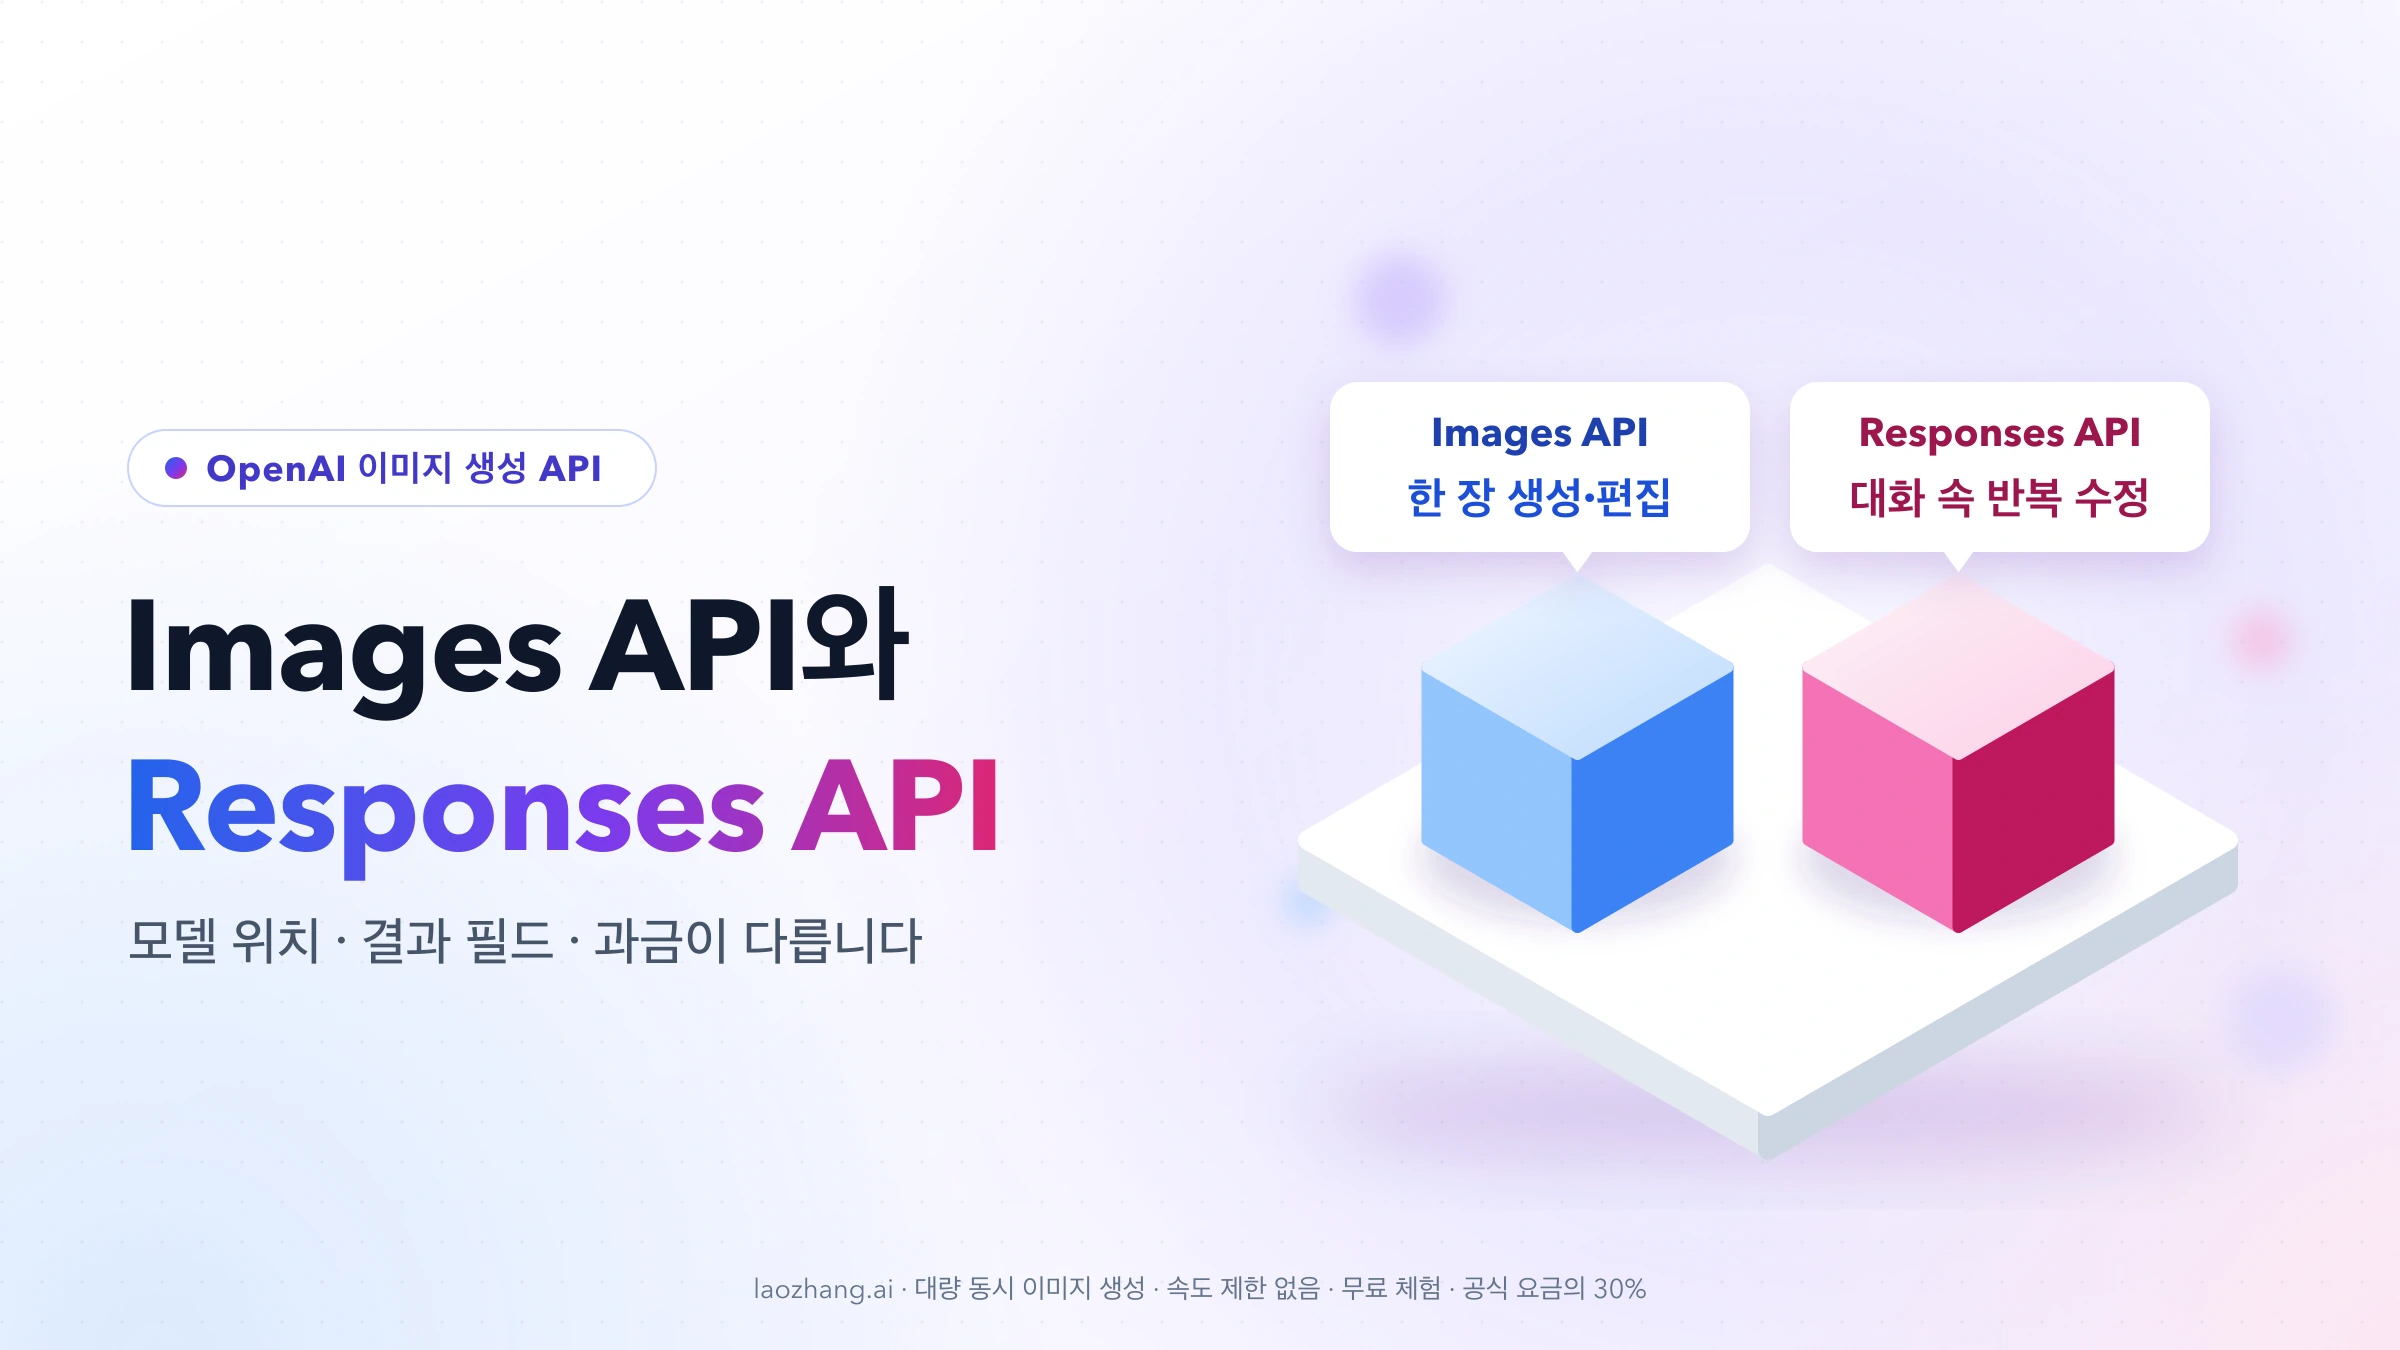
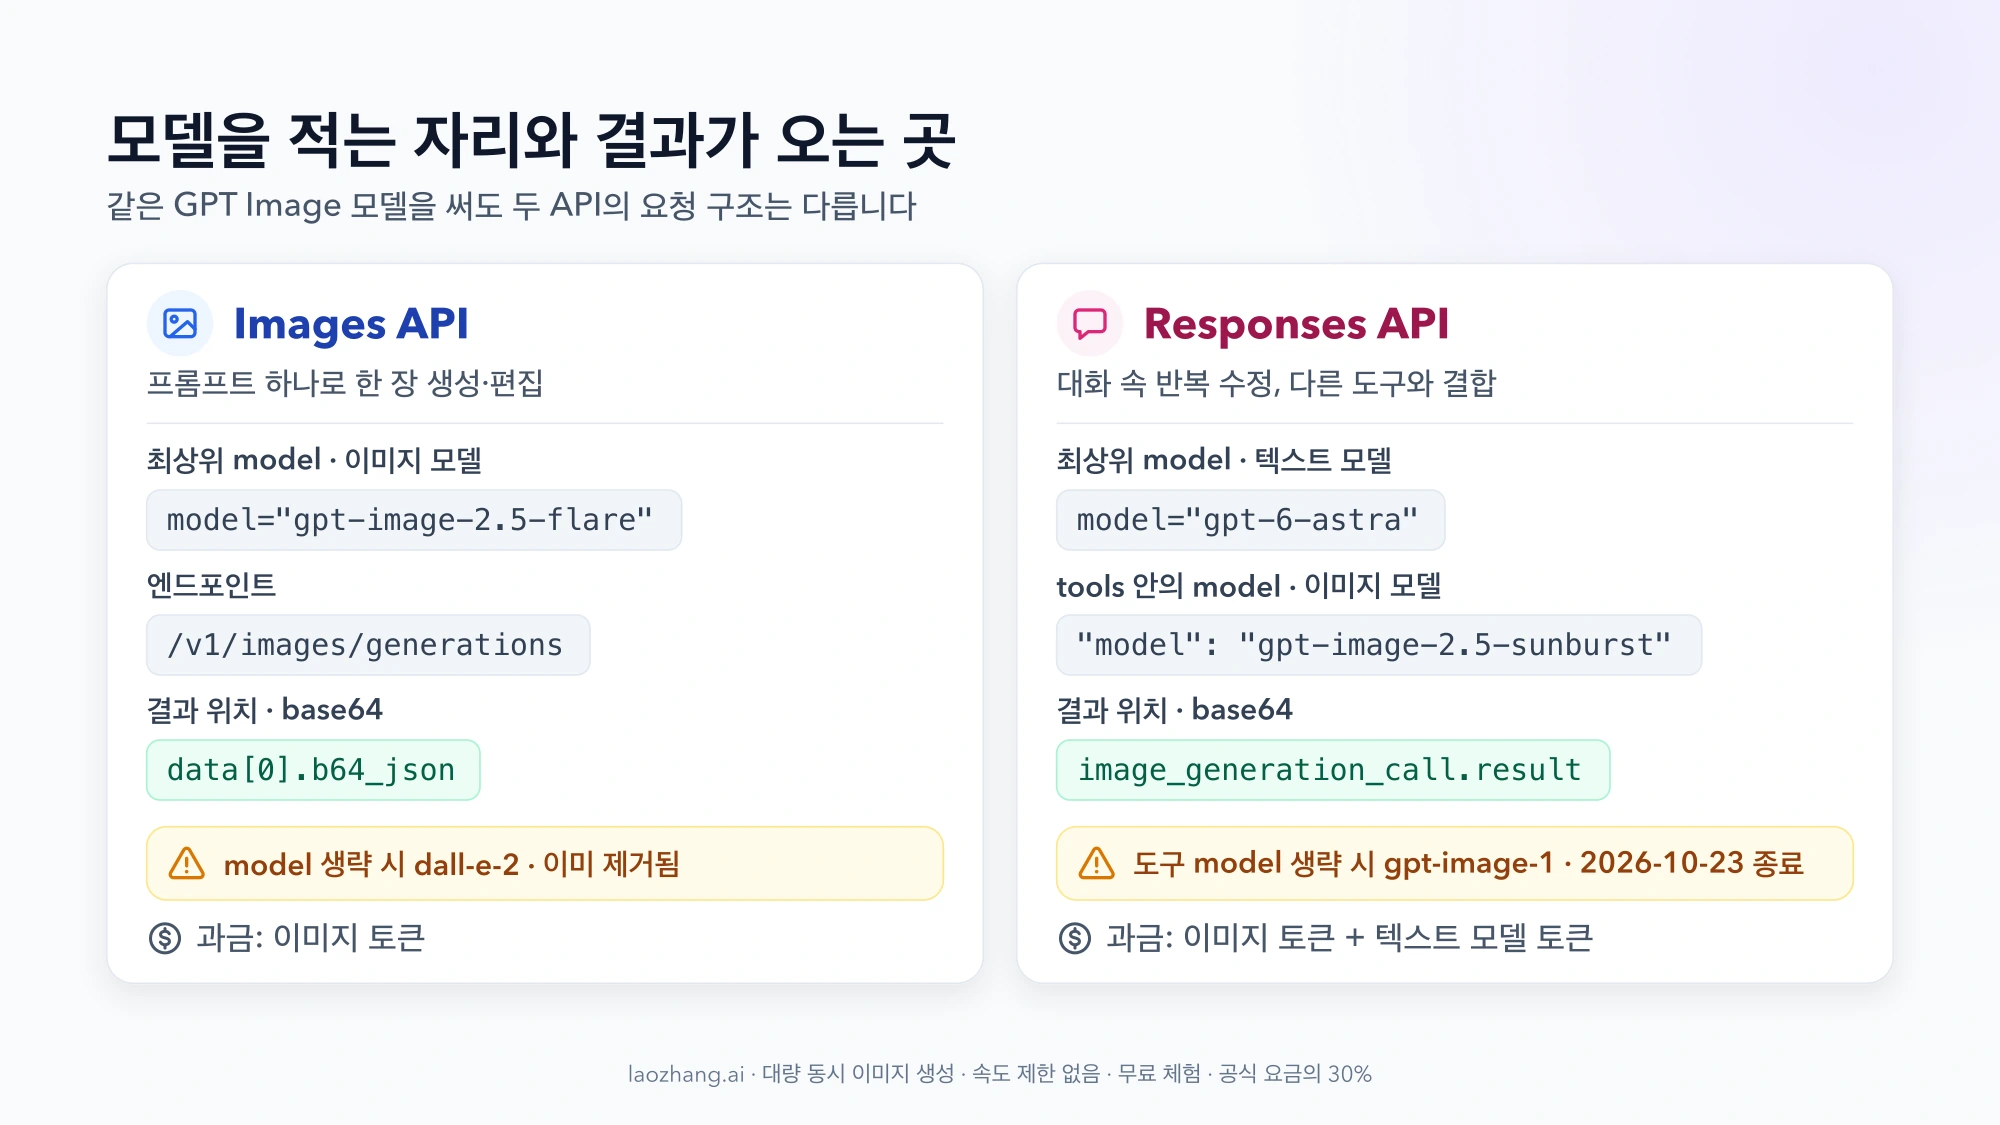
2026년 9월 25일 기준으로 결론부터 정리하면 이렇습니다. 프롬프트 하나로 이미지 한 장을 만들거나 편집한다면 Images API를 쓰고 model="gpt-image-2.5-flare"(또는 gpt-image-2.5-sunburst)를 직접 지정합니다. 대화 속에서 같은 이미지를 여러 번 고치거나, 텍스트 답변·다른 도구와 이미지를 한 흐름에 묶는다면 Responses API의 image_generation 도구를 씁니다. 이때 최상위 model에는 대화를 맡는 텍스트 모델을, 도구 안의 model에는 이미지 모델을 적습니다. OpenAI 이미지 생성 가이드의 선택 기준도 같습니다.
두 API 모두 이미지를 base64로 돌려주며, URL은 오지 않습니다. 그리고 둘 다 모델을 생략했을 때의 기본값이 이미 제거됐거나 곧 종료되는 모델입니다. Images API는 dall-e-2(2026년 5월 12일 제거), Responses 도구는 gpt-image-1(2026년 10월 23일 종료)입니다. gpt-image-1 시절 튜토리얼 코드를 가져왔다면 모델 ID부터 바꾸십시오.
아래 코드는 OpenAI 문서와 API 레퍼런스에 맞춰 작성한 사용 예시이며, 실제 호출 결과를 옮긴 것은 아닙니다.
선택 기준: 한 번 생성·편집은 Images API, 이어서 수정은 Responses
| 하려는 일 | 먼저 고를 API | 이유 |
|---|---|---|
| 프롬프트 하나로 이미지 한 장 생성 | Images API | 요청 하나, 응답 하나로 끝나고 결과 위치가 단순합니다 |
| 기존 이미지 한 번 편집·합성 | Images API (/v1/images/edits) | 편집 전용 엔드포인트와 마스크를 씁니다 |
| 같은 프롬프트로 여러 장 | Images API | n으로 1~10장을 한 번에 요청할 수 있습니다. 도구에는 n이 없습니다 |
| 대화하면서 "배경만 바꿔 줘"처럼 이어서 수정 | Responses API | previous_response_id나 이전 이미지 ID로 맥락을 이어 갑니다 |
| 텍스트 답변, 웹 검색 같은 다른 도구와 함께 사용 | Responses API | 이미지 생성이 여러 도구 중 하나로 동작합니다 |
| Files API로 올린 파일(File ID)을 입력 이미지로 사용 | Responses API | URL, base64 data URL, File ID를 입력으로 받습니다 |
두 API의 차이는 "어느 쪽이 더 최신인가"가 아니라 요청 구조에 있습니다.
| 항목 | Images API | Responses API image_generation 도구 |
|---|---|---|
| 이미지 모델을 적는 곳 | 최상위 model | tools 안의 model (최상위 model은 텍스트 모델) |
| 모델을 생략하면 | dall-e-2 (이미 제거됨) | gpt-image-1 (2026-10-23 종료) |
| 결과 위치 | data[0].b64_json | output 중 type이 image_generation_call인 항목의 result |
| 과금 | 이미지 모델 토큰 | 이미지 모델 토큰 + 텍스트 모델 토큰 |
| 반복 수정 | 매번 편집 요청에 이미지를 다시 전달 | previous_response_id 또는 이미지 생성 호출 ID |
Responses API가 텍스트 API 전반에서 Chat Completions와 무엇이 다른지는 Chat Completions와 Responses API: 무엇이 실제로 달라지나에서 다룹니다.
코드 속 모델 ID가 언제 멈추는지 확인하기
새로 연동한다면 OpenAI는 GPT Image 2.5 두 모델 중 하나를 권합니다. gpt-image-2.5-flare는 빠른 일상 생성, gpt-image-2.5-sunburst는 편집 정밀도가 중요한 작업에 맞춘 모델이고, 날짜를 고정하려면 -2026-09-08 스냅샷 ID를 씁니다. 접미사 없는 gpt-image-2.5라는 모델 ID는 없습니다. 두 모델의 차이와 고르는 법은 GPT Image 2.5 사용 가이드: Flare·Sunburst 차이, 요금과 API 예제에서 다룹니다.
OpenAI 지원 종료 페이지의 일정은 다음과 같습니다.
| 모델 ID | 상태 (2026년 9월 25일 기준) | 대응 |
|---|---|---|
dall-e-2, dall-e-3 | 2026-05-12 API에서 제거 | 이미 호출할 수 없습니다 |
gpt-image-1 | 2026-10-23 종료 예정 | 도구 model을 생략한 코드도 여기에 해당합니다 |
gpt-image-1.5, gpt-image-1-mini, chatgpt-image-latest | 2026-12-01 종료 예정 | 12월 전에 교체해야 합니다 |
gpt-image-2 | 지원 중 ("이전 모델"로 분류) | 기존 연동을 유지하거나 Batch가 필요할 때 |
gpt-image-2.5-flare, gpt-image-2.5-sunburst | 현재 권장 | 새 연동의 기본 선택 |
지원 종료 표는 대체 모델로 gpt-image-2를 적어 두었고, 이미지 생성 가이드는 새 연동에 2.5를 권합니다. 둘 다 유효한 경로이므로 2.5가 의무는 아닙니다. 다만 GPT Image 2.5는 Batch를 지원하지 않으니, 대량 작업을 Batch로 돌린다면 gpt-image-2를 유지하는 것이 현실적입니다.
이미지 모델은 Responses API의 최상위 model에 넣을 수 없습니다. 이미지 모델 페이지에는 v1/responses가 최상위 모델로 "지원되지 않음"으로 표시돼 있습니다.
준비: API 키와 SDK
- OpenAI 플랫폼에서 API 키를 만들고 환경 변수
OPENAI_API_KEY에 넣습니다. 키를 소스 파일에 직접 적지 않습니다. - SDK를 설치합니다. Python은
pip install openai, Node.js는npm install openai입니다.gpt-image-2.5-*ID와 새 파라미터를 쓰려면 최신 버전으로 올려 두는 편이 안전합니다. - GPT Image 모델을 쓰기 전에 API 조직 인증이 필요할 수 있습니다. 인증 관련 오류가 나면 GPT Image 2 조직 인증 오류 해결: 인증했는데도 막힐 때 확인할 것을, 인증 없이 쓸 방법을 찾는다면 GPT Image 2, 조직 인증 없이 쓸 수 있나요? API 선택과 오류 해결을 참고하십시오.
ChatGPT Plus 같은 구독과 API 과금은 별개입니다. 구독 중이어도 API 사용량은 OpenAI 플랫폼 계정에서 따로 청구됩니다. 한국은 OpenAI API 지원 국가 목록에 포함돼 있습니다.
Images API로 첫 이미지 만들기
가장 짧은 경로입니다. 모델을 명시하고, b64_json을 디코딩해 파일로 저장합니다.
# generate.py
import base64
from openai import OpenAI

client = OpenAI()  # OPENAI_API_KEY 환경 변수를 읽습니다

result = client.images.generate(
    model="gpt-image-2.5-flare",
    prompt="햇살이 드는 카페 창가 테이블 위의 라테 한 잔, 제품 사진 스타일",
    size="1024x1024",
    quality="medium",
    output_format="png",
)

image_b64 = result.data[0].b64_json
with open("latte.png", "wb") as f:
    f.write(base64.b64decode(image_b64))

print(result.usage)  # 실제 소비 토큰 확인용
Node.js에서는 ESM 파일(generate.mjs)로 저장하면 최상위 await를 그대로 쓸 수 있습니다.
// generate.mjs
import fs from "node:fs";
import OpenAI from "openai";

const client = new OpenAI(); // OPENAI_API_KEY 환경 변수를 읽습니다

const result = await client.images.generate({
  model: "gpt-image-2.5-flare",
  prompt: "햇살이 드는 카페 창가 테이블 위의 라테 한 잔, 제품 사진 스타일",
  size: "1024x1024",
  quality: "medium",
  output_format: "png",
});

fs.writeFileSync("latte.png", Buffer.from(result.data[0].b64_json, "base64"));
console.log(result.usage);
성공하면 작업 폴더에 latte.png가 생기고, usage에 이번 요청의 토큰 수가 찍힙니다. 이 요청에서 알아 둘 점은 세 가지입니다.
response_format을 넣지 않습니다. API 레퍼런스에 따르면 GPT 이미지 모델은 이 파라미터를 지원하지 않고 항상 base64를 반환합니다. "URL은 60분 동안만 유효"라는 설명은 DALL·E 모델에 해당하던 이야기입니다.model을 빼지 않습니다. 레퍼런스상 기본값은dall-e-2이고, 이 모델은 이미 제거됐습니다. GPT 이미지 전용 파라미터를 함께 보내면 GPT 이미지 모델이 기본으로 잡힌다고 적혀 있지만, 어느 모델인지 코드에서 알 수 없게 되므로 명시하는 편이 낫습니다.- 첫 요청은 단순하게. 권장 크기는
1024x1024,1536x1024,1024x1536입니다. 사용자 지정 크기는 16의 배수 등 조건이 붙으니, 16:9처럼 비율이 정해진 결과물이 필요하면 GPT Image 2의 1024x576 오류 해결: 16:9로 생성하고 정확하게 줄이기를 먼저 보십시오. 투명 배경은background: "transparent"에 PNG나 WebP 출력이 필요하며, 자세한 요청과 검증은 GPT Image 2로 투명 PNG·WebP 만들기: API 요청과 파일 검증에 있습니다.
기존 이미지를 고치는 작업은 같은 Images API의 /v1/images/edits 엔드포인트를 씁니다. 여러 입력 이미지, 마스크, 예전 variations 기능을 대신하는 방법은 GPT Image 2 이미지 편집 API: variations 전환과 dall-e-2 오류 해결에서 다룹니다.
Responses API로 생성하고 결과를 안전하게 꺼내기
Responses API에서는 텍스트 모델이 대화를 처리하다가 image_generation 도구를 호출합니다. 따라서 모델이 두 곳에 들어갑니다. 아래 예시의 최상위 gpt-6-astra는 OpenAI 도구 가이드의 예제에 쓰인 모델입니다. 다른 텍스트 모델을 쓸 때는 모델 페이지에서 이미지 생성 도구 지원 여부를 확인하십시오. 가이드에 실린 고정 목록은 같은 가이드 예제에 쓰인 모델조차 빠져 있을 만큼 갱신이 늦습니다.
# responses_image.py
import base64
from openai import OpenAI

client = OpenAI()

IMAGE_TOOL = {
    "type": "image_generation",
    "model": "gpt-image-2.5-sunburst",  # 생략하면 gpt-image-1이 선택됩니다
    "size": "1024x1024",
    "quality": "medium",
}

def save_first_image(response, path):
    calls = [item for item in response.output if item.type == "image_generation_call"]
    if not calls:
        raise RuntimeError(f"이미지 생성 호출이 없습니다 (response id: {response.id})")
    call = calls[0]
    if call.status != "completed" or not call.result:
        raise RuntimeError(f"이미지가 비어 있습니다 (status: {call.status}, id: {call.id})")
    with open(path, "wb") as f:
        f.write(base64.b64decode(call.result))
    print("revised_prompt:", call.revised_prompt)
    return call

response = client.responses.create(
    model="gpt-6-astra",  # 이미지 생성 도구를 지원하는 텍스트 모델
    input="햇살이 드는 카페 창가 테이블 위의 라테 한 잔을 제품 사진 스타일로 그려 줘",
    tools=[IMAGE_TOOL],
    tool_choice={"type": "image_generation"},  # 도구 호출을 강제합니다
)

first_call = save_first_image(response, "latte.png")
Node.js로 옮기면 다음과 같습니다.
// responses-image.mjs
import fs from "node:fs";
import OpenAI from "openai";

const client = new OpenAI();

const imageTool = {
  type: "image_generation",
  model: "gpt-image-2.5-sunburst", // 생략하면 gpt-image-1이 선택됩니다
  size: "1024x1024",
  quality: "medium",
};

function saveFirstImage(response, path) {
  const call = response.output.find((item) => item.type === "image_generation_call");
  if (!call) throw new Error(`이미지 생성 호출이 없습니다 (response id: ${response.id})`);
  if (call.status !== "completed" || !call.result) {
    throw new Error(`이미지가 비어 있습니다 (status: ${call.status}, id: ${call.id})`);
  }
  fs.writeFileSync(path, Buffer.from(call.result, "base64"));
  console.log("revised_prompt:", call.revised_prompt);
  return call;
}

const response = await client.responses.create({
  model: "gpt-6-astra",
  input: "햇살이 드는 카페 창가 테이블 위의 라테 한 잔을 제품 사진 스타일로 그려 줘",
  tools: [imageTool],
  tool_choice: { type: "image_generation" },
});

const firstCall = saveFirstImage(response, "latte.png");
OpenAI 공식 예제는 image_generation_call을 걸러 result를 디코딩하는 것까지만 보여 줍니다. 서비스에 붙일 때는 위처럼 세 가지를 더 챙기는 편이 안전합니다.
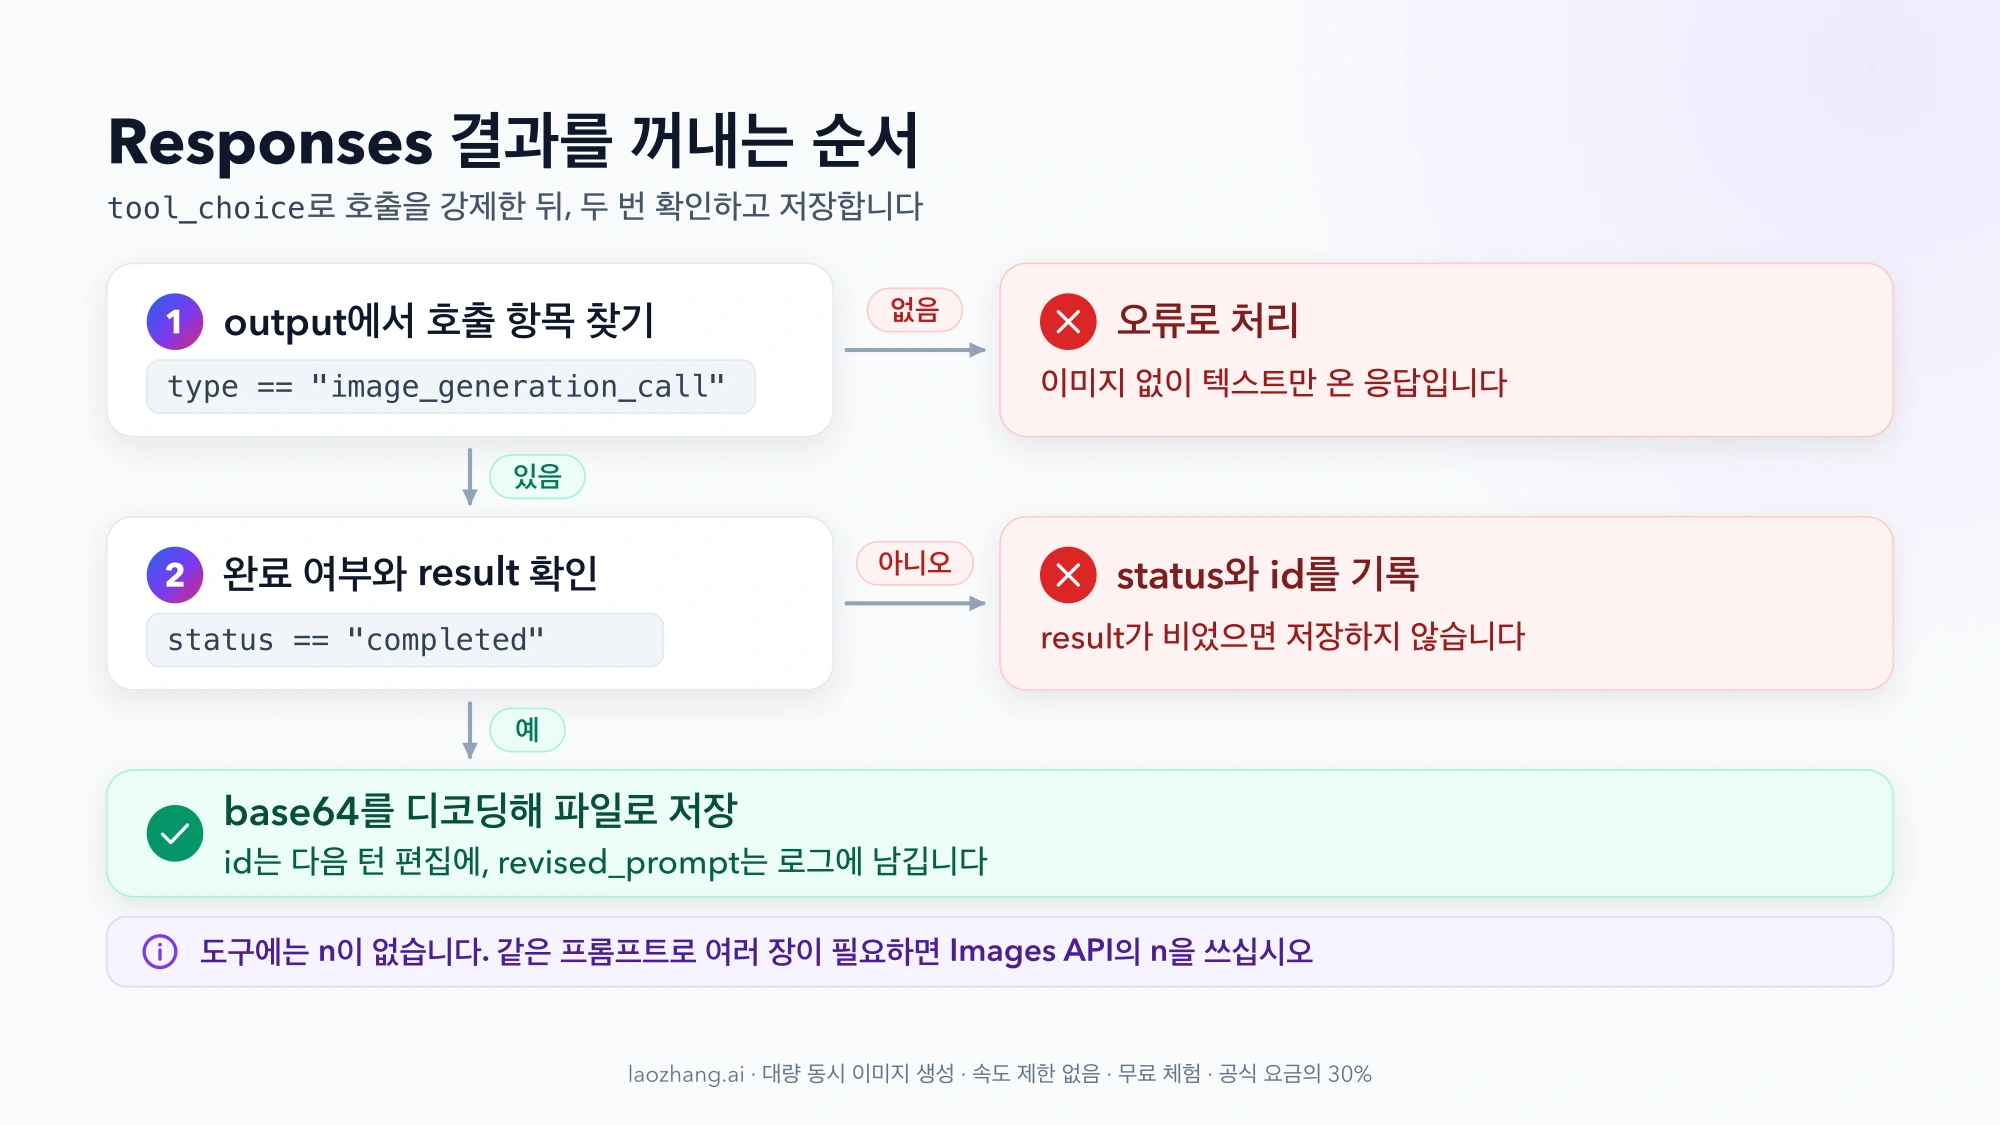
도구 model을 항상 적습니다. Responses API 레퍼런스에서 도구 model의 기본값은 gpt-image-1이고, 이 모델은 2026년 10월 23일 종료됩니다. 종료 뒤 모델을 생략한 요청이 오류가 되는지 다른 모델로 넘어가는지는 공개 문서에 나와 있지 않습니다. OpenAI 도구 가이드의 Java·Ruby 예제는 도구 모델 없이 도구를 만들고 있어, 그대로 복사하면 이 기본값을 물려받습니다.
tool_choice로 호출을 강제합니다. 도구를 넣기만 하면 텍스트 모델이 이미지를 만들지 말지 스스로 판단합니다. 사용자가 이미지를 요청한 화면이라면 tool_choice: {"type": "image_generation"}을 주고, 그래도 image_generation_call이 없거나 result가 비어 있으면(status가 failed 등) 오류로 처리합니다.
결과 필드를 구분합니다. result는 base64 이미지, revised_prompt는 텍스트 모델이 다듬어 도구에 넘긴 프롬프트, id는 다음 턴에서 이 이미지를 가리킬 때 쓰는 값입니다. 도구에는 n이 없으므로 한 요청에서 정확히 몇 장이 나올지 제어할 공개 방법은 없습니다. 같은 프롬프트로 여러 장이 필요하면 Images API의 n이 맞습니다.
도구에서 쓸 수 있는 주요 옵션은 size, quality(2.5는 xhigh, max까지), output_format, output_compression, background, action(auto/generate/edit), partial_images(0~3), moderation, input_image_mask입니다. input_fidelity는 레퍼런스와 가이드의 설명이 서로 달라 2.5에서의 동작이 분명하지 않으므로 넣지 않는 편이 안전합니다.
대화 속에서 이어서 수정하기
Responses API를 고르는 가장 큰 이유가 이 부분입니다. 앞 응답을 이어 받는 방법은 두 가지이며, 둘 다 도구 가이드에 예제가 있습니다.
첫째, previous_response_id로 이전 응답 전체를 맥락으로 넘깁니다. 위 Python 코드에 이어서 실행하는 예입니다.
follow_up = client.responses.create(
    model="gpt-6-astra",
    previous_response_id=response.id,
    input="같은 구도에서 배경만 비 오는 저녁 거리로 바꿔 줘",
    tools=[{**IMAGE_TOOL, "action": "edit"}],  # 맥락 속 이미지를 편집하도록 고정
    tool_choice={"type": "image_generation"},
)
save_first_image(follow_up, "latte-evening.png")
둘째, 대화 이력을 직접 관리한다면 이전 이미지 생성 호출의 ID를 입력 항목으로 넣습니다.
follow_up = client.responses.create(
    model="gpt-6-astra",
    input=[
        {"role": "user", "content": [{"type": "input_text", "text": "같은 구도에서 배경만 비 오는 저녁 거리로 바꿔 줘"}]},
        {"type": "image_generation_call", "id": first_call.id},
    ],
    tools=[{**IMAGE_TOOL, "action": "edit"}],
    tool_choice={"type": "image_generation"},
)
save_first_image(follow_up, "latte-evening.png")action을 생략하면 기본값 auto로, 모델이 새로 그릴지 맥락 속 이미지를 고칠지 정합니다. 이어서 수정하는 화면이라면 edit, 매번 새 이미지를 원하면 generate로 고정해 두면 결과가 예측하기 쉬워집니다. 이 action: "edit"는 Images API의 /v1/images/edits 엔드포인트와는 별개의 설정입니다.
비용 면에서 주의할 점도 있습니다. previous_response_id를 쓰면 체인에 쌓인 이전 응답의 입력 토큰이 모두 다시 입력 토큰으로 과금됩니다. 수정이 길어질수록 텍스트 모델 쪽 비용이 늘어납니다.
referenced_image_ids라는 이름으로 이전 이미지를 지정하는 코드를 찾는 경우가 있는데, 이 이름은 현재 OpenAI의 이미지 생성 가이드, 도구 가이드, Responses API 레퍼런스 어디에도 없습니다. 문서에 있는 위 두 방식을 쓰십시오.
비용: 이미지 출력 100만 토큰당 $30, Responses는 텍스트 토큰 추가
OpenAI 가격 페이지 기준으로 GPT Image 2.5 두 모델과 gpt-image-2는 같은 토큰 단가를 씁니다. 100만 토큰당 이미지 출력 $30, 이미지 입력 $8(캐시 $2), 텍스트 입력 $5(캐시 $1.25)입니다. 단가가 같아도 모델과 품질 설정에 따라 이미지 한 장에 쓰는 토큰 수는 다릅니다.
OpenAI 가이드의 계산기로 뽑은 출력 토큰만의 1024×1024 추정치는 다음과 같습니다. 입력 토큰과 텍스트 모델 비용은 빠져 있습니다.
| 모델 | low | medium | high |
|---|---|---|---|
| GPT Image 2.5 (Flare·Sunburst) | $0.00588 | $0.01317 | $0.05268 |
gpt-image-2 | $0.00588 | $0.05268 | $0.21072 |
품질 이름이 같아도 가격이 같지 않다는 점에 유의하십시오. 2.5의 high가 gpt-image-2의 medium과 같은 금액입니다. 2.5의 xhigh와 max는 각각 $0.09366, $0.21072로 추정됩니다.
Responses API로 호출하면 이 이미지 비용에 텍스트 모델의 토큰 사용량이 더해집니다. 가격 페이지의 내장 도구 요금표에는 이미지 생성 도구의 호출당 요금이 따로 없고, 내장 도구가 쓰는 토큰은 선택한 모델의 토큰 단가로 청구된다고 적혀 있습니다. 스트리밍으로 미리보기(partial_images)를 받으면 미리보기 1장마다 이미지 출력 토큰 100개가 추가됩니다. 100 × $30 ÷ 1,000,000 = 장당 $0.003입니다.
실제 금액은 응답의 usage로 확인하는 것이 정확합니다. 장당 비용을 월 예산으로 환산하는 방법은 GPT Image 2 API 가격: 이미지 한 장부터 월간 예산까지에 있습니다.
요청이 실패할 때 먼저 볼 것
| 증상 | 먼저 확인할 것 | 대응 |
|---|---|---|
| 모델 관련 오류, 또는 옛 코드가 갑자기 실패 | 코드에 적힌 모델 ID와 도구 model 생략 여부 | 위 모델 표의 종료일과 대조하고 2.5나 gpt-image-2로 교체 |
| Responses 응답에 이미지가 없음 | tool_choice 지정 여부, image_generation_call의 status | 도구 호출을 강제하고, result가 비면 오류로 처리 |
image_generation_user_error, moderation_blocked | error.code, moderation_details | 프롬프트나 입력 이미지를 바꾸기 전에는 자동 재시도하지 않음 |
| 속도 제한, 서버 오류 | HTTP 상태와 요청 ID | 간격을 늘려 가며 재시도(backoff). 할당량 오류는 재시도하지 않음 |
| 요청이 오래 걸리다 끊김 | 클라이언트 타임아웃 설정 | 복잡한 프롬프트는 최대 약 2분 걸릴 수 있으니 타임아웃을 넉넉히 |
| 조직 인증 요구 오류 | 대시보드의 조직 인증 상태 | 인증 절차 확인 (위 준비 단계의 글 참고) |
어떤 경우든 SDK 예외에 담긴 요청 ID를 로그에 남겨 두면 원인을 좁히기 쉽습니다. moderation 파라미터는 auto(기본)와 low 두 값만 받습니다.
자주 묻는 질문
gpt-image-1 튜토리얼 코드를 그대로 써도 되나요?
요청 구조는 대부분 그대로지만 모델 ID는 바꿔야 합니다. gpt-image-1은 2026년 10월 23일, gpt-image-1.5와 gpt-image-1-mini는 2026년 12월 1일 종료됩니다. Responses 예제에서 도구 model이 빠져 있다면 그 코드도 gpt-image-1을 쓰고 있는 것입니다.
Chat Completions에서도 image_generation 도구를 쓸 수 있나요?
OpenAI가 호스팅하는 내장 도구는 Chat Completions에서 그대로 쓸 수 없습니다. 이미지만 필요하면 Images API를, 대화 속 이미지 생성이 필요하면 Responses API를 쓰십시오.
GPT 이미지 모델의 결과를 URL로 받을 수 있나요?
OpenAI API를 직접 호출하면 GPT 이미지 모델은 base64만 반환합니다. 웹에서 보여 주려면 디코딩한 파일을 직접 스토리지에 올려 URL을 만들어야 합니다.
Responses API가 Images API보다 비싼가요?
이미지 자체의 토큰 단가는 같지만, Responses API는 텍스트 모델 토큰이 추가로 청구되고 previous_response_id로 이어 가면 이전 입력도 다시 과금됩니다. 한 장 생성·편집만 한다면 Images API가 비용 면에서도 단순합니다.