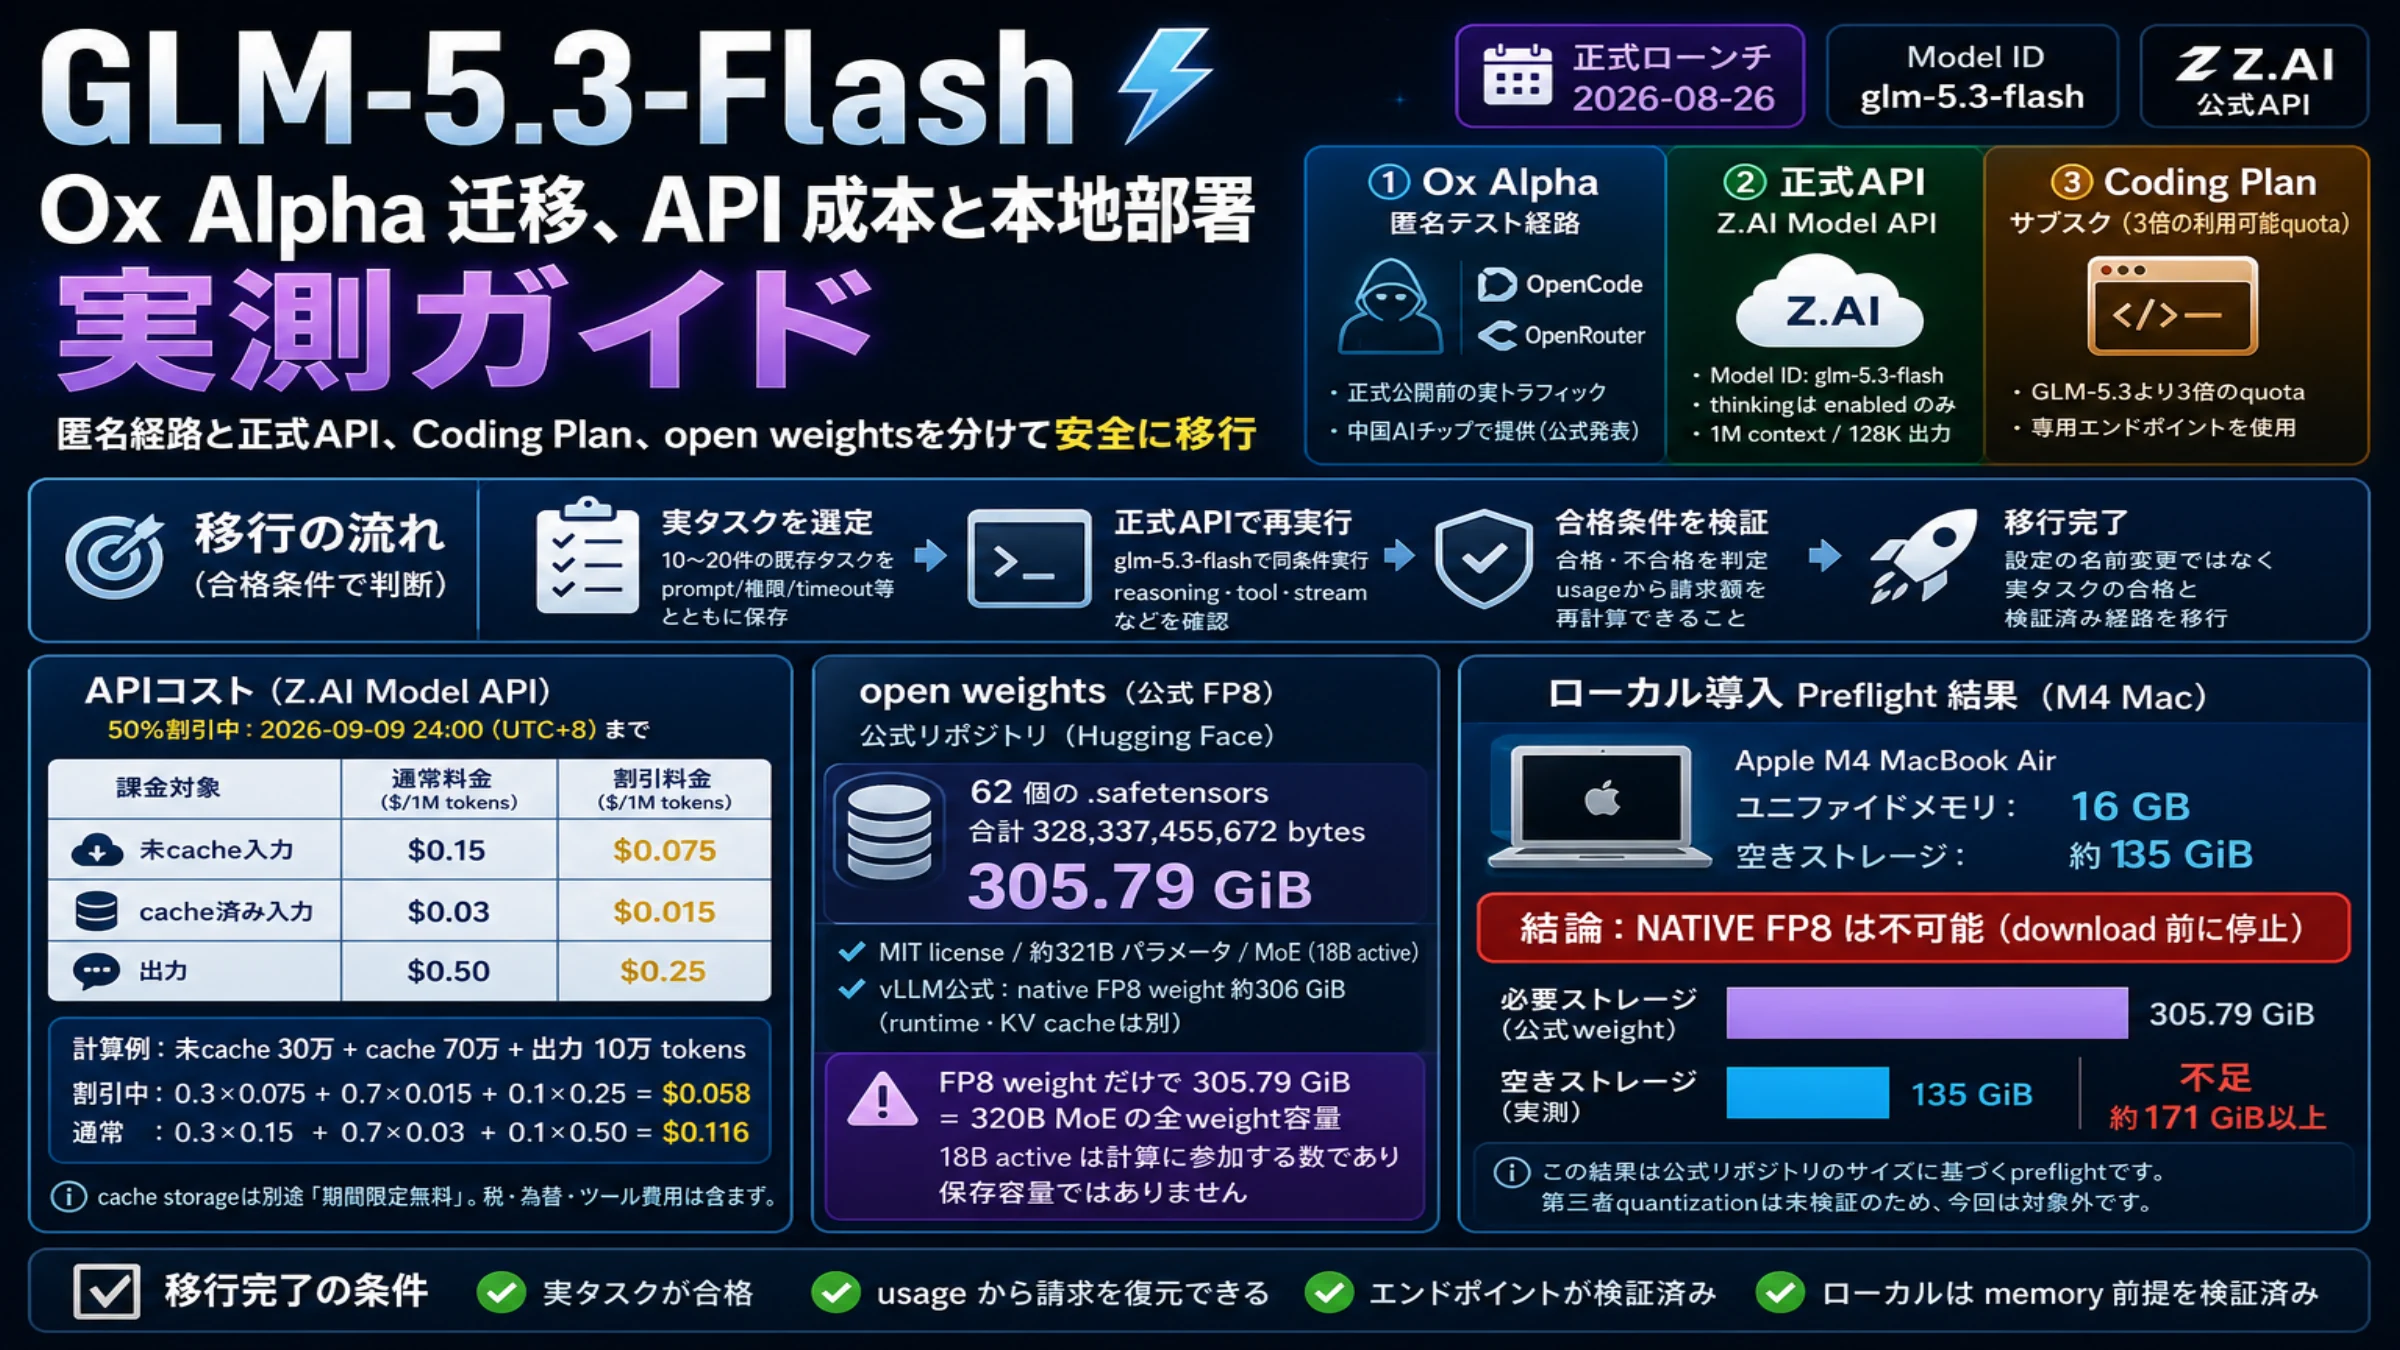
Ox Alphaの正体はGLM-5.3-Flashです。智譜AIは2026年8月26日の公式発表で、正式公開前にOx-Alphaという匿名名を使い、OpenCodeとOpenRouterの実トラフィックでテストしたと説明しています。正式なモデルIDはglm-5.3-flashです。
ただし、同じモデルでもサービスの利用条件が同じとは限りません。匿名プレビューの接続先、無料枠、キャッシュ、レート制限、ストリーミングの応答形式が、そのまま正式APIへ引き継がれるとは考えず、Ox Alphaでの結果を比較基準として正式APIを確認してください。
以下は公式文書に基づく導入手順と費用の計算例です。APIの成功率や応答時間、ローカルでの生成速度を測った結果ではありません。ローカル導入では、まず公式FP8モデルの重みだけで約306 GiBという要件を確認し、その上に実行環境やキャッシュの容量を見積もります。vLLMの導入要件
同じ作業と合格条件で移行を確認する
まず、Ox Alphaで完了した代表的な作業を選びます。依頼文だけでなく、ツールの権限、タイムアウト、最大ターン数、成果物、最終的な合否を保存し、正式APIでも同じ条件で比較します。
GLM-5.3-Flashの公式モデルページは、テキスト・画像・動画・ファイルの入力、テキスト出力、100万トークンのコンテキスト、最大128Kトークンの出力を示しています。提供元のAPIではthinking.typeはenabledのみです。reasoning_effortはlow、high、maxから選べ、既定値はmaxです。
確認する項目は次の通りです。
modelがglm-5.3-flashになっているか。- 推論部分と最終回答を別々に取り出せるか。
- ツールのストリーミングでは、引数の断片を最後まで結合してから処理できるか。未完成のJSONを実行しない。
- 構造化出力、画像・動画・ファイルの入力、再試行が実際のテストデータで動作するか。
- usageにある通常入力、キャッシュ済み入力、出力の内訳から費用を検算できるか。
Z.AIの通常APIのベースURLは公式APIリファレンスにあるhttps://api.z.ai/api/paas/v4です。Coding Planは専用の接続先を使います。プラン用のキーを、そのまま通常の従量課金APIへ送る構成にしないでください。次は環境変数ZAI_API_KEYに通常API用のキーを設定済みとした例です。公式推奨のreasoning_effort="max"を指定しますが、出力上限の4,096トークンは短い確認用の設定です。
curl -sS 'https://api.z.ai/api/paas/v4/chat/completions' \
  -H "Authorization: Bearer ${ZAI_API_KEY}" \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [{
      "role": "user",
      "content": "移行計画は、既存DBに列を追加し、新版を5%の通信に適用し、エラー率を確認して全体へ展開する手順です。リスク、受け入れ条件、切り戻し前の確認点を挙げてください。"
    }],
    "thinking": {"type": "enabled", "clear_thinking": false},
    "reasoning_effort": "max",
    "temperature": 1,
    "top_p": 0.95,
    "max_tokens": 4096
  }'
実行時はHTTP 200だけで終えず、最初の出力までの時間と完了までの時間、トークン内訳、再試行、ツールを使う処理の完了、業務上の合否を記録します。
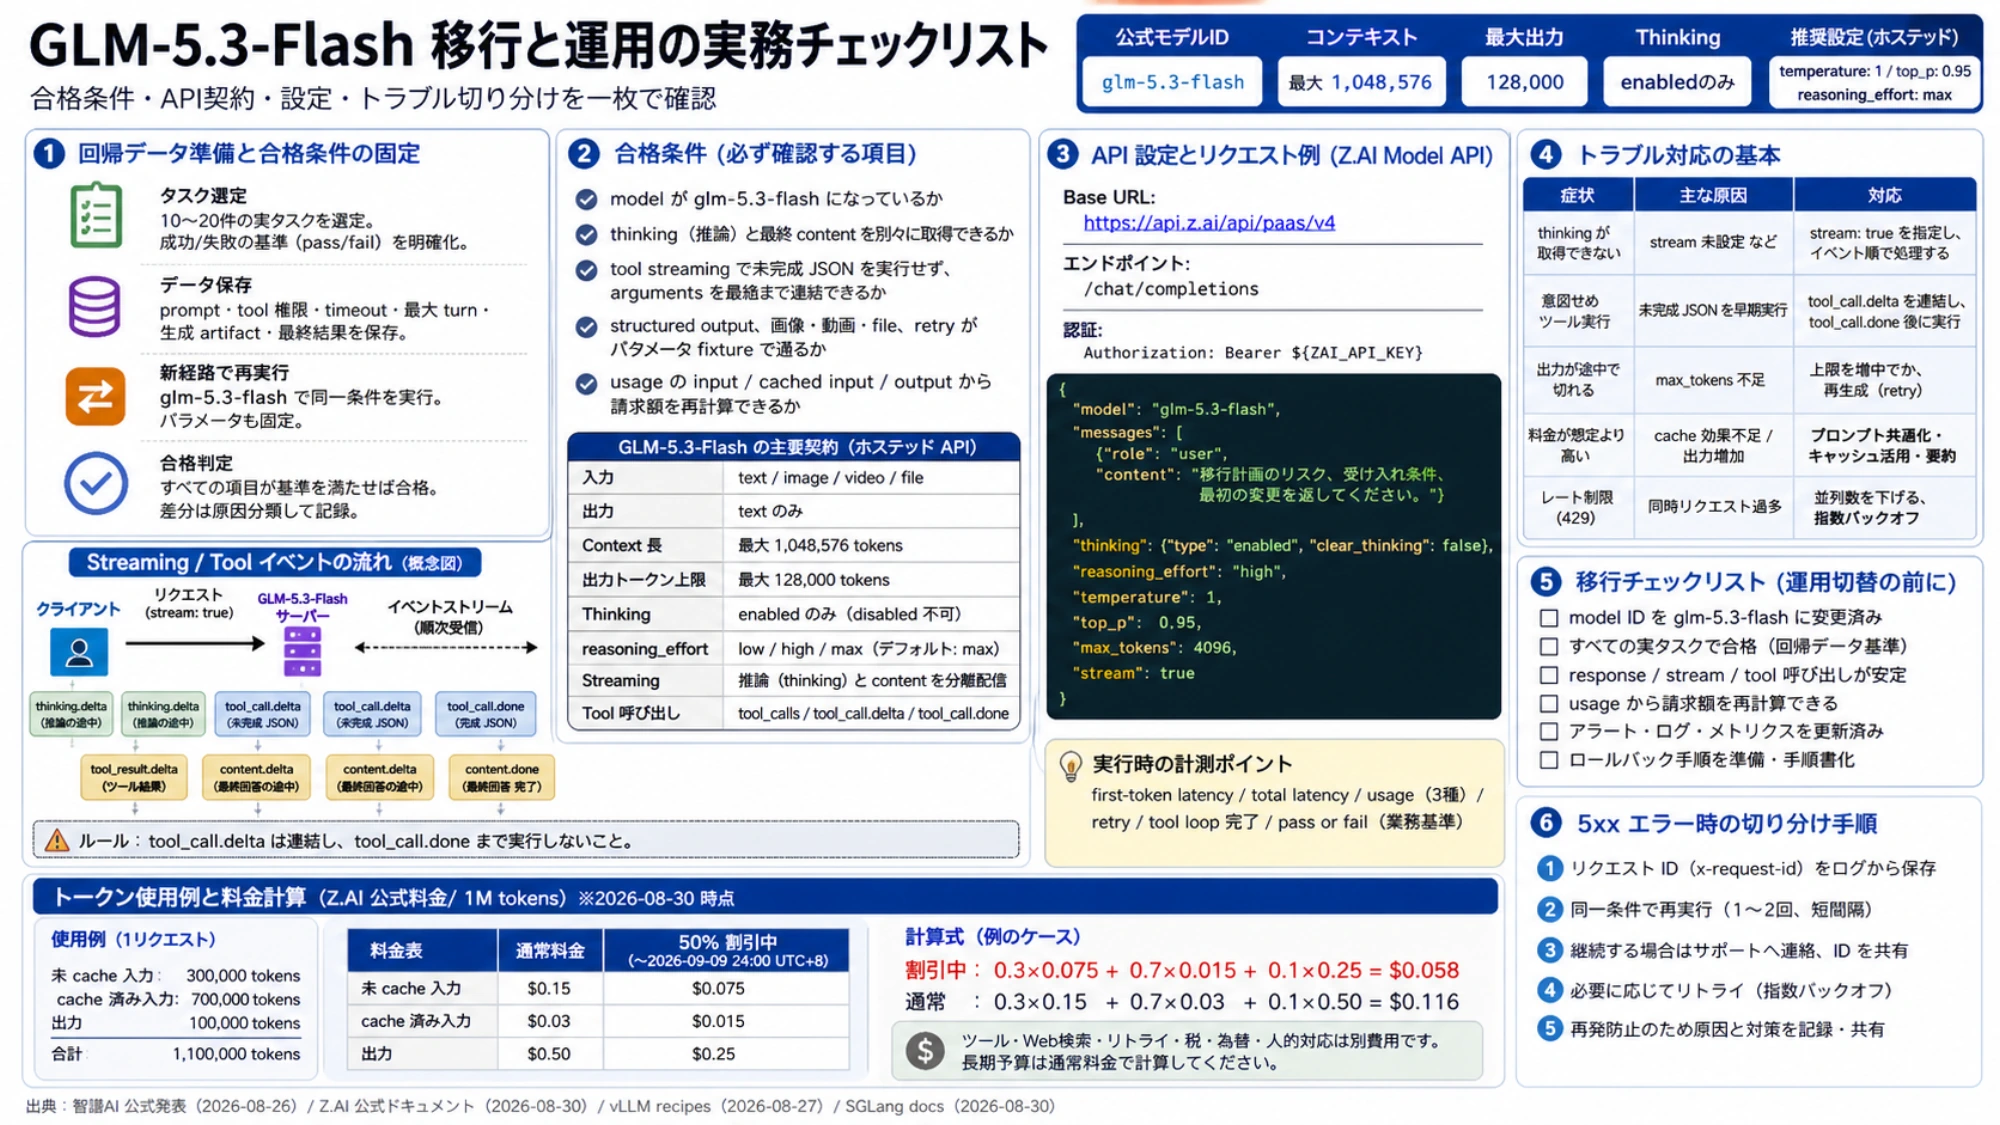
API料金は通常入力・キャッシュ入力・出力を分ける
2026年9月12日に確認したZ.AI公式料金は、100万トークン当たり次の米ドル単価です。
| 課金対象 | 標準料金(米ドル/100万トークン) |
|---|---|
| キャッシュされていない入力 | $0.15 |
| キャッシュ済み入力 | $0.03 |
| 出力 | $0.50 |
9月9日までと案内されていた50%割引の期間は終了しています。現在の料金表を使って見積もってください。キャッシュの保存は引き続き「期間限定無料」と記載されているため、恒久的な無料とは扱いません。
たとえば、通常入力30万、キャッシュ済み入力70万、出力10万トークンを消費したと仮定すると、トークン料金は次のとおりです。実測した使用量ではありません。
0.3 × $0.15 + 0.7 × $0.03 + 0.1 × $0.50 = $0.116
ツールや検索の別料金、税、為替、人による手直しの費用は別に考慮します。再試行で消費したトークンも含めた総費用を、合格した作業件数で割ると比較できます。入力合計にキャッシュ分が含まれる場合は、通常入力から差し引いて二重計上を避けます。
GLM Coding Planの利用量と通常APIのトークン料金は、別の課金方式です。プランの利用可能量の倍率を、API単価の割引率として使わないでください。
1. 約306 GiBの重みを保存できるか
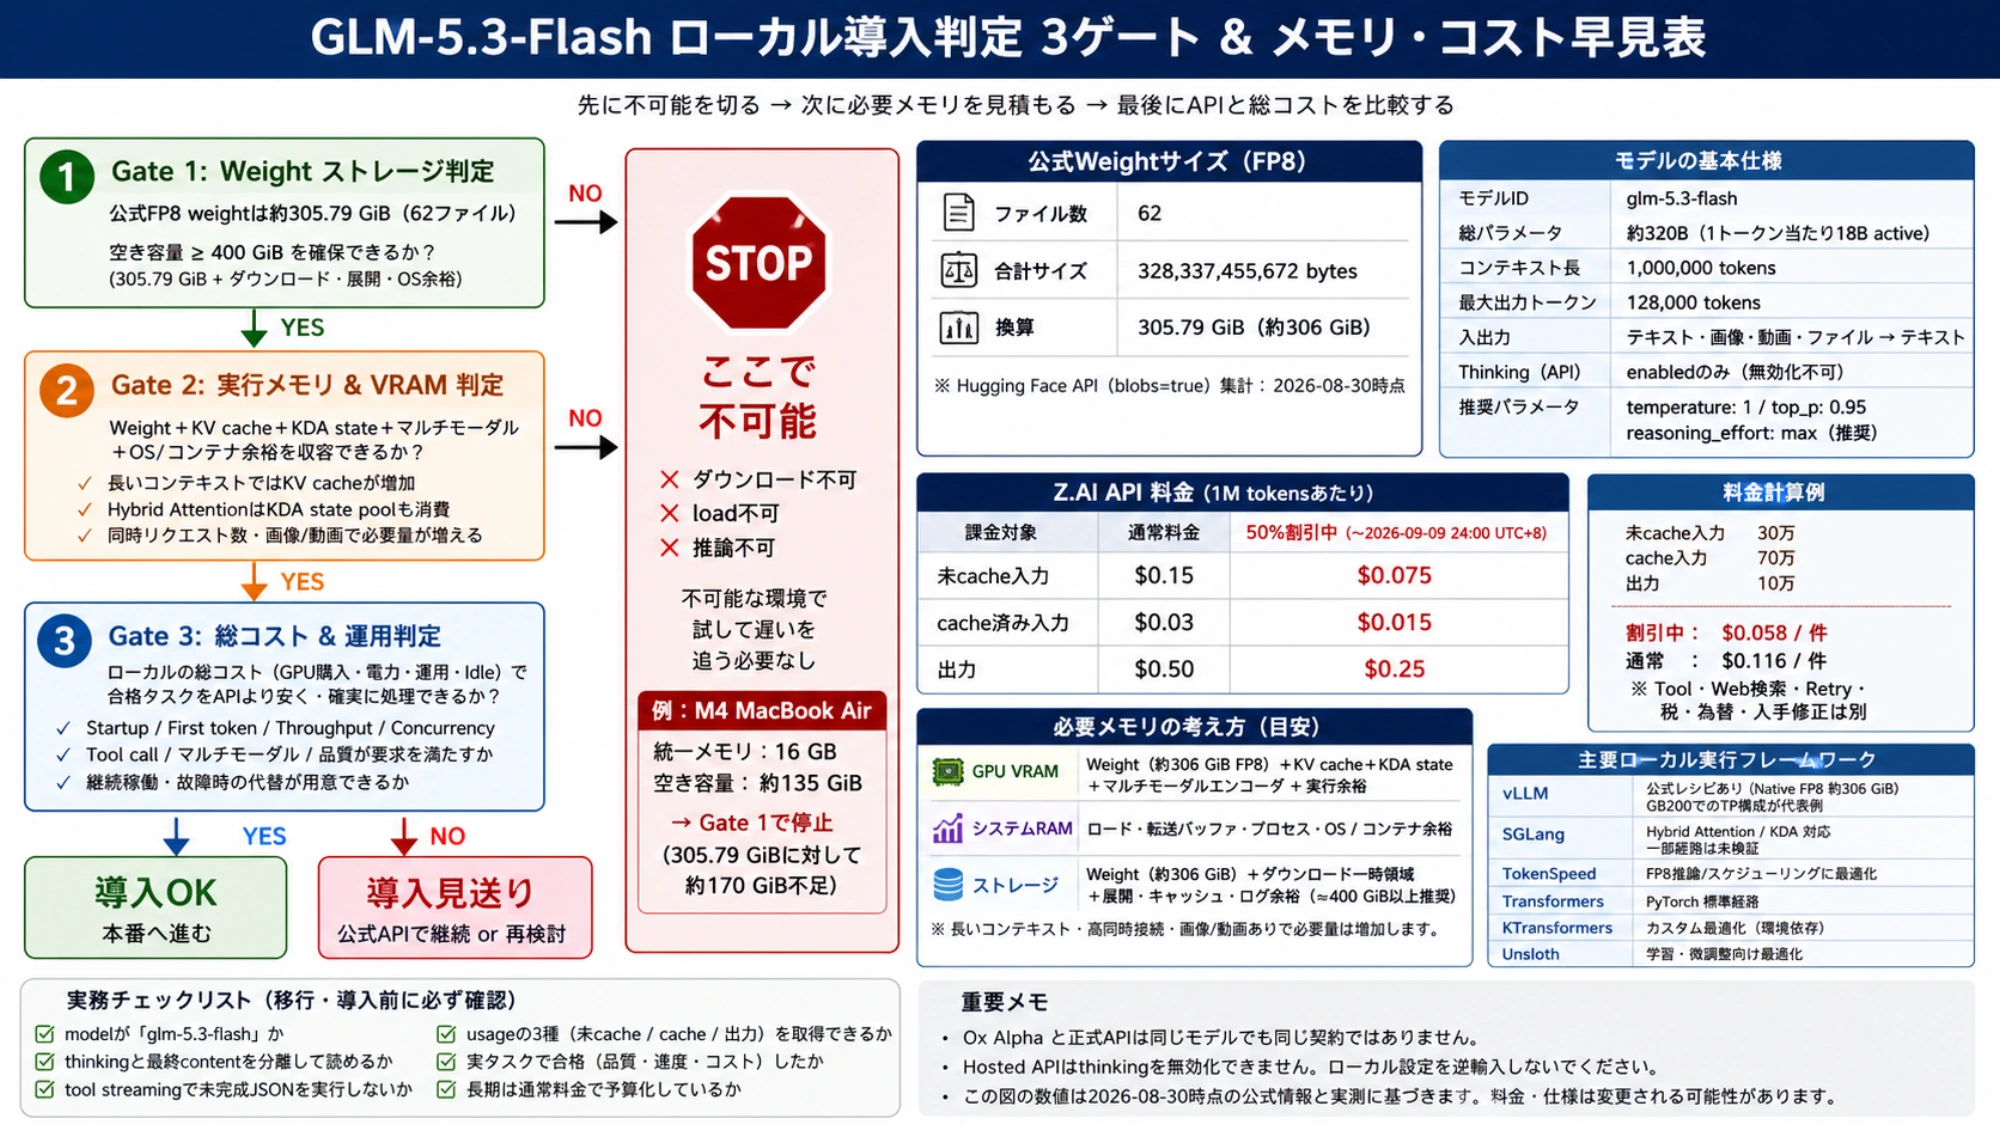
GLM-5.3-Flashは総パラメータ数約320B、1トークン当たりの稼働パラメータ数18BのMoEです。18Bは計算に参加するパラメータ数で、全重みの保存容量や必要メモリを表す数字ではありません。
公式Hugging Faceリポジトリの標準FP8版について、vLLMの導入ガイドは重みだけで約306 GiB、BF16版はその約2倍が必要としています。実行環境とKVキャッシュのメモリは別です。
モデル本体をダウンロードせず、現在の公開メタデータから重みファイルの総容量を確認するには、次を実行します。リポジトリの更新により値は変わり得ます。
curl -fsSL \
  'https://huggingface.co/api/models/zai-org/GLM-5.3-Flash?blobs=true' |
jq '[.siblings[]
  | select(.rfilename | endswith(".safetensors"))
  | .size]
  | {files: length, bytes: add, GiB: (add / 1073741824)}'
たとえば空きストレージが135 GiBの端末なら、約306 GiBのFP8重みを保存できません。16 GBのユニファイドメモリにも、その重み全体は収まりません。これは仕様との比較による事前判断で、起動後の速度を測った結果ではありません。
第三者の量子化版では条件が変わりますが、圧縮率だけで判断せず、その版の容量、対応環境、品質を確認する必要があります。ここでは量子化版の実行結果は扱っていません。
2. 重み以外に必要なメモリも見積もる
長い文脈を扱うとKVキャッシュの必要量が増えます。GLM-5.3-FlashはKDAの状態を保持するメモリ領域も使うため、KVキャッシュに余裕があっても、KDA側が同時処理数を制限する場合があります。画像・動画処理中のメモリ使用量や、コンテナーイメージの保存容量も見積もります。
SGLangの公式導入ガイドはBlackwell、H100/H200、AMD系でキャッシュのデータ型とAttentionの実装を分け、一部の構成を未検証としています。vLLMの代表例はGB200での4分割テンソル並列構成であり、一般向けGPU1枚の起動例ではありません。
GPU名と合計VRAMだけでなく、計算精度、並列化方式、平均入力長、最大同時リクエスト数、画像・動画入力の有無を決め、起動ログにある各メモリ領域の容量を確認します。
3. APIより低い総費用で必要な仕事を終えられるか
公式モデルカードに実行基盤が載っていても、対応ハードウェアや機能の実装状況は同じとは限りません。使用する版、Attentionの実装、推論・ツールの解析処理、画像入力を組み合わせた構成で、起動、最初の出力、処理速度、同時実行、ツール呼び出しを確認します。
提供元のAPIでは推論を無効化できません。ローカルのチャットテンプレートや設定を変更できても、それが提供元APIで受け付けられるパラメータとは限りません。利用する実装ごとの仕様を確認してください。
品質と費用を早く知りたいなら、まず正式APIで同じ課題を試すと判断材料を得やすくなります。データを自社環境内に保つ必要性、継続的な利用量、独自の推論要件を、複数GPUの購入費・電力・運用費・未稼働時の費用と比べてローカル導入を検討します。モデルを比較したい場合は、GLM-5.3とDeepSeek V4 Proの比較を参照してください。
移行後は、同じ業務の合格条件を満たすか、usageから費用を検算できるかを確かめます。APIなら接続先と課金、ローカルなら実際のメモリ使用量と処理結果まで確認してから利用を広げてください。