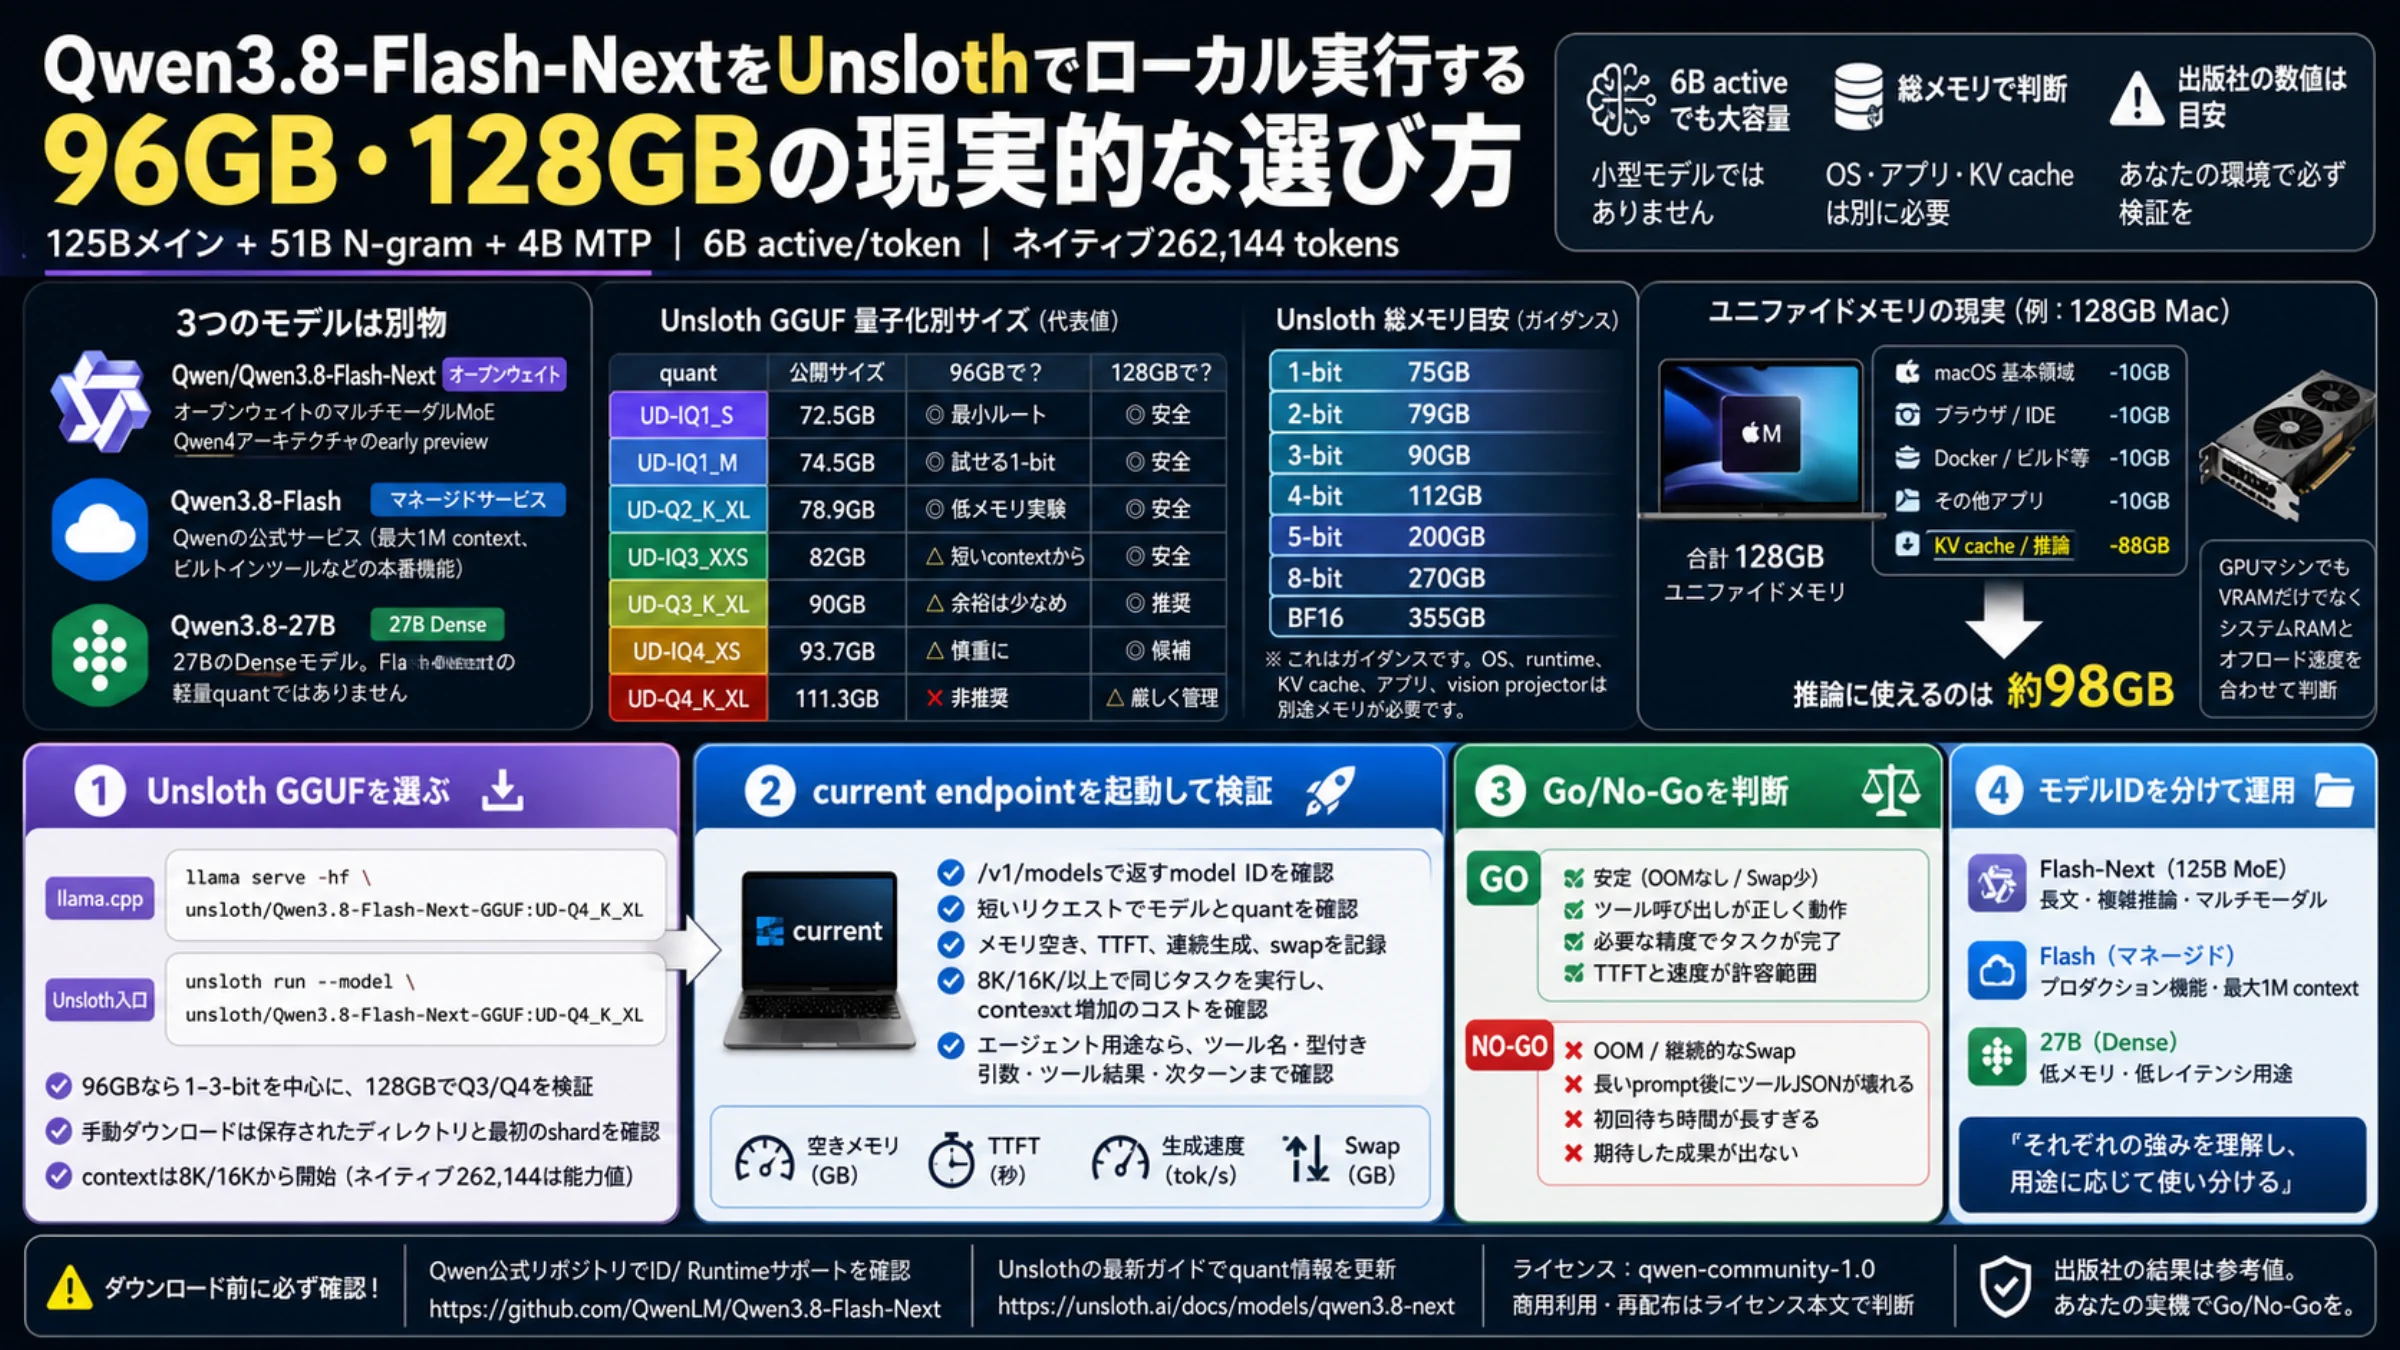
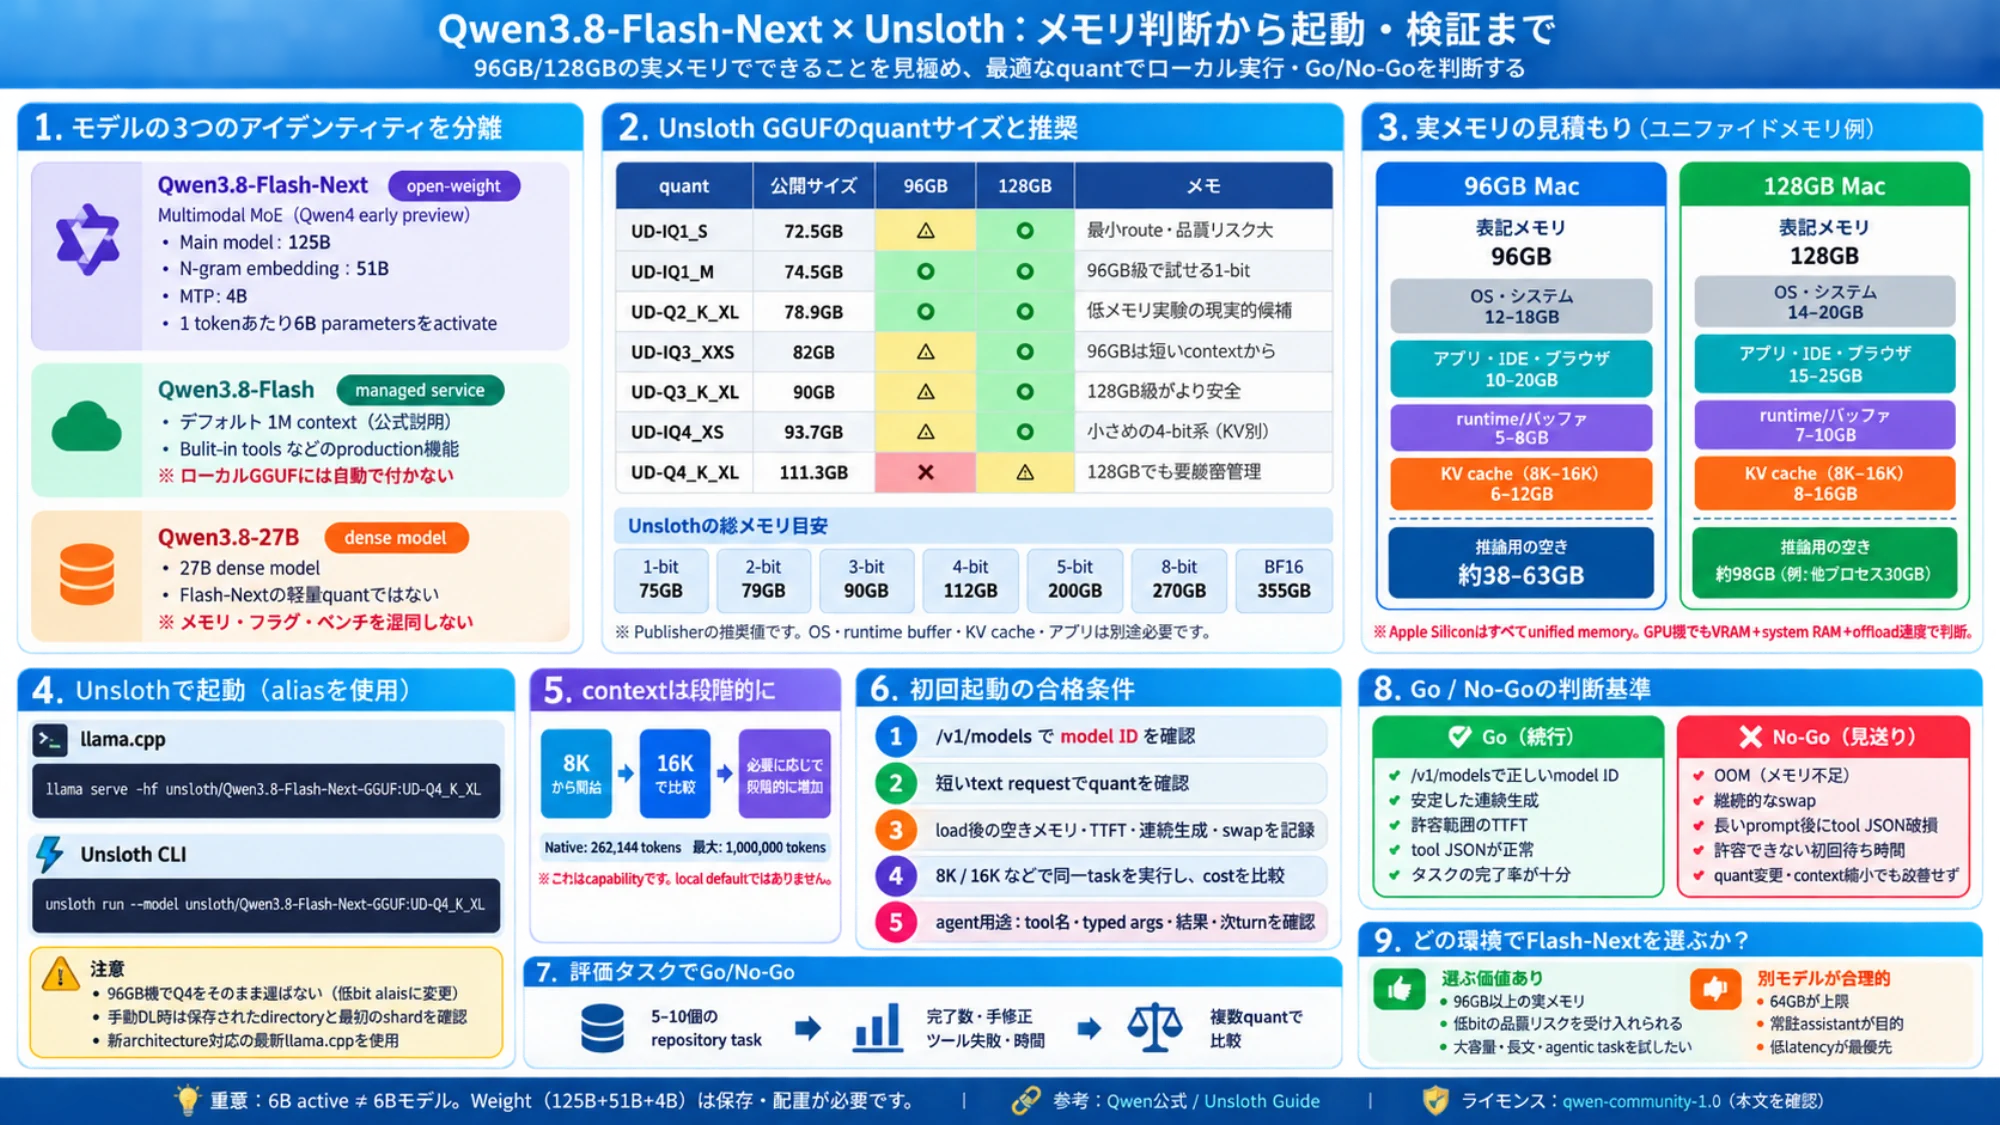
Qwen3.8-Flash-Nextのローカル実行で最初に見るべき数字は、GPU名ではなく推論中に本当に空いている総メモリです。Unslothは最小の1ビット量子化版の下限を75GBとし、96GB RAMまたはユニファイドメモリの端末を推奨しています。2026年9月12日のUnsloth公式ガイドでは4ビット版の目安は96〜114GBです。128GBのMacでも長い文脈を余裕で扱えるとは限らず、Q3/Q4から条件を絞って確認する出発点と考えてください。
「1トークン当たり6Bのパラメータが稼働する」という説明も、モデル全体が6Bという意味ではありません。Qwen公式モデルカードでは、本体が125B、N-gram埋め込みが51B、複数トークン予測のMTPが4Bと説明されています。1回の計算に使われる本体のパラメータが6Bでも、必要な重み全体の保存・配置は別に考えます。
96GBと128GBでできることは違う
Apple Siliconではモデル、macOS、アプリ、KVキャッシュが同じユニファイドメモリを共有します。仮に128GBのうちブラウザーやIDEなどが30GBを使っていれば、残りは98GBです。GPUを使う構成でも、VRAMだけでなくシステムRAMや、メモリ間で処理を分担する際の速度を合わせて判断します。
2026年9月12日に確認したUnslothの量子化比較では、モデルファイルの容量は次のとおりです。
| 量子化版 | 公開サイズ | 判断 |
|---|---|---|
UD-IQ1_S | 72.5GB | 最小容量。収めることを優先し、品質は用途ごとに確認 |
UD-IQ1_M | 74.5GB | 96GB級で試せる1ビット版 |
UD-Q2_K_XL | 78.9GB | 低メモリ実験の現実的な候補 |
UD-IQ3_XXS | 82GB | 96GB級でも短いコンテキストから始める |
UD-Q3_K_XL | 90GB | 128GB級の方がメモリの余裕を取りやすい |
UD-IQ4_XS | 93.7GB | 小さめの4ビット系。KVキャッシュは別に必要 |
UD-Q4_K_XL | 111.3GB | 128GBでも他プロセスとコンテキスト長を厳しく管理する |
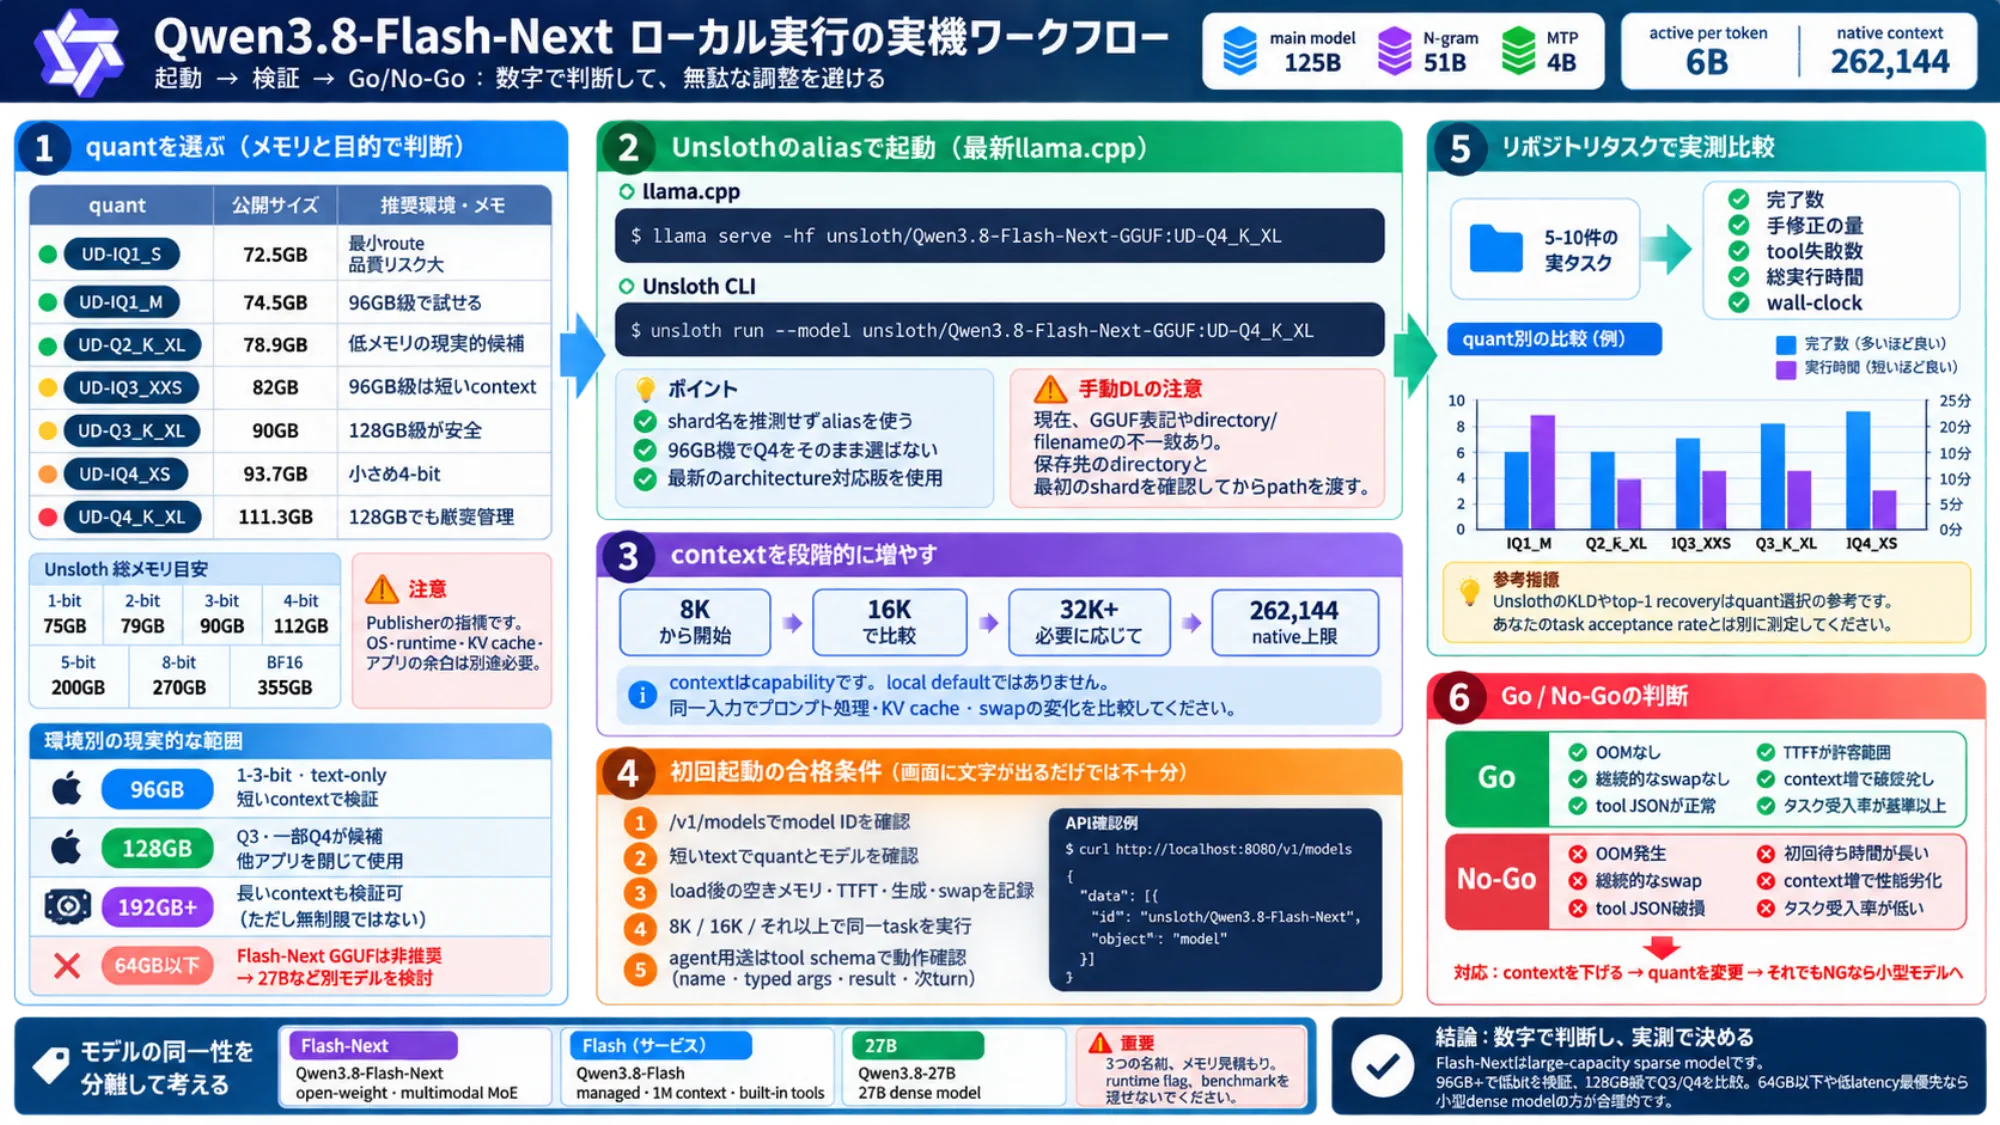
Unslothのガイドでは、総メモリの目安は1/2/3ビット版で75/79/90GB、4ビット版で96〜114GB、5ビット版で163GB、8ビット版で200GB、BF16で355GBです。これは配布元の目安であり、OS、実行時のバッファー、KVキャッシュ、画像入力用の追加モデルに必要な容量を、個々の環境に合わせて計算した値ではありません。
したがって、64GB以下はFlash-Nextの全重みをメモリに載せる構成を前提にしない方がよく、96GBは1〜3ビット版・テキスト入力のみ・短いコンテキストでの検証向けです。128GBならQ3と一部Q4が候補になります。192/256GB以上でも、文脈を長くするための追加メモリは必要です。
24〜48GB級でローカルのコーディングエージェントを使う目的なら、より小さい別モデルを検討できます。Qwen3.8-27Bのローカル実行ガイドで、その環境に合う量子化版と必要メモリを確認してください。
同じように見える3つの名前
Qwen/Qwen3.8-Flash-Nextは重みを公開したマルチモーダルMoEで、Qwen4アーキテクチャの初期プレビューです。Gated DeltaNetとQwen Sparse Attentionを組み合わせ、N-gram埋め込みを追加しています。
Qwen3.8-FlashはQwenが運用するサービスです。公式説明では既定の100万トークンの文脈や内蔵ツールなどが提供されますが、ローカルのGGUFを起動しても、それらが自動で付くわけではありません。
Qwen3.8-27Bは27Bの密モデルです。Flash-Nextを軽量化した量子化版ではないため、メモリの見積もり、起動オプション、評価結果を流用しないでください。
Qwenが公開したコーディング、エージェント、ツール利用の評価は、同社のテスト環境で得た結果です。Unslothの1ビット版でもツールの引数が正しく返るか、手元のMacで最初の出力までの待ち時間を許容できるかは、実際の構成で確かめます。
分割ファイル名を手入力せず、量子化版の名前で起動する
このモデルのアーキテクチャに対応したllama.cppを使います。UnslothのGGUFリポジトリで案内される量子化版の別名指定を使えば、分割ファイル名を手で組み立てる必要はありません。
llama serve -hf unsloth/Qwen3.8-Flash-Next-GGUF:UD-Q4_K_XL96GBの端末では、111.3GBあるこのQ4版をそのまま選ばないでください。空きメモリに合う低ビット版の名前へ置き換えます。Unsloth側では次のように起動します。
unsloth run --model unsloth/Qwen3.8-Flash-Next-GGUF:UD-Q4_K_XL2026年9月12日に確認したUnslothの手動ダウンロード例には、ローカルディレクトリのGGFFという誤記と、UD-IQ1_SのディレクトリにUD-Q4_K_XLのファイル名を組み合わせた不一致が残っています。手動で取得する場合は、実際に保存されたGGUFのディレクトリと先頭の分割ファイルを確認し、一致するパスを指定してください。
最初の確認では、コンテキスト長を8Kや16K程度に抑える方法が考えられます。公式の標準262,144トークン、拡張時最大100万トークンという値は、モデルの対応範囲であり、手元の環境に適した起動設定ではありません。段階的に増やし、入力の処理時間、KVキャッシュ、スワップの変化を同じ入力で比べてください。
初回起動の合格条件
画面に文字が出るだけでは不十分です。
/v1/modelsでサーバーが返すモデルIDを確認する。- 起動ログでFlash-Nextと選んだ量子化版が読み込まれていることを確認し、短いテキストの依頼に回答が返るか試す。
- 読み込み後の空きメモリ、最初の出力までの時間、連続生成の速度、スワップを記録する。
- 8K、16K、それ以上で同じ作業を行い、文脈を長くした際のメモリと待ち時間の変化を見る。
- エージェント用途なら、単純なツール定義を用い、ツール名、引数の型、実行結果、次のターンまで確認する。
その後、結果の正しさを判断できるリポジトリの作業を複数の量子化版で比較します。完了件数、手直し、ツールの失敗、実際の所要時間を記録してください。UnslothのKLDやtop-1一致率は量子化版を選ぶ参考になりますが、その値が自分の仕事の成功率を表すわけではありません。
メモリ不足(OOM)、継続的なスワップ、長い入力後の壊れたツールJSON、許容できない待ち時間があれば、その構成の採用を見送ります。コンテキスト長を下げ、量子化版を変えても改善しなければ、小型モデルを検討してください。読み込めたことに加え、必要な作業を終えられるかを判断します。
Flash-Nextを選ぶ条件
96GB以上のメモリがあり、低ビット量子化による品質の変化を確認しながら、大規模MoEをエージェント処理や長文脈の仕事で試したい場合は候補になります。Q3/Q4を比較するなら、ほかのアプリを閉じてメモリを確保できる128GB級の方が試しやすくなります。
一方、64GBが上限の場合、常駐アシスタントが目的の場合、待ち時間の短さを最優先する場合は、小型モデルから検討するとよいでしょう。Flash-Nextは1トークン当たりの計算量を減らしても、重みとN-gram埋め込みの保存が不要になるわけではありません。
ダウンロード前にQwen公式リポジトリで対象モデルと実行基盤の対応を確認し、Unslothの最新ガイドで量子化版の情報を確認してください。モデルページのライセンスタグはqwen-community-1.0です。商用利用や再配布は、タグだけでなく実際のライセンス本文を読んで判断します。