DeepSeek V4やV4.1をvLLMで動かし、coding agentからツールを呼ばせると、チャットは返るのにツールが実行されない、DSMLの断片が本文に出る、引数が空のまま届く、といった症状が出ることがあります。2026年9月30日時点では、次の順に確かめると原因をかなり絞れます。
- vLLMをv0.30.0以降にする。開始wrapperが欠けたDSMLのパース(PR #55954)、綴りの崩れたwrapperの許容(#56141)、V4.1-Flash対応(#56208)は、2026年9月22日公開のv0.30.0のリリースノートに載っています。
- V4.1-Flashはまず非ストリーミングで確かめる。
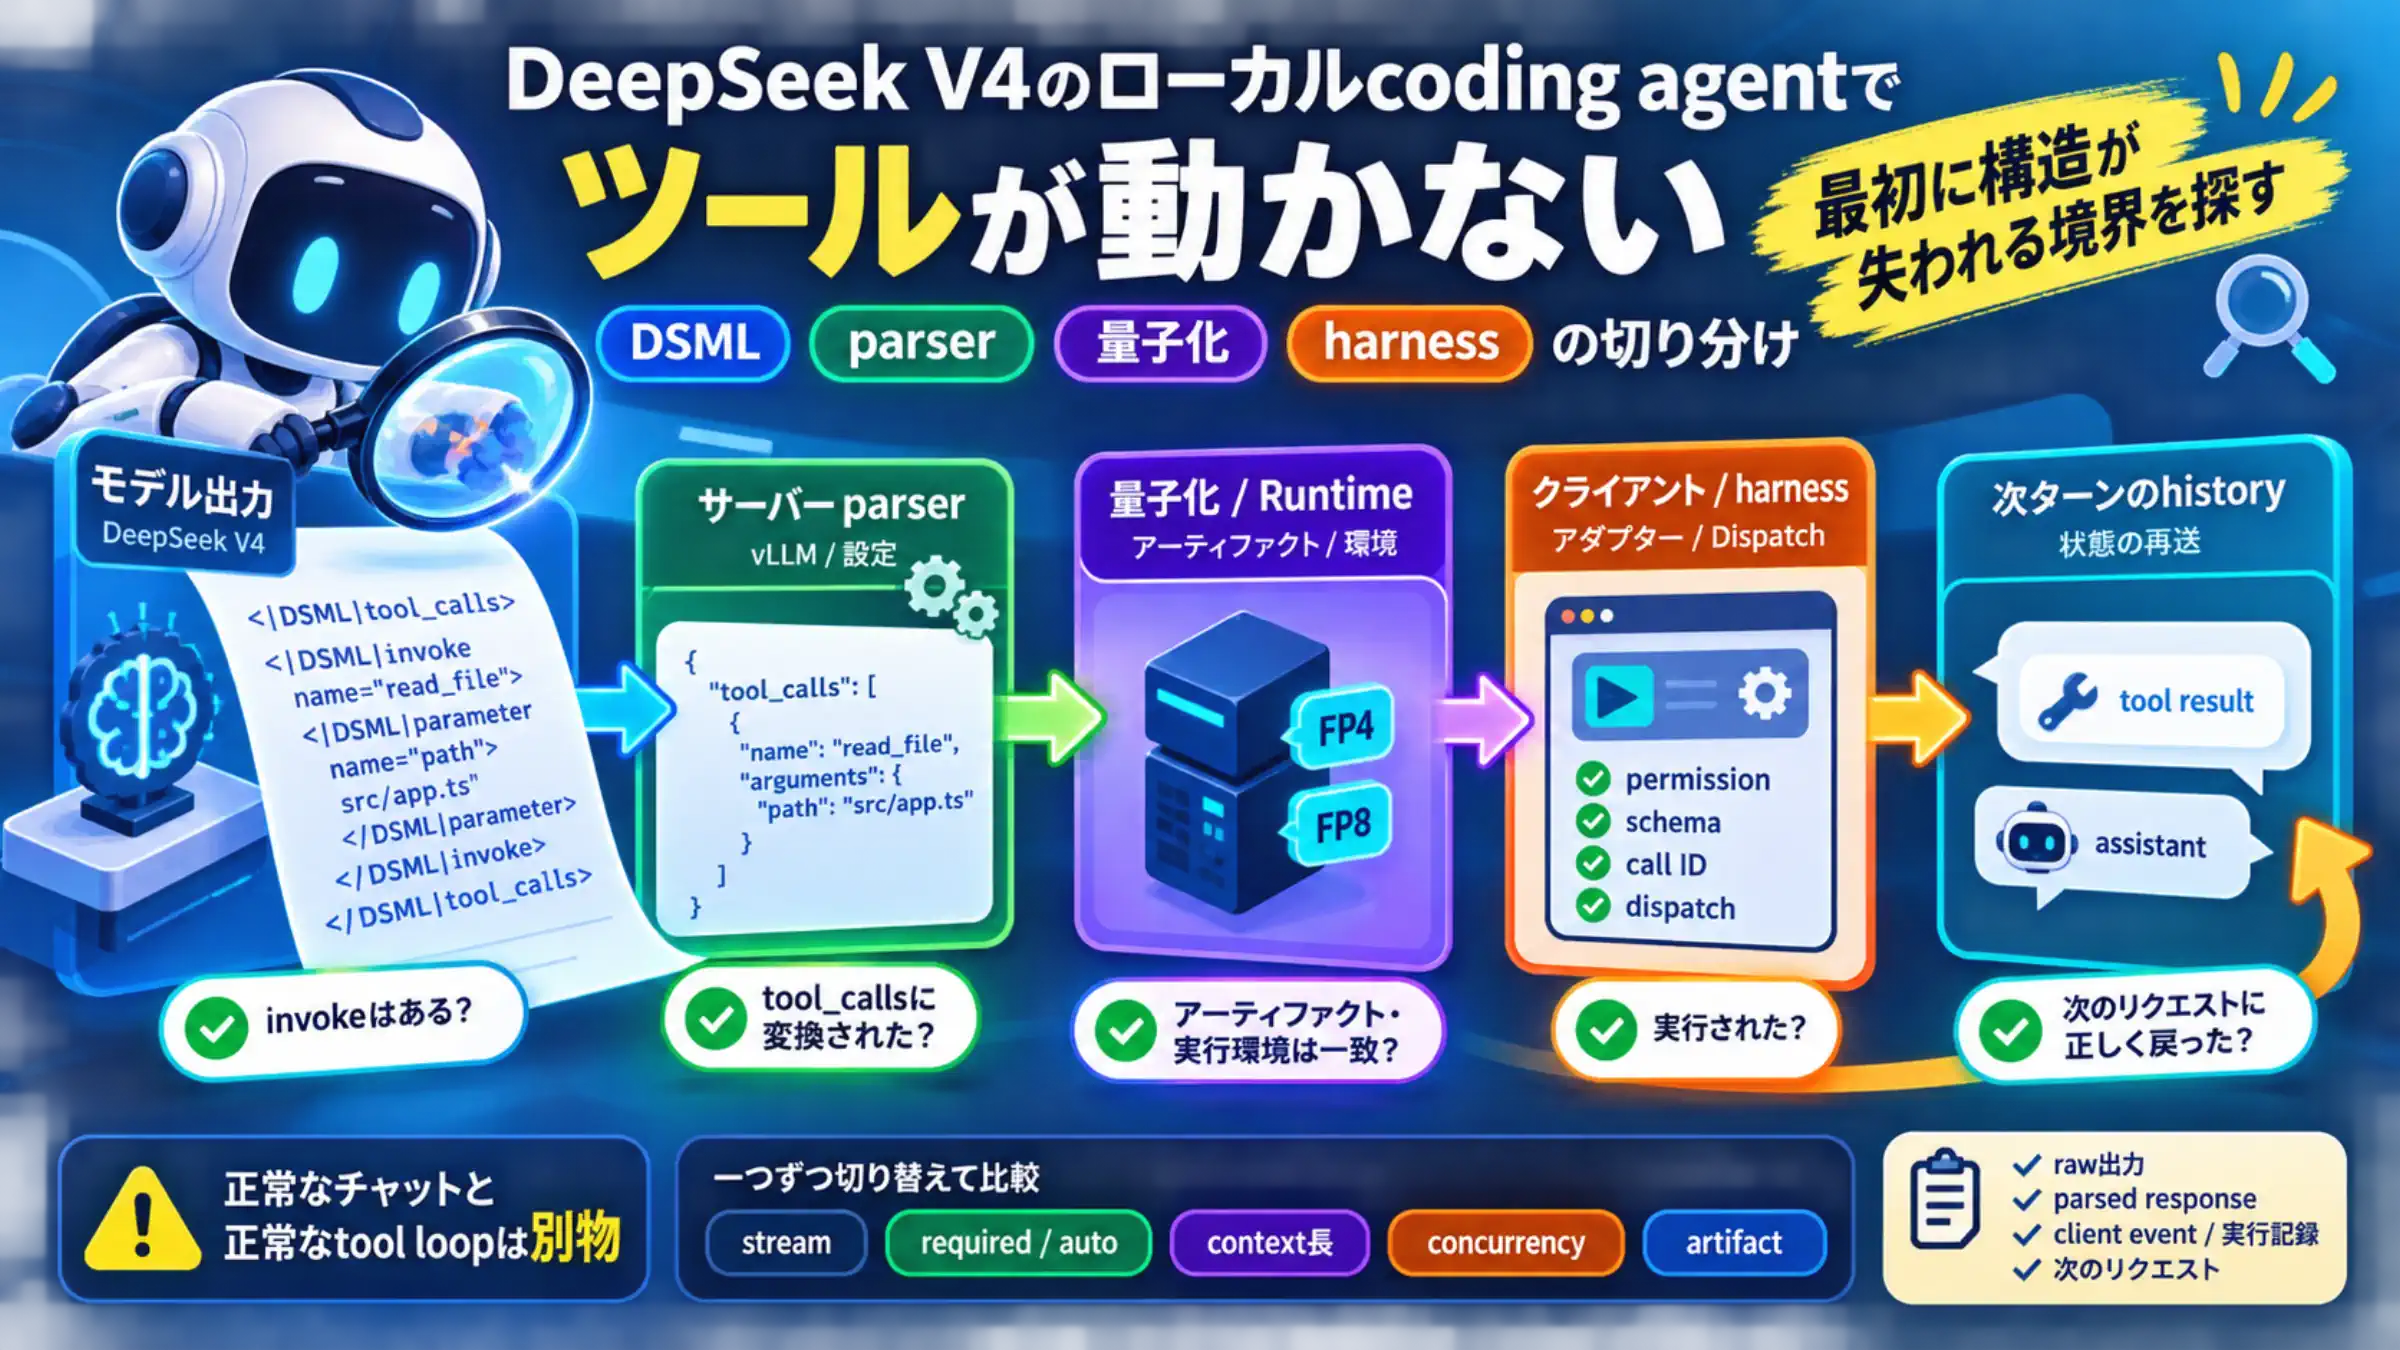
deepseek_v41パーサーでストリーミング中に引数のdeltaが落ちる問題(issue #58640)は、修正PR #58822がまだマージされていません。 - それでも壊れるなら、構造が最初に消える境界を探す。生の出力、サーバーの応答、クライアントが受け取ったイベント、実行されたツール、次のリクエストの履歴を、同じ1往復分そろえて比べます。
公式のDeepSeek APIで2回目のリクエストだけが400になる場合は原因が別です。toolsを付けたリクエストでは、過去すべてのターンのreasoning_contentを送り返す必要があります(詳しくは後半の公式APIの節)。
DSMLとは:ツール呼び出しがどこで消えるか
DSMLは、DeepSeek V4系のモデルがツール呼び出しを表すために出力するタグ形式のマークアップです。V4-FlashとV4.1-FlashにはJinja形式のチャットテンプレートが付いておらず、代わりにモデルリポジトリのencodingフォルダーにあるPythonの参照実装(encoding.py)が、多ターン会話、ツール呼び出し、thinkingモード、推論の強さ(effort)の扱いを定めています(DeepSeek-V4.1-Flashのモデルカード)。
モデルの生出力は次のような形です。vLLMのdeepseek_v4パーサーのドキュメントにある形式に、ファイル読み込みのツールを当てはめた例です。
<think>……</think>
<|DSML|tool_calls>
<|DSML|invoke name="read_file">
<|DSML|parameter name="path" string="true">src/app.ts</|DSML|parameter>
</|DSML|invoke>
</|DSML|tool_calls>サーバー側のパーサーがこのブロックをOpenAI互換のtool_callsに変換し、agentはtool_callsだけを見てツールを実行します。本文(content)にDSMLが出ているのは、パーサーがブロックを認識できなかった印です。モデルがそもそもツールを呼ぼうとしなかった場合とは、直す場所が違います。
string属性は、値を文字列として渡すか("true")、数値などのJSON値として読むか("false")の指定です。ドキュメントの例ではlocationの「杭州」がtrue、countの5がfalseになっています。モデルはこの属性を省くことがあり、vLLMのパーサーは「省かれたパラメーターを捨てると、クライアントには引数のないツール呼び出しが渡ってしまう」として属性を任意扱いにしています。引数が空の{}で届く症状は、この部分と関係します。
vLLMで直った不具合と残っている不具合(2026年9月30日時点)
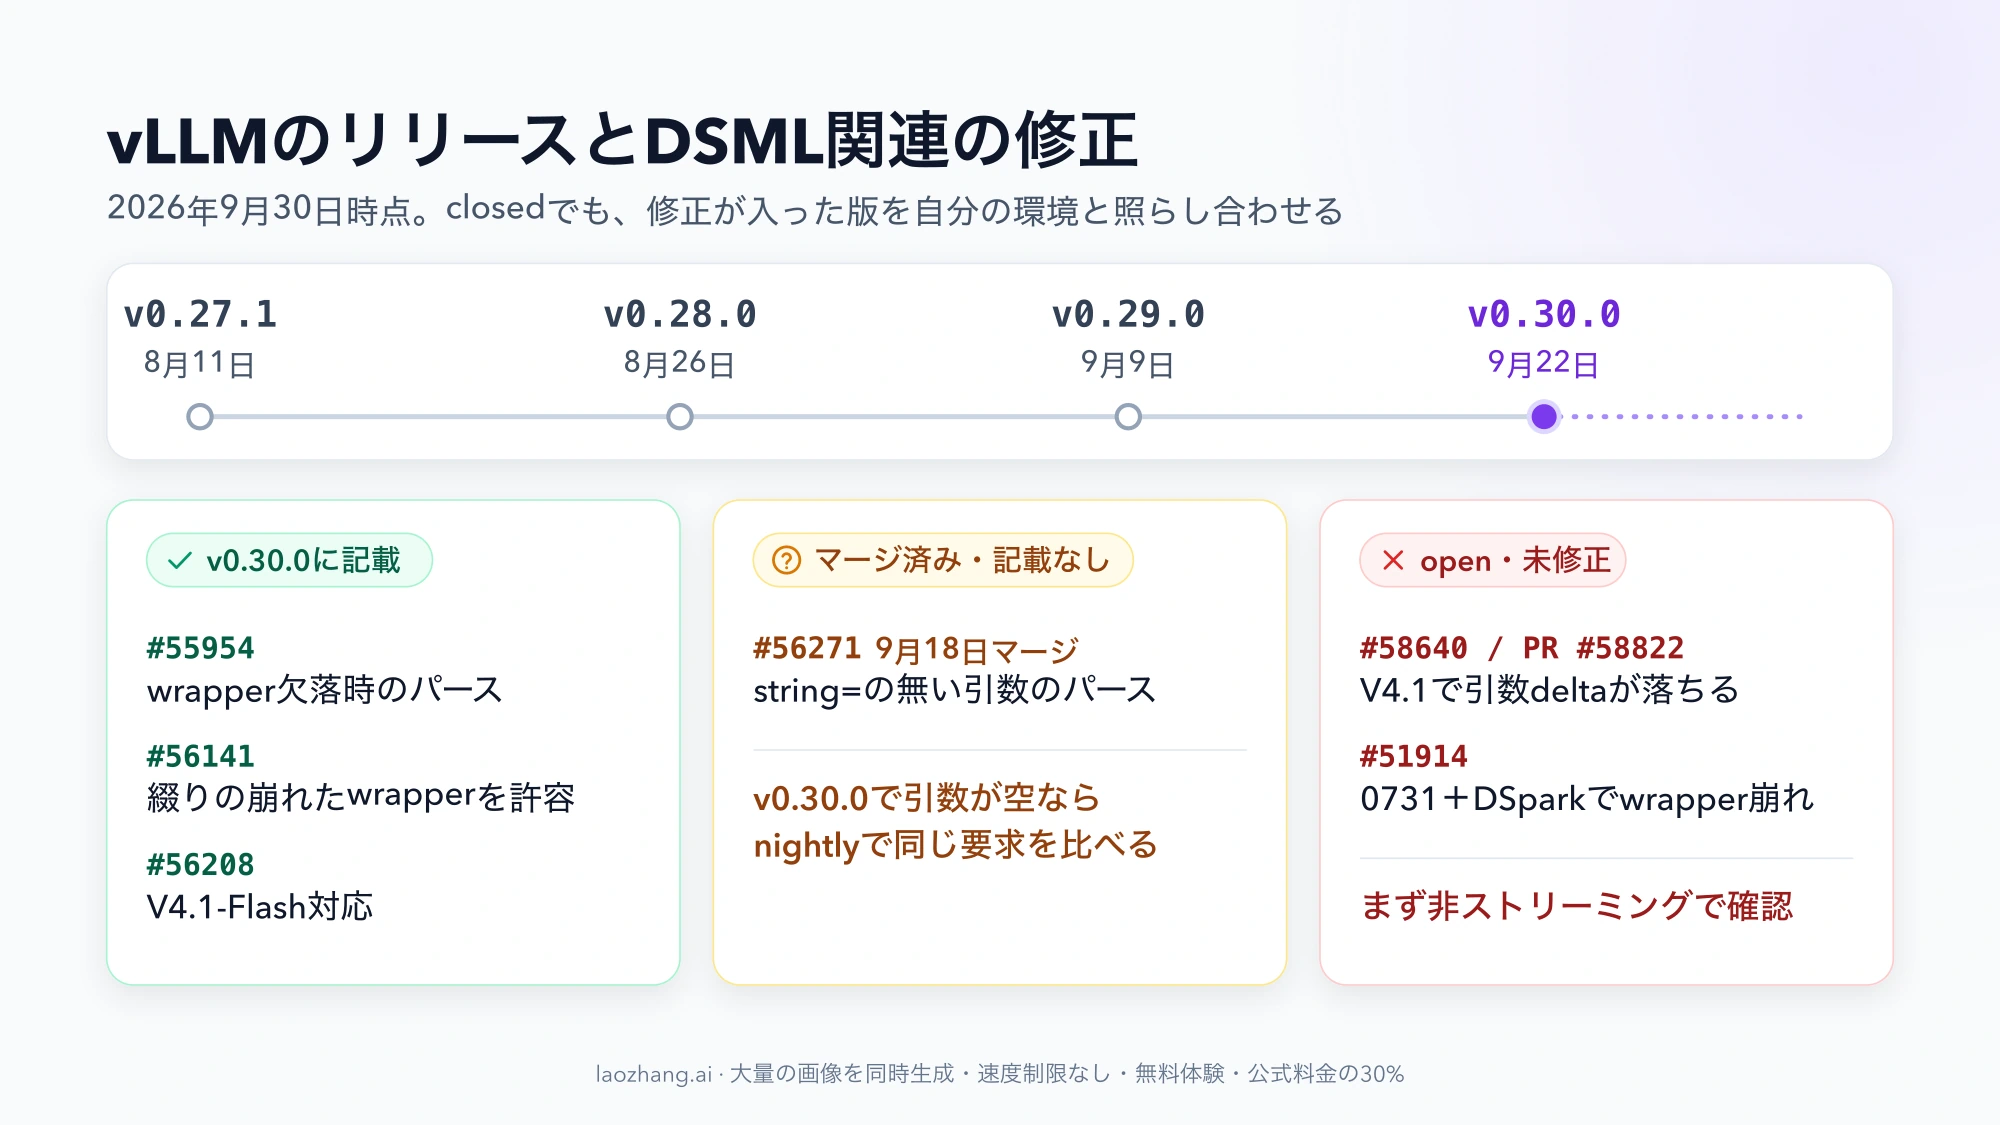
vLLMのissueとPRの状態を症状別に並べると次のとおりです。closedは「どのバージョンでも直った」という意味ではありません。修正がどのリリースに入ったかを見て、自分の環境のバージョンと照らし合わせます。
| 症状 | 関連するissue・PR | 状態(2026年) | 自分の環境での確かめ方 |
|---|---|---|---|
auto+ストリーミングでDSMLの断片がcontentに漏れる | #40801 | 6月25日closed | ストリーミングとtool_choiceを切り替えて再現するか見る |
argumentsで包まれた引数や予約名の引数をパーサーが誤処理する | #41240 | 5月6日closed | 使っている版で再現するか見る |
開始wrapper <|DSML|tool_calls>が無いと生のDSMLが本文に漏れる | #48931、PR #55954 | 9月9日closed・マージ | v0.30.0のリリースノートに記載 |
綴りの崩れたwrapper(例:toolcalls)を認識しない | PR #56141 | 9月10日マージ | v0.30.0のリリースノートに記載 |
| 並列負荷でタグの対応が崩れる | #48089 | 9月1日closed | 並列数1と本番の負荷で比べる |
非正規の量子化で起動時にKeyError: scale_fmt | #41604 | 9月5日closed | ロードの失敗なのでパーサーとは分けて扱う |
string=の無いパラメーターを読めない | PR #56271 | 9月18日マージ | v0.30.0のリリースノートには記載なし |
| V4.1-Flashへの対応 | PR #56208、#56214、#56228 | 9月10〜11日マージ | #56208はv0.30.0のリリースノートに記載 |
| V4.1でストリーミング中に引数のdeltaが落ちる | issue #58640、PR #58822 | PRはopen(9月26日作成) | 非ストリーミングでは引数が届くか確かめる |
| V4-Flash-0731+v0.27.1+DSparkで開始wrapperが崩れる | #51914 | open | DSparkのオンとオフで比べる |
リリースの日付は、v0.27.1が8月11日、v0.28.0が8月26日、v0.29.0が9月9日、v0.30.0が9月22日です。#55954と#56141はv0.30.0のノートで初めて出てくるため、v0.29.0以前のイメージを使っているなら、ほかの調査より先に更新します。
#56271はv0.30.0の公開より前にマージされていますが、ノートには載っていません。v0.30.0でもstring=が無いパラメーターで引数が空になるなら、mainから作られたnightlyイメージで同じリクエストを試すと、この修正の有無を切り分けられます。
起動設定と実際のバージョンを確かめる
最初に、コンテナの中で実際に動いているvLLMのバージョンを確認します。新しい起動オプションを古いイメージに渡しても、パーサーの実装は変わりません。
docker exec <コンテナ名> python3 -c "import vllm; print(vllm.__version__)"次に、モデルとパーサーの組み合わせを確認します。V4とV4.1ではパーサーが別で、V4.1は統合されたdeepseek_v41パーサーを使います。ツール呼び出しに関係するオプションだけを抜き出すと次のとおりです。V4側はvLLMのリポジトリにあるV4-Flashのテスト設定、V4.1側はvLLM recipesのV4.1-Flash設定の記載です。並列数、KVキャッシュ、投機的デコードなどの設定は省いています。
# DeepSeek-V4-Flash
vllm serve deepseek-ai/DeepSeek-V4-Flash \
  --tokenizer-mode deepseek_v4 \
  --tool-call-parser deepseek_v4 --enable-auto-tool-choice \
  --reasoning-parser deepseek_v4

# DeepSeek-V4.1-Flash
vllm serve deepseek-ai/DeepSeek-V4.1-Flash \
  --tokenizer-mode deepseek_v41 \
  --tool-call-parser deepseek_v41 --enable-auto-tool-choice \
  --reasoning-parser deepseek_v41
recipesのV4.1-Flash設定(2026年9月29日更新)は、必要なvLLMの最低バージョンを0.30.0とし、Dockerイメージにはnightlyを指定しています。DSparkによる投機的デコードは、同じ設定の中で任意に有効化する機能として分けられています。
V4.1をV4用のパーサーのまま動かしている場合は、まずそこを直します。V4とV4.1ではDSMLの書き方(方言)が異なり、PR #56260(9月11日マージ)の説明に出てくるV4.1の例は、<|DSML| parameterのようにタグの中に空白を含みます。ルーター事業者OrcaRouterのブログも、V4.1-Flashの公開直後は素のvLLMでツール呼び出しが動かず、DSMLタグ内の空白が原因で2本のPRによって直ったと報告しています。
同じ#56260は、履歴にあるツール引数をプロンプトに戻すときのエンコードを、DeepSeekの参照実装deepseek-recipeに合わせました。JSONとして読めない引数やオブジェクトでない引数は、string="true"のargumentsパラメーター1個としてそのまま保たれます。agentが引数を文字列のまま二重にエンコードして履歴に戻していても、DSML上ではその文字列がそのまま渡ります。
tool_choiceとストリーミングを切り替えて比べる
agentを外し、同じリクエストをstreamとtool_choiceの組み合わせだけ変えて送ります。tool_choiceは"auto"ならモデルが呼ぶかどうかを判断し、"required"ならいずれかのツールを必ず呼ばせます。VLLM_URLには自分のサーバーのアドレスを入れてください。
curl -s "$VLLM_URL/v1/chat/completions" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4.1-Flash",
    "stream": false,
    "tool_choice": "required",
    "messages": [{"role": "user", "content": "src/app.tsを読んでください"}],
    "tools": [{
      "type": "function",
      "function": {
        "name": "read_file",
        "description": "指定したパスのファイルを読む",
        "parameters": {
          "type": "object",
          "properties": {"path": {"type": "string"}},
          "required": ["path"]
        }
      }
    }]
  }' | jq '.choices[0].message | {content, tool_calls}'
"stream": falseとtrue、"required"と"auto"の4通りを試し、結果を次のように読みます。
| 結果 | まず疑う場所 | 次にやること |
|---|---|---|
非ストリーミングではtool_callsに引数まで入るが、ストリーミングでは引数だけ空になる(V4.1) | deepseek_v41パーサーのストリーミング処理(#58640) | agent側でストリーミングを切れるなら切る。切れないならPR #58822の取り込みを待つ |
requiredではtool_callsが返り、autoではDSMLがcontentに漏れる | auto経路のパース(#40801と同系統) | v0.30.0以降で再現するか確かめ、再現するなら生出力を添えて報告する |
どの組み合わせでもtool_callsが無く、contentにDSMLがある | パーサーの設定かバージョン | --tool-call-parserとモデルの組み合わせ、バージョンを見直す |
| どの組み合わせでもDSMLが出ず、普通の文章だけ返る | 生成側かプロンプトの組み立て | 次の節の方法で生出力を確認する |
requiredで直るからといって、agentの設定をrequiredに固定するのはおすすめしません。毎回ツール呼び出しを強制すると、モデルは最後の回答を文章で返せなくなります。あくまで原因を絞るための切り替えです。
構造が最初に消える境界を探す
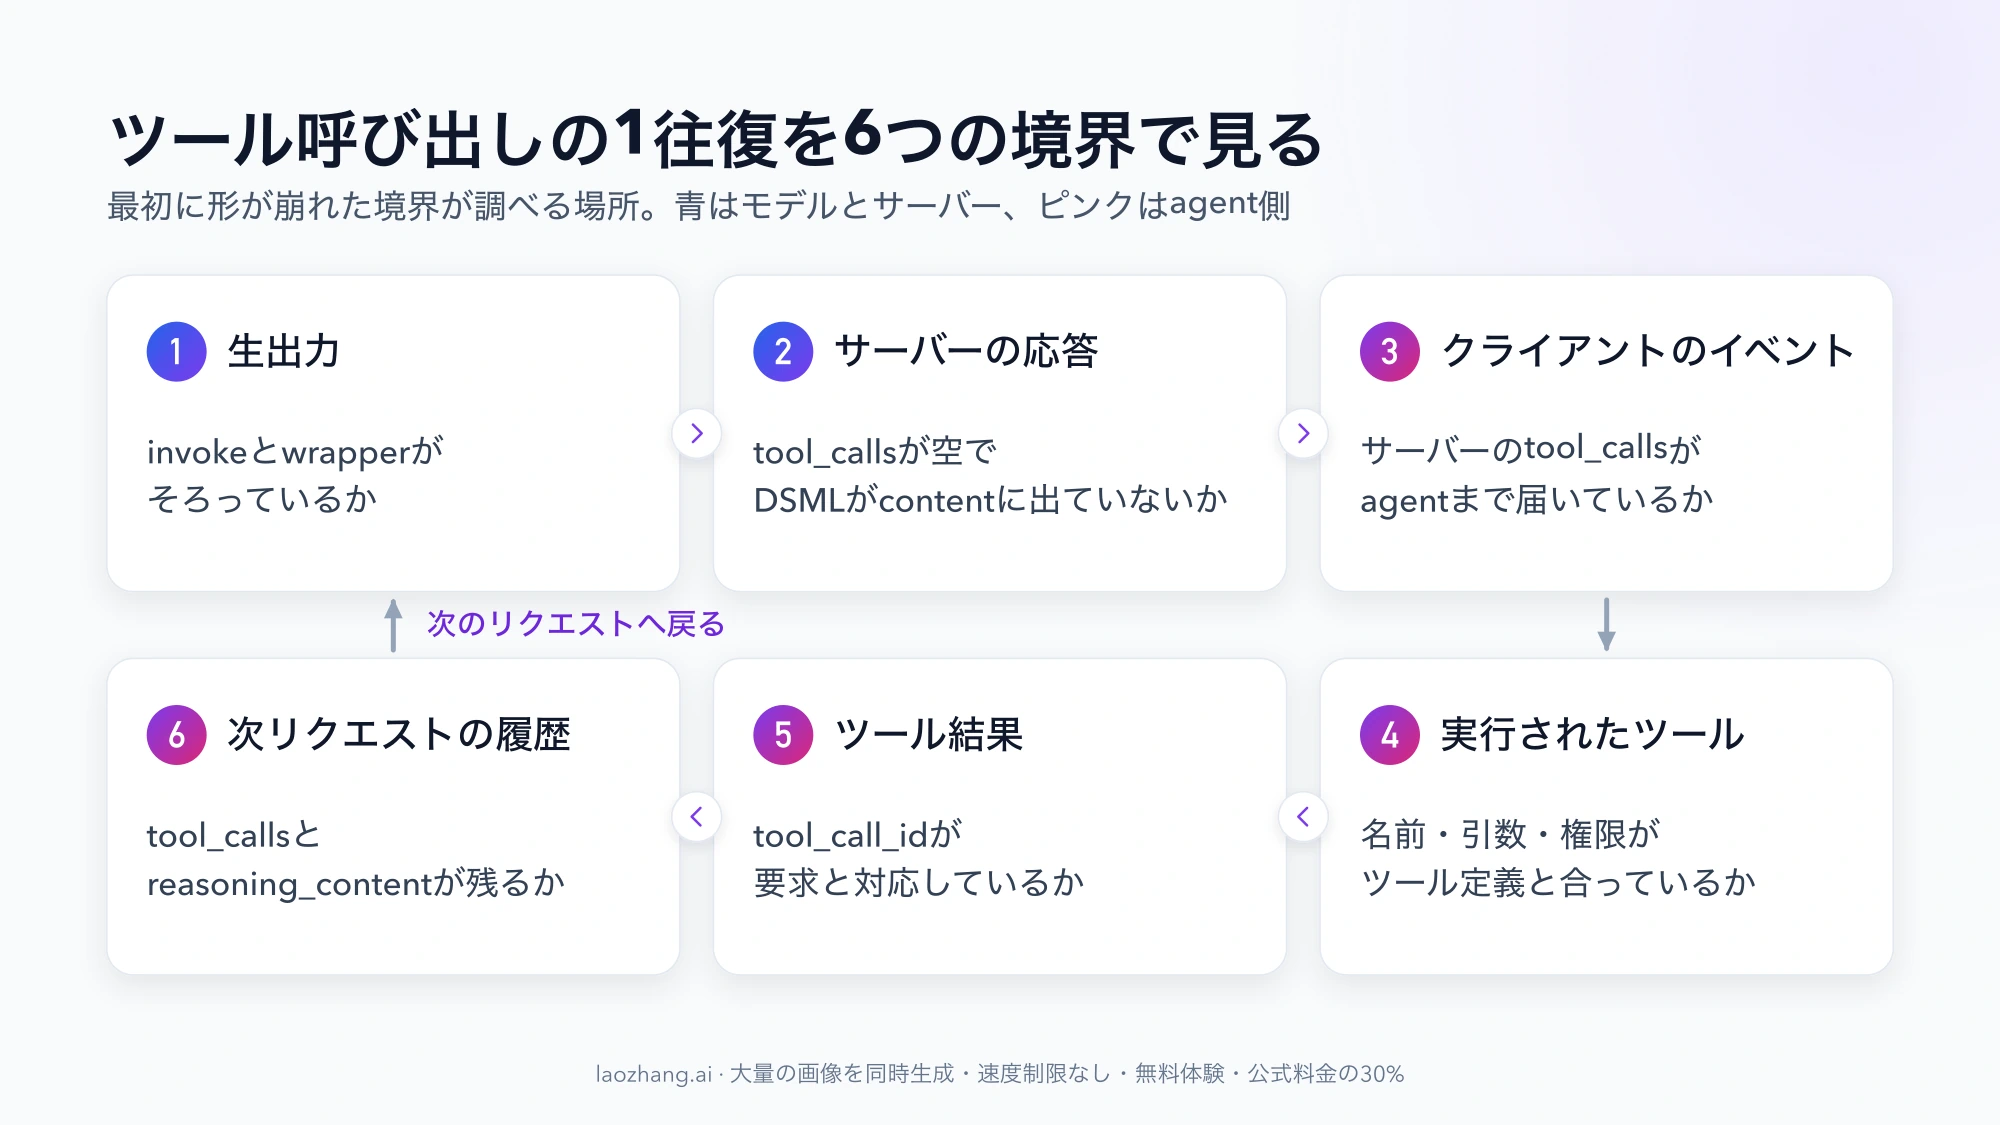
上の比較でも原因が見えないときは、ツール呼び出しの1往復を6つの境界に分け、同じリクエストについてそれぞれの時点の記録を残します。最初に形が崩れた場所が、調べるべき場所です。
| 境界 | 保存するもの | ここで壊れていたら |
|---|---|---|
| 1. 生出力 | パーサーを通る前のテキスト | invokeが無い、wrapperやnameが崩れている。コンテキストを短くし、requiredや公式の重みと比べる |
| 2. サーバーの応答 | /v1/chat/completionsのJSON | 生出力には完全なinvokeがあるのにtool_callsが空。パーサーのバージョンと設定を見る |
| 3. クライアントのイベント | agentやSDKが受け取ったイベント | サーバーはtool_callsを返しているのにagent側に無い。ストリーミングの結合処理やアダプターを見る |
| 4. 実行されたツール要求 | ツール名、引数、許可判定 | 名前の不一致、権限設定、引数のschemaを見る |
| 5. ツール結果 | tool_call_idと結果の中身 | IDの付け替えや欠落を見る |
| 6. 次リクエストの履歴 | 2回目に送ったmessages | assistantのtool_callsやreasoning_contentが抜けていないかを見る |
生出力は、公式のencoding実装でプロンプト文字列を作って/v1/completionsに送ると、パーサーを通らない形で得られます。V4.1-Flashのモデルカードは、同じ形式を扱う保守版としてRust製ライブラリとPythonバインディングのdeepseek-recipeも案内しています。サンプリングの揺れがあるので、トークン単位の一致ではなくDSMLの構造が保たれているかを比べます。
記録がそろったら、最初の2境界は次の程度の判定で十分です。DSMLを直して実行するためのコードではありません。崩れたマークアップを寛容に実行すると、意図しないツールが動く危険があります。
def locate(raw_text: str, message: dict) -> str:
    has_invoke = "<|DSML|invoke" in raw_text
    calls = message.get("tool_calls") or []
    if has_invoke and not calls:
        return "パーサー(境界2)"
    if calls:
        return "クライアント以降(境界3〜6)"
    return "生成またはプロンプトの組み立て(境界1)"
最小のSDKループなら2往復とも成功し、同じエンドポイントにつないだcoding agentだけが失敗するなら、調べる対象は境界3〜6、つまりクライアント側の変換、権限、ツールの振り分け、履歴の組み立てです。モデルや量子化を替えても、この差は説明できません。
量子化やDSparkを疑う条件
公式のV4-Flashの重み自体が、MoEのエキスパートにFP4、ほかの多くにFP8を使う混合精度です。「量子化したからツール呼び出しが壊れる」とひとまとめにはできません。問題になるのは、重みとトークナイザー、エンコード、実行環境の組み合わせが合っているかどうかです。
#41604は、非正規の量子化でscale_fmtのメタデータが無く、モデルの初期化時にKeyErrorで止まるケースでした。これは応答のパースより前、ロードの段階の問題です。モデルが起動して文章を返しているなら、量子化を最初に疑う理由は薄くなります。比べるときはモデルのリビジョン、vLLMのバージョン、起動オプション、サンプリング、コンテキスト、ツール定義を固定し、重みだけを替えます。
DSparkを有効にしている場合は、オンとオフで同じリクエスト群を比べます。#51914はV4-Flash-0731、v0.27.1、DSparkの組み合わせで開始wrapperが<|DSML|toolcalls>に崩れた報告ですが、報告者はDSparkが原因とは断定していません。NVIDIAの開発者フォーラムにも、2026年8月30日付で、spark-vllm環境のV4-Flash-0731でツール呼び出しの閉じタグが回答に漏れるというスレッドがあります。v0.30.0には綴りの崩れたwrapperを許容する#56141が入っていますが、#51914自体は2026年9月30日時点でopenのままです。
公式APIではreasoning_contentを全ターン返す
ローカルではなく公式のDeepSeek APIを使う場合、thinkingモードでtoolsを付けたリクエストには、過去すべてのターンのreasoning_contentを送り返す必要があります(Thinking Modeのドキュメント)。ツールを呼ばなかったターンも含まれ、正しく返さないとAPIは400エラーを返します。toolsを付けないリクエストでは返す必要がなく、送っても無視されます。
2026年8月時点のドキュメントは「ツールを呼んだassistantターンのreasoning_contentを返す」という説明でしたが、現在はtoolsの有無が条件になっています。最も簡単なのは、返ってきたメッセージをそのまま履歴に足す方法です。
messages.append(response.choices[0].message)
# content、reasoning_content、tool_callsがまとめて入るストリーミングではdelta.reasoning_contentを自分で連結し、assistantメッセージのreasoning_contentに入れて返します。履歴を独自に組み立て直すagentが1回目は成功し、2回目で400になるなら、まずこのフィールドの欠落を疑います。ローカルのOpenAI互換サーバーが同じ検証をするとは限らないので、この400は公式APIの規則として扱ってください。
公式APIのツール呼び出しには、ほかに2つの規則があります(Tool Callsのドキュメント)。
- strictモード(Beta):
base_urlをhttps://api.deepseek.com/betaにし、すべての関 数に"strict": trueを付けると、ツール呼び出しの出力が関数のJSON Schemaに従います。対応していないschemaの型はエラーになります。 - 会話の途中へのツール呼び出しの挿入:モデルが生成していないツール呼び出しと結果を履歴の途中に差し込む操作は、Chat Completions APIではできません。Anthropic API(
/messages)かResponses APIを使います。
モデルIDや料金を含む公式APIの使い方は、DeepSeek V4 Pro APIガイド:現行モデル・料金・使い方を参照してください。
vLLMにissueを出す前にそろえる情報
ここまでで直らない場合、vLLMにissueを出すときは次をそろえると、メンテナーがモデル、パーサー、実行環境、agentのどこから見るべきかを判断できます。トークン、実際のパス、社内のコードは伏せます。
- モデルのリポジトリとリビジョン、量子化ファイルの名前とハッシュ
- vLLMのバージョンとイメージのタグ、起動オプション全体、DSparkのオン・オフ
- 秘密情報を除いたリクエスト、生出力、サーバーの応答、次のリクエスト
streamとtool_choiceの4通りの結果、並列数1と本番負荷での違い
よくある質問
issueがclosedなら、手元のバージョンでも直っていますか
そうとは限りません。closedはGitHub上で課題が閉じられたという意味で、修正が入ったリリースは別に確認が要ります。たとえば開始wrapperの欠落を扱う#55954は2026年9月9日にマージされ、リリースノートに出てくるのはv0.30.0(9月22日)です。
SGLangで動かしている場合も、修正状況はvLLMと同じですか
上の表はvLLMのissueとPRの状態で、SGLangの修正状況は含みません。V4.1-FlashのモデルカードにはSGLangでの起動例もありますが、ツール呼び出しが最後まで通るかは別の問題です。6つの境界で切り分ける方法はそのまま使えます。
V4.1-Flashのストリーミングで引数が空になる問題はいつ直りますか
2026年9月30日時点で、修正PR #58822はopenです。マージされたあと、それを含むリリースかnightlyイメージに更新するまでは、非ストリーミングで引数が届くことを確認して使うのが確実です。
ローカルで使うモデルそのものを見直すなら、DeepSeek最新モデル比較 2026:V4 Pro・V4 Flash・Vision Expの選び方と、代替の候補としてQwen3.8-27Bはローカルのエージェント型コーディングに最適かが参考になります。