Qué es Decisions API: GPT-6 Luna elige entre respuestas cerradas
Decisions API es un endpoint de OpenAI, POST /v1/decisions, que recibe texto, imágenes o ambas cosas junto con preguntas que tú defines, y devuelve respuestas tipadas en lugar de texto libre: la probabilidad de que una condición se cumpla, una opción de una lista cerrada o una puntuación sobre una escala. Solo funciona con gpt-6-luna. Está en beta pública desde el 6 de octubre de 2026 (hora de EE. UU.): ese día el changelog de la API de OpenAI anunció su lanzamiento «en beta con gpt-6-luna», y la guía de Decisions prevé la disponibilidad general «en las próximas semanas».
A 10 de octubre de 2026, la situación es esta:
| Pregunta | Respuesta a 10 de octubre de 2026 |
|---|---|
| ¿Puedo usarla con mi clave de API? | Sí. La beta es pública y no hay lista de espera publicada. Puedes probarla sin código en el Playground de Decisions |
| ¿Hay documentación? | Sí: guía, referencia de la API y ejemplos en curl, Python, JavaScript, Go, Ruby y Java |
| ¿Cuánto cuesta? | 0,10 $ por millón de tokens de entrada. Sin cargo por salida ni por lectura o escritura de caché |
| ¿Sale siempre más barata que Luna por la Responses API? | No. Con instrucciones fijas largas que la Responses API puede cachear, Luna sale más barata (cálculo más abajo) |
| ¿Qué falta por publicar? | Fecha y precio de la disponibilidad general, límites de tasa propios y número máximo de preguntas por petición |
Los usos encajan con casi todas las bifurcaciones pequeñas de un producto: clasificar contenido (intención de un ticket, spam, si un texto infringe tus normas), enrutar peticiones (a qué cola, equipo o modelo va cada mensaje), priorizar trabajo o elegir la siguiente acción de un agente. Que acepte imágenes importa si tus entradas son capturas de pantalla o fotos de productos dañados. No redacta nada: si necesitas un objeto JSON propio, campos extraídos o una explicación escrita, la propia guía remite a Structured Outputs con la Responses API.
Beta pública desde el 6 de octubre de 2026: qué ha publicado OpenAI y qué falta
OpenAI la presentó en el DevDay del 29 de septiembre de 2026 como vista previa limitada para clientes seleccionados y la abrió a todos los desarrolladores el 6 de octubre. Desde entonces la guía y la referencia de la API describen el endpoint completo:
| Aspecto | Estado a 10 de octubre de 2026 |
|---|---|
| Endpoint y modelo | POST /v1/decisions, solo con gpt-6-luna |
| SDK | client.decisions.create(...) (en Go, client.Decisions.New). Versiones mínimas: Python 3.26.0, JavaScript 7.30.0, Go 3.73.0, Ruby 0.101.0 y Java 4.78.0 |
| Entrada | Una cadena de texto, o mensajes con rol user que combinan partes input_text e input_image |
| Tipos de pregunta | predicate, choice y score; varias preguntas independientes en la misma petición |
| Salida | Array answers en el orden de las preguntas, cada respuesta con el name que le diste |
| Precio | 0,10 $ por millón de tokens de entrada. Figura en la guía de Decisions, no en la página general de precios |
| Velocidad | OpenAI la describe como «unas 10 veces más rápida que la Responses API», sin publicar cómo lo midió |
| Datos | Zero Data Retention (ZDR) y uso HIPAA para clientes que cumplan los requisitos; residencia de datos y procesamiento regional en EE. UU. y Europa (EEE + Suiza) |
| Sin publicar | Fecha y precio de la GA, límites de tasa propios, máximo de preguntas por petición y si habrá descuento por caché |
La documentación todavía tiene dos cabos sueltos: la página del modelo GPT-6 Luna no incluye v1/decisions en su tabla de endpoints, y la guía y la referencia no coinciden sobre las imágenes por URL (detalle en la sección de límites). Al tratarse de una beta, nombres de campos y tarifas pueden cambiar antes de la GA.
Cuánto cuesta Decisions API: 0,10 $ por millón de tokens, solo de entrada
Decisions API cobra 0,10 $ por cada millón de tokens de entrada y nada más: no hay cargo por tokens de salida ni por lectura o escritura de caché. Sí se aplican el recargo por procesamiento regional y los multiplicadores de contexto largo, y la tarifa vale únicamente para /v1/decisions; cualquier otra llamada a gpt-6-luna paga el precio normal del modelo, según el apartado de precios de la guía.
«Sin cargo por salida» no quiere decir gratis, ni siempre más barato. Por cada decisión pagas:
coste = tokens de entrada × 0,10 $ / 1.000.000
La entrada es todo lo que envías en cada petición: instrucciones, descripciones de las opciones o de los niveles, el texto y las imágenes. Este endpoint no aplica descuento por entrada en caché, así que unas instrucciones fijas de 1.500 tokens se cobran enteras en cada llamada. Las imágenes suman tokens de entrada según su tamaño, en Decisions y en cualquier otra ruta.
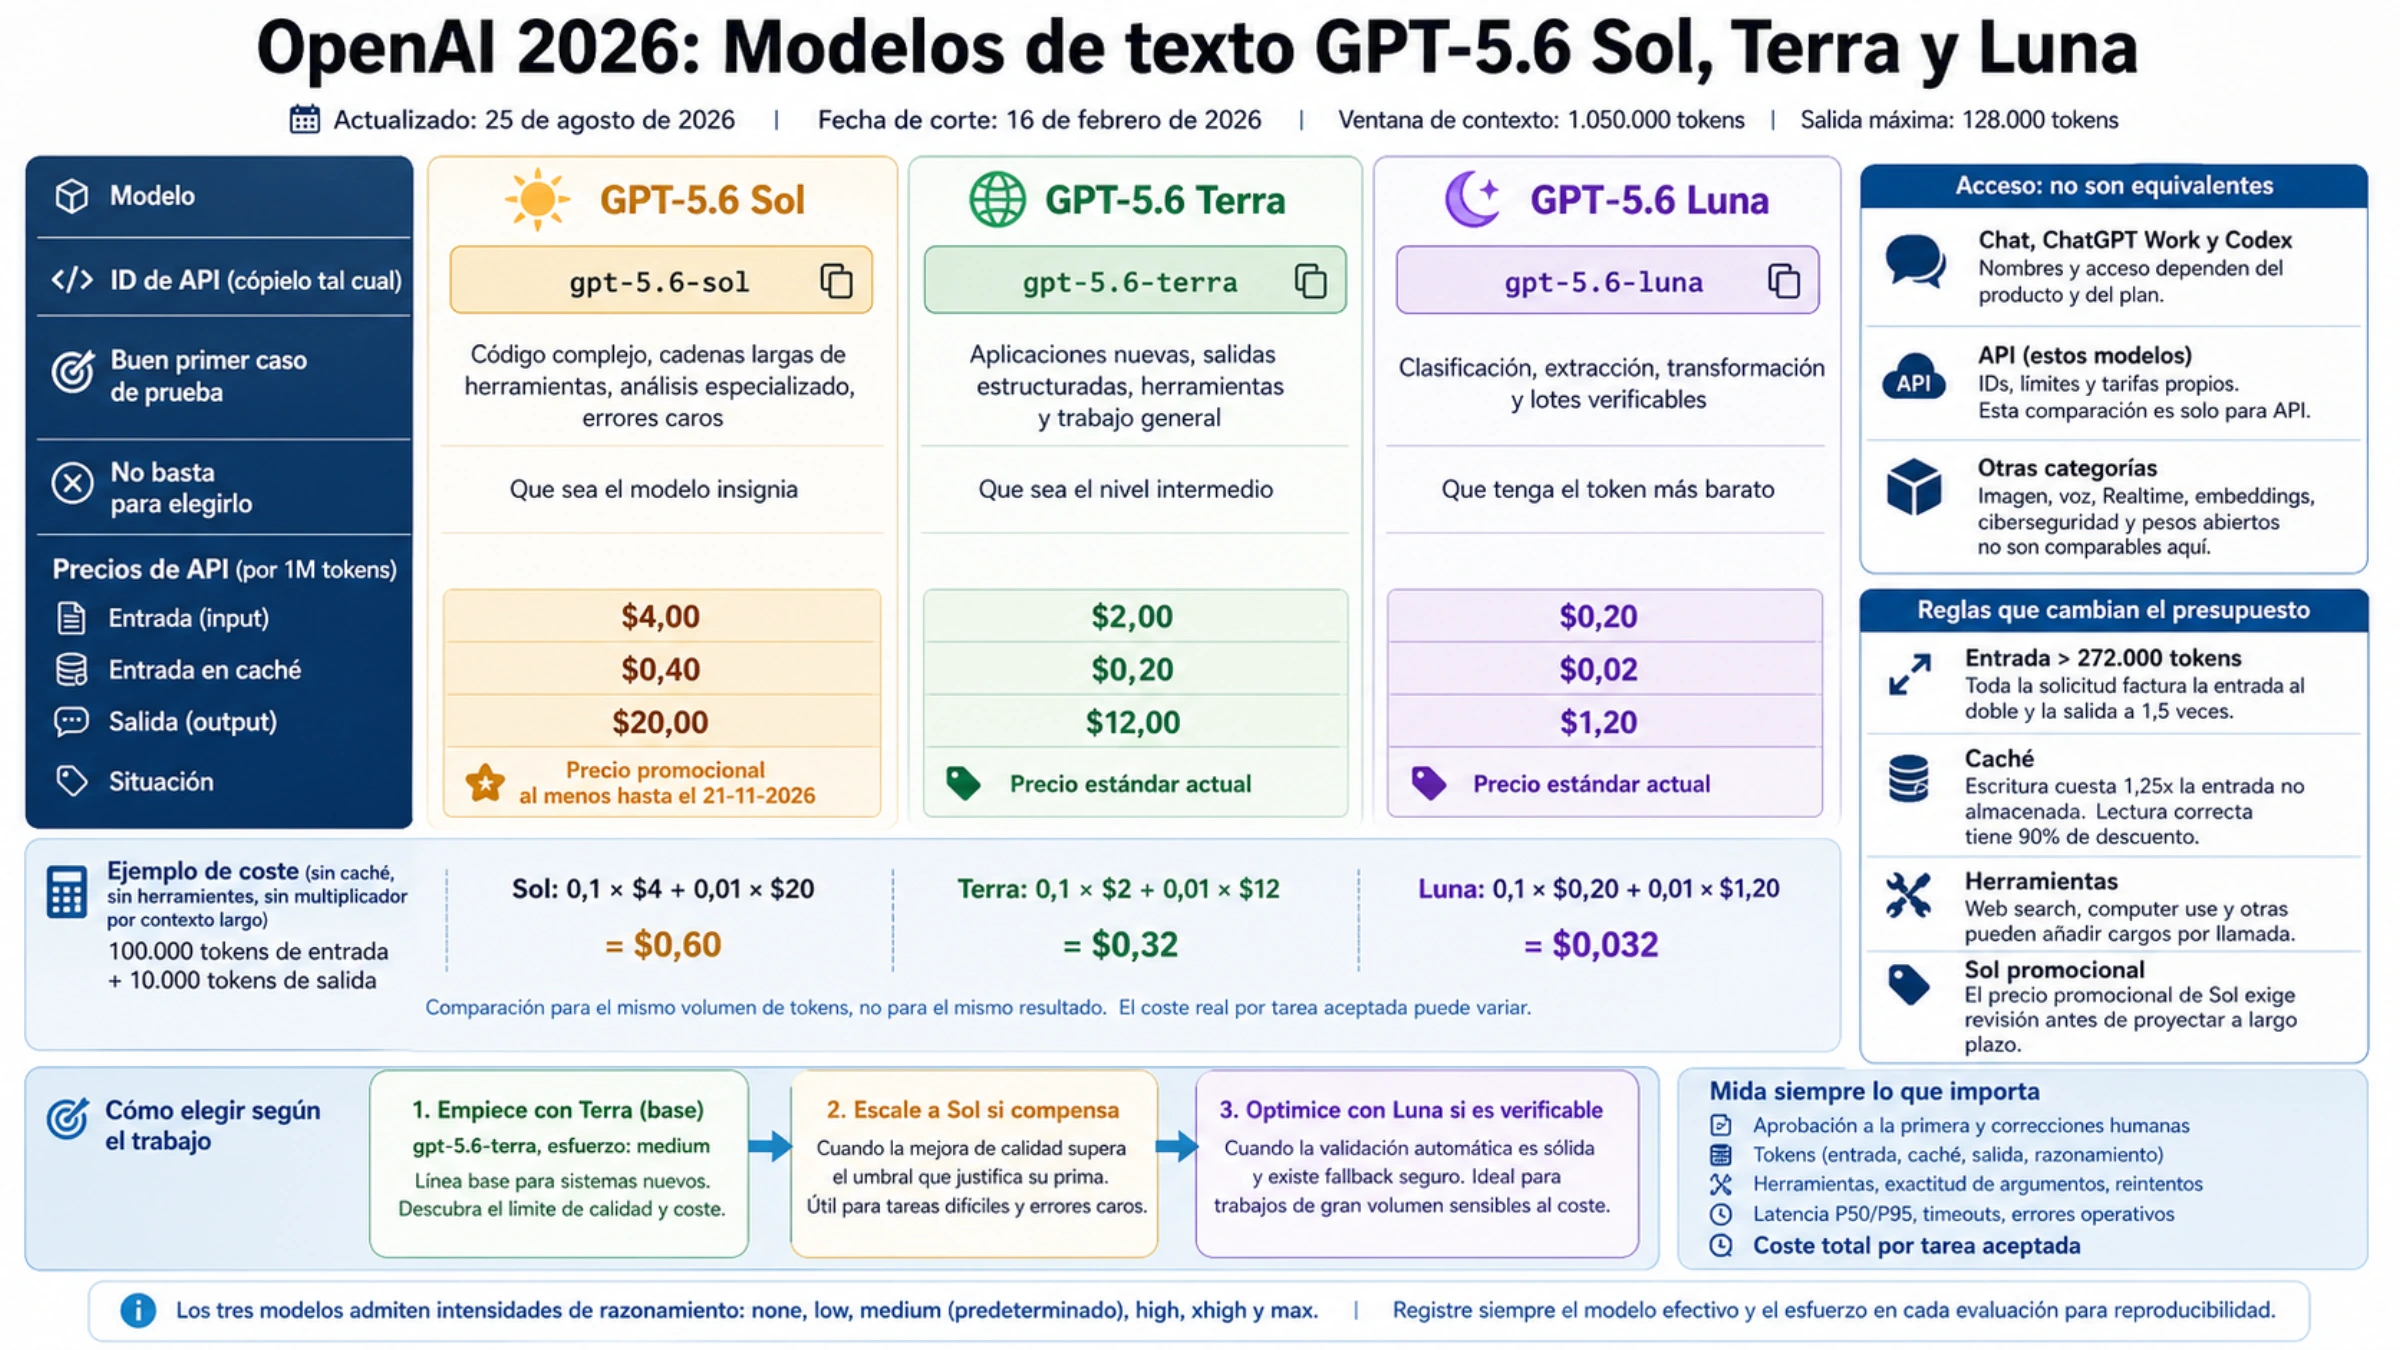
La comparación útil es con lo que seguramente usas hoy: GPT-6 Luna por la Responses API con salida estructurada. Según su página de modelo, en Standard cuesta 0,10 $ por millón de tokens de entrada, 0,01 $ por millón de entrada en caché y 0,50 $ por millón de salida; con razonamiento none no hay tokens de razonamiento. Dos casos con tokens supuestos (sustitúyelos por los que devuelve el campo usage en tus pruebas):
| Caso (tokens de ejemplo) | Decisions API | Luna por la Responses API | Sale más barata |
|---|---|---|---|
| A: 400 tokens de entrada sin caché; Luna devuelve unos 15 de salida | 0,00004 $ por decisión · 0,04 $ por 1.000 · 40 $ por millón | 0,0000475 $ · 0,0475 $ · 47,50 $ | Decisions, un 16 % |
| B: 1.500 tokens de instrucciones fijas + 100 variables; Luna devuelve unos 10 de salida y la caché acierta | 0,00016 $ · 0,16 $ · 160 $ | 0,00003 $ · 0,03 $ · 30 $ | Luna, unas 5,3 veces |
Las cuentas del caso B: en Decisions, 1.600 × 0,10 $ / 1.000.000 = 0,00016 $. En Luna con la caché caliente, (1.500 × 0,01 $ + 100 × 0,10 $ + 10 × 0,50 $) / 1.000.000 = 0,000015 $ + 0,00001 $ + 0,000005 $ = 0,00003 $. Los fallos de caché añaden de vez en cuando escrituras a 0,125 $ por millón, lo que acerca un poco las dos cifras.
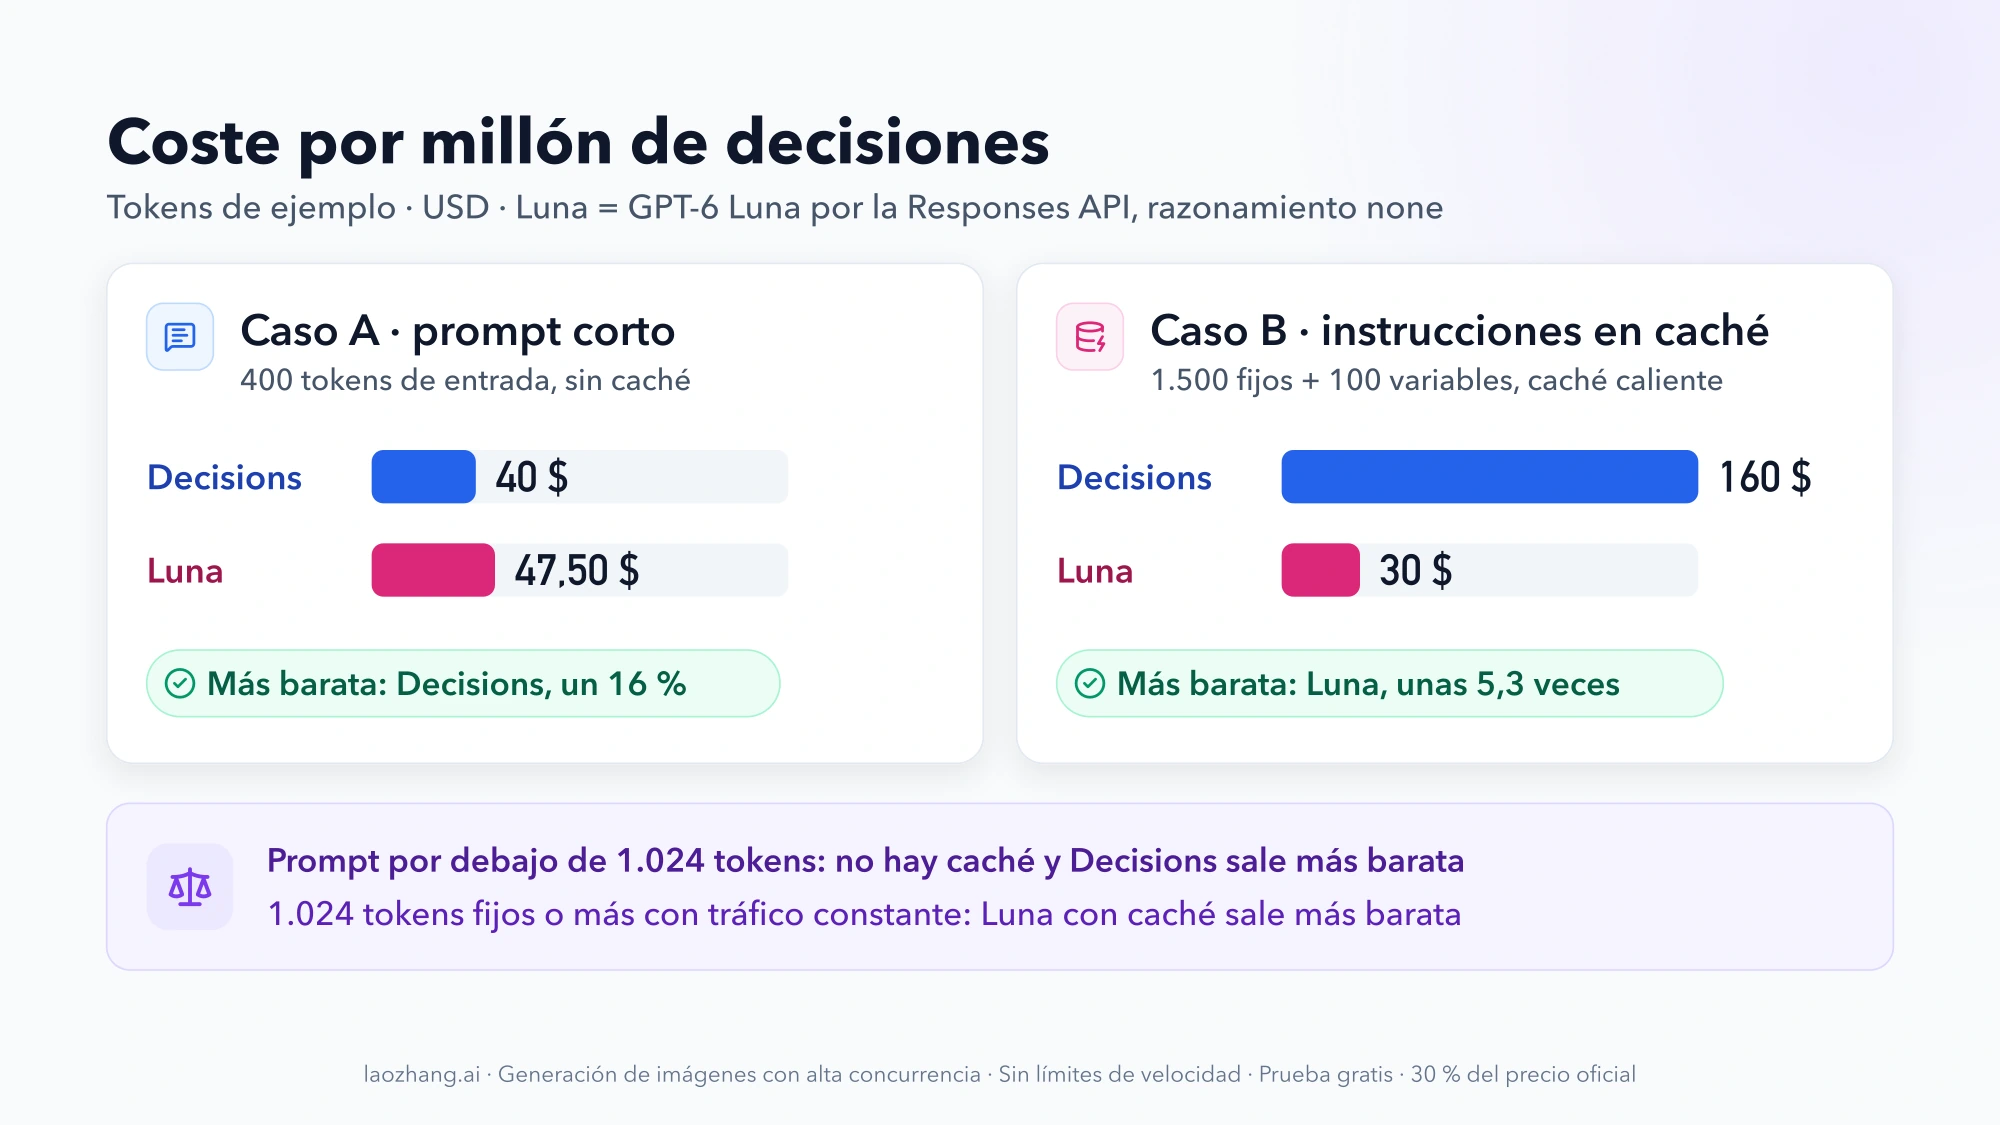
De ahí sale una regla de punto de equilibrio. Si P son los tokens de prefijo fijo que Luna puede cachear y O los tokens de salida, Decisions solo sale más barata mientras 0,09 × P sea menor que 0,50 × O, es decir, mientras P no supere unas 5,6 veces O (unos 83 tokens con 15 de salida). Como la caché de prompts solo actúa con prefijos de al menos 1.024 tokens, la regla práctica queda así:
- Prompt por debajo de 1.024 tokens: no hay caché posible y Decisions sale más barata, porque te ahorras la salida.
- Instrucciones fijas de 1.024 tokens o más y tráfico constante: el prefijo cacheado sigue disponible al menos 30 minutos desde su último uso, la caché acierta y Luna por la Responses API sale más barata.
- Tráfico a ráfagas, con huecos de más de 30 minutos: los fallos de caché acercan las dos rutas; decide con tu
usagereal. - Luna con razonamiento activado: los tokens de razonamiento cuentan como salida, así que O crece y la balanza se inclina hacia Decisions.
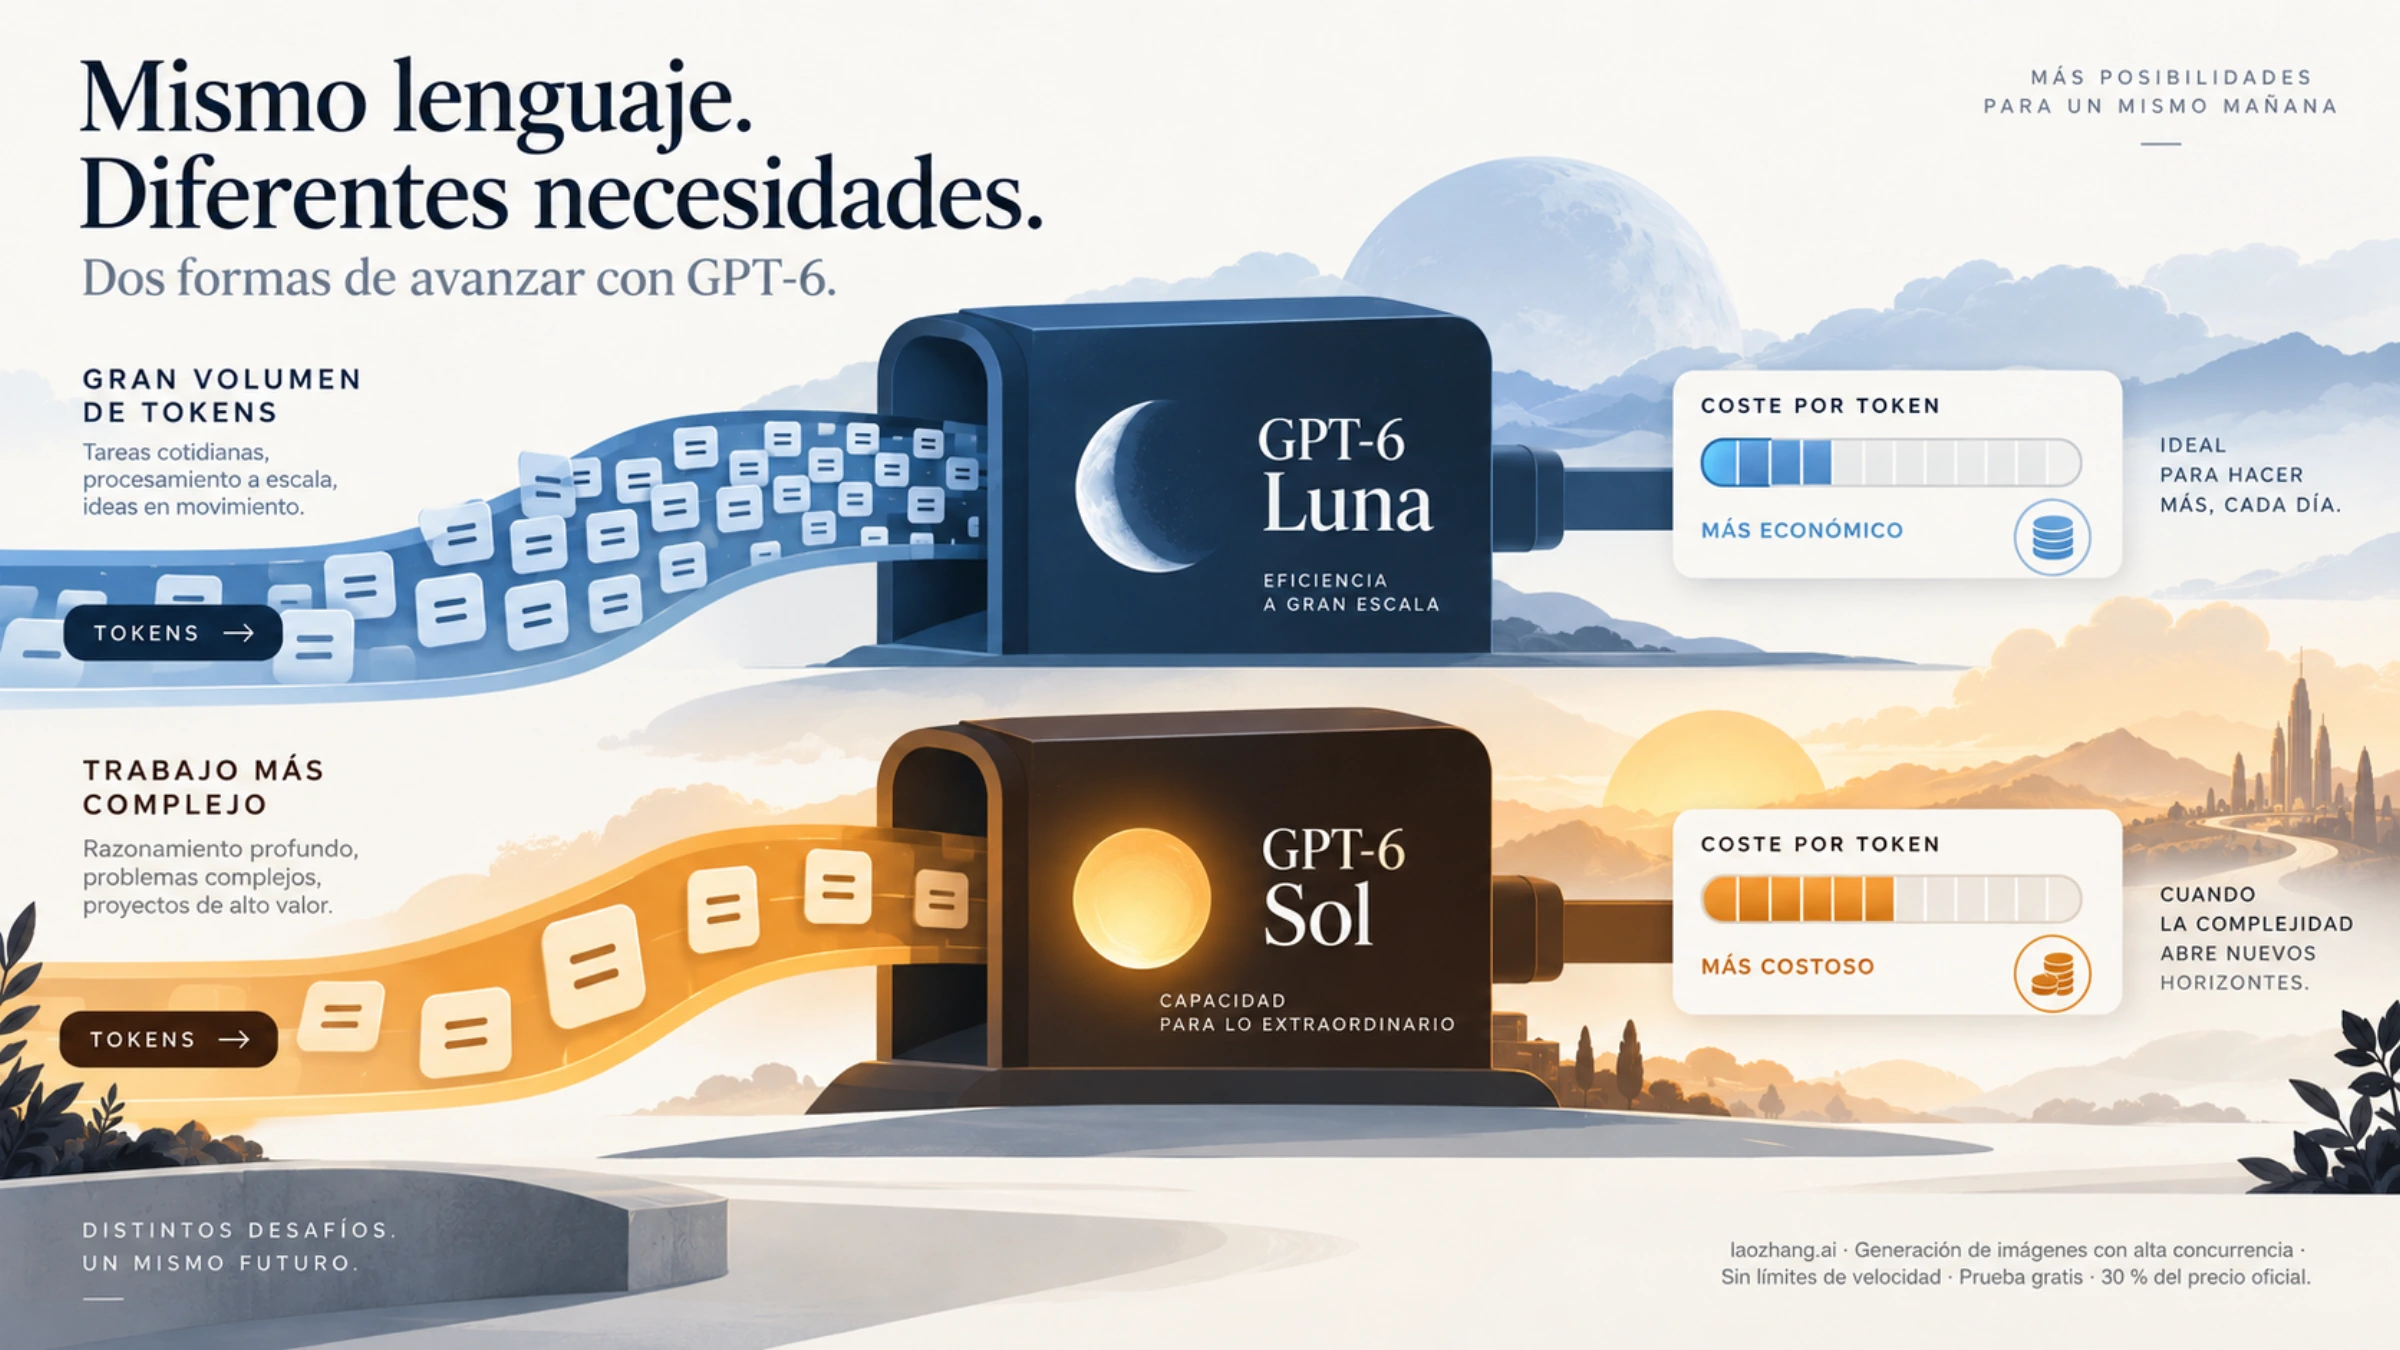
El precio no es lo único: Decisions devuelve probabilidades por opción y responde más rápido, y para muchos clasificadores eso pesa más que unos dólares por millón. Si además te planteas GPT-6 Sol para las decisiones difíciles, GPT-6 Luna vs Sol: precio, coste por tarea y cuál elegir detalla cuándo compensa pagar más por token.
Cómo llamar a POST /v1/decisions: predicate, choice y score
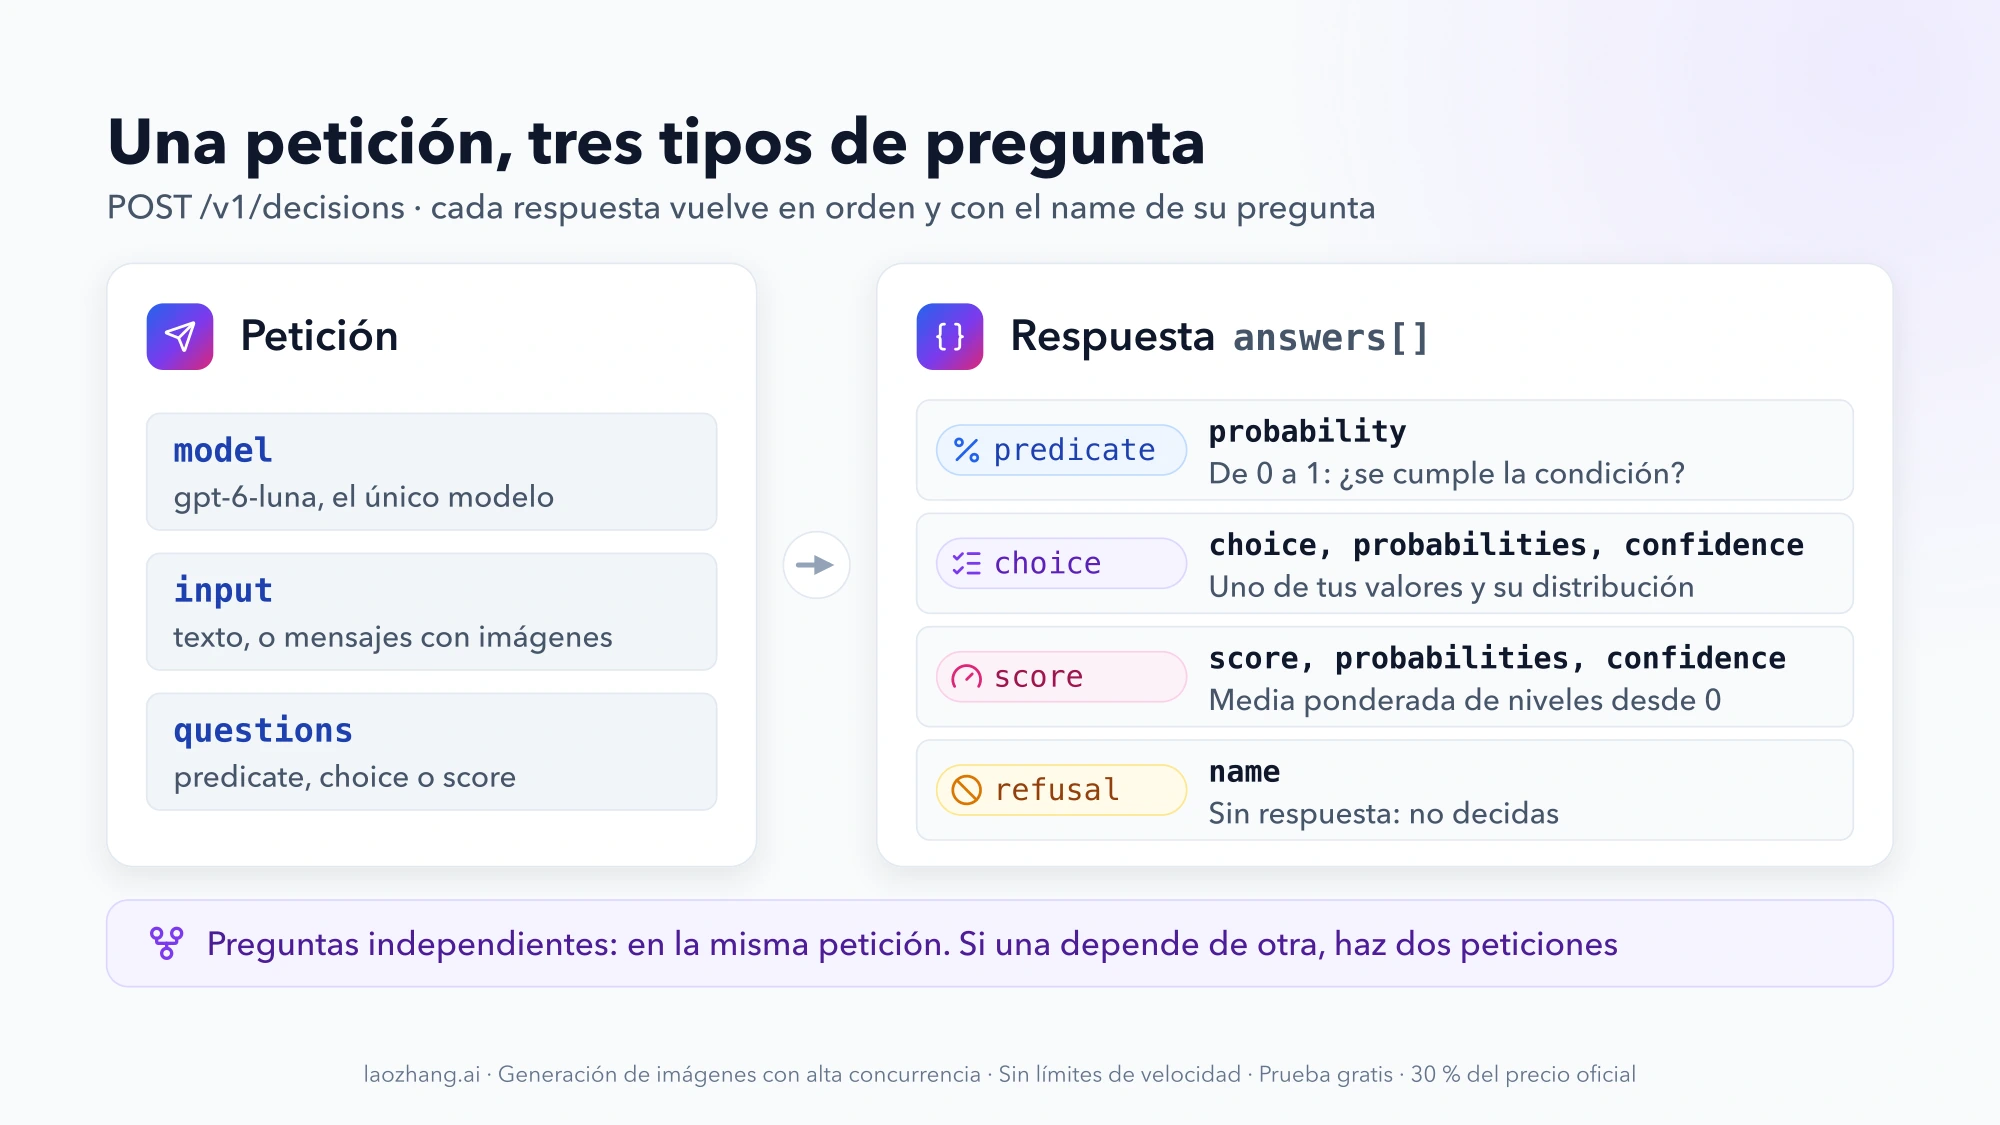
Necesitas una clave de API de OpenAI en la variable OPENAI_API_KEY y el SDK en la versión mínima indicada arriba (en Python, pip install --upgrade openai). Cada petición tiene tres partes: model (gpt-6-luna), input (el texto o las imágenes que comparten todas las preguntas) y questions.
| Tipo | Para qué sirve | Qué devuelve |
|---|---|---|
predicate | Comprobar una condición: ¿hay daños visibles?, ¿el texto es relevante? | probability: estimación de 0 a 1 de que la condición se cumple |
choice | Elegir una opción sin orden: departamento, categoría | choice (uno de tus valores), probabilities por opción y confidence |
score | Valorar sobre niveles ordenados: gravedad, prioridad | score (media de los índices de nivel ponderada por probabilidad, empezando en 0), probabilities por nivel y confidence |
Este ejemplo en Python reproduce la forma de petición del ejemplo de choice de la guía oficial, con un ticket en español. Haz una llamada de prueba con tus propios datos antes de integrarlo:
from openai import OpenAI

client = OpenAI()  # lee OPENAI_API_KEY del entorno

decision = client.decisions.create(
    model="gpt-6-luna",
    input="Me habéis cobrado dos veces el pedido.",
    questions=[
        {
            "type": "choice",
            "name": "departamento",
            "instructions": "¿Qué departamento debe atender esta queja?",
            "choices": [
                {"value": "facturacion", "description": "Pagos, facturas y reembolsos."},
                {"value": "tecnico", "description": "Problemas al usar el producto."},
                {"value": "envios", "description": "Entregas y seguimiento."},
                {"value": "otro", "description": "Peticiones fuera de estas categorías."},
            ],
        }
    ],
)

answer = decision.answers[0]
if answer.type == "refusal":
    print(f"Sin respuesta: {answer.name}")
elif answer.type == "choice":
    print(f"Departamento: {answer.choice} (confidence: {answer.confidence})")
La respuesta tiene esta forma; los números son los del ejemplo ilustrativo de la guía, no una medición:
{
  "answers": [
    {
      "type": "choice",
      "name": "departamento",
      "choice": "facturacion",
      "probabilities": [
        { "value": "facturacion", "probability": 0.95 },
        { "value": "tecnico", "probability": 0.02 },
        { "value": "envios", "probability": 0.01 },
        { "value": "otro", "probability": 0.02 }
      ],
      "confidence": 0.93
    }
  ]
}
Qué significa cada campo:
choicees siempre uno de los valores que enviaste. Los valores tienen tipo: la cadena"true"y el booleanotrueson opciones distintas.probabilitiestrae una entrada por opción (o por nivel, enscore). Es la distribución en la que se basa la respuesta.confidencees un campo aparte que solo devuelvenchoiceyscore. Unpredicateno tieneconfidence: su único número esprobability.scorepuede caer entre dos niveles. En el ejemplo de gravedad de la guía, probabilidades de 0,1, 0,7 y 0,2 sobre tres niveles (0 = estético, 1 = hay alternativa, 2 = bloqueado del todo) dan 0 × 0,1 + 1 × 0,7 + 2 × 0,2 = 1,1. Si necesitas una sola categoría, usachoice.refusal: cualquier pregunta puede volver contype: "refusal"y suname, sin respuesta. Trátala como «no decidir».usagerecoge los tokens de entrada que pagas; es el dato que necesitas para el cálculo de coste.
Para evaluar imágenes, envía un mensaje user con partes input_text e input_image, y la imagen como data URL en base64. Esta petición con curl sigue el ejemplo de predicate de la guía:
IMAGE_BASE64="$(base64 < producto.png | tr -d '\r\n')"

curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  --data-binary @- <<JSON
{
  "model": "gpt-6-luna",
  "input": [{
    "role": "user",
    "content": [
      {"type": "input_text", "text": "Revisa el producto de esta foto."},
      {"type": "input_image", "image_url": "data:image/png;base64,$IMAGE_BASE64"}
    ]
  }],
  "questions": [{
    "type": "predicate",
    "name": "danos_visibles",
    "instructions": "¿Tiene el producto daños visibles, como una grieta, un desgarro o una abolladura? Ignora las sombras y los daños del embalaje."
  }]
}
JSON
Las preguntas independientes sobre la misma entrada, como «¿hay daños?» y «¿de qué categoría es el producto?», van juntas en el array questions, cada una con su tipo. Si una pregunta depende de la respuesta de otra, haz dos peticiones. Para identificar al usuario final sin enviar datos personales tienes el campo opcional safety_identifier, de hasta 128 caracteres.
Límites de Decisions API: 255 opciones, 128 imágenes y rate limits sin publicar
| Límite | Valor a 10 de octubre de 2026 |
|---|---|
Opciones por pregunta choice | Entre 2 y 255, sin repetir; cada valor es una cadena o un booleano |
| Imágenes | Hasta 128 por petición, sumando todos los mensajes; detail admite low, high, auto u original |
| Formato de imagen | Data URL en base64. La guía no admite URL alojadas; la referencia sí acepta URL HTTP(S) públicas |
| Roles y tipos de entrada | Solo el rol user. Sin archivos, audio, herramientas, llamadas a funciones ni referencias a elementos; no acepta file ID |
Preguntas por petición y niveles por score | Sin máximo publicado |
| Límites de tasa (RPM y TPM) | Sin publicar para Decisions; los tuyos aparecen en Settings > Organization > Limits |
| Acceso desde el nivel Free | No especificado |
| Controles de datos | ZDR y HIPAA para clientes que cumplan los requisitos; residencia de datos en EE. UU. y Europa (EEE + Suiza), con recargo por procesamiento regional |
Tres notas que evitan errores:
- Imágenes en base64. Es el formato que funciona según los dos documentos; las URL alojadas solo aparecen en la referencia. Hasta que coincidan, no cuentes con ellas.
- No tomes los límites de Luna como límites de Decisions. El 6 de octubre OpenAI simplificó los niveles de uso a Free, Build, Launch y Grow, y Luna en Standard tiene, por ejemplo, 5.000 RPM y 2 millones de TPM en Build, 10.000 RPM en Launch y 30.000 RPM en Grow. La documentación no dice que esas cifras valgan para
/v1/decisions. El antiguo «Tier 1: 500 RPM» ya no existe. - Actualiza el SDK. Las versiones anteriores a las mínimas no tienen
client.decisionsy la llamada falla antes de llegar a la API.
Error 403 «Decision API is not enabled for this user»: qué significa
Era el filtro de la vista previa limitada. El 1 y el 2 de octubre de 2026, antes de la beta pública, eesel recibió un HTTP 403 con el mensaje Decision API is not enabled for this user. al llamar a POST https://api.openai.com/v1/decisions con una clave estándar, mientras que rutas vecinas como /v1/decisions/create devolvían 404. La ruta existía, pero solo respondía a las cuentas incluidas en la vista previa.
Desde la apertura del 6 de octubre no hay informes públicos de ese 403: ni las pruebas de classmethod ni los usuarios que probaron el endpoint en el hilo de la beta pública del foro de OpenAI mencionan errores de acceso. OpenAI no documenta ese mensaje, así que si te aparece ahora, revisa por este orden (son deducciones, no causas oficiales):
- Que tu SDK cumple la versión mínima y que la petición va a
/v1/decisions, no a otra ruta. - Que el modelo es exactamente
gpt-6-luna. - Que tu organización o proyecto no tiene restringidos modelos o endpoints en su configuración.
Cuándo pasarte a Decisions API desde un enum estricto con Luna
Pásate si tu clasificador usa prompts cortos, si necesitas probabilidades para fijar umbrales o si la latencia te importa. Quédate con Luna por la Responses API si tus instrucciones fijas superan los 1.024 tokens y la caché acierta, si necesitas una explicación o un JSON propio, o si accedes a Luna a través de un proveedor que no ofrece Decisions.
| Tu caso | Qué te conviene |
|---|---|
| Prompt corto (menos de 1.024 tokens) y una etiqueta como salida | Decisions: más barata y más rápida |
| Instrucciones largas y fijas con tráfico constante | Luna por la Responses API con caché, salvo que la latencia pese más que el coste |
| Quieres enrutar por umbrales con una probabilidad por opción | Decisions (probabilities, confidence), calibrando con tus datos |
| Entradas con capturas o fotos | Las dos sirven; Decisions acepta hasta 128 imágenes por petición |
| Necesitas el motivo, campos extraídos o llamar a herramientas | Structured Outputs o function calling con la Responses API |
| Chat en directo o agente que toma muchas decisiones por tarea | Decisions, midiendo la latencia desde tu región |
Sobre la velocidad, OpenAI promete respuestas «unas 10 veces más rápidas» sin publicar la prueba. Las mediciones de terceros, hechas en condiciones distintas, dan una idea orientativa: classmethod obtuvo medianas de 273 ms con el ejemplo de choice (145 tokens de entrada) y 256 ms con el de score, en 5 ejecuciones con curl; un usuario del foro de OpenAI, unos 0,8 s con imágenes en una conexión de unos 3 Mbps; y en la prueba de eesel anterior a la beta, Luna con enum estricto y razonamiento none tardaba una mediana de 1,46 s. La cifra de «150 ms» procede de la prensa y de la presentación, no de la documentación. En un agente que toma 20 decisiones por tarea, pasar de 1,46 s a unos 0,27 s por decisión supone esperar unos 5 s en lugar de unos 29 s.
Si decides migrar, hazlo en este orden:
- Aísla la decisión en una función, como
decidir()en la sección siguiente, para que el resto del código no sepa qué motor responde. - Convierte tu enum en
choices: un valor por opción, con unadescriptionque explique cuándo aplica, y mantén una opción de escape comootroorevision; la guía recomienda incluirla cuando tus categorías no cubren todas las entradas. - Decide qué hace la opción
no_seguro. Puedes mantenerla como opción o sustituirla por un umbral sobreconfidenceoprobabilities, pero solo con un umbral fijado sobre ejemplos etiquetados. - Lanza la misma muestra etiquetada contra los dos motores y compara acierto, latencia y el coste calculado con el
usagede cada respuesta. - Cambia con un interruptor y conserva Luna como respaldo mientras dure la beta.
Cómo montar la misma decisión con GPT-6 Luna y un enum estricto
Esta ruta sigue siendo la adecuada cuando la caché la hace más barata, cuando necesitas Chat Completions o un proveedor compatible con OpenAI, y como respaldo durante la beta. GPT-6 Luna (gpt-6-luna) admite entrada de imágenes, Structured Outputs y reasoning.effort desde none hasta max, y funciona en Responses, Chat Completions y Batch, según su página de modelo. Con Structured Outputs en la Responses API, text.format de tipo json_schema y strict: true obliga a que la salida cumpla tu esquema; si ese esquema tiene un único campo con enum, la respuesta solo puede ser una de tus opciones (guía de Structured Outputs).
Necesitas Python 3.10 o superior, pip install openai y la variable de entorno OPENAI_API_KEY. El código sigue la forma documentada en las guías; haz una llamada de prueba con tus propios datos antes de ponerlo en producción.
import json
from openai import OpenAI

client = OpenAI()  # lee OPENAI_API_KEY del entorno

NO_SEGURO = "no_seguro"


def decidir(contexto: str, pregunta: str, opciones: list[str],
            imagen_url: str | None = None) -> str:
    """Devuelve exactamente una de `opciones` o NO_SEGURO.

    Usa GPT-6 Luna con Structured Outputs. Para pasar a Decisions API
    solo cambia el interior de esta función.
    """
    permitidas = opciones + [NO_SEGURO]

    contenido = [{"type": "input_text", "text": contexto}]
    if imagen_url:
        contenido.append({"type": "input_image", "image_url": imagen_url})

    respuesta = client.responses.create(
        model="gpt-6-luna",
        reasoning={"effort": "none"},
        input=[
            {
                "role": "developer",
                "content": (
                    f"{pregunta} Elige solo una opción. Si el contenido no "
                    f"permite decidir con seguridad, elige {NO_SEGURO}."
                ),
            },
            {"role": "user", "content": contenido},
        ],
        text={
            "format": {
                "type": "json_schema",
                "name": "decision",
                "strict": True,
                "schema": {
                    "type": "object",
                    "properties": {
                        "opcion": {"type": "string", "enum": permitidas}
                    },
                    "required": ["opcion"],
                    "additionalProperties": False,
                },
            }
        },
    )

    try:
        return json.loads(respuesta.output_text)["opcion"]
    except (json.JSONDecodeError, KeyError):
        # Negativa del modelo o respuesta incompleta: no actúes
        return NO_SEGURO


cola = decidir(
    contexto="Me habéis cobrado dos veces el pedido 4471.",
    pregunta="¿A qué cola debe ir este ticket?",
    opciones=["facturacion", "envios", "tecnico", "otro"],
)
print(cola)
Cuatro detalles hacen que este patrón aguante en producción:
- La opción
no_segurova siempre en la lista. La guía advierte de que el modelo intenta ajustarse al esquema incluso cuando la entrada no tiene nada que ver, y eso puede producir respuestas inventadas. Darle una salida explícita es más fiable que esperar a que se niegue. - Las reglas del esquema no son opcionales: con
strict: true, todos los campos van enrequiredy cada objeto necesitaadditionalProperties: false. Un esquema admite hasta 1.000 valores de enum en total. reasoning.effortennoneevita tokens de razonamiento y da la menor latencia. Súbelo alowsolo si tus datos de prueba muestran errores, y vuelve a medir latencia y coste.- La función es la frontera. El resto de tu código solo conoce
decidir(). Para probar Decisions API, reescribes ese interior, comparas con la misma muestra y cambias sin tocar la lógica que actúa sobre la respuesta.
Así quedaría el interior con Decisions API para entradas de texto, con la misma forma de petición que el ejemplo de choice anterior. El umbral de 0,8 es solo un ejemplo; fíjalo con tus datos:
def decidir_con_decisions(contexto: str, pregunta: str,
                          opciones: list[str], umbral: float = 0.8) -> str:
    decision = client.decisions.create(
        model="gpt-6-luna",
        input=contexto,
        questions=[
            {
                "type": "choice",
                "name": "decision",
                "instructions": pregunta,
                "choices": [{"value": o} for o in opciones + ["otro"]],
            }
        ],
    )
    answer = decision.answers[0]
    if answer.type != "choice" or answer.confidence < umbral:
        return NO_SEGURO  # rechazo o poca confianza: a revisión
    return answer.choice
Si llamas a Luna con Chat Completions, el mismo esquema va en response_format:
respuesta = client.chat.completions.create(
    model="gpt-6-luna",
    reasoning_effort="none",
    messages=[
        {"role": "developer", "content": "¿A qué cola debe ir este ticket? ..."},
        {"role": "user", "content": "Me habéis cobrado dos veces el pedido 4471."},
    ],
    response_format={
        "type": "json_schema",
        "json_schema": {"name": "decision", "strict": True, "schema": esquema},
    },
)
opcion = json.loads(respuesta.choices[0].message.content)["opcion"]
Aquí esquema es el mismo diccionario del primer bloque. Esta variante es la que conviene si accedes a Luna a través de un proveedor compatible con OpenAI en lugar de la API oficial, por ejemplo laozhang.ai, cuyo catálogo de modelos lista gpt-6-luna a 0,10 $ y 0,50 $ por millón de tokens de entrada y salida (con base_url="https://api.laozhang.ai/v1" en el cliente). Ese catálogo no incluye Decisions API, solo el modelo Luna, y antes de depender de él conviene comprobar con una llamada que respeta el esquema estricto. Si quieres Decisions a través de un gateway, Vercel AI Gateway (openai/gpt-6-luna-decisions) y OpenRouter ya la listan con su propio formato de llamada, distinto del de /v1/decisions.
Etiqueta válida no es etiqueta correcta: dónde poner la revisión humana
Ni el enum estricto ni Decisions API garantizan que la respuesta sea la acertada: garantizan que sea una de tus opciones. La propia guía de Structured Outputs avisa de que las salidas estructuradas «pueden seguir conteniendo errores».
La prueba de eesel lo ilustra con 20 tickets de soporte y 160 llamadas en total. Luna eligió la cola correcta en 40 de 40 casos, pero a la pregunta «¿se puede responder automáticamente a este ticket?» acertó 33 de 40 sin razonamiento. Es una muestra pequeña de un proveedor que vende una herramienta de soporte, pero señala dónde está el riesgo: enrutar es la decisión fácil; saber cuándo no actuar es la difícil.
Las probabilidades de Decisions ayudan, pero no las tomes al pie de la letra. En las pruebas de classmethod, el ejemplo de choice que la guía muestra con 0,95 y confidence 0,93 devolvió 1,0 y 1,0 en las cinco ejecuciones. Un usuario del foro de OpenAI probó una moneda trucada que sale cara el 70 % de las veces: el predicate dio cerca de un 70 %, mientras que choice dio alrededor de un 98 % y cambiaba según el orden de las opciones. Son pruebas pequeñas, pero apuntan en la misma dirección que la guía: fija los umbrales con ejemplos etiquetados de tu aplicación, según lo que te cueste un falso positivo o un falso negativo, y usa predicate cuando lo que necesitas es una probabilidad bien calibrada.
Reparte las decisiones según lo que cuesta un error:
| Lo que provoca la decisión | Cómo tratarla |
|---|---|
| Etiquetar, enrutar, priorizar (un error cuesta minutos) | Automatiza. Revisa una muestra cada semana |
| Enviar un mensaje al cliente, cobrar, reembolsar, borrar o modificar datos | Solo actúa con las opciones que lo autorizan de forma explícita y por encima de un umbral calibrado; no_seguro, otro y los casos dudosos van a una persona |
| Moderación con consecuencias para el usuario (bloqueos, suspensiones) | Usa la decisión como filtro previo y deja la sanción final a revisión humana |
Guarda en un registro cada entrada, la opción elegida, las probabilidades si las hay, el motor, el esfuerzo de razonamiento y la latencia. Ese registro es lo que te permite comparar Luna y Decisions API con la misma muestra y ajustar umbrales cuando cambie el tráfico.
Preguntas frecuentes sobre Decisions API de OpenAI
¿Cuándo estará disponible Decisions API para todos?
Ya lo está, en beta pública desde el 6 de octubre de 2026 (hora de EE. UU.), para cualquier desarrollador con una clave de la API de OpenAI. La disponibilidad general (GA) está prevista «en las próximas semanas», sin fecha ni precio de GA anunciados. La documentación no aclara si las cuentas en el nivel Free pueden llamarla.
¿Qué aporta Decisions API frente a Structured Outputs?
Respuestas tipadas con probabilidades (probability, probabilities, confidence, score), más velocidad según OpenAI y un precio que solo cuenta la entrada. Structured Outputs sigue siendo lo indicado cuando necesitas un objeto con tu propio esquema JSON, campos extraídos o una explicación, y además se beneficia de la caché, lo que lo abarata con instrucciones largas.
¿Decisions API es la respuesta de OpenAI a Jev?
Se presentó dos semanas después de Jev, el modelo de decisiones de TypeSafe AI lanzado el 15 de septiembre de 2026, y casi toda la cobertura los compara. Las pruebas de terceros no dan un ganador claro: classmethod midió latencias parecidas (255 ms frente a 238 ms de Jev) y un coste por petición mayor en Decisions; un usuario del foro de OpenAI vio a Jev más preciso en juicios ambiguos y a Luna a la par en comprobaciones simples. La diferencia clara es que Decisions acepta imágenes, mientras que Jev solo texto, y que funciona dentro de la plataforma de OpenAI, con ZDR, HIPAA y residencia de datos.
¿Puedo acceder a Decisions API desde España?
Sí. España está en la lista de países admitidos por la API de OpenAI, y la beta pública no tiene restricciones por país documentadas. Si necesitas que los datos se procesen en Europa, Decisions admite residencia de datos en el EEE y Suiza para clientes que cumplan los requisitos, con el recargo por procesamiento regional; en la página de Luna ese recargo es del 10 %.
¿Puedo usar Decisions API a través de OpenRouter o Vercel AI Gateway?
Los dos la listan: Vercel AI Gateway con el modelo openai/gpt-6-luna-decisions a 0,10 $ por millón de tokens de entrada, y OpenRouter como «GPT-6 Luna Decisions» al mismo precio de entrada y 0 $ por la salida. Cada gateway usa su propio formato de llamada, distinto del de /v1/decisions, así que el código de esta página no vale tal cual. Los proveedores compatibles con OpenAI que solo ofrecen el modelo gpt-6-luna, como laozhang.ai, sirven para la alternativa con enum estricto, no para Decisions.