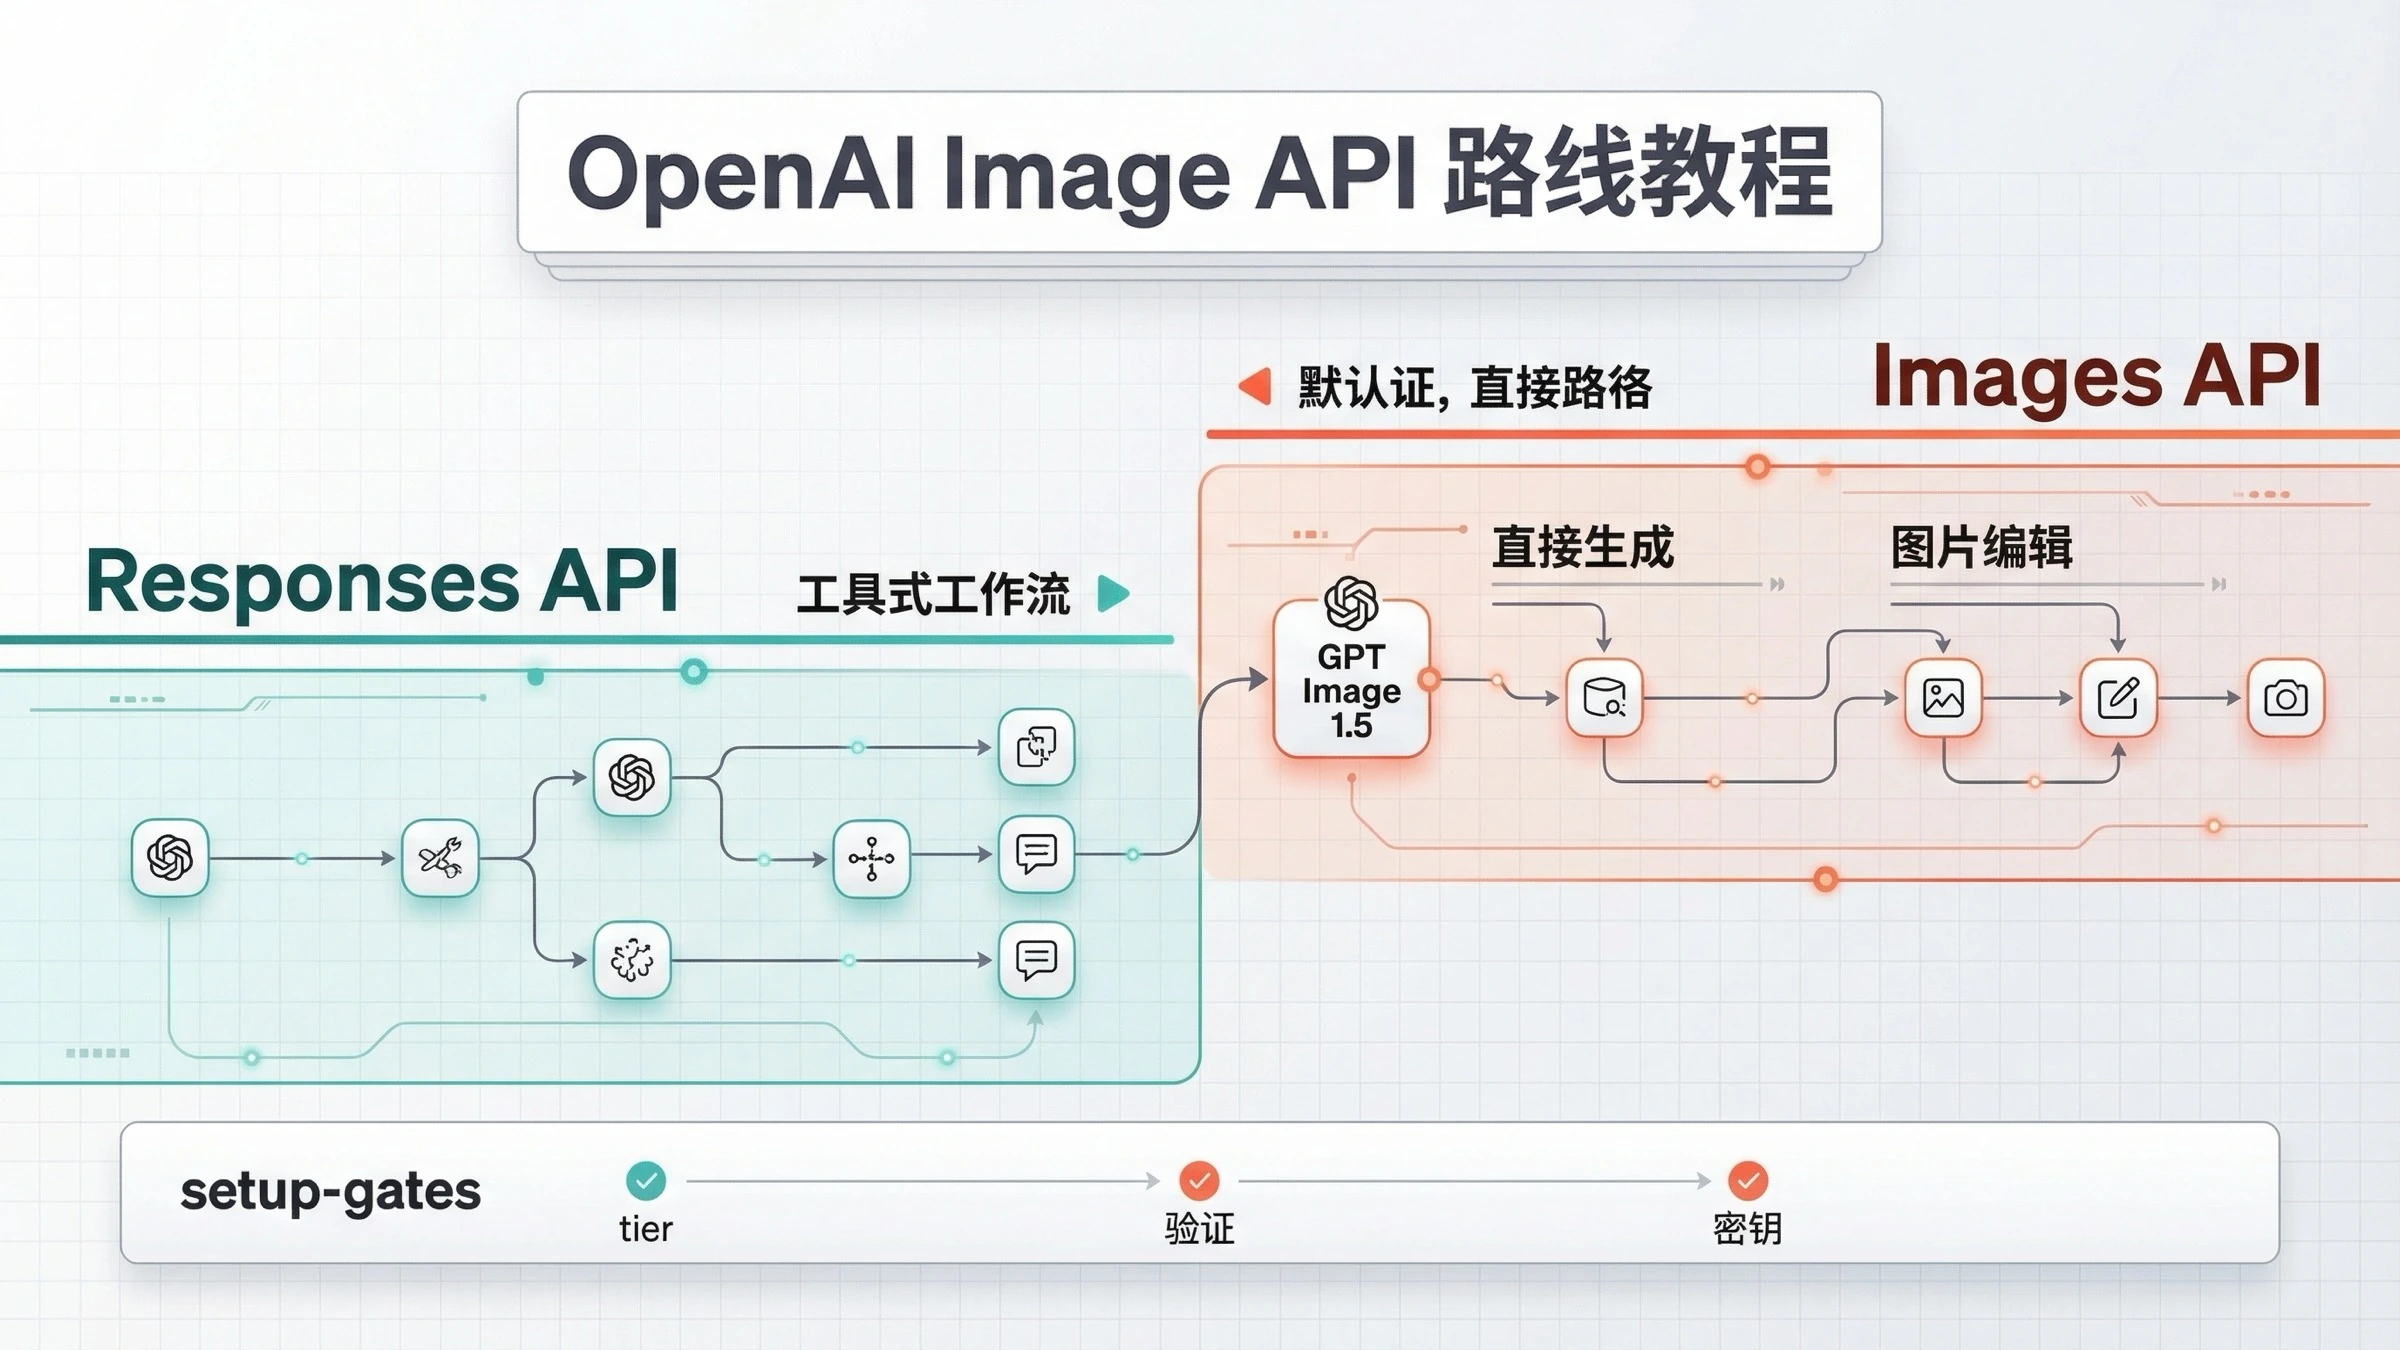
截至 2026 年 10 月 9 日,OpenAI 公开的图片生成接口只有两个:POST https://api.openai.com/v1/images/generations 按提示词出图,POST /v1/images/edits 基于已有图片改图;原来的 /v1/images/variations 已经停用。model 填 gpt-image-2.5-sunburst(编辑精度优先)或 gpt-image-2.5-flare(日常快速出图),图片只会以 base64 写在响应体里,需要你自己解码保存。只有当图片生成是对话或多步流程中的一个环节时,才改用 Responses API 的 image_generation 工具。
另一类人到这里是因为手里只有 ChatGPT 对话或导出数据里的 gen_id、parent_gen_id、referenced_image_ids 或 asset_pointer,想找一个接口把那张图下载下来。答案是没有这样的接口:这些是 ChatGPT 产品内部的字段,OpenAI 公开 API 里没有任何接口接受它们,Images API 也没有按 ID 取图的 GET 接口。图片本体在 ChatGPT 的对话和图库里,能走的路线是界面下载、申请数据导出,或者用 API 重新生成并自己保存。第二节逐字段说明。
当前 OpenAI 图片接口路线:generations、edits 与 Responses 工具
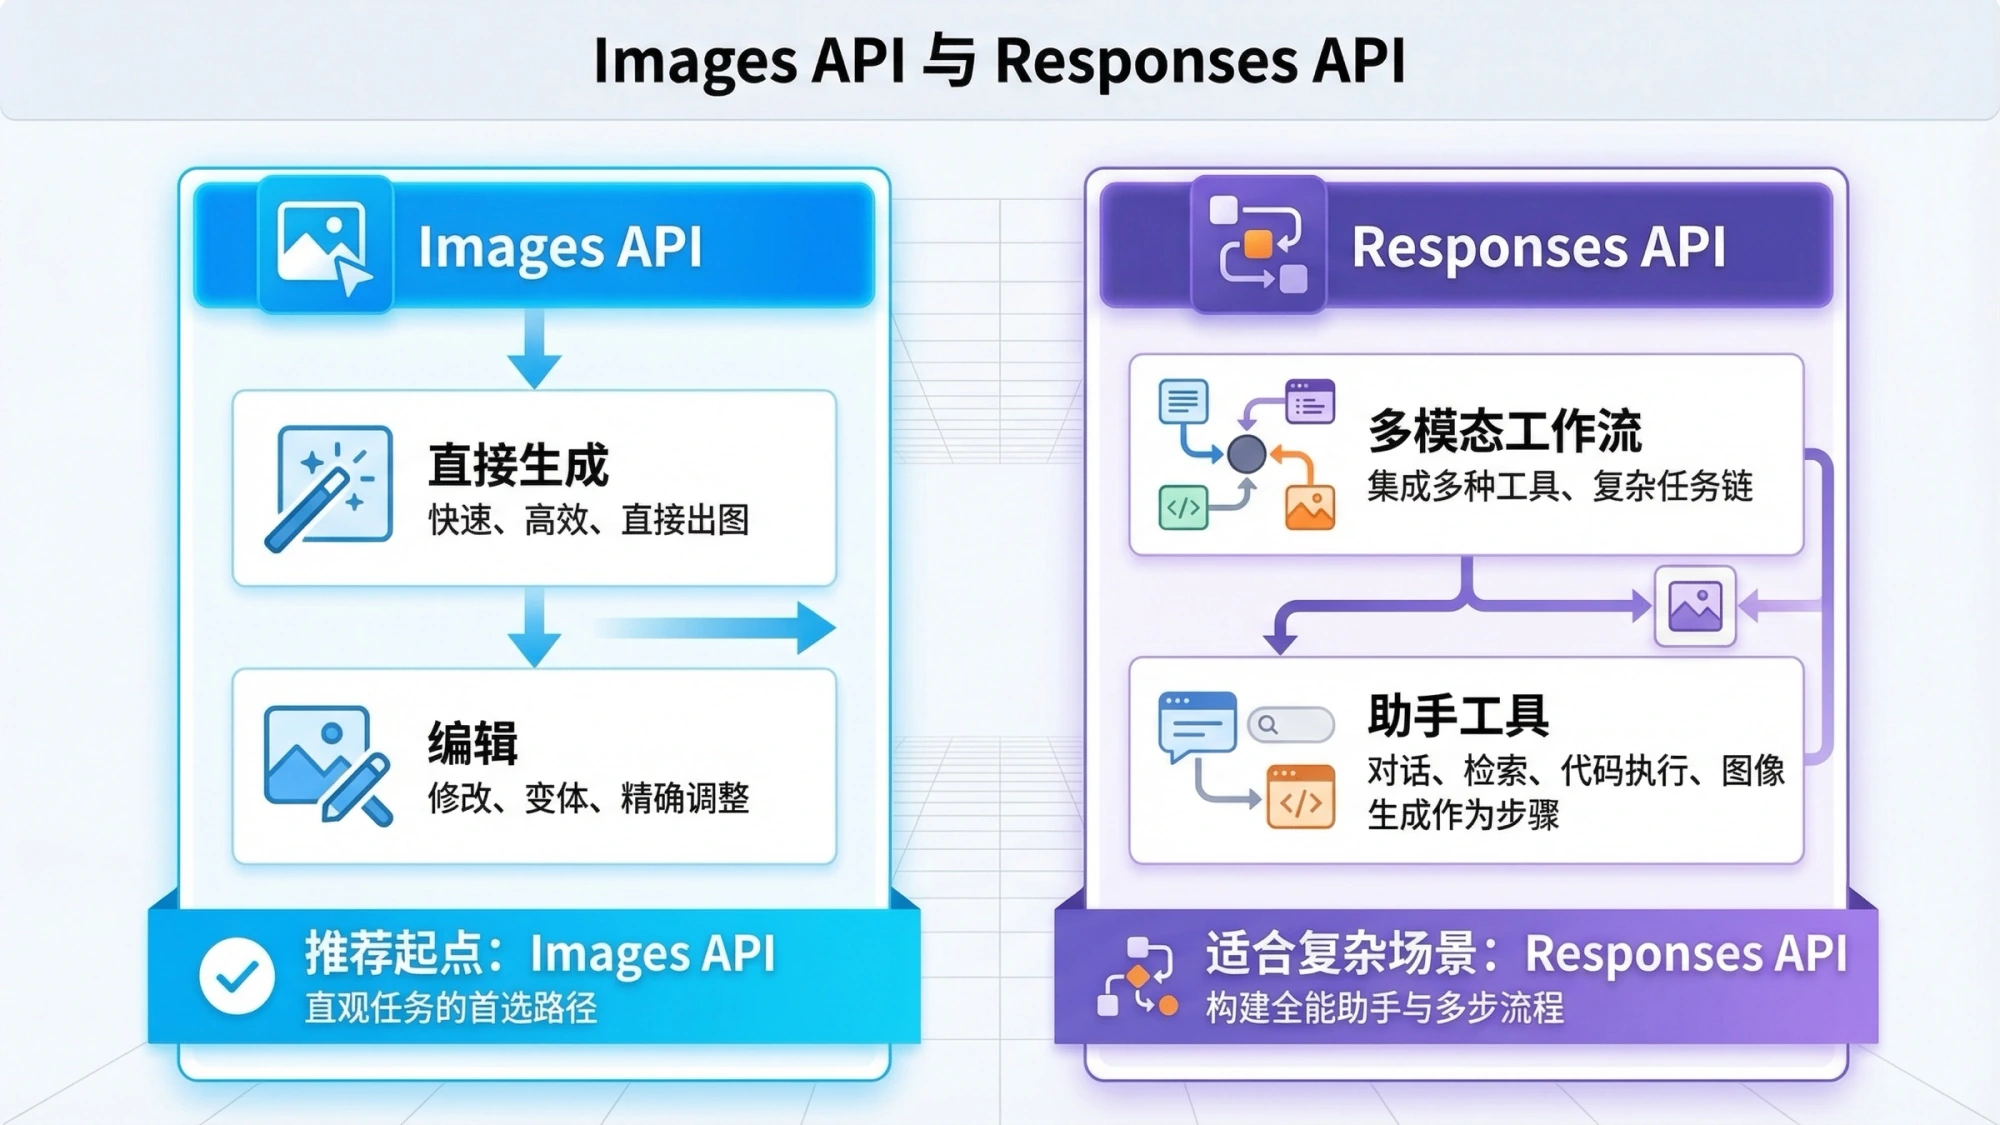
把直接图片任务和工具式多模态编排拆开看,路线就只剩三条。
| 任务 | 当前路线 | 原始路径或 SDK 调用 | model 填什么 | 什么时候先用它 | 最容易犯的错 |
|---|---|---|---|---|---|
| 一次请求生成一张图 | Images API | POST /v1/images/generations 或 client.images.generate() | gpt-image-2.5-sunburst 或 gpt-image-2.5-flare(必须显式填写,没有默认值) | 你要的是最短可运行路径 | 继续填 gpt-image-1,它 2026 年 10 月 23 日下线 |
| 基于现有图片做修改 | Images API | POST /v1/images/edits 或 client.images.edit() | 同上,不填时默认 gpt-image-2.5-sunburst | 你已经有输入图片 | 还在找 /v1/images/variations,它已停用 |
| 图片生成只是更大流程中的一步 | Responses API + image_generation 工具 | client.responses.create(),tools 里加 {"type":"image_generation"} | 顶层 model 填主线文本模型(指南要求 gpt-5 或更新),图片模型写在工具项的 model 里 | 你做的是多模态助手或 agent | 把 gpt-image-2.5-sunburst 填进 Responses 顶层 model |
三条路线的分工来自 image generation guide:只要是"一段提示词生成或编辑一张图",Image API 就是最合适的选择;Responses 的工具形式留给对话式和多步流程。原始路径以 Images API reference 为准,它只列出 generations、edits 和已标为停用的 variations 三项,没有任何读取或下载图片的接口。
没有充分理由时,先用直接 Images API。第一条请求更容易调试,也更容易把问题限定在模型 ID、权限和请求结构这三件事里。模型选择和每张成本不在这篇里展开,见 GPT Image 2 API 每张多少钱?OpenAI 图片价格与预算怎么算。
只有 ChatGPT 的 gen_id、asset_pointer:没有公开接口能按它下载图片
ChatGPT 的对话 JSON 和导出数据里,图片生成记录会带上 image_gen 工具名、gen_id、parent_gen_id、referenced_image_ids(社区帖子里也常写成 reference_image_ids),以及形如 file-service://file-... 的 asset_pointer。这些字段只在 ChatGPT 产品内部有意义。OpenAI 的 Images API reference 和 Responses 图片工具指南 里没有任何参数接受 gen_id,也没有"按 ID 取图"的接口;公开文档里同样找不到 ChatGPT 侧按 gen_id 取图的说明。
常和 gen_id 一起出现在对话 JSON 与网页请求里的 backend-api,是 ChatGPT 网页客户端自己使用的私有接口,不是对外支持的 API,没有文档、没有兼容承诺,不应作为任何集成的基础。第三方整理的报告还描述过:backend-api 和 files.oaiusercontent.com 返回的是带签名的临时链接,字段不全时报 422,过期后报 404。这些报告没有 OpenAI 文档背书,但结论方向一致:那些链接不是可长期保存的图片地址。
ChatGPT 字段对应 API 里的什么机制
| ChatGPT 里看到的字段 | 它在 ChatGPT 里的身份 | 公开 API 里对应的机制 |
|---|---|---|
gen_id | image_gen 工具给每张生成图的内部标识。DALL·E 3 时期(2023 至 2024 年)用户常让模型报出它,再在下一条提示里引用以保持画面一致 | Images API 没有对应物,响应里只有图片字节;Responses 里最接近的是 image_generation_call 输出项的 id(形如 ig_...),只能在后续轮次里续用,不能用来下载 |
parent_gen_id | 一张图在 ChatGPT 里被改出下一张时记录的上一代 ID | Responses 的 previous_response_id,或把上一轮 image_generation_call 的 id 放回下一次请求的 input |
referenced_image_ids | 让 image_gen 参考已有图片的字段 | /v1/images/edits 的 image 参数(最多 16 张输入图,base64 或 file_id);或 Responses 的多轮编辑 |
asset_pointer(file-service://file-...) | 报告描述的图片文件指针,不是 URL | 没有对应物。API 里图片字节直接在响应体里,不经过任何指针 |
image_gen | ChatGPT 对话 JSON 里的工具名 | Responses 的 image_generation 工具 |
四个入口里图片在哪、有什么 ID、能做什么
| 入口 | 图片实体在哪 | 你能拿到的 ID | 能做的事 |
|---|---|---|---|
| ChatGPT 界面与图库 | ChatGPT 服务端存储,界面里展示 | 对话 JSON 里的 gen_id、asset_pointer | 在对话或图库里点"下载图片";在同一对话里继续改图 |
| 数据导出 ZIP | 帮助中心写的是"聊天记录和其他相关账户数据";报告称 conversations.json 里的 image_asset_pointer 与包内 file-... 文件能对上 | file-... 指针 | 按指针在包内找文件(帮助页没有明说图片一定在包内) |
| Images API 响应 | 响应体 data[].b64_json | 没有图片 ID,只有 created 时间戳和 usage | 解码保存;之后无法再向 API 取回 |
| Responses 输出项 | image_generation_call 的 result(base64) | ig_... 形式的 id | 保存;后续轮次用 previous_response_id 或该 id 继续编辑 |
手里只有 gen_id 时的三条路线
- 回到 ChatGPT 界面或图库下载。图片还在对话里就直接下载;这是普通路线,也是唯一不需要等待的路线。
- 申请数据导出。按 帮助中心,在 Settings → Data controls → Export data 申请,或通过 Privacy Portal;Free、Go、Plus、Pro 和符合条件的 Edu 账户可用,Business、Enterprise、Healthcare 工作区不可用。导出最长要等 7 天,下载链接在收到后 24 小时过期,已删除的对话无法恢复。ZIP 里是"聊天记录和其他相关账户数据",帮助页没有明说包含生成图片;第三方报告称
conversations.json里的image_asset_pointer可以和包内文件对上,拿到包后按file-...指针查即可验证。 - 用 API 重新生成并自己保存。这是重新出图,不是取回原图:API 没有参数能引用 ChatGPT 的
gen_id,所以画面不会与原图一致。好处是从此图片字节在你自己手里,下面三节说明怎么保存。
单次出图:POST /v1/images/generations 请求与 base64 保存
对大多数新接入,这一步是最好的第一验证。原始路径是 https://api.openai.com/v1/images/generations;Images API reference 要求显式指定 model,这个接口没有默认模型。
第一条请求最好故意"无聊":一段提示词、一张方图、一个现行模型,足够告诉你 API key、模型访问和请求结构是不是都正常。
curl https://api.openai.com/v1/images/generations \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2.5-sunburst",
    "prompt": "Create a clean editorial illustration of a robot camera operator in a bright studio",
    "size": "1024x1024",
    "quality": "medium"
  }'
响应里的图片在 data[0].b64_json。按接口参考文档的说明,GPT Image 系列"总是返回 base64 编码的图片",response_format 是给已停用的旧模型留的字段,url 对 GPT Image 模型不受支持。所以第一条成功请求不应该只看 HTTP 200,而要确认你已经把 base64 解码落盘:
import fs from "fs";
import OpenAI from "openai";

const client = new OpenAI({ apiKey: process.env.OPENAI_API_KEY });

const result = await client.images.generate({
  model: "gpt-image-2.5-sunburst",
  prompt: "Create a clean editorial illustration of a robot camera operator in a bright studio",
  size: "1024x1024",
  quality: "medium",
});

fs.writeFileSync("studio-robot.png", Buffer.from(result.data[0].b64_json, "base64"));
console.log(result.usage); // input_tokens / output_tokens / total_tokens
这也是 gen_id 那类问题在 API 侧的根源:Images API 的响应里除了图片字节,只有 created、usage、size、quality、output_format、background 这些描述字段,没有任何可供事后取图的 ID。不落盘,这张图就没有第二次获取的机会。GPT Image 模型也不返回 revised_prompt。
想要可直接复制的 Python、JavaScript 与 cURL 版本,见 OpenAI 图像生成 API 示例:当前可用的 JavaScript、Python 和 cURL;只要 curl 请求,见 OpenAI 图像生成 API cURL:当前可用的生成与编辑请求。
已有素材要改图:POST /v1/images/edits,variations 已停用
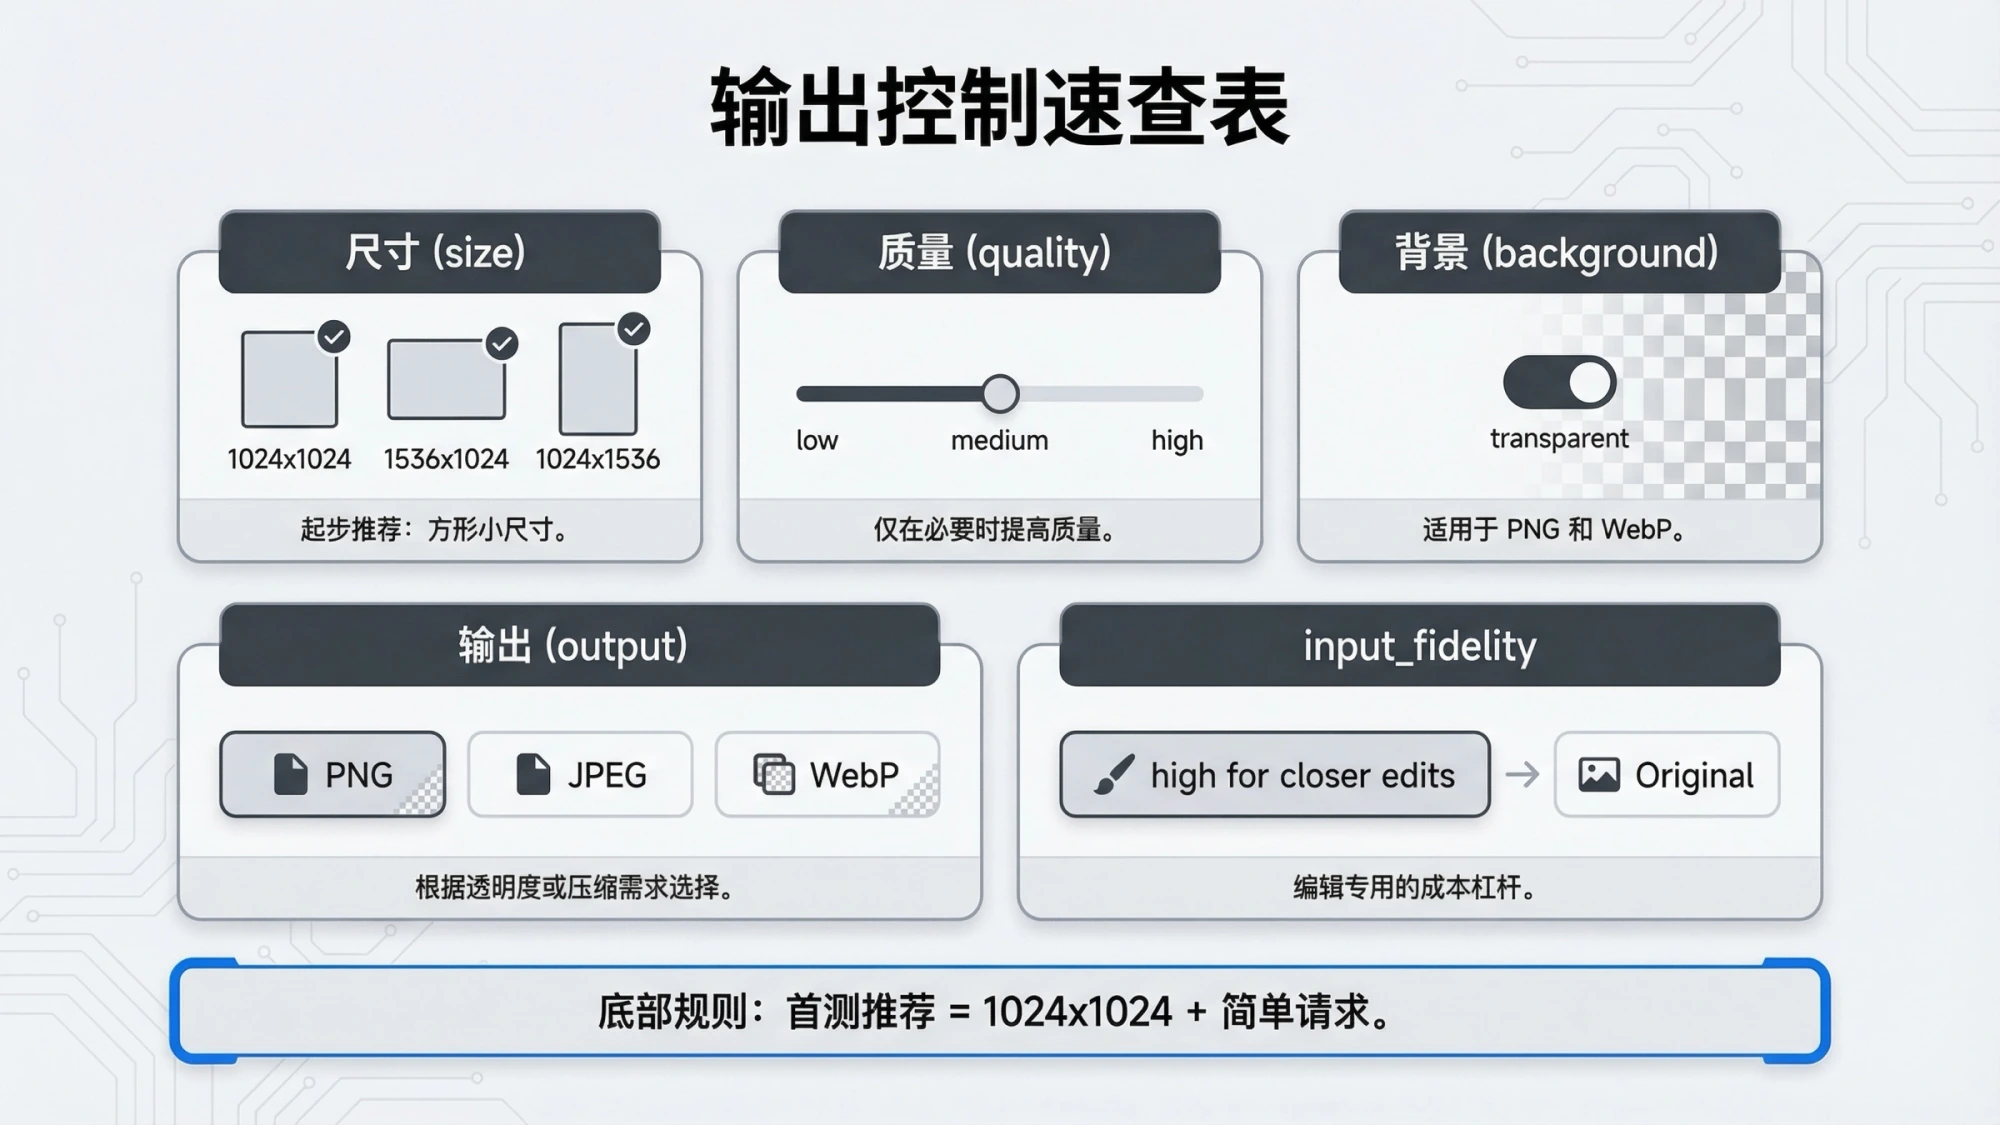
不少接入的真实需求不是纯生成,而是"我已经有一张产品图或参考图,怎么改"。这仍然是直接 Images API 的事,只是从生成分支换成编辑分支。按 Images API reference,/v1/images/edits 接受最多 16 张输入图(GPT Image 模型),可选 mask(以 image_url 或 file_id 传入),不填 model 时默认 gpt-image-2.5-sunburst。/v1/images/variations 已标为"停用、不再可用",原来做变体的需求改用 edits 加一段提示词完成。
import fs from "fs";
import OpenAI from "openai";

const client = new OpenAI({ apiKey: process.env.OPENAI_API_KEY });

const result = await client.images.edit({
  model: "gpt-image-2.5-sunburst",
  image: [fs.createReadStream("product-shot.png")],
  prompt: "Keep the product shape, but place it on a clean studio shelf with warm lighting",
  input_fidelity: "high",
});

fs.writeFileSync("product-shelf.png", Buffer.from(result.data[0].b64_json, "base64"));
在 ChatGPT 里靠 referenced_image_ids 做到的"参考这张图继续画",在 API 里就是 edits 的 image 参数:把参考图作为输入直接传进去,而不是传一个 ID。参数上值得记住的几点,参考文档与指南当前一致:
size:auto、1024x1024、1536x1024、1024x1536;gpt-image-2 系列还接受自定义WIDTHxHEIGHT。指南对 gpt-image-2 的限制是最长边 3840 px、两边都是 16 的倍数、长短边比不超过 3:1、总像素 655,360 到 8,294,400;2.5 模型的自定义尺寸规则指南里没有单独列出。quality:low、medium、high、auto;xhigh和max只有 gpt-image-2.5 模型支持,更早的 GPT Image 模型最高到high。output_format:png(默认)、jpeg、webp;output_compression0 到 100 只对 jpeg/webp 生效。background:transparent、opaque、auto;透明背景需要 png 或 webp,gpt-image-2 上标为预览。n1 到 10;partial_images0 到 3 配合stream使用;moderationauto或low;prompt最长 32,000 字符。input_fidelity:high或low;gpt-image-1-mini 只支持low;gpt-image-2 不能设置这个参数(始终高保真,参考图编辑会多消耗输入 token)。
编辑是 Images API 的正式场景,不是切到 Responses 的理由。mask、保真度、多图合成怎么选,见 OpenAI 图片编辑 API:GPT Image 2 变体迁移与 dall-e-2 报错。
图片生成只是流程一步时:Responses 的 image_generation 工具
Responses 的价值不在于"更新",而在于适合更大的工作流:主线模型先理解任务,可能调别的工具,可能继续对话,在某个节点决定出图。按 image_generation tool guide,图片模型写在工具项里,顶层 model 是主线文本模型;主指南写的是"需要 gpt-5 或更新的模型",具体支持列表以模型页当日显示为准。
import fs from "fs";
import OpenAI from "openai";

const client = new OpenAI({ apiKey: process.env.OPENAI_API_KEY });

const response = await client.responses.create({
  model: "gpt-5.5",
  input: "Generate a transparent sticker-style icon of a paper airplane for a travel app",
  tools: [{ type: "image_generation", model: "gpt-image-2.5-sunburst", background: "transparent", quality: "high" }],
});

const call = response.output.find((item) => item.type === "image_generation_call");
fs.writeFileSync("airplane.png", Buffer.from(call.result, "base64"));
console.log(call.id); // 形如 ig_...,下一轮编辑时可以引用
输出里的 image_generation_call 项带三样东西:result(base64 图片,同样要自己落盘)、id(文档示例写作 ig_123)和 revised_prompt。要在下一轮继续改这张图,传 previous_response_id,或者把 {"type":"image_generation_call","id": ...} 作为输入项和新的用户消息一起发出。这就是 ChatGPT 里 parent_gen_id 链条在 API 侧的对应机制,也是 API 里唯一的"生成 ID",它只能用于续写会话,不能用来下载。工具项里还可以设 action(auto、generate、edit;上下文里没有图片时 edit 会报错),partial_images 1 到 3 会流式返回 response.image_generation_call.partial_image 事件,tool_choice: {"type":"image_generation"} 可以强制调用。
成本上有一点只在这条路线成立:GPT Image 2.5 的缓存输入价格(图片输入 $2 / 百万 token,文本输入 $1.25 / 百万 token)只通过 Responses 工具生效,直接调 /v1/images/* 没有缓存价;但 Responses 请求同时计主线模型自己的 token。每张流式部分图另加 100 个输出 token。费率见下一节。
更完整的两条路线对比见 OpenAI 图片 API 教程:Images API 还是 Responses。
模型 ID 与下线日期:gpt-image-1 到 10 月 23 日,1.5 等到 12 月 1 日
接口选对了却调用失败,最常见的原因不再是接口路径,而是模型 ID 过期。截至 2026 年 10 月 9 日,deprecations 页 的状态如下:
| 模型 ID | 状态 | 说明 |
|---|---|---|
gpt-image-2.5-sunburst、gpt-image-2.5-flare(各有 -2026-09-08 快照) | 现行 | 指南只把这两个列为当前模型;edits 默认 sunburst |
gpt-image-2(快照 gpt-image-2-2026-04-21) | 可用,未列入停用 | 支持自定义尺寸,input_fidelity 不可设 |
gpt-image-1 | 2026 年 10 月 23 日下线(2026 年 4 月 22 日公告) | 推荐迁移到 2.5 sunburst 或 flare |
gpt-image-1.5、gpt-image-1-mini、chatgpt-image-latest | 2026 年 12 月 1 日下线(2026 年 6 月 2 日公告) | 同上 |
dall-e-2、dall-e-3 | 已于 2026 年 5 月 12 日关闭 | 参考文档的 model 枚举里还能看到名字,但已不可调用 |
chatgpt-image-latest 值得单独说一句:按它的模型页,它指向 ChatGPT 之前使用的图片模型快照,只支持 v1/images/generations、v1/images/edits 和 v1/batch,模型页本身推荐 API 用户改用 GPT Image 2.5 Sunburst。它的按张价格是 low $0.009(1024×1024)/ $0.013(1024×1536 或 1536×1024),medium $0.034 / $0.05,high $0.133 / $0.20。想在 API 里复现 ChatGPT 旧版出图效果的人要注意,这个 ID 到 2026 年 12 月 1 日就没有了,迁移目标仍是 2.5。
GPT Image 2.5 按 token 计价:图片输入 $8 / 百万 token、缓存图片输入 $2 / 百万、图片输出 $30 / 百万、文本输入 $5 / 百万、缓存文本输入 $1.25 / 百万(image generation guide)。指南特别提醒"费率相同不等于每张成本相同",因为输出 token 数随质量和尺寸变化;作为量级参考,早期 GPT Image 模型一张 1024×1024 图在 low / medium / high 下分别消耗约 272 / 1,056 / 4,160 个输出 token。2.5 的每张美元数以你的实际 usage 为准,预算怎么算见 GPT Image 2 API 每张多少钱?OpenAI 图片价格与预算怎么算。
排错顺序因此变成:
- 先确认路线:Images API 先,Responses 只在需要编排时用。
- 再确认模型 ID 是不是现行的:
gpt-image-1一类的 model-not-found,先看上表的日期。 - 请求被拦时看错误码:
moderation_blocked会附带moderation_details,其中categories和moderation_stage(input / output)说明是提示词还是生成结果触发了拦截,这不是接口问题。 - 最后才去改 payload 或 SDK 代码。
账户层面的组织验证问题走 GPT Image 2 提示组织必须验证:从账户核验到恢复出图;ChatGPT 产品本身出不了图,走 ChatGPT 图片生成不了?先查状态,再按分支修复。
FAQ
ChatGPT 生成的图片能用 OpenAI API 按 gen_id 下载吗?
不能。gen_id 是 ChatGPT 内部字段,Images API 和 Responses API 都没有参数接受它,Images API 也没有任何读取接口。图片在 ChatGPT 对话或图库里直接下载,或者申请数据导出;需要程序化拿到图片字节,就用 API 重新生成并在响应返回时保存。
referenced_image_ids 在 OpenAI 图片 API 文档里对应什么参数?
没有同名参数。它是 ChatGPT image_gen 工具的字段;API 里"参考已有图片"的做法是把图片本身作为输入:/v1/images/edits 的 image 参数(最多 16 张,base64 或 file_id),或者在 Responses 里用 previous_response_id 延续带图的会话。
https://api.openai.com/v1/images/generations 返回的是链接还是 base64?
GPT Image 模型只返回 base64(data[].b64_json),url 不受支持,response_format 只对已停用的旧模型有意义。拿到响应后立即解码保存,API 不保留这张图。
普通图片编辑也要走 Responses 吗?
不用。POST /v1/images/edits 与 client.images.edit() 就是正式的编辑路线,默认模型 gpt-image-2.5-sunburst。只有当编辑本身是对话式或多工具流程中的一个节点时,Responses 才更合适。
chatgpt-image-latest 是什么模型,还能用多久?
它指向 ChatGPT 之前使用的图片模型快照,只能通过 v1/images/generations、v1/images/edits 和 v1/batch 调用,2026 年 12 月 1 日下线。新接入直接用 gpt-image-2.5-sunburst 或 gpt-image-2.5-flare。
明明接口写对了,为什么还是调用失败?
先看模型 ID:gpt-image-1 在 2026 年 10 月 23 日之后、gpt-image-1.5 等在 12 月 1 日之后都会消失;Responses 里把图片模型填进顶层 model 也会失败。再看错误码,moderation_blocked 说明是内容拦截而不是接口错误。都不是,再检查 API key 和组织的访问状态。