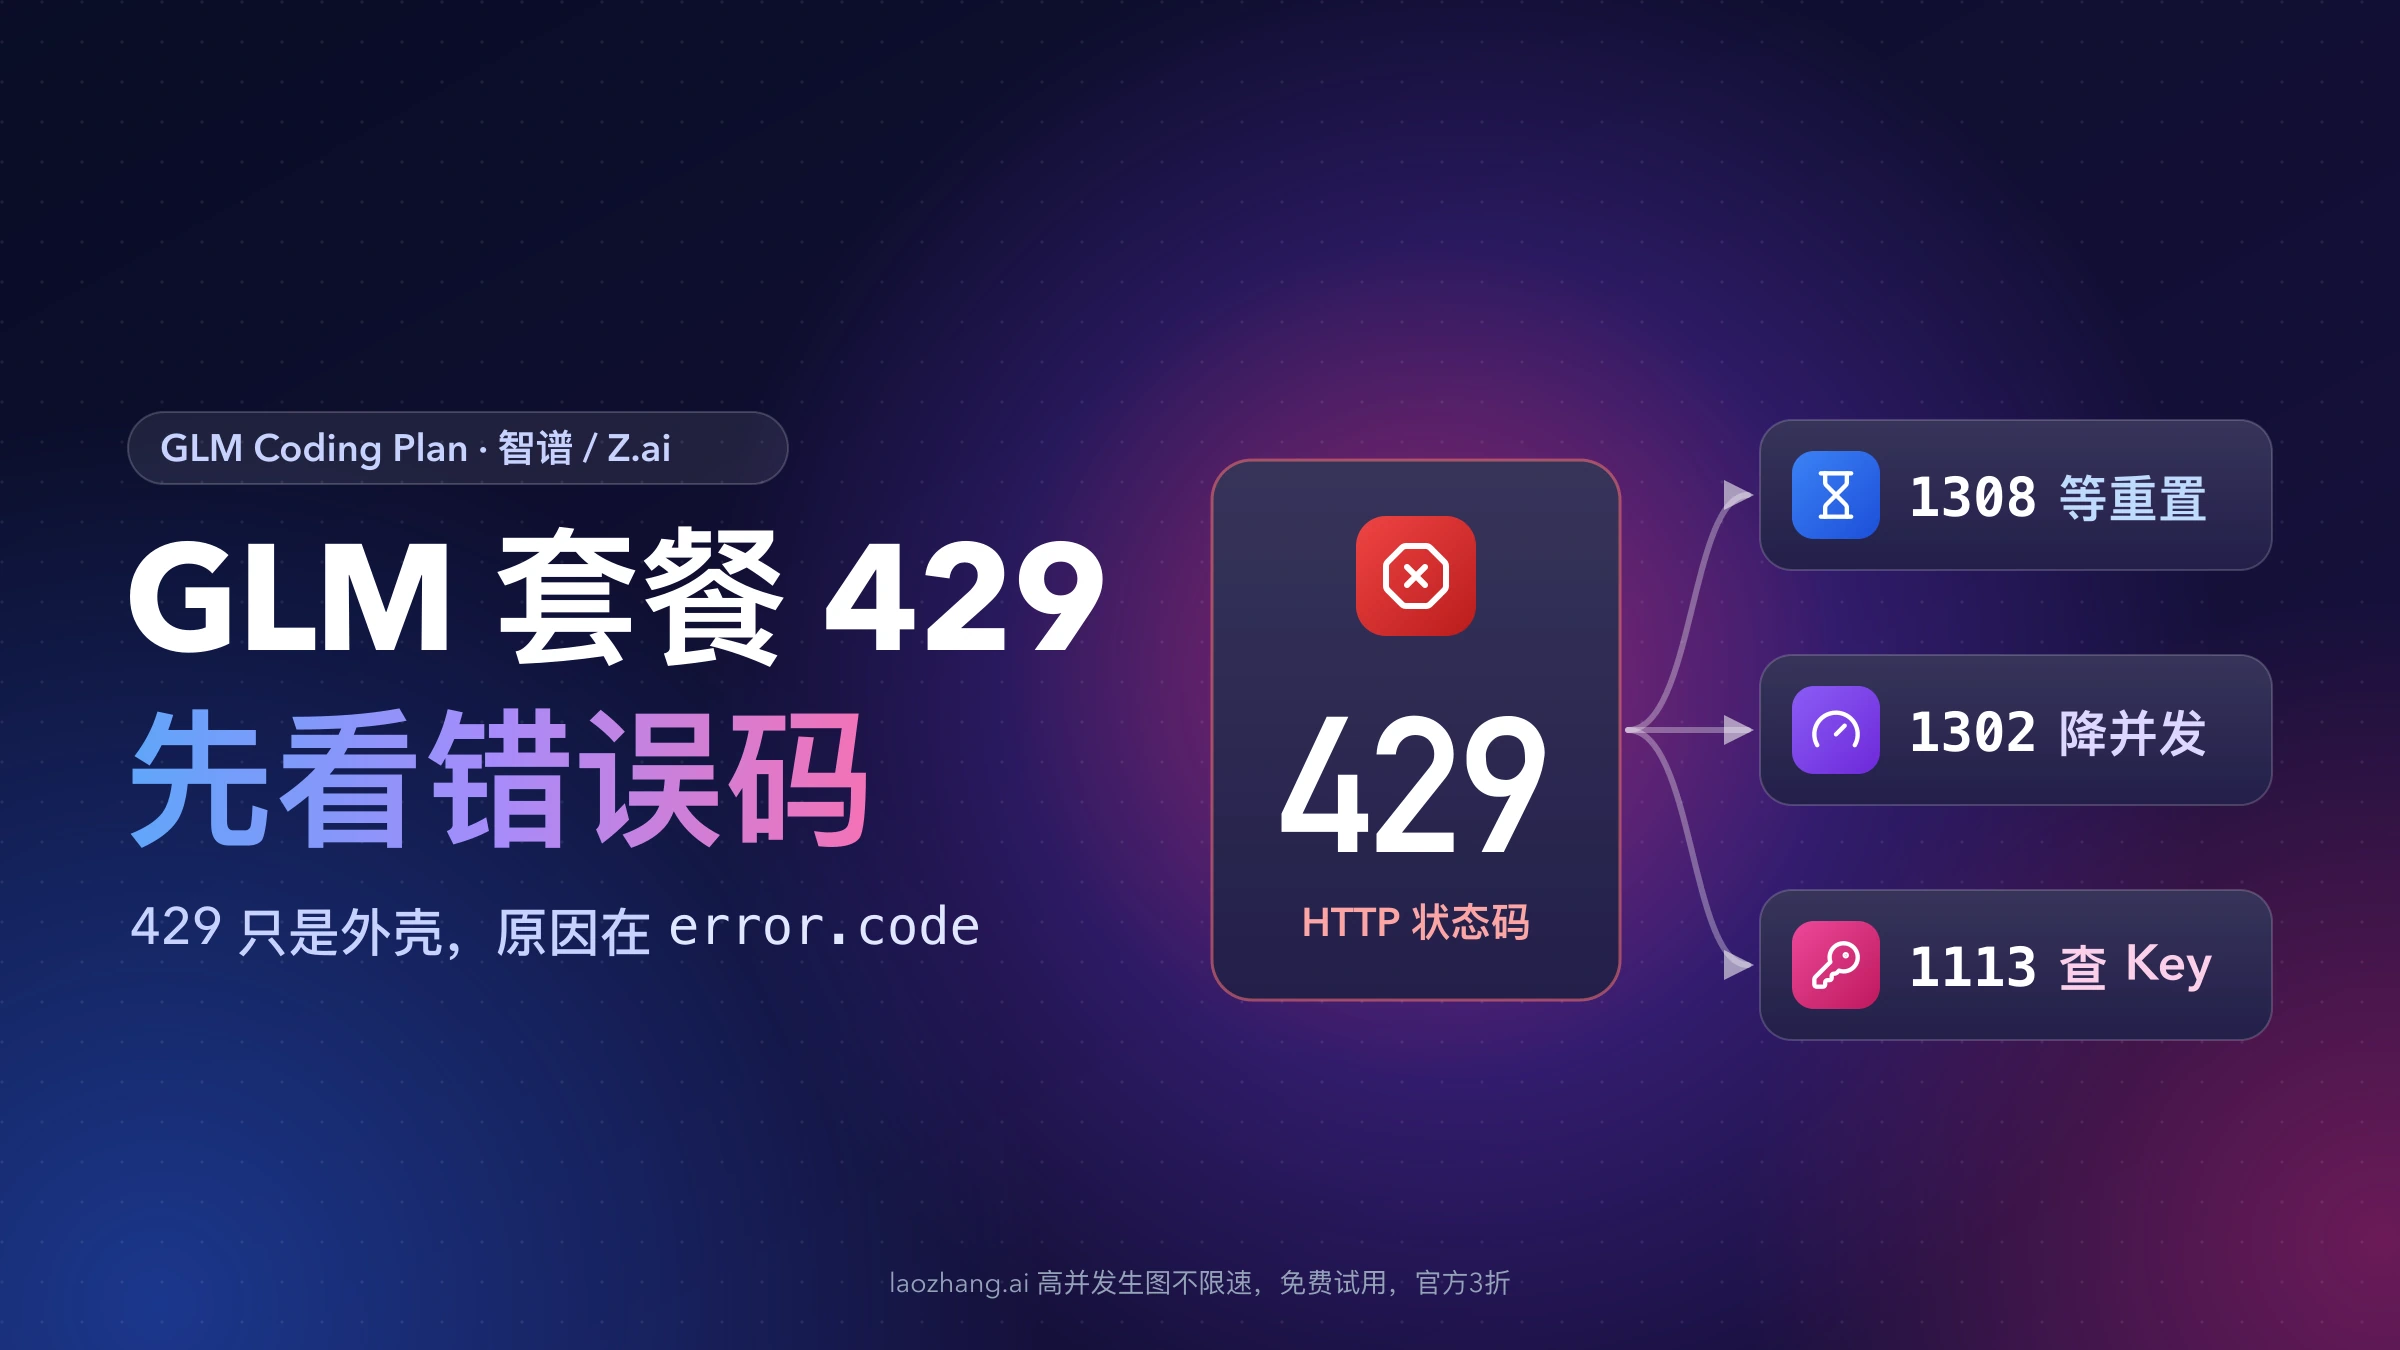
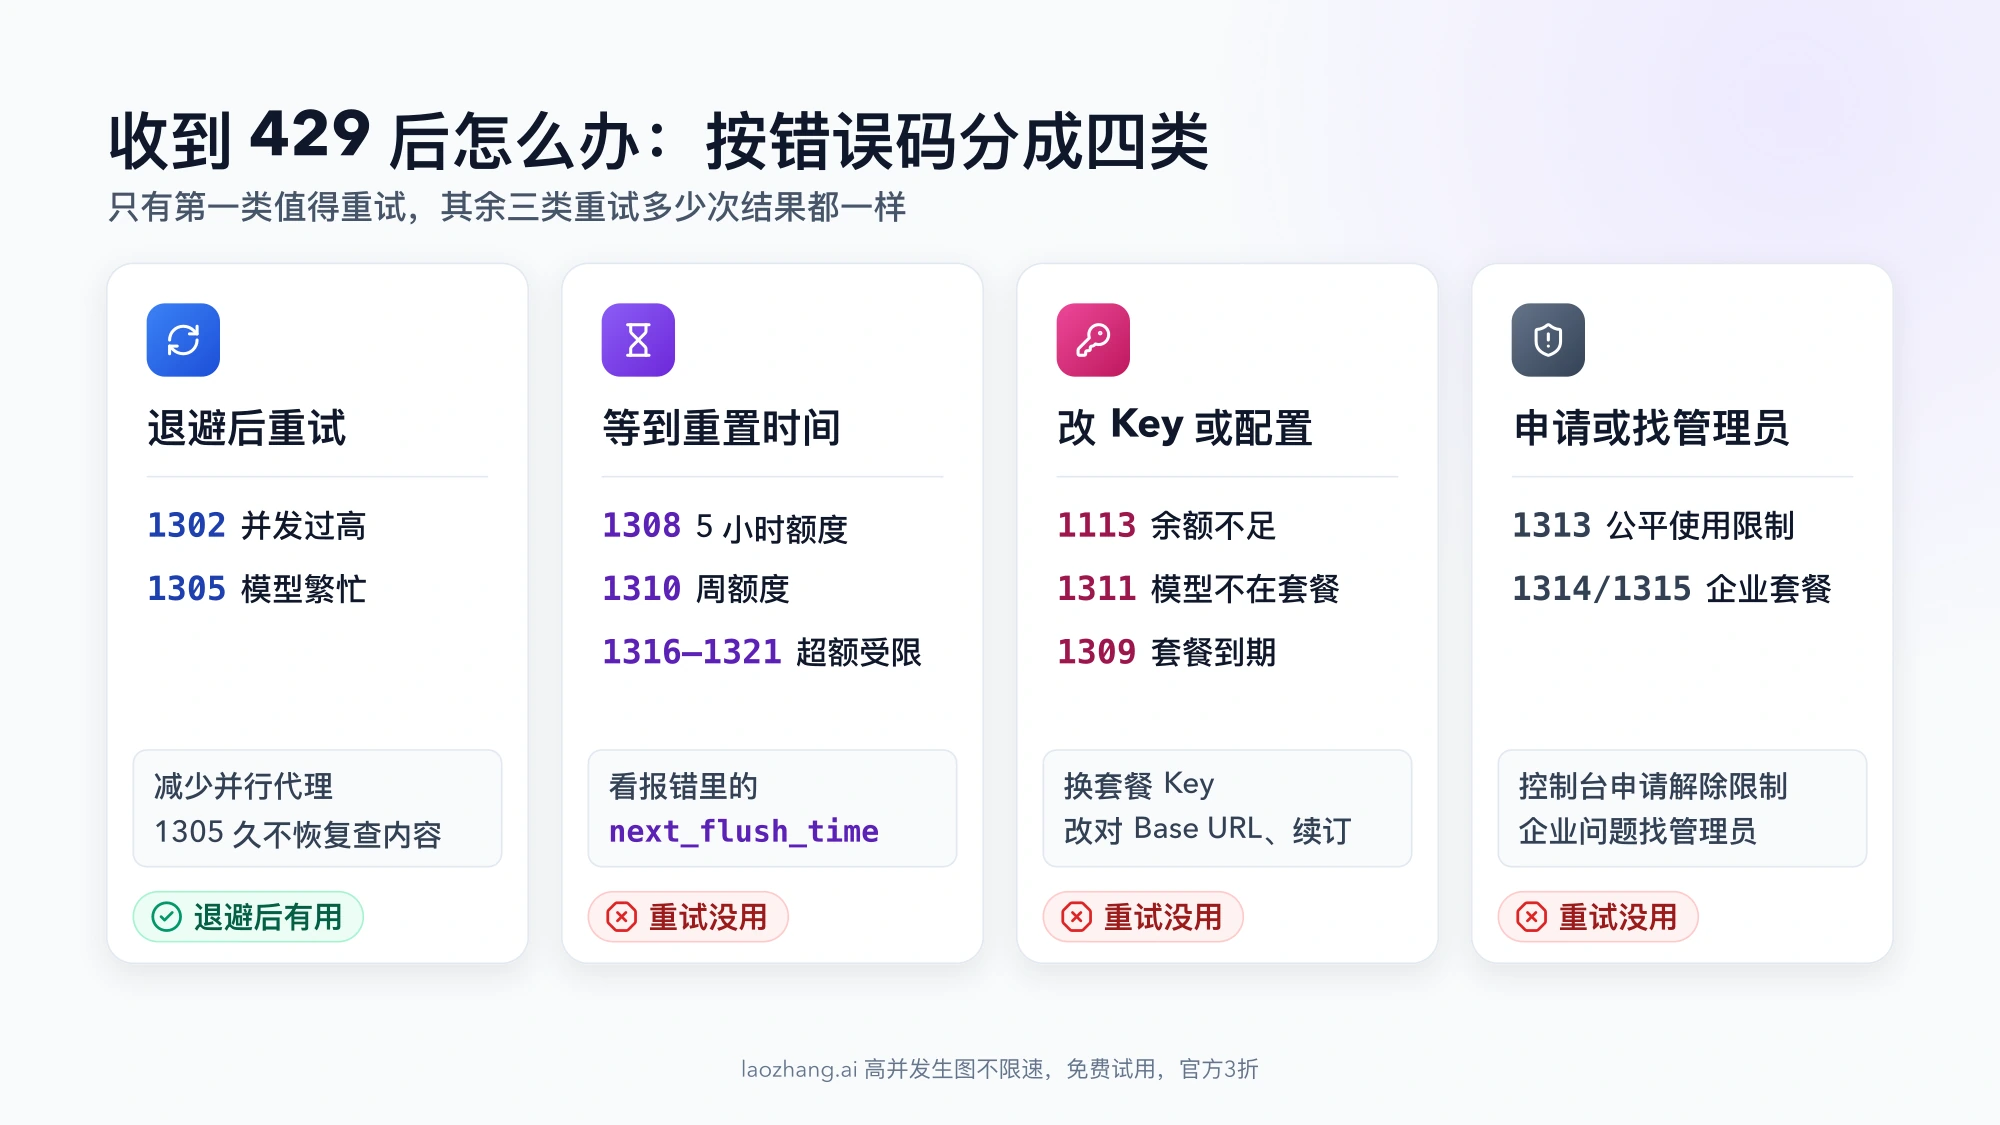
GLM Coding Plan 的额度用完、请求太频繁、模型繁忙、套餐到期、Key 用错、触发公平使用限制,返回的 HTTP 状态码都是 429,所以光看 "429" 判断不了原因。要看的是响应体里的业务错误码和报错原文:1308、1310 表示额度窗口用完,报错里直接写了重置时间,只能等或换路;1302「您的账户已达到速率限制,请您控制请求频率」是并发或频率太高,减少并行任务就能缓解;1113 在已订阅套餐的账号上出现,多半是 Key 类型或 Base URL 让请求走了按量计费,而不是套餐真的没额度;1305 先退避重试,长时间不恢复再查请求内容;1313 要去控制台申请解除限制,反复重试没有用。
下面按国内版智谱 BigModel(open.bigmodel.cn,控制台在 bigmodel.cn)来讲,国际版 Z.ai(api.z.ai)地址或规则不同的地方单独标出。两个平台的账号、控制台、API Key 和 Base URL 互不通用,先确认你订阅的是哪一个。
先在 429 响应体里找到错误码和报错原文
智谱开放平台的错误由两层组成:外层是 HTTP 状态码,内层是响应体里的业务错误码和说明,比如:
{"error":{"code":"1302","message":"您的账户已达到速率限制,请您控制请求频率"}}智谱错误码文档里,套餐相关的拒绝全部挂在 HTTP 429 下面,区分原因只能靠 code 和 message。有些工具收到 429 会自动重试或换备用模型,表面上只是变慢、卡住。看原始报错有两个办法,都不离开官方支持的工具:
- 看工具自己的报错输出和日志:界面里只显示 429 或 "rate limit"、看不到这段 JSON 时,打开工具的日志,或者开启它的详细输出、调试模式再复现一次,通常能看到完整的响应体。
- 在官方支持的工具里开一个最小的新会话:用同一把套餐 Key 和同一个套餐地址,比如新开一个 Claude Code 会话,只发一句"hi"。能正常回复,说明 Key、地址和套餐本身是通的,问题出在原来那个工具发出的请求上(并发、请求内容或它实际用的地址);同样报 429,就拿到了这次的错误码,按下面的对照处理。
不要为了排查拿套餐 Key 写 curl、脚本或 SDK 直接调接口。套餐额度只能在官方支持的工具里用,使用须知写明用于非支持工具会被限制权益,Z.ai 的订阅协议也点名了通过 SDK 接入的情况;违规还可能触发限流、冻结等风控处置。
还有两点会影响判断:
- 流式输出(SSE)在推理中途异常结束时,不会返回这些错误码,原因写在响应的
finish_reason里。任务做到一半断掉、却找不到 429 的,先看这个字段。 - 额度剩多少,在控制台 用量统计 看;每次调用扣的是套餐还是余额,在 费用明细 的抵扣资源包一列看。
GLM Coding Plan 429 错误码对照:原因、处理与要不要重试
报错原文取自智谱国内版错误码文档,${} 里的内容会替换成实际数值。
| 错误码 | 报错原文(国内版) | 实际原因 | 怎么处理 | 重试有没有用 |
|---|---|---|---|---|
| 1302 | 您的账户已达到速率限制,请您控制请求频率 | 并发或请求频率超过当前档位的动态上限 | 减少同时运行的代理和子任务,避开高峰时段 | 退避后重试有用,原样高并发重试没用 |
| 1305 | 该模型当前访问量过大,请您稍后再试 | 模型繁忙;也有用户报告由请求内容触发 | 等几分钟再试;一直不恢复就查请求内容 | 真繁忙时有用,内容触发时没用 |
| 1308 | 已达到 ${number} ${unit} 的使用上限。您的限额将在 ${next_flush_time} 重置 | 5 小时额度用完 | 等到报错里的重置时间,或改用按量付费 | 没用 |
| 1310 | 您已达到每周/每月使用上限,您的限额将在 ${next_flush_time} 重置 | 周(或月)额度用完 | 同上 | 没用 |
| 1316 / 1317 | 已达到 5 小时 / 7 天使用上限。主账号余额不足,无法使用超额按量付费… | 额度用完,超额按量付费因余额不足没能接上 | 充值主账号余额,或等重置 | 没用 |
| 1318–1321 | 已达到 5 小时 / 7 天使用上限,且已达子账号(或企业级)月消费上限… | 额度用完,超额付费撞上月消费上限 | 联系管理员调整上限,或等重置 | 没用 |
| 1113 | 您的账户已欠费,请充值后重试 | 请求按标准 API 计费而余额不足:Key 类型、Base URL、工具或模型不在套餐范围 | 换成套餐 Key,改对 Base URL | 没用 |
| 1309 | 您的 GLM Coding Plan 套餐已到期,暂无法使用… | 套餐到期 | 续订,或新建标准 API Key 按量付费 | 没用 |
| 1311 | 当前订阅套餐暂未开放 ${model_name} 权限 | 请求的模型不在套餐内 | 改用 GLM-5.3 或 GLM-5.3-Flash | 没用 |
| 1313 | 您的账户当前使用模式不符合公平使用策略,请求频率已受到限制… | 触发公平使用风控 | 在控制台申请解除限制 | 没用 |
| 1314 | 您的企业套餐已失效,请联系企业管理员。 | 企业套餐失效 | 找企业管理员 | 没用 |
| 1315 | 该 API Key 仅限企业编程套餐场景使用,请到官网更换对应产品类型的 API Key | Key 属于企业编程套餐,用错了场景 | 换成对应产品类型的 Key | 没用 |
官方中文表里 1113 写的是「您的账户已欠费,请充值后重试」,也有用户贴出的原文是「余额不足或无可用资源包,请充值」,处理方法一样。用 Z.ai 国际版时报错是英文,常见几条对应关系:1302 是 "Rate limit reached for requests",1305 是 "The service may be temporarily overloaded, please try again later",1308 是 "Usage limit reached for … Your limit will reset at …",1113 是 "Insufficient balance or no resource package. Please recharge.",1313 以 "Your account's current usage pattern does not comply with the Fair Usage Policy" 开头(Z.ai 错误码文档)。
1308、1310 额度用完:按 next_flush_time 等重置
这两个码说明套餐额度窗口确实用完了。报错原文里的 next_flush_time 就是这一档额度恢复的时间点,比自己推算准;在它之前反复重试只会继续收到 429。
截至 2026 年 10 月 22 日,国内版个人套餐(按积分计量的新套餐)的额度如下(套餐概览):
| 套餐 | 5 小时积分 | 每周积分 |
|---|---|---|
| Lite | 2,000 | 10,000 |
| Pro | 12,000 | 60,000 |
| Max | 28,000 | 140,000 |
两个窗口的重置方式不同,"5 小时额度几点重置"没有统一答案:
- 5 小时积分是滚动恢复的:官方写的是"积分额度在请求消耗 5 小时后刷新重置",哪一刻用掉的积分,5 小时后回来,不是每天固定几个整点。连续高强度用了一下午,额度会在接下来的几个小时里陆续恢复。
- 周积分从下单那一刻算起,每 7 天刷新一次,和自然周无关。
- 套餐额度用完后,系统不会转去扣你的账户余额或其他资源包,只能等恢复。
积分为什么用得这么快
每次调用扣多少积分,官方给的算法是:
积分 =(未命中缓存的输入 token × 输入系数 + 缓存命中 token × 缓存系数 + 输出 token × 输出系数)÷ 10,000
GLM-5.3 的系数是 6.9 / 1.7 / 24,GLM-5.3-Flash 是 2.3 / 0.56 / 8,同样的 token 量,GLM-5.3 扣的积分是 Flash 的 3 倍。另外,非高峰时段模型调用按 50% 扣,高峰时段是北京时间周一至周五 14:00–18:00,按全价扣。
拿一个假设的编程代理请求算一下:上下文 80,000 token,其中 70,000 命中缓存、10,000 未命中,输出 2,000 token。
- GLM-5.3,高峰时段:(10,000×6.9 + 70,000×1.7 + 2,000×24) ÷ 10,000 = 23.6 积分。Lite 的 2,000 积分够这样的请求大约 84 次。
- 同一请求放到非高峰:11.8 积分,大约 169 次。
- 换成 GLM-5.3-Flash、高峰时段:7.82 积分,大约 255 次。
代理工具完成一个任务要连续发很多次请求,缓存命中率一掉、输出一长,积分消耗就上去了。实际每次扣了多少,以费用明细里的 token 数为准。
2026 年 7 月 30 日之前订阅、还没到期的老套餐不按积分计,按 prompt 次数估算。Z.ai 国际版公布的老套餐 V2 参考值是 Lite 每 5 小时约 80 次、每周约 400 次,Pro 约 400 / 2,000 次,Max 约 1,600 / 8,000 次,GLM-5.3 在高峰时段按 3 倍计(Z.ai 套餐调整公告)。自己是哪一版,看控制台套餐页面的标识。
等不到重置时能做什么
- 把不需要强推理的步骤换成 GLM-5.3-Flash:同样的 token 消耗约三分之一的积分。
- 把长任务挪到非高峰:避开北京时间工作日 14:00–18:00,扣减减半。
- 用额度重置卡:只在活动期间发放,有的话在用量统计页面能看到;用完后这一档额度回满,重置周期从使用时刻重新算。
- 升级套餐:国内版升级后积分按新档位立即刷新;续费不会重置积分,也不改变刷新周期。升级要付差价,只在你确实长期不够用时考虑。
- 临时改用按量付费:见后文"等不了额度重置"一节。
1316–1321:超额按量付费也被拦下
这一组码同样是额度用完,报错同时说明"超额按量付费"这条后路也没接上:1316/1317 是主账号余额不足,充值后才能继续按量计费;1318/1319 是子账号月消费上限,1320/1321 是企业级月消费上限,这两类要找管理员调额度。团队套餐的超额付费按团队设置执行;个人套餐如何开通超额按量付费,公开文档里没有说明。
1302「您的账户已达到速率限制」:减少并发,不是额度问题
1302 和额度无关,用量统计里还剩很多积分时也会出现。它表示同一时间发出的请求太多,超过了你这一档的速率(并发)上限。
官方对并发的说明只有几条原则(使用须知):并发上限与套餐档位相关,Max > Pro > Lite,平台按资源情况动态调整;推荐 Lite 同时只开发一个项目,Pro 1–2 个,Max 2 个以上;低峰期并发会动态提高。具体的并发数和每分钟请求数没有公开,网上流传的数字都没有官方出处。
能做的事:
- 减少同时跑的代理:多个终端同时开 Claude Code、开了大量 Subagent、Cline 和 OpenCode 共用一个 Key 同时跑,都会把请求叠在一起。Lite 用户按"一次一个项目"来排。
- 避开工作日下午:北京时间周一至周五 14:00–18:00 是高峰,低峰期的并发更宽松。
- 让工具退避重试:间隔逐步拉长的重试能等到并发空出来;原样立刻重试只会继续撞上限。
- OpenClaw 用户另外注意:官方说明 OpenClaw 走次级调度,编程代理任务优先抢占资源,高负载时 OpenClaw 任务会被动态排队和限流。
V2EX 上有用户说 Z.ai 的 Lite 套餐几乎没法用,LINUX DO 上也有帖子吐槽智谱套餐日常 429 限流,帖子里提到的是 NewAPI 日志里的大量限流报错,也就是把套餐 Key 接进了中转系统。中转、共享、多人共用本身就违反套餐使用规则,可能直接触发 1313 风控甚至冻结,不能拿来"扩并发";轮换多个账号或 Key 也一样。并发确实不够用,正路只有降低并行、换时段、升级档位,或者把超出的部分放到按量付费的标准 API 上。
1305「该模型当前访问量过大」:不一定是真繁忙
官方对 1305 的说明是模型当前访问量过大,请稍后再试。先按这个处理:等几分钟,让工具拉长间隔重试。
但如果 1305 持续出现,而同一时间别的请求正常,就要怀疑请求内容。GitHub 上有 Hermes Agent 用户报告,在 Z.ai 国际版套餐上,系统提示里只要出现 "Hermes Agent" 这个短语,请求就稳定返回 1305(OpenAI 兼容端点是 HTTP 429,Anthropic 端点是 HTTP 529),把这几个字改掉,同一个 Key、同一个端点立即返回 200(issue #89278);另一位用户发现对话里以纯文本出现的 skill_view(...) 调用写法也会稳定触发(issue #56816)。这些是用户的二分实验结果,Z.ai 没有确认,过滤现在是否还生效、国内版有没有同样的行为,公开资料里都没有说明。Hermes Agent 本身在官方支持的工具列表里,这不是用错工具的问题。
判断方法:
- 在同一个工具里开一个新会话,不带自定义系统提示、技能和插件,只发一句"hi"。成功而原任务一直 1305,基本可以排除真繁忙。
- 把系统提示、AGENTS.md / CLAUDE.md 一类的项目说明、技能定义分段去掉再试,缩小到触发的那一段,改写它。
- 换个时段仍然稳定复现的,带着请求 ID 和报错原文找官方技术支持。
有套餐却报 1113 余额不足:查 Key 类型和 Base URL
已订阅套餐、用量统计里也还有积分,却收到 1113「余额不足」,通常不是套餐出了问题,而是这次请求根本没有走套餐,被当成标准 API 按量计费,账户余额又是 0。官方 FAQ 列的原因有三类:工具不在支持列表里、Base URL 不对、调用了套餐外的模型;另外,官网体验中心也不能用套餐额度。
2026 年 10 月 16 日之后,还要加上第一条:Key 的类型。
10 月 16 日起,Key 类型决定扣哪里的钱
从 2026 年 10 月 16 日起,标准 API、个人套餐、团队套餐的 API Key 分开管理,三类 Key 互不通用(API Key 分类管理说明):
- 10 月 16 日及之后新建的 Key,扣哪类额度只看 Key 类型,和填什么地址无关。在 API Key 页面新建的"标准 API Key",填进编程工具后永远不用套餐额度,按标准 API 计费扣余额;余额不够,就报 1113。
- 套餐 Key 要从套餐入口建:个人版在「个人编程套餐 → 套餐概览」,团队版在「团队编程套餐 → 我的套餐」。个人套餐 Key 的入口只在已开通个人套餐的账号、默认组织的默认项目下显示,切到别的组织或项目会找不到。
- 10 月 16 日之前建的 Key 不用换,系统已自动分类。账号曾经有过套餐的,旧 Key 会标成"兼容",沿用老规则:扣哪类额度取决于调用的端点。配在
https://open.bigmodel.cn/api/paas/v4上按标准 API 计费,即使套餐还有剩余额度,也会扣余额;配在套餐端点上才用套餐额度。
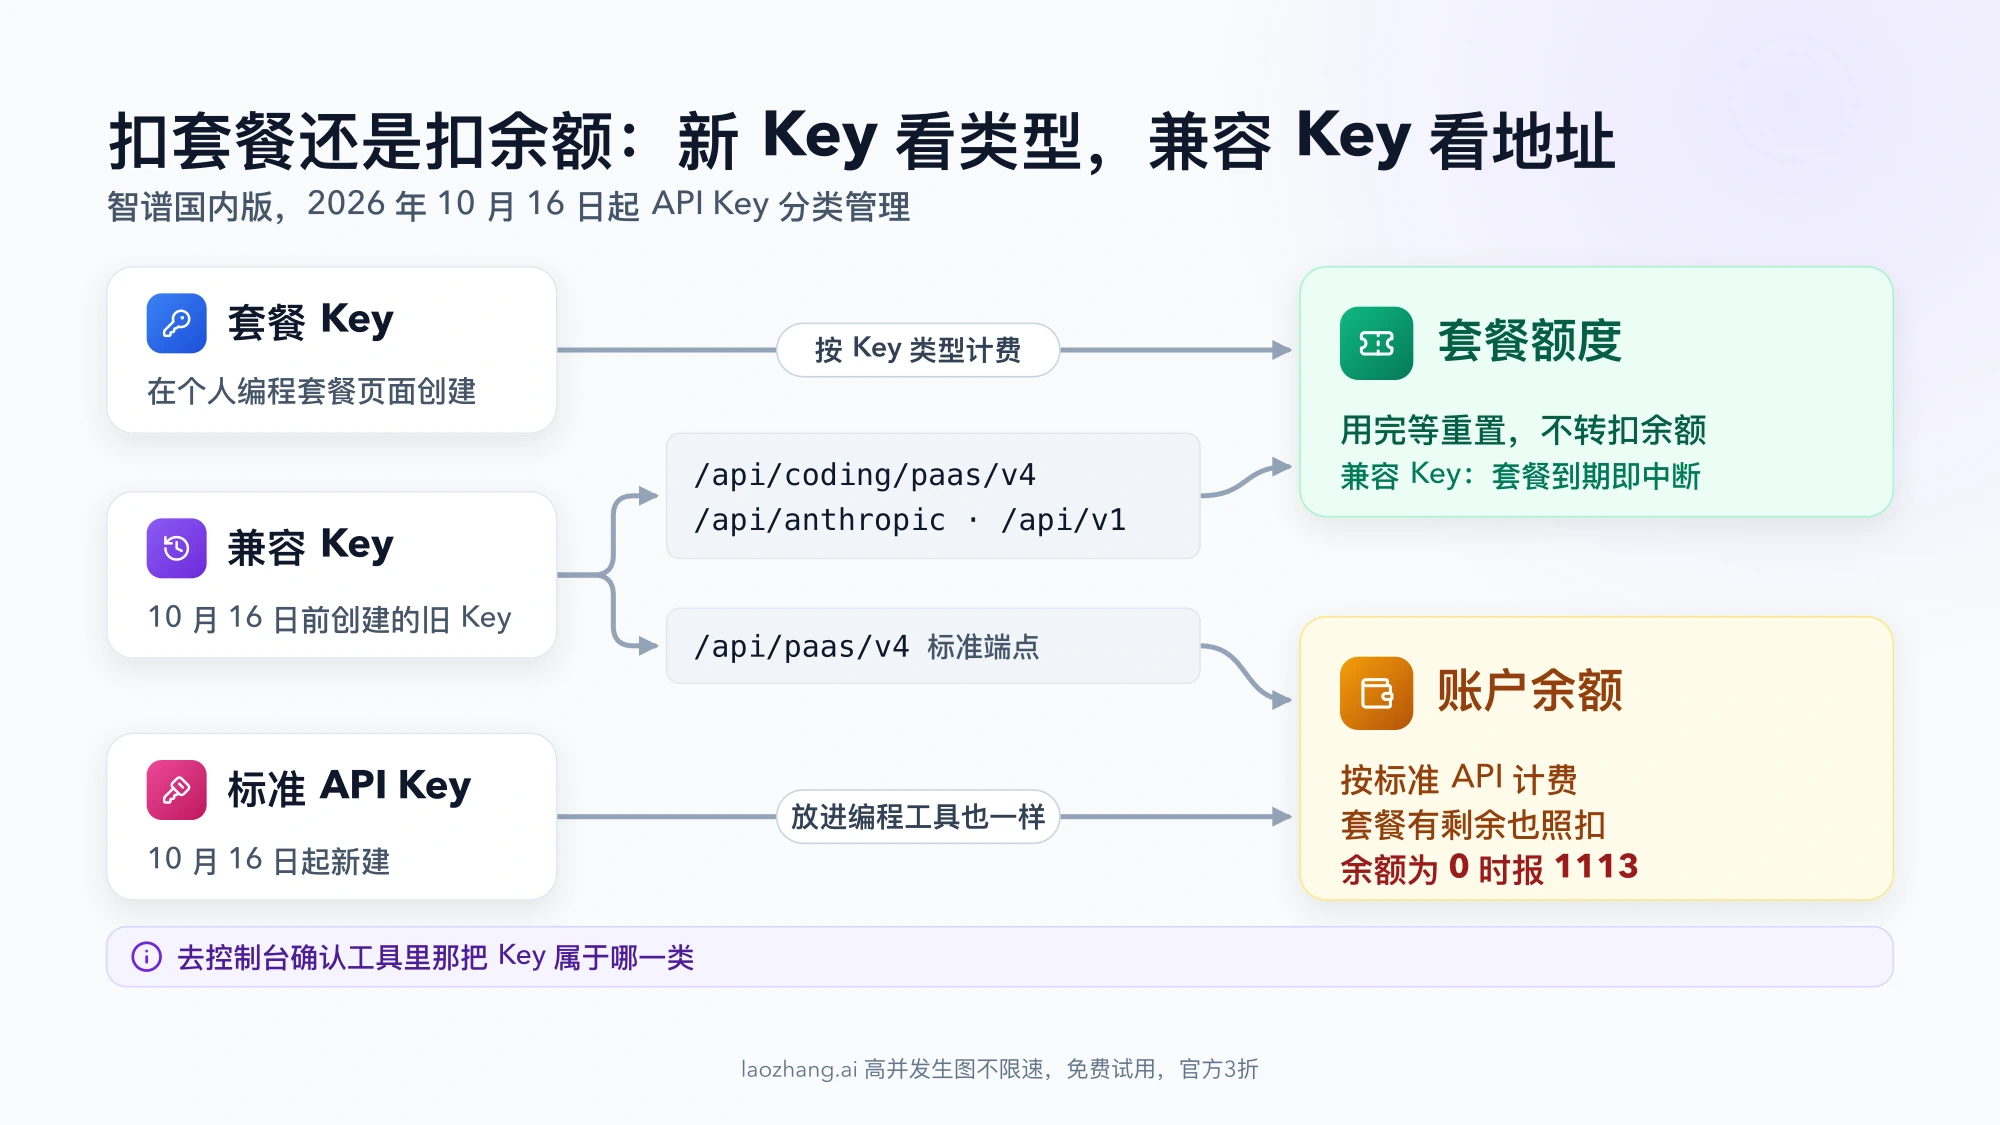
所以排查 1113 的第一步,是去控制台确认工具里填的那把 Key 属于哪一类。最近新建过 Key、又刚好是在"API Key"页面建的,多半就是这个原因。
套餐对应的 Base URL
| 用途 | 国内版 BigModel | 国际版 Z.ai |
|---|---|---|
| Claude Code(Anthropic 协议) | https://open.bigmodel.cn/api/anthropic | https://api.z.ai/api/anthropic |
| Cline、Roo Code、OpenCode、Kilo Code 等(OpenAI Chat Completions) | https://open.bigmodel.cn/api/coding/paas/v4 | https://api.z.ai/api/coding/paas/v4 |
| Cherry Studio | https://open.bigmodel.cn/api/coding/paas/v4/(末尾 带 /) | — |
| Codex(OpenAI Responses) | https://open.bigmodel.cn/api/v1 | https://api.z.ai/api/v1 |
| 标准 API,不走套餐 | https://open.bigmodel.cn/api/paas/v4 | https://api.z.ai/api/paas/v4 |
最常见的错误是把 /api/coding/paas/v4 写成 /api/paas/v4,少了 coding 这一段。用兼容 Key 时,这一处就决定了扣套餐还是扣余额。
地址填对了还是 1113
- 工具可能没用你填的地址:有 Hermes Agent 用户报告,工具某些代码路径把
/api/paas/v4写死了,主对话改对地址后正常,其他功能仍然报 1113(issue #18302)。看工具日志里实际请求的 URL,而不是配置文件里写的。Claude Code 用户可以用/status核对实际生效的地址,具体步骤见 Claude Code ANTHROPIC_BASE_URL 不生效:先看 /status 再按报错修复。 - 平台串了:国内版的 Key 填到
api.z.ai,或者反过来,都不会走套餐。 - 工具不在支持列表:套餐只能在官方支持的工具里用,包括 Claude Code、Codex、OpenCode、Cline、Roo Code、Kilo Code、Cursor、TRAE、Hermes Agent、OpenClaw 等,完整列表以官方工具页为准。
- 最后用费用明细验证:改完后在工具里正常发一次请求,到费用明细的抵扣资源包一列看是不是套餐抵扣的。
1309、1311、1314、1315:套餐到期或模型、Key 不对应
这几个码都说明请求不在当前套餐的覆盖范围内,等待和重试都没用,要改的是订阅或配置。
- 1309 套餐已到期:到 bigmodel.cn/claude-code 续订后恢复。注意,兼容 Key 在套餐到期后不会自动转成按量计费,在套餐端点上会直接中断;想先按量用着,要新建一把标准 API Key 替换进工具,官方说明原调用地址可以不变,账户里要有余额。
- 1311 套餐未开放该模型:所有套餐支持 GLM-5.3 和 GLM-5.3-Flash。请求 GLM-5.2、GLM-5.1 会自动切到 GLM-5.3,GLM-5-Turbo、GLM-4.7 会自动切到 GLM-5.3-Flash;报 1311 说明工具里配了这些之外的模型名,改回套餐支持的模型。
- 1314 企业套餐已失效、1315 Key 仅限企业编程套餐场景:这是企业账号的问题,前者找企业管理员,后者换成对应产品类型的 Key。
1313 公平使用限制:在控制台申请解除,别换号硬刷
1313 的完整原文是「您的账户当前使用模式不符合公平使用策略,请求频率已受到限制。详情请参阅《条款与协议-订阅及自动续费协议》,如需恢复请前往个人中心-编程套餐总览-顶部申请解除限制」。它是风控处置,不会因为等一会儿或重试就消失。
处理步骤:
- 打开控制台的 套餐概览,查看风控提示,按页面顶部的入口申请解除限制或发起申诉。
- 对照使用规范自查:套餐只限订阅人本人、只限官方支持的工具;接进自建应用、网站、机器人或 SaaS,共享账号,转售或中转,都属于违规。
- 有异议的,通过官方客服渠道申诉,附上报错原文和请求 ID,不要发送完整 API Key。
触发 1313 的具体阈值和判定逻辑,官方明确表示不公开。违规会被限流、冻结,3 次以上可能封号;用小号、轮换 Key 或中转池绕开,只会让后果更重。
等不了额度重置:改用标准 API Key 按量付费
额度窗口用完、任务又不能停,官方路线是临时改用标准 API 按量付费:
- 在控制台的 标准 API Key 页面 新建一把标准 API Key,确认账户有余额或可用的普通资源包。
- 把工具里的套餐 Key 换成这把标准 Key。按 10 月 16 日的新规则,标准 Key 在支持的端点上一律按标准 API 计费,不消耗也不会恢复套餐额度。
- 额度恢复后换回套餐 Key,避免继续扣余额。
国内版标准 API 的人民币价格以控制台当日显示为准。Z.ai 国际版按量价格是 GLM-5.3 每百万 token 输入 $1.4、缓存命中输入 $0.26、输出 $4.4(Z.ai 价格页)。GLM-5.3-Flash 的 API 接入和成本,可以参考 GLM-5.3-Flash:Ox Alpha 迁移、API 成本与本地部署条件。
如果你需要一个不依赖智谱账户的按 token 付费备选,laozhang.ai 提供 glm-5.2,输入每百万 token $1.142、输出 $3.997,支持 Anthropic Messages 和 OpenAI 兼容两种接口,Claude Code 里把 ANTHROPIC_BASE_URL 设为 https://api.laozhang.ai 即可(模型列表)。需要清楚它的边界:模型是 GLM-5.2 而不是套餐里的 GLM-5.3,单独计费、有自己的限额,和你的 Coding Plan 额度没有关系,既不会消耗、也不能恢复套餐额度,解决不了套餐本身的 429。
如果频繁 1302 或额度不够已经影响工作,换模型也是一个选项,两条路线的接入、成本和代理能力对比见 GLM-5.3 与 DeepSeek V4 Pro 怎么选:接入、成本与 Agent 能力。
GLM Coding Plan 429 常见问题
GLM Coding Plan 的 5 小时额度几点重置?
没有固定时间点。5 小时积分在每次消耗 5 小时后滚动恢复,周积分从下单时起每 7 天刷新。最准的时间是 1308、1310 报错原文里的 next_flush_time,或者控制台用量统计页面显示的进度。
明明还有额度,为什么还是 429?
额度只对应 1308、1310 这类错误。用量统计还有积分时收到 429,常见的是 1302(并发太高)、1305(模型繁忙或请求内容触发)、1113(Key 或 Base URL 让请求走了按量计费)和 1313(公平使用限制),先看错误码再处理。
套餐额度用完会不会扣账户余额?
不会。套餐额度耗尽后只能等恢复,系统不会转去扣余额或其他资源包。真正会扣余额的是两种配置:在编程工具里用了标准 API Key,或者兼容 Key 配在了 /api/paas/v4 标准端点上,这两种从第一次请求起就按量计费。
智谱国内版的 Key 能在 Z.ai 上用吗?
不能。国内版(open.bigmodel.cn)和国际版 Z.ai(api.z.ai)是两套账号和控制台,Key、套餐、Base URL 都不通用。
NVIDIA 上调用 GLM 报 429,和 Coding Plan 有关系吗?
没有关系。NVIDIA 托管的 GLM 端点有自己的速率限制,开发者论坛上也有人反映容易触发 429,但它不消耗也不受 GLM Coding Plan 额度影响,按 NVIDIA 那边的规则处理。