Ox Alpha 确实是 GLM-5.3-Flash。 智谱在 2026 年 8 月 26 日的官方发布说明中确认,正式发布前曾用匿名模型 Ox-Alpha 在 OpenCode 和 OpenRouter 接受真实流量测试。现在应使用的正式模型 ID 是 glm-5.3-flash,而不是继续把匿名入口当作长期可用的正式服务。
这次变化同时带来三个可以直接行动的结论:
- 托管 API 已有明确模型 ID、请求参数和按 token 价格;
- GLM Coding Plan 的“3 倍额度”是订阅积分规则,不能换算成 API 单价;
- 开源权重已经可下载,但“18B 激活参数”不代表只要 18 GB 内存。官方 FP8 仓库本身约 305.8 GiB,运行时和上下文缓存还要额外空间。
本文于 2026 年 9 月 12 日重新读取官方仓库的文件元数据,核对了 62 个 safetensors 分片的总大小。这里没有下载并启动完整模型,也没有吞吐或质量实测。以只有 16 GB 统一内存的 M4 机器为例,仅权重大小就远超内存容量,应在下载前停止这条原生部署方案;下面说明如何自行核算。
从 Ox Alpha 迁移,先把“身份”与“接口”拆开
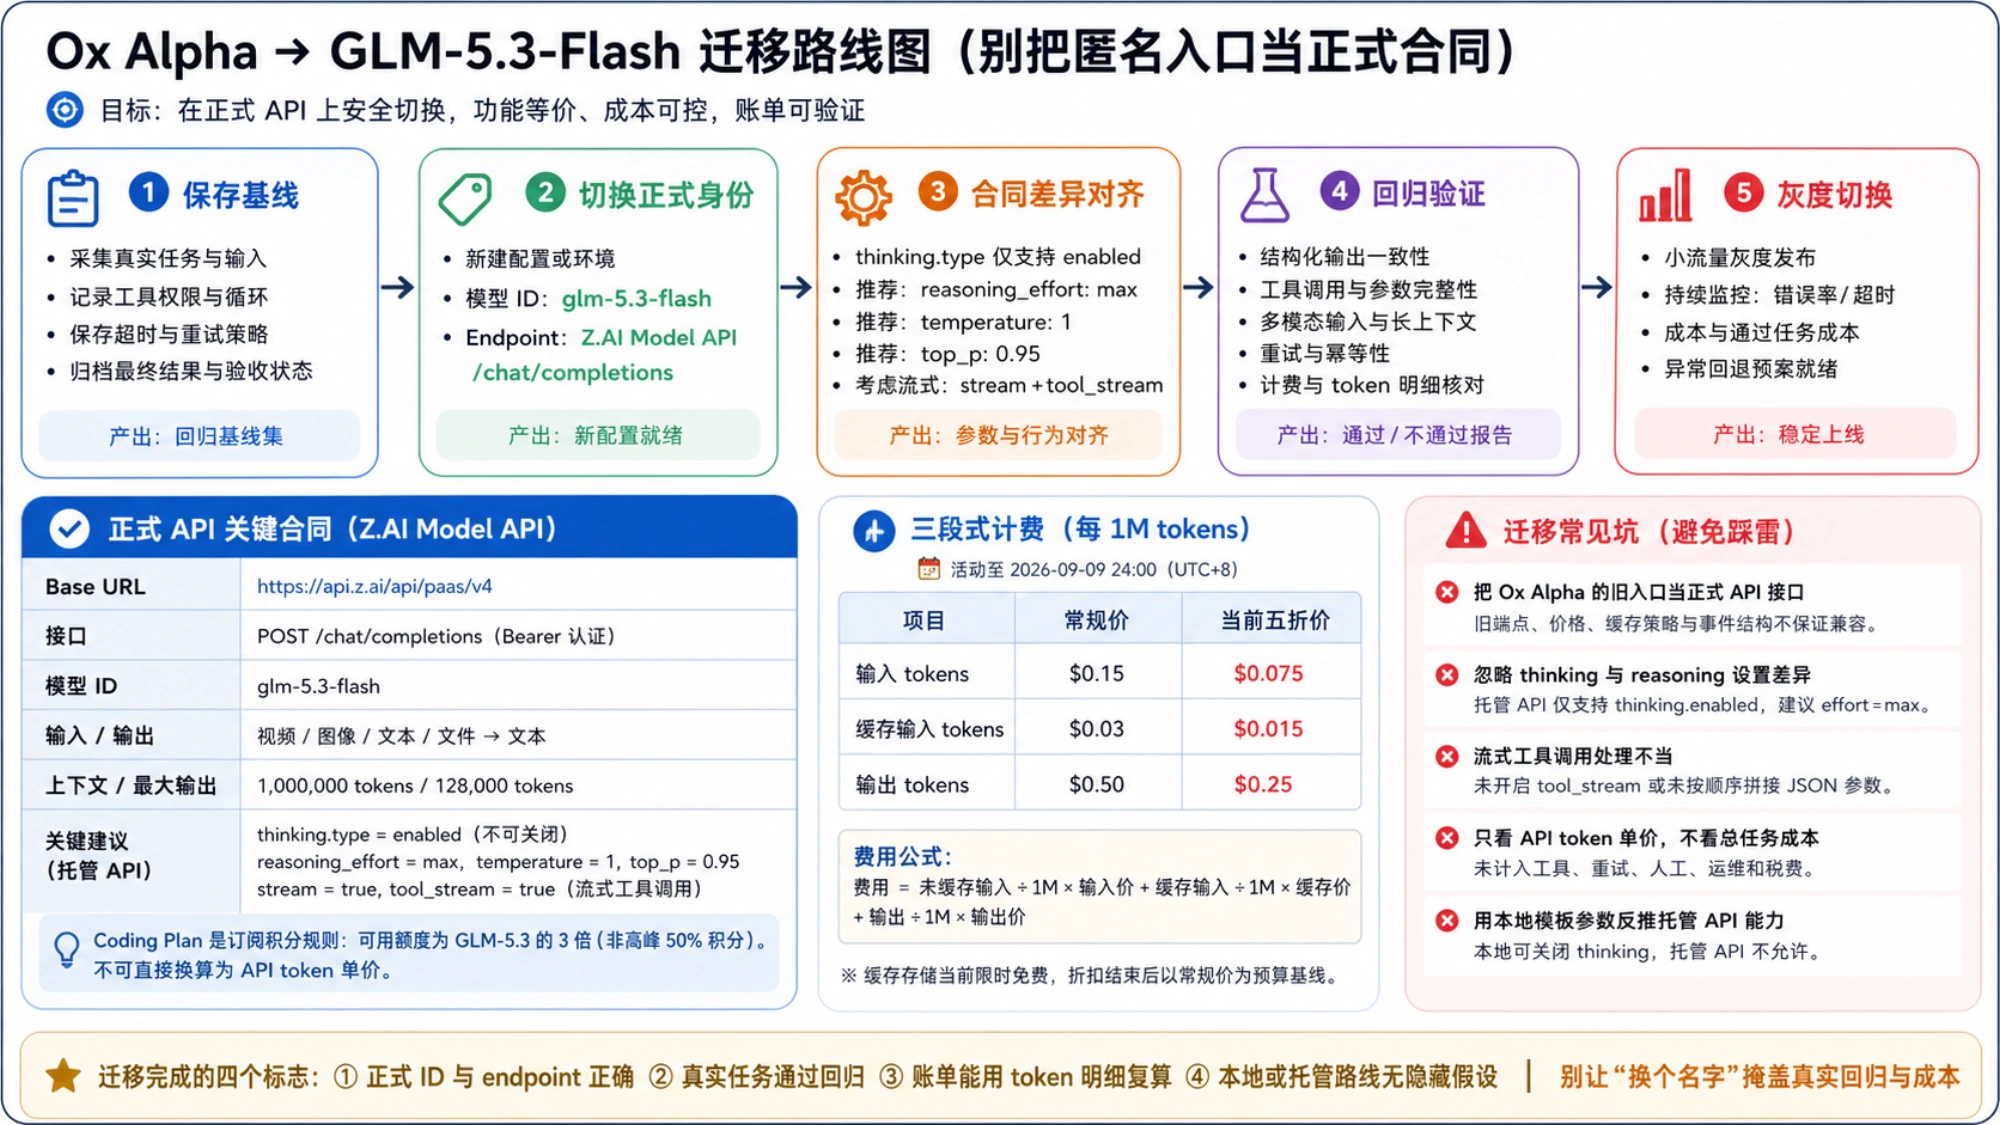
匿名测试证明的是模型曾在真实工作流中被使用,不证明 OpenCode、OpenRouter、Z.AI Model API 与本地服务共享同一接口地址、价格、缓存或返回事件。最稳妥的迁移动作不是替换一串名称后直接上线,而是把正式模型当作一套需要重新验证的服务配置:
- 保存一批 Ox Alpha 的真实输入、工具权限、超时、最终结果和验收状态,作为回归基线;
- 在你选择的正式服务中创建新配置,模型写成
glm-5.3-flash; - 明确启用思考,并重新处理推理内容、最终正文和流式工具参数;
- 用相同任务验证结构化输出、工具循环、多模态输入、重试与计费;
- 只有新路径通过验收后,才逐步切换生产流量。
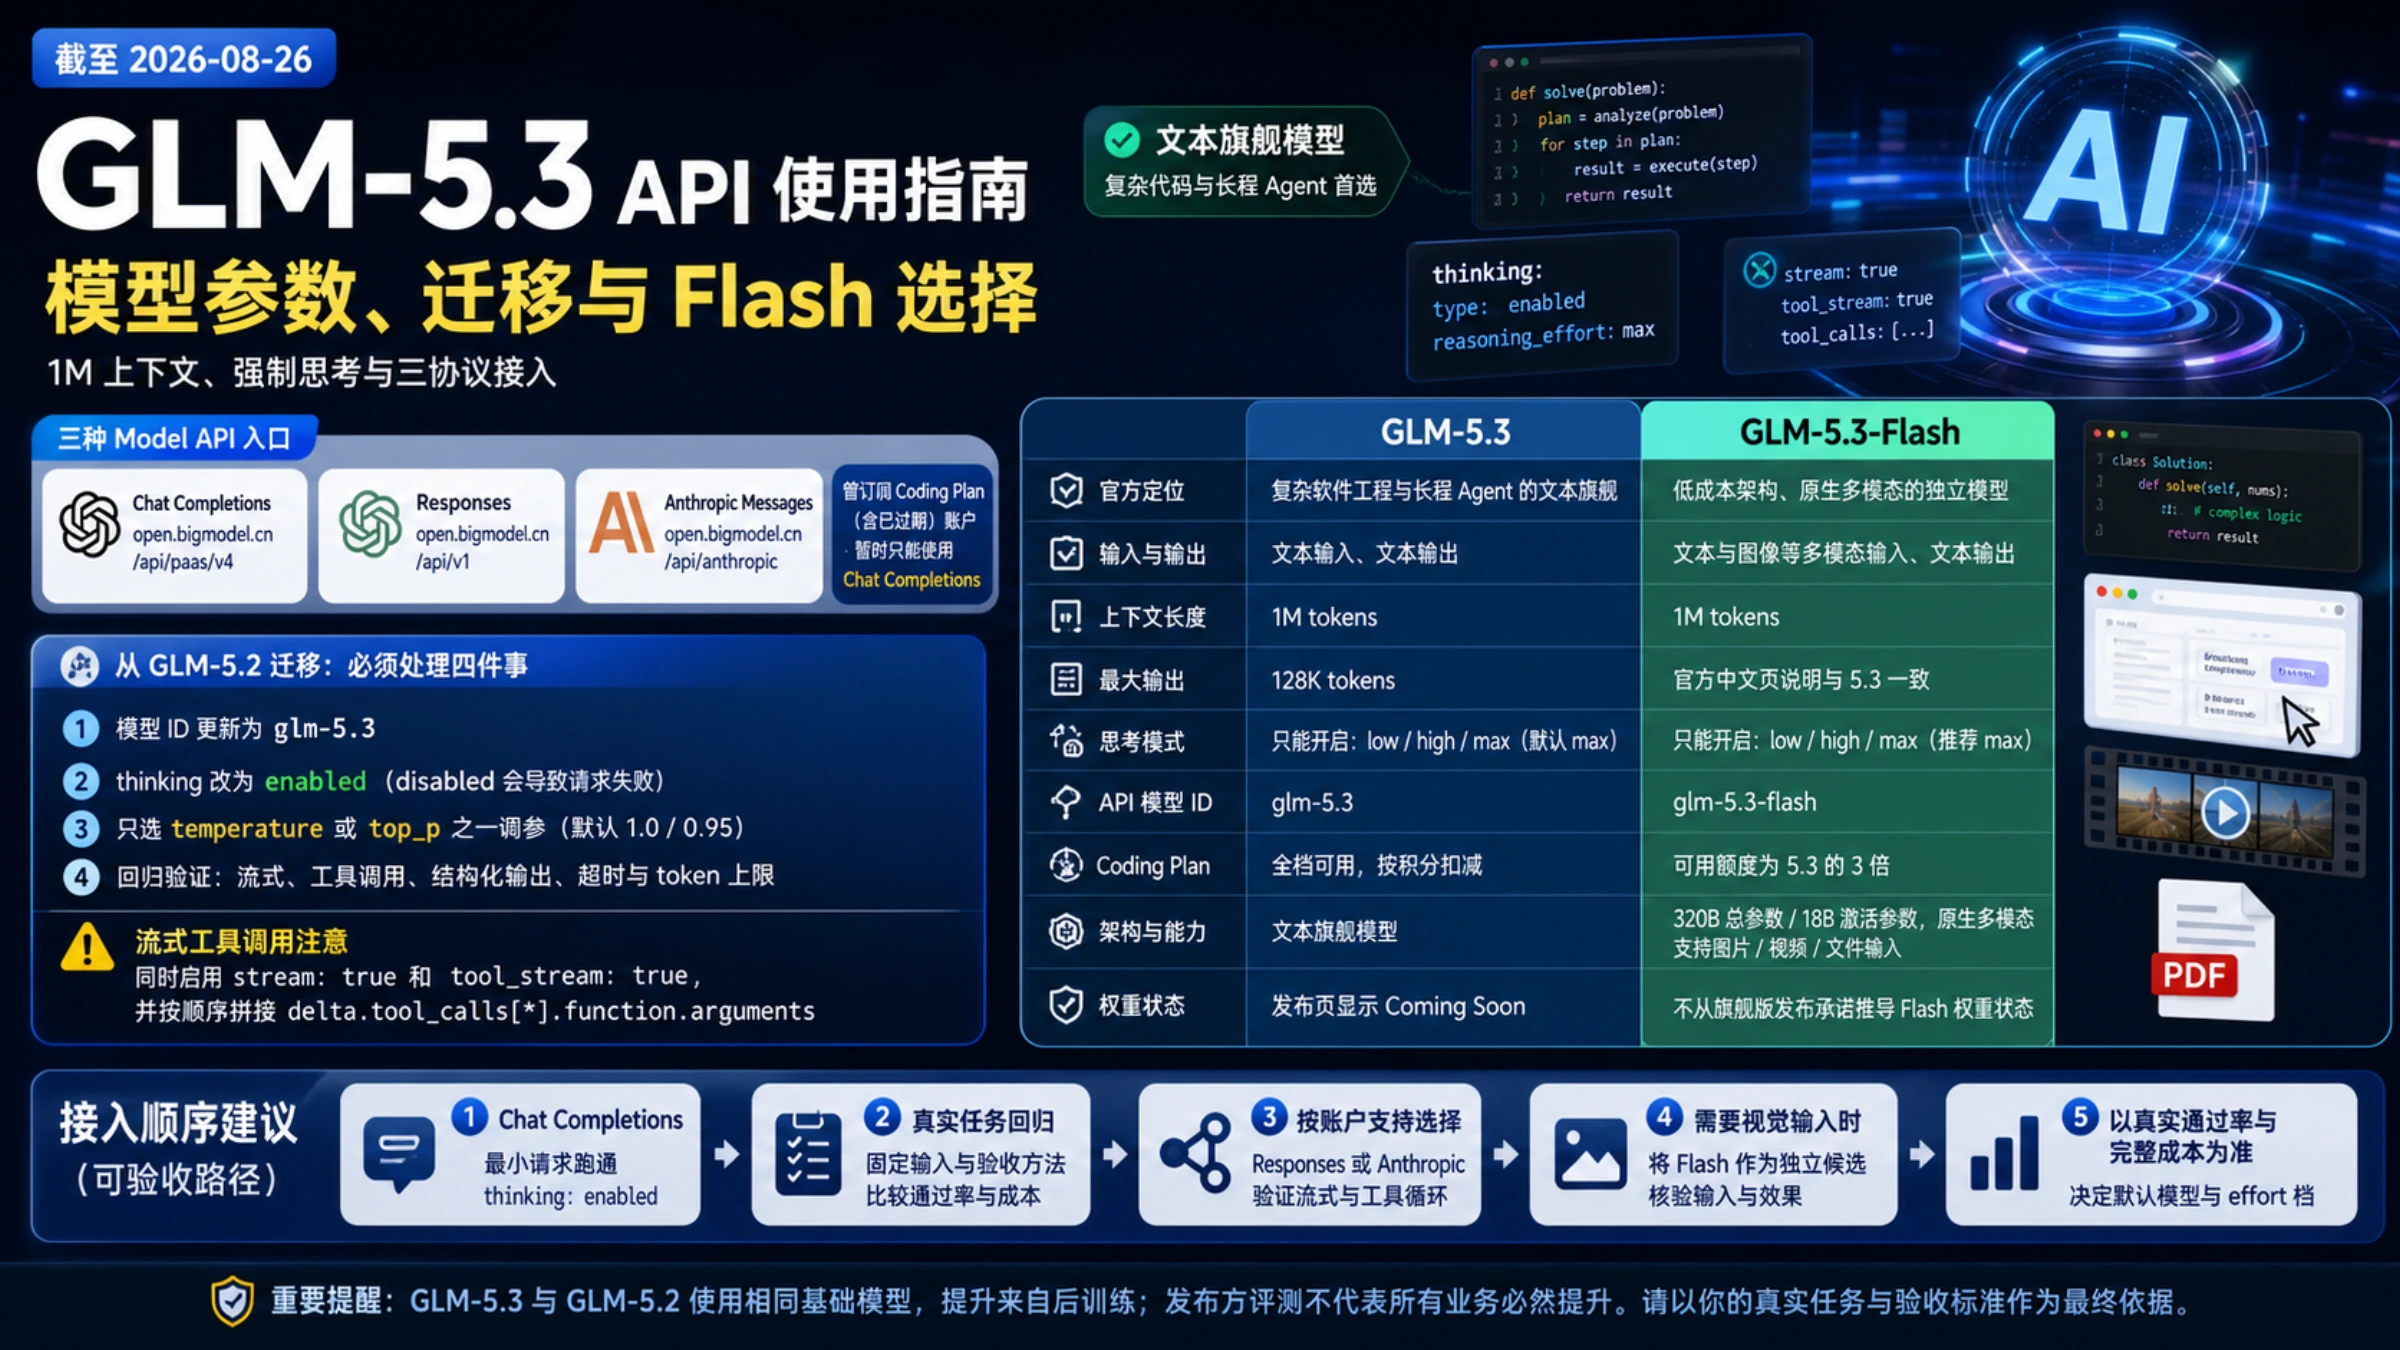
Z.AI 的模型文档列出视频、图像、文本和文件输入,输出为文本;上下文上限为 1M tokens,最大输出为 128K。托管 API 中 thinking.type 只支持 enabled,推荐 reasoning_effort: "max"。这意味着旧配置如果假设可以关闭思考,就不能原样搬过来。
下面是 Z.AI 通用 Model API 的最小 Chat Completions 请求。其官方 API 说明给出的 base URL 是 https://api.z.ai/api/paas/v4;Coding Plan 使用专用接口地址,不能把两种接口混成一个示例。
export ZAI_API_KEY="替换为你自己的密钥"

curl -sS "https://api.z.ai/api/paas/v4/chat/completions" \
  -H "Authorization: Bearer ${ZAI_API_KEY}" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [
      {
        "role": "user",
        "content": "迁移计划:保留旧模型配置,先离线比较十个历史任务,再把少量新请求交给新模型。请指出风险、验收条件和第一步。"
      }
    ],
    "thinking": { "type": "enabled", "clear_thinking": false },
    "reasoning_effort": "max",
    "temperature": 1,
    "max_tokens": 4096
  }'
这段请求是依据当前官方文档整理的可复制起点,尚未经过付费 API 调用验证,不能当作成功响应的证明。真正接入时至少记录 HTTP 状态、首个 token 的等待时间、总耗时、输入及输出用量、缓存用量、工具循环状态和业务验收结果。只得到 HTTP 200 仍不能说明迁移成功。
官方建议在流式工具调用时同时开启 stream: true 与 tool_stream: true,按顺序拼接 delta.tool_calls[*].function.arguments,并分别处理思考内容与最终答案。不要把尚未完整的 JSON 参数直接交给工具,也不要因为客户端只显示最终文字就丢弃诊断所需的流式事件。
API 当前价格与已结束的五折活动
截至 2026 年 9 月 12 日,Z.AI 官方价格页按每百万 tokens 列出三项费用:
| 项目 | 当前常规价 | 已结束活动的五折价 |
|---|---|---|
| 输入 tokens | $0.15 | $0.075 |
| 缓存输入 tokens | $0.03 | $0.015 |
| 输出 tokens | $0.50 | $0.25 |
五折活动已于 2026 年 9 月 9 日 24:00(UTC+8) 结束,当前应按常规价做预算。表中活动价只用于核对历史费用;缓存存储仍标为限时免费,也不能视为永久价格。
一次请求的模型费用可以写成:
费用 = 未缓存输入 ÷ 1,000,000 × 输入价 + 缓存输入 ÷ 1,000,000 × 缓存价 + 输出 ÷ 1,000,000 × 输出价
例如,一次任务消耗 1,000,000 个未缓存输入 tokens 和 100,000 个输出 tokens:
- 活动期:
1 × $0.075 + 0.1 × $0.25 = $0.10; - 常规价:
1 × $0.15 + 0.1 × $0.50 = $0.20。
如果同样的 1,000,000 输入中有 90% 命中缓存,且仍输出 100,000 tokens:
- 活动期:
0.1 × $0.075 + 0.9 × $0.015 + 0.1 × $0.25 = $0.046; - 常规价:
0.1 × $0.15 + 0.9 × $0.03 + 0.1 × $0.50 = $0.092。
这两个算例只比较模型 token 费用,不含工具调用、联网搜索、失败重试、税费、汇率或人工修复。真正有意义的分母不是“每次请求”,而是“每个通过验收的任务”:
通过任务成本 =(模型 + 工具 + 重试 + 人工 + 运维)÷ 通过任务数
GLM Coding Plan 则使用订阅与积分配额。官方说 Flash 的可用额度相对 GLM-5.3 增至 3 倍,非高峰调用只消耗 50% 标准积分;这些规则适合比较编码工具里的可用量,却不能直接填进上面的 Model API 公式。
下载前先检查:原生权重约 305.8 GiB
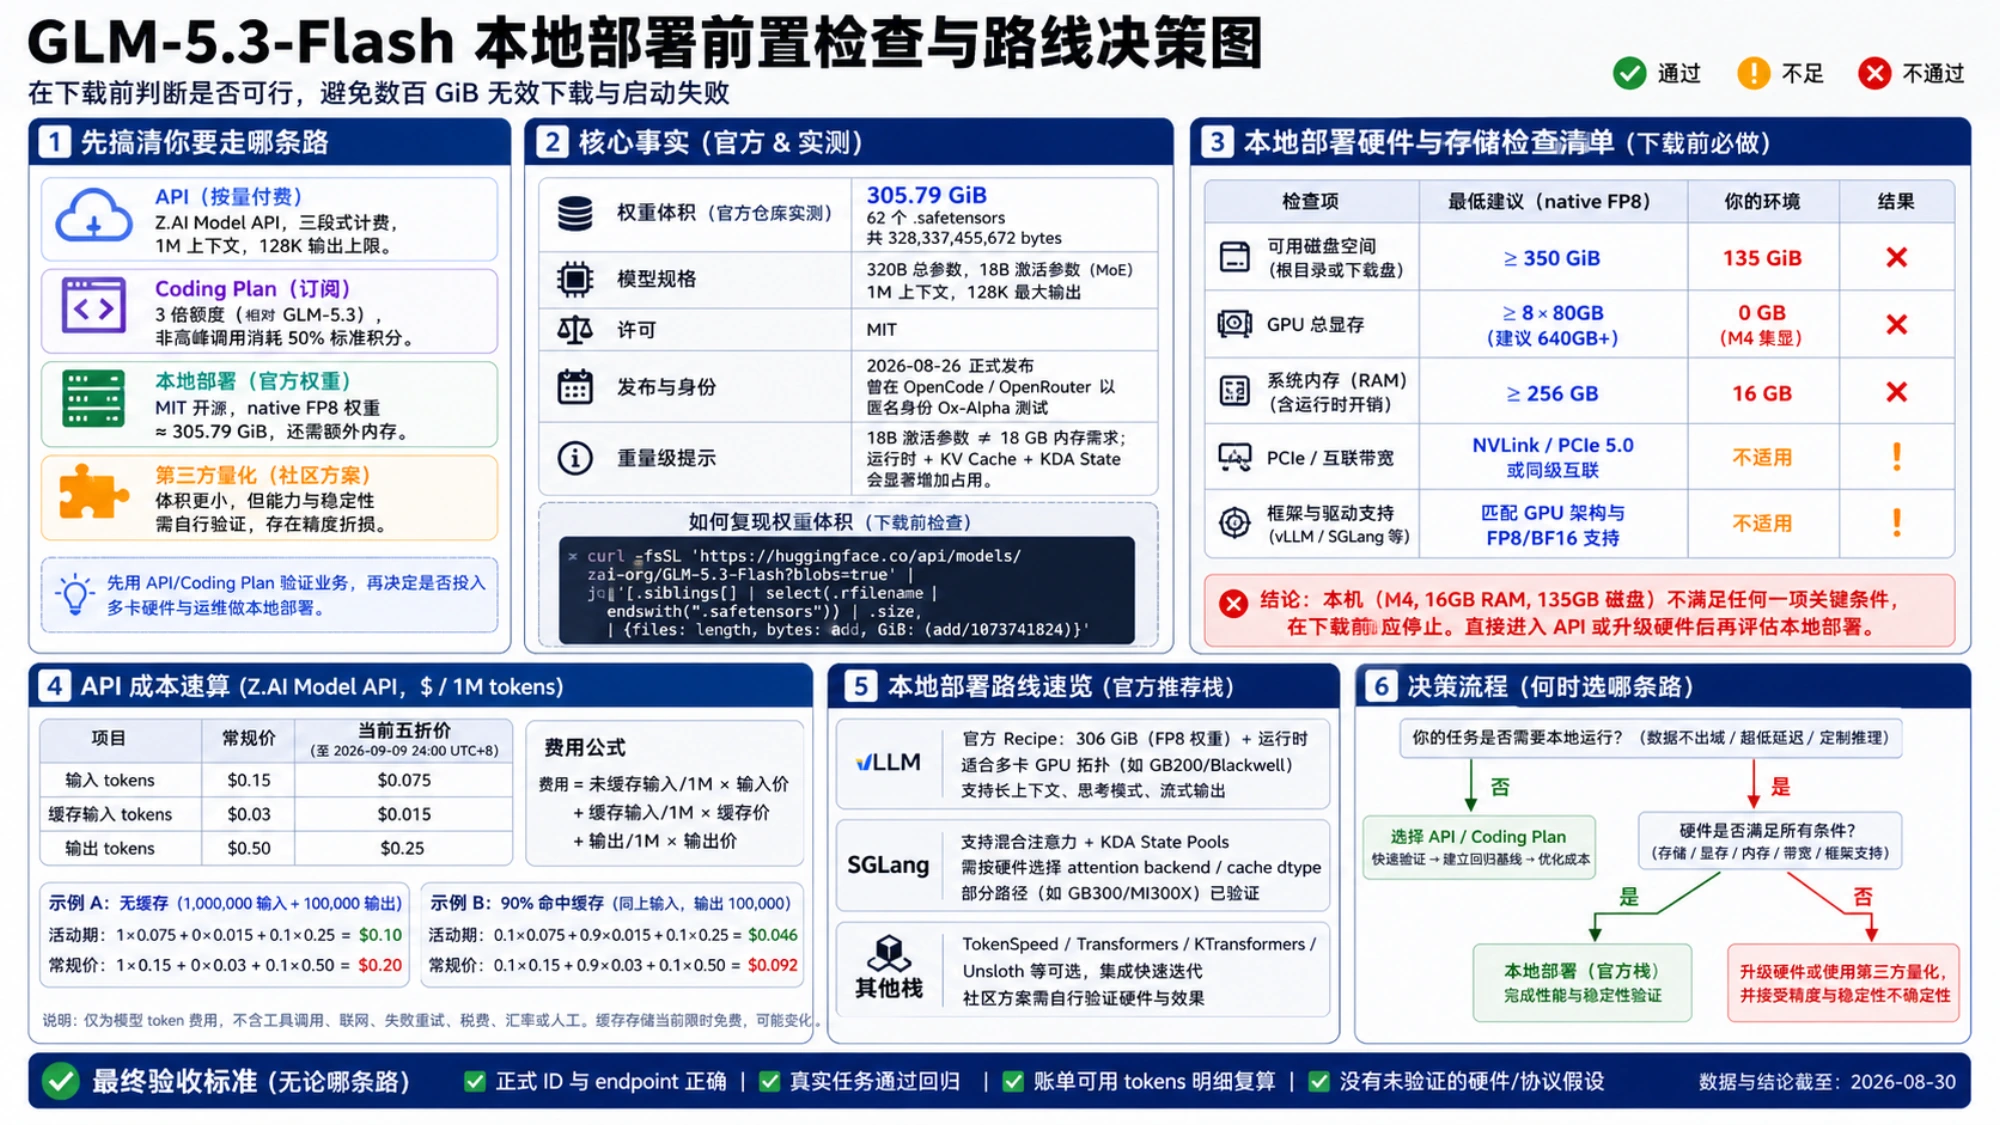
GLM-5.3-Flash 是 320B 总参数、18B 激活参数的 MoE 模型。18B 描述的是每个 token 参与计算的激活参数规模,不是完整权重只占 18B 级内存。官方 Hugging Face 模型仓库采用 MIT 许可;2026 年 9 月 12 日通过公开文件元数据接口核对,62 个 .safetensors 合计 328,337,455,672 bytes,约 305.79 GiB。
vLLM 官方部署指南也说明,原生 FP8 权重约为 306 GiB,还未计入运行时与 KV 缓存开销。BF16 版本的权重内存约为两倍。长上下文还会占用 KV cache;混合注意力架构另外维护 KDA state pool,并发可能先被这部分内存限制。
你可以在下载前自己复现权重体积:
curl -fsSL \
  'https://huggingface.co/api/models/zai-org/GLM-5.3-Flash?blobs=true' |
jq '[.siblings[]
  | select(.rfilename | endswith(".safetensors"))
  | .size]
  | {files: length, bytes: add, GiB: (add / 1073741824)}'
然后检查本机资源。macOS 可运行:
sysctl -n hw.memsize
df -h /
Linux 服务器可运行:
free -h
df -h /
nvidia-smi --query-gpu=name,memory.total --format=csv
例如,若机器只有 16 GB 统一内存,或者可用磁盘不足 305.79 GiB,就不应开始下载这套原生权重。先检查资源能避免无效下载,但它只给出部署可行性的初步判断,不能替代模型启动和实际任务测试。
硬件通过后,也不要用一条通用命令假装生产可用
官方模型卡列出 SGLang、vLLM、TokenSpeed、Transformers、KTransformers 和 Unsloth。这些框架的支持成熟度与硬件要求不同。当前 vLLM 部署示例采用多卡 GPU,示例包括 TP4 的 GB200;SGLang 部署指南还区分 Blackwell、H100/H200 与 AMD ROCm 的缓存数据类型、注意力后端和已验证范围。
因此,采购或启动前至少写下这些验收条件:
- 权重能放入本地存储,并预留下载临时文件、容器镜像和日志空间;
- GPU/加速器总内存不仅覆盖权重,还覆盖 runtime、KV cache、KDA state、视觉编码峰值与并发;
- 所选推理框架的当前版本明确支持该 GPU、FP8/BF16 类型和 GLM-5.3-Flash 架构;
- 用固定的输入输出长度测试启动、首 token、吞吐、并发、工具调用与多模态;
- 在相同任务与验收条件下比较托管 API 总成本,而不是只比较电费或 token 标价。
本地模板与托管 API 也有一个容易踩错的差异:官方托管 API 写明思考不能关闭;本地 SGLang 示例则允许通过聊天模板参数改变思考行为。它们适用于不同的运行方式,不能用本地能力反推托管 API 会接受相同参数。
如果你的目标只是尽快验证业务任务,先用正式 Model API 建立回归与成本数据通常更省时间。只有当数据边界、稳定吞吐、长期利用率或定制推理确实能抵消多卡硬件与运维成本时,本地部署才进入下一轮采购评估。若还需要比较 GLM 与其他新模型,可再看 GLM-5.3 与 DeepSeek V4 Pro 选型指南;它解决的是模型选择,而这里解决的是从匿名测试迁移到正式服务。
最终迁移完成的标志,不是配置里出现了新模型名,而是四件事同时成立:正式 ID 与接口地址正确、真实任务通过回归、账单能用 token 明细复算、本地或托管路线都没有隐藏未验证的硬件与协议假设。