
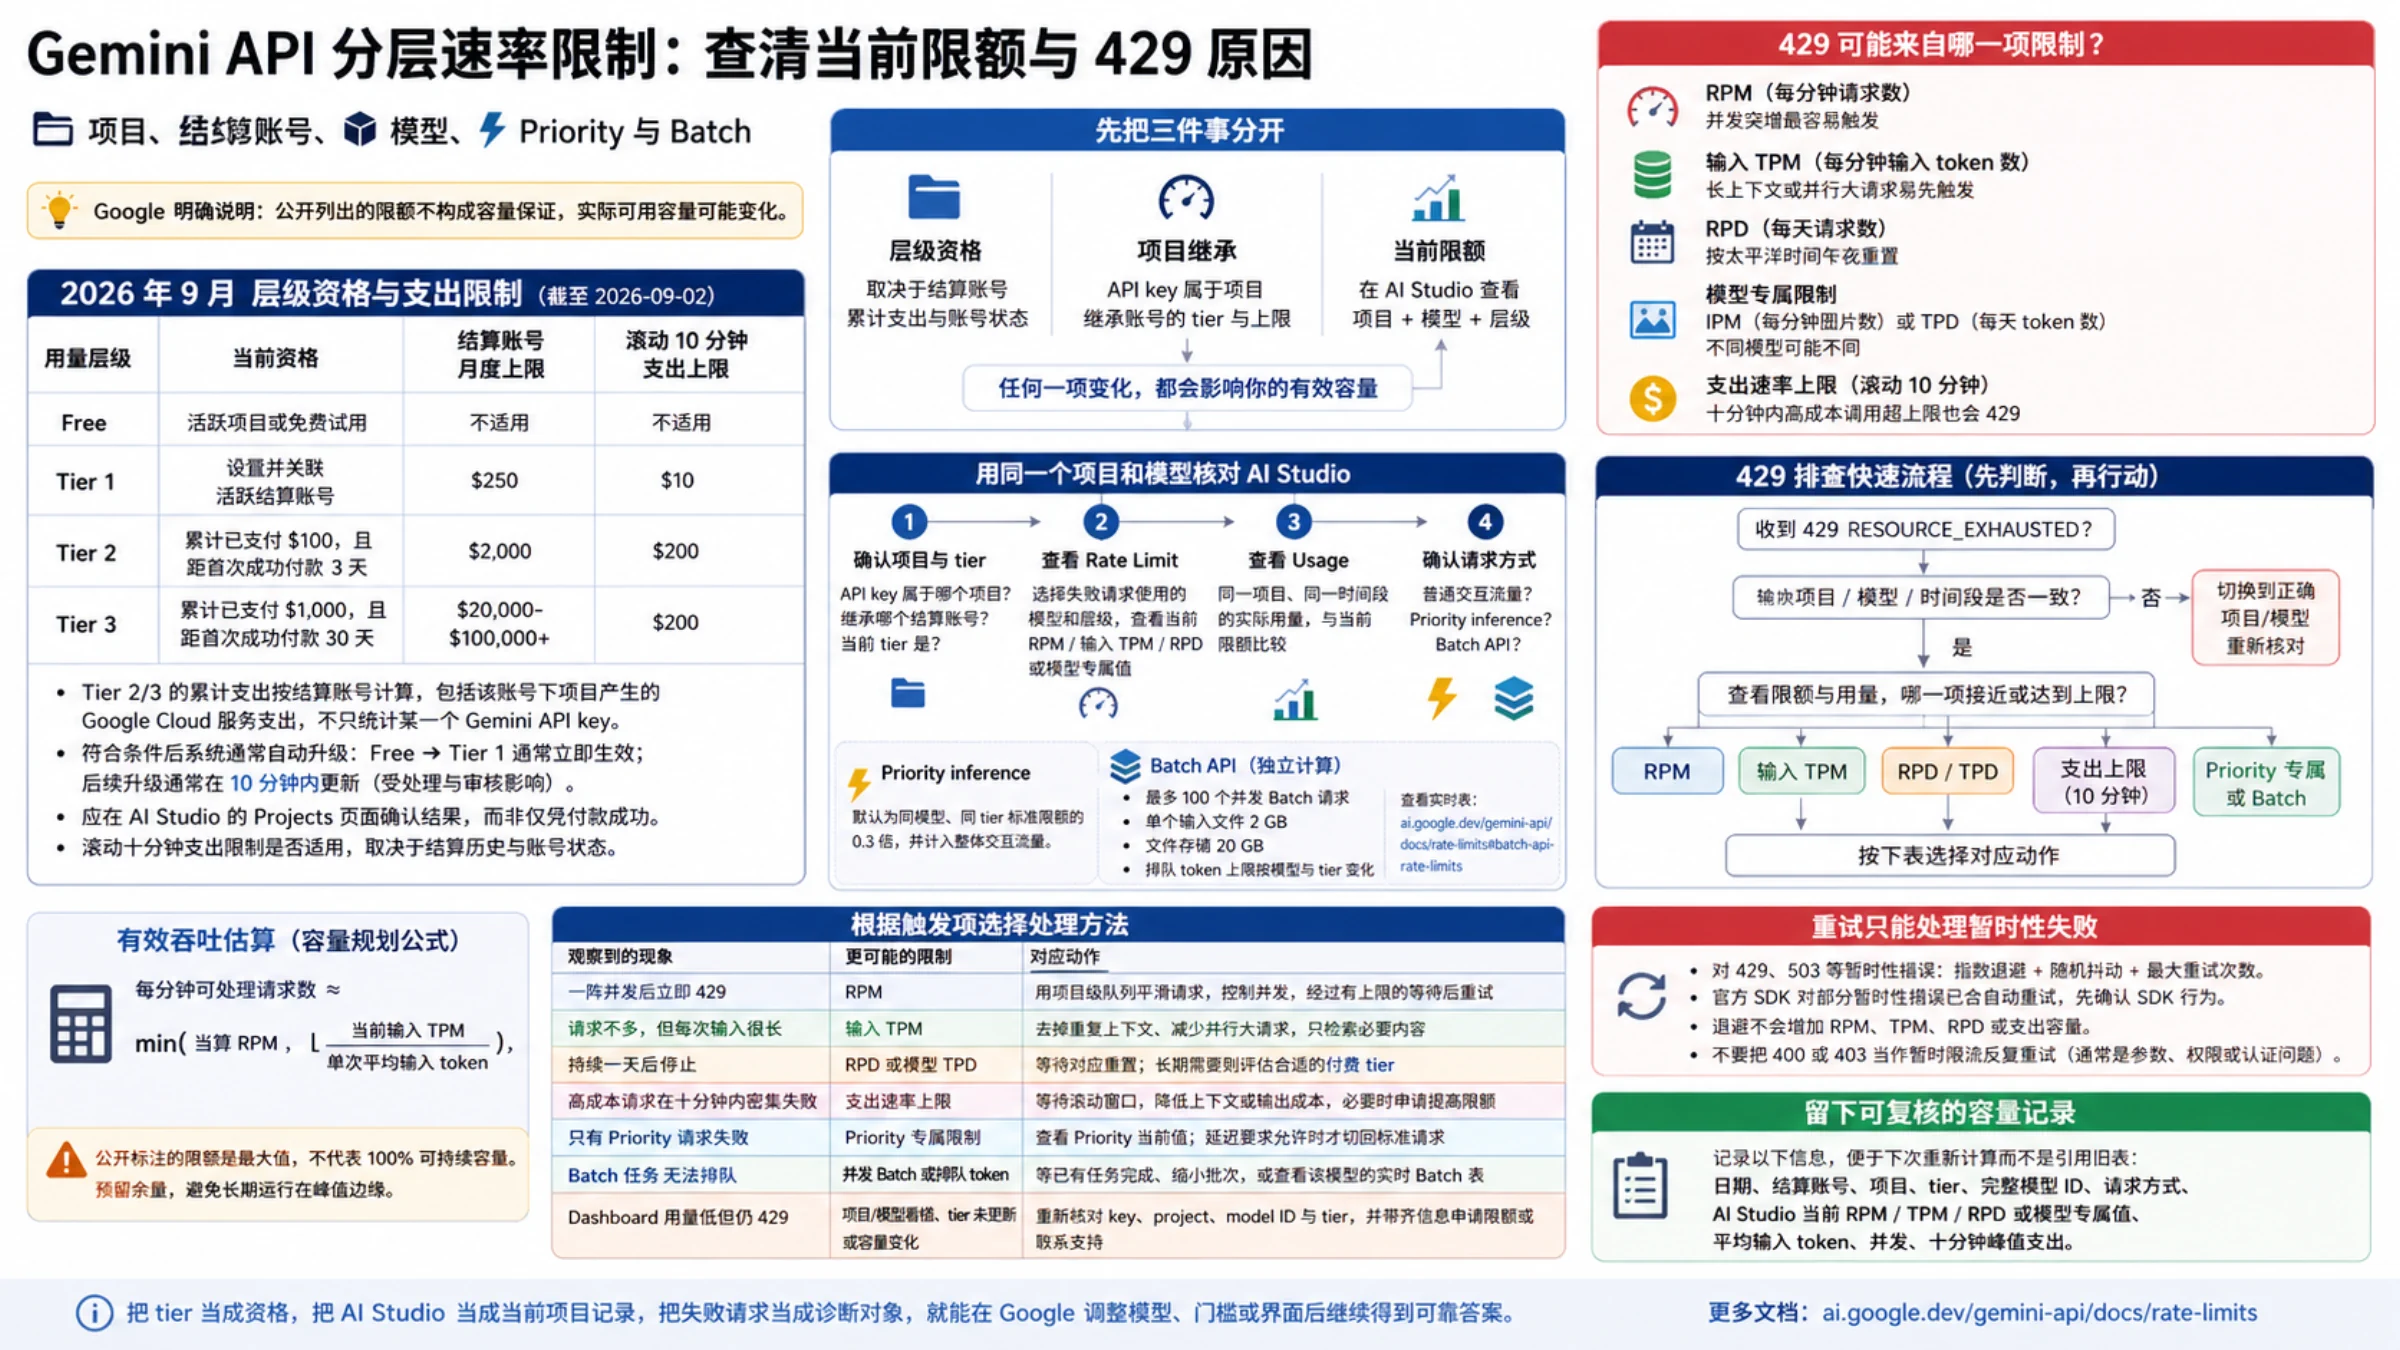
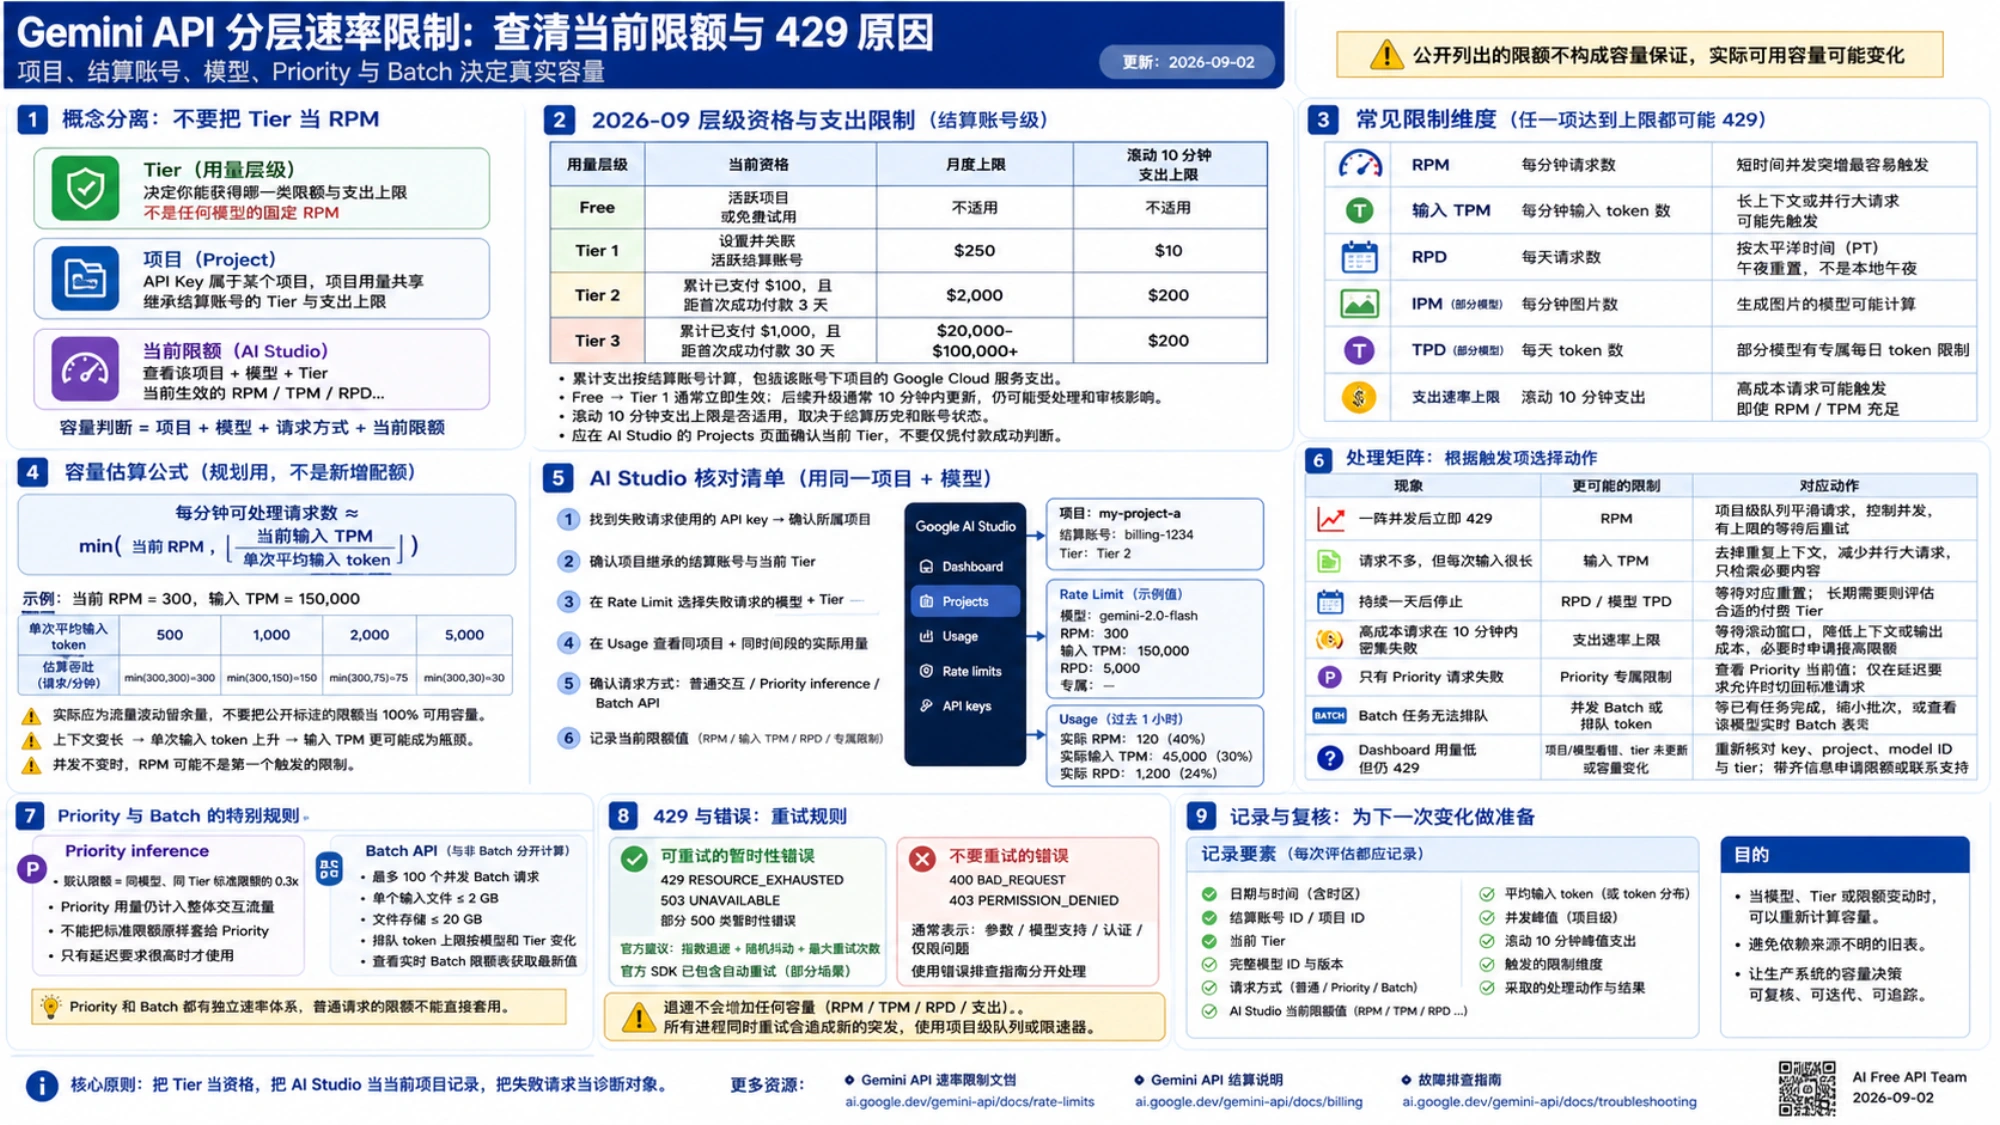
Gemini API 的 Free、Tier 1、Tier 2、Tier 3 不能简单换算成“每分钟固定能发多少次请求”。Google 当前要求开发者在 AI Studio 查看项目和模型的生效限额,并明确说明公开列出的限额不构成容量保证,实际可用容量可能变化。
因此,遇到 429 RESOURCE_EXHAUSTED 时,先不要拿旧文章里的 RPM 数字作结论。真正要确认的是:请求用了哪个项目、继承哪个结算账号与用量层级、调用哪个模型和版本、走普通请求还是 Priority/Batch,以及哪一项当前限额被触发。
先把层级、项目和当前限额分开
Google 的 Gemini API 速率限制文档 把 tier 作为影响限额的因素之一,而不是一张适用于所有模型的永久配额表。
一次容量判断至少要看三处信息:
- Projects / API keys:确认 API key 属于哪个项目,项目关联哪个结算账号,以及当前 tier。
- Dashboard 的 Rate Limit:查看该项目、模型和层级当前生效的 RPM、输入 TPM、RPD 或模型专属限制。
- Dashboard 的 Usage:把同一项目、同一时间段的实际用量与当前限额比较。
API key 本身没有独立的层级或结算配置。一个项目内的多个 key 共享项目用量;创建更多 key 不会把 RPM 或 TPM 乘倍。项目关联到结算账号后,还会继承该结算账号的 tier 与账号级支出上限。
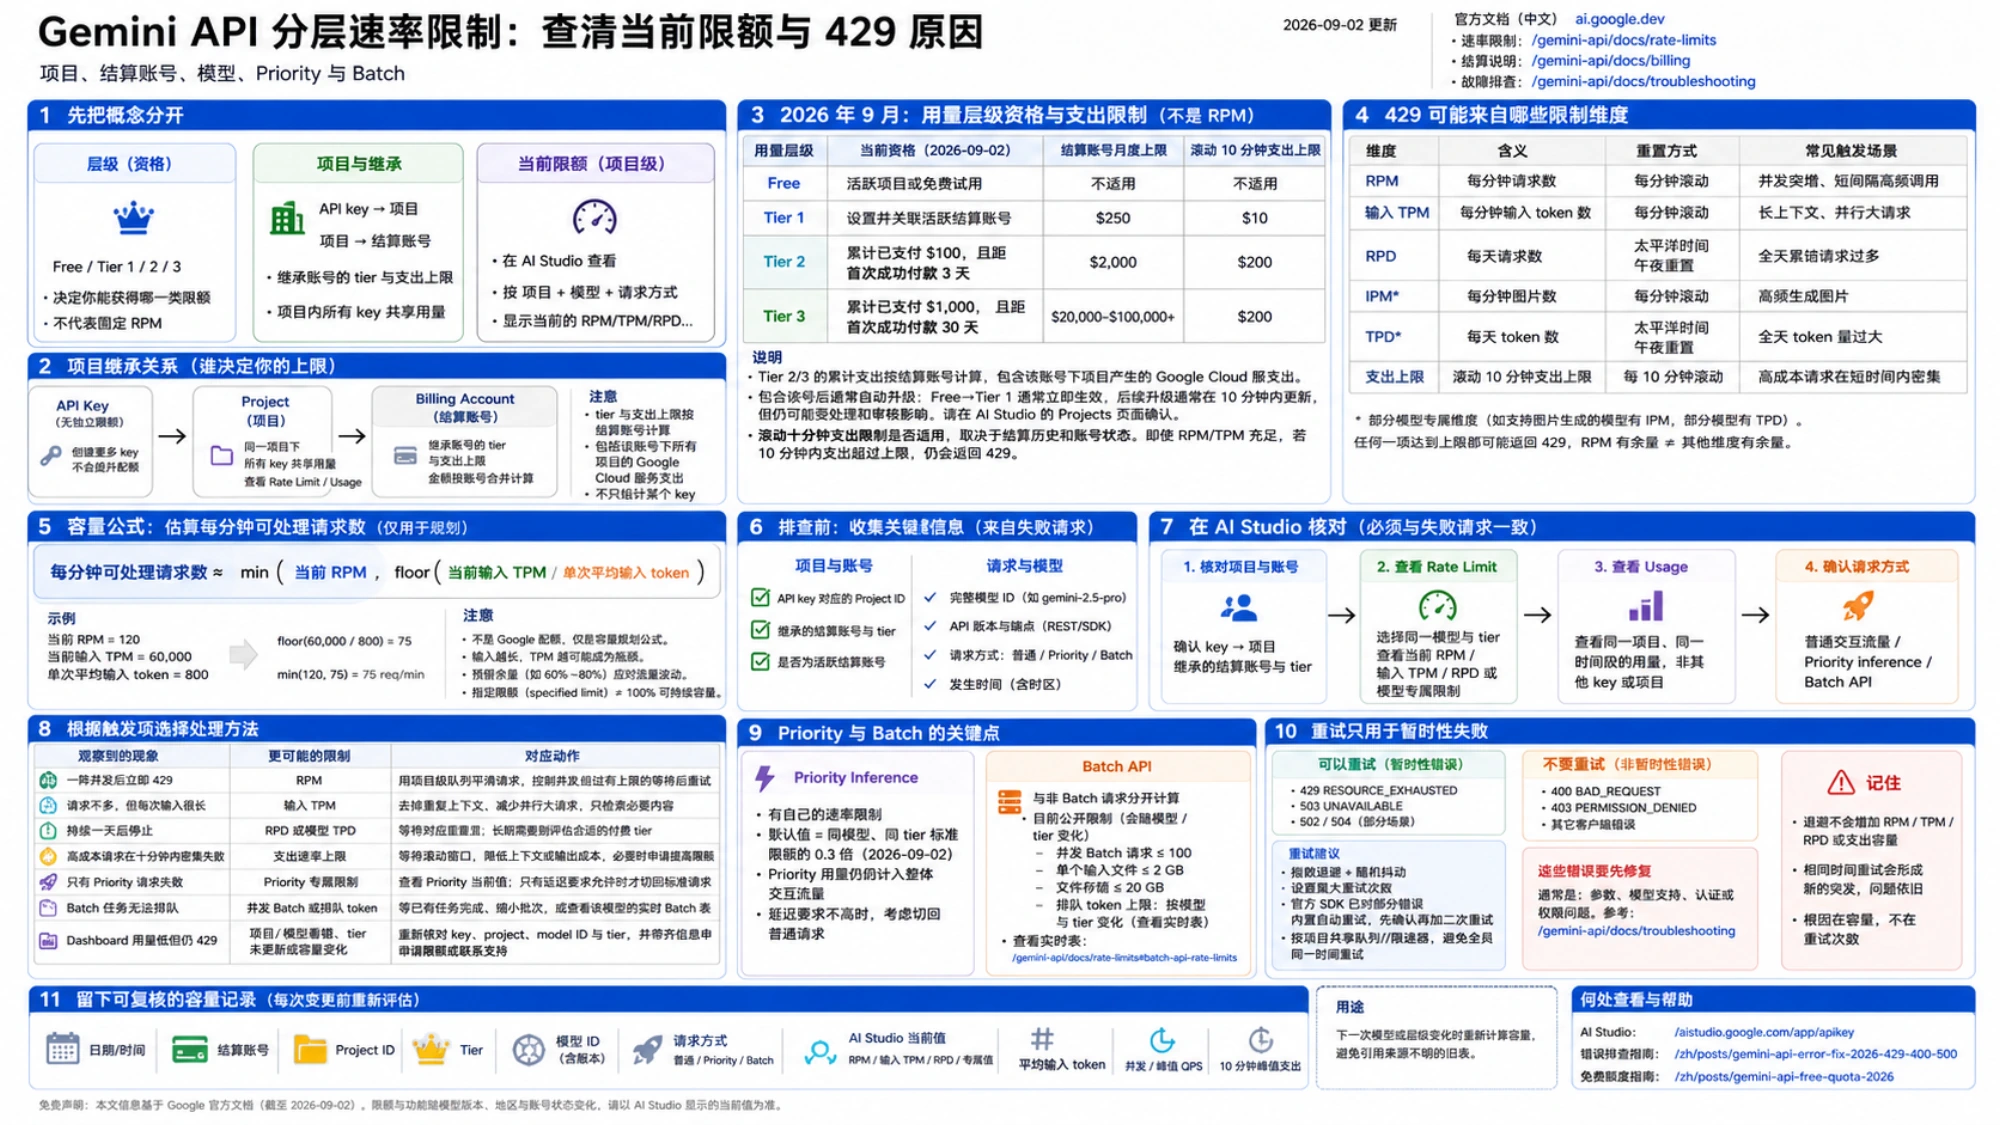
2026 年 9 月的层级资格与支出限制
截至 2026 年 9 月 2 日,Google 的 Gemini API 结算说明 给出的资格如下。表中的结算上限和十分钟支出上限,不是某个模型的 RPM。
| 用量层级 | 当前资格 | 结算账号月度上限 | 滚动 10 分钟支出上限 |
|---|---|---|---|
| Free | 活跃项目或免费试用 | 不适用 | 不适用 |
| Tier 1 | 设置并关联活跃结算账号 | $250 | $10 |
| Tier 2 | 累计已支付 $100,且距首次成功付款 3 天 | $2,000 | $50 |
| Tier 3 | 累计已支付 $1,000,且距首次成功付款 30 天 | $20,000–$100,000+ | $200 |
Tier 2 和 Tier 3 的累计支出按关联结算账号计算,包括该账号下项目产生的 Google Cloud 服务支出,并不只统计某一个 Gemini API key。符合条件后系统通常自动升级;Free 到 Tier 1 通常立即生效,后续升级通常在 10 分钟内更新,但仍可能受处理和审核影响。应在 AI Studio 的 Projects 页面确认结果,不要仅凭付款成功判断 tier 已经改变。
滚动十分钟支出限制已于 2026 年 9 月 12 日复核,见官方速率限制页。Google 说明它是否适用于某个账号还取决于结算历史和账号状态。即使请求数和输入 token 都低于当前显示值,十分钟内高成本调用超过对应支出上限,也会得到 429。
429 可能来自哪一项限制
Google 目前列出的常见维度包括:
- RPM:每分钟请求数。短时间并发突增最容易触发。
- 输入 TPM:每分钟输入 token 数。长上下文和多个并行大请求可能在 RPM 很低时先触发。
- RPD:每天请求数。它在太平洋时间午夜重置,不按中国或用户本地午夜重置。
部分模型还有专属维度。能生成图片的模型可能计算 IPM(每分钟图片数),其他模型可能有 TPD(每天 token 数)。任何一项达到上限都可以拒绝请求;“RPM 还有余量”并不能排除 TPM、RPD、IPM、TPD 或支出上限。
如果 AI Studio 显示当前 RPM 和输入 TPM,可以先估算有效吞吐:
每分钟可处理请求数 ≈ min(当前 RPM, floor(当前输入 TPM / 单次平均输入 token))
这不是 Google 新增的配额,只是容量规划公式。假设同一项目的调用从短问题变成长文档,即使并发和 RPM 不变,输入 TPM 也可能成为新的瓶颈。生产系统还应为流量波动留出余量,不要把公开标注的限额当作百分之百可持续容量。
用同一个项目和模型核对 Dashboard
排查前先从失败请求中记录 API key 对应的项目、完整模型 ID、API 版本、请求端点和发生时间。随后在 AI Studio 中核对同一对象:
- 确认 API key 与项目的对应关系,以及项目与结算账号的关系的结算账号和 tier。
- 在 Rate Limit 中选择失败请求实际使用的模型和层级。
- 在 Usage 中查看同一项目和时间段,而不是另一个 key 或项目。
- 确认请求属于普通交互流量、Priority inference 还是 Batch API。
Priority inference 有自己的速率限制。Google 当前写明默认值为同模型、同 tier 标准限额的 0.3 倍,同时 Priority 用量仍计入整体交互流量。普通请求的限额不能原样套给 Priority 请求。
Batch API 与非 Batch 请求分开计算。当前公开限制包括最多 100 个并发 Batch 请求、单个输入文件 2 GB、文件存储 20 GB,以及按模型和 tier 变化的排队 token 上限。完整模型表会随版本改变,应查看 实时 Batch 限额,不要把旧表当成长期不变的容量依据。
根据触发项选择处理方法
| 观察到的现象 | 更可能的限制 | 对应动作 |
|---|---|---|
| 一阵并发后立即 429 | RPM | 用项目级队列平滑请求,控制并发,经过有上限的等待后重试 |
| 请求不多,但每次输入很长 | 输入 TPM | 去掉重复上下文、减少并行大请求,只检索必要内容 |
| 错误明确指向日用量耗尽 | RPD 或模型 TPD | 等待对应重置;长期需要则评估合适的付费 tier |
| 高成本请求在十分钟内密集失败 | 支出速率上限 | 等待滚动窗口,降低上下文或输出成本,必要时申请提高限额 |
| 只有 Priority 请求失败 | Priority 专属限制 | 查看 Priority 当前值;只有延迟要求允许时才切回标准请求 |
| Batch 任务无法排队 | 并发 Batch 或排队 token | 等已有任务完成、缩小批次,或查看该模型的实时 Batch 表 |
| Dashboard 用量低但仍 429 | 项目/模型看错、tier 未更新或容量变化 | 重新核对密钥所属项目、模型 ID 与用量层级,并带齐信息申请限额或联系支持 |
提高 tier 不能解决所有 429。项目看错、预览版模型限额更紧、所有工作进程同时重试,都会在更高层级下继续制造问题。
重试只能处理暂时性失败
Google 的 故障排查说明 建议对 429、503 等暂时性错误采用指数退避,加入随机抖动并设置最大重试次数。官方 SDK 对部分暂时性错误已经包含自动重试;自己再加一层前,应先确认 SDK 行为。
退避不会增加 RPM、TPM、RPD 或支出容量。如果每个进程都用相同时间重试,下一轮会形成新的突发。更可靠的做法是按项目共享队列或限速器,因为同一项目的多个 key 共用限额。
不要把 400 或 403 当作暂时限流反复重试。它们通常表示请求参数、模型支持、认证或权限问题。可使用 Gemini API 错误排查指南 分开处理。
留下可复核的容量记录
真正能支持生产决策的记录,应包含日期、结算账号、项目、tier、完整模型 ID、请求方式、AI Studio 当前 RPM/TPM/RPD 或模型专属值、平均输入 token、并发和十分钟峰值支出。这样下一次模型或层级变化时,可以重新计算,而不是继续引用一张来源不明的旧表。
如果任务只是确认免费额度是否够做原型,可继续看 Gemini API 免费额度指南。如果已经确定是普通 API 错误,则进入错误排查。
把 tier 当成资格,把 AI Studio 当成当前项目记录,把失败请求当成诊断对象,就能在 Google 调整模型、门槛或界面后继续得到可靠答案。


