截至 2026 年 10 月 10 日,OpenAI Decisions API 已经可以直接调用。OpenAI 在 2026 年 10 月 6 日(美国时间,北京时间 10 月 7 日凌晨)把它从限量预览改为公测(public beta),官方指南写的是预计"未来几周"正式发布(GA),没有给日期。它目前只支持 GPT-6 Luna(gpt-6-luna),走单独的 POST /v1/decisions 端点,SDK 方法是 client.decisions.create。
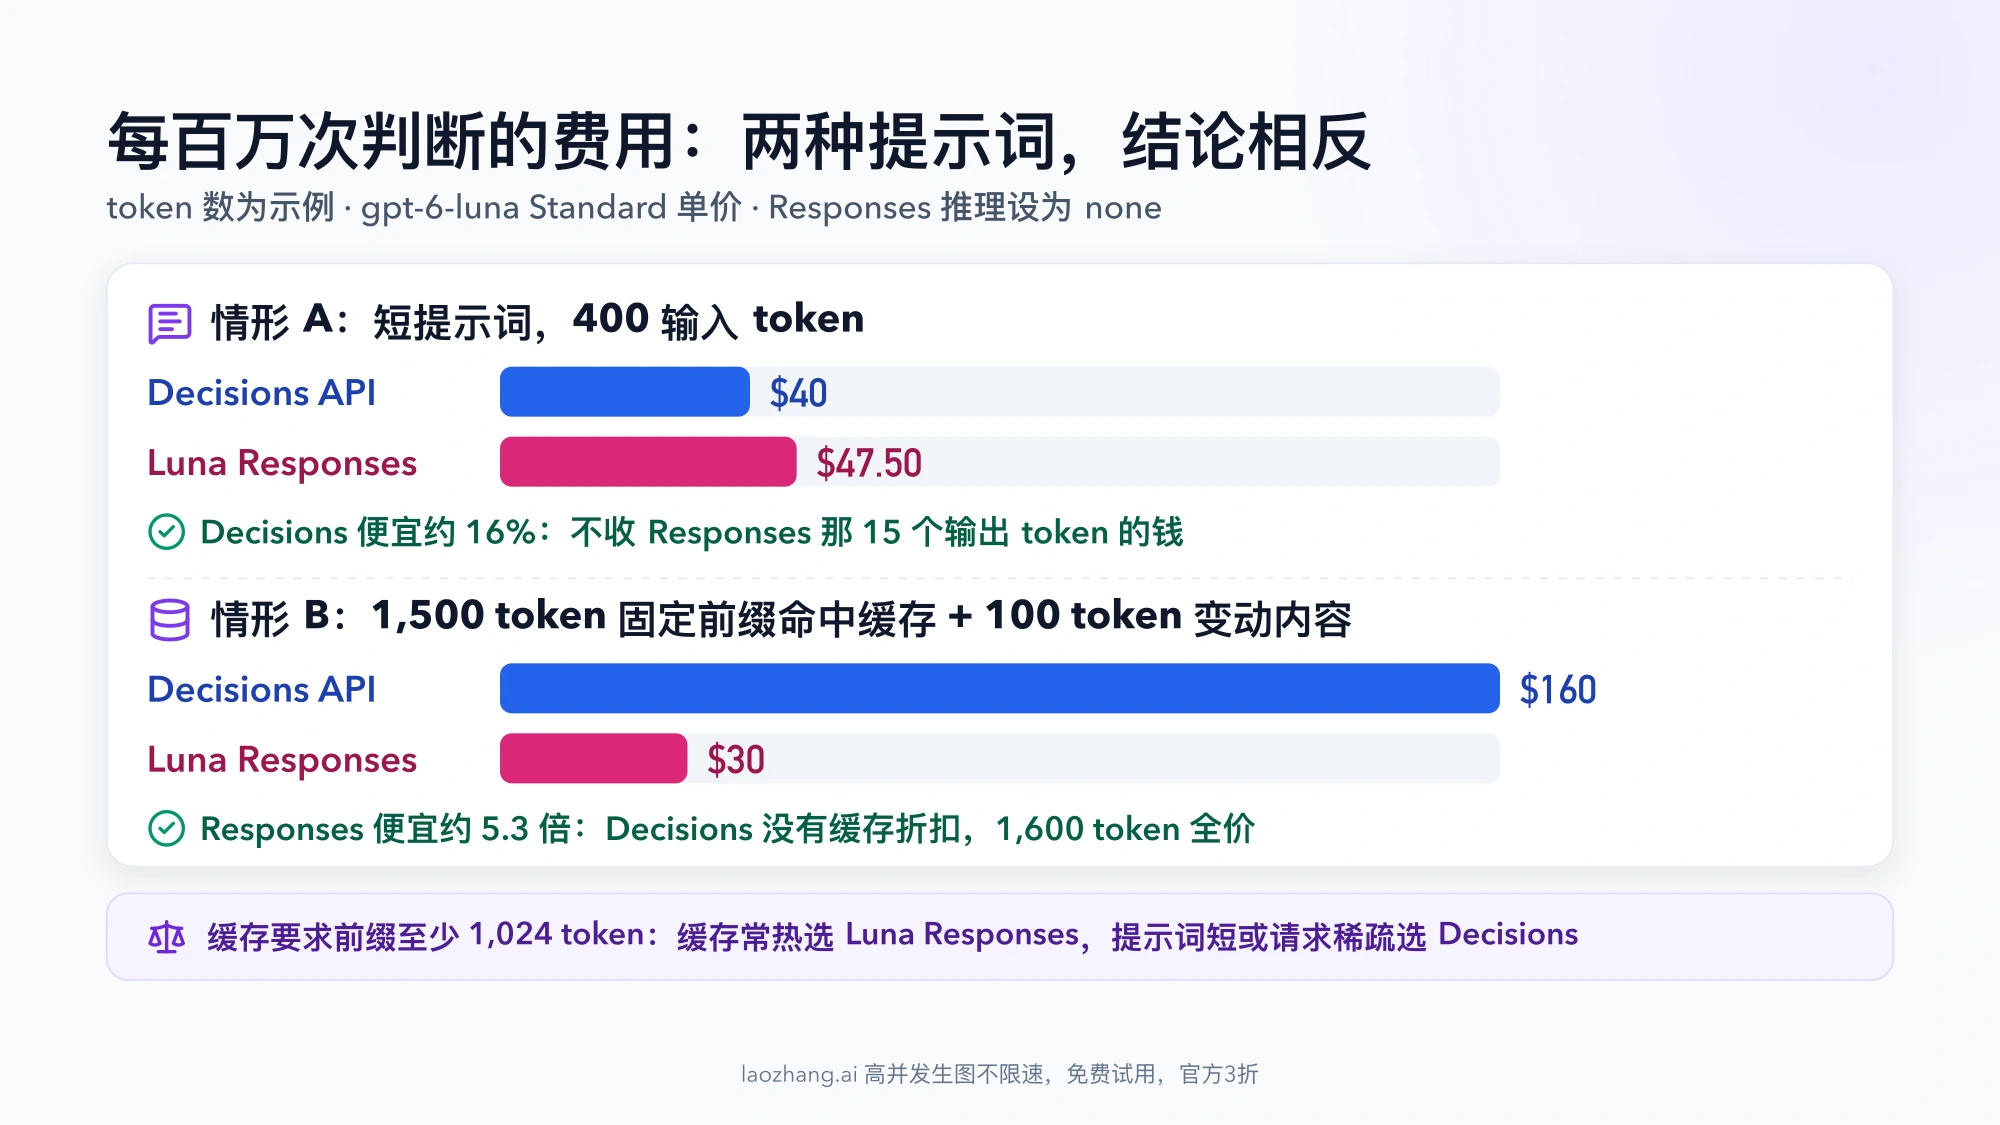
计费只看输入:每百万输入 token $0.10,输出、缓存读取和缓存写入都不收费。按每次 400 输入 token 估算,每百万次判断约 $40,比同样的任务走 Luna Responses 接口加严格枚举(约 $47.50)便宜约 16%。反过来,如果你的提示词有 1,024 token 以上的固定说明,并且 Responses 能稳定命中提示词缓存,Luna Responses 会便宜得多,下文有公式可以代入自己的数。官方 API 的支持地区不含中国大陆,国内接入路线见"国内开发者怎么跑起来"一节。
OpenAI Decisions API 是什么:在你给定的答案里选一个
Decisions API 是 OpenAI 专门做"判定类调用"的接口:你传入文本或图片,再给出几个问题和允许的答案,它不生成文字,只返回结构固定的结果。按官方指南,问题有三种:
| 问题类型 | 适合做什么 | 主要返回 |
|---|---|---|
predicate | 判断一个条件是否成立,比如商品照片有没有明显破损 | probability:条件成立的概率,0 到 1 |
choice | 从一组固定选项里选一个,比如工单分到哪个部门 | choice:你提供的某个值,另附每个选项的概率和 confidence |
score | 按有序等级打分,比如问题严重程度 | score:按概率加权的等级序号,另附每个等级的概率和 confidence |
典型用途是分类、请求路由和排优先级,也可以让 Agent 从几个预设动作里选下一步。OpenAI 另有一份语音控制指南,演示把它和 Live API 配合,从语音请求里选出"后退、刷新、不操作"这类浏览器动作。
它和 GPT-6 Luna 的关系:Decisions API 目前唯一可用的模型就是 gpt-6-luna。同一个模型走 /v1/responses 时按 Luna 的普通价格计费、输出文字;走 /v1/decisions 时按 Decisions 的价格计费、只返回判定结果。需要自定义 JSON 对象、提取字段或一段解释文字时,官方建议继续用 Responses API 的结构化输出(Structured Outputs);需要模型发起工具调用时用 function calling。
两个同名对象别混:Decisions 也是一个与 OpenAI 无关的低代码平台(decisions.com),它文档里的 OpenAI Module 是该平台自己的集成模块;decisionapi.net 是第三方网站,不是 OpenAI 文档。
Decisions API 现在能用吗:10 月 6 日起公测,GA 预计未来几周
能用。OpenAI API 更新日志在 2026 年 10 月 6 日记了一条:"Released the Decisions API in beta with gpt-6-luna";同一天开发者社区的公测公告说面向所有开发者开放。9 月 29 日 DevDay 发布后到 10 月 6 日之间,它只对 OpenAI 选定的客户开放,当时没有公开文档和价格;这个限量预览阶段已经结束。
"公测"对你意味着三件事:
- 不用申请:有 OpenAI API 账号就能调用,也可以先在 Playground 里试问题和输入。官方没有公布 Decisions 专属的账号层级门槛;Free 层能不能调用,文档没有写。
- 接口还可能变:字段名、SDK 方法、限制在 GA 前都可能调整,生产代码最好把调用封装在一个函数里(做法见下文"第四步")。
- 价格是公测价:GA 之后的价格、会不会加缓存折扣,都没有公布。
目前已公布和仍未知的内容:
| 项目 | 现状 |
|---|---|
| 状态 | 公测,2026 年 10 月 6 日(美国时间)起 |
| 正式发布(GA) | "未来几周",无具体日期 |
| 模型 | 只有 gpt-6-luna |
| 端点与 SDK | POST /v1/decisions;client.decisions.create(Go 为 client.Decisions.New) |
| 价格 | 每百万输入 token $0.10,输出与缓存不收费 |
| 数据控制 | 符合条件的客户可用零数据保留(ZDR)和 HIPAA;数据驻留支持美国和欧洲(EEA 加瑞士) |
| Decisions 专属速率限额 | 未公布 |
每次请求最多几个问题、score 最多几个等级 | 未公布 |
一个文档细节:截至 2026 年 10 月 10 日,GPT-6 Luna 模型页的端点表里还没有列出 v1/decisions,以 Decisions 指南和 API 参考为准。
第一条请求怎么写:POST /v1/decisions 的三种问题
请求只有三个字段:model(固定写 gpt-6-luna)、input(文本字符串,或包含文字和图片的 user 消息)、questions(问题数组)。用 SDK 时,官方给出的最低版本是 Python 3.26.0、JavaScript 7.30.0、Go 3.73.0、Ruby 0.101.0、Java 4.78.0,版本更低的 SDK 里没有 decisions 这个方法。
下面的示例按官方指南和 API 参考里的请求结构改写成中文场景,需要环境变量 OPENAI_API_KEY。示例没有经过实际调用,返回值以你自己的结果为准。
choice:从固定选项里选一个
工单分流是最直接的用法。每个选项有 value,description 可选,但写清每个选项什么时候适用,结果会更稳定。官方也建议留一个 other 这样的兜底选项:
from openai import OpenAI  # 需要 openai>=3.26.0

client = OpenAI()  # 读取环境变量 OPENAI_API_KEY

decision = client.decisions.create(
    model="gpt-6-luna",
    input="我的订单 #4471 被扣了两次钱",
    questions=[
        {
            "type": "choice",
            "name": "department",
            "instructions": "这张工单应该分到哪个部门?",
            "choices": [
                {"value": "billing", "description": "付款、发票和退款"},
                {"value": "technical", "description": "产品使用中的问题"},
                {"value": "shipping", "description": "配送和物流跟踪"},
                {"value": "other", "description": "不属于以上类别,交给人工"},
            ],
        }
    ],
)

answer = decision.answers[0]
if answer.type == "refusal":
    print(f"拒答:{answer.name}")
elif answer.type == "choice":
    print(answer.choice, answer.confidence, answer.probabilities)
print(decision.usage.input_tokens)  # 计费只看这个数
不用 SDK 时,直接发 HTTP 请求:
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "我的订单 #4471 被扣了两次钱",
    "questions": [{
      "type": "choice",
      "name": "department",
      "instructions": "这张工单应该分到哪个部门?",
      "choices": [
        {"value": "billing", "description": "付款、发票和退款"},
        {"value": "technical", "description": "产品使用中的问题"},
        {"value": "shipping", "description": "配送和物流跟踪"},
        {"value": "other", "description": "不属于以上类别,交给人工"}
      ]
    }]
  }'
官方文档给的示意返回(标注为 illustrative,不是实测值)大致是这样:
{
  "answers": [
    {
      "type": "choice",
      "name": "department",
      "choice": "billing",
      "probabilities": [
        { "value": "billing", "probability": 0.95 },
        { "value": "technical", "probability": 0.02 },
        { "value": "shipping", "probability": 0.01 },
        { "value": "other", "probability": 0.02 }
      ],
      "confidence": 0.93
    }
  ]
}
predicate 和 score:判断条件、按等级打分,一次请求问多个问题
互不依赖的问题可以放进同一个 questions 数组,共用一份输入,每个问题的类型可以不同。下面这个请求带一张截图,同时问"有没有报错弹窗"(predicate)和"问题有多严重"(score)。图片按官方指南的写法转成 base64 data URL:
import base64
from pathlib import Path

from openai import OpenAI

client = OpenAI()
image_base64 = base64.b64encode(Path("screenshot.png").read_bytes()).decode("ascii")

decision = client.decisions.create(
    model="gpt-6-luna",
    input=[
        {
            "role": "user",
            "content": [
                {"type": "input_text", "text": "用户反馈:在 Safari 里点导出没反应,Chrome 正常。"},
                {"type": "input_image", "image_url": f"data:image/png;base64,{image_base64}"},
            ],
        }
    ],
    questions=[
        {
            "type": "predicate",
            "name": "error_dialog",
            "instructions": "截图里是否出现了错误提示弹窗?只看弹窗,不看页面上的普通文字。",
        },
        {
            "type": "score",
            "name": "severity",
            "instructions": "这个问题有多严重?",
            "levels": [
                {"label": "仅外观", "description": "只影响显示,功能没有损失"},
                {"label": "有替代办法", "description": "某个操作失败,但换一种方式可以完成"},
                {"label": "完全受阻", "description": "操作失败,且没有替代办法"},
            ],
        },
    ],
)

for answer in decision.answers:  # 按提问顺序返回
    if answer.type == "refusal":
        print(f"拒答:{answer.name}")
    elif answer.type == "predicate":
        print(answer.name, answer.probability)
    elif answer.type == "score":
        print(answer.name, answer.score, answer.confidence)
score 的等级要从低到高排列。如果后一个问题要看前一个问题的答案(例如先判断有没有破损,有破损再选维修类别),官方要求拆成两次请求。
返回字段:probability、choice、probabilities、confidence、score
| 字段 | 出现在 | 含义 |
|---|---|---|
probability | predicate | 条件成立的概率估计,0 到 1;predicate 没有单独的 confidence |
choice | choice | 你提供的某个选项值(值区分类型,字符串 "true" 和布尔值 true 是两个选项) |
probabilities | choice、score | 每个选项或等级的概率;score 里每项带 value(从 0 开始的序号)和 label |
confidence | choice、score | 单独给出的置信度,和概率分布一起返回 |
score | score | 各等级序号按概率加权的平均值,可以落在两个等级之间 |
type: "refusal" | 任何问题 | 这个问题被拒答,只带问题的 name(没起名时为 null) |
usage | 整个响应 | input_tokens、cached_tokens、cache_write_tokens、output_tokens、reasoning_tokens 等用量字段 |
score 的算法举例:三个等级的概率是 0.1、0.7、0.2,score = 0 × 0.1 + 1 × 0.7 + 2 × 0.2 = 1.1,意思是"大致在'有替代办法'这一级,略偏严重"。想要一个确定的类别,就用 choice,不要拿 score 四舍五入。
Decisions API 有哪些限制:2–255 个选项、每次最多 128 张图
下面这些限制来自 API 参考和官方指南,写代码前先对一遍:
| 限制 | 内容 |
|---|---|
| 模型 | 只有 gpt-6-luna |
| choice 选项数 | 2 到 255 个,值不能重复 |
| 图片数量 | 每次请求所有消息加起来最多 128 张 |
| 图片格式 | 用 base64 data URL;不接受 file ID(见下方说明) |
| 图片清晰度 | detail 可选 low、high、auto、original,默认 auto |
| 消息角色 | 只接受 user 消息,没有 system 或 developer 消息 |
| 不支持的输入 | 文件、音频、工具与函数调用、item 引用 |
safety_identifier | 可选,最长 128 个字符,用来标识你的终端用户 |
| 速率限额 | 没有公布 Decisions 专属限额,在控制台 Settings > Organization > Limits 查看 |
图片地址的说法有冲突:指南写的是图片必须是内嵌的 base64 data URL,不支持 HTTP(S) 图片链接;API 参考却写 base64 和可公开访问的 HTTP(S) 链接都可以。两边都说不接受 file ID。稳妥的做法是统一传 base64,两份文档都认可。
速率限额也要注意口径。OpenAI 在 10 月 6 日同时调整了账号层级,现在是 Free、Build、Launch、Grow(详见 OpenAI API 账号分层(Tier):Free、Build、Launch、Grow 额度与升级条件),以前常见的"Tier 1 每分钟 500 次"已经作废。Luna 在 Responses 等端点上的标准限额是 Build 每分钟 5,000 次请求、200 万 token,Launch 10,000 次、1,000 万 token,Grow 30,000 次、1.8 亿 token,但文档没有说这些数字适用于 /v1/decisions。按峰值规划容量时,以控制台显示的数字为准。
另外两点:Decisions API 支持零数据保留和 HIPAA,但只对符合条件、签了相应协议的客户开放;使用区域处理(regional processing)会加收溢价。
每千次、每百万次判断要花多少钱:用自己的 token 数复算
Decisions API 的价格写在官方指南的"Pricing and availability"一节,定价总页里没有单独一行:使用 gpt-6-luna 时,每百万输入 token $0.10,输出、缓存读取、缓存写入都不收费。所以:
单次成本 = 输入 token × $0.10 ÷ 1,000,000
输入 token 包括你的说明、选项描述、待判断的文本和图片折算的 token,以响应里的 usage.input_tokens 为准。区域处理溢价和长上下文倍率照样适用(Luna 模型页写的是区域处理加收 10%,单次输入超过 272K token 时输入按 2 倍计价),判断类请求一般碰不到后者。这个价格只适用于 /v1/decisions,同一个模型走其他端点仍按 Luna 的普通价格。
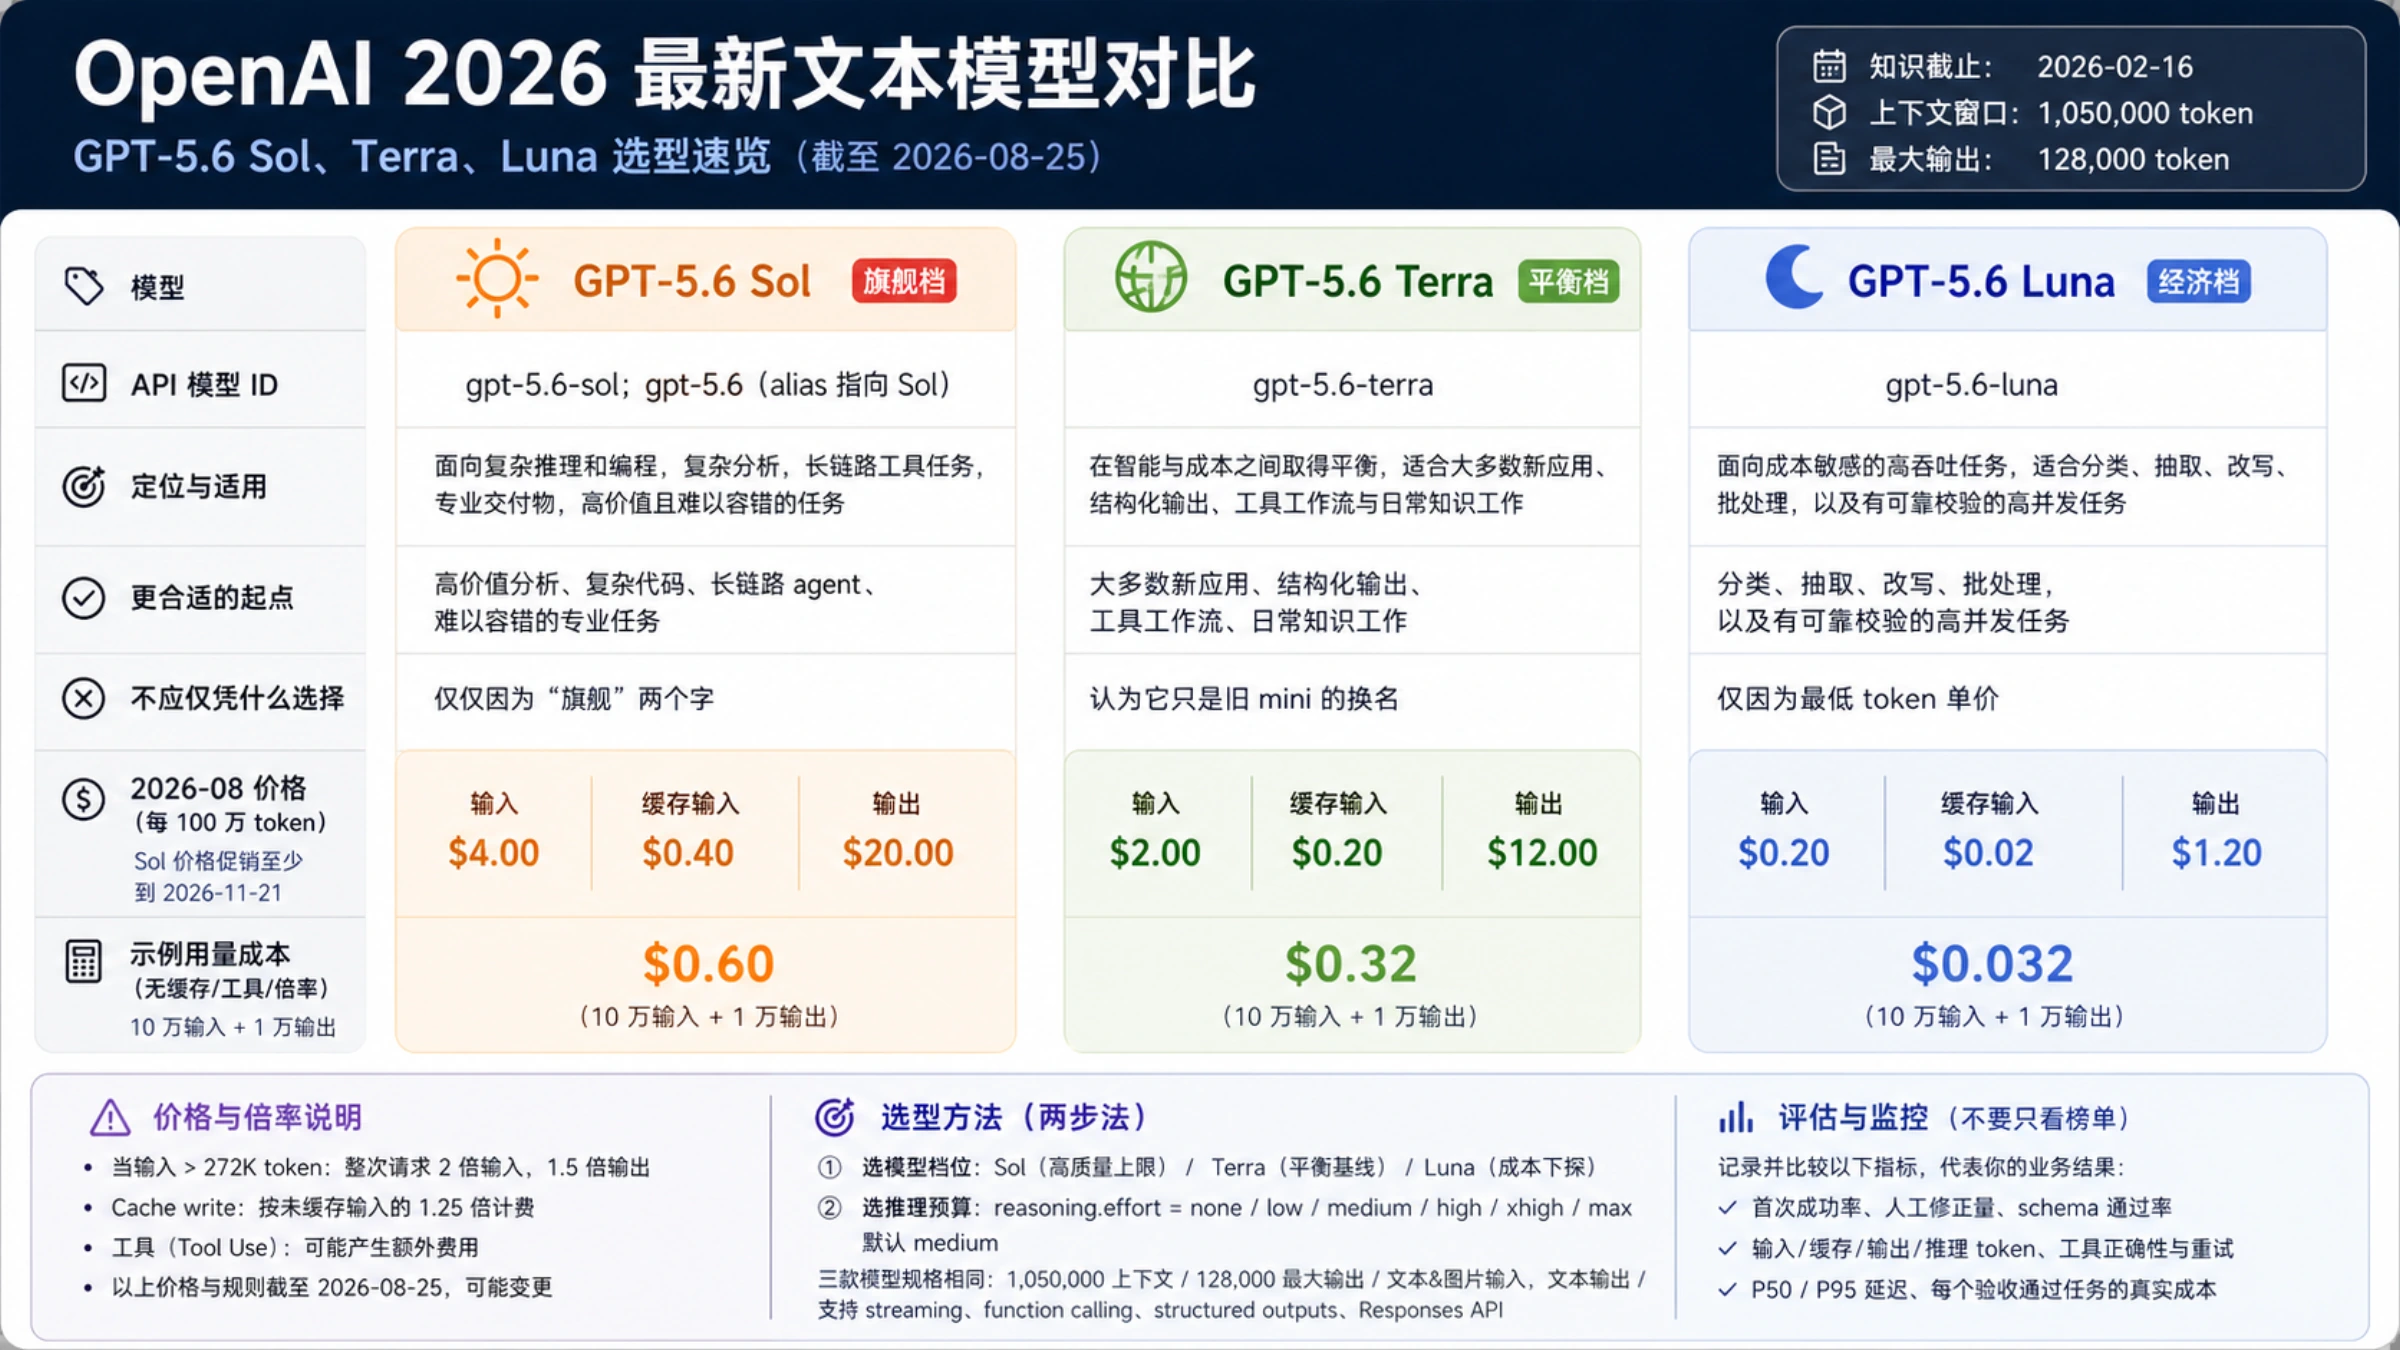
拿来比较的是同一个模型走 Responses API 加严格枚举的做法。按 Luna 模型页的 Standard 价格(每百万 token:输入 $0.10、缓存输入 $0.01、缓存写入 $0.125、输出 $0.50),reasoning.effort 设为 none 时:
Luna Responses 单次成本 = (未缓存输入 × $0.10 + 缓存输入 × $0.01 + 输出 × $0.50) ÷ 1,000,000
下表的 token 数都是假设值,用来看方向:
| 情形 | Decisions API 每百万次 | Luna Responses 每百万次 | 哪个便宜 |
|---|---|---|---|
| A:短提示词,400 输入 token,Responses 输出约 15 token | $40 | $47.50 | Decisions 便宜约 16% |
| A':输入翻倍到 800 token,输出不变 | $80 | $87.50 | Decisions 仍便宜 $7.50 |
| B:1,500 token 固定说明 + 100 token 变动内容,Responses 输出约 10 token,命中缓存 | $160 | $30 | Responses 便宜约 5.3 倍 |
| A 走 Luna Batch(半价,异步) | — | $23.75 | 离线任务用 Batch 更便宜 |
情形 A 的算法:Decisions 是 400 × $0.10 ÷ 1,000,000 = $0.00004 一次,每千次 $0.04,每百万次 $40;Luna Responses 是 400 × $0.10 ÷ 1,000,000 + 15 × $0.50 ÷ 1,000,000 = $0.0000475 一次,每百万次 $47.50。差价全部来自输出 token,Decisions 不收这部分。
情形 B 的算法:Decisions 没有缓存折扣,1,600 个输入 token 全价计费,1,600 × $0.10 ÷ 1,000,000 = $0.00016 一次,每百万次 $160;Luna Responses 命中缓存时是 (1,500 × $0.01 + 100 × $0.10 + 10 × $0.50) ÷ 1,000,000 = $0.000015 + $0.00001 + $0.000005 = $0.00003 一次,每百万次 $30(缓存未命中的那几次还要按 $0.125 付缓存写入费)。社区里已经有开发者指出,这个端点没有缓存输入折扣,长提示词的分类任务从 Luna Responses 迁过来并不划算。
临界点可以直接算出来。设固定前缀为 P、变动输入为 V、Responses 输出为 O(都按 token 计),两者的差只剩前缀和输出:Decisions 多付 0.09 × P,Responses 多付 0.50 × O。只有 P < 5.6 × O 时 Decisions 更便宜,输出 15 token 时约是 83 token 的前缀。而 OpenAI 的提示词缓存只在前缀达到 1,024 token 时才生效,缓存在最后一次写入或复用后至少保留 30 分钟。换成可以直接执行的规则:
- 提示词短、没有可缓存的长前缀,或者请求稀疏、缓存经常过期:Decisions 更便宜。
- 有 1,024 token 以上固定说明、流量足够让缓存一直热着:命中缓存时 Luna Responses 更便宜,差距可以到几倍。
- 不急着要结果的离线打标:Luna Batch 半价,按情形 A 的假设比 Decisions 还便宜。官方指南没有提到 Decisions 能否走 Batch。
这里只比较了 token 价格。Decisions 的真正优势在速度和直接给出概率,下文分开讲;如果你在意的是延迟,每百万次判断几美元到一百多美元的差价可能不是决定因素。
换成你自己的数:拿 20 条真实样本分别走两种接口,取 usage 里的输入、缓存和输出 token 平均值代入上面两个公式。带截图的判断,图片会折算成输入 token,要单独统计。想对比 Luna 和 Sol 在相同 token 用量下的花费,可以看 GPT-6 Luna 与 Sol 价格对比:API 和 Codex 分别怎么算。
调用 v1/decisions 返回 403 是什么意思
在 10 月 6 日公测之前,这个 403 的意思是账号不在预览名单里,跟请求怎么写无关。第三方 eesel 在 2026 年 10 月 1 日和 2 日的测试里,用普通 API Key 请求 POST https://api.openai.com/v1/decisions,两天都拿 到 HTTP 403:
{
  "error": {
    "message": "Decision API is not enabled for this user.",
    "type": "invalid_request_error",
    "param": null,
    "code": null
  }
}
当时连空请求体也直接返回这个错误,说明它是按账号开放的功能开关。公测开始后,第三方测试者(例如日本 classmethod 在 10 月 7 日的测试)和社区回帖都没有再报告这个错误。
如果你现在仍然遇到它,OpenAI 没有文档说明原因,可以按下面的顺序排查(这是推断,不是官方说法):
- 路径和模型:确认是
POST https://api.openai.com/v1/decisions,model写的是gpt-6-luna。/v1/decisions/create、/v1/beta/decisions这类路径不存在。 - SDK 版本:Python 低于 3.26.0、JavaScript 低于 7.30.0 时 SDK 里没有
decisions方法,通常会先在本地报错;自己拼 URL 时要确认没有用错端点。 - 项目和组织权限:在控制台检查这个 API Key 所属的项目是否限制了可用端点或模型,换一个组织管理员创建的 Key 对比。
- 账号地区:OpenAI 的支持国家和地区列表以外的访问可能导致账号受限。
逐项排除后仍是 403,就带上请求 ID 联系 OpenAI 支持,别靠反复改请求体试。
要不要把 GPT-6 Luna 严格枚举分类器迁到 /v1/decisions
不一定。已经用 Luna 加严格枚举 schema 跑得好好的分类器,要按延迟、成本结构和输入类型来判断:
| 你的情况 | 建议 | 理由 |
|---|---|---|
| 实时聊天里的路由、Agent 一个任务里要做很多次小判断 | 优先测试迁移 | 延迟逐次累加,Decisions 主打速度 |
| 需要一个概率来设阈值(自动通过、转人工、拦截三档) | 测试迁移,优先用 predicate | Luna 严格枚举只给答案,不给概率 |
| 提示词短、没有长的固定说明 | 可以迁 | 不收输出费,按情形 A 的假设便宜约 16% |
| 有 1,024 token 以上固定说明,流量稳定 | 先留在 Luna Responses | 命中缓存时 Responses 便宜几倍 |
| 离线重新打标、历史数据回填 | 用 Luna Batch | 半价,不需要实时返回 |
| 要输出自定义 JSON、提取字段或附带理由 | 留在 Responses 结构化输出 | Decisions 只返回概率、选项和分数 |
| 只能经第三方网关调用 | 先确认网关是否提供 Decisions | 很多 OpenAI 兼容网关只提供普通 Luna |
决定迁移时,按这个顺序做,风险最小:
- 准备标注集:从线上取几百条已经有人工结论的样本,覆盖常见和难判断的输入。
- 影子运行:线上继续用 Luna 方案,同时把同样的输入发给
/v1/decisions,只记录不执行。 - 对比四个数:准确率(尤其是"该不该执行动作"这类难判断)、延迟中位数和长尾、每千次判断的实际费用、高峰期有没有触发限额。
- 用标注集定阈值:根据误判的代价决定
probability或confidence到多少才自动执行(下文"概率不能直接当阈值"一节)。 - 分批切换:先切可撤销的动作(打标签、分队列),保留 Luna 方案作为回退。
用 GPT-6 Luna 和严格枚举 schema 实现有限选项判断
这是 Decisions API 公测之前的做法,现在仍然有用:提示词有长前缀、需要走 Batch,或者你只能经过只提供普通 Luna 的网关时,它更合适。GPT-6 Luna 支持文本和图片输入,也支持结构化输出,reasoning.effort 可以设为 none,Responses、Chat Completions 和 Batch 三个端点都能调用。按 OpenAI 的结构化输出指南,把输出约束成一个只有 enum 字段的 JSON Schema,并打开 strict,模型返回的答案就只能是你列出的选项之一。
第一步:选项里留一个"交给人工"
结构化输出指南明确说了两件事:模型会尽量遵守 schema,当输入和问题完全无关时,这种"必须选一个"的约束可能导致胡乱作答;结构化输出仍然可能出错。所以候选答案里要有一个出口,例如 needs_human(信息不足、无法判断或与问题无关),提示词里写清什么情况选它。Decisions API 的 choice 问题同样适用这条,官方也建议留 other。
第二步:用 Responses API 调用(官方直连)
下面的 Python 示例需要 openai SDK 和环境变量 OPENAI_API_KEY。decide() 接收上下文文本、可选的图片地址、问题和选项列表,返回一个保证在列表内的答案:
import json
import time
from openai import OpenAI

client = OpenAI()  # 读取环境变量 OPENAI_API_KEY

def decide(context: str, question: str, options: list[str],
           fallback: str = "needs_human", image_url: str | None = None) -> dict:
    """在 options 中选一个答案;任何异常情况都返回 fallback。"""
    if fallback not in options:
        options = options + [fallback]

    content = [{"type": "input_text", "text": context}]
    if image_url:  # 公网 URL 或 data:image/png;base64,... 均可
        content.append({"type": "input_image", "image_url": image_url})

    start = time.perf_counter()
    resp = client.responses.create(
        model="gpt-6-luna",
        reasoning={"effort": "none"},
        input=[
            {"role": "developer",
             "content": f"{question}\n只能从给定选项中选一个。"
                        f"信息不足、无法判断或输入与问题无关时,选 {fallback}。"},
            {"role": "user", "content": content},
        ],
        text={"format": {
            "type": "json_schema",
            "name": "decision",
            "strict": True,
            "schema": {
                "type": "object",
                "properties": {"answer": {"type": "string", "enum": options}},
                "required": ["answer"],
                "additionalProperties": False,
            },
        }},
    )
    latency_ms = round((time.perf_counter() - start) * 1000)

    answer = fallback
    if resp.status == "completed" and resp.output_text:  # 拒答或输出被截断时 output_text 为空
        try:
            parsed = json.loads(resp.output_text).get("answer")
        except json.JSONDecodeError:
            parsed = None
        if parsed in options:
            answer = parsed

    return {
        "answer": answer,
        "model": resp.model,
        "latency_ms": latency_ms,
        "input_tokens": resp.usage.input_tokens,
        "output_tokens": resp.usage.output_tokens,
    }

ROUTES = ["billing", "shipping", "technical", "other", "needs_human"]
print(decide("我的订单 #4471 被扣了两次钱", "这张工单应该分到哪个队列?", ROUTES))
成功的判断标准:返回的 answer 是 ROUTES 里的一个值;input_tokens、output_tokens 有数,代入上文的成本公式。
一次要回答好几个问题(比如"分到哪个队列"和"能不能自动回复")时,在 schema 里放多个枚举字段即可,每个字段都要列进 required。结构化输出指南规定,一个 schema 里所有枚举值加起来不超过 1,000 个。
第三步:经 OpenAI 兼容网关时改用 Chat Completions
如果你通过 OpenAI 兼容网关调用(下文讲国内路线),一般走 Chat Completions 接口(/v1/chat/completions)。结构化输出在 Chat Completions 里写在 response_format 中,其余逻辑不变:
import json, os
from openai import OpenAI

client = OpenAI(base_url="https://api.laozhang.ai/v1",
                api_key=os.environ["LAOZHANG_API_KEY"])

options = ["billing", "shipping", "technical", "other", "needs_human"]
resp = client.chat.completions.create(
    model="gpt-6-luna",
    reasoning_effort="none",
    messages=[
        {"role": "developer",
         "content": "这张工单应该分到哪个队列?只能从给定选项中选一个;无法判断时选 needs_human。"},
        {"role": "user", "content": [
            {"type": "text", "text": "快递显示已签收,但我没收到"},
            # 有截图时追加:{"type": "image_url", "image_url": {"url": "https://..."}}
        ]},
    ],
    response_format={"type": "json_schema", "json_schema": {
        "name": "decision",
        "strict": True,
        "schema": {
            "type": "object",
            "properties": {"answer": {"type": "string", "enum": options}},
            "required": ["answer"],
            "additionalProperties": False,
        },
    }},
)

choice = resp.choices[0]
answer = "needs_human"
if choice.finish_reason == "stop" and not choice.message.refusal:
    try:
        parsed = json.loads(choice.message.content).get("answer")
        answer = parsed if parsed in options else "needs_human"
    except (TypeError, json.JSONDecodeError):
        pass  # 返回的不是合法 JSON,说明 json_schema 可能没有生效
print(answer, resp.usage)
两段代码都在本地再校验一次答案是否在列表里。原因很简单:官方直连时,严格 schema 已经保证这一点;经第三方网关时,这一层校验能兜住 response_format 没被透传的情况。
第四步:把 decide() 换成 Decisions API 实现
让业务代码只依赖 decide(context, question, options) 和它返回的 answer,不直接接触 gpt-6-luna、text.format 这些实现细节。问题文本和选项列表放在配置里集中管理,每次调用把输入版本、答案、模型、延迟和 token 数写进日志。
这样一来,迁移到 Decisions API 只需要另写一个返回同样结构的实现,再加一个 confidence 字段。下面这个版本按官方请求结构写成,图片按指南要求传 base64:
import time
from openai import OpenAI  # 需要 openai>=3.26.0

client = OpenAI()

def decide_with_decisions(context: str, question: str, options: list[str],
                          fallback: str = "needs_human",
                          image_base64: str | None = None) -> dict:
    """与 decide() 返回结构相同,多一个 confidence。"""
    if fallback not in options:
        options = options + [fallback]

    if image_base64:
        input_ = [{"role": "user", "content": [
            {"type": "input_text", "text": context},
            {"type": "input_image", "image_url": f"data:image/png;base64,{image_base64}"},
        ]}]
    else:
        input_ = context

    start = time.perf_counter()
    decision = client.decisions.create(
        model="gpt-6-luna",
        input=input_,
        questions=[{
            "type": "choice",
            "name": "answer",
            "instructions": f"{question}\n信息不足、无法判断或输入与问题无关时,选 {fallback}。",
            "choices": [{"value": o} for o in options],
        }],
    )
    latency_ms = round((time.perf_counter() - start) * 1000)

    result = decision.answers[0]
    answer, confidence = fallback, None
    if result.type == "choice" and result.choice in options:  # 拒答时 type 为 refusal
        answer, confidence = result.choice, result.confidence

    return {
        "answer": answer,
        "confidence": confidence,
        "model": decision.model,
        "latency_ms": latency_ms,
        "input_tokens": decision.usage.input_tokens,
        "output_tokens": decision.usage.output_tokens,
    }
用同一批标注样本分别跑 decide() 和 decide_with_decisions(),比较答案、延迟和 token 数,再决定切不切。选项超过 255 个时 Decisions 放不下,要先拆成两级问题。
速度差距:OpenAI 称快约 10 倍,第三方测得中位约 260 毫秒
OpenAI 在更新日志和指南里都说 Decisions API 比 Responses API 快约 10 倍,但没有公布测试方法。流传很广的"约 150 毫秒返回"出自媒体报道和发布会,OpenAI 文档里没有这个数。
能参考的是几份第三方数据,测试地点和网络都不同,只能看数量级:
| 测试 | 设置 | 中位耗时 |
|---|---|---|
| classmethod,Decisions API(10 月 7 日) | curl 调官方 choice 示例,145 输入 token,跑 5 次 | 273 毫秒 |
| classmethod,Decisions API | 官方 score 示例,跑 5 次 | 256 毫秒 |
| 社区开发者,Decisions API | 带图片输入,约 3 Mbps 网络 | 约 0.8 秒 |
| eesel,GPT-6 Luna 严格枚举(10 月初) | 20 张工单各跑两遍,推理 none,笔记本端到端 | 1.46 秒 |
数据来源:classmethod 的测试、OpenAI 社区公告帖的回帖、eesel 的测试。eesel 的 Luna 测试里,推理强度调到 low、medium 时中位耗时分别是 1.62 秒和 2.33 秒。
差距在哪里有影响:工单、邮件分流基本没有影响;实时聊天里,每轮在回复前多等 1 秒以上,用户能感觉到;Agent 一个任务里做 20 次小判断,按 1.46 秒算光等待就要约 29 秒,按 0.26 秒算约 5 秒。从国内经网关调用还会多出一段网络延迟,要在你自己的网络环境里测。
概率不能直接当阈值:会发消息、扣钱的动作要加兜底
Decisions API 返回的 probability 和 confidence 是模型自己的估计,不保证判断正确,也不一定和真实比例对得上。两份公开报告值得先看:
- classmethod 用官方 choice 示例跑 5 次,每次都是 billing 概率 1.0、confidence 1.0,而文档的示意值是 0.95 和 0.93;score 示例 5 次都是 0.97、confidence 0.96,示意值是 1.1 和 0.55。数值只有两位小数,多次调用完全相同。
- 社区开发者 platypus 用"70% 正面的硬币"测试:predicate 给出的概率接近 70%,和真实比例一致;同样的问题写成 choice,给出约 98%,而且选项顺序一换,概率也跟着变。
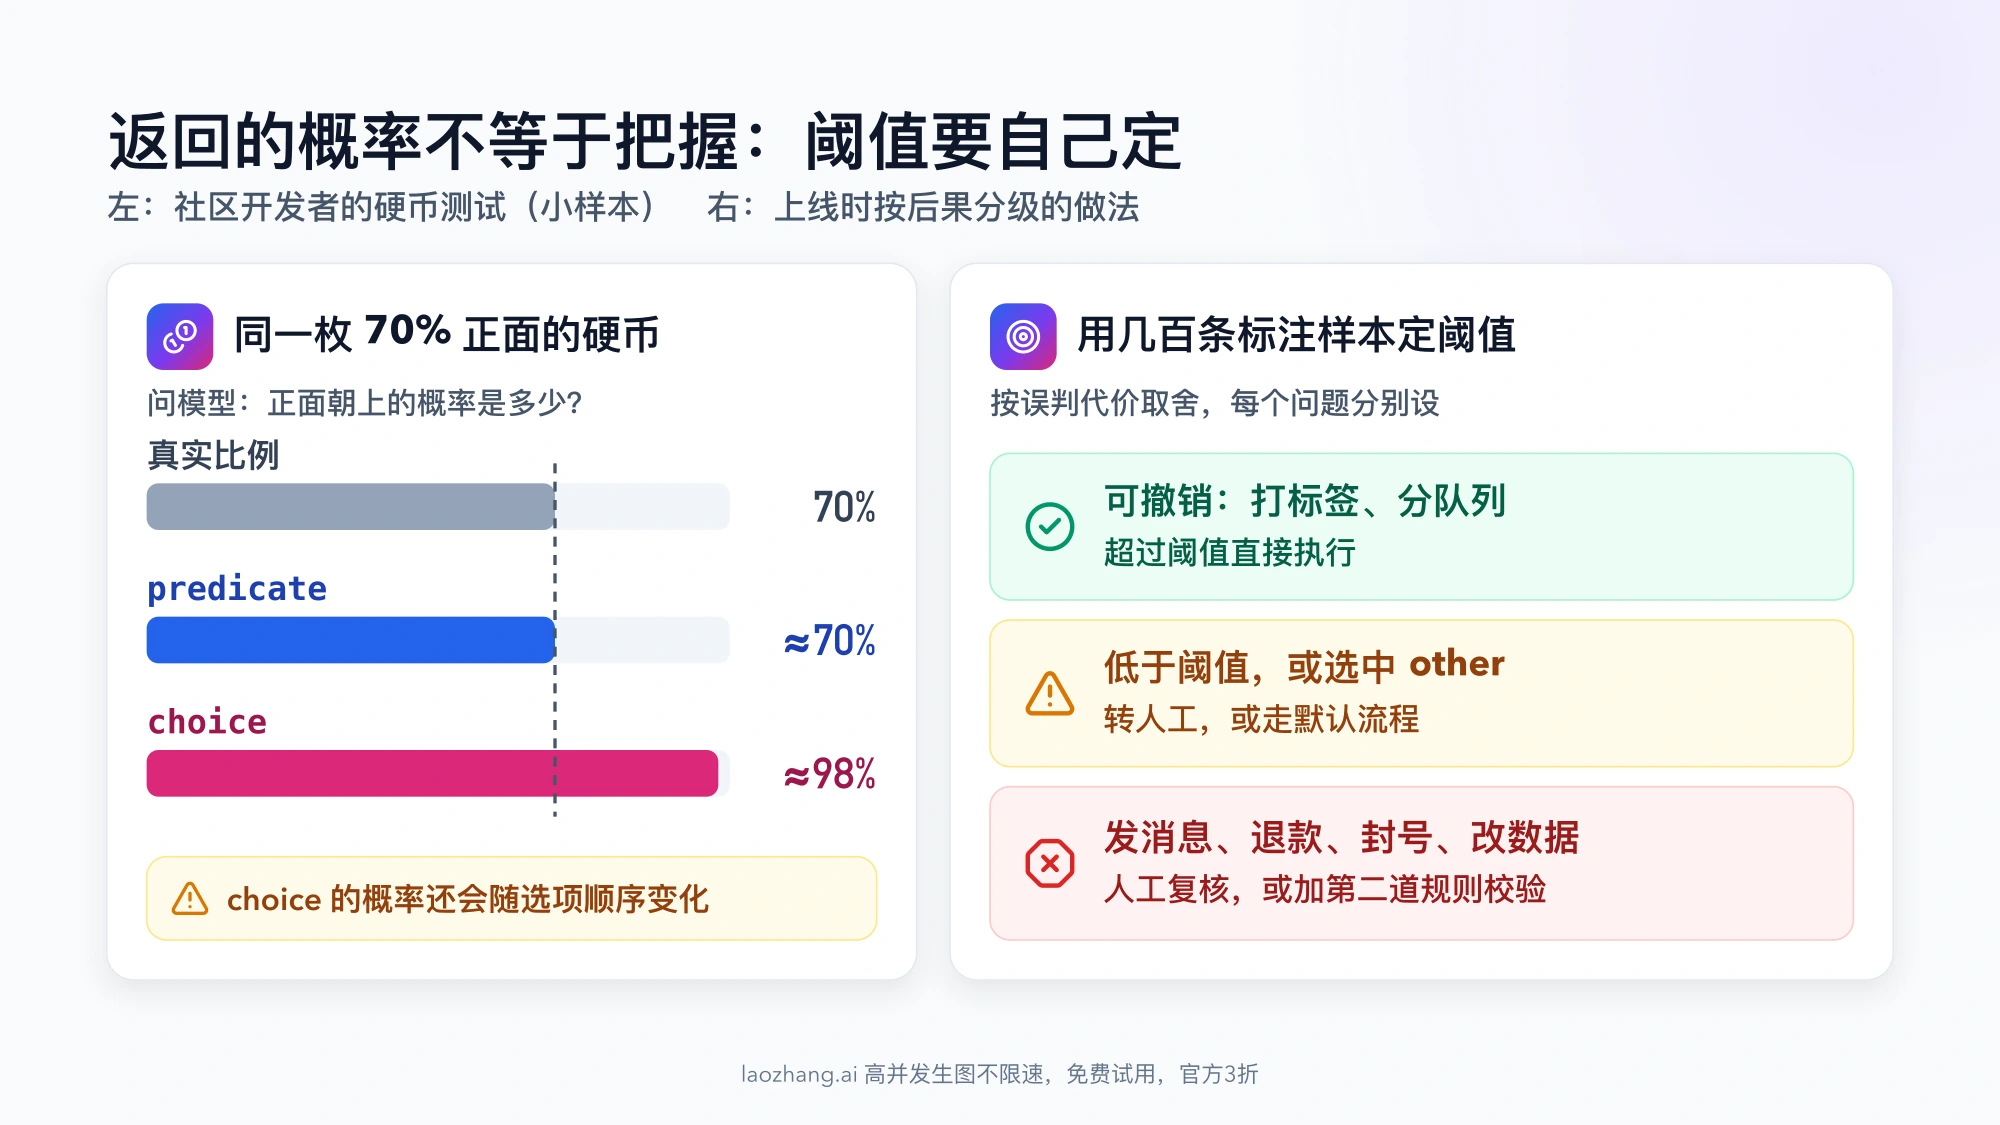
这只是小样本的个人测试,不代表所有任务,但足以说明:不要把 0.9 直接当"九成把握"。OpenAI 自己的建议也是用你应用里的标注样本来定阈值,按误判的代价取舍。实际操作上(以下是做法建议,不是官方规定):
- 需要可信概率时优先用 predicate:把"是不是退款请求"这类二元判断写成 predicate,比塞进 choice 更容易校准。
- 留出口:每个 choice 问题都有
other或needs_human这类选项,选中就转人工或走默认流程。 - 用标注集画阈值:把几百条样本的概率和人工结论放在一起,看阈值设在多少时误判可以接受,不同问题分别设。
- 按后果分级:可撤销的动作(打标签、分队列)可以直接执行;发消息、退款、封号、改数据这类动作,需要人工复核或第二道规则校验。
- 留日志:记录输入版本、问题与选项版本、答案、概率和最终结果,换模型、换接口或 GA 后接口变化时用来对比。
严格枚举的 Luna 方案也有同样的问题,只是它连概率都不给。eesel 的测试里,"分到哪个队列"所有设置都是 40 次全对;但"这张工单能不能自动回复",Luna 不推理时 40 次里对了 33 次。分队列错了,损失的是几分钟;自动回复错了,错误回复会直接发到客户那里。
国内开发者怎么跑起来:直连限制与 OpenAI 兼容网关
OpenAI 的 API 支持国家和地区列表里没有中国大陆,页面还写明在列表以外访问可能导致账号被封禁或暂停。按你的条件,有三条路:
| 路线 | 能用 Decisions API 吗 | 适合谁 | 要注意什么 |
|---|---|---|---|
| OpenAI 官方直连 | 能,就是上文的写法 | 有合规海外主体和 OpenAI 账号的团队 | 唯一能用到 ZDR、HIPAA、数据驻留这些数据控制的路线 |
| 已上架 Decisions 的第三方网关 | 能,但请求格式是网关自己的 | 已经在用这些网关的团队 | Vercel AI Gateway 用 AI SDK 的写法,和 /v1/decisions 原生格式不同 |
| 只提供普通 Luna 的 OpenAI 兼容网关 | 不能 | 只需要有限选项判断、能接受 Luna 方案的团队 | 用上文第三步的 Chat Completions 写法 |
已上架 Decisions 的网关:Vercel AI Gateway 列出模型 openai/gpt-6-luna-decisions,输入同样是每百万 token $0.10,页面示例用的是 AI SDK 的 experimental_decide 函数,问题的写法(例如 type: 'boolean')和 OpenAI 原生请求不一样;OpenRouter 也上架了名为 GPT-6 Luna Decisions 的模型。上文的 Python 示例不能原样套用到这两家,请求格式以它们各自的文档为准;能不能从国内访问和付款,也要先在小额度下确认。
只需要 Luna 方案时,以 laozhang.ai 为例:截至 2026 年 10 月 10 日,它的模型目录列出 gpt-6-luna,走 OpenAI 兼容接口(/v1/chat/completions),标价输入 $0.1、输出 $0.5(每百万 token),与 OpenAI 官方 Standard 价格相同,实际扣费以控制台和调用日志为准。目录里没有 Decisions 模型,所以它只能跑上文的严格枚举方案。接入时用第三步的写法,把 base_url 换成 https://api.laozhang.ai/v1。
它是否完整透传 response_format 的严格 json_schema 和 reasoning_effort,公开文档里没有写明。上线前先做一次确认:
- 发一条正常工单,看返回的
message.content是否是{"answer": "..."}这样的纯 JSON,且值在列表里。 - 再发一条和问题完全无关的输入(比如一句闲聊),看返回是否仍是合法 JSON、仍是列表里的值(理想情况是
needs_human)。 - 如果返回了自由文本、被 Markdown 代码块包裹的 JSON 或列表外的值,说明约束没有生效。这时本地校验会把它们兜成
needs_human,但兜底比例会变高,需要评估是否改走官方直连。
Decisions API 价格、开放时间与 Jev 的常见问题
OpenAI Decisions API 的价格是多少?
使用 gpt-6-luna 时,每百万输入 token $0.10,输出、缓存读取和缓存写入都不收费;区域处理溢价和长上下文倍率仍然适用。按每次 400 输入 token 估算,每千次判断 $0.04,每百万次 $40。注意这个端点没有缓存折扣,提示词里固定说明很长时,命中缓存的 Luna Responses 可能更便宜。这是公测期价格,GA 后的价格没有公布。
OpenAI Decisions API 什么时候全面开放?
它从 2026 年 10 月 6 日(美国时间)起已经公测,开发者不用申请就能调用。正式发布(GA)官方只说"未来几周",没有给日期。GA 前接口和价格都可能调整,以 Decisions 指南和更新日志为准。
GPT-6 Luna 和 Decisions API 是什么关系?
Decisions API 目前只支持 gpt-6-luna 一个模型。同一个 Luna 走 /v1/responses 时生成文字、按 Luna 的输入加输出价格计费;走 /v1/decisions 时只返回概率、选项或分数,只收输入费。OpenAI 称后者快约 10 倍。
OpenAI Decisions API 和 Jev 有什么不同?
Jev 是 TypeSafe AI 的专用判断模型,只接受文本;Decisions API 能处理图片,而且在 OpenAI 平台内,可以用零数据保留、HIPAA 和美欧数据驻留。两者的效果对比目前只有第三方报告,结论不一:classmethod 测得延迟相近(255 毫秒对 238 毫秒),按每次请求计,Decisions 约 $0.0000406、Jev 约 $0.0000169;社区里有开发者认为 Jev 在需要判断的任务上更准,也有人在文档分类和成文规则路由上测得各模型差不多。用你自己的标注样本对比再选。