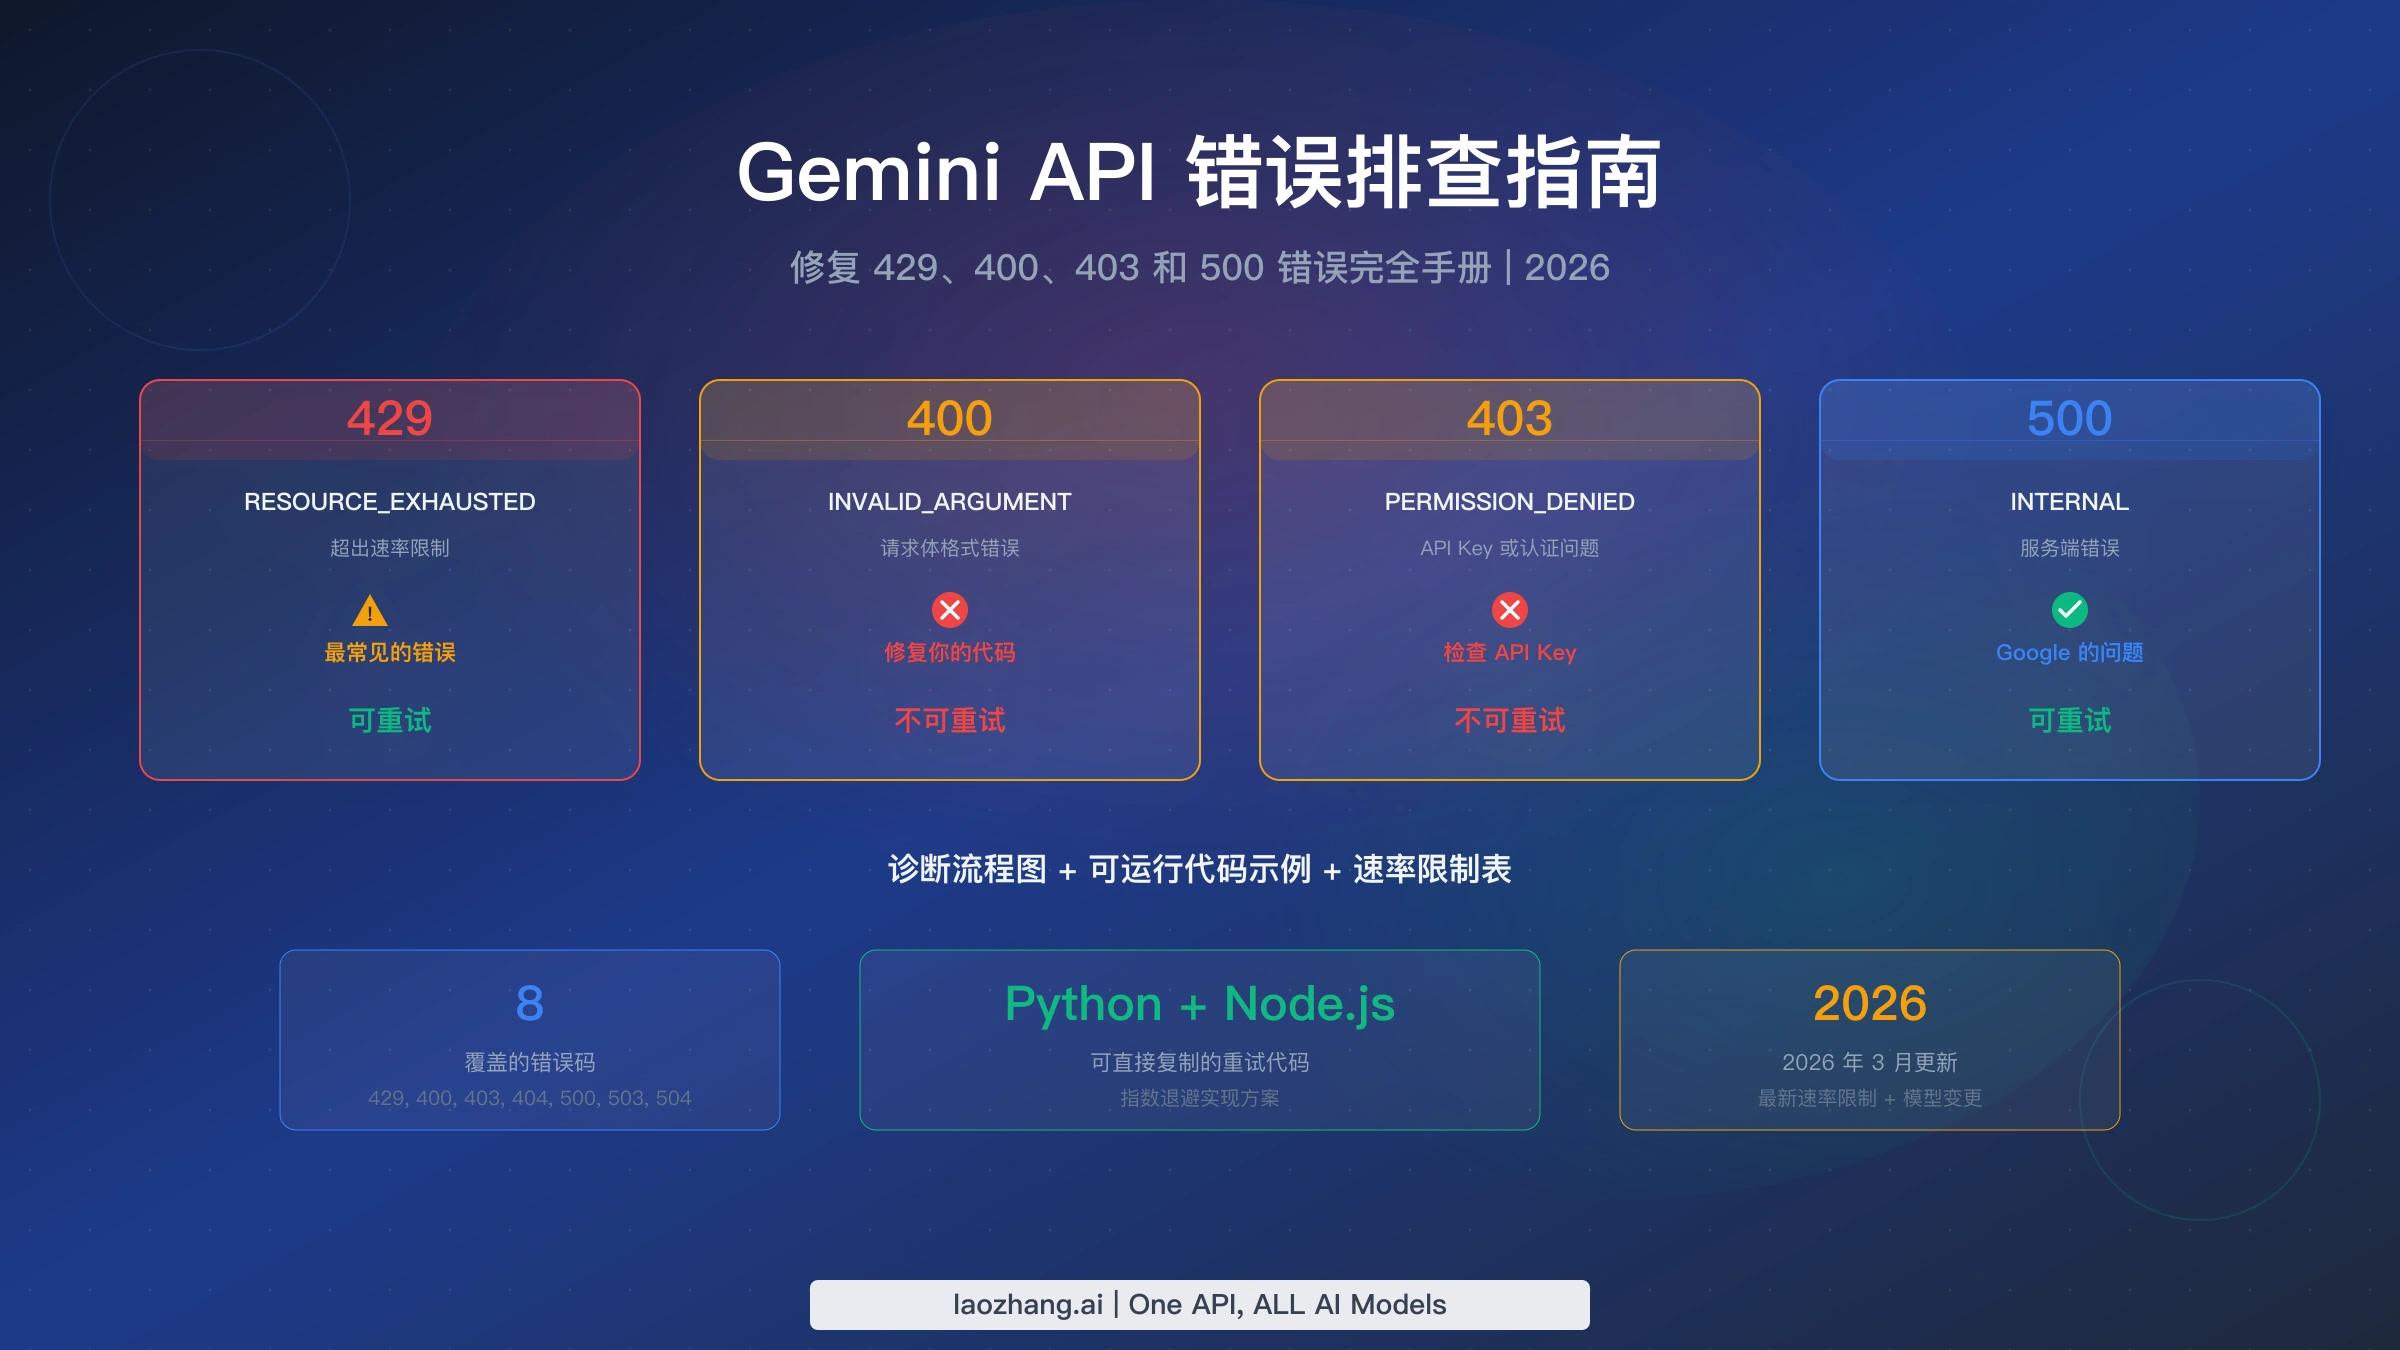
Gemini API 调用失败后,先保存脱敏后的错误详情,再判断是否值得重试。400 通常要改请求,403 要查项目和资源权限,404 要核对模型或文件;429 必须分清短时间限流与额度耗尽。500、503、504 可以在限定次数内重试,持续失败则应缩小请求或转入故障处理,不能靠循环保证成功。
本文针对 Gemini Developer API 的服务端调用,保留 Python 与 Node.js 的可运行示例。Gemini 网页、CLI、AI Studio 界面以及 Enterprise 接口的登录和额度规则不能直接套用。以下文档与 SDK 用法核对于 2026 年 10 月 28 日。
先看错误详情,再选排查路径
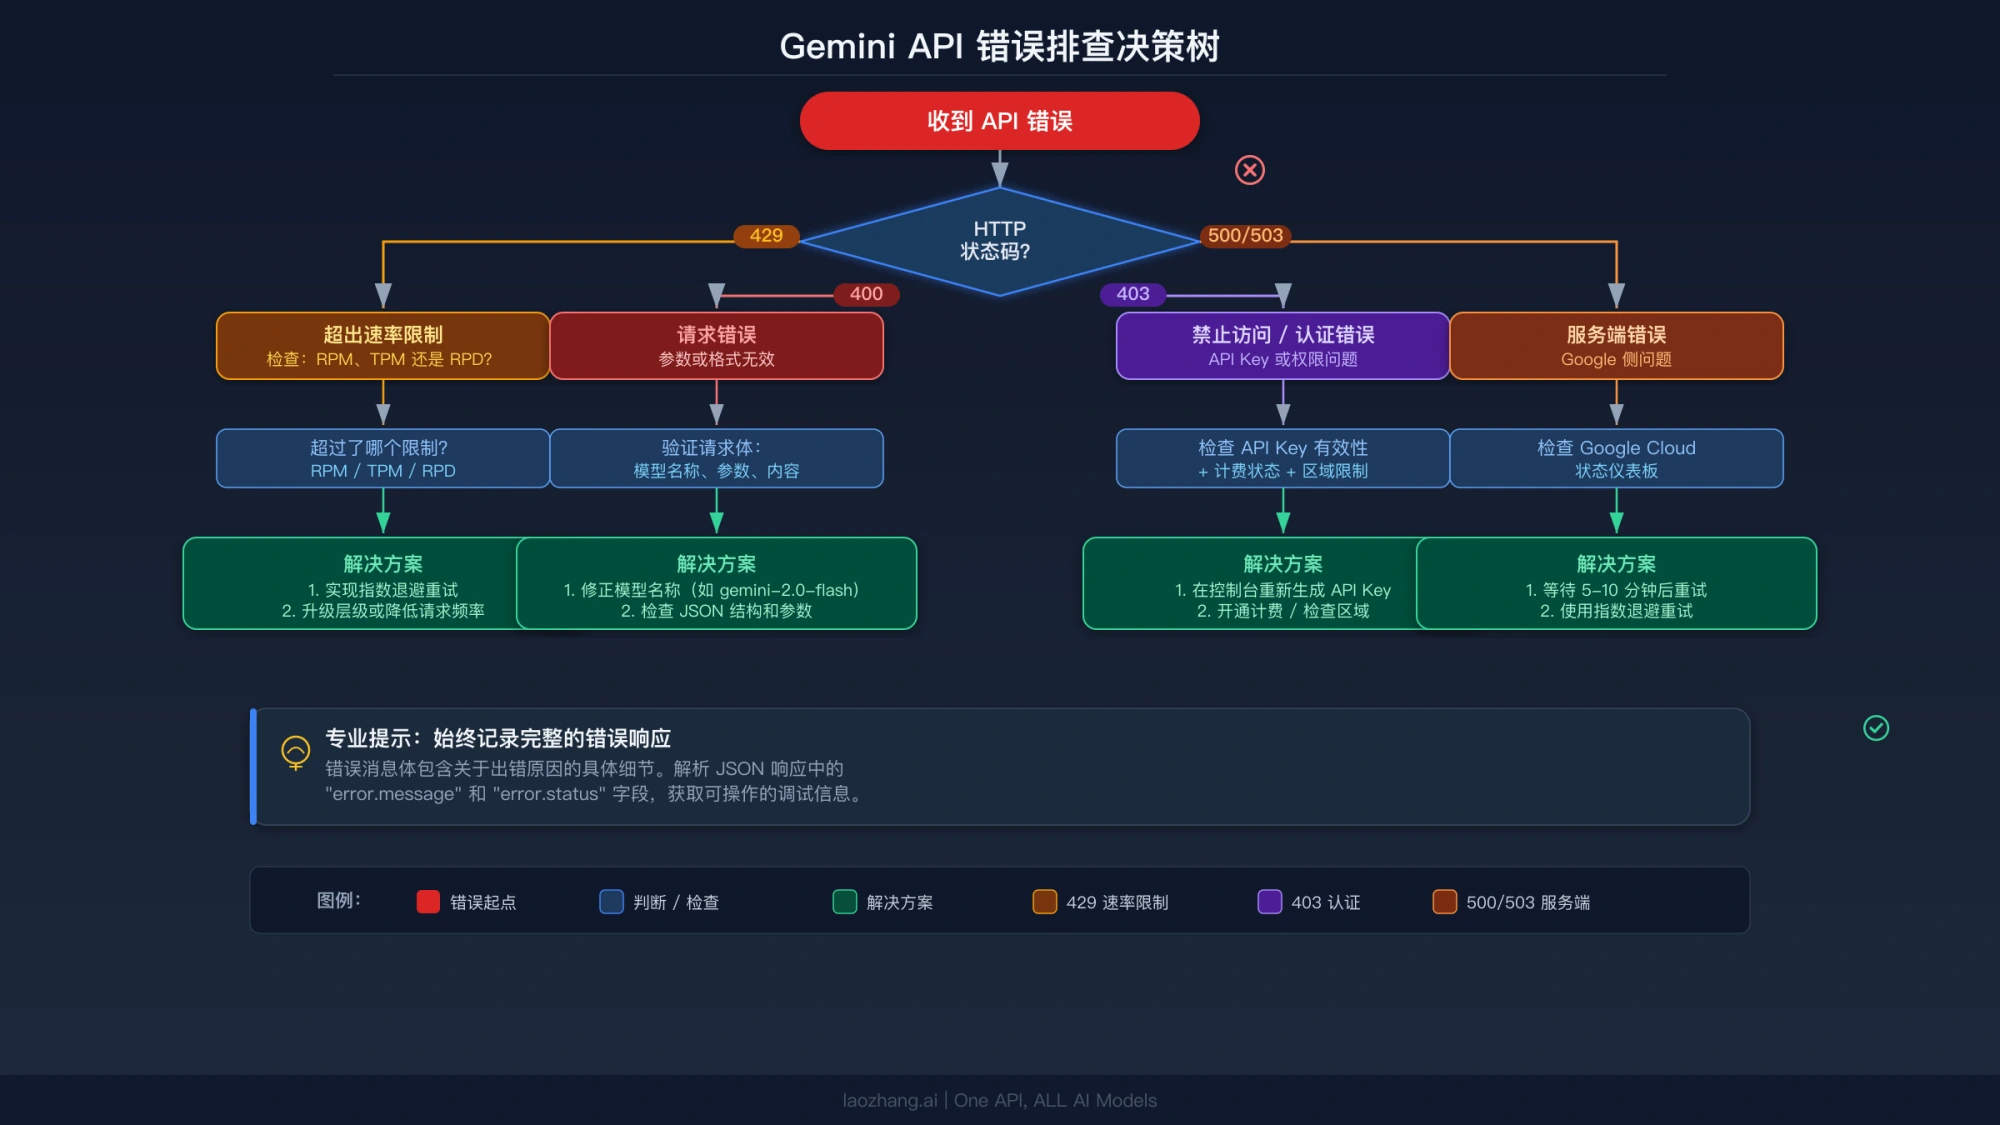
同一个 HTTP 状态码可能对应不同原因。记录接口、模型 ID、HTTP 状态、错误标识与消息,确认响应来自哪个服务;只看到 SDK 抛出的“请求失败”,往往还不足以定位。
| 看到的状态 | 先核对什么 | 下一步与停止条件 |
|---|---|---|
| 400 | 错误指向的字段、请求格式、模型支持的功能,或前提条件 | 改正后再发送;原样循环没有帮助 |
| 401 或密钥无效提示 | 服务端是否读到正确凭据、认证方式是否匹配接口 | 修复凭据配置,不自动重试 |
| 402 | 是否明确提示预付费余额耗尽 | 检查计费状态,余额问题解决前停止请求 |
| 403 | Key 所属项目、项目资格、计费或策略限制、资源权限 | 根据消息处理对应限制,不能只反复换 Key |
| 404 | 模型 ID、API 版本、资源路径、文件是否仍存在 | 修正目标或恢复资源后再试 |
| 429 | 限流指标、计量窗口、日额度及适用的支出限制 | 短时限流可排队退避;额度耗尽要等重置或调整额度 |
| 500、503 | 是否偶发、是否仅特定请求失败、服务状态 | 少量重试;持续失败就停止并保留诊断信息 |
| 504 | 是服务端返回状态,还是客户端自己超时 | 检查耗时与输入;延长客户端等待不保证解决服务端超时 |
这些是诊断入口,不是所有端点共用的一份 JSON 格式。当前 API 错误文档 对 Interactions API 使用 rate_limit_exceeded 等字符串 error.code;generateContent 的响应或 SDK 异常可能出现整数状态码与 RESOURCE_EXHAUSTED 等名称。日志中应分别保存 HTTP 状态和错误标识,不能把字符串 error.code 直接当成 HTTP 整数比较。
如果根本没有收到 HTTP 响应,先检查运行环境的 DNS、TLS、网络连接及客户端超时。浏览器能打开 AI Studio,不足以证明容器或服务器的调用链路正常。
429:先分清“太快”还是“已经用完”
429 的处理取决于触发了哪一种限制。短时间请求过密可以降速,日额度耗尽不能靠几秒钟的退避恢复。 先在 AI Studio 的当前限额页面 核对同一项目、同一模型,再对照错误详情。
Gemini Developer API 的 RPM 是每分钟请求数,TPM 通常指每分钟输入 Token 数,RPD 是每日请求数;任一适用指标超限都可能使请求失败。限制按项目计算,同一项目多建几把 Key 不会增加配额。RPD 在太平洋时间午夜重置,换算本地时间应使用 America/Los_Angeles 时区,考虑夏令时。官方限流说明
| 错误详情与使用情况 | 有效动作 | 如何判断下一步 |
|---|---|---|
| 短时间 RPM 触顶 | 降低并发、集中排队、拉开请求间隔 | 等窗口释放后做少量请求,不同时唤醒全部任务 |
| 输入 TPM 触顶 | 缩减无关上下文,限制单位时间内发送的 Token | 只减少请求数量但保留超大输入,仍可能超限 |
| RPD 或其他日额度耗尽 | 暂停相应任务,等待重置,或检查能否申请调整 | 不再运行秒级重试循环 |
| 适用的支出速率上限触发 | 平滑任务调度,查看对应支出窗口 | 账户有余额不代表这个窗口还有容量 |
| 详情不明确,仪表板用量很低 | 核对项目、模型、指标与时间范围,保留完整的脱敏错误 | 不能仅凭低用量断定是服务端故障 |
部分账户还适用滚动 10 分钟的支出速率限制,具体是否适用取决于计费历史和账户状态。它与月预算、预付费余额是不同限制,可能解释“RPM、TPM 都不高,仍然 429”的情况。支出速率限制说明
对任务队列来说,比反复重试更有用的是在发送前控制流量。例如,短时间内来了大量独立任务,就让它们按项目共用一条限流队列,而不是让每台应用实例各自以为还有完整配额。合并小请求只在任务适合一起处理时才有帮助;它能降低请求次数,却不一定降低输入 Token,也可能让单次响应更慢。
如果决定开通计费,先看当前项目能获得的实际限额和计费条件。付费使用仍有容量限制,不能保证某个固定倍数的提升,也不能保证立即消除 429。
403:区分密钥问题、项目资格和文件权限
403 表示访问被拒绝,但原因不只在 Key。按照错误消息逐项确认:
- 当前程序使用的是哪一个项目的 Key。 检查部署环境中的变量来源,避免本地配置正确、服务器却读到旧值。不要把完整 Key 打进日志。
- 是否明确提示密钥泄露、封禁或失效。 这类情况需要撤销暴露的凭据并替换应用配置,同时排查泄露位置;仅在同一份公开代码里换一把 Key 会重复发生。
- 项目是否具备相应使用资格。 项目受限、免费层不可用、关联计费账户异常或策略暂停,应分别按提示处理。重新生成同一项目的 Key 不会改变项目资格。
- 请求是否引用了其他资源。 带文件的调用要核对文件所属项目、权限和有效期;纯文本调用成功也不能证明某个文件可用。
如果错误指向 Key 类型或限制设置,还要区分 standard key 与授权密钥。当前 Gemini API 会拒绝未设置限制的 standard key,受限制的 standard key 仍可使用;不要把“解除所有 Key 限制”当作通用修复。使用正确的 Gemini API 限制设置,并按官方密钥说明检查密钥类型。
Google 的项目受限排查说明指出,并非所有项目和账户都符合免费层条件。部分受限项目需要关联有效的付费计费账户;这意味着按付费条件使用,不是“开通计费后获得更多免费额度”。
执行位置也要单独检查。截至本次核对,中国大陆不在 Gemini API 的支持地区列表中。中文读者可能在不同地区运行服务,应以实际调用环境和账户条件判断;开通计费不能替代地区资格。
为什么列出模型成功,生成内容仍然 403?
models.list 返回 200 不能证明推理权限正常。官方说明,该操作可以确认 Key 存在,但不检查项目使用资格或计费状态;generateContent 等推理接口还会执行相应检查。模型列表与推理权限的区别
确认项目和计费条件后,才有必要用同一项目、同一模型发送最小生成请求。最小请求也可能产生费用。若它仍然失败,继续查访问条件;若它成功而业务请求失败,再逐步恢复业务参数与附件,找出差异。
只有带文件的请求失败怎么办?
先通过 files.get 核对上传文件的元数据。Files API 上传的文件会在 48 小时后自动删除,旧文件引用不能永久复用;失效后需要重新上传,并更新请求里的引用。Files API 文件生命周期
排查时可以用不带附件的请求验证基础访问,但不能删掉用户必须分析的文件后,就把一次纯文本响应当作业务成功。
400 和 404:从最小请求查参数与模型
400 优先读错误消息中指出的字段。先保留准确的模型 ID 和一段短文本,去掉非必要的工具、结构化输出配置、附件及调参项;最小请求成功后,再逐项恢复。若是 FAILED_PRECONDITION 或对应的前提条件错误,则应检查消息所指的项目、计费或地区要求,而不是只改 JSON。
模型参数不能跨代照搬。当前官方说明中,Gemini 3.6 及之后和 Gemini 4 对 temperature、top_p、top_k 的处理与早期 Gemini 3 不同,部分参数会被忽略并给出警告,未来可能改为拒绝。排查时以所用模型的说明为准,不要把“所有 Gemini 模型都必须把 temperature 设成 1”当作修复规则。模型参数排查
404 则优先核对资源是否正确:模型名称是否精确、所选 API 版本是否支持该方法、文件或缓存是否存在。若程序昨天能用、今天开始失败,也要检查模型生命周期,但不能仅凭日期推断模型已关闭。模型目录与弃用说明应一起核对;旧教程里的默认模型不一定对新项目开放。
改模型时还要重新检查输入格式、工具支持和输出要求。新模型能返回文本,只说明基础调用恢复,不能代替原业务的功能验证。
500、503、504:有限重试后,用对照请求缩小范围
偶发的 500 或 503 可以退避后重试;同一输入持续失败,就需要比较请求本身。用同一项目、同一模型先尝试较短的输入,再逐步恢复上下文和功能:短请求成功、长请求失败,是继续调查输入规模和处理耗时的线索,不是已经证明存在某个固定上下文边界。
查看 Gemini 官方状态页可以确认是否有公开事故。但状态页没有公告,既不能排除个别请求故障,也不能证明自己的代码有错。故障若集中在特定时间或模型,记录这一模式,比不断切换配置更利于后续处理。
504 是服务端返回的截止时间错误,客户端超时则是本地在等待期间中止,两者要分开记录。客户端等待时间过短时可以根据业务预算调整;服务端已经返回 504 时,单纯把本地超时改得更大不保证有效。缩短输入、拆分可独立处理的任务,或降低单次请求的复杂度,都应通过对照请求验证效果。错误定义
对于用户正在等待的交互请求,还要限制整体等待时间。多次调用的耗时加上退避等待,可能远超单次超时设置。客户端放弃等待,也不能证明服务端没有处理或生成结果;不要立即启动多条重复请求来“抢一个成功”。
Python 与 Node.js:只在 SDK 一层设置重试
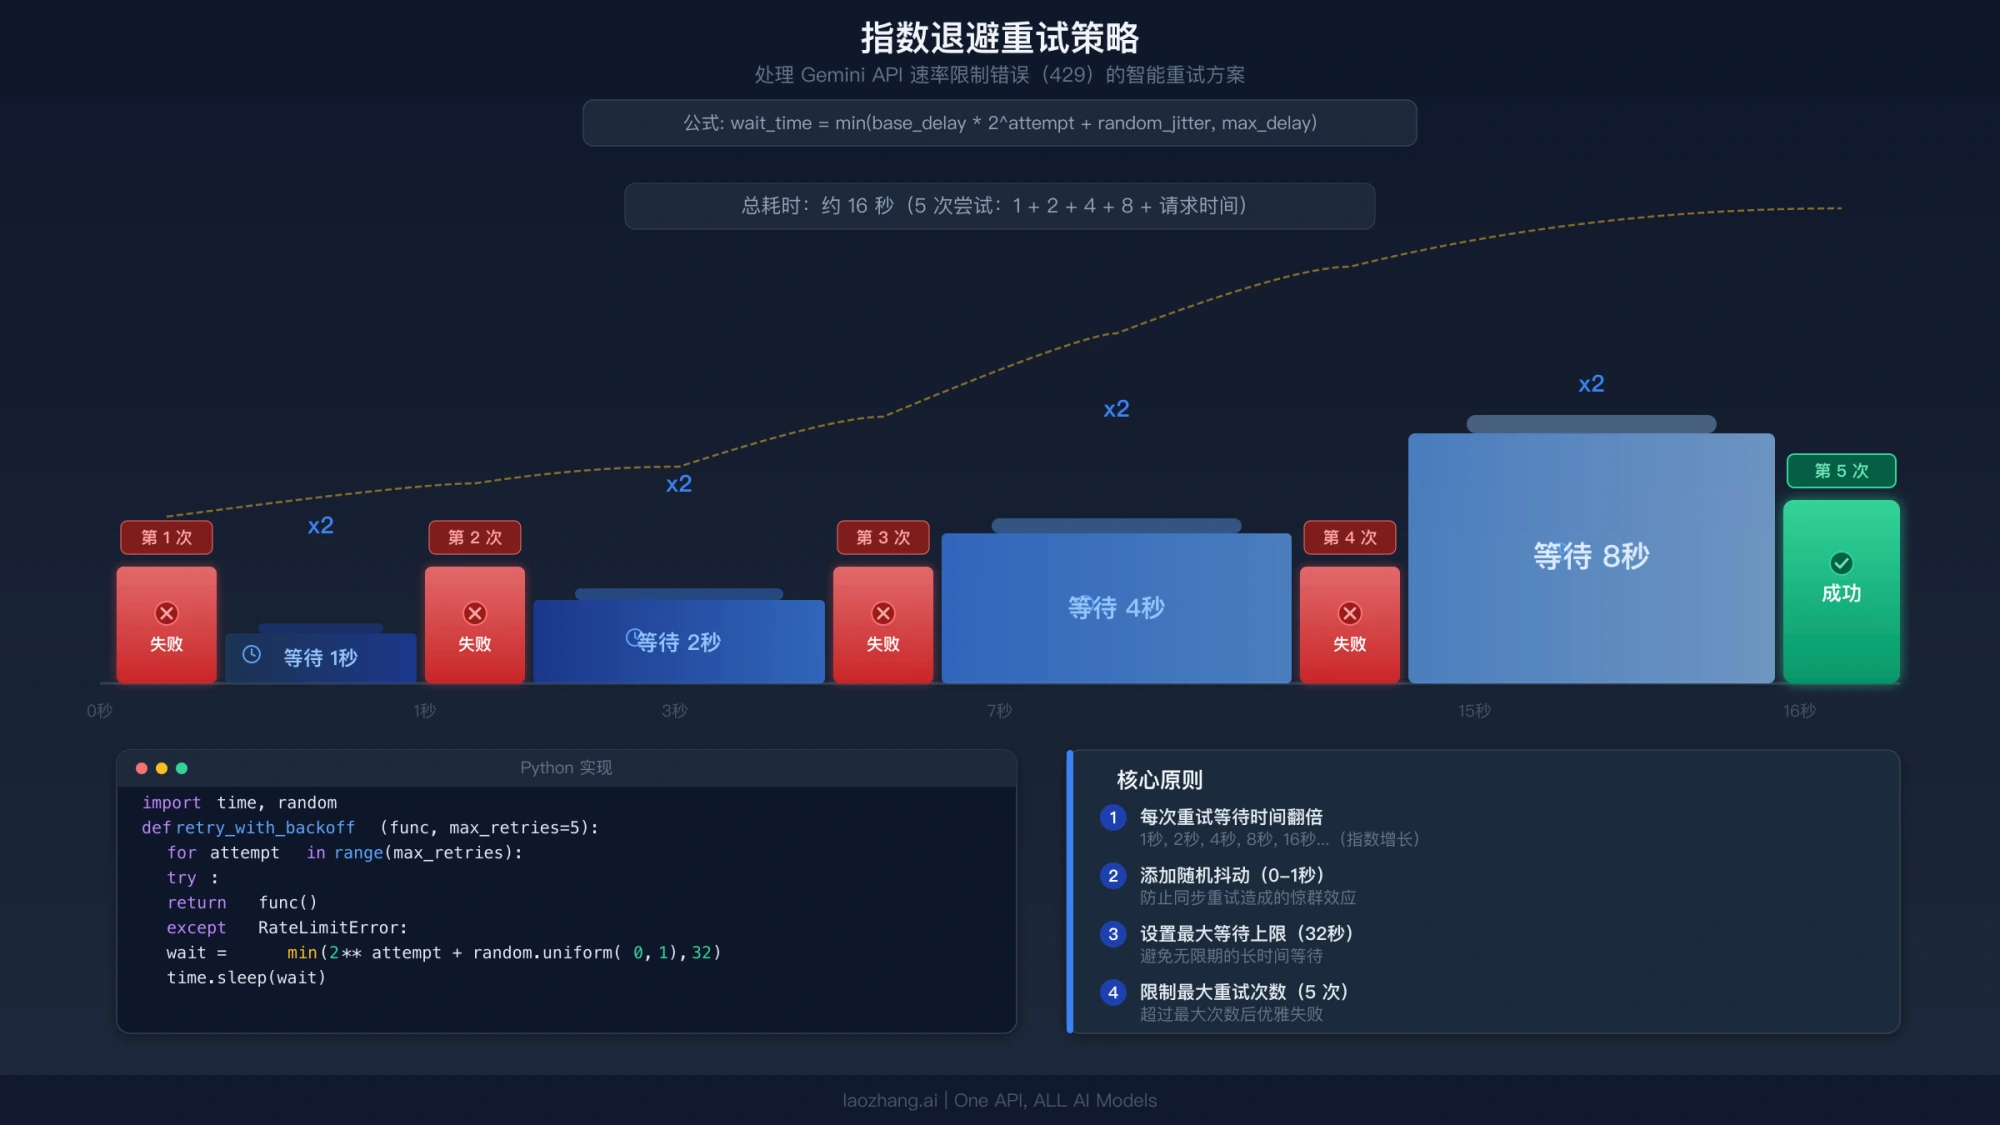
当前官方库是 Python 的 google-genai 和 JavaScript 的 @google/genai,旧版 google-generativeai、@google/generative-ai 不再是本页示例的依赖。官方 SDK 说明
SDK 自动读取环境变量时,如果同时设置 GOOGLE_API_KEY 和 GEMINI_API_KEY,前者优先。下面的代码显式传入 GEMINI_API_KEY,避免排查时误用另一项配置;不要打印变量值来确认来源。环境变量读取规则
下面使用 SDK 自带的有界重试,不再叠加外层循环。示例策略是:500、503、504 最多尝试 3 次,包含首次请求;429 先返回给调用方诊断。 只有确认是可恢复的短时限流,并且应用已做排队和额度控制,才考虑把 429 加入允许重试的列表。402、400、403、404 和不支持功能的 501 不在列表中。
这是一组便于说明的应用设置,不是 Google 推荐的统一等待预算。timeout 的单位是毫秒,延迟字段的单位是秒;SDK 的随机抖动用于分散同时重试的请求。参数定义见 Python SDK和 JavaScript HttpRetryOptions。
Python 示例
安装 google-genai,在服务端环境中设置 GEMINI_API_KEY 和 GEMINI_MODEL。模型值应填写当前项目确实可访问的模型 ID;不要直接沿用过期教程的默认值。把以下代码保存为 gemini_check.py,执行 python gemini_check.py 会发起真实生成调用。
import os
from google import genai
from google.genai import errors, types


def main():
    with genai.Client(
        api_key=os.environ["GEMINI_API_KEY"],
        http_options=types.HttpOptions(
            timeout=30_000,
            retry_options=types.HttpRetryOptions(
                attempts=3,
                initial_delay=1.0,
                max_delay=8.0,
                exp_base=2.0,
                jitter=1.0,
                http_status_codes=[500, 503, 504],
            ),
        ),
    ) as client:
        try:
            response = client.models.generate_content(
                model=os.environ["GEMINI_MODEL"],
                contents="请只回复:连接成功",
            )
        except errors.APIError as exc:
            # 不把原始请求、Key 或用户数据写进日志。
            print(f"调用失败,HTTP 状态:{exc.code}")
            raise SystemExit(1) from None
        print(response.text or "响应没有文本,请检查候选项和完成状态。")


if __name__ == "__main__":
    main()
Node.js 示例
安装 @google/genai,配置同样的两个环境变量。将代码保存为 gemini-check.mjs,执行 node gemini-check.mjs。示例使用 ESM 导入方式。
import { GoogleGenAI, ApiError } from "@google/genai";

async function main() {
  const apiKey = process.env.GEMINI_API_KEY;
  const model = process.env.GEMINI_MODEL;
  if (!apiKey || !model) {
    throw new Error("请设置 GEMINI_API_KEY 和 GEMINI_MODEL。");
  }
  const ai = new GoogleGenAI({
    apiKey,
    httpOptions: {
      timeout: 30_000,
      retryOptions: {
        attempts: 3,
        initialDelay: 1.0,
        maxDelay: 8.0,
        expBase: 2.0,
        jitter: 1.0,
        httpStatusCodes: [500, 503, 504],
      },
    },
  });
  try {
    const response = await ai.models.generateContent({
      model,
      contents: "请只回复:连接成功",
    });
    console.log(response.text || "响应没有文本,请检查候选项和完成状态。");
  } catch (error) {
    if (error instanceof ApiError) {
      console.error(`调用失败,HTTP 状态:${error.status}`);
    } else {
      console.error("未取得可识别的 API 错误,请检查本地配置和网络。");
    }
    process.exitCode = 1;
  }
}

await main();
这里的成功信号是收到预期文本;仅有 HTTP 成功或空文本,不代表业务任务完成。示例只打印状态码以减少信息暴露,实际排障仍应在受控位置保留脱敏错误详情。
上述示例使用 google-genai 2.33.0、@google/genai 2.31.0 做了本地语法与模拟响应验证,检查成功响应、指定状态的重试次数和失败退出。测试用假 Key 拦截网络,并缩短等待时间,没有调用真实模型,不能据此证明某个账户、地区或模型当前可用。
持续失败时,留下能复现的信息
当请求格式和访问条件已经核对,有限重试仍然失败,就停止自动放大请求量。后台任务保留失败状态与恢复入口;交互请求给用户明确提示,避免界面一直显示加载。需要切换模型时,先确认备用模型满足任务要求与权限条件,不能把“有任意结果”当成等价恢复。
给维护者或支持渠道的记录应包含:
- 出错时间与时区、SDK 版本、实际调用的服务和 API 方法。
- 模型 ID、HTTP 状态、脱敏后的错误标识与消息,以及响应提供的请求标识。
- 问题是偶发还是稳定复现,是否只有特定输入、附件或模型失败。
- 尝试次数、总耗时、输入规模,以及最小请求的结果。
不提交 API Key、认证请求头、含密钥的 URL、完整用户提示词或附件内容。需要复现时,用不含敏感数据的最小样本替换,并保留触发故障所必需的结构。
常见疑问
换一把 API Key 能解决 429 吗?
如果新旧 Key 属于同一项目,不能增加该项目的配额。应按实际触发的 RPM、TPM、RPD 或其他限制处理;Key 轮换适用于凭据泄露或失效等问题。官方限流说明
为什么付费后还是报错?
付费不等于无限容量。先区分错误是配额、支出速率、余额、关联计费账户还是项目策略问题,再检查所用模型是否对当前项目开放。不同错误需要不同恢复动作,不能用继续充值替代诊断。
请求失败还会收费或占用配额吗?
Google 计费 FAQ 明确说明,返回 400 或 500 的失败请求不收取 Token 费用,但仍计入配额。这个结论不能扩大到所有状态、客户端超时或重复生成;出现超时时,不能仅凭客户端没收到结果判断服务端没有执行。失败请求的计费说明
429 用量显示为零,等半小时就会好吗?
不能保证。先核对查看的项目、模型、指标与计量窗口,再读错误详情。短时限流可能随窗口释放恢复,日额度、项目资格或计费限制则有各自条件。另一个具体区别是:授权密钥的请求不计入 Cloud 服务账户用量指标;这不等于 AI Studio 或所有仪表板都没有用量。密钥与用量指标说明