让 Claude Code “多跑一会儿”不是一个单一功能问题。一次模型请求超时、一条 Bash 命令等待结束、终端关闭,以及 conversation 成功恢复但旧进程已经消失,都会表现为“任务没跑完”,却需要完全不同的处理。
所以恢复时不要先问“要不要重试”,而要先问“哪个计时器到期了、哪些副作用可能已经发生”。把请求、命令、会话、文件回退和持久进度分开后,才能安全选择 retry、resume、rewind、respawn,或把任务迁移到更耐久的执行面。
请求超时和命令超时是两块不同的表
Claude Code 当前的错误参考把 API_TIMEOUT_MS 的默认值列为 600000 毫秒,也就是单次模型请求 10 分钟。单独的环境变量参考则把 Bash tool 的 BASH_DEFAULT_TIMEOUT_MS 默认为 120000 毫秒,并把默认最大值 BASH_MAX_TIMEOUT_MS 设为 600000 毫秒。
这三个时间边界不能混为一谈:
- 请求超时:Claude Code 在请求 deadline 前没有收到模型响应;
- Bash 超时:tool invocation 等待命令的时间到期,不自动说明模型请求或所有子进程的状态;
- 任务 deadline:你为时间、预算和风险设置的业务停止点。
官方错误参考指出,负载较高或生成特别大的响应都可能导致 Request timed out。拆小任务通常比盲目延长等待更安全。只有已知瓶颈是慢网络或 proxy 时,才考虑调大 API_TIMEOUT_MS;更大的数字不会自动生成 checkpoint,也不会让 shell side effect 变得幂等。
Claude Code 还会对 server error、overload、request timeout、临时 429 和连接中断执行带指数退避的自动重试,默认最多 10 次。界面会显示 attempt 倒计时。当最终错误已经出现时,这些内置重试已经耗尽。再在外层套一个无限循环,可能只会重复费用或副作用。
先用四个问题确定任务的生命周期
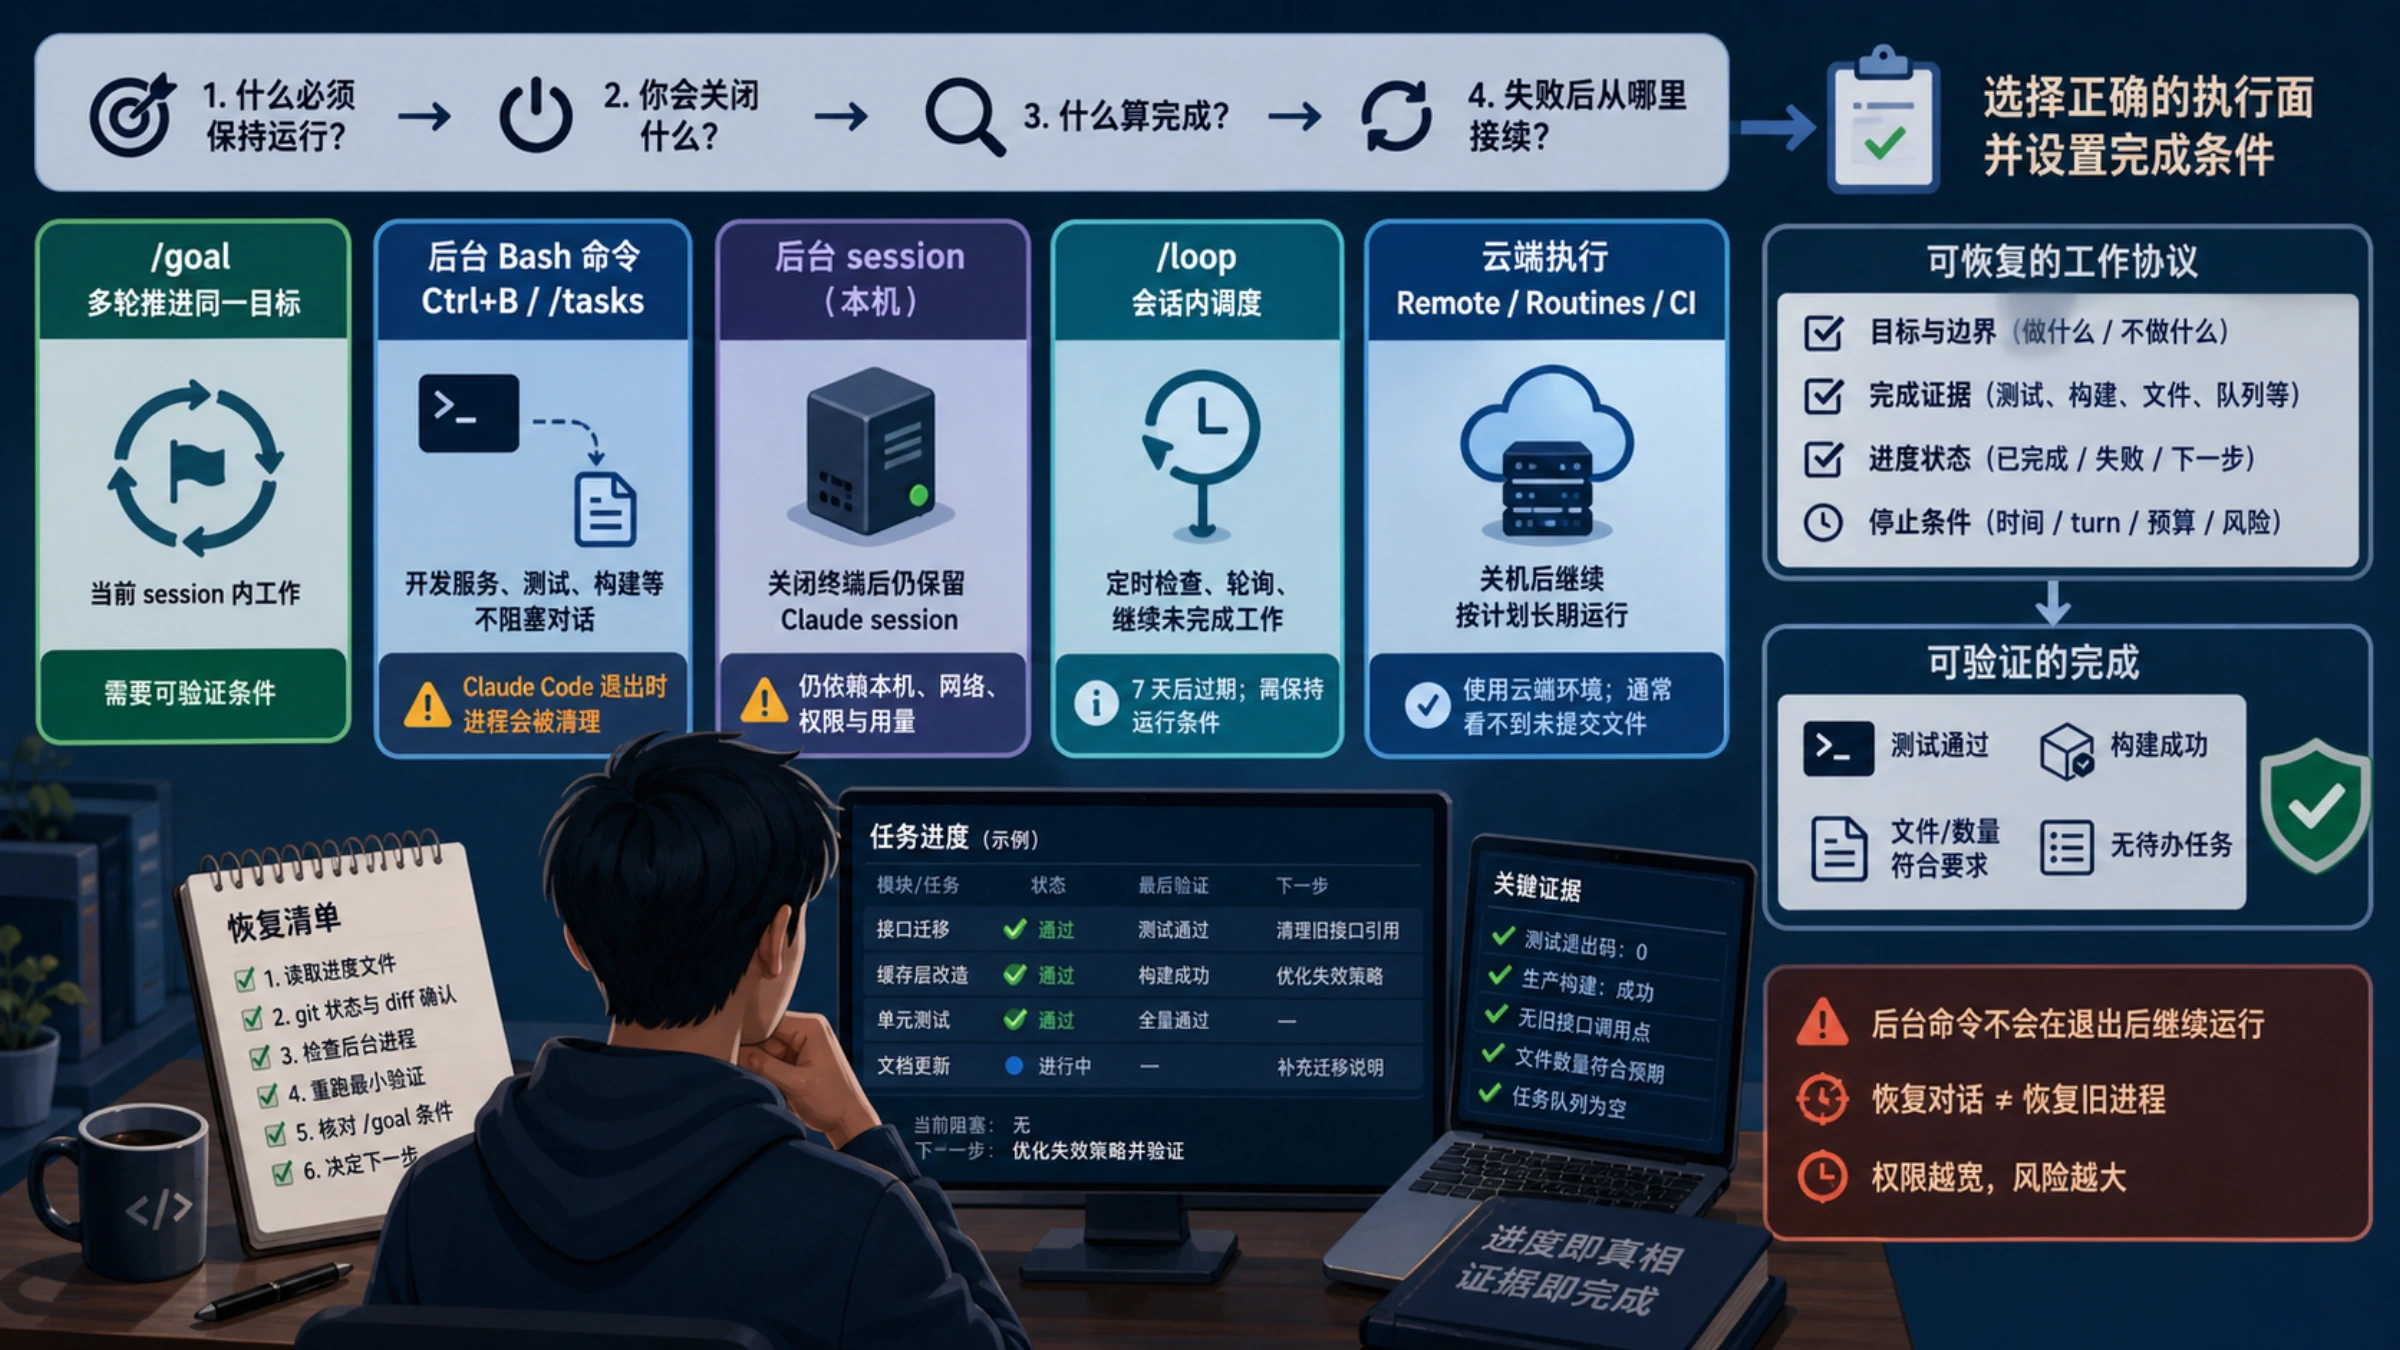
启动前先回答下面四个问题,往往比研究更多命令更有用:
- 什么必须保持运行? 是一条
npm test、一个 Claude Code agent session,还是一个每天重新启动的新任务? - 你会关闭什么? 只离开键盘、关闭终端、退出 Claude Code、让电脑睡眠,还是彻底关机?
- 什么算完成? “代码看起来差不多”不够;需要测试退出码、构建结果、文件数量、空任务队列或其他可观察证据。
- 失败后从哪里接续? 进度只存在对话里,还是已经写入任务文件、Git 提交、测试报告或其他持久状态?
这四个答案会把常见需求分成几类:
| 需求 | 合适的起点 | 关键边界 |
|---|---|---|
| 让 Claude 连续多轮推进同一目标 | /goal | 当前 session 内工作,需要可验证条件 |
| 让测试、构建或开发服务器不阻塞对话 | 后台 Bash、Ctrl+B、/tasks | Claude Code 退出时进程会被清理 |
| 关闭当前终端后仍保留一个本机 Claude session | agent view 的后台 session | 仍依赖本机、网络、权限与用量 |
| 稍后接着同一段对话工作 | --continue、--resume | 恢复的是会话记录,不是旧 Bash 进程 |
| 在当前 session 定时检查构建或部署 | /loop 或 cron tools | session 与电脑需满足运行条件,任务会过期 |
| 关机后继续或按计划长期运行 | Remote session、Routines 或 CI | 使用云端/CI 环境,不能假定拥有本地未提交文件 |
/goal 适合有明确终点的多轮工作
如果任务是“大改一批代码,直到验收条件成立”,/goal 比不断输入“继续”更贴合需求。/goal 官方文档说明,它会保存一个完成条件;每个 turn 结束后,独立的小模型根据对话中已经出现的证据判断条件是否成立。若未成立,Claude 会开始下一轮。
一个有效条件应同时写出结果、检查方式和边界。例如:
text/goal 完成 payments 模块的异步 API 迁移;npm test -- payments 退出码为 0,
npm run lint 通过,不修改 billing schema;如果 15 个 turn 后仍未完成,停止并报告阻塞。
这里真正重要的不是命令本身,而是“可证明”。/goal 的 evaluator 不会自行读文件或运行测试;它只能判断 Claude 已经在对话中展示的命令输出和结论。因此,应要求 Claude 在宣告完成前运行决定性检查,并把结果带回 transcript。
活跃的 goal 可以随 --continue 或 --resume 恢复,但恢复后计时、turn 数和 token 统计会重新计算。它适合跨几次人工停顿继续同一目标,不代表原进程在退出期间仍工作。
后台 Bash 解决“不阻塞”,不是“退出后继续”
开发服务器、长测试、构建、Docker 或 Terraform 命令经常只需要在当前 session 里异步运行。你可以明确让 Claude 在后台执行,也可以在 Bash tool 正在运行时按 Ctrl+B;如果你在 tmux 中,需要按两次,因为第一次是 tmux 前缀。
后台命令会获得 task ID,输出写入文件,Claude 可以稍后读取。/tasks(也可用 /bashes)用来查看、接入或停止当前 session 的后台工作。这个机制适合:
- 启动开发服务器后继续修前端;
- 跑完整测试集时先分析另一个失败;
- 等待构建、容器或基础设施命令返回;
- 保留一条可读取输出的长日志任务。
它不适合需要关闭 Claude Code 后继续的任务。官方文档还给出另一个硬边界:输出超过 5GB 时,后台任务会被终止。长时间产生日志的命令应主动写入轮转文件、减少 verbosity,或由专门的进程管理器接管。
需要离开终端时,用后台 session 而不是后台命令
较新的 agent view 把 Claude Code session 交给本机的 supervisor 管理,而不是让它成为当前终端的子进程。agent view 文档给出了对应的管理入口:
bashclaude agents
claude attach <id>
claude logs <id>
claude stop <id>
claude respawn <id>
这类 background session 可以从终端分离,之后重新连接。一个仍在工作、等待输入或有终端连接的 session 会保持进程;已经完成且无人连接的 session 大约空闲一小时后,supervisor 可能停止其进程以释放资源,但 transcript 和状态仍保存在磁盘,重新接入时再从原位置启动。
这个路线解决的是“不要把长 agent session 绑死在某个终端窗口”。它仍然是本机执行:电脑关机、网络断开、系统睡眠、账号用量耗尽或权限被拒绝都可能让工作停下。需要真正脱离本机时,应换到 Remote session、Routines 或 CI,而不是再叠一层 shell 技巧。
/loop 是会话内调度,Routines 才是耐久调度
/loop 适合“每隔一段时间检查一次”的任务,例如轮询部署、照看 PR、等待集成测试,或在空闲时继续未完成工作。计划任务文档说明,/loop 和 cron tools 属于当前 conversation;Claude Code 需要保持运行,调度任务在 turn 之间以低优先级触发。
text/loop 10m 检查 staging 部署;如果失败,读取最后一次失败日志并报告最小阻塞原因
当前官方合同还有几个容易忽略的限制:循环任务七天后自动过期;错过的触发不会逐次补跑;恢复 session 只能带回尚未过期的 schedule;后台 Bash 和 monitor task 不会随 resume 恢复。若你需要跨重启的本地计划,可以使用 Desktop scheduled tasks;若电脑可以关闭,则使用 Anthropic 云端 Routines 或 CI 的 schedule。
Claude Code Desktop 文档把 Remote session 描述为运行在 Anthropic 云端的任务,关闭 app 或本机后仍可继续。 Routines 文档则说明每次触发会创建新的云端 Claude Code session,结果可回看和审查。云端持续不等于自动成功:每次运行仍需要明确输入、可见输出和完成判断,而且云端环境通常使用仓库的 clone,看不到你本地未提交的文件。
检查点能回退编辑,但不是完整事务
Claude Code 会在每次用户 prompt 前创建 checkpoint,并让 checkpoint 随可恢复 session 保留。按两次 Esc 或运行 /rewind,可以只恢复 code、只恢复 conversation、同时恢复两者,或从选定位置压缩 context。官方检查点文档把它定义为 session 级的快速恢复能力。
它的边界比按钮更重要。Rewind 跟踪的是 Claude file editing tool 产生的修改,不能撤销 Bash 命令、手工编辑、外部程序或其他并发 session 的全部变化,也不能代替 Git。包含 migration、code generation 或外部 API 的任务,在 rewind 前仍要分别检查 git diff、生成物、数据库和外部系统。
可恢复的长任务因此需要两层 checkpoint:一层是 Claude Code 自带的 prompt checkpoint,负责 conversation 和直接文件编辑;另一层是项目自己的持久记录,负责已完成单元、验证证据和不可逆副作用。第二层可以是仓库内的 Markdown 或 JSON 进度文件、CI artifact,或团队已经信任的状态存储。
把长任务写成可恢复的工作协议
工具选对后,还要让任务的“真相”离开模型的短期记忆。一个可恢复协议至少应包含以下信息:
md目标:
- 将旧缓存接口迁移到新 API,同时保持现有失效语义。

完成证据:
- 指定测试退出码为 0;
- production build 成功;
- 不再存在旧接口调用点。

不得改变:
- 数据库 schema;
- 公共 API response shape;
- 与本任务无关的文件。

进度状态:
- 已完成的文件与验证命令;
- 当前失败和最小复现;
- 下一步;
- 需要人工决定的问题。

停止条件:
- 15 个 turn、2 小时或预算上限先到即停止;
- 遇到生产凭据、付费、部署或 destructive action 时暂停。
Anthropic 在长时间科学计算的研究实践中采用了相似的恢复思路:进度文件、测试 oracle、清晰规则和 Git checkpoint。那是 HPC 场景的实践示例,不是每个项目必须照搬的产品合同;但“把进度和验证留在持久介质中”适用于大多数长任务。
如果要并行,优先为不同 lane 使用隔离 worktree,并明确文件归属。多个 agent 同时改同一目录只会把长任务变成更长的冲突恢复。需要组织多个 Claude worker 时,可进一步查看 Claude Code Agent Teams 指南,但先确保单个任务的完成条件和写入边界已经清楚。
权限越少打断,风险边界越要清楚
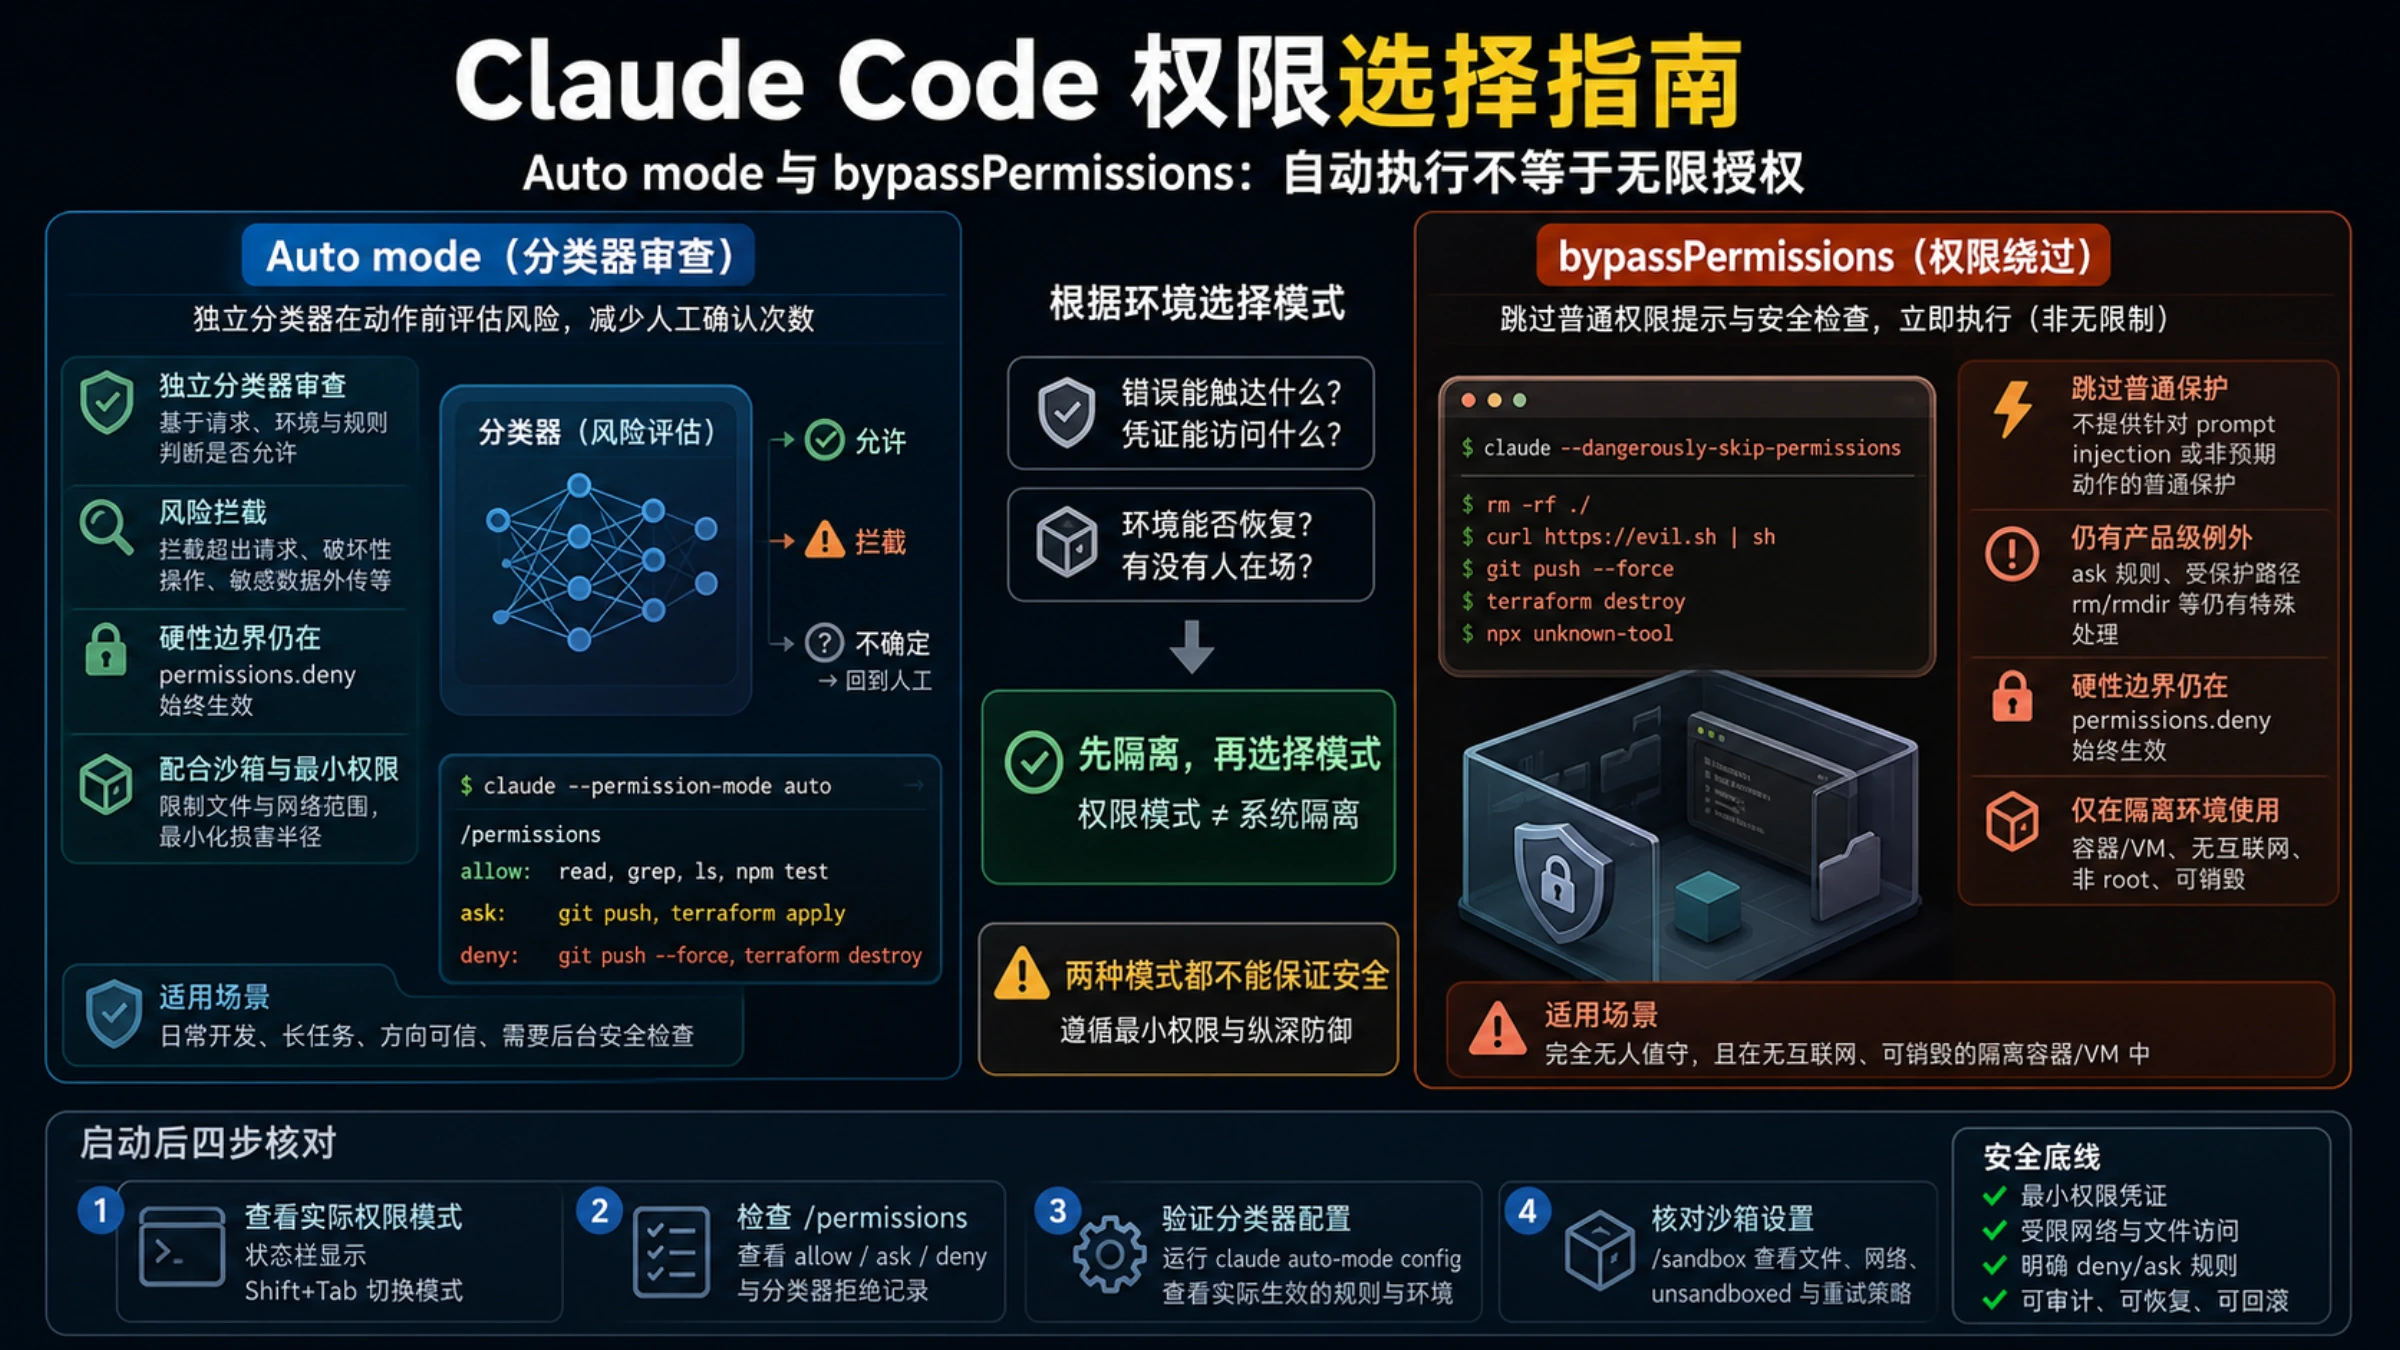
长任务常因 permission prompt 停住。解决办法不是默认关闭所有保护。权限模式文档把模式分成不同监督强度:acceptEdits 适合你会持续 review 的编辑工作;dontAsk 只运行预先允许的工具,适合锁定的脚本或 CI;Auto mode 会用额外 classifier 检查动作,减少 prompt,但它仍是 research preview,而且取决于版本、套餐、模型、provider 和管理员设置。
bypassPermissions 会跳过 permission layer。Anthropic 将其定位为隔离 container 或 VM 中的路线,并明确警告它不提供 prompt injection 防护。让任务跑更久并不会降低误删、泄密、错误部署或高额消耗的代价。需要无人值守时,最好缩小文件系统、网络、凭据、分支和预算范围,而不是扩大权限。
同时给任务一个支出和用量停止点。若 session 因额度中断,先保存目标、已改文件、最后检查和下一步,再进入 Claude Code 用量限制诊断;不要在不清楚认证和计费路线时反复重试或直接购买额外用量。
重试前先对账,别把错误当成自动回滚
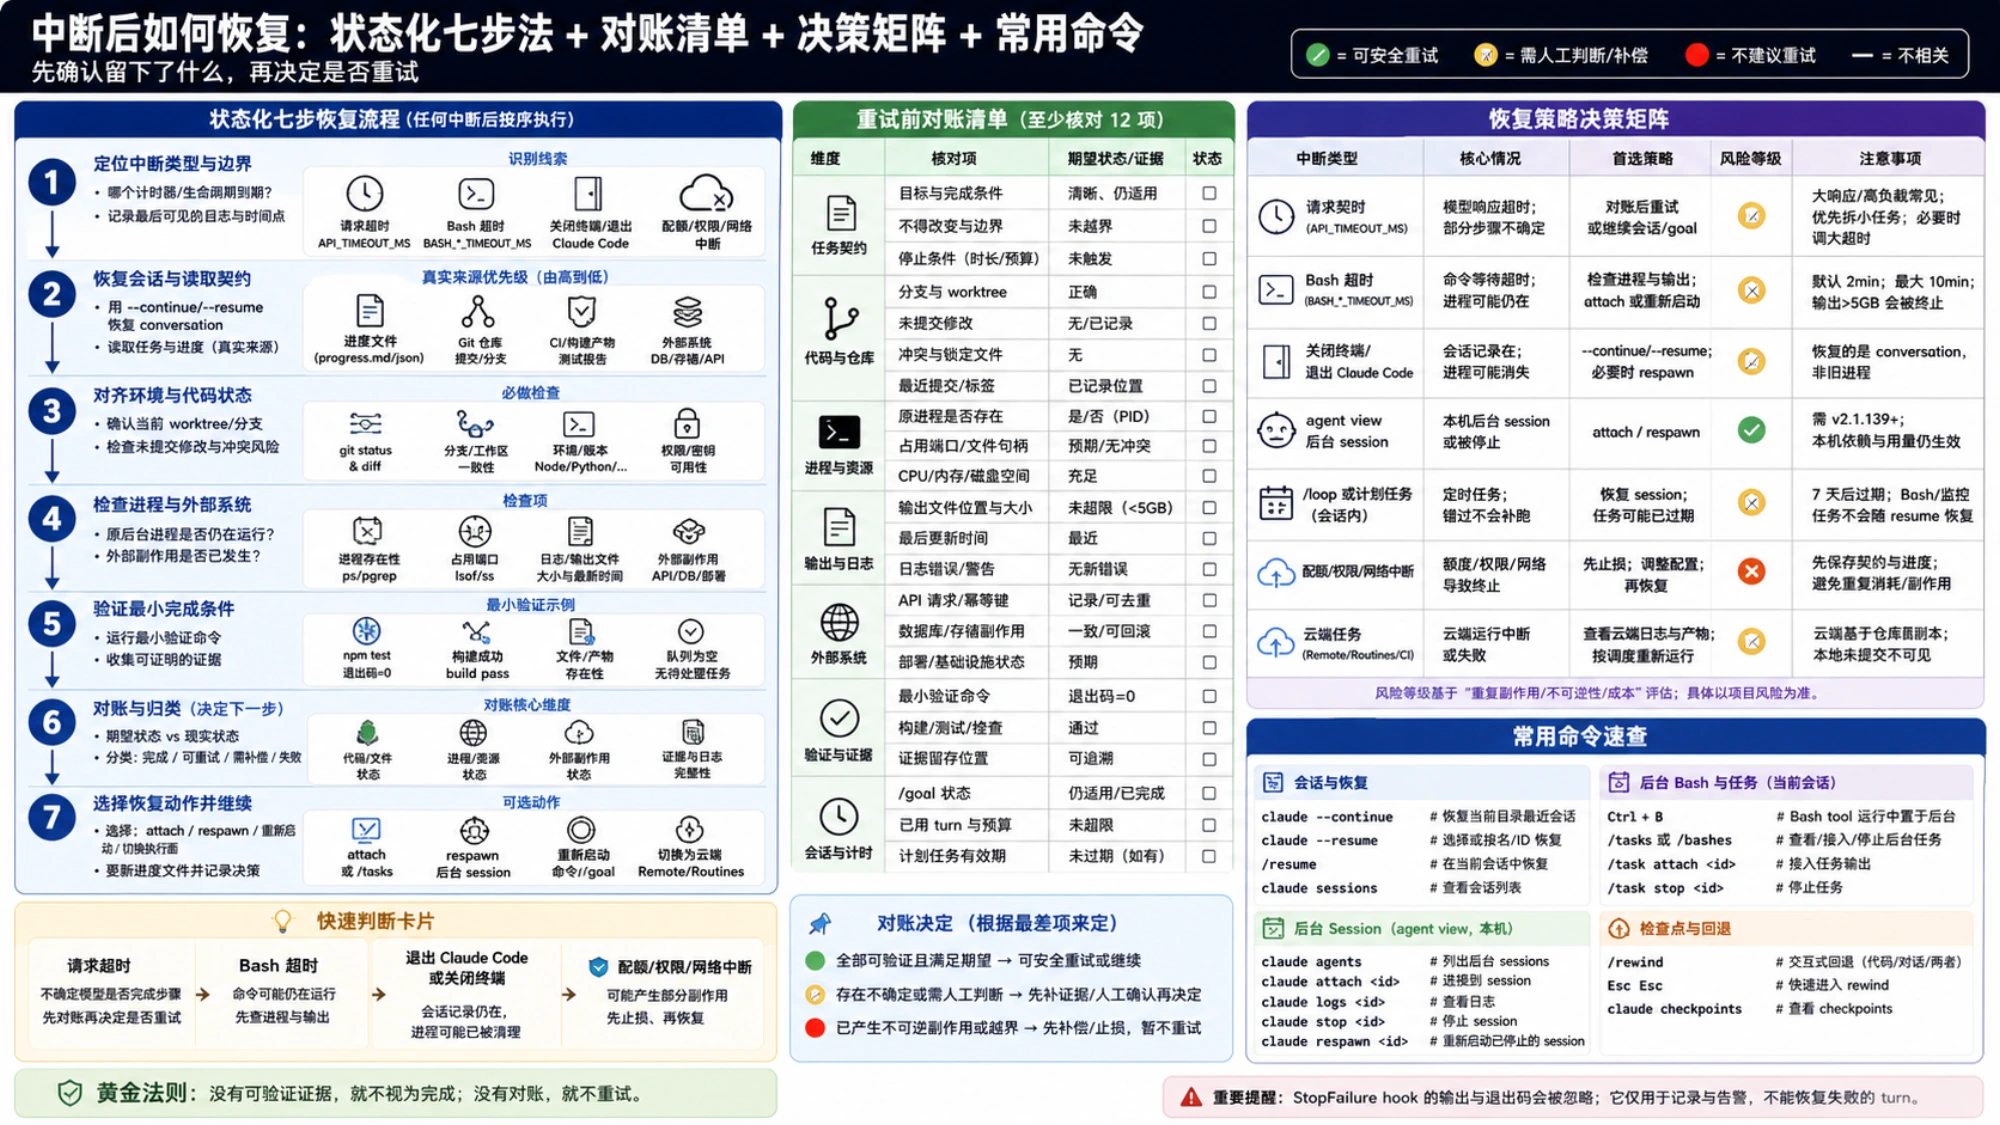
API error 说明响应失败,不证明 turn 中尝试的每个动作都已回滚。重新执行前,先把期望状态与现实对齐:目标文件是否已经存在、test 或 build 是否留下 artifact、process 是否仍由预期 owner 运行、外部 API 是否收到过请求,以及进度文件是否只在验证通过后标记完成。
尽量把工作拆成幂等单元:如果目标状态已经存在,就直接识别并跳过;如果外部系统支持 operation key,就用稳定 key 防止重复。无法做到幂等时,至少留下足够证据,能够在 verify、compensate 和 retry 之间选择。
当 turn 因 API error 结束时,Claude Code 会触发 StopFailure hook。官方Hooks 参考明确说明它的输出和退出码会被忽略,因此适合记录失败或发出提醒,不适合拿来自动恢复失败 turn。任何自建恢复循环仍然需要 retry budget 和对账规则。
中断后按状态恢复,不要只说“继续”
会话管理文档说明,Claude Code 会持续保存 CLI conversation,可以用 claude --continue 恢复当前目录最近的 session,用 claude --resume 选择或按名称恢复,也能在活动 session 内使用 /resume。
恢复后先执行一个短检查,而不是直接让 Claude 继续改:
- 读取持久的任务/进度文件;
- 查看
git status和相关 diff,确认当前 worktree; - 检查原 background process 是否还存在,不要从 transcript 推断;
- 重跑最小验证命令,确认失败没有变化;
- 若 active
/goal被恢复,核对条件仍适用; - 判断中断单元是已经完成、可以安全重试,还是必须补偿;
- 再决定 attach、respawn、重新启动命令或改用云端路线。
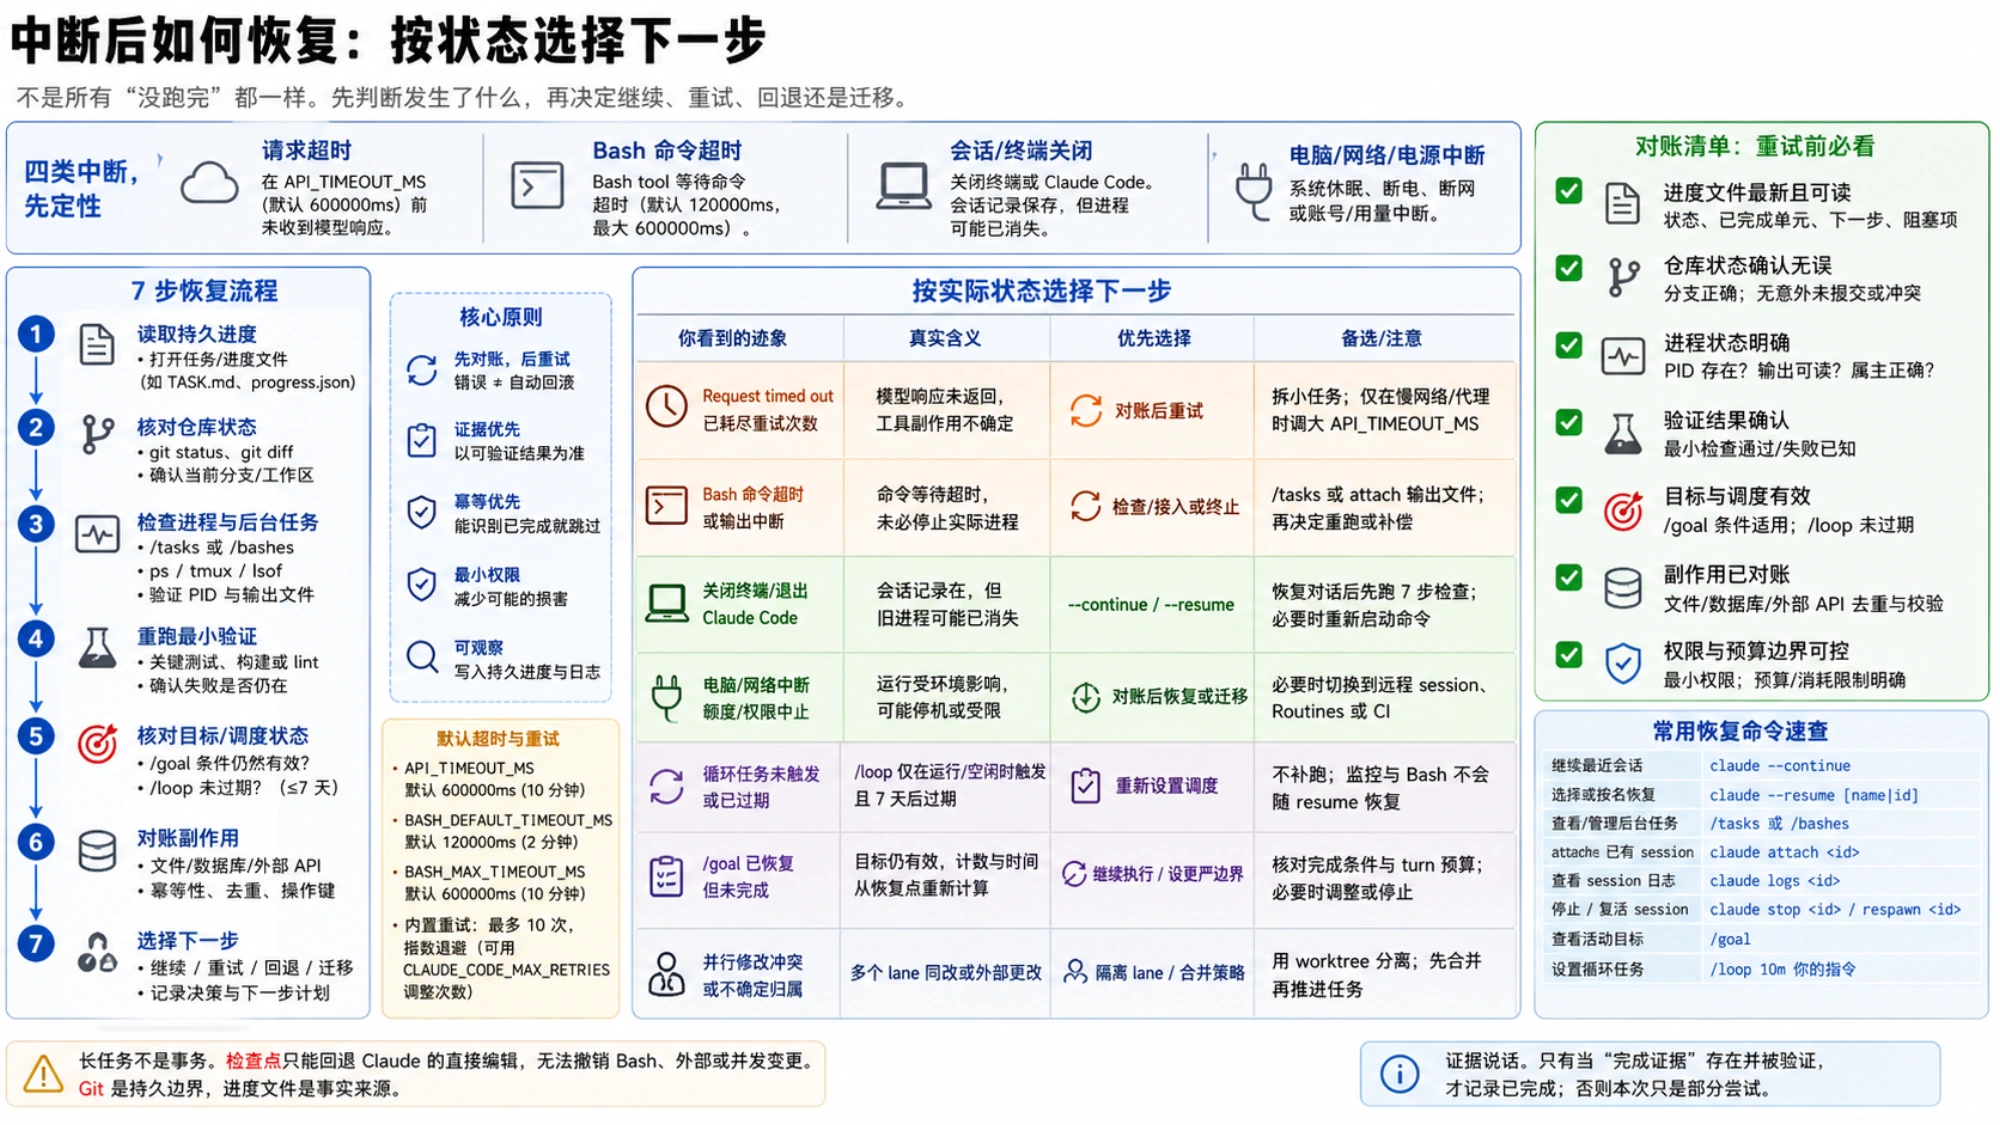
一项长任务可靠完成的标志,不是 Claude Code 显示“worked for 3h”,而是你能回答三个问题:现在由谁在运行、状态保存在哪里、哪条证据证明已经完成。只要这三个答案仍清楚,即使 terminal、session 或 agent 中途停止,工作也不会退回到猜测。