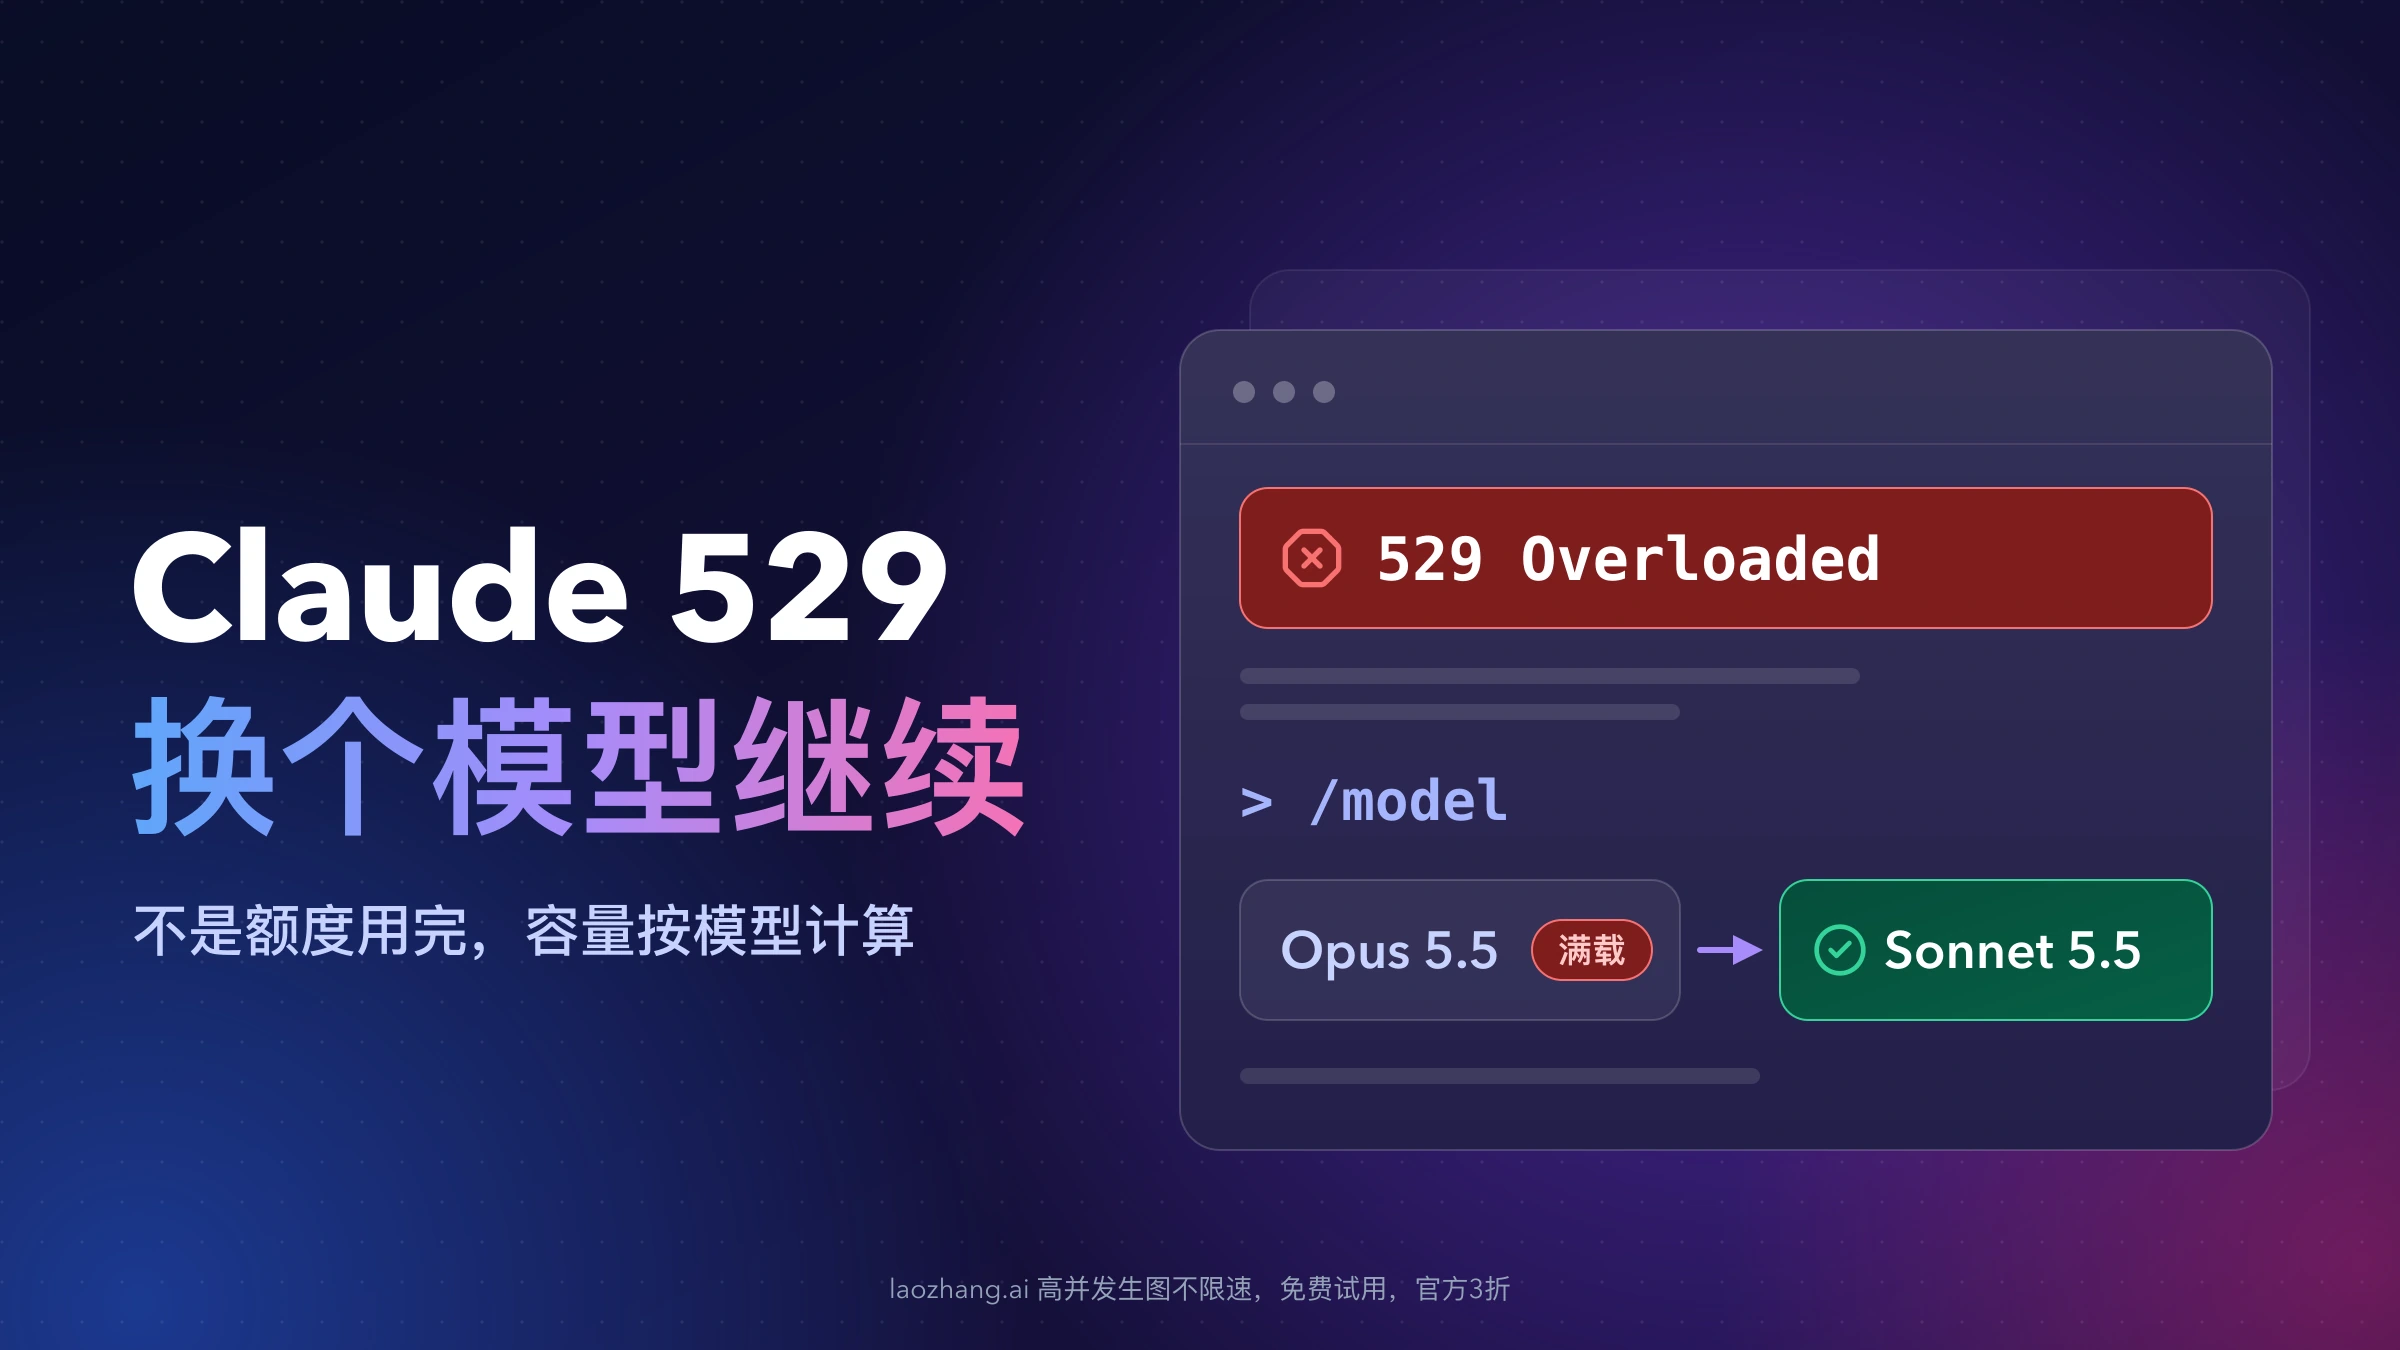
先说结论: 529 overloaded_error 的意思是 Anthropic 那边你正在用的模型此刻容量不足,官方原话是"所有用户的流量都很高时"会出现。它不是你的用量上限,也不是请求写错了;Claude Code 的官方错误参考写得很明确:529 "不是您的用量限制,也不会计入您的配额"(中文版错误参考)。
遇到 529 错误,下一步按你所在的位置选:
- Claude Code:倒计时还在走就先等;看到
Repeated 529就运行/model换一个模型,因为容量是按模型计算的。长任务提前配好--fallback-model。 - 自己写代码调 API:官方 SDK 默认已经重试 2 次,再报错就换模型或稍后重发,别在外面再套一层快速循环。
- 报错结尾写着
check your inference gateway、Bedrock 或 Google Cloud:问题先看那一层,Anthropic 的状态页管不到。 - 报错其实是 429、500、504:那是另一类问题,处理方法不同,下面有区分表。
先对照报错原文:529 出在哪一层、下一步做什么
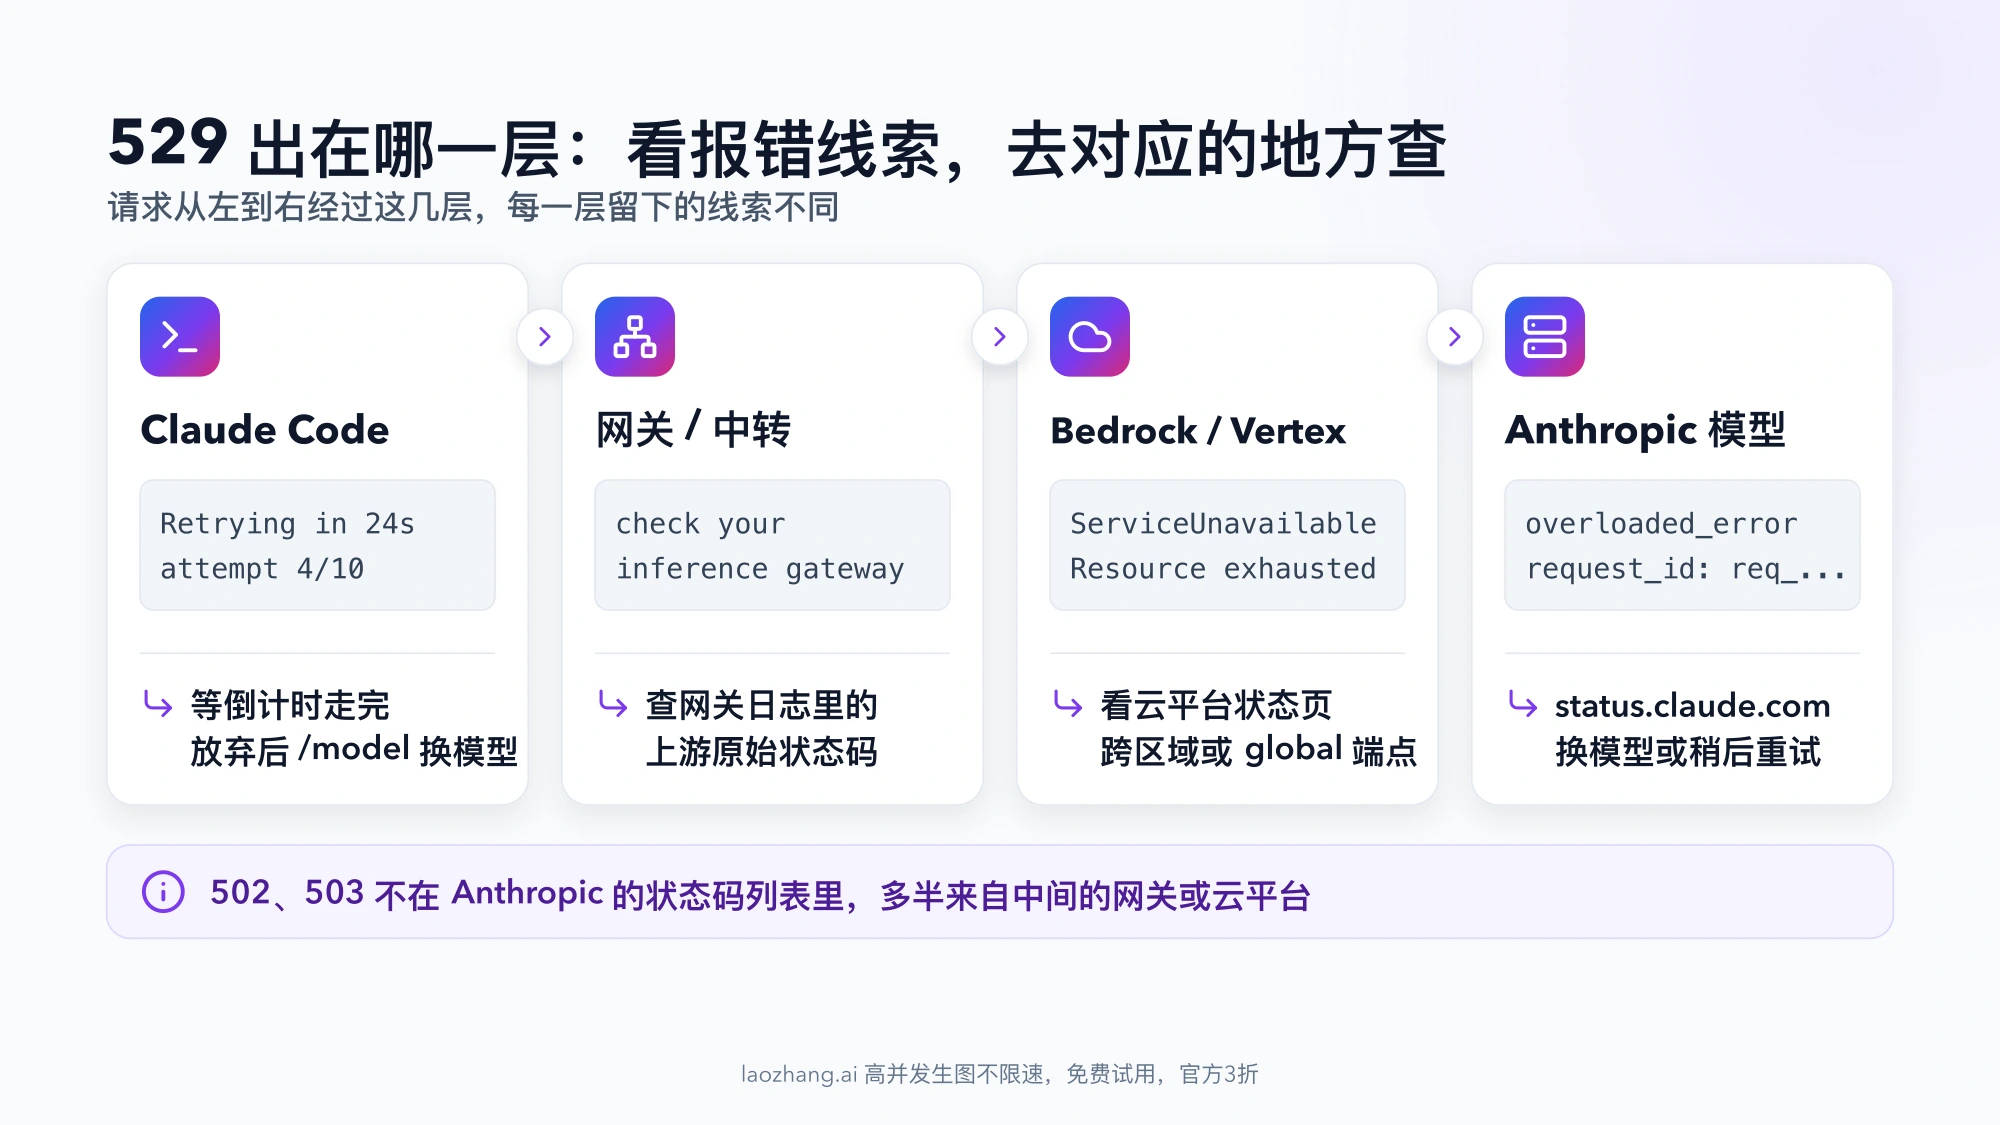
同一个 529,在不同工具里长得完全不一样。把你看到的那一行和下表对一下,就知道该往哪一层查。报错原文保持英文,方便你直接复制搜索。
| 你看到的原文(节选) | 来自哪一层 | 意思 | 下一步 |
|---|---|---|---|
529 Overloaded · Retrying in 24s · attempt 10/10 | Claude Code 正在自动重试 | 还没失败,在倒计时 | 等倒计时走完,不用动 |
API Error: 529 Overloaded. This is a server-side issue, usually temporary — try again in a moment. | Claude Code,重试已用完 | 这一轮请求放弃了 | 几分钟后重发,或 /model 换模型 |
API Error: Repeated 529 Overloaded errors. The API is at capacity — this is usually temporary. | Claude Code,连续 529 后放弃 | 这个模型此刻满载 | /model 换模型,或配置备用模型链 |
Opus is experiencing high load, please use /model to switch to Sonnet | Claude Code 主动提示 | Opus 负载特别高 | 按提示换到 Sonnet |
Agent terminated early due to an API error: API Error: 529 Overloaded. | Claude Code 子代理 | 子代理被 529 打断 | 重跑子任务;配置备用模型链可减少中断 |
…If it persists, check your inference gateway (127.0.0.1:8787) | 你配置的网关(ANTHROPIC_BASE_URL) | 错误经过你的代理或网关 | 查网关日志里的上游状态码 |
{"type":"error","error":{"type":"overloaded_error","message":"Overloaded"},"request_id":"req_..."} | Claude API 原始响应 | HTTP 529 | 记下 request_id,按 SDK 一节处理 |
anthropic.InternalServerError,status_code 为 529 | Python / TypeScript SDK | SDK 自带重试已用完 | 换模型或稍后重发 |
anthropic stream error (overloaded_error): Overloaded | 客户端包装的流式错误事件 | 流式响应途中收到过载事件 | 整个请求重发,已收到的输出不完整 |
API Error: Server error mid-response. The response above may be incomplete. | Claude Code,输出中途出错 | 已输出的内容保留,但可能不完整 | 检查已生成的部分,再让它继续 |
overloaded_error(529)或 ServiceUnavailable(503) | Amazon Bedrock | AWS 侧该模型容量不足 | 退避重试、跨区域推理,看 AWS 状态 |
Resource exhausted, please try again later.(429) | Google Cloud Vertex | Google 侧容量或配额 | 改用 global 端点、退避重试 |
Due to unexpected capacity constraints, Claude is unable to respond to your message. | claude.ai 网页与应用 | 聊天端容量紧张,不算事故 | 几分钟后再试 |
Claude Code 相关的几行来自官方错误参考和用户在 GitHub 贴出的原始报错(如 #89156,v2.1.241);Bedrock 和 Vertex 的写法来自各自的官方文档,后面单独讲。
529 overloaded_error 是什么意思:这个模型暂时没容量,不是你的额度
Anthropic 的 API 错误文档对 529 只有一句定义:overloaded_error,API 暂时过载;并补充说 529 会在"API 面对所有用户的高流量时"出现。几个容易误会的点:
- 和你的请求内容无关。 同一个合法请求,换个时间或换个模型就能通过。改提示词、换 API key、重装 Claude Code 都解决不了容量问题。
- 和你的额度无关。 在 Claude Code 里,529 不计入订阅配额(官方中文原文"不会计入您的配额")。额度用完的提示是另一套文字,比如
5-hour limit reached - resets [time],处理方法见 Claude Code 速率限制与额度:5 小时窗口、周限额,用完怎么办。 - 容量按模型计算。 Claude Code 文档原话是"容量是按模型跟踪的"。Anthropic 状态页上最近的事故也大多点名某一个模型,所以"换模型"往往比"一直等"更快恢复。
- 付费套餐不代表不会遇到 529。 官方没有任何文档说 Pro、Max 或更高的 API 速率等级在 529 时有优先权;"免费 tier 或低等级 key 排不上队"的说法同样找不到官方依据。API 速率等级影响的是 429,不是 529。
还有一条过时建议要纠正:以前常见"生产环境买 Priority Tier 来减少 529"。截至 2026 年 10 月 14 日,Anthropic 的服务等级文档开头写明 Priority Tier 的容量承诺已经停止购买,已有合同可以用到到期;需要保证容量只能联系销售。而且 Opus 5.5、Sonnet 5.5、Haiku 5.5、Fable 5.1 这些当前模型本来就不支持 Priority Tier。
529、429、500、504 和网关错误怎么区分
很多"529 怎么修都不好"的情况,其实看到的根本不是 529。Anthropic API 文档列出的状态码里,和这类故障相关的是下面几个,502 和 503 不在列表中:
| 状态码 / 原文 | 类型 | 含义 | 该怎么做 |
|---|---|---|---|
| 529 | overloaded_error | Anthropic 侧该模型容量不足,所有用户都受影响 | 等待、换模型、有节制地重试 |
| 429 | rate_limit_error | 你的组织触发了速率限制、月消费上限或突增限制 | 遵守 retry-after,降并发,平滑流量 |
| 500 | api_error | API 内部意外故障 | 指数退避重试,持续出现就带 request ID 上报 |
| 504 | timeout_error | 请求处理超时 | 长请求改用流式或 Message Batches |
| 502、503 | 不在 Anthropic 列表中 | 通常是代理、网关、负载均衡或云平台返回的 | 查链路上那一层的日志 |
Server is temporarily limiting requests (not your usage limit) | Claude Code 的短暂限流 | 服务端临时节流,和套餐额度无关 | 稍等再试,Claude Code 会自动重试 |
5-hour limit reached、You've reached your weekly limit | 订阅用量上限 | 你的 5 小时或每周额度用完 | 等额度重置,或开启 usage credits 按量付费 |
429 和 529 最容易混。2025 年 8 月 11 日的官方更新日志写明:组织用量突然暴涨时,现在会因为"加速限制"返回 429,而以前同样的场景返回的是 529。所以如果你的批量任务一启动就报错,先看状态码到底是哪个。看到 500 的读者可以接着读 Claude API 500 错误:别盲目重试,先保存 request_id;周额度的变化见 9 月 14 日后 Claude Code 周限额怎么变。
经第三方中转或聚合网关调用时还要多一层判断。据社区反馈,部分聚合网关会把上游的错误转换成自己的状态码或文字,你看到的"529"可能是网关自己的渠道满了,也可能是 Anthropic 真的过载。Anthropic 的每个响应都带 request-id 头,错误体里也有以 req_ 开头的 request_id;如果网关返回的错误里完全没有这个 ID,就先向网关运营方确认上游的原始状态码,而不是去看 Anthropic 状态页。
Claude Code 报 529:重试倒计时、Repeated 529 和默认 160 秒
Claude Code 遇到 529 不会马上报错。按官方错误参考,它会先用指数退避自动重试,最多 10 次,期间旋转图标后面显示 Retrying in Ns · attempt x/y:
- 前两次标签只写
API error,从 v2.1.198 起,第三次开始改成具体原因,例如529 Overloaded; - 原因显示出来以后,倒计时下面一行会告诉你去哪看服务状态:直连 Anthropic 时是
status.claude.com,走 Bedrock、Vertex、Foundry 或自定义网关时是对应的平台或网关主机。
默认情况下 10 次都失败,才会出现 API Error: Repeated 529 Overloaded errors… 或 API Error: 529 Overloaded… 这一行。
默认 10 次重试一共等多久:159.5 秒的算法
官方文档给出的默认值是:529 退避的起始等待 500 毫秒,单次等待上限 32 秒,最多重试 10 次。假设每次等待翻倍、不计随机抖动:
0.5 + 1 + 2 + 4 + 8 + 16 + 32 + 32 + 32 + 32 = 159.5 秒
也就是说,一轮请求大约扛 2 分半。GitHub 上有用户逆向 v2.1.220 安装包后报告,每次等待还会加 0% 到 25% 的随机抖动(#81330),这样最多约 200 秒。容量事故经常持续十几分钟以上,所以在事故期间发出的消息几乎都会以 Repeated 529 结束,看起来像"一直不恢复",其实是每一轮只扛了 2 到 3 分钟。
同一份社区报告还提到:在 v2.1.220 上,用 API key 登录、使用 Opus、Fable、Mythos 这类模型时,连续 3 次 529 就会直接显示 Repeated 529(配置了 fallbackModel 则改为切换模型),而倒计时仍然显示 attempt N/10。这是社区对旧版本的解读,官方文档没有写这条规则,新版本是否仍然如此也没有公开说明。
输出到一半遇到 529 会怎样
- 还没开始输出:Claude Code 按上面的规则重试。
- 刚想完、还没开始写文字或调用工具:从 v2.1.284 起,会再重试最多两次;更早的版本直接结束这一轮。
- 已经写出部分内容:不再重跑,保留已输出的部分,显示
API Error: Server error mid-response. The response above may be incomplete.(v2.1.199 起;更早的版本会把部分输出丢掉)。
子代理被 529 打断时,主会话看到的是 Agent terminated early due to an API error: API Error: 529 Overloaded.。有用户反馈子代理此前完成的工作拿不回来,只能整个重跑(#89267)。从 v2.1.247 起,备用模型链也覆盖子代理,配好之后子代理会换模型继续,而不是直接失败。
旧版 529 报错格式:带文档链接或整段 JSON
2026 年 3 月前后,API 返回的 529 消息里带着文档链接,Claude Code 会原样打印成 API Error: 529 Overloaded. https://docs.claude.com/en/api/errors 这样的一行,更早的版本还会直接打出整段 JSON:529 {"type":"error","error":{"type":"overloaded_error","message":"Overloaded"}}。意思和现在的提示一样,处理方法也一样。
Claude Code 遇到 529 怎么办:/model 换模型与 fallbackModel
马上能做的:换模型。 运行 /model,从当前模型换到另一个。Opus 负载特别高时,Claude Code 会主动提示 Opus is experiencing high load, please use /model to switch to Sonnet;在 Claude 桌面应用的 Code 标签页或 Cowork 里,提示是 Opus is experiencing high load. Switch to Sonnet.,用应用里的模型选择器切换。
截至 2026 年 10 月 14 日,直连 Anthropic API 时别名对应关系是:opus → Opus 5.5,sonnet → Sonnet 5.5,haiku → Haiku 5.5;在 Bedrock 和 Google Cloud 上,sonnet 仍指向 Sonnet 4.5,haiku 指向 Haiku 4.5(模型配置文档)。Opus 5.5 需要 Claude Code v2.1.280 以上,Sonnet 5.5 需要 v2.1.284 以上,版本太旧先运行 claude update。Opus 5.5 本身的能力和价格见 Claude Opus 5.5 已发布:API 价格、能力与从 Opus 5 迁移的检查项。
提前配好的:备用模型链。 主模型过载、不可用或返回其他不可重试的服务端错误时,Claude Code 会按顺序换到备用模型:
# 只对这次会话生效,逗号分隔,按顺序尝试
claude --fallback-model sonnet,haiku
想长期生效,在 settings 文件里写成数组:
{
  "fallbackModel": ["sonnet", "haiku"]
}
几条容易踩的规则:
- 最多 3 个模型,多写的会被忽略;命令行参数优先于 settings。
- 切换只在当前这一轮有效,下一条消息又会先试主模型。
- 启动时不会确认,
/status里也看不到;第一次真正切换时出现的提示,才是配置生效的证据。 - 429、认证、计费、请求过大这几类错误不会触发切换。
- 压缩上下文(compaction)时也会用备用链,但不会换到上下文窗口更小的模型。
- 交互会话里使用
--fallback-model和fallbackModel设置需要 v2.1.166 以上。
另外有一种"自动换模型"和 529 无关:Fable、Opus 5.5、Sonnet 5.5、Opus 5 在安全分类器拦下网络安全或生物类内容时会换模型重跑,这是按内容触发的,不会因为过载发生。
无人值守和 CI:用环境变量把 529 重试拉长
夜间任务、CI 或长时间自动运行时,默认 2 分半的重试窗口太短。可以用这些环境变量调整(变量更新很快,以官方错误参考的"调整重试行为"为准):
| 环境变量 | 默认值 | 作用 | 版本要求 |
|---|---|---|---|
CLAUDE_CODE_MAX_RETRIES | 10 | 重试次数,最高 15 | v2.1.186 起封顶 15 |
CLAUDE_CODE_OVERLOADED_RETRY_BASE_DELAY_MS | 500 | 529 退避的起始等待,最高 32000 | v2.1.292+ |
CLAUDE_CODE_OVERLOADED_RETRY_MAX_DELAY_MS | 32000 | 529 退避的单次上限,最高 64000 | v2.1.296+ |
CLAUDE_CODE_RETRY_WATCHDOG | 未设置 | 设为 1 后对 429、529 容量错误无限重试 | v2.1.199 起扩展到其他临时错误 |
CLAUDE_CODE_RETRY_WATCHDOG_MAX_WAIT_MS | 未设置 | 开启上一项后,每个请求等 429、529 的最长时间 | v2.1.295+ |
按"每次等待翻倍、不计抖动"推算,几种设置下一轮请求能扛多久:
| 设置 | 计算 | 约等于 |
|---|---|---|
| 全部默认 | 0.5+1+2+4+8+16+32+32+32+32 | 160 秒 |
| 只把单次上限调到 64000 | 0.5+1+2+4+8+16+32+64+64+64 | 256 秒 |
| 起始 2000、上限 64000 | 2+4+8+16+32+64+64+64+64+64 | 382 秒 |
| 起始 2000、上限 64000、重试 15 次 | 382 + 5 × 64 | 702 秒,约 12 分钟 |
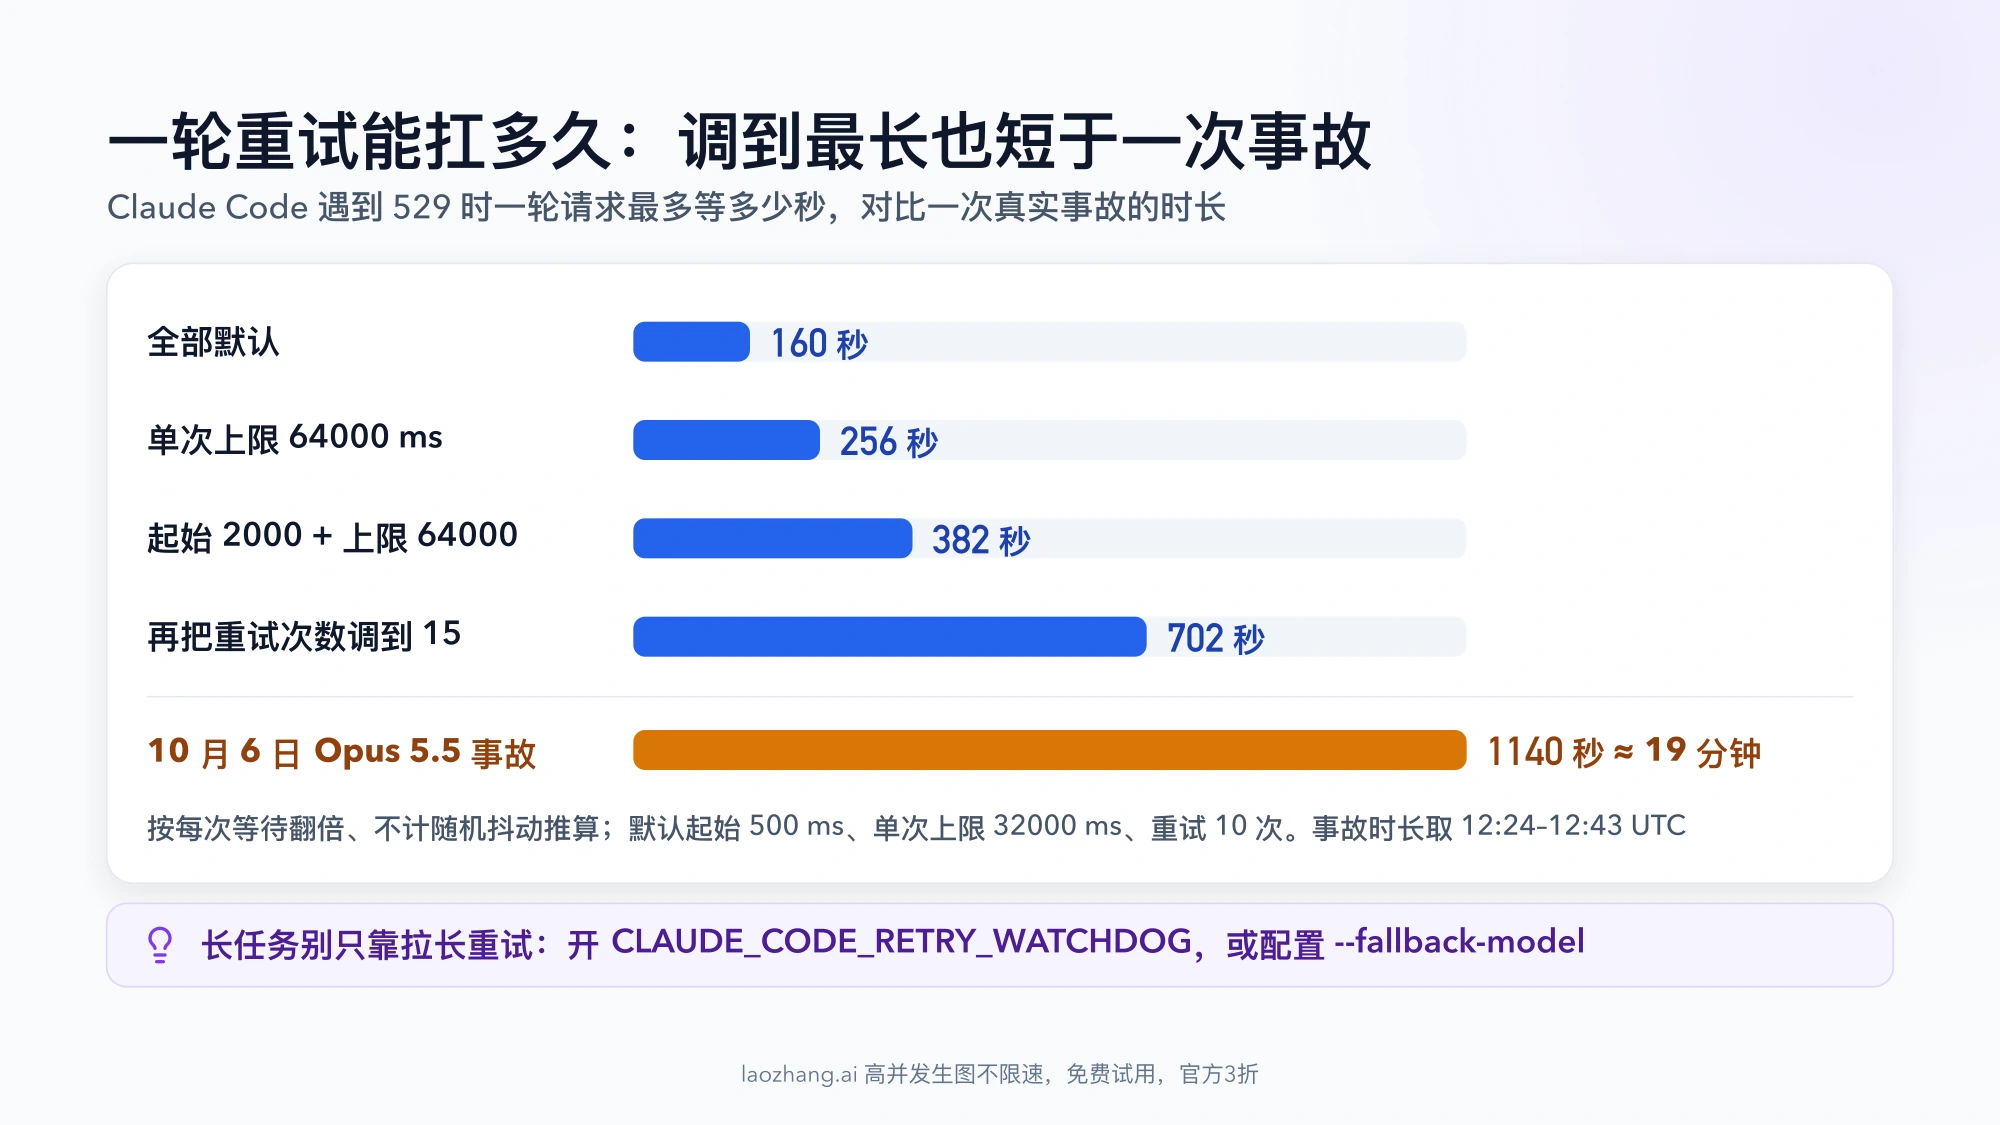
即使把几个变量都调到上限,一轮重试也只有十来分钟,比 2026 年 10 月 6 日那次 Opus 5.5 事故(12:24–12:43 UTC,约 19 分钟)还短。真要扛过整场事故,靠的是看门狗模式或备用模型链。
CI 里更省心的写法是开启看门狗模式,再给它一个上限,避免卡死几个小时:
export CLAUDE_CODE_RETRY_WATCHDOG=1
export CLAUDE_CODE_RETRY_WATCHDOG_MAX_WAIT_MS=1800000   # 每个请求最多等 30 分钟
claude -p "运行测试并修复失败用例" --fallback-model sonnet
注意:开启 CLAUDE_CODE_RETRY_WATCHDOG 后,上面两个 529 退避变量不再生效;遇到消费上限或用量额度耗尽的 429 时(v2.1.239 起)会立即失败,不会无限等。
Claude Code 被 529 打断后,上下文还在吗
529 打断的是这一次请求,不是整个会话。官方对服务端错误的建议是:等一会儿再发,原来的消息还在对话里,长提示不用重新粘贴,直接输入 try again 即可。如果当时已经输出了一部分(The response above may be incomplete),先确认已经改过的文件,再让它从中断处继续。
API 和 SDK 报 529:SDK 已重试 2 次,别再叠循环
官方 Python、TypeScript SDK 会自动重试连接错误、408、409、429 和所有 ≥500 的错误,默认 2 次,带指数退避并遵守 retry-after(Python SDK 文档)。所以 529 先被 SDK 自己重试,用完后才以 InternalServerError 抛出(SDK 没有单独的 Overloaded 异常类,按 status_code == 529 判断)。
最常见的错误是在外面再套一层重试:外层循环 5 次 × SDK 每次最多 3 次请求 = 15 次请求,而且大多挤在同一个过载窗口里。更好的做法是让 SDK 负责重试,外层只负责换模型:
import anthropic

# SDK 负责退避重试:每个模型最多 1 + 4 = 5 次请求
client = anthropic.Anthropic(max_retries=4)

# 容量按模型计算,备用选另一个模型
MODELS = ["claude-opus-5-5", "claude-sonnet-5-5"]

def ask(messages):
    last_error = None
    for model in MODELS:
        try:
            return client.messages.create(
                model=model,
                max_tokens=1024,
                messages=messages,
            )
        except anthropic.InternalServerError as e:
            if e.status_code != 529:
                raise  # 500 等其他服务端错误交给上层处理
            # 记下 request-id,持续出现时上报要用
            print("529 overloaded:", model, e.response.headers.get("request-id"))
            last_error = e
    raise last_error
这段代码最坏情况下发出 2 × 5 = 10 次请求就停止,429(RateLimitError)不会被吞掉,会直接抛给上层。模型 ID 截至 2026 年 10 月 14 日有效(模型总览);claude-sonnet-4-6 这类旧示例里的模型已经是旧版本。
减少 529 冲击的另外几件事:
- 平滑流量,错开重试。 别从零瞬间拉满并发,突增流量现在会先撞上 429。AWS 的 Bedrock 文档也提醒,多个客户端同时重试会加重负载、拖慢恢复。
- 不急的任务走批处理。 服务等级文档把 Batch 定位为"可以等待、或适合放在常规容量之外"的异步任务。
- 长请求用流式。 官方建议长请求(尤其超过 10 分钟的)用流式或批处理来避免 504;流式也能让你看到错误发生在哪一刻。
anthropic stream error (overloaded_error):流式响应中途的 529
流式请求的 HTTP 状态码可能已经是 200,之后才收到过载。官方流式文档的示例是:
event: error
data: {"type": "error", "error": {"type": "overloaded_error", "message": "Overloaded"}}
文档说明这个事件"在非流式场景下通常对应 HTTP 529"。error: anthropic stream error (overloaded_error): overloaded 这类文字不是 Anthropic 的原话,而是你用的客户端、插件或网关把这个事件包装后的提示,具体是哪个工具会因客户端而异。
处理时注意三点:
- 这种错误不走普通的 HTTP 错误机制,只看状态码的重试逻辑会漏掉它,代码里要单独处理流里的
error事件。 - 已经收到的文本不完整,需要整个请求重发,或者像 Claude Code 那样保留部分输出并标明不完整。
- 中途失败前已经生成的部分是否计费,官方没有写明(见下方常见问题)。
Bedrock、Vertex 和自建网关上的 529
通过云平台或网关调用 Claude 时,容量属于那一层,Anthropic 的状态页看不到,报错文字也不同。
Amazon Bedrock. Bedrock 错误码文档把三种情况分得很清楚:overloaded_error(529)是模型因需求过高或服务容量不足暂时无法处理;ServiceUnavailable(503)也是临时容量问题,和账号配额无关;ThrottlingException(429)才是超出了你账号的 Bedrock 配额。对 529,AWS 建议退避加随机抖动、遵守 Retry-After、避免多个客户端同时重试,模型支持时使用跨区域推理;持续出现就带上 request ID、模型 ID、区域和大致时间联系 AWS Support。
Google Cloud(Vertex). Google 侧容量不足返回的是 429,按量付费时文字为 Resource exhausted, please try again later.(Google 的 429 说明)。建议改用 global 端点、截断指数退避、平滑流量;Claude Code 用户可以设置 CLOUD_ML_REGION=global,并确认所选模型在该区域可用。
自建或第三方网关. 设置了 ANTHROPIC_BASE_URL 时,Claude Code 报错的结尾会改成网关主机,例如 If it persists, check your inference gateway (127.0.0.1:8787)(v2.1.143 起)。这里说的是你自己配置的代理或 LLM 网关,不是 Anthropic。先看这个网关的日志:上游返回的原始状态码是什么、有没有 req_ 开头的 request ID。网关返回自己的 HTML 错误页时,Claude Code 会显示 API Error: 502 Bad Gateway 这样的状态码加页面标题(v2.1.281 起),说明这个错误页来自代理、负载均衡或网关本身。
status.claude.com 怎么看:事故大多按模型发布
status.claude.com 截至 2026 年 10 月 14 日列出 6 个组件:claude.ai、Claude Console(platform.claude.com)、Claude API(api.anthropic.com)、Claude Code、Claude Cowork 和 Claude for Government。可以用邮件、短信、Slack、Microsoft Teams、Webhook 或 RSS/Atom 订阅;做监控时直接读 https://status.claude.com/api/v2/summary.json 和 https://status.claude.com/api/v2/incidents.json。
看状态页时有三点要知道:
- 事故标题写的是 "Elevated errors",不会写 529。 529 是用户那一侧看到的症状,比如 2026 年 8 月 24 日有多个模型的错误事故,同一个上午 GitHub 上就出现了 Claude Code 的 529 报告。
- 事故大多点名具体模型。 这就是"换模型"有效的原因。
- 绿灯不等于不会遇到 529。 帮助中心写明 claude.ai 的容量紧张"不是故障",不会出现在状态页上;对 API 和 Claude Code,官方让你在状态页找容量通知,但没有承诺每次 529 都会发布。
最近几次带模型名的事故(UTC 与北京时间):
| 日期 | 事故 | 影响时间(UTC) | 北京时间 |
|---|---|---|---|
| 2026 年 10 月 6 日 | Elevated errors for Claude Opus 5.5 | 12:24–12:43 | 20:24–20:43 |
| 2026 年 10 月 5 日 | Elevated errors for Claude Mythos 5.1 and Claude Fable 5.1 | 12:40–13:10 | 20:40–21:10 |
| 2026 年 9 月 29 日 | claude.ai、Claude Code、Cowork 和 API 全线错误 | 14:00–14:59 | 22:00–22:59 |
| 2026 年 9 月 22 日 | Mythos 5.1、Fable 5.1、Opus 5 等多个模型 | 00:50–02:10 | 08:50–10:10 |
这些事故从约 20 分钟到约 80 分钟不等,都比 Claude Code 默认约 160 秒的重试窗口长得多。
何时上报 529:request-id、/feedback 和要附的信息
偶尔出现、几分钟内恢复的 529 不需要上报。满足下面任一条时再报:
- 状态页没有事故,但同一个模型持续 529 超过十几分钟;
- 换了模型、换了时间段仍然只在你这边出现;
- 错误里没有
req_开头的 ID,怀疑是中间网关的问题。
上报时带上:
- Claude Code:运行
/feedback,它会附上这次请求的细节; - API:错误体里的
request_id,或响应头里的request-id(SDK 的成功响应对象上是_request_id),以及时间、模型 ID; - Bedrock:request ID、模型 ID、区域和大致时间,提交给 AWS Support;
- 网关:网关自己的请求日志和上游原始状态码,先交给网关运营方。
Claude 529 常见问题:多久恢复、扣不扣额度、换不换套餐
Claude 529 一般会持续多久?
没有官方给出的时长。从状态页的记录看,最近几次模型级事故持续约 20 到 80 分钟;没有发布事故的短时容量不足可能几分钟就过去。Claude Code 单轮默认只重试约 160 秒,所以较长的事故里会反复看到 Repeated 529,这时换模型比反复重发更有效。
529 是不是我超额了,会扣 Claude Code 的额度吗?
不是超额。Claude Code 的官方错误参考写明 529 不是你的用量上限,也不计入配额。claude.ai 网页端的容量提示是否计入用量,官方没有同样明确的说明。
Claude API 报 529 会不会扣费?
官方文档没有写明。被 529 拒绝的请求没有生成输出,按理不应产生输出费用;但流式响应中途过载时,之前生成的部分可能已经消耗了 token。有用户在 GitHub 反馈,客服答复部分输出通常会保留并按比例计费(#89267),这是个人转述。最稳妥的办法是用 request ID 在 Claude Console 的用量页面里核对。
免费账号或低等级 API key 更容易遇到 529 吗?
没有官方依据。529 的定义是所有用户的流量都高,API 速率等级决定的是你什么时候撞上 429。升级套餐或提高速率等级不会让你免于 529,能提供优先容量的 Priority Tier 也已经停止购买。
经过中转网关调用 Claude 报 529 怎么办?
先确认 529 是谁返回的:看网关日志里的上游原始状态码,以及错误中有没有 req_ 开头的 request ID。是 Anthropic 返回的,就按换模型、退避重试处理;是网关自己的渠道或限流,就要找网关运营方,Anthropic 的状态页和支持帮不上忙。