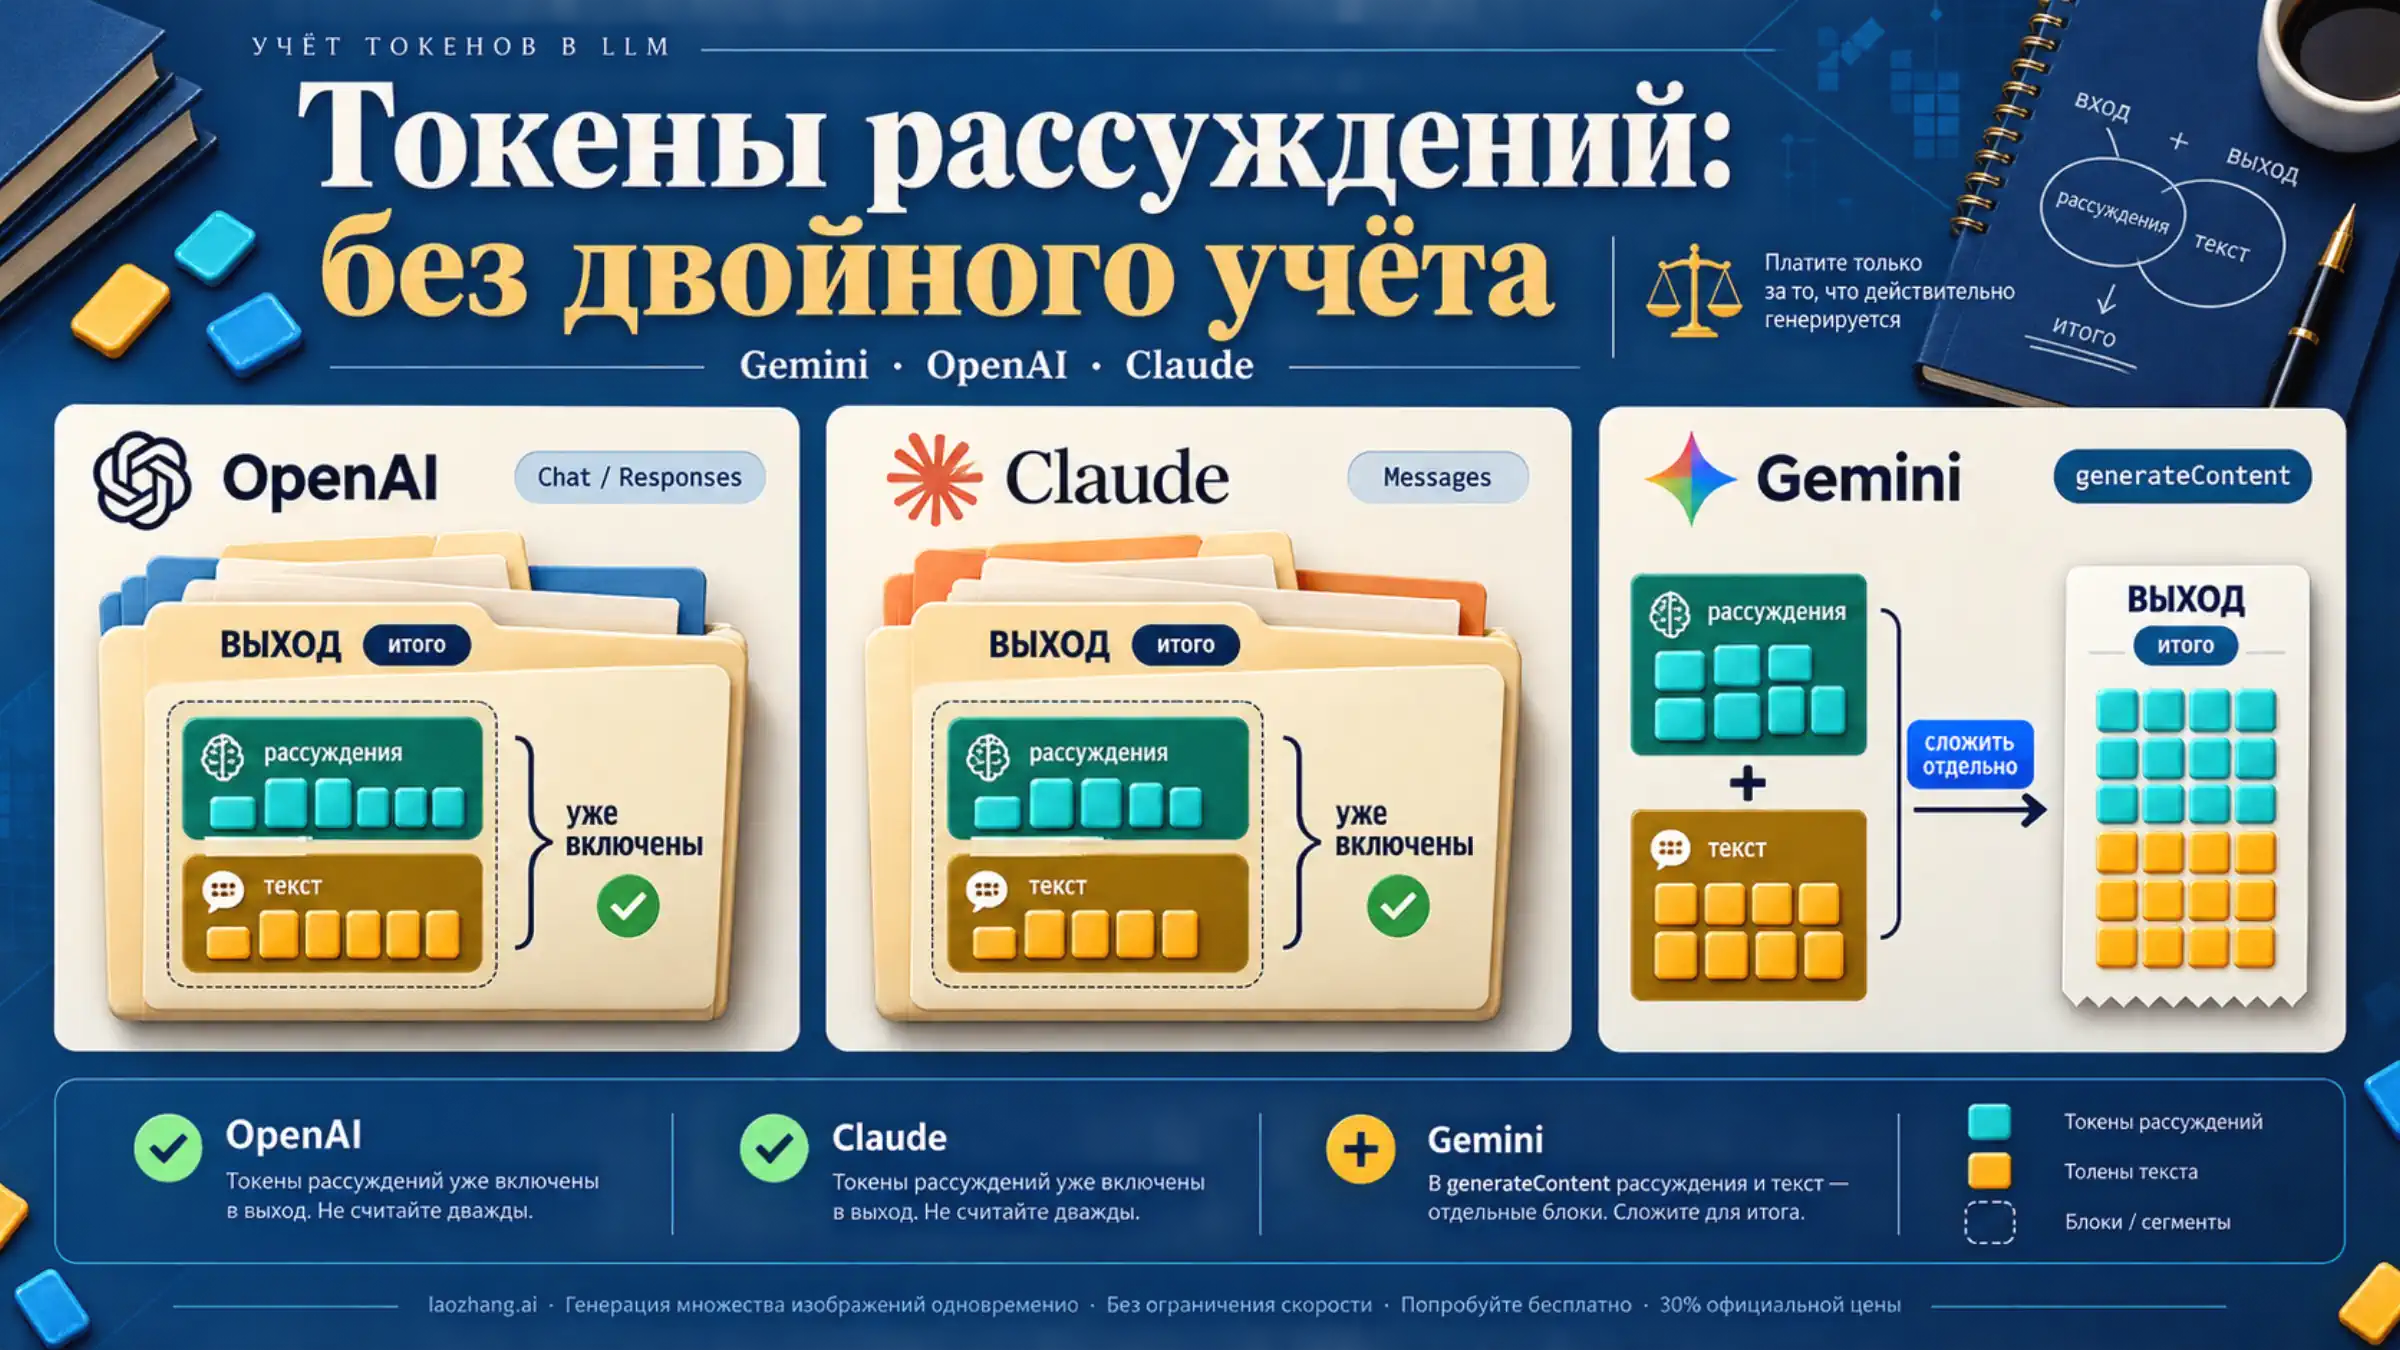
Токены рассуждений (reasoning tokens, thinking) у OpenAI, Anthropic и Google оплачиваются по ставке выходных токенов — отдельной цены для них нет, и платите вы за всё, что модель сгенерировала, а не за то, что видно в ответе. Поэтому счёт считают по полю usage, а не по длине текста:
- OpenAI (Responses и Chat Completions) и Claude (Messages API): рассуждения уже входят в
output_tokens/completion_tokens. Поле с разбивкой — только справка, прибавлять его нельзя. - Gemini
generateContent:candidatesTokenCountрассуждений не содержит, оплачиваемый выход =candidatesTokenCount + thoughtsTokenCount.
Расходом управляют двумя разными рычагами. Жёсткий лимит (max_output_tokens, max_tokens) обрезает один запрос, но может оставить вас с оплаченным пустым ответом. Параметры глубины (effort, thinking_level) уменьшают объём рассуждений в среднем, но точного числа токенов не гарантируют. Цены ниже приведены по состоянию на 25 сентября 2026 года; все суммы — арифметические примеры по официальным тарифам, а не замеры реальных счетов.
Почему рассуждения оплачиваются, хотя их не видно
Reasoning-модель перед ответом генерирует внутренние токены: разбирает задачу, пробует варианты, планирует вызовы инструментов. Это такая же генерация, как и видимый текст, поэтому провайдеры тарифицируют её как выход. У OpenAI это сказано прямо: рассуждения не видны через API, но занимают место в контекстном окне и оплачиваются как выходные токены. У Gemini строка тарифа так и называется — «Output price (including thinking tokens)» в таблице цен Gemini API.
Видимый результат не показывает оплаченный объём ни у одного из трёх провайдеров:
- Claude по умолчанию скрывает текст рассуждений на Opus 5.5, Opus 5, Sonnet 5, Fable и Mythos (
display: "omitted"), но списывает их полностью. Если включитьdisplay: "summarized", вы увидите краткое изложение; его генерация бесплатна, а оплачиваются всё равно полные рассуждения. Anthropic отдельно предупреждает, что оплаченное число выходных токенов не совпадает с видимым. - Gemini возвращает только резюме мыслей, а тарифицирует полный объём thought-токенов.
- OpenAI включает в выходной счётчик ещё и невидимые служебные токены форматирования. Поэтому
output_tokens − reasoning_tokens— это приблизительный, а не точный объём видимого текста (подсчёт выходных токенов).
Практический вывод: длина ответа на экране и размер показанного резюме ничего не говорят о стоимости. Единственный надёжный источник — объект usage в ответе API.
Какое поле usage умножать на цену выхода
Сначала определите интерфейс, через который пришёл ответ, и только потом модель: одна и та же формула для разных API даёт ошибку в разные стороны.
| API | Оплачиваемый выход | Рассуждения | Чего не делать |
|---|---|---|---|
| OpenAI Responses | usage.output_tokens | usage.output_tokens_details.reasoning_tokens — уже внутри итога | Не прибавлять reasoning_tokens к output_tokens |
| OpenAI Chat Completions | usage.completion_tokens | usage.completion_tokens_details.reasoning_tokens — уже внутри итога | Не прибавлять reasoning_tokens к completion_tokens |
| Claude Messages | usage.output_tokens | usage.output_tokens_details.thinking_tokens — уже внутри итога, всегда ≤ output_tokens | Не прибавлять thinking_tokens к output_tokens |
Gemini generateContent | candidatesTokenCount + thoughtsTokenCount | usageMetadata.thoughtsTokenCount — отдельно от ответа | Не брать один candidatesTokenCount |
| Gemini Interactions API | total_output_tokens + total_thought_tokens | usage.total_thought_tokens — отдельно от ответа | Не брать один total_output_tokens |
Официальные примеры показывают масштаб. В руководстве OpenAI ответ с output_tokens: 1186 содержит reasoning_tokens: 1024 — почти всё, за что заплачено, пользователь не видит. В документации Claude пример с output_tokens: 348 и thinking_tokens: 312 Anthropic называет output_tokens «включающим и авторитетным итогом для биллинга», а разбивку — полем только для наблюдения. У Gemini в описании UsageMetadata thoughtsTokenCount перечислен отдельно, а в примере Interactions API итог 530 складывается из входа 62, ответа 171 и мыслей 297.
Ещё три ловушки:
total_tokensу OpenAI иtotalTokenCountу Gemini включают вход. Если умножить их на цену выхода, расчёт будет завышен даже с выключенными рассуждениями.promptTokenCountу Gemini уже содержит кэшированный контент. Чтобы применить к кэшу его тариф, беритеcachedContentTokenCountкак часть входа, а не как прибавку к нему.- Посредники, которые отдают Gemini в формате OpenAI, могли уже сложить поля в один
completion_tokens— или не передать разбивку вовсе. Пока документация конкретного шлюза этого не описывает, храните сырой ответ и не применяйте к нему формулуgenerateContent.
Если в ответе Gemini нет поля thoughtsTokenCount, сверьтесь с totalTokenCount: по документации он равен сумме промпта, мыслей и ответа. Подставлять ноль вместо отсутствующего значения опасно — «данных нет» превращается в «рассуждений не было».
Ниже — минимальная нормализация для сырого JSON-ответа REST (в SDK имена полей могут отличаться, например быть в snake_case). Функция возвращает число токенов для умножения на цену выхода или None, если данных недостаточно:
def billable_output_tokens(api: str, usage: dict) -> int | None:
    """Выходные токены для умножения на цену выхода; None — данных нет."""
    if api in ("openai.responses", "claude.messages"):
        return usage.get("output_tokens")          # рассуждения уже внутри
    if api == "openai.chat":
        return usage.get("completion_tokens")      # рассуждения уже внутри
    if api == "gemini.generateContent":
        candidates = usage.get("candidatesTokenCount")
        thoughts = usage.get("thoughtsTokenCount")
        if candidates is None or thoughts is None:
            return None                            # проверить по totalTokenCount
        return candidates + thoughts
    if api == "gemini.interactions":
        output = usage.get("total_output_tokens")
        thoughts = usage.get("total_thought_tokens")
        if output is None or thoughts is None:
            return None
        return output + thoughts
    raise ValueError(f"Неизвестный API: {api}")
Функция нарочно не угадывает API по названию модели и не превращает отсутствующие значения в ноль. Разбивку рассуждений храните отдельным полем для аналитики и никогда не прибавляйте её к итогу OpenAI или Claude.
Как обе ошибки выглядят в деньгах, видно на условном тарифе 10 $ за 1 млн выходных токенов. Пусть итог выхода равен 1 200 токенам, из которых 800 — рассуждения. Правильная стоимость выхода — 1 200 × 10 $ / 1 000 000 = 0,012 $. Если к итогу ещё раз прибавить 800, отчёт покажет 0,020 $. Если у Gemini учесть только 400 токенов ответа без мыслей, получится 0,004 $. Провайдер при этом спишет те же 0,012 $: ошибка живёт только в вашем отчёте.
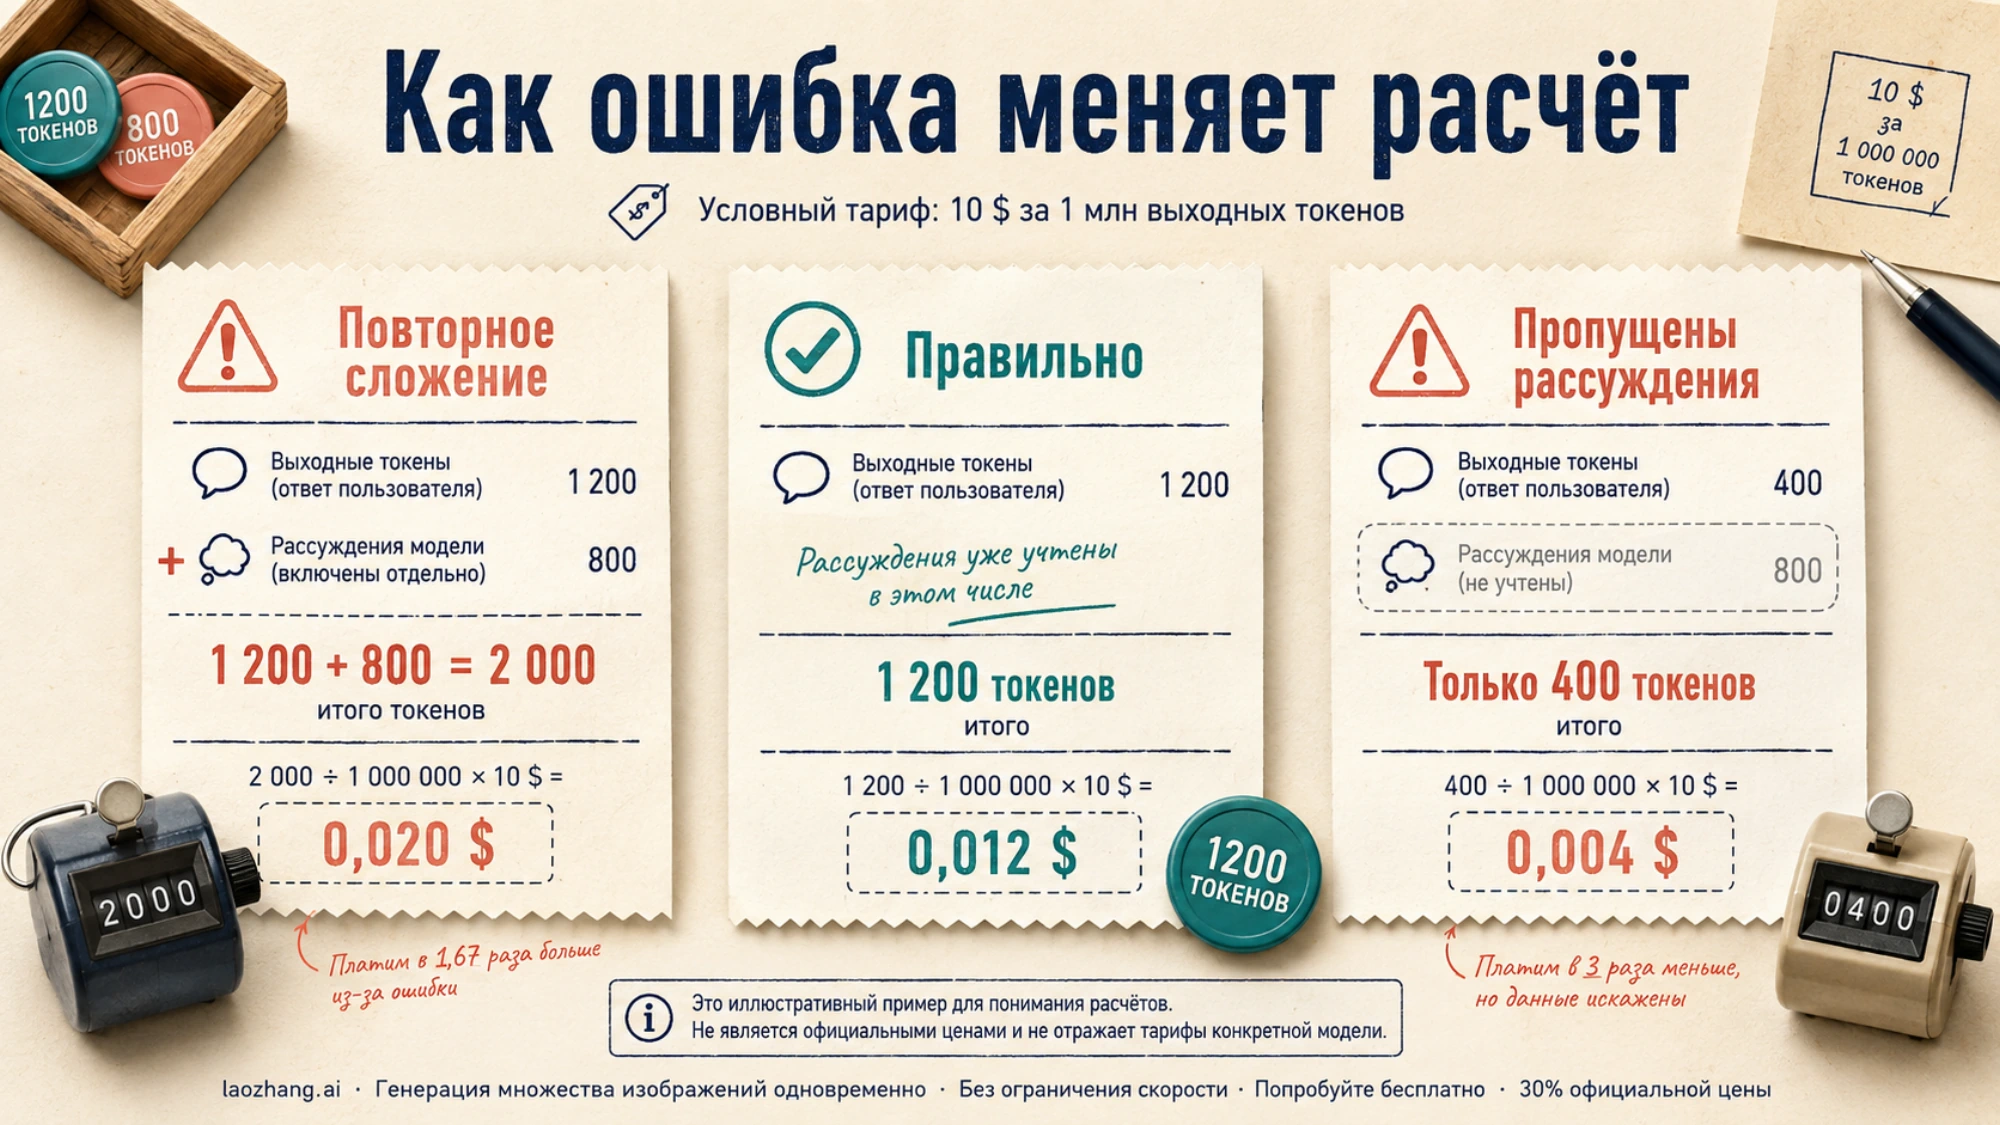
Реальный пример такой ошибки — issue #4065 в browser-use: функция _get_usage() прибавляла reasoning_tokens к completion_tokens, и для reasoning-моделей отображаемый расход вырастал примерно вдвое. Ошибку исправили, issue закрыли 10 февраля 2026 года. Это сбой клиентского учёта, а не двойное списание со стороны OpenAI.
Сколько стоит запрос: цены и пример расчёта
Цены на 25 сентября 2026 года
Стандартные тарифы прямых API, доллары за 1 млн токенов; строки Google сверены 10 октября 2026 года. Отдельного столбца для рассуждений нет ни у кого: они входят в выход.
| Провайдер | Модель | Вход | Выход (с рассуждениями) |
|---|---|---|---|
| OpenAI | gpt-6-astra | 10 $ | 50 $ |
| OpenAI | gpt-6-sol | 2 $ | 10 $ |
| OpenAI | gpt-6-luna | 0,10 $ | 0,50 $ |
| OpenAI | gpt-5.6-sol (промоцена) | 4 $ | 20 $ |
| OpenAI | gpt-5.6-terra | 2 $ | 12 $ |
| OpenAI | gpt-5.6-luna | 0,20 $ | 1,20 $ |
| Anthropic | Claude Fable 5.1 | 10 $ | 50 $ |
| Anthropic | Claude Opus 5.5 | 4 $ | 20 $ |
| Anthropic | Claude Opus 5 | 5 $ | 25 $ |
| Anthropic | Claude Sonnet 5 | 2 $ | 10 $ |
| Anthropic | Claude Sonnet 4.6 | 3 $ | 15 $ |
| Anthropic | Claude Haiku 4.5 | 1 $ | 5 $ |
gemini-3.8-flash до 31.12.2026 | 0,75 $ | 3,75 $ | |
gemini-3.8-flash с 01.01.2027 | 1,50 $ | 7,50 $ | |
gemini-3.6-flash до 31.12.2026 | 0,75 $ | 3,75 $ | |
gemini-3.6-flash с 01.01.2027 | 1,50 $ | 7,50 $ | |
gemini-3.5-flash-lite | 0,30 $ | 2,50 $ | |
gemini-3.1-pro-preview, промпт ≤ 200 тыс. | 2 $ | 12 $ | |
gemini-3.1-pro-preview, промпт > 200 тыс. | 4 $ | 18 $ |
Источники: цены OpenAI API (короткий контекст, вход до 272 тыс. токенов; для длинного контекста ставки выше), цены Claude API, цены Gemini Developer API (платный уровень, режим Standard). Batch у всех трёх снижает цену вдвое. Цифра 6,75 $ за выход у Gemini 3.8 Flash относится к режиму Priority, а не к Standard. gemini-3.5-flash (прежняя цена 1,50 $ / 9,00 $) и gemini-3.7-flash 8 октября 2026 года объявлены устаревшими: все запросы к ним автоматически выполняют gemini-3.6-flash и gemini-3.8-flash, отдельных строк в прайсе больше нет (журнал изменений Gemini API). Какой тариф применяется к запросам на старый ID, Google не уточняет. Логично ожидать цену модели, которая фактически отвечает, но это наш вывод: сверьте строки по SKU в отчётах Cloud Billing. Тарифы Gemini в Google Cloud (Agent Platform, Vertex AI) считаются отдельно, и смешивать их с Developer API нельзя. Подробнее о режимах и миграции — в разборе Gemini 3.8 Flash API: ID модели, цены, лимиты и миграция.
Пример: 2 000 токенов на входе, 6 000 на выходе
Возьмём один запрос без кэша: 2 000 входных токенов, 6 000 выходных, из них 5 000 — рассуждения (для Gemini это 1 000 токенов ответа и 5 000 мыслей). Одинаковые объёмы для всех моделей — допущение ради арифметики: на одну и ту же задачу разные модели тратят разное число токенов, а токенизаторы у них различаются. Поэтому это не сравнение провайдеров, а шаблон, в который подставляются ваши цифры из usage.
| Модель | Формула | Стоимость запроса |
|---|---|---|
| GPT-6 Sol | 2 000 × 2 $ / 1 млн + 6 000 × 10 $ / 1 млн | 0,064 $ |
| Claude Opus 5.5 | 2 000 × 4 $ / 1 млн + 6 000 × 20 $ / 1 млн | 0,128 $ |
| Gemini 3.8 Flash (до конца 2026 года) | 2 000 × 0,75 $ / 1 млн + 6 000 × 3,75 $ / 1 млн | 0,024 $ |
| Gemini 3.8 Flash (цены 2027 года) | 2 000 × 1,50 $ / 1 млн + 6 000 × 7,50 $ / 1 млн | 0,048 $ |
Что видно из этого расчёта:
- У GPT-6 Sol рассуждения стоят 5 000 × 10 $ / 1 млн = 0,050 $, то есть 78 % цены запроса. Именно они, а не видимый ответ, определяют счёт.
- Если прибавить
reasoning_tokensк итогу ещё раз, отчёт покажет 2 000 × 2 $ / 1 млн + 11 000 × 10 $ / 1 млн = 0,114 $ вместо 0,064 $. - Если у Gemini забыть
thoughtsTokenCount, выйдет 0,00525 $ — в четыре с лишним раза меньше правильной суммы.
Цена за токен не равна цене задачи. Модель с дешёвым токеном может рассуждать дольше или чаще ошибаться, и тогда задача обходится дороже. Как это считать на реальных сценариях, разобрано в статьях GPT-6 Luna или Sol: сколько стоят и когда Sol окупается и Claude Opus 5.5 или GPT-5.6 Sol: одинаковая цена, разные счета.
Лимит расхода и глубина рассуждений (effort) — разные рычаги
У каждого провайдера есть два вида настроек, и путать их дорого. Жёсткий лимит ограничивает, сколько токенов модель вправе сгенерировать за один запрос, включая рассуждения. Параметр глубины подсказывает модели, насколько подробно думать, но не обещает конкретного числа токенов.
| API | Жёсткий лимит (включает рассуждения) | Что при исчерпании | Управление глубиной | Значение по умолчанию |
|---|---|---|---|---|
| OpenAI | max_output_tokens (Responses), max_completion_tokens (Chat) | status: incomplete, incomplete_details.reason: max_output_tokens | reasoning.effort / reasoning_effort | medium у GPT-6 Sol, GPT-6 Luna и GPT-5.6 |
| Claude | max_tokens на один запрос | stop_reason: "max_tokens" | output_config.effort: low … max | high у большинства моделей, medium у Opus 5.5 |
| Gemini | max_output_tokens (Interactions API) | status: incomplete, ответ обрезан или пуст | thinking_level (thinkingLevel в generateContent) | medium у 3.8 Flash (на неё же с 8 октября 2026 года уходят запросы к gemini-3.7-flash), high у 3.1 Pro Preview, minimal у 3.5 Flash-Lite |
Детали, которые меняют поведение:
- OpenAI. Допустимые значения effort зависят от модели: GPT-6 Sol, Luna и GPT-5.6 принимают от
noneдоmax, а GPT-6 Astra наnoneотвечает ошибкой 400. Режимreasoning.mode: "pro"в Responses API выполняет больше работы и тарифицирует её по обычным ставкам модели — расход токенов растёт (раздел о reasoning effort). Выбор между GPT-6 и GPT-5.6 — в статье Какую модель OpenAI выбрать для API: GPT-6 или GPT-5.6. - Claude. На моделях с адаптивным мышлением бюджета рассуждений нет: старый параметр
budget_tokensна Claude 4.7 и новее отклоняется с ошибкой 400, так что инструкции с ним к актуальным моделям не подходят. На Opus 5.5 мышление не отключается, и effort — главный способ управлять ценой. Effort влияет на все выходные токены, включая текст и вызовы инструментов. Смена effort между запросами сбрасывает кэш промпта; у Opus 5.5 и Fable 5.1 есть бета-режим смены effort внутри диалога, который кэш сохраняет (документация effort). Как выбрать уровень для Opus 5.5 — в статье Claude Opus 5.5: какой уровень effort выбрать и как его задать. - Gemini. В
generateContentпомимоthinkingLevelестьthinkingBudget— желаемое число токенов мыслей, но для Gemini 3 и новее Google рекомендует уровни (ThinkingConfig).
Сколько токенов тратит каждый уровень effort, ни один провайдер не публикует: это зависит от задачи. Измеряйте на собственных запросах по полю разбивки рассуждений.
Почему пустой ответ всё равно оплачен
Лимит выхода считает рассуждения вместе с текстом. Если модель израсходовала его на размышления, текст ответа может так и не начаться, а вход и рассуждения уже оплачены. OpenAI описывает этот сценарий прямо и советует на старте оставлять под рассуждения и ответ не меньше 25 000 токенов. Google пишет то же для Gemini: при исчерпании max_output_tokens мысли тарифицируются, даже если ответ пуст.
Пример по тарифу GPT-6 Sol: запрос с 2 000 входных токенов и max_output_tokens 4 096, целиком ушедшими на рассуждения, стоит 2 000 × 2 $ / 1 млн + 4 096 × 10 $ / 1 млн ≈ 0,045 $ — и не приносит ни строки текста. Маленький лимит, выставленный «для экономии», превращает часть трафика в такие запросы.
Что менять: счёт слишком большой или ответ обрывается
- Ответы нормальные, но дорого. Снижайте глубину:
reasoning.effort,output_config.effortилиthinking_level. Google прямо рекомендует понижатьthinking_level, а не урезатьmax_output_tokens. Проверяйте качество на своих задачах: экономия имеет смысл, только если результат не портится. - Ответы обрываются,
incompleteилиstop_reason: "max_tokens". Решите, нужны ли этим запросам рассуждения. Если качество важно — поднимайте лимит; если модель передумывает простые задачи — снижайте глубину. Anthropic даёт тот же выбор в разделе об управлении стоимостью. - Нужен потолок на всю операцию, а не на запрос. У Claude
max_tokensдействует на каждый запрос отдельно, поэтому в цикле с инструментами он не ограничивает весь ход агента. Потолок на операцию придётся считать в своём коде, суммируя usage по запросам.
Масштаб эффекта легко оценить. Допустим, после снижения effort рассуждения у GPT-6 Sol сократились с 5 000 до 1 000 токенов на запрос. При 1 000 запросов в день это 1 000 × 4 000 × 10 $ / 1 млн = 40 $ в день. Реальное снижение будет другим: цифры 5 000 и 1 000 взяты для примера.
Как свести свой учёт со счётом
Даже с правильной формулой отчёт расходится со счётом, если одно и то же потребление записано несколько раз или, наоборот, потеряно.
Потоковые ответы
- Claude. Значения usage в событиях
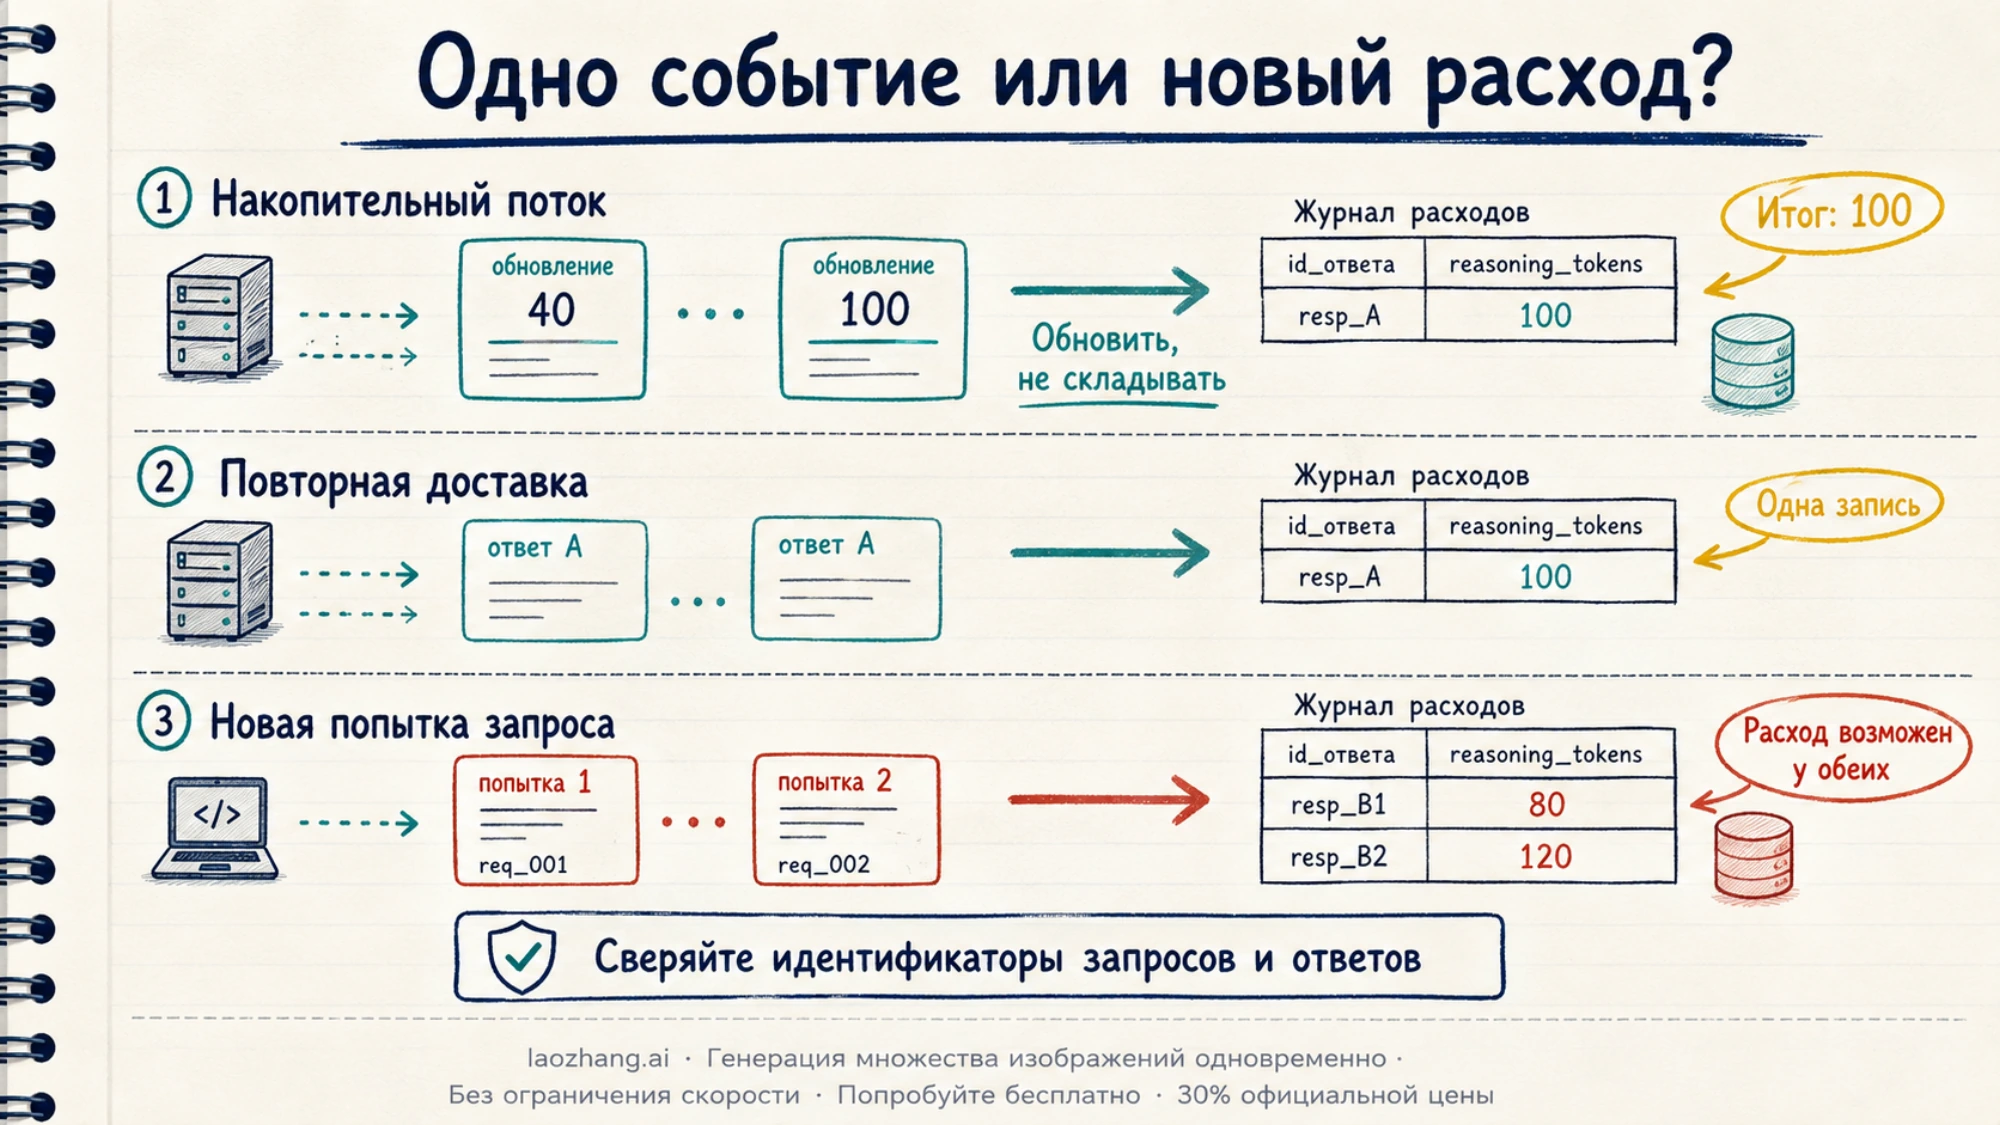
message_deltaнакопительные: если промежуточное событие показало 40 выходных токенов, а финальное — 100, итог равен 100, а не 140. Берите последнее значение или итоговое сообщение SDK (потоковая передача в Claude API). Разбивкаthinking_tokensприходит только в финальномmessage_delta. - OpenAI Chat Completions. С
stream_options.include_usageпередdata: [DONE]приходит отдельный чанк с usage за весь запрос. Если поток оборвался, этого чанка может не быть — и тогда итог неизвестен, а не равен нулю. - OpenAI Responses. Поток завершается событием
response.completed; usage берите из итогового объекта ответа. Чем ещё отличаются два API OpenAI, включая потоковую передачу, — в статье Chat Completions или Responses API: что меняется в интеграции.
Если финальных данных нет, пометьте запись как неполную. Последнее увиденное промежуточное число — не подтверждённый расход.
Повторная доставка и новая попытка
Для собственной базы важно различать три случая:
- Обновление того же ответа. Накопительное значение заменяет предыдущее, а не прибавляется к нему.
- Повторная доставка того же события. Очередь или вебхук прислали финальную запись дважды — расход не меняется. Запись должна быть идемпотентной по идентификатору ответа.
- Новая попытка запроса. Клиент получил тайм-аут и отправил запрос заново. Провайдер мог обработать обе попытки, и тогда оплачены обе, даже если промпт совпадает до символа.
Храните идентификатор своей операции, номер попытки и идентификаторы запроса и ответа провайдера. Тогда одна пользовательская операция с двумя оплаченными попытками не будет выглядеть как ошибка учёта.
Рассуждения прошлых ходов во входе
В многоходовом диалоге рассуждения могут вернуться в счёт уже как вход следующего запроса. У Claude на моделях, которые сохраняют мышление всех ходов (Opus 4.5 и более поздние Opus, Sonnet 4.6 и более поздние Sonnet, Fable, Mythos), прошлые thinking-блоки по умолчанию остаются в контексте и оплачиваются как входные токены. Это новое потребление на следующем шаге, а не повторная оплата прошлого выхода. Блоки, которые целевая модель прочитать не может, API отбрасывает без ошибки и не тарифицирует. Если в длинном диалоге внезапно дорожает отдельный ход, проверьте и кэш — это разобрано в статье Claude Code cache miss и стоимость токенов: почему один turn внезапно дорогой.
У OpenAI модели GPT-5.6 по умолчанию подставляют доступные рассуждения прошлых ходов в следующий запрос (reasoning.context: "all_turns"), у более ранних моделей по умолчанию — только текущий ход. Как именно эти рассуждения отражаются в usage следующего запроса, в документации не расписано. Если это важно для бюджета, прогоните один и тот же диалог с all_turns и current_turn и сравните входные токены.
Порядок проверки при расхождении
Возьмите одну попытку запроса, для которой есть сырой usage и запись провайдера, и пройдите по шагам:
- Совпадают ли модель, API, время и идентификатор ответа. Через посредника — его описание полей и тарифов.
- Правильная ли формула выхода: не прибавлена ли разбивка к итогу OpenAI или Claude, не потеряны ли мысли Gemini.
- Финальный ли это usage и записан ли он один раз. Накопительные снимки не складываются.
- Верно ли разделены вход, кэш и выход и выбран ли тариф нужной модели, даты и режима (Standard, Batch, Priority, длинный контекст).
- Были ли другие попытки той же операции и прошлые рассуждения во входе следующих запросов.
Если после пятого шага разница осталась, сохраните сырые ответы и идентификаторы: с ними поддержка провайдера или посредника сможет найти конкретные записи.
Короткие ответы
Оплачиваются ли рассуждения, если модель их не показывает?
Да. У OpenAI, Claude и Gemini скрытые рассуждения тарифицируются по цене выходных токенов в полном объёме. Показанное резюме мыслей (у Claude оно бесплатное) или его отсутствие на сумму не влияет.
Можно ли задать точное число токенов рассуждений?
У актуальных моделей Claude — нет: budget_tokens на Claude 4.7 и новее не принимается, есть только effort и жёсткий max_tokens. У OpenAI точного бюджета тоже нет: effort задаёт глубину, а max_output_tokens — потолок. У Gemini в generateContent доступен thinkingBudget, но для Gemini 3 Google рекомендует thinkingLevel. Жёсткий лимит выхода ограничивает объём, но может оставить ответ пустым.
Сколько токенов тратят high, xhigh и max?
Эти цифры не публикует ни один провайдер: effort — подсказка модели, а не бюджет, и расход зависит от задачи. Прогоните несколько уровней на своих запросах и сравните reasoning_tokens или thinking_tokens вместе с качеством результата.
Почему посредник показывает другие числа, чем официальный API?
У шлюзов свои параметры reasoning и свой формат usage. Проверьте, возвращает ли посредник разбивку рассуждений и не объединяет ли поля Gemini в один completion_tokens, прежде чем применять формулы из таблицы выше.
Работают ли API OpenAI, Anthropic и Gemini из России?
Россия и Беларусь не входят в списки поддерживаемых стран OpenAI, Anthropic и Gemini API; OpenAI предупреждает, что доступ из стран вне списка может привести к блокировке или приостановке аккаунта. Казахстан, Армения, Грузия, Узбекистан и Кыргызстан в этих списках есть. Значение имеет местоположение, а не язык интерфейса.